
Last chance! 50% off DataCamp Premium
Sale ends in
Als ik één ding in de diepte zou aanraden om te leren om een betere data-analist of data scientist te worden, dan is het regressie. En een cruciaal onderdeel van regressie leren is precies begrijpen wat heteroscedasticiteit is.
In dit artikel kijken we naar het fenomeen heteroscedasticiteit, waarom het ertoe doet, hoe je het herkent en welke stappen je kunt nemen om het aan te pakken. Ik ben volledig maar ga vlot door. Dus of je nu een doorgewinterde analist bent of net begint, ik hoop dat je hier iets interessants en nuttigs vindt. Voor meer informatie en om het pad naar expertise te starten, volg onze Intro to Regression in R-cursus of onze Intro to Regression in Python. Ik heb ook een tutorial over simpele lineaire regressie als je een snelle opfrisser nodig hebt.
Wat is heteroscedasticiteit nu precies? Laten we de technische definities even behandelen voordat we naar voorbeelden kijken. Als je over het woord struikelt, zoals ik, kun je ook “ongelijke variantie” zeggen — dat dekt de lading.
Heteroscedasticiteit verwijst naar een situatie waarin de variabiliteit van een afhankelijke variabele ongelijk is over het bereik van waarden van een onafhankelijke variabele. Of, meer geworteld in modelbouw: heteroscedasticiteit treedt op wanneer de spreiding of dispersie van residuen niet constant is, zoals we soms zien in een model als een regressiemodel of een tijdreeksmodel.
In zekere zin geef ik de voorkeur aan die tweede definitie omdat die ons eraan herinnert dat heteroscedasticiteit eigenlijk een veelvoorkomend aspect (maar ook een veelvoorkomend probleem) is van statistische modellering. Maar om het duidelijk te zeggen: hoewel heteroscedasticiteit het meest wordt besproken in de context van modellen zoals regressie, kan het zowel een kenmerk van de modelspecificatie zijn als een eigenschap van de data zelf.
Laten we een paar voorbeelden bekijken met R en een domein kiezen — bijvoorbeeld, huishoudfinanciën. Voor de aftrap laat ik de klassieke trechter- of waaier-vorm zien waar ik persoonlijk als eerste aan denk bij ongelijke variantie.
Deze vorm van heteroscedasticiteit kan bijvoorbeeld voorkomen in data met inkomen versus uitgaven: Huishoudens met een lager inkomen hebben vaak consistente maandelijkse uitgaven gericht op basisbehoeften zoals huur en eten, wat resulteert in lage variabiliteit; huishoudens met een hoger inkomen hebben daarentegen meer variabiliteit in uitgaven omdat slechts sommige hoge-inkomenshuishoudens kiezen voor dure discretionaire aankopen zoals vakanties of luxeartikelen, terwijl anderen sparen. Dus in dit voorbeeld neemt, naarmate het inkomen stijgt, de variabiliteit in maandelijkse uitgaven ook toe — vandaar de waaier-vorm.
y_funnel <- x + rnorm(length(x), mean = 0, sd = x * 0.5)y_inverse_funnel <- x + rnorm(length(x), mean = 0, sd = (1 / x) * 20)y_cyclical <- x + rnorm(length(x), mean = 0, sd = 10 * abs(sin(x / 5)))heteroscedasticity_data <- data.frame(x, y_funnel, y_inverse_funnel, y_cyclical)library(ggplot2)ggplot(heteroscedasticity_data, aes(x = x, y = y_funnel)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs( title = "Funnel Shape", x = "X Values", y = "Y Values" )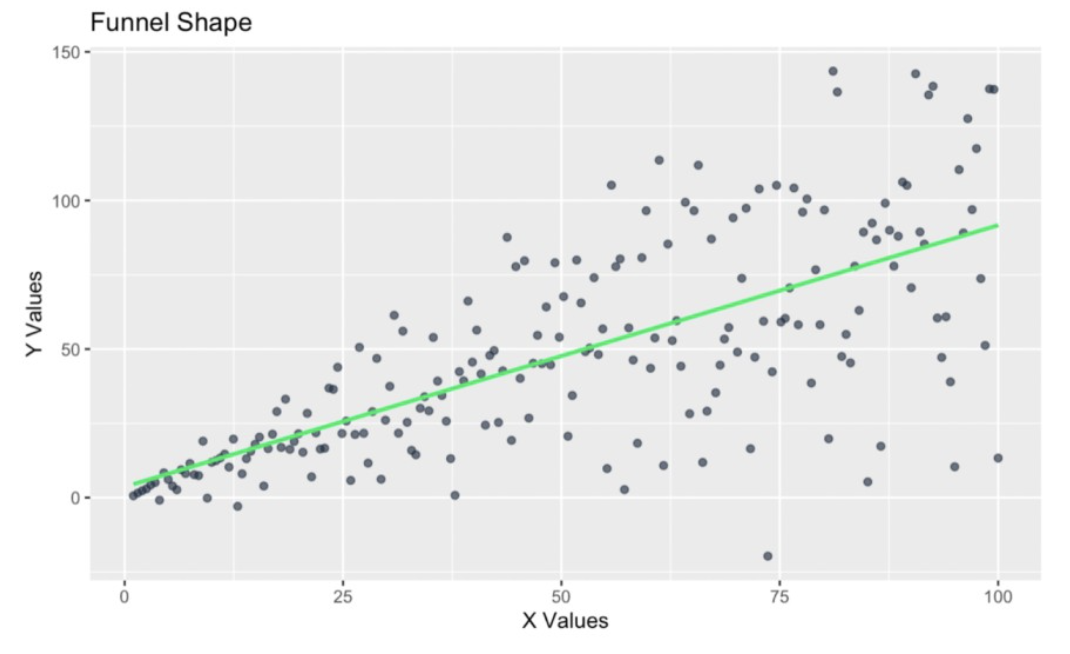
Trechtervorm in de residuen. Afbeelding door de auteur
Laten we nog een voorbeeld proberen, ook binnen huishoudfinanciën. Stel dat we een regressiemodel maken om spaarvariabiliteit tegenover de leeftijd van gezinsleden te laten zien.
We vermoeden dat deze data heteroscedasticiteit zal vertonen omdat jongere huishoudens mogelijk een hoge variabiliteit in sparen hebben door onregelmatige inkomsten, zoals gigwerk en stages, of onvoorziene uitgaven, zoals studieleningen of het starten van een gezin. Maar naarmate huishoudens ouder worden en financieel stabiliseren, wordt spaargedrag consistenter, wat een omgekeerde trechtervorm creëert waarbij de variabiliteit met de leeftijd afneemt.
ggplot(heteroscedasticity_data, aes(x = x, y = y_inverse_funnel)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs( title = "Inverse Funnel Shape", x = "X Values", y = "Y Values" )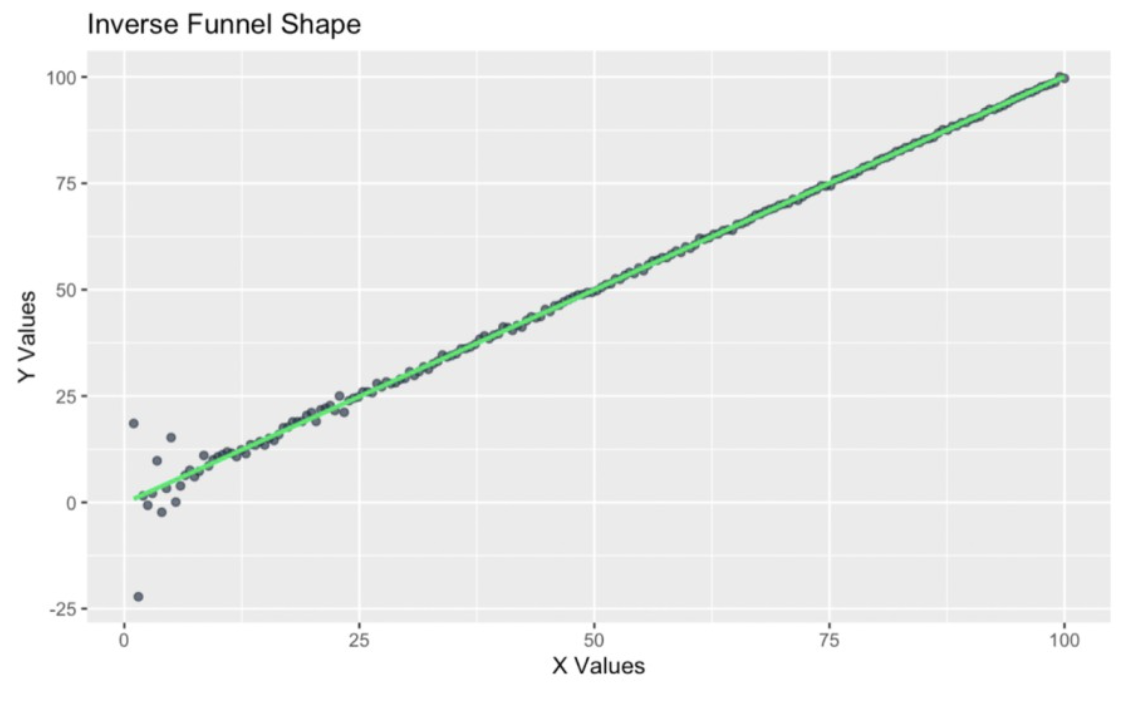
Omgekeerde trechtervorm in de residuen. Afbeelding door de auteur
Laten we tot slot nog een voorbeeld bekijken met huishoudinkomens. Hier kijken we naar cyclische variantie, specifiek uitgavenvariatie over seizoenen. Je herkent dit patroon misschien als je een van onze forecasting-cursussen hebt gevolgd, zoals onze zeer populaire Forecasting in R.
We weten dat huishoudelijke uitgaven vaak cyclisch fluctueren door het jaar heen. Zo kan de variantie toenemen tijdens feestdagen omdat we cadeaus kopen of reizen om familie te bezoeken, en afnemen in andere maanden met minder feestdagen, zoals maart of september. De onderstaande grafiek toont heteroscedasticiteit, maar dan op een complexere manier, waarbij deze in verschillende perioden toeneemt en afneemt.
ggplot(heteroscedasticity_data, aes(x = x, y = y_cyclical)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs( title = "Cyclical Pattern", x = "X Values", y = "Y Values" )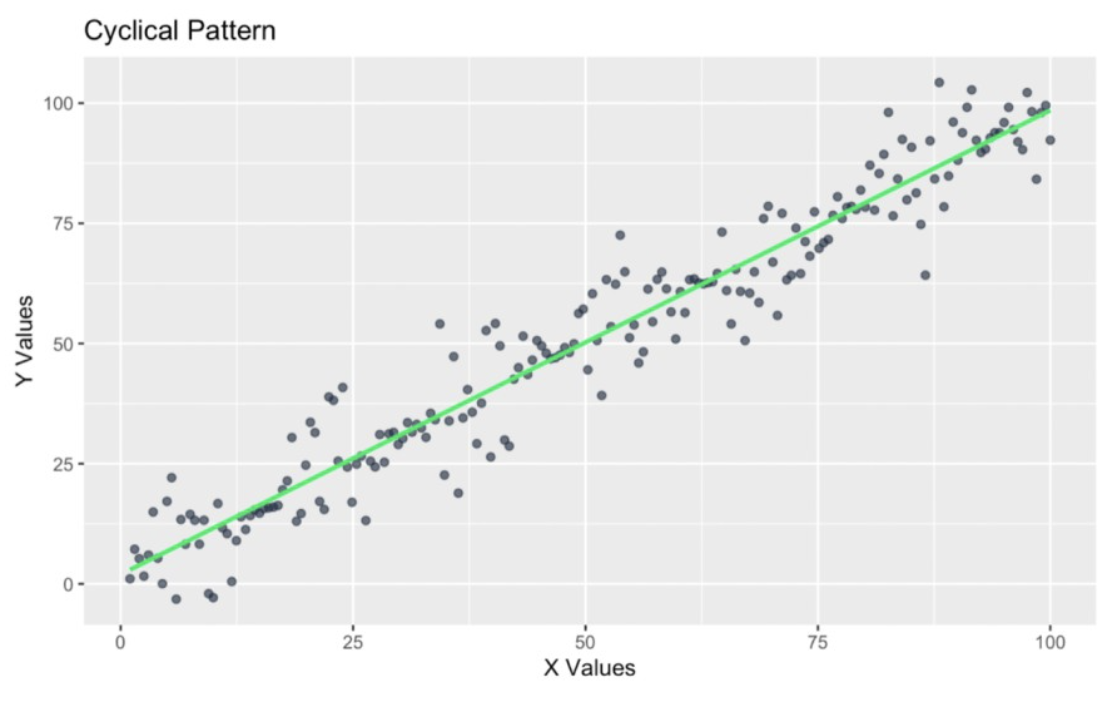
Cyclisch patroon in de residuen. Afbeelding door de auteur
Zoals je ziet kan heteroscedasticiteit verschillende vormen aannemen. Laten we nu kijken waarom dit allemaal belangrijk is.
Ik durf te stellen dat je in het algemeen geen regressies goed kunt doen zonder iets te begrijpen van heteroscedasticiteit, aangezien heteroscedasticiteit zo vaak voorkomt en zo’n groot vertekenend effect op onze resultaten kan hebben.
Waarschijnlijk is het om deze reden dat homoscedasticiteit — het tegenovergestelde van heteroscedasticiteit — eigenlijk een van de belangrijkste aannames van regressiemodellen is, naast lineariteit, onafhankelijkheid van fouten, normaliteit van residuen en de afwezigheid van multicollineariteit.
Deze regressie-aannames zijn belangrijk omdat ze helpen ervoor te zorgen dat de voorspellingen en inferenties van ons model betekenisvol zijn. Wanneer deze aannames geschonden worden, kan de betrouwbaarheid van onze schattingen, inclusief onze standaardfouten en betrouwbaarheidsintervallen, afnemen en zijn onze hypothesetests minder geldig.
Heteroscedasticiteit verschijnt niet uit het niets. De oorzaak ligt vaak in hoe data wordt verzameld of getransformeerd. Laten we kijken naar zowel datatransformatie- als dataverzamelingsproblemen.
Soms kunnen juist de stappen die we nemen om onze data voor te bereiden heteroscedasticiteit introduceren. Ik denk dan aan hoe onjuiste schaling of niet-lineaire transformaties onbedoelde variabiliteit kunnen creëren.
Om hierover na te denken, stel dat we de relatie tussen de grootte van een appartement en de maandhuur bestuderen. Normaal gesproken verwachten we misschien een lineaire relatie tussen grootte en huur, omdat grotere appartementen meer kosten, en de variantie in huur hoeft niet per se toe te nemen met de grootte omdat de relatie (misschien) proportioneel is. Zo zou dat eruit kunnen zien:
set.seed(1024)size <- runif(1000, 500, 2000) # Random sizes between 500 and 2000 sq ftrent <- 20 * size + rnorm(100, mean = 0, sd = 5000) # Linear relation with added noiseunequal_variance_df <- data.frame(size = size, rent = rent)ggplot(unequal_variance_df, aes(x = size, y = rent)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs(title = "Size vs. Rent", x = "Size (sq ft)", y = "Rent")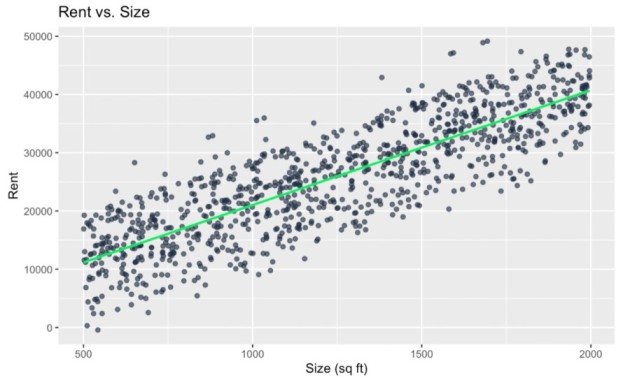
Geen heteroscedasticiteit. Afbeelding door de auteur
Als we de huur schalen naar grootte om de “huur per vierkante voet” te berekenen, creëren we een nieuwe maatstaf. Als we vervolgens proberen huur per vierkante voet te voorspellen op basis van huur, kan deze transformatie heteroscedasticiteit creëren of uitvergroten. Om duidelijk te zijn: in het algemeen erken ik dat dit geen goed idee is — om de onafhankelijke variabele door de afhankelijke te delen — omdat we een situatie creëren waarin y al beïnvloed is door x en we dus een schijncorrelatie veroorzaken. Ik erken dus dat dit conceptuele en statistische uitdagingen oplevert. Maar (blijf even bij me) ik gebruik dit als voorbeeld om het punt te illustreren:
unequal_variance_df$rent_per_sqft <- unequal_variance_df$rent / unequal_variance_df$sizeggplot(unequal_variance_df, aes(x = size, y = rent_per_sqft)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs(title = "Size vs. Rent per Square Foot", x = "Size (sq ft)", y = "Rent per Sq Ft")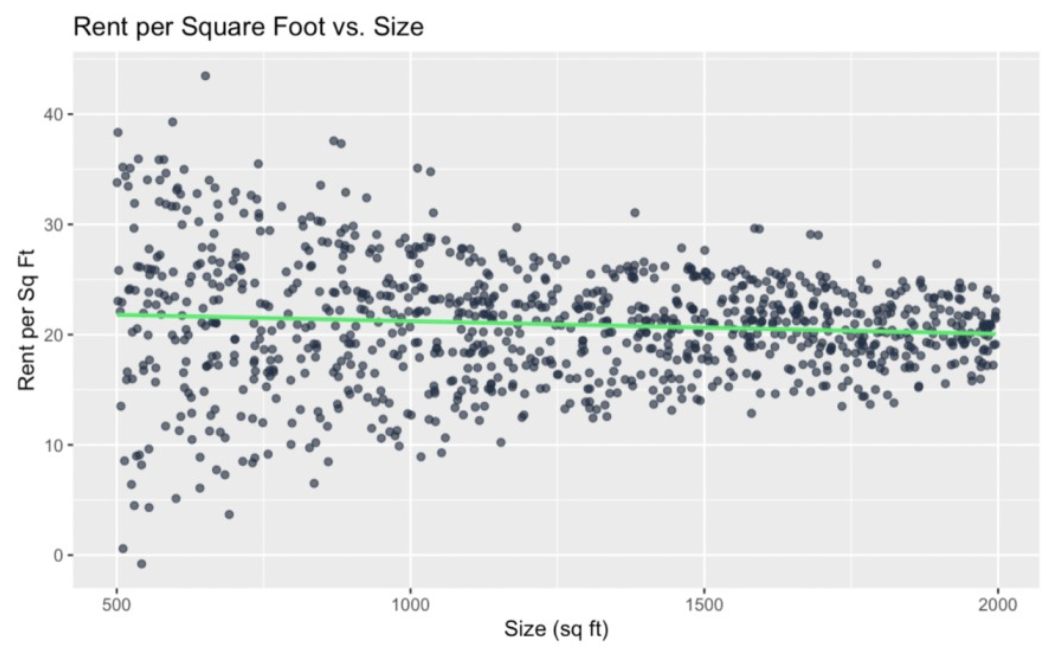
Heteroscedasticiteit veroorzaakt door functionele afhankelijkheid. Afbeelding door de auteur
We zien dat deze grafiek een trechtervorm heeft waarbij de variabiliteit in huur per vierkante voet afneemt naarmate de grootte toeneemt. We hebben heteroscedasticiteit dus uit het niets gecreëerd. Voor een ander voorbeeld kunnen we beide variabelen kwadrateren:
unequal_variance_df$size_squared <- unequal_variance_df$size^2ggplot(unequal_variance_df, aes(x = size ^ 2, y = rent ^ 2)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs(title = "Size Squared vs. Rent Squared", x = "Size Squared", y = "Rent Squared")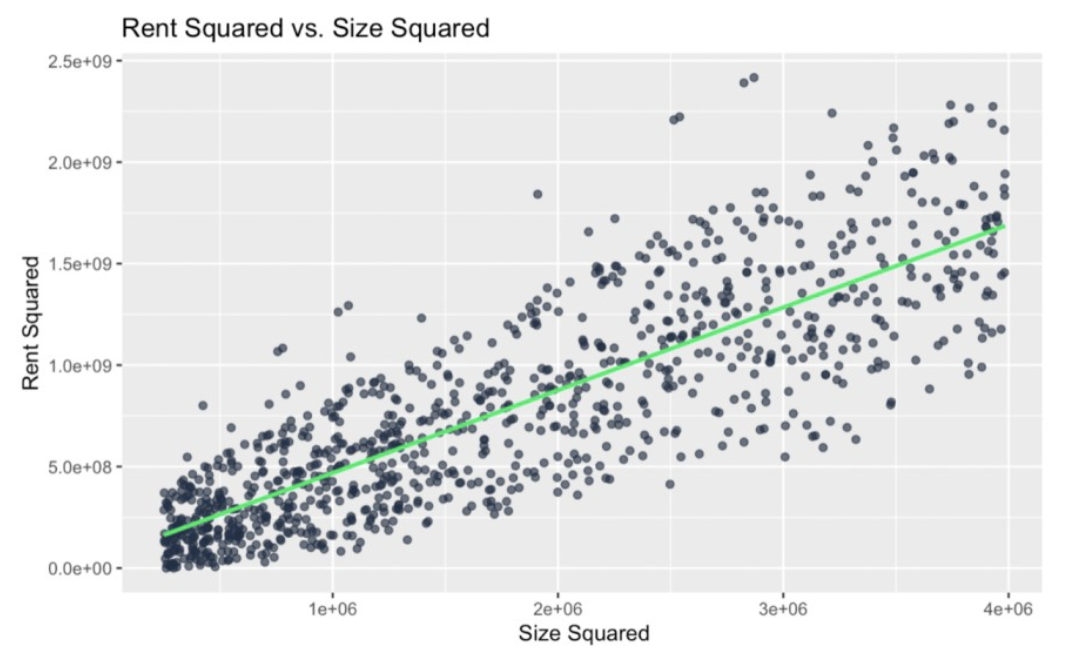
Heteroscedasticiteit veroorzaakt door kwadrateren. Afbeelding door de auteur
Opnieuw hebben we heteroscedasticiteit gecreëerd waar die eerst niet bestond, omdat we per se zowel x als y wilden kwadrateren. In sommige contexten is dit prima, maar hier vermoedde ik dat het kwadrateren van beide variabelen heteroscedasticiteit zou creëren, omdat de transformatie verschillen in variantie versterkt naarmate de waarden van de variabelen toenemen.
Dit tweede voorbeeld is ook wat gekunsteld, want we zouden dit model niet moeten maken. We zouden dit model niet maken omdat het zonder reden lastig te interpreteren is. Maar in een realistische modelworkflow kunnen transformaties die per ongeluk heteroscedasticiteit creëren subtieler zijn. Je kunt het missen als het proces meerdere stappen omvat.
Concreter: in dit geval is heteroscedasticiteit ontstaan door feature engineering met verhoudingen. Ratio’s zoals “huur per vierkante voet” komen inderdaad vaak voor bij feature engineering. Deze variabelen kunnen echter heteroscedasticiteit introduceren als met name de noemer sterk varieert tussen observaties. Logaritmische of exponentiële transformaties worden ook vaak gebruikt om variantie te stabiliseren of relaties te linearizeren. Ze inconsistent toepassen kan echter averechts werken. Stel dat je in een model het inkomen log-transformeert maar verwante features zoals uitgaven niet aanpast. Dit soort mismatch is een veelvoorkomende bron van heteroscedasticiteit, dus zorg dat alles op elkaar aansluit zodat je geen valse dynamiek veroorzaakt.
Heteroscedasticiteit kan ook voortkomen uit inconsistente dataverzamelingspraktijken. Bijvoorbeeld, halverwege een studie van meetinstrument wisselen kan heteroscedasticiteit introduceren. Verschillende groepsgroottes en daardoor verschillende steekproefgroottes in een studie kunnen ook heteroscedasticiteit creëren. Vasthouden aan één aanpak is belangrijk.
Heteroscedasticiteit detecteren is de eerste stap om het aan te pakken, en gelukkig zijn er zowel visuele als statistische hulpmiddelen beschikbaar.
Spreidingsdiagrammen kunnen patronen in je data onthullen die helpen heteroscedasticiteit te ontdekken. Ik vind de plot van gefitte waarden versus residuen hiervoor prettig. Terzijde: een histogram van residuen of een residuen-q-q plot is niet genoeg om heteroscedasticiteit te detecteren, omdat deze twee plots eigenlijk het best zijn voor het testen van normaliteit.
y_funnel <- x + rnorm(length(x), mean = 0, sd = x * 0.5)heteroscedasticity_data <- data.frame(x, y_funnel)unequal_variance_model <- lm(y_funnel ~ x, heteroscedasticity_data)fitted_values_vs_residuals <- ggplot(data = unequal_variance_model, aes(x = .fitted, y = .resid)) + geom_point(color = '#203147') + geom_hline(yintercept = 0, linetype = "dashed", color = '#01ef63', size = 1) + xlab("fitted values") + ylab("residuals") + labs(title = "Heteroscedasticity Data") + labs(subtitle = "Fitted Values vs Residuals")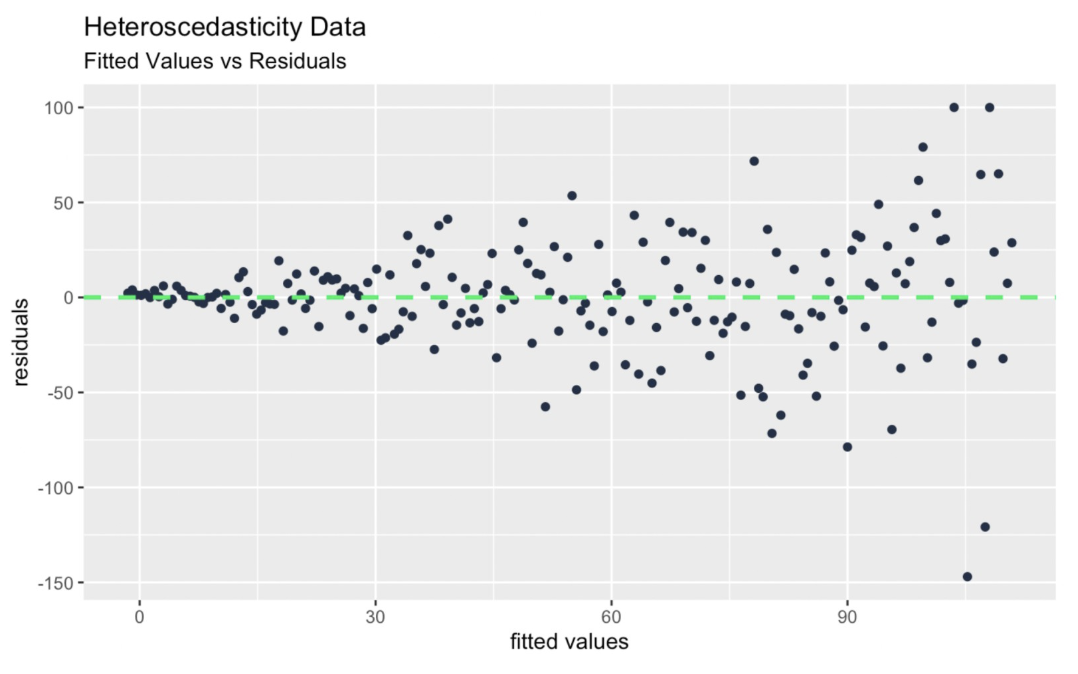 Diagnostische plot van gefitte waarden versus residuen. Afbeelding door de auteur
Statistische tests zoals de Breusch–Pagan-test bieden een kwantitatievere aanpak. De Breusch–Pagan kijkt of de gekwadrateerde residuen uit het model gerelateerd zijn aan de voorspellers. Om de test uit te voeren, fitten we ons model en gebruiken we de functie bptest() uit de lmtest-bibliotheek. Weet wel dat de test normale residuen aanneemt.
library(lmtest)model <- lm(rent ~ size, data = unequal_variance_df)bp_test <- bptest(model)print(bp_test)Zodra je heteroscedasticiteit hebt vastgesteld, is de volgende stap om het aan te pakken met beproefde technieken.
Eenvoudige transformaties, zoals het toepassen van logaritmen, kunnen heteroscedasticiteit vaak verminderen of elimineren. Eerder namen we een model zonder ongelijke variantie, pasten transformaties toe en creëerden problemen, maar in de praktijk gebeurt vaker het omgekeerde: we gebruiken transformaties zoals logaritmen, wortels of reciproken om grotere waarden te comprimeren terwijl kleinere waarden worden uitvergroot. Bijvoorbeeld: als de huur exponentieel zou groeien met de grootte, zou het nemen van de log van de huur de exponentiële groei afvlakken en de relatie lineair maken met (misschien) gelijke variantie.
Ook wil ik erop wijzen dat we bij het voorbereiden van data vaak denken aan het corrigeren van scheefheid. Bijvoorbeeld: als we rechts-scheve data hebben, gebruiken we misschien een worteltransformatie om de data Gaussiaans te maken. Maar wat we wellicht minder waarderen is dat in scheve data grotere waarden ook neigen naar grotere variabiliteit, wat óók een schending is van de aannames van homoscedasticiteit.
Wanneer transformaties niet volstaan, kunnen robuuste regressiemethoden zoals gewogen kleinste kwadraten (WLS) helpen. Weighted least squares is hier vooral interessant omdat het is ontworpen om dataproblemen zoals heteroscedasticiteit en uitschieters aan te pakken. Concreet kent WLS gewichten toe aan observaties op basis van hun variantie, waardoor de invloed van datapunten met hogere variabiliteit afneemt en we stabielere schattingen krijgen. Terzijde: bij WLS gaan we ervan uit dat de gewichten goed bekend of goed geschat zijn.
Heteroscedasticiteit negeren lijkt misschien onschuldig, maar het kan problemen veroorzaken.
Heteroscedasticiteit kan vertekenen hoe een model het belang van features interpreteert. In een uitgavenmodel kunnen features zoals inkomen bijvoorbeeld belangrijker lijken als ze gekoppeld zijn aan groepen met hoge variabiliteit, zoals hoge-inkomenshuishoudens met discretionaire aankopen. Deze verkeerde weergave kan ertoe leiden dat we minder betrouwbare voorspellers overschatten terwijl we consistentere onderschatten, wat de bruikbaarheid van het model beïnvloedt.
Heteroscedasticiteit kan het gebruik van gangbare statistische tests zoals t-tests of F-tests ongeldig maken als je gelijke variantie aanneemt en aan die aanname niet wordt voldaan. Ongelijke variantie is ook problematisch in tijdreeksdata, waar patronen in variabiliteit in de tijd evolueren, wat tot verwarring kan leiden bij het analyseren van seizoenspatronen. Heteroscedasticity-consistente standaardfouten (HCSE) kunnen worden gebruikt om betrouwbaardere statistische inferentie mogelijk te maken.
In dit artikel hebben we de situatie bestudeerd waarin de variantie van de residuen niet constant is over niveaus van een onafhankelijke variabele in een model. Hier wil ik kort praten over een verwant idee, namelijk variantieheterogeniteit op groepsniveau, verwijzend naar variabiliteit over vooraf gedefinieerde groepen. Dit is minder een statistisch probleem gekoppeld aan modelaannames en meer een beschrijvende observatie van de data.
Ik laat het zien met een laatste voorbeeld. Hier gebruik ik een simulatie van surveydata. Ik denk aan een scenario waarin inkomensdata is verzameld met twee verschillende methoden: enquêtes en administratieve registraties. Deze methoden kunnen verschillende nauwkeurigheidsniveaus hebben (Zijn enquêtes niet berucht?). We zien dat de hoeveelheid variatie binnen elke groep niet consistent is, wat een probleem kan zijn bij iets als ANOVA.
set.seed(1024)income_admin <- rnorm(500, mean = 50000, sd = 2000) spending_admin <- income_admin * 0.3 + rnorm(500, mean = 0, sd = 1000)income_survey <- rnorm(500, mean = 50000, sd = 8000) # Same mean, higher SDspending_survey <- income_survey * 0.3 + rnorm(500, mean = 0, sd = 5000)income <- c(income_admin, income_survey)spending <- c(spending_admin, spending_survey)method <- rep(c("Administrative Records", "Survey"), each = 500)survey_and_admin_data <- data.frame(income = income, spending = spending, method = method) # Plot the datacustom_colors <- c("Administrative Records" ='#01ef63', "Survey" = '#203147')ggplot(survey_and_admin_data, aes(x = income, y = spending, color = method)) + geom_point(alpha = 0.7) + labs( title = "Variability in Data Collection", x = "Income", y = "Spending")+ scale_color_manual(values = custom_colors)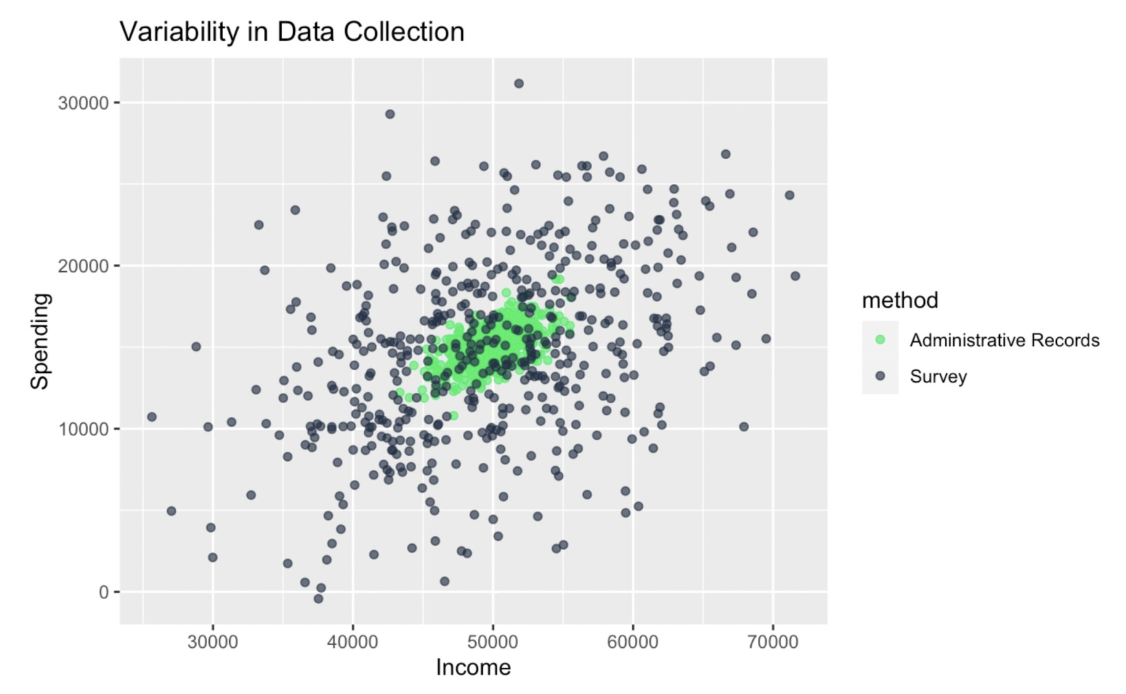
Variantieheterogeniteit op groepsniveau. Afbeelding door de auteur
Heteroscedasticiteit aanpakken draait niet alleen om het verbeteren van je regressiemodel. Het gaat erom dat je werk kritiek kan doorstaan. Blijf leren en word expert met onze Statistical Inference in R-track en de cursus Foundations of Inference in R. Ik denk ook dat onze Statistician in R-track een andere geweldige optie is, zowel voor leren als voor loopbaanontwikkeling.
Leer regressie met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min


