

Een vraagcurve gebruiken om prijzen te analyseren in R
Laten we een vraagcurve maken en analyseren met R. Om een dataset te simuleren heb ik een exponentiële-vervalcurve gemaakt met ruis eromheen. Het idee is dat elk datapunt een week aan autoverkoop voorstelt, waarbij de dealer verschillende acties en prijsniveaus voor hetzelfde type auto uitprobeert om de verkoop te verhogen.
# Load necessary library
library(tidyverse)
# Define parameters for the exponential decay
a <- 100 # Initial value
b <- 0.5 # Decay rate
# Define a realistic price range
price <- seq(10000, 40000, length.out = 200) # Price from $10,000 to $40,000
# Calculate the exponential decay
y <- a * exp(-b * (price / 10000)) # Adjust decay rate to match price scaling
# Add mixed noise (additive + slight proportional)
set.seed(42) # For reproducibility
additive_noise <- rnorm(length(y), mean = 0, sd = 1) # Constant additive noise
proportional_noise <- rnorm(length(y), mean = 0, sd = 0.05 * y) # Small proportional noise
y_noisy <- y + additive_noise + proportional_noise
# Ensure no negative values (optional, as sales can't be negative)
y_noisy[y_noisy < 0] <- 0.01
# Combine price and noisy y into a data frame
demand_curve_data <- data.frame(
price = price,
quantity_sold = y_noisy
)
# Clean and prepare the data
demand_curve_data <- demand_curve_data %>%
mutate(quantity_sold = round(quantity_sold, 0)) %>%
filter(quantity_sold != 0)
# Plot the noisy exponential decay
ggplot(demand_curve_data, aes(x = price, y = quantity_sold)) +
geom_point(color = '#203147', alpha = 0.6) +
geom_line(
aes(y = a * exp(-b * (price / 10000))),
color = '#01ef63',
size = 1.2,
linetype = "dashed"
) +
labs(
title = "Cars Sold",
subtitle = "Demand Curve (Cars Sold)",
x = "Price ($)",
y = "Quantity Sold"
) +
scale_x_continuous(labels = scales::dollar_format()) # Format x-axis as dollars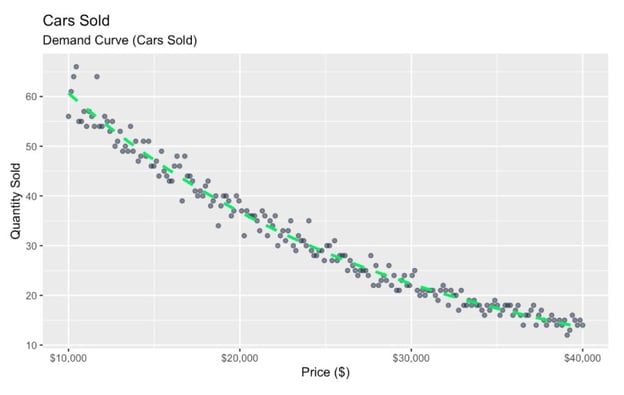 Vraagcurve met ruis. Afbeelding door de auteur
Hier heb ik de relatie tussen prijs en verkochte hoeveelheid gevisualiseerd, en met spreidingspunten de natuurlijke variatie weergegeven, die veel oorzaken kan hebben.
Als we deze grafiek lezen, zien we dat naarmate de prijs stijgt, de verkoop daalt, en dat deze relatie in sommige prijsranges gevoeliger is dan in andere. Maar afhankelijk van wat je met de data wilt doen, is dit algemene inzicht misschien niet genoeg voor een praktische bedrijfsbeslissing. Uit mijn ervaring willen bazen vaak een normatief inzicht dat een concreet antwoord geeft op een dringende vraag. Zo’n vraag is: Wat is de autoprijs die de totale omzet daadwerkelijk maximaliseert?
We zouden kunnen beginnen met wat gokjes te maken door naar de grafiek te kijken.
- Aan de onderkant zien we, langs de groene lijn, dat de verkochte hoeveelheid 60 is waar de x-waarde voor prijs $10.000 is. Dit vertaalt zich naar $600.000 aan totale omzet.
- Aan de bovenkant raakt de groene lijn ongeveer 10 waar de x-waarden $40.000 zijn, wat neerkomt op $400.000 omzet.
- Precies in het midden raakt de groene lijn 30 bij een prijs van $25.000. Dit is gelijk aan $750.000.
Je krijgt nu misschien het gevoel dat de prijs die de totale omzet maximaliseert ergens in het midden ligt. Conceptueel klopt dat: we verwachten dat superlage prijzen een hoog verkoopvolume opleveren maar relatief weinig omzet, terwijl superhoge prijzen veel minder verkoop en ook relatief weinig omzet opleveren. Maar ergens in het midden moet er een optimale prijs zijn die de omzet maximaliseert.
In plaats van de grafiek te schatten met het blote oog, leren we nu een betere, efficiëntere en solide manier om de totale omzet te maximaliseren. We kunnen de optimale prijs vinden door een eenvoudig optimalisatieprobleem op te lossen. We maken eerst een lineair model, buigen dat vervolgens om tot een parabool en vinden het hoogste punt.
Onze eerste stap is de relatie lineariseren. Omdat ik dit alles met een exponentiële-vervalfunctie heb geconstrueerd, weet ik dat lineariseren goed werkt door het logaritme van de verkochte hoeveelheid te nemen. Voor de eenvoud negeren we eventuele heteroscedasticiteit.
# Create a linearized version of the data
demand_curve_data$log_quantity_sold <- log(demand_curve_data$quantity_sold)
# Plot the linearized relationship
ggplot(demand_curve_data, aes(x = price, y = log_quantity_sold)) +
geom_point(color = '#203147', alpha = 0.6) +
geom_smooth(method = "lm", color = '#01ef63', se = FALSE) +
labs(
title = "Cars Sold",
subtitle = "Demand Curve (Log Quantity Sold)",
x = "Price ($)",
y = "Log of Quantity Sold"
) +
scale_x_continuous(labels = scales::dollar_format()) # Format x-axis as dollars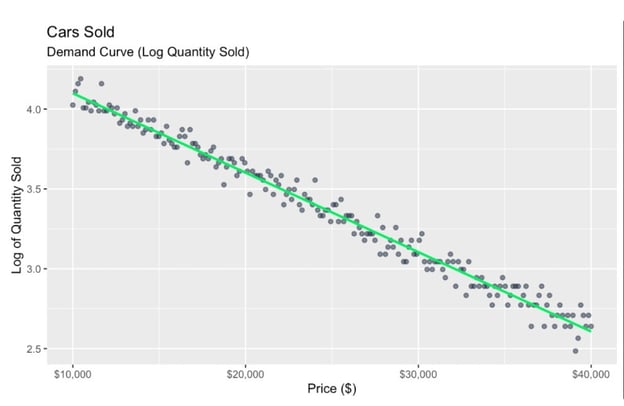
Getransformeerde vraagcurve. Afbeelding door de auteur
Nu kunnen we een nieuwe variabele revenue maken die is gedefinieerd als price maal log_quantity_sold. Ter info: we maken een lineair modelobject met de functie lm() omdat we toegang willen tot de getallen die horen bij de modelcoëfficiënten.
Voor de volgende stap vullen we onze lineaire modelvergelijking in onze formule in. Als we geen logtransformatie hadden gehad:
-
Dan zou onze vergelijking:
revenue = price * quantity_soldnu geschreven kunnen worden alsrevenue = price * (b0 + b1 * price). -
Vervolgens zouden we termen distributeren. Net zoals je termen in x(1-x) distribueert tot x - x2, herschrijven we onze vergelijking als
revenue = b0 * Price + b1 * price2.
Merk op dat we nu revenue krijgen als vergelijking met price als een kwadraatterm. Dit is de kern, want door price als kwadraatterm te modelleren, hebben we een maximerende functie gecreëerd.
Maar omdat we wél een logtransformatie hebben, moeten we een exponentiële terugtransformatie van het log-lineaire model doen.
-
Dit betekent dat onze vergelijking:
revenue = price * log_quantity_soldnu wordt geschreven alsrevenue = price * eb0 + b1 * price. -
We kunnen deze vergelijking desgewenst herschrijven naar een nieuwe vorm:
revenue=price * eb0 * eb1⋅price. Maar deze vergelijking distribueert niet op dezelfde manier als een lineaire of polynomiale vergelijking, omdat de exponentiële functie termen niet laat scheiden of distribueren zoals de meer standaard algebraïsche termen hierboven.
Hoe dan ook, laten we doorgaan:
# Fit a linear model to the log-transformed quantity sold
model <- lm(log_quantity_sold ~ price, data = demand_curve_data)
# Create a revenue model based on the linear model coefficients
revenue_model_data <- demand_curve_data %>%
mutate(
revenue_model = price * exp(coef(model)[1] + coef(model)[2] * price) # Modeled revenue
)
# Plot the revenue model
ggplot(revenue_model_data, aes(x = price, y = revenue_model)) +
geom_point(color = '#203147', alpha = 0.6) + # Actual revenue points
geom_line(color = '#01ef63', size = 1.2) + # Revenue model line
labs(
title = "Car Sales",
subtitle = "Revenue Model",
x = "Price ($)",
y = "Revenue ($)"
) +
scale_y_continuous(labels = scales::dollar_format()) + # Format y-axis as dollars
theme_minimal() + # Apply a minimal theme for aesthetics
theme(
text = element_text(family = "Arial", size = 12),
plot.title = element_text(face = "bold", size = 16),
plot.subtitle = element_text(size = 14)
)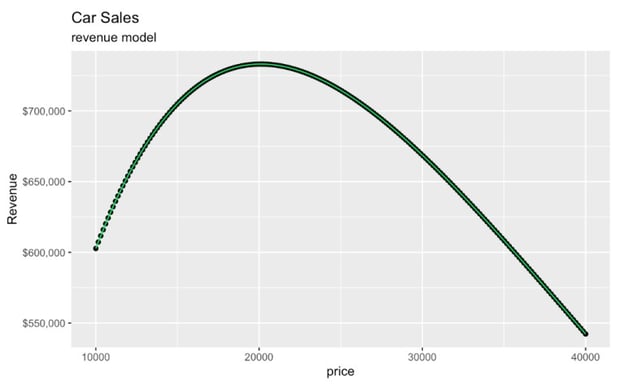
Omzetmodel gemaakt vanuit een vraagcurve. Afbeelding door de auteur.
Interessant is dat, hoewel het oorspronkelijke model log_quantity_sold gebruikte, de grafiek die we hebben gemaakt volledig in de oorspronkelijke schalen van price en revenue staat. De logtransformatie beïnvloedt alleen het onderliggende model, en onze terugtransformatie met e zet de grafiek terug op de oorspronkelijke schaal, zodat hij makkelijk te interpreteren blijft.
Zoeken waar de afgeleide nul is
Ons laatste kernpunt is dit: de plek bovenaan de parabool, waar de afgeleide nul is, wordt de theoretische prijs die de omzet maximaliseert.
We herinneren ons misschien dat we de afgeleide van een vergelijking zoals 3x² + 2x vinden door met de exponenten te vermenigvuldigen tot 6x + 2. Ditzelfde principe geldt, maar onthoud weer: in dit voorbeeld moeten we eerst onze gelogde waarden terugtransformeren voordat we de omzetfunctie vormen. Door terug te gaan naar de oorspronkelijke schaal vóór het vinden van het omzetmaximum, weten we dat we de prijs vinden die de daadwerkelijke omzet maximaliseert, niet een getransformeerde maat. Dit is dus de juiste omzetfunctie om te differentiëren: revenue = price * e(b0 + b1 * price).
Laten we het uitwerken. Ik neem de lineaire modelcoëfficiënten, definieer dan een omzetfunctie. Tot slot bereken ik de optimale prijs en de bijbehorende verwachte totale omzet.
# Model coefficients
b0 <- 4.596 # Intercept
b1 <- -4.974e-05 # Slope for price
# Define the revenue function
revenue <- function(P, b0, b1) {
P * exp(b0 + b1 * P)
}
# Calculate the optimal price (analytical solution from dR/dP = 0) - shortcut code here
(optimal_price <- -1 / b1)
# Calculate maximum revenue
(max_revenue <- revenue(optimal_price, b0, b1))[1] 20104.54
[1] 732853.5Je hebt misschien gemerkt dat één regel code voor de optimale prijs niet goed in de context werd uitgelegd. Ik bedoel dit deel: (optimal_price <- -1 / b1). Laat me kort laten zien hoe ik ontdekte dat de optimale prijs -1 gedeeld door de helling is.
Eerst moeten we de productregel uit de analyse herinneren, die stelt dat als de functie van x, f(x), gelijk is aan u(x) maal v(x), dan is de afgeleide, f'(x), gelijk aan de afgeleide van het eerste deel maal het tweede deel, plus het eerste deel maal de afgeleide van het tweede deel.
# the product rule in calculus
f(x) = u(x) * v(x)
f'(x) = u'(x) * v(x) + u(x) * v'(x)Hier is onze vergelijking opnieuw, samen met de afgeleide:
# our equation:
revenue = price * e^(b0 + b1 * price)
# the derivative of our equation
derivative = 1 * e^(b0 + b1 * price) + price * b1 * e^(b0 + b1 * price)Ik weet dat de afgeleide van prijs hier 1 is, omdat dat hetgene is waarvan we de afgeleide nemen. “Hoeveel verandert prijs als prijs verandert?” Dat is een één-op-éénrelatie.
Aan de andere kant is de afgeleide van e(b0 + b1 * price) niet zo netjes als een simpele functie zoals 2x2, waarvan de afgeleide 4x is.
In de uitdrukking waarmee we hier werken, is de exponent een polynoom. De truc is om goed naar alle termen te kijken: Om te beginnen
-
b0is slechts één waarde, dus de afgeleide daarvan is nul -
priceis 1, zoals we al hadden vastgesteld. -
b1is de schaalfactor, dus die zetten we ervoor; volgens de regel laten we de polynomiale exponent verder gelijk.
Dus de afgeleide van e(b0 + b1 * price) is b1 * e(b0 + b1 * price). Dit staat bekend als de kettingregel, zoals ik hier laat zien:
# the chain rule in calculus
f(x) = x^g(x)
f'(x) = g'(x) * x^g(x)Het laatste is wat factoriseren.
De algebra vertelt ons dat dit hetzelfde is:
A + B * A = A(1+B)En als ik goed naar de afgeleide kijk waarmee ik werk, zie ik een A- en een B-deel:
De “A” is e(b0 + b1 * price) en de “B” is price * b1. Dus ik kan dit factoriseren
e^(b0 + b1 * price) + price * b1 * e^(b0 + b1 * price)naar dit:
e^(b0 + b1 * price)(1 + price * b1)Tot slot moet ik deze afgeleide gelijk aan nul zetten om de plek te vinden waar de helling ophoudt met stijgen en begint te dalen: de top van de parabool.
e^(b0 + b1 * price)(1 + price * b1) = 0Als laatste truc weet ik dat wanneer A * B nul is, ofwel A ofwel B (of beide) nul moet zijn. Maar toevallig weet ik dat e(b0 + b1 * price) nooit nul kan zijn, omdat het een exponentiële functie is. Als de exponent positief is, is de uitkomst groot; als de exponent 0 is, is de uitkomst 1; en als de exponent negatief is, is de uitkomst een kleine breuk. Dus dat deel kan ik negeren bij het oplossen.
Het enige wat ik nu nog hoef te doen, is herschikken en oplossen voor price.
(1 + b1 * price) = 0
b1 * price = -1
price = - 1 / b1Zo vond ik -1 / b1 voor onze op maat gemaakte R-functie.
Om de draad weer op te pakken: we kunnen de optimale prijs intekenen en de bijbehorende omzet bekijken.
De optimale prijs is $20.104,54, wat een verwachte totale omzet van $732.853,50 oplevert, plus of min. Ik zeg ‘plus of min’ omdat we, als je het narekent, uitgaan van 36,45 verkochte auto’s, en je geen halve auto kunt verkopen.
ggplot(revenue_model_data, aes(x = price, y = revenue_model)) +
geom_point() + geom_line(color = '#01ef63') +
ggtitle("Car Sales") + labs(subtitle = "revenue model") +
ylab("Revenue") +
scale_y_continuous(labels = scales::dollar_format()) +
geom_vline(xintercept = optimal_price, linetype = "dashed", color = '#203147') +
geom_point(aes(x = optimal_price, y = max_revenue), color = '#203147', size = 3) 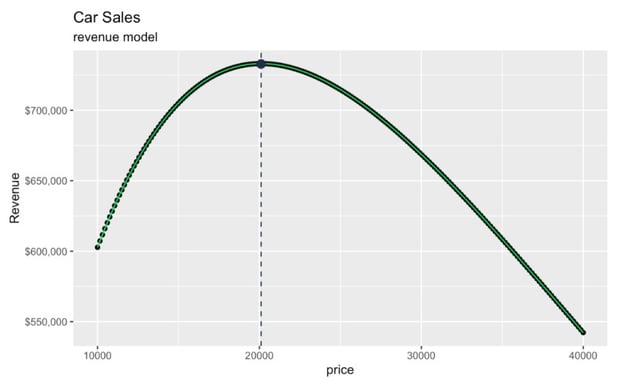 De prijs vinden die de omzet maximaliseert. Afbeelding door de auteur.
In een andere workflow kunnen we deze ideeën zelfs uitbreiden naar winst in plaats van omzet. Ik werk het hier niet helemaal uit, maar weet dat je dan profit = revenue - cost zou kunnen nemen, waarbij cost wordt gezien als quantity * unit cost. Als de stukprijs constant is en quantity kan worden vervangen door een uitdrukking zoals 1 - price, krijgen we opnieuw een omgekeerde parabool.
Wil je meer leren over hoe calculus en afgeleiden een rol spelen in machine learning, probeer dan onze cursus Introduction to Deep Learning with PyTorch, die gradient descent in detail verkent in de context van hyperparametertuning. De context is anders, maar je kunt vergelijkbaar denken toepassen. Optimalisatie, in zijn verschillende vormen, is – zoals je ziet – een kernvaardigheid in data science, en oefening helpt.
Vraagcurve vs. Laffer-curve
Als je economie hebt gestudeerd, herken je deze parabool misschien als iets dat lijkt op de Laffer-curve, een enigszins controversieel concept dat illustreert hoe belastingtarieven de belastinginkomsten van de overheid beïnvloeden.
Hoewel ik zowel de Laffer-curve als deze transformatie op de vraagcurve zou rekenen tot “maximaliseren vs. tarief”-problemen, is de Laffer-curve specifiek voor belastingheffing: de x-as staat voor het belastingtarief (0% tot 100%) en de y-as voor de totale geïnde belastinginkomsten. Conceptueel is de Laffer-curve ook U-vormig omgekeerd, omdat we aan de hoge kant veronderstellen dat, als het tarief te hoog is, dit geen inkomsten oplevert: er is dan geen prikkel meer voor individuen of bedrijven om belastbare activiteiten te ontplooien. Economen zijn het mogelijk oneens over dat ‘prikkel’-deel.
De Laffer-curve in Ferris Bueller's Day Off. Bron: YouTube
Een vraagcurve gebruiken om prijzen te analyseren in SQL
Nu we het idee hebben doorgenomen, wil ik ook een SQL-script delen dat hetzelfde werk doet. Deze functie voert een regressie uit van quantity_sold tegen price. Vervolgens kun je de optimale prijs vinden om de omzet te maximaliseren op basis van de regressiecoëfficiënten, en de overeenkomstige maximale omzet bepalen.
Ik denk dat het volgende script vooral nuttig is bij het maken van dynamische dashboards in Power BI of Tableau, omdat je realtime data-updates krijgt zonder dat er iets offline hoeft.
Je ziet ook dat ik een handmatige aanpak heb gebruikt om de regressiecoëfficiënten te vinden met SQL-aggregatiefuncties, omdat de meeste SQL-dialecten geen gespecialiseerde regressiefuncties hebben. Je zult misschien verbaasd zijn dat eenvoudige lineaire regressie prima werkt in SQL, omdat de modelcoëfficiënten voor simple linear regression kunnen worden uitgedrukt in termen van de correlatie, standaarddeviatie en gemiddelden van x en y.
-- SQL script to perform linear regression on log(quantity_sold) vs price,
-- calculate the optimal price to maximize revenue, and determine the maximum revenue.
WITH regression_data AS (
SELECT
COUNT(*) AS N,
SUM(price) AS sum_x,
SUM(LOG(quantity_sold)) AS sum_y,
SUM(price * LOG(quantity_sold)) AS sum_xy,
SUM(price * price) AS sum_x2,
SUM(LOG(quantity_sold) * LOG(quantity_sold)) AS sum_y2
FROM sales_data
),
regression_coefficients AS (
SELECT
N,
sum_x,
sum_y,
sum_xy,
sum_x2,
sum_y2,
(N * sum_xy - sum_x * sum_y) / (N * sum_x2 - sum_x * sum_x) AS slope,
(sum_y - ((N * sum_xy - sum_x * sum_y) / (N * sum_x2 - sum_x * sum_x)) * sum_x) / N AS intercept
FROM regression_data
),
optimal_price AS (
SELECT
slope,
intercept,
(-1 / slope) AS optimal_P
FROM regression_coefficients
),
max_revenue AS (
SELECT
optimal_P,
slope,
intercept,
optimal_P * EXP(intercept + slope * optimal_P) AS max_R
FROM optimal_price
)
SELECT
optimal_P AS Optimal_Price,
max_R AS Maximum_Revenue
FROM max_revenue;Optimal_Price | Maximum_Revenue
------------- | ----------------
20104.32 | 402082.58Houd er rekening mee dat het SQL-script mogelijk aanpassingen vereist afhankelijk van het gebruikte SQL-dialect, omdat de syntaxis kan verschillen. Controleer voor troubleshooting ook of je verkoopdatatabel geldige en positieve waarden bevat voor zowel price als quantity_sold, aangezien negatieve of nulwaarden tot fouten kunnen leiden.
Als je een logtransformatie wilt opnemen, zoals we in het R-gedeelte deden, kan dat, maar afhankelijk van je dialect kan de natuurlijke logaritmefunctie anders heten, LN of LOG. In DuckDB zijn LN en LOG daadwerkelijk verschillend: LN is de natuurlijke logaritme e, terwijl LOG basis 10 is. Als je geïnteresseerd bent in het maken van een vraagcurve om de relatie tussen prijs en verkoop in SQL te analyseren, kijk dan mijn Analyzing Product Demand in SQL code-along. Tot slot zou ik zeggen: om je SQL-vaardigheden als analist te versterken, verken de Associate Data Analyst in SQL career track, zodat je een complete toolset ontwikkelt.
Uitzonderingen op de vraagcurve
Er zijn opvallende uitzonderingen waarbij consumentengedrag kan afwijken van het standaardpatroon van de vraagcurve:
Giffen-goederen
Giffen-goederen zijn een zeldzaam type inferieure goederen waarvoor de wet van de vraag niet opgaat. Wanneer de prijs van een Giffen-goed stijgt, kunnen consumenten er paradoxaal genoeg meer van kopen in plaats van minder. Dit gebeurt omdat het goed zo’n groot deel van het budget van een consument uitmaakt dat, wanneer de prijs stijgt, de consument zich geen wenselijker substituten meer kan veroorloven en gedwongen wordt nog meer van het Giffen-goed te kopen. Een klassiek (zij het omstreden) historisch voorbeeld is de stijging van de broodprijzen in de 19e eeuw op sommige plekken (mogelijk Engeland), waarbij mensen meer brood gingen consumeren omdat ze zich andere, duurdere voedingsmiddelen niet konden veroorloven.
Veblen-goederen
Veblen-goederen zijn luxe- of statussymbolen—zoals designerhandtassen, goede wijnen of high-end horloges—waarvan de vraag toeneemt naarmate de prijs stijgt. Een deel van de aantrekkingskracht komt voort uit de perceptie dat een hogere prijs exclusiviteit of hogere sociale status signaleert, waardoor het goed aantrekkelijker wordt naarmate het duurder wordt. Je kunt dit zien als “conspicuous consumption”.
Andere bijzondere gevallen
- Bandwagon- of netwerkeffecten: Sommige goederen worden voor elke gebruiker waardevoller naarmate meer mensen ze gebruiken (bijv. socialmediaplatforms, bepaalde software-ecosystemen). De vraag kan stijgen, niet alleen vanwege de prijs, maar door de groeiende populariteit of netwerkgrootte.
- Snobeffect: Sommige consumenten kopen goederen juist omdat weinig anderen ze hebben. In zulke gevallen kunnen lagere prijzen het goed “minder exclusief” doen lijken, waardoor de aantrekkingskracht afneemt.
- Speculatieve of beleggingsactiva: Bij activa zoals bepaalde crypto’s of grondstoffen kan, als de markt gelooft dat prijzen blijven stijgen, de vraag juist toenemen als reactie op prijsstijgingen, in plaats van dalen.
In al deze voorbeelden keert de gebruikelijke prijs–hoeveelheidsrelatie om of wordt complexer door psychologische, culturele of situationele factoren die de klassieke aanname overstijgen dat consumenten simpelweg “meer willen bij lagere prijzen.”
Veelvoorkomende termen rond de vraagcurve
We hebben in dit artikel een paar verschillende termen behandeld. Laten we een tabel maken om het overzichtelijk te houden.
| Begrip | Beschrijving |
|---|---|
| Vraagcurve | Een grafische weergave van de relatie tussen de prijs van een goed en de hoeveelheid waarnaar consumenten vragen. |
| Wet van de vraag | Stelt dat, ceteris paribus, wanneer de prijs van een product daalt, de gevraagde hoeveelheid toeneemt. |
| Prijs-hoeveelheidsrelatie | Geeft aan dat de prijs van een product rechtstreeks de hoeveelheid beïnvloedt die consumenten willen kopen. |
| Elasticiteit | Meet hoe gevoelig de gevraagde hoeveelheid is voor een prijsverandering. |
| Afnemend grensnut | Verwijst naar de afname van tevredenheid of nut bij het consumeren van extra eenheden van een product. |
Tot slot
We hebben veel behandeld: van vraagcurven en vraagmodellen, tot log- en exponentiële transformaties, tot kwadratische regressietechnieken en optimalisatie.
Blijf businessanalyse leren met DataCamp. Overweeg om je in te schrijven voor cursussen zoals die ik eerder noemde: Forecasting Product Demand in R en Data-Driven Decision Making for Business, die je leren hoe je data inzet om betere beslissingen te nemen in business en finance. Er gaat niets boven wat technische vaardigheden en de juiste technieken kennen.
Oefen ook de kern van data science. Volg naast de kerncursussen over regressie (Introduction to Regression with statsmodels in Python en Introduction to Regression in R) ook Nonlinear Modeling with Generalized Additive Models (GAMs) in R of Statistics Fundamentals in Python. Ik raad ook onze volledige Machine Learning Scientist in Python career track aan. Kies waar je het zwakst in bent, zodat je het meest leert.

Auteur
Josef Waples
Ik ben een schrijver en editor op het gebied van data science en heb bijgedragen aan onderzoeksartikelen in wetenschappelijke tijdschriften. Ik ben vooral geïnteresseerd in lineaire algebra, statistiek, R en dergelijke. Ik speel ook best wat schaak!


De vraagcurve is een van de meest interessante en nuttige hulpmiddelen om consumentengedrag en prijsstrategieën te begrijpen. Hij wordt vaak gebruikt om de relatie tussen de prijs van een goed of dienst en de verkochte hoeveelheid te analyseren, maar kan in andere contexten ook worden ingezet om marktdynamiek te bestuderen of omzet te voorspellen.
In dit artikel leer je alles over de vraagcurve. We verkennen zowel de bepalende kenmerken als verwante termen. Later laat ik ook zien hoe je de vraagcurve kunt uitbreiden om de optimale prijs te vinden die de winst maximaliseert – een handige toepassing van elementaire algebra voor een eenvoudig optimalisatieprocedé dat ik in mijn eigen werk nuttig vond.
Als je deze methoden volgt, kun je niet alleen beslissingen nemen over prijsstrategieën, maar kun je de aanpak ook helder onderbouwen als raamwerk voor toekomstige projecten. Ik gebruik in dit artikel R en SQL, maar je kunt dezelfde methoden toepassen met andere veelgebruikte tools, zoals Excel, Python, Tableau en Power BI. Tot slot: wil je echt een prijsexpert worden, dan raad ik onze cursus Forecasting Product Demand in R van harte aan.
Wat is een vraagcurve?
Een vraagcurve is een fundamenteel begrip in prijsstrategie en economie in het algemeen. Het is een krachtige visuele manier om de relatie weer te geven tussen de prijs van een goed of dienst en de hoeveelheid waarnaar consumenten vragen. De belangrijkste onderdelen van een vraagcurve zijn de prijs op de ene as en de gevraagde hoeveelheid op de andere. Hier is een voorbeeld:
Een basisvorm van een vraagcurve. Afbeelding door de auteur.
Onderdelen van een vraagcurve
In de bovenstaande grafiek zie je iets wat op het eerste gezicht vrij voor de hand ligt: prijs en verkochte hoeveelheid hebben een omgekeerde relatie. Formeler gezegd sluit de vraagcurve nauw aan bij wat bekendstaat als de wet van de vraag, die stelt dat, ceteris paribus, wanneer de prijs van een product daalt, de gevraagde hoeveelheid toeneemt. Soms wordt ditzelfde idee aangeduid als een prijs-hoeveelheidsrelatie, wat betekent dat de prijs van een product rechtstreeks beïnvloedt hoeveel consumenten willen kopen.
Toch bevat deze specifieke grafiek ook iets minder voor de hand liggends: de verkochte hoeveelheid daalt veel scherper bij lage prijzen en vlakt af bij hoge prijzen. Deze kromming hangt samen met andere concepten, zoals veranderende elasticiteit en afnemend grensnut, waar ik in de volgende sectie op inga.
Prijselasticiteit van de vraag
Een centraal begrip dat voortkomt uit de omgekeerde relatie tussen prijs en gevraagde hoeveelheid is de prijselasticiteit van de vraag, die meet hoe gevoelig de gevraagde hoeveelheid is voor een prijsverandering. Formeel wordt elasticiteit vaak berekend als:
Een product heeft elastische vraag als een relatief kleine prijsverandering leidt tot een grote verandering in de gevraagde hoeveelheid. High-end elektronica of designerhandtassen kunnen een scherpe vraagdaling zien als de prijs zelfs maar een beetje stijgt, omdat consumenten substituten kunnen vinden.
Een product heeft inelastische vraag als grote prijsveranderingen leiden tot relatief kleine veranderingen in de gevraagde hoeveelheid. Noodzakelijke goederen zoals benzine of medicijnen zijn klassieke voorbeelden. Zelfs als de prijs stijgt, blijven consumenten bijna evenveel kopen omdat er geen alternatieven zijn.
Typen vraagcurven
Hoewel ik één voorbeeld van een vraagcurve heb laten zien, kan hij veel verschillende vormen aannemen, afhankelijk van de onderliggende kenmerken van de markt, het product en de voorkeuren van consumenten. Hoewel de curve altijd neerwaarts helt, hoeft die relatie geen enkele vaste wiskundige vorm te volgen.
Lineaire vraagcurven
Lineaire vraagcurven hebben een constante verandering tussen prijs en hoeveelheid. Deze komen vaak voor in eenvoudige marktscenario’s. Ze worden weergegeven door een rechte lijn.
Niet-lineaire vraagcurven
Zoals we zagen, worden vraagcurven niet altijd als perfecte rechte lijnen getekend, omdat de relatie tussen prijs en hoeveelheid niet altijd goed wordt weergegeven door een eenvoudige één-op-één lineaire functie. Daar zijn verschillende redenen voor, waar ik eerder al aan refereerde:
In de praktijk zijn niet-lineaire vraagcurven vaak realistischer omdat ze een variabele verandering beter weergeven. Echtemarktcijfers zijn immers rommelig en consumentengedrag is complex. Dat gezegd hebbende, zijn er vaak manieren om een niet-lineaire curve te lineariseren, zoals ik later laat zien.
Individuele vraagcurve vs. marktvraagcurve
We kunnen ook verschillen in vraag op consument- en marktniveau vergelijken. Een individuele vraagcurve geeft de relatie weer tussen de prijs van een product en de gevraagde hoeveelheid door één consument. Deze weerspiegelt persoonlijke voorkeuren en betalingsbereidheid.
Een marktvraagcurve combineert de vraag van alle consumenten in een markt. Ze aggregeert individuele vraagcurven en toont de totale gevraagde hoeveelheid bij elke prijs. Vanwege de manier waarop ze zijn opgebouwd, worden marktvraagcurven door bedrijven gebruikt om het marktpotentieel te peilen.
Vraagcurve vs. aanbodcurve
Als je vraagcurven bestudeert, heb je waarschijnlijk ook gehoord van de aanbodcurve. In wezen zijn een aanbodcurve en een vraagcurve twee kanten van dezelfde medaille. Terwijl de vraagcurve laat zien hoeveel van een product consumenten willen kopen bij verschillende prijzen, geeft de aanbodcurve weer hoeveel producenten willen verkopen bij diezelfde prijzen.
Als je nu zowel een vraagcurve als een aanbodcurve in dezelfde grafiek zet, zie je een punt waar ze elkaar kruisen. Het snijpunt, het evenwichtspunt, bepaalt naar men aanneemt de marktprijs en -hoeveelheid. Dus wanneer de vraag het aanbod overtreft, neigen prijzen te stijgen, wat producenten stimuleert om meer te produceren. Maar als het aanbod de vraag overstijgt, dalen prijzen, wat extra vraag aanwakkert.
Vraagcurve vs. aanbodcurve. Afbeelding door de auteur.
Een vraagcurve gebruiken in data science
Er zijn veel manieren om vraagcurven te gebruiken voor zakelijke beslissingen. Hier neem ik je mee door één specifieke aanpak: we gebruiken onze data om zowel een vraagcurve als een vraagmodel te maken met een kwadratische regressietechniek. Ik laat zien hoe je deze techniek in zowel R als SQL toepast, zodat je hem kunt gebruiken in interactieve dashboards in Power BI of Tableau.
Voordat ik verder ga: als je dit leest en denkt dat je een heel team tegelijk wilt upskillen, bijvoorbeeld een team of afdeling van business-analisten of data scientists, dan is DataCamp for Business er om te helpen. We helpen je team vaardigheden en technieken op te bouwen die nuttig zijn in jullie specifieke bedrijfscontext. Zware data-analyseprojecten vereisen vaak meerdere bijdragers – neem dus contact op met ons DataCamp-team om meer te leren.