{count, plural, one {Leerpad} other {Leerpaden}}
AI voor softwareontwikkeling
{hours} uur
Anthropic heeft Claude Opus 4.7 uitgebracht, de nieuwste iteratie van zijn vlaggenschipmodel. De belangrijkste verbetering is autonomie: Anthropic presenteert dit als het model waaraan je je zwaarste, langstlopende codeer- en agentwerk kunt overlaten zonder nauw toezicht.
In deze release leren we ook dat er een plafond boven Opus 4.7 zit. Anthropics interne Mythos Preview scoort hoger op verschillende benchmarks, maar wordt tegengehouden voor brede release terwijl Anthropic cybersafeguards test. Voor iedereen die geen interne onderzoeker bij Anthropic is, is Opus 4.7 het huidige plafond.
In dit artikel lopen we door wat er nu daadwerkelijk nieuw is in Opus 4.7, duiken we in de benchmarkresultaten en delen we hands-ontests die je zelf kunt uitvoeren. Je kunt ook onze gidsen bekijken van recent gepubliceerde concurrenten, zoals Meta’s Muse Spark, OpenAI's GPT-5.5, en Google's Gemini 3.1.
Update: Op 28 mei 2026 bracht Anthropic het opvolgermodel uit. Lees er alles over in onze gids Claude Opus 4.8.
Claude Opus 4.7 is Anthropics nieuwste vlaggenschip-large language model, bovenaan de Claude-familie boven Sonnet en Haiku. Het volgt Claude Opus 4.6 op en is ontworpen voor de meest veeleisende taken, zoals complexe agentworkflows en redeneertaken in meerdere stappen die tijdens lange sessies consistente prestaties vragen.
Vergeleken met Opus 4.6 richt de 4.7-release zich op drie gebieden:
Anthropics interne Mythos Preview, die we eerder noemden en waar we ook een FAQ over hebben, leidt op verschillende benchmarks, maar is niet breed beschikbaar. Opus 4.7 is in wezen een zustermodel dat is getraind met opzettelijk ingeperkte cybersecuritymogelijkheden.
Anthropic meldde dat verschillende capaciteitsgebieden merkbare verbeteringen hebben laten zien in Opus 4.7.
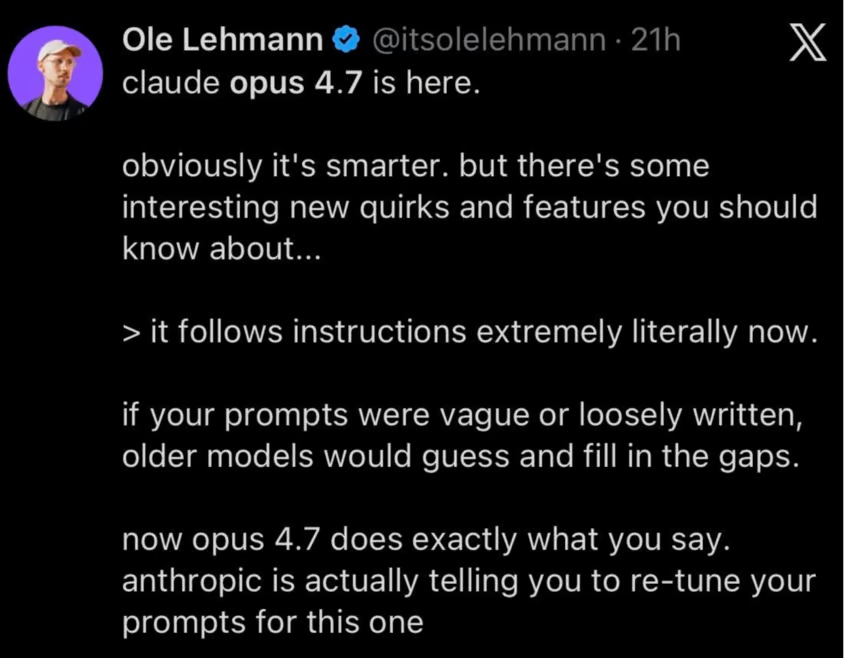
Opus 4.7 volgt instructies nauwkeuriger dan eerdere modellen. Dat is natuurlijk handig voor elke workflow die afhankelijk is van betrouwbaarheid, maar kan ook onbedoelde gevolgen hebben: Anthropic raadt gebruikers aan hun prompts en harnassen opnieuw af te stemmen, omdat instructies die eerdere modellen oversloegen of losjes interpreteerden nu letterlijk worden genomen.
De visie voor hoge resolutie is verbeterd om beelden tot 3,75 megapixel te ondersteunen, meer dan drie keer zoveel als oudere modellen accepteerden. Computer-use agents en data-extractieworkflows kunnen sterk profiteren van deze toegenomen detailgranulariteit, omdat ze afhankelijk zijn van leesbaarheid en nauwkeurigheid, soms tot op pixelniveau.
Opus 4.7 is beter in op het bestandssysteem gebaseerd geheugen, wat verwijst naar een patroon waarbij het model tijdens het werk notities naar bestanden schrijft en deze bij volgende runs terugleest.
Claude Code is de meest voor de hand liggende setting hiervoor: een CLAUDE.md-bestand in de hoofdmap van een project dat Claude leest wanneer een sessie start, bijwerkt naarmate er beslissingen worden genomen, en gebruikt wanneer je terug aan het werk gaat.
"Beter" betekent hier: beter oordeel over wat het waard is om op te schrijven en betrouwbaardere herinnering in latere beurten. Anthropic zegt dat dit ervoor zorgt dat nieuwe taken "minder context vooraf nodig hebben" — wat je zult waarderen als je ooit voor de vijfde keer je projectconventies aan een model hebt uitgelegd, zoals wij.
Dus, de echte bottom line: als je Opus 4.7 gebruikt voor werk over meerdere sessies, laat het dan notities bijhouden. Het doet dat beter dan Opus 4.6 deed, hoewel we vonden dat Opus 4.6 al best goede notities bijhield.
Anthropic vertelt ons dat Claude Opus 4.7 aanzienlijke verbeteringen heeft geboekt op deze gebieden.
We hebben enkele eigen tests gemaakt om hun claims te prikken.
Om het opvolgen van instructies door Opus 4.7 te testen, gebruikten we de volgende gedetailleerde prompt om het te stress-testen. Het bevat 12 afzonderlijke beperkingen die we achteraf kunnen checken.
You are writing a short briefing document for a new employee at a mid-sized accounting firm. Follow every instruction below.
Write a briefing about the firm's approach to client onboarding. The briefing must meet all of the following requirements:

The briefing must be exactly 4 paragraphs long.
-The second paragraph must begin with the word "Historically".
-Each paragraph must contain between 3 and 5 sentences. No paragraph may have fewer than 3 or more than 5.
-Do not use the words "streamline", "leverage", "robust", or "synergy" anywhere in the document.
-Include exactly two direct quotes from fictional senior partners. Attribute each quote to a named partner. Do not include any other quoted material.
-One of the partners quoted must have a surname that starts with the letter M.
-End the document with a single-sentence closing line on its own, separated from the fourth paragraph by a blank line. This closing line does not count toward the 4-paragraph requirement.
-The closing line must be a question.
-Use British English spelling throughout (e.g., "organisation", "colour", "realise").
-Do not use any bullet points, numbered lists, or headings.
-Mention a specific fictional client name exactly once, and italicise it using markdown asterisks.
-The total word count of the briefing, including the closing line, must be between 280 and 320 words. Do not include any preamble, explanation, or commentary before or after the briefing. Output only the briefing itself.
En hier is het resultaat:
Welcome to Harding & Whitcombe, where client onboarding is treated as the foundation of every successful long-term engagement. Our approach centres on understanding the organisation behind the numbers before any technical work begins, which means the first two weeks are devoted almost entirely to listening. New clients are assigned a dedicated onboarding lead who coordinates introductions across tax, audit, and advisory teams. This structure ensures that every colleague touching the account shares a consistent understanding of the client's priorities and sensitivities.

Historically, the firm operated a more transactional model, with onboarding handled piecemeal by whichever partner had signed the engagement letter. That changed in 2014, when senior leadership recognised that our competitors were winning work on relationships rather than fees alone. As Helena Marchbanks, our managing partner, often reminds new hires, "A client who feels understood in week one rarely questions the invoice in month six." The revised approach has measurably improved retention and referral rates across every service line.

In practical terms, you will be expected to attend the initial discovery meeting for any client you support, even in a purely observational capacity. You should familiarise yourself with the client's sector, recent filings, and any public commentary from their leadership before that first conversation. When we onboarded Thornbury Mills Ltd last spring, the junior associate who had read three years of their annual reports was the one who spotted the inventory anomaly that shaped our entire advisory brief. Preparation of that depth is the standard we expect, not the exception.

You will also notice that we emphasise candour from the outset, particularly around scope and realistic timelines. "We would rather lose a pitch than promise something we cannot deliver," says Rupert Castellane, head of our advisory practice, and that philosophy colours every onboarding conversation. Take the time to ask questions, observe the senior partners in action, and recognise that trust accumulates slowly but pays compounding dividends.

Are you ready to meet your first client?
Tijd om te scoren. Ik deel onze rubric:
|
# |
Voorwaarde |
Hoe te controleren |
|
1 |
Exact 4 alinea’s (plus afsluitende zin) |
Alinea-afbrekingen tellen |
|
2 |
Alinea 2 begint met "Historically" |
Kijk naar het eerste woord |
|
3 |
Elke alinea heeft 3–5 zinnen |
Zinnen per alinea tellen |
|
4 |
Geen verboden woorden |
Ctrl+F voor elk |
|
5 |
Precies 2 citaten, beide met naamsvermelding, geen ander geciteerd materiaal |
Aanhalingstekens tellen |
|
6 |
De achternaam van één partner begint met een M |
Attributies controleren |
|
7 |
Afsluitende zin gescheiden door een lege regel |
Visuele check |
|
8 |
Afsluitende zin is een vraag |
Eindigt op "?" |
|
9 |
Britse spelling |
Ctrl+F voor "organization", "color", "realize", enz. |
|
10 |
Geen opsommingstekens, nummers, koppen |
Visuele check |
|
11 |
Fictieve cliënt één keer genoemd, cursief |
Ctrl+F voor asterisken |
|
12 |
Woordaantal 280–320 |
Plakken in word counter |
We besparen je de moeite om het helemaal door te nemen. Het model scoorde 11/12.
Het deed het perfect, maar ging uiteindelijk net over het woordaantal heen (325 woorden, met een limiet van 320 woorden).
We hebben dezelfde test toegepast op Claude Sonnet 4.6, en dat model haalde ook 11/12 instructies correct, met een misser op hetzelfde punt (woordaantal). Maar we zien Opus 4.7 toch als een verbetering, omdat Sonnet 4.6 ver, ver over de limiet ging (400 woorden).
Voor onze tweede test gaven we Opus 4.7 een slecht leesbare afbeelding:
You are analysing a degraded image that may be blurry, low-resolution,
or otherwise difficult to read. Your job is to extract as much accurate
information as possible.

Complete all of the following tasks. Do not include any preamble,
explanation, or commentary. Output only the requested deliverable.

1. Describe what type of document or visualisation this appears to be
   (e.g. bar chart, dashboard, table, report page). State your confidence
   as High, Medium, or Low.

2. List every number you can make out, however partial. For each one,
   state what you believe it refers to and your confidence (High, Medium,
   or Low). If a number is ambiguous between two readings (e.g. could be
   138 or 188), state both possibilities.

3. List every piece of text you can make out — titles, labels, legends,
   footnotes — quoted as precisely as possible. Where a word or character
   is unclear, use [?] to mark the uncertain character, e.g. "Re[?]enue".

4. Describe the layout: how many distinct sections or panels are visible,
   and what does each appear to contain?

5. State what you believe the overall subject or story of the image is,
   in one sentence of no more than 25 words. Flag if your confidence is
   Low.

6. List anything you attempted to read but could not make out at all.
Naast deze instructies voedden we Opus 4.7 met een gedegradeerde screenshot van Playfairs handelsgrafiek van Schotland uit 1786, die we haalden uit ons artikel over voorbeelden van datavisualisatie.
We wisten dat we de output konden valideren omdat we een hogere resolutieversie van Wikipedia hadden. Dit is de afbeelding die Opus 4.7 zag:
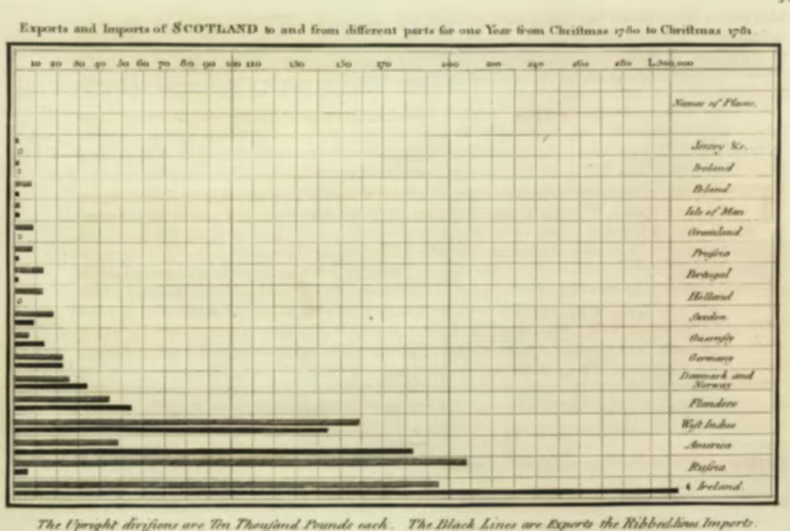
Hier is de lezing van Opus 4.7:
Type: Horizontal bar chart, antique engraving. Confidence: High.

Numbers: X-axis ticks: 10, 20, 30…110, 130, 150, 170, 200, 220, 240, 260, 280, L.300,000 (High, but 130/220 uncertain).

Years "1780" and "1781" in title (High). "Ten Thousand Pounds" per division (High).

Title: "Exports and Imports of SCOTLAND to and from different parts for one Year from Christmas 1780 to Christmas 1781"

Header: "Names of Places"

Places: Jersey &c., Ireland, [?]oland, Isle of Man, Gr[oe]nland, Prussia, Portugal, Holland, Sweden, Guernsey, Germany, Denmark and Norway, Flanders, West Indies, America, Russia, Ireland (duplicate?)

Footnote: "The Upright divisions are Ten Thousand Pounds each. The Black Lines are Exports the Ribbed lines Imports."

Layout: Single panel — title, plot area with ~16 paired bars, right-hand place-name column, footnote below.

Subject: A 1780–81 trade chart showing Scotland's exports and imports by partner. Confidence: High.

Couldn't read: Top-right corner mark; exact bar values; first letter of "[?]oland"; whether bottom "Ireland" is a duplicate.
We wisten dat deze test lastig kon zijn, omdat de x-as van Playfairs grafiek daadwerkelijk halverwege van telling wisselt (iedere 10 tot 110, dan oneven tientallen 130/150/170, dan even tientallen 200/220/240/260/280). Maar Opus 4.7 las de as in de eerste poging correct, ondanks dat het vreemd was.
Eén ding vonden we nog steeds grappig: we waarderen het als AI-modellen hun onzekerheid tonen, maar “[?]oland" had echt met vertrouwen als “Poland" gelezen moeten worden en "Gr[oe]nland" als “Greenland.” Hoewel we hier geen officiële rubric voor hadden, kunnen we het eerlijk gezegd een 9/10 geven.
Opus 4.7 werd geëvalueerd op 14 benchmarks voor codering, redeneren, toolgebruik, computergebruik en visueel redeneren. De tabel hieronder toont de volledige vergelijking met Opus 4.6, GPT 5.4, Gemini 3.1 Pro en de nog niet gepubliceerde Mythos Preview.
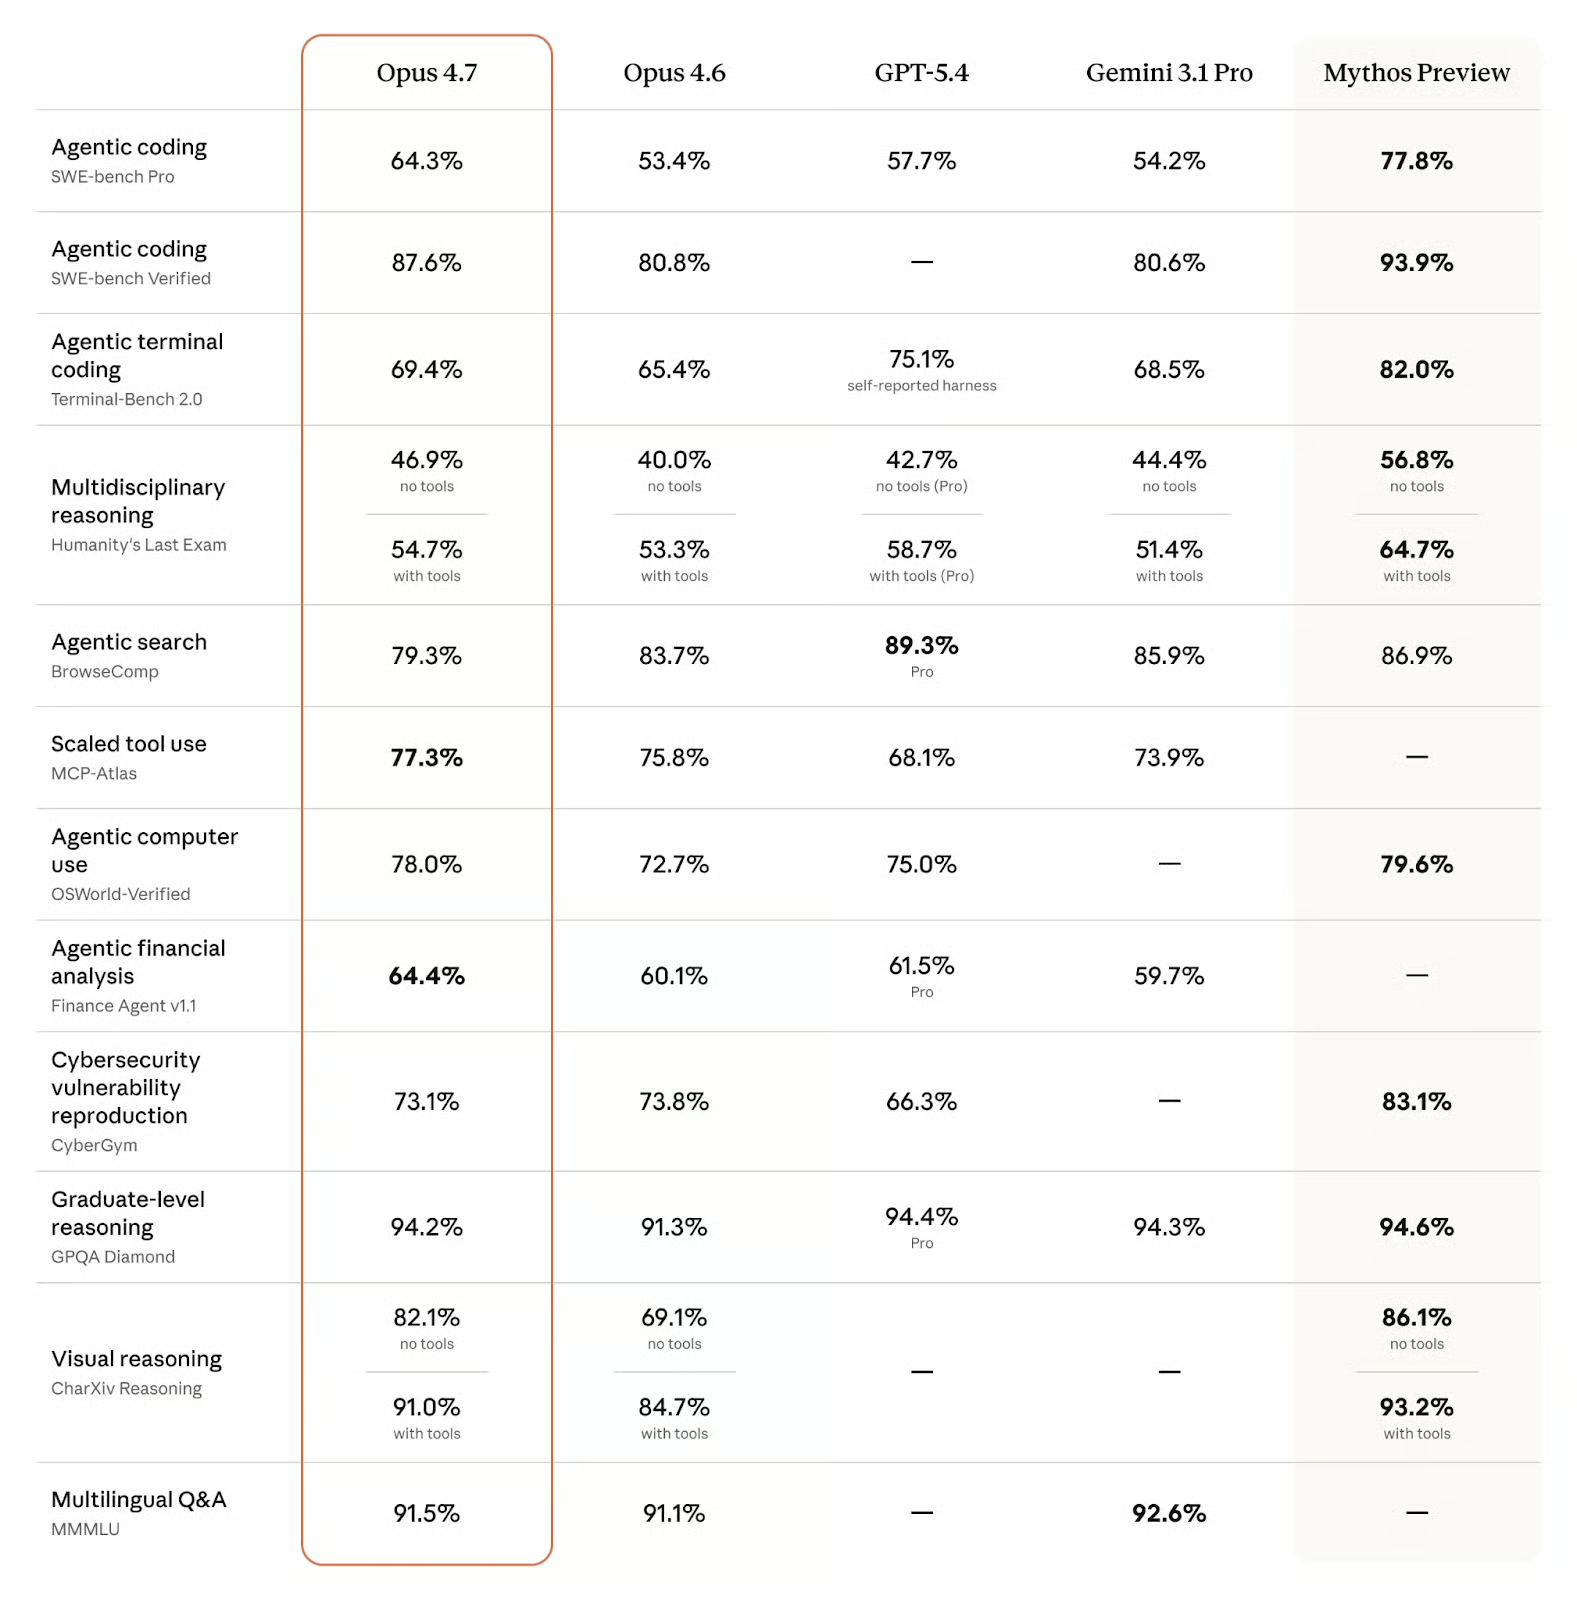
Op SWE-bench Pro scoort Opus 4.7 64,3%, vóór GPT-5.4 met 57,7%, Gemini 3.1 Pro met 54,2% en Opus 4.6 met 53,4%. Op SWE-bench Verified haalt Opus 4.7 87,6% tegenover 80,6% voor Gemini 3.1 Pro en 80,8% voor Opus 4.6. GPT-5.4 heeft in deze vergelijking geen gepubliceerde score op SWE-bench Verified.
SWE-bench test het vermogen van een model om echte GitHub-issues in open-source Python-repo’s op te lossen. Pro is een moeilijkere variant met complexere issues. De winst van 10,9 punten ten opzichte van Opus 4.6 op SWE-bench Pro is de grootste verbetering in deze release (in procentpunten) en zet Opus 4.7 duidelijk voor op beide grote concurrenten op deze taak.
Alleen Anthropics interne Mythos Preview scoort 77,8% op SWE-bench Pro en 93,9% op SWE-bench Verified, wat laat zien dat er nog speelruimte boven Opus 4.7 is. Toch is Mythos niet breed beschikbaar, dus voor productiegebruik is Opus 4.7 het huidige plafond.
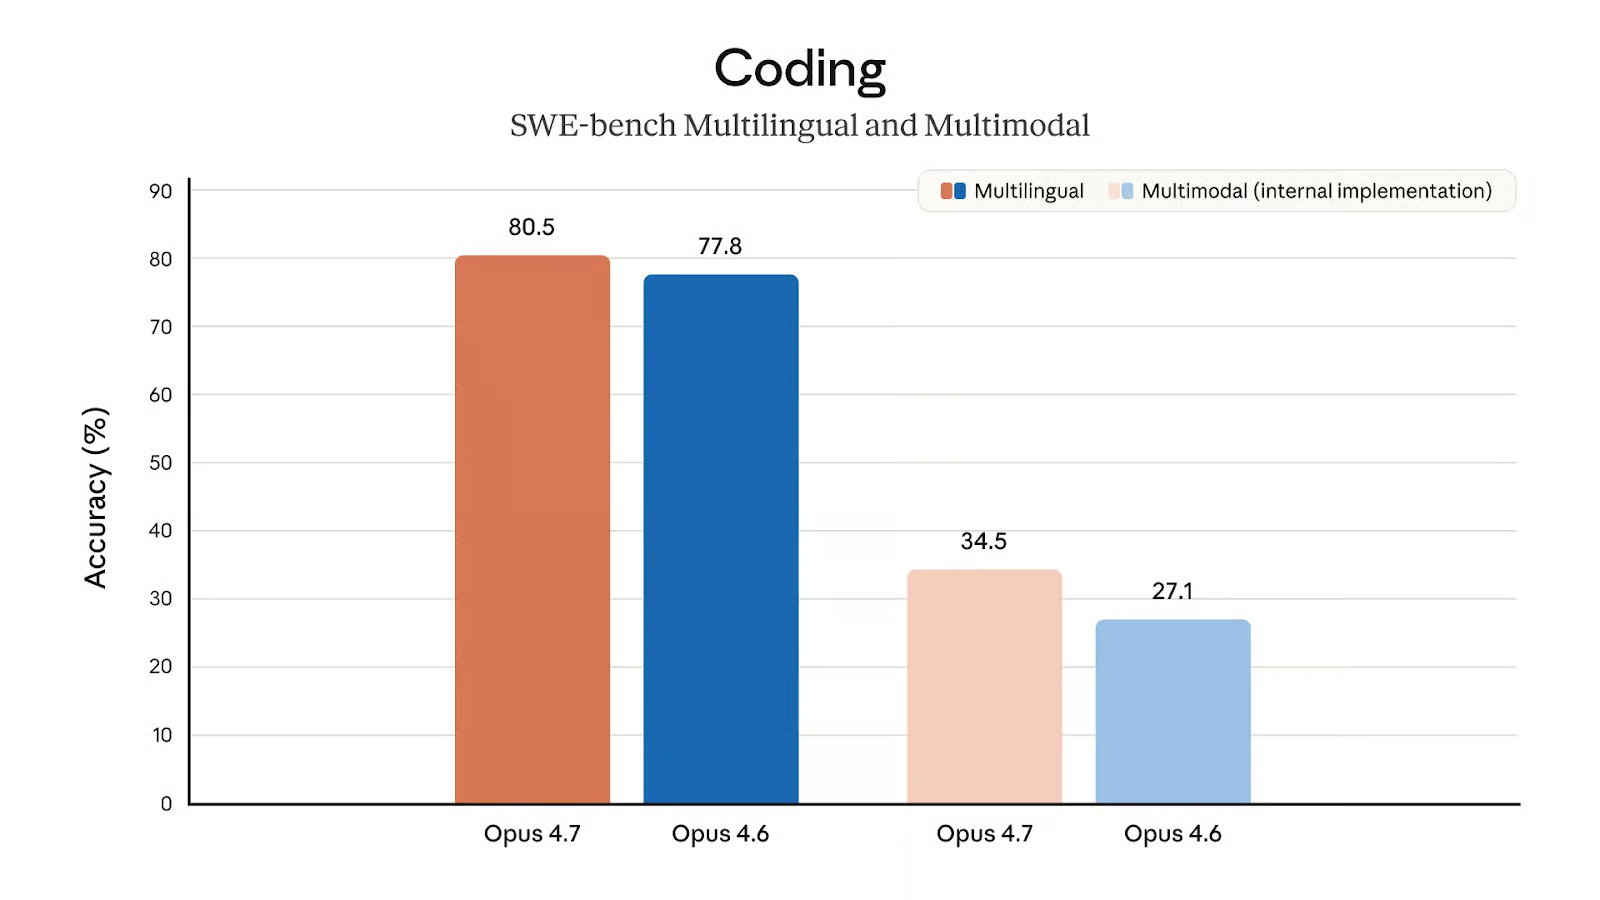
De resultaten op Terminal-Bench 2.0, de toonaangevende benchmark voor agentische codering in de terminal, zijn behoorlijk interessant. Opus 4.7 verbetert licht ten opzichte van zijn voorganger (69,4% vs. 65,4%) en steekt Gemini 3.1 Pro voorbij, dat 68,5% scoort.
Dat gezegd hebbende, kan het niet concurreren met GPT-5.4 (75,1%) op dit vlak, al is de zelf-gerapporteerde kanttekening bij de score van GPT-5.4 het waard om in gedachten te houden bij de vergelijking. Toch kan het voor Anthropic teleurstellend zijn dat zijn nieuwste (uitgebrachte) vlaggenschip geen toppositie haalt op een benchmark die centraal staat in agentische softwareontwikkeling.
Humanity's Last Exam is een verzameling vragen op masterniveau over wetenschap, wiskunde en geesteswetenschappen, ontworpen om moeilijk te zijn voor huidige frontiermodellen. Opus 4.7 leidt de variant zonder tools, die puur redeneren test zonder externe retrieval. De met-tools kloof in het voordeel van GPT-5.4 (58,7%) is het duidelijkste gebied waar Opus 4.7 (54,7%) niet leidt.
Redeneren op masterniveau wordt meestal gemeten in GPQA-Diamond, dat tegenwoordig behoorlijk verzadigd is: net als alle huidige frontiermodellen scoren alle vier vergeleken modellen boven de 90% en zijn ze in essentie gelijk.
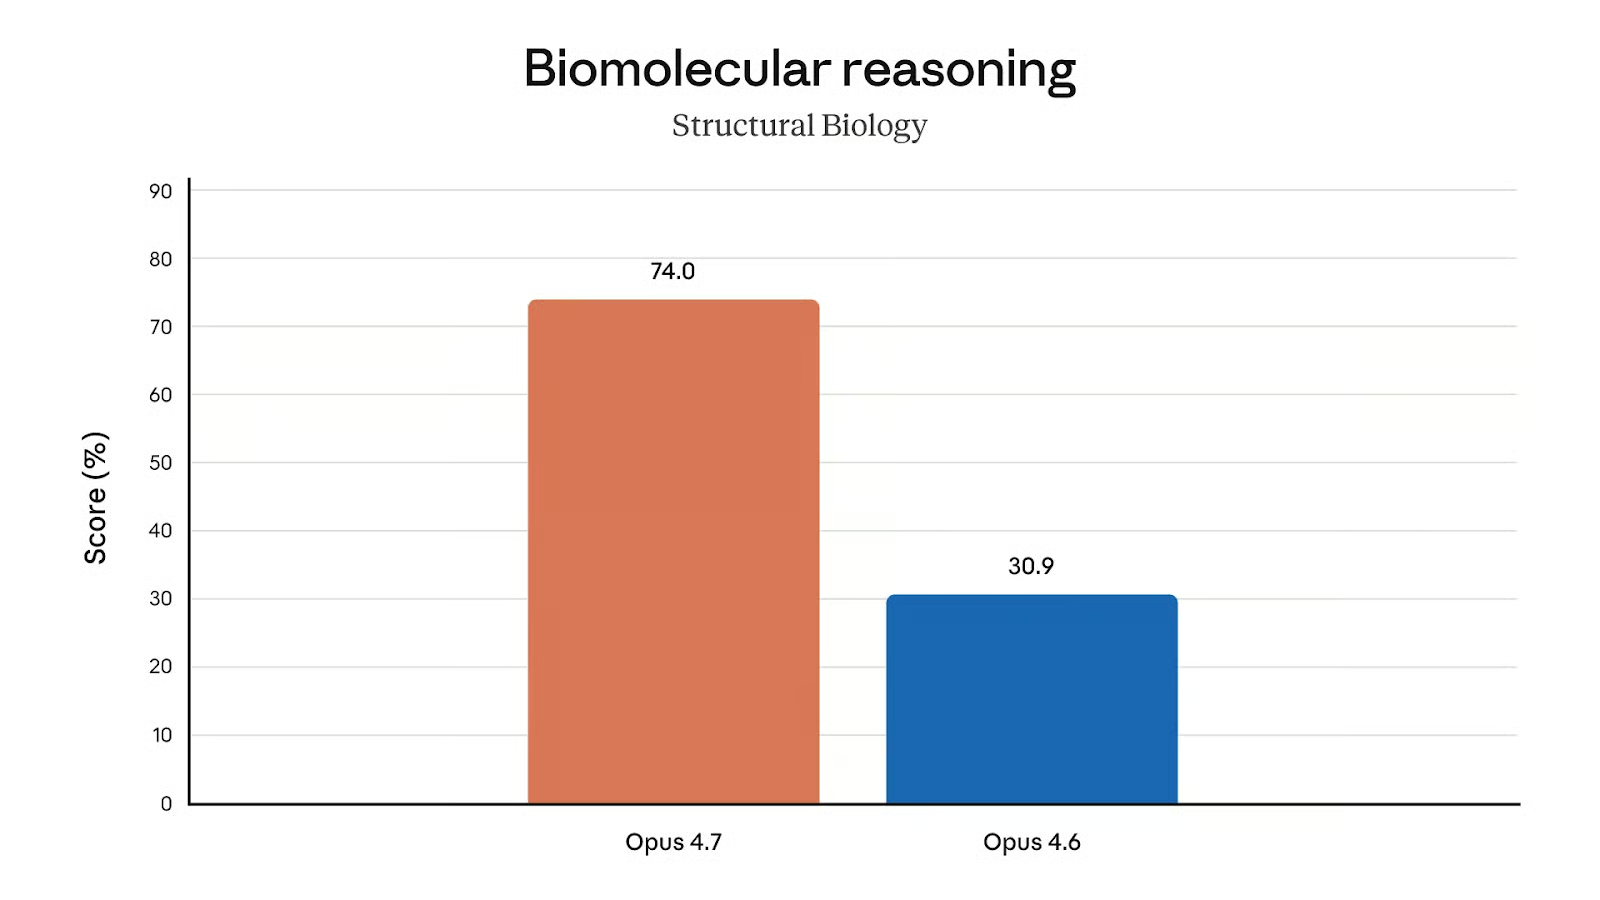
Een interessanter benchmarkresultaat richt zich op biologie, een van de velden die ook specifiek in GPQA-Diamond worden getest. Hoewel we het niet met de concurrenten kunnen vergelijken, is de sprong tussen Opus 4.6 (30,9%) en Opus 4.7 (74,0%) zeker noemenswaardig!
De resultaten in de CharXiv-benchmark, die visueel redeneren over wetenschappelijke grafieken en figuren meet, weerspiegelen dat dit een van de belangrijkste focusgebieden was bij de ontwikkeling van Opus 4.7.
De verbetering van 13 punten zonder tools is de grootste relatieve winst in deze release. Zonder concurrentiescores om tegen af te zetten is het lastig te zeggen waar Opus 4.7 breder in het veld staat op deze taak, maar de verbetering ten opzichte van Opus 4.6 is substantieel.
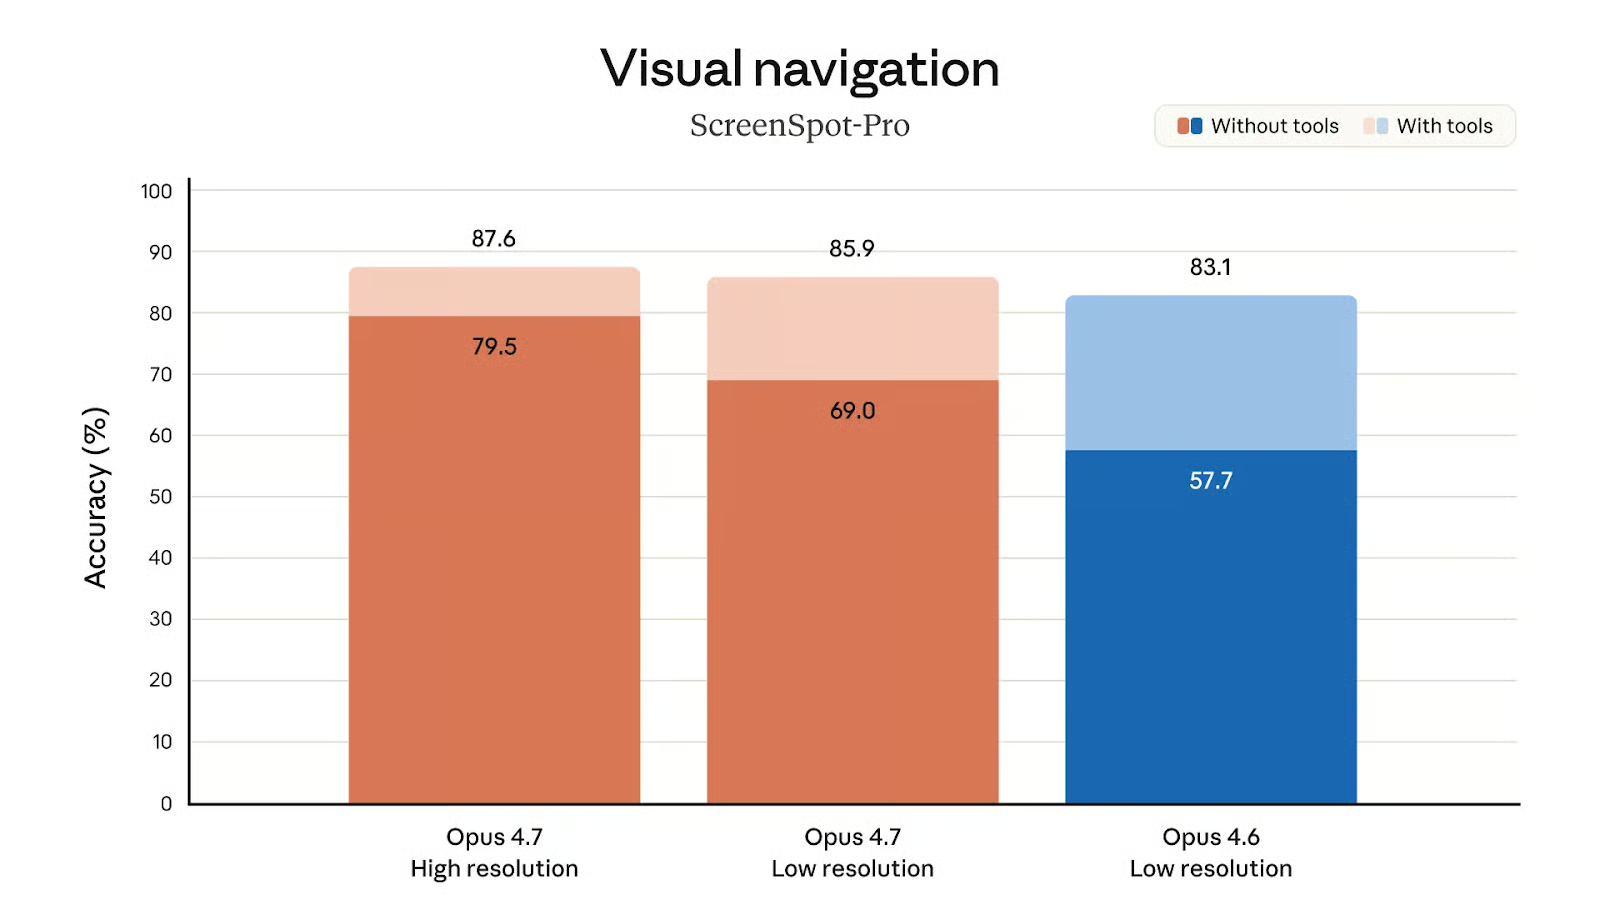
De ondersteuning voor afbeeldingen met hogere resolutie is waarschijnlijk een van de redenen voor het verbeterde visuele redeneren. De grafiek met Screenspot-Pro-scores bij verschillende resoluties laat de enorme nauwkeurigheidsboost zien die Opus 4.7 krijgt van een hogere resolutie, vooral zonder toolgebruik (79,5% vs. 69,0%).
MCP-Atlas test prestaties over complexe workflows met meerdere tools. Opus 4.7 scoort hier 77,3%, het hoogste van alle modellen in de vergelijking. Het enige model dat de MCP-Atlas-score van Opus 4.7 heel licht overstijgt is Muse Spark, dat wordt gerapporteerd op 78,3%.
OSWorld test het vermogen van een model om taken te voltooien door een computerinterface te bedienen: klikken, typen en door applicaties navigeren. Opus 4.7 scoort 78,0%, tegen 72,7% in Opus 4.6. GPT-5.4 scoort 75,0%, en Gemini 3.1 Pro heeft geen gepubliceerde score op deze benchmark. Mythos Preview scoort 79,6%, net iets boven Opus 4.7.
Dit is zeker een gebied waar Opus 4.7 uitblinkt: het leidt zowel MCP-Atlas als OSWorld-Verified met een betekenisvolle marge boven de vlaggenschepen van Google en OpenAI, wat een sterk resultaat is voor iedereen die productiesystemen met agents bouwt die vertrouwen op toolorkestratie en computer-use agents.
De financiële analysevaardigheden van het model verdienen een eervolle vermelding: Opus 4.7 staat bovenaan het Finance Agent v1.1-leaderboard (64,4%), en ligt aanzienlijk voor op zowel GPT-5.4 (61,5%) als Gemini 3.1 Pro (59,7%).
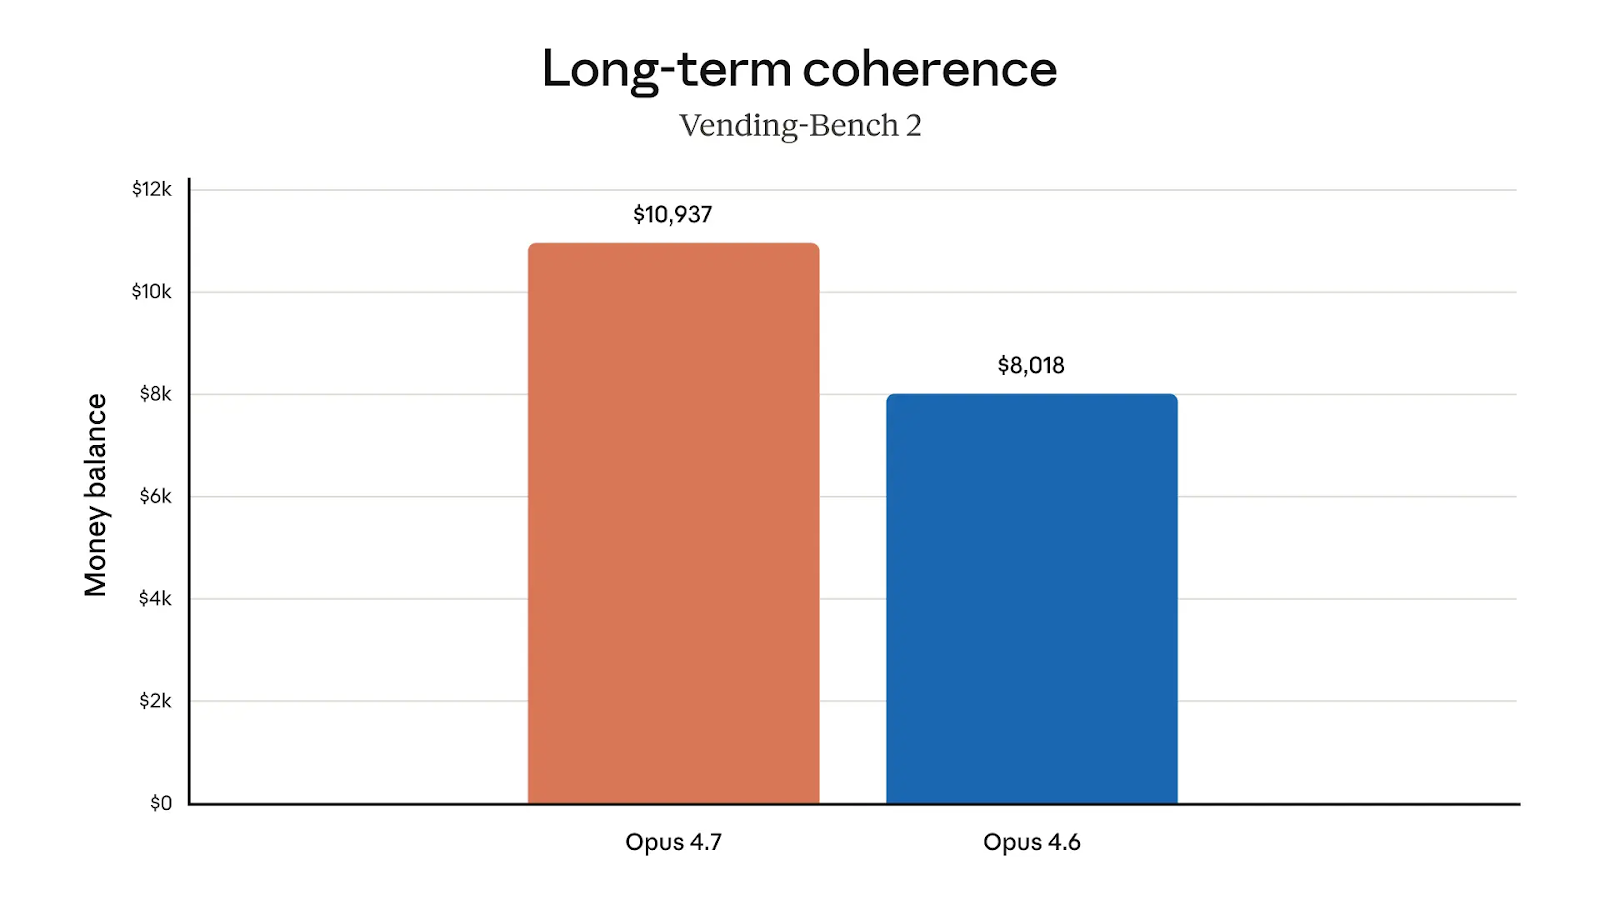
In de meer praktijkgerichte Vending-Bench 2 zien we dat Opus 4.7 ook beter met geld omgaat. Gemiddeld eindigde het model met een bedrag van $10.937, vergeleken met $8.018 met Opus 4.6.
Anthropic laat ons niet wachten. Opus 4.7 is nu beschikbaar
In alle Claude-producten
De Claude API (claude-opus-4-7)
Vertex AI, en
Microsoft Foundry
Je maakt je — zeker nu — altijd zorgen over inflatie. Maar gelukkig is de prijs hetzelfde als bij Opus 4.6. Dat is $5 per miljoen inputtokens en $25 per miljoen outputtokens. (Er was ook geen prijsverhoging tussen Opus 4.6 en Opus 4.7.)
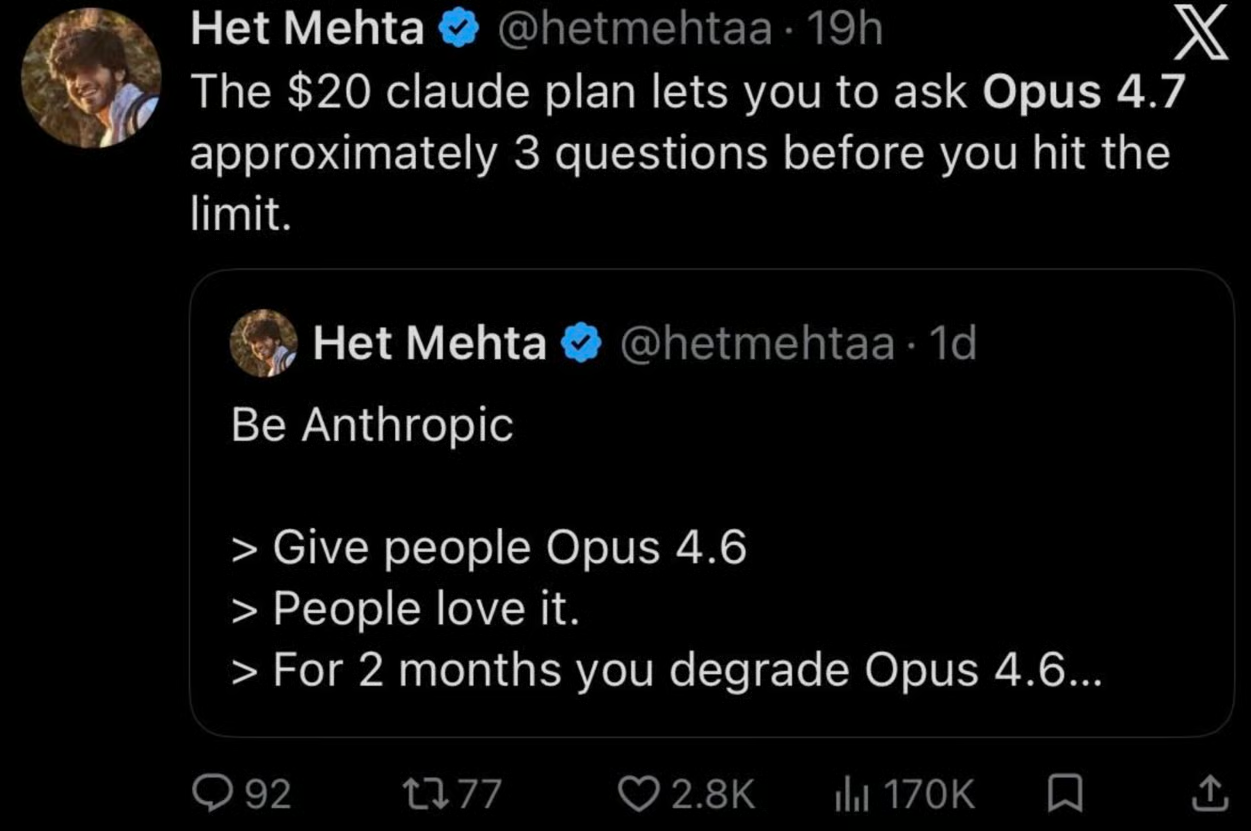
Als algemene herinnering, als je Opus gebruikt in Claude.ai: elk bericht dat je verstuurt, bevat het hele gesprek tot nu toe (je nieuwe vraag + alle eerdere uitwisselingen) plus het antwoord van het model. Al dat verkeer wordt gemeten in tokens. Je abonnement, welk dan ook, heeft een tokenbudget dat in een rolling window wordt aangevuld.
Verschillende modellen rekenen verschillende tarieven tegen dat budget. Opus is het duurst omdat het het krachtigst is. Een grove gepubliceerde verhouding: Opus kost ongeveer 5× zoveel per token als Sonnet.
Anthropic leverde verschillende updates naast het model zelf die de moeite waard zijn, in elk geval als je Claude Code gebruikt of op de API bouwt.
Een nieuw xhigh ("extra hoog")-inspanningniveau zit nu tussen high en max in. Dit geeft je een extra optie bij het kiezen tussen redeneerdiepte en latentie. In Claude Code is het standaardinspanningniveau verhoogd naar xhigh voor alle abonnementen, en Anthropic raadt aan te beginnen met high of xhigh bij het testen van Opus 4.7 op codeer- en agenttaken.
Claude Code kreeg een nieuw slash-commando /ultrareview, dat een speciale reviewpass over je wijzigingen draait en bugs of ontwerpproblemen markeert die een zorgvuldige menselijke reviewer zou opmerken. Pro- en Max-gebruikers krijgen drie gratis ultrareviews om het uit te proberen.
Max-gebruikers krijgen nu toegang tot automodus, een machtigingsinstelling waarbij Claude namens jou beslissingen neemt. Het is een middenweg tussen elke stap goedkeuren en machtigingen volledig overslaan.
Taakbudgetten zijn nu in publieke bèta op de Claude API. Hiermee kunnen ontwikkelaars Claude’s tokenbesteding over een run begrenzen, wat vooral handig is voor langere agentworkflows waarbij je wilt dat het model het tempo bewaakt in plaats van zijn budget op te stoken.
We hebben de benchmarkresultaten nauwkeurig bekeken, en die bevatten een vergelijking met andere modellen. Op hoofdlijnen: laten we Opus 4.7 direct met GPT-5.4 vergelijken.
De kernboodschap is dat Opus 4.7 optimaliseert voor autonomie over lange horizon. GPT-5.4 is een verenigd general-purpose model met bredere toolondersteuning en goedkopere prijzen voor korte context.
| Claude Opus 4.7 | GPT-5.4 | |
|---|---|---|
| Beste in | Lange coderuns, desktop-computergebruik, dichte visie |
Browseronderzoek, kort-contexttaken, sturing tijdens het antwoord |
| SWE-bench Pro | 64,3% | 57,7% |
| BrowseComp | 79,3% | 89,3% |
| Prijzen | Vast tarief over 1M context | Goedkoper onder 272K, volledige sessie herprijst daarboven |
| Contextvenster | ~1M tokens | ~1M tokens |
Voor de volledige vergelijking met OpenAI’s opvolger, GPT-5.5, zie onze blogpost, Claude Opus 4.7 vs. GPT-5.5.
Sommige gebruikers melden dat hun pipelines kuren vertonen omdat Opus 4.7 instructies letterlijker volgt dan voorheen. Anthropic waarschuwde voor de noodzaak om prompts opnieuw af te stemmen.
Andere gebruikers maakten zich zorgen over tokenverbruik. Als onderdeel van de release verhoogde Anthropic de rate limits voor alle gebruikers om het hogere tokenverbruik op te vangen, maar het is niet helemaal duidelijk of het een echte compensatie is.
Claude Opus 4.7 is het capabelste model dat de meeste mensen op dit moment daadwerkelijk kunnen gebruiken. De verbeteringen wijzen allemaal in dezelfde richting: langerlopende, minder gesuperviseerde agentwerkzaamheden, met sterkere codeerprestaties, scherper zicht en betere sessie-overstijgende geheugensteun.
Wat deze release interessant maakt, is de Mythos-invalshoek. Opus 4.7 is een cyber-beperkt testvoertuig op weg naar een bredere release in de Mythos-klasse, wat betekent dat er nu een duidelijk plafond boven zit waar je niet bij kunt — maar ook dat de safeguards die met 4.7 worden geleverd een voorbode zijn van hoe Anthropic voornemens is frontierreleases voortaan te behandelen.
Leren met DataCamp
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min