
Cursus
Python voor gevorderde ontwikkelaars
2 uur
70.2K
Oefen en volg je voortgang.
Ga Verder Met GoogleOnlangs had ik het voorrecht om vroegtijdige toegang te krijgen tot de Polars GPU-engine, aangedreven door NVIDIA RAPIDS cuDF, nog vóór de open-bètarelease. Deze geavanceerde functie kan dataworkflows transformeren door Polars-bewerkingen tot 13x te versnellen met NVIDIA GPU’s. Als je met grootschalige datasets in Python werkt, wil je dit niet missen.
In deze blogpost leg ik alles uit wat je moet weten over de nieuwe Polars GPU-engine en geef ik een stapsgewijze gids om je op weg te helpen!
De kern van de meeste data science-workflows is de DataFrame: een tabelstructuur die flexibel en intuïtief is voor gestructureerde data. Simpel gezegd: iedereen in data science heeft met DataFrames gewerkt.
DataFrames maken het makkelijk om data te manipuleren, te verkennen en te analyseren, met een vertrouwde en consistente interface voor opschonen, filteren, groeperen en transformeren.
In de context van big data schieten traditionele DataFrame-bibliotheken echter vaak tekort qua performance en schaalbaarheid. Daar komt Polars om de hoek kijken.
Polars is een snelle, efficiënte DataFrame-bibliotheek die snel is uitgegroeid tot een topkeuze voor high-performance dataverwerking. Polars is from scratch in Rust geschreven en ontworpen om dicht op de hardware te draaien, met optimale snelheid en efficiënt gebruik van resources, zonder externe afhankelijkheden.
De Introductie tot Polars-blogpost is een uitstekende bron om in Python met de bibliotheek aan de slag te gaan.
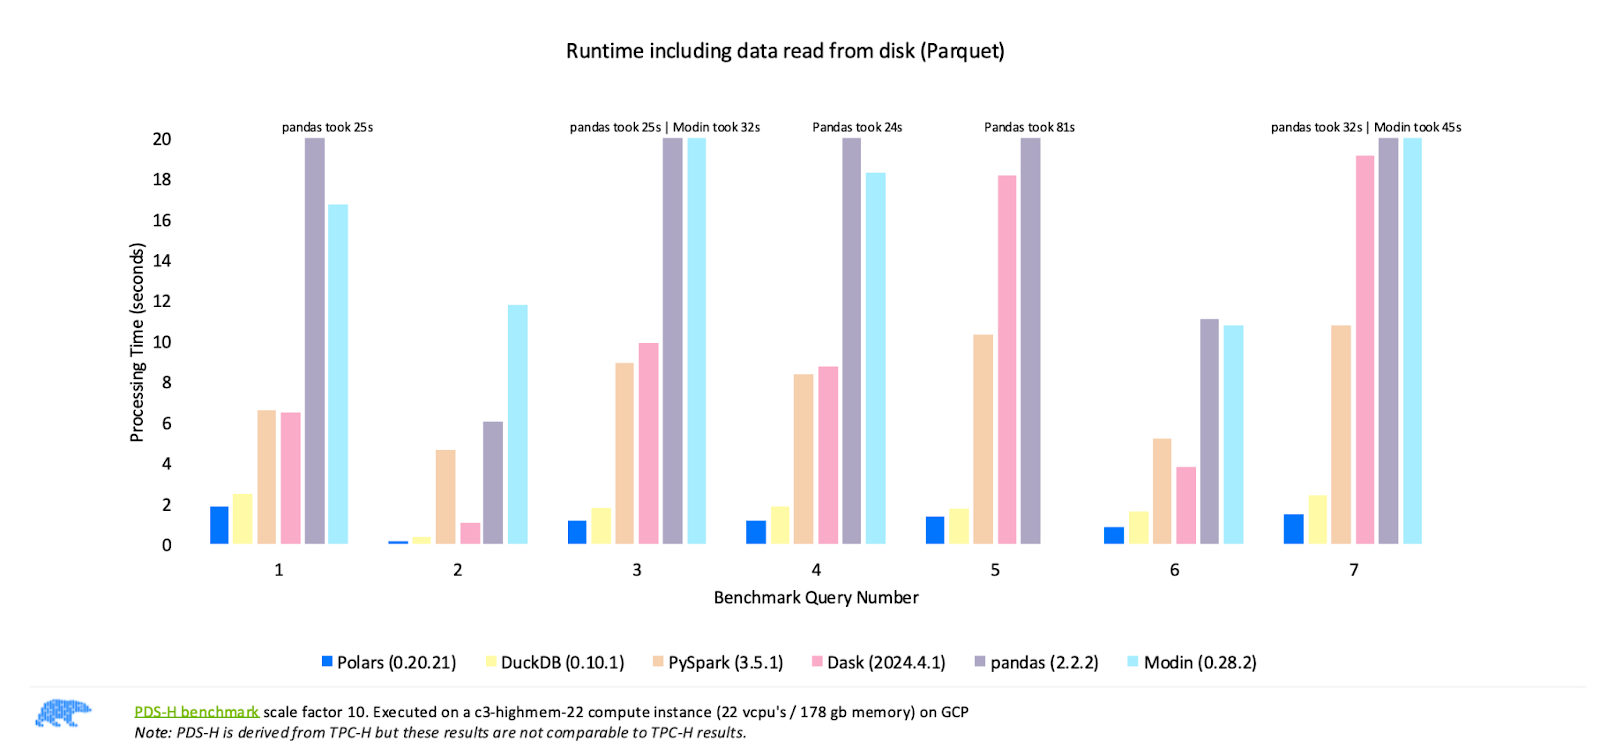
Vergelijking van de prestaties van de populairste DataFrame-bibliotheken. Bron: Polars
De benchmarkresultaten van Polars, weergegeven in de afbeelding hierboven, laten zien dat Polars consequent sneller is dan andere bibliotheken zoals Pandas, Modin, PySpark en Dask bij verschillende queries. Deze resultaten onderstrepen Polars’ kracht als de snelste optie voor high-performance dataverwerking.
Maar hoe kan dat? Dit zijn enkele kenmerken die Polars razendsnel maken:
En met de recente open-bètaaankondiging van de Polars GPU-engine wordt het nóg sneller!
De vraag naar snellere dataverwerking en -analyse is de afgelopen jaren exponentieel gegroeid, omdat datasets zijn opgeschaald naar honderden miljoenen of zelfs miljarden rijen. Om deze uitdaging aan te gaan, verschuift het data science-veld steeds meer van traditionele CPU-gebaseerde verwerking naar GPU-versnelde computing. Daar komt NVIDIA RAPIDS cuDF om de hoek.
NVIDIA RAPIDS is een opensourcebibliotheekensuite voor GPU-versnelde data science en analytics. RAPIDS is ontworpen om dataworkflows te stroomlijnen door de massale parallelliteit van NVIDIA GPU’s te benutten om taken te versnellen die doorgaans CPU-bound zijn.
Binnen RAPIDS is cuDF de bibliotheek die verantwoordelijk is voor DataFrame-bewerkingen. cuDF breidt de vertrouwde DataFrame-abstrahering uit naar GPU-geheugen, zodat je het zonder grote codewijzigingen in je workflows kunt integreren. De bibliotheek ondersteunt alle kernbewerkingen die data scientists op DataFrames uitvoeren: filteren, aggregeren, mergen en sorteren — allemaal GPU-aangedreven voor snelheid.
NVIDIA en Polars hebben zojuist de open-bètarelease aangekondigd van de Python Polars GPU-engine, aangedreven door RAPIDS cuDF. Deze nieuwe functie is een grote sprong voorwaarts voor high-performance dataverwerking en levert tot 13x snellere workflows voor Polars-gebruikers met NVIDIA GPU’s!
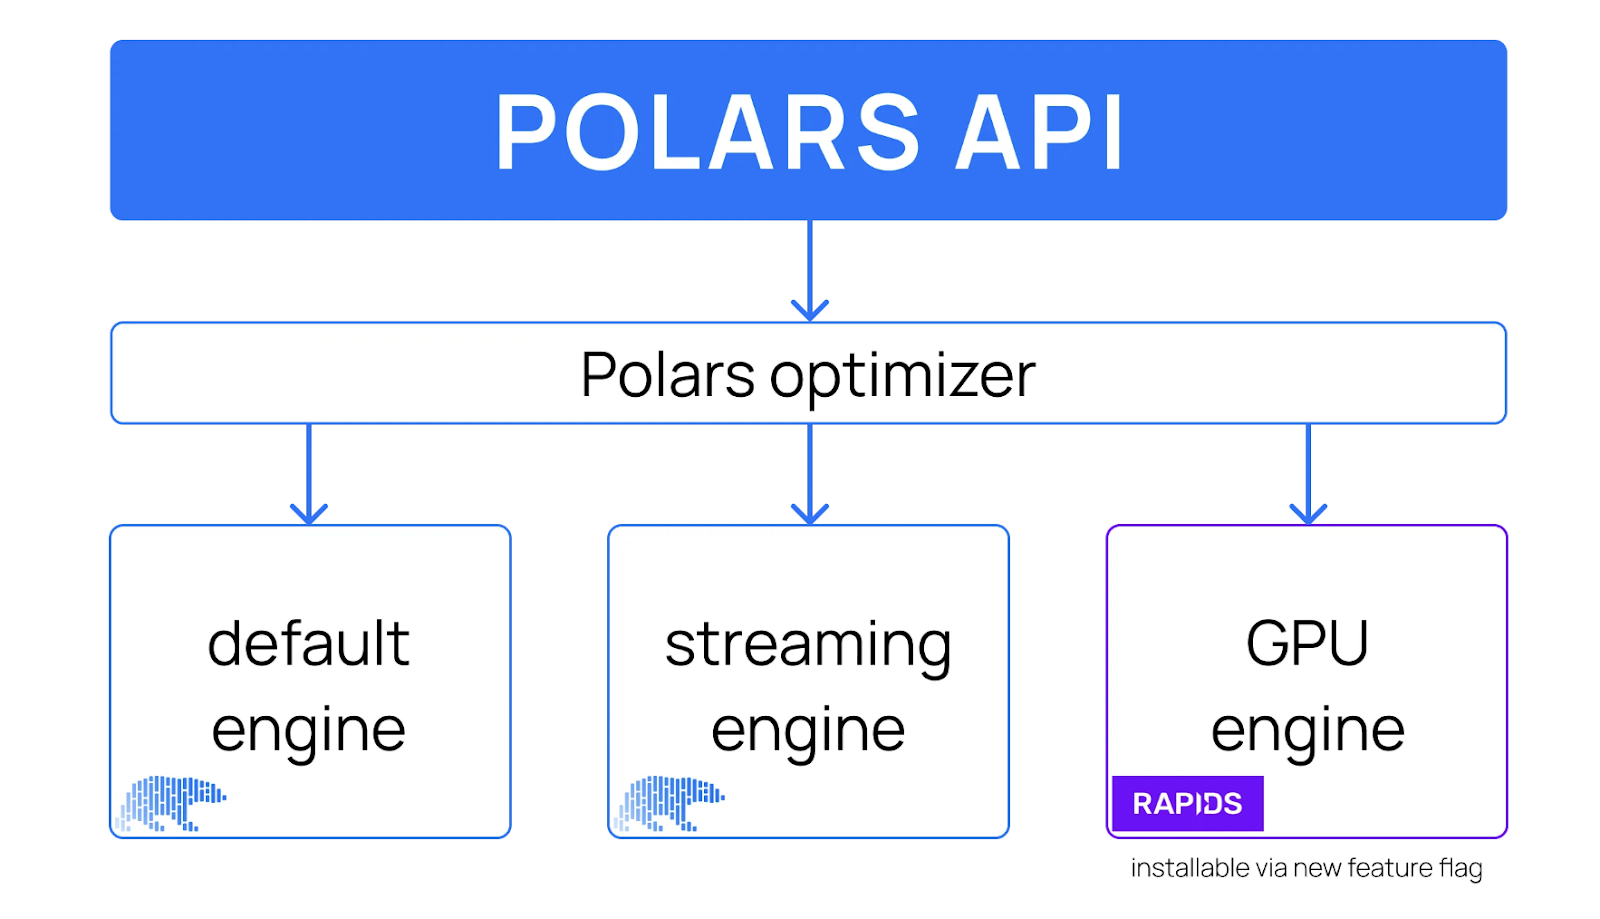
High-level ontwerp van de Polars API, inclusief een GPU-engine. Bron: Polars
Met de toevoeging van de GPU-engine kunnen Polars-gebruikers kiezen op welke engine hun workloads draaien. De Polars-optimizer ondersteunt alle engines en bepaalt dynamisch welke queries op de GPU of CPU kunnen worden uitgevoerd.
Je hebt nu wat context over Polars en de NVIDIA RAPIDS cuDF-bibliotheek, hoe ze integreren en via de Python Polars API beschikbaar zijn. Maar wat betekent dit voor developers en data scientists?
Hier is een samenvatting van wat de Polars GPU-engine mogelijk maakt:
engine="gpu" meegeven aan de collect()-operatie in de Lazy API van Polars, zodat GPU-verwerking werkt zonder grote codewijzigingen.Wat zijn de resultaten tot nu toe? Laten we kijken.
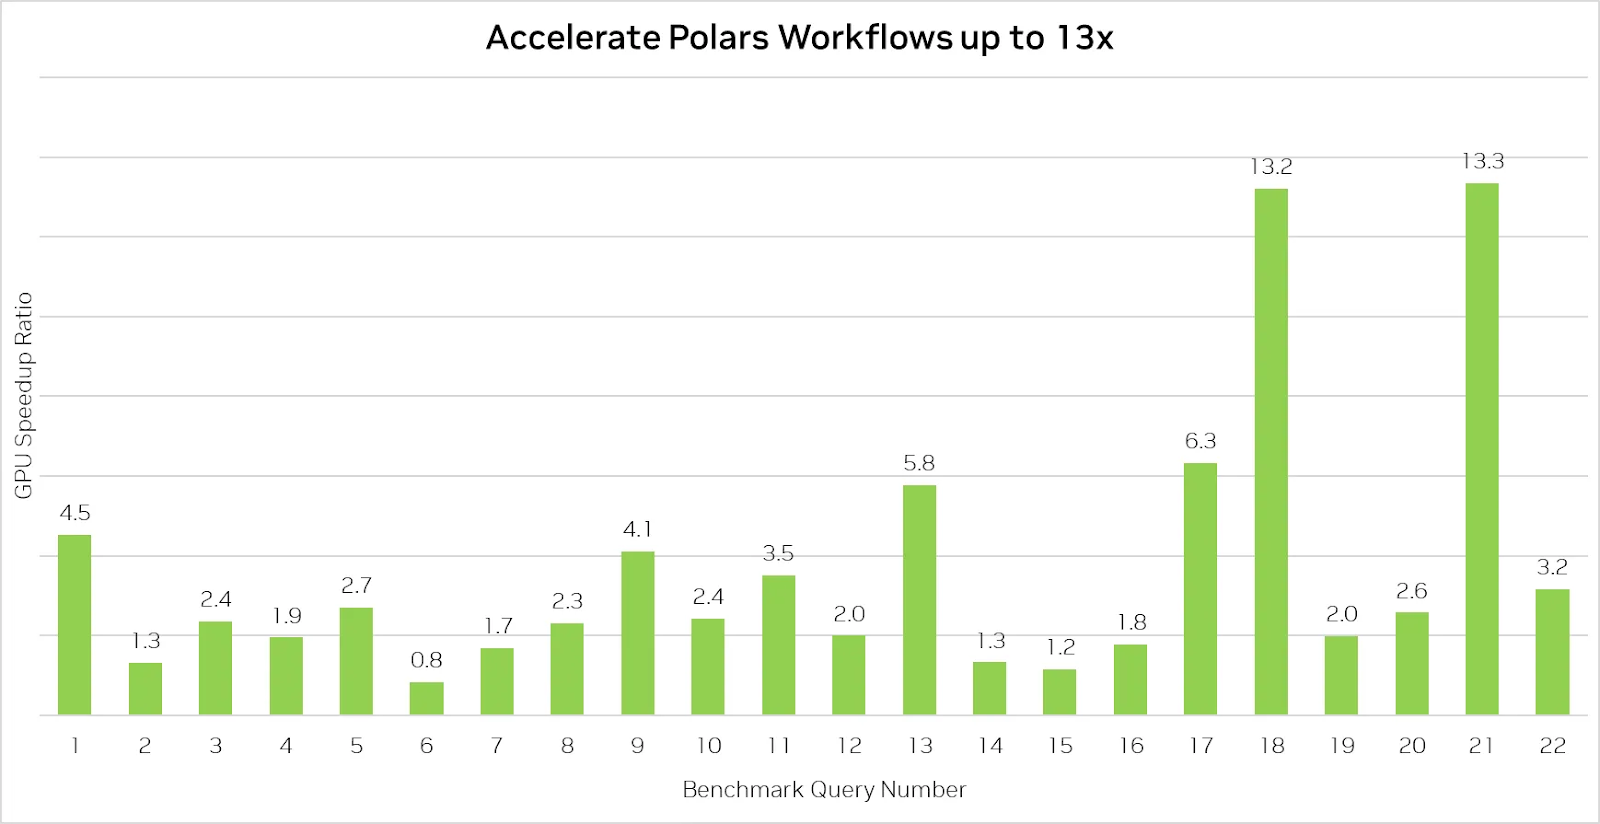
Polars GPU-engine versnelt dataverwerking tot 13x. Bron: Polars
De benchmark hierboven toont de indrukwekkende capaciteiten van de Polars GPU-engine door queries tot 13x te versnellen.
Het is echter belangrijk om te beseffen dat Polars op een GPU niet altijd sneller is dan op een CPU, zeker niet bij eenvoudigere, weinig rekenintensieve queries. In zulke gevallen wordt de performance vaak beperkt door de snelheid waarmee data van schijf wordt gelezen. GPU-versnelling biedt dan minder voordeel wanneer input/output (I/O) de primaire bottleneck is.
Dat gezegd hebbende levert de GPU-engine aanzienlijke versnellingen op voor complexere databewerkingen. Het is daarmee een waardevol hulpmiddel voor teams die werken met grote datasets of queries met joins, group-bys en stringverwerking.
Een van de meest overtuigende kenmerken van deze integratie is de flexibiliteit. Zoals eerder genoemd kan de optimizer schakelen tussen CPU- en GPU-uitvoering op basis van de complexiteit van je queries. Maar hoe werkt die overgang precies?
Als je Polars op de CPU draait, volgt de engine een gestructureerde en sterk geoptimaliseerde pijplijn om databewerkingen uit te voeren. Globaal zijn dit de stappen:
Wanneer je GPU-versnelling inschakelt door engine="gpu" aan de .collect()-methode door te geven, blijft het proces aan de oppervlakte grotendeels hetzelfde, maar met extra checks en optimalisaties achter de schermen om te bepalen hoeveel van de workload via cuDF naar de GPU kan worden uitbesteed:
Dit hybride uitvoermodel — waarbij GPU en CPU samen worden ingezet — maakt Polars zeer flexibel. Je profiteert van GPU-versnelling zonder compatibiliteit op te offeren voor queries die niet op de GPU worden ondersteund. De Polars releaseblogpost gaat hier dieper technisch op in.
Eindelijk het leukste deel! In dit hoofdstuk doorloop ik de stappen om je omgeving in te richten en te profiteren van GPU-versnelde dataverwerking.
De meest rechttoe rechtaan manier is om mee te doen met dit Google Colab-notebook.
Colab biedt gratis, beperkte GPU-tijd, handig als je niet direct toegang hebt tot een GPU. Gebruik je het notebook, dan beginnen we vanaf stap 2 hieronder en kun je de eerdere stappen overslaan.
Controleer vóór de installatie van de Polars GPU-engine of je systeem voldoet aan de vereisten voor NVIDIA RAPIDS cuDF. Bekijk de benodigde specificaties, waaronder GPU-compatibiliteit en driververeisten, op de RAPIDS-documentatiepagina.
Om te beginnen met de Polars GPU-engine is het best practice om een virtuele omgeving te maken en je projectafhankelijkheden te isoleren.
Ik gebruik hiervoor conda, maar gebruik gerust je eigen pakketmanager.
Naast Python kun je JupyterLab toevoegen voor interactieve data-exploratie en -ontwikkeling, ideaal voor het draaien van kleine codefragmenten en het on-the-fly analyseren van datasets.
conda create -n polars-gpu -c conda-forge python=3.11 jupyterlabActiveer na het aanmaken van de virtuele omgeving deze met:
conda activate polars-gpuLaten we nu GPU-versnelling inschakelen door Polars en de GPU-engine te installeren. Dit zet ook cuDF en andere benodigde afhankelijkheden op voor gebruik van NVIDIA GPU’s:
pip install -U polars[gpu] --extra-index-url=https://pypi.nvidia.comZodra de Polars GPU-engine is geïnstalleerd, voelt werken met Polars op een GPU vergelijkbaar met de CPU, maar dan met veel snellere resultaten voor complexe of data-intensieve workflows.
Zoals eerder uitgelegd optimaliseert de Polars-engine het uitvoerplan automatisch en benut hij de NVIDIA GPU volledig om bewerkingen te versnellen en geheugengebruik te minimaliseren. Voor queries die niet worden ondersteund op de GPU, heeft de Polars GPU-engine een soepele CPU-terugval, zodat de workflow ononderbroken doorgaat.
Laten we de engine aan het werk zetten met een paar simpele voorbeelden!
Voor deze demo gebruiken we een dataset van 22 GB met gesimuleerde financiële transacties van Kaggle. NVIDIA host de dataset in een Google Cloud Storage (GCS)-bucket voor snelle downloads.
Download eerst de dataset:
!wget https://storage.googleapis.com/rapidsai/polars-demo/transactions.parquet -O transactions.parquetOmdat deze dataset afkomstig is van Kaggle valt hij onder een Kaggle-dataset-specifieke licentie en gebruiksvoorwaarden.
Laten we de dataset laden met Polars en het schema bekijken:
import polars as pl
from polars.testing import assert_frame_equal

transactions = pl.scan_parquet("transactions.parquet")
transactions.collect_schema()
Hier is de output:
Schema([('CUST_ID', String),
        ('START_DATE', Date),
        ('END_DATE', Date),
        ('TRANS_ID', String),
        ('DATE', Date),
        ('YEAR', Int64),
        ('MONTH', Int64),
        ('DAY', Int64),
        ('EXP_TYPE', String),
        ('AMOUNT', Float64)])
Nu berekenen we het totale transactievolume door de kolom AMOUNT op te tellen. Eerst zonder GPU-versnelling:
transactions.select(pl.col("AMOUNT").sum()).collect()Output:
AMOUNT
f64
3.6183e9
Dat is een hoog totaal transactievolume! Laten we dezelfde query op de GPU draaien:
transactions.select(pl.col("AMOUNT").sum()).collect(engine="gpu")Output:
AMOUNT
f64
3.6183e9
Voor simpele bewerkingen als deze leveren CPU en GPU hetzelfde resultaat in vergelijkbare tijd, omdat de query niet rekenintensief genoeg is om veel profijt te hebben van GPU-versnelling. De GPU schittert bij complexere queries.
Laten we nu een complexere query doen. We groeperen transacties op klant-ID (CUST_ID), sommeren de bedragen en sorteren vervolgens op de hoogste spenders.
Eerst draaien we hem op de CPU:
%%time
res_cpu = (
   transactions
   .group_by("CUST_ID")
   .agg(pl.col("AMOUNT").sum())
   .sort(by="AMOUNT", descending=True)
   .head()
   .collect()
)
res_cpu
Hier is de output:
CPU times: user 4.63 s, sys: 3.75 s, total: 8.38 s
Wall time: 6.04 s
CUST_ID
AMOUNT
str
f64
"CA9UYOQ5DA"
2.0290e6
"CJUK2MTM5Q"
1.8115e6
"CYXX1NBIKL"
1.8082e6
"C6ILEYAYQ9"
1.7961e6
"CCNBC305GI"
1.7274e6
Nu draaien we dezelfde query op de GPU:
%%time
res_gpu = (
   transactions
   .group_by("CUST_ID")
   .agg(pl.col("AMOUNT").sum())
   .sort(by="AMOUNT", descending=True)
   .head()
   .collect(engine=”gpu”)
)
res_gpu
Output:
CPU times: user 347 ms, sys: 0 ns, total: 347 ms
Wall time: 353 ms
shape: (5, 2)
CUST_ID
AMOUNT
str
f64
"CA9UYOQ5DA"
2.0290e6
"CJUK2MTM5Q"
1.8115e6
"CYXX1NBIKL"
1.8082e6
"C6ILEYAYQ9"
1.7961e6
"CCNBC305GI"
1.7274e6
Zoals je ziet levert de GPU bij complexere queries flinke performancewinst op: de uitvoeringstijd gaat van 6,04 seconden op de CPU naar slechts 353 milliseconden op de GPU!
Dit voorbeeld laat zien hoe krachtig de Polars GPU-engine is voor grootschalige databewerkingen.
Meer geavanceerde voorbeelden vind je in het bijbehorende Colab-notebook.
De Polars GPU-engine, aangedreven door NVIDIA RAPIDS cuDF, levert indrukwekkende snelheidswinsten op, met tot 13x snellere dataverwerking bij complexe bewerkingen. Voor grootschalige datasets biedt Polars een duidelijk voordeel ten opzichte van traditionele DataFrame-bibliotheken.
Hoewel niet elke query evenveel profiteert van GPU-versnelling, blijft Polars een krachtig hulpmiddel voor iedereen die met grote datasets werkt. De eenvoudige integratie, gecombineerd met het hybride CPU-GPU-uitvoermodel, maakt Polars tot een sterke kandidaat voor moderne dataworkflows.
Als je je datamanipulatievaardigheden — vooral met Pandas — wilt ontwikkelen, raad ik deze cursussen van harte aan:
Deze bronnen geven je een solide basis die de krachtige mogelijkheden van tools als Polars mooi aanvult!
Leer meer over data science en Python met deze cursussen!
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

