
Corso
Python intermedio per sviluppatori
2 ore
70.2K
Pratica and corso your progress.
Continua Con GoogleDi recente ho avuto il privilegio di accedere in anteprima al motore GPU di Polars, basato su NVIDIA RAPIDS cuDF, prima della sua open beta. Questa funzionalità all’avanguardia ha il potenziale per trasformare i flussi di lavoro sui dati accelerando le operazioni di Polars fino a 13 volte con le GPU NVIDIA. Se lavori con dataset su larga scala in Python, è una svolta che non vuoi perderti.
In questo post ti spiegherò tutto ciò che devi sapere sul nuovo motore GPU di Polars e ti fornirò una guida passo passo per iniziare!
Al centro della maggior parte dei flussi di lavoro in data science c’è il DataFrame, una struttura tabellare flessibile e intuitiva per gestire dati strutturati. In poche parole, chiunque faccia data science ha lavorato con i DataFrame.
I DataFrame consentono una manipolazione, esplorazione e analisi dei dati semplice, offrendo un’interfaccia familiare e coerente per pulire, filtrare, raggruppare e trasformare i dati.
Tuttavia, nel contesto dei big data, le librerie tradizionali di DataFrame possono peccare in prestazioni e scalabilità: è qui che entra in gioco Polars.
Polars è una libreria DataFrame veloce ed efficiente che è diventata rapidamente una delle scelte migliori per l’elaborazione dati ad alte prestazioni. Scritto da zero in Rust, Polars è progettato per operare vicino all’hardware, ottimizzando velocità e uso delle risorse senza dipendere da componenti esterni.
Il post Introduzione a Polars è un’ottima risorsa per iniziare a usare la libreria in Python.
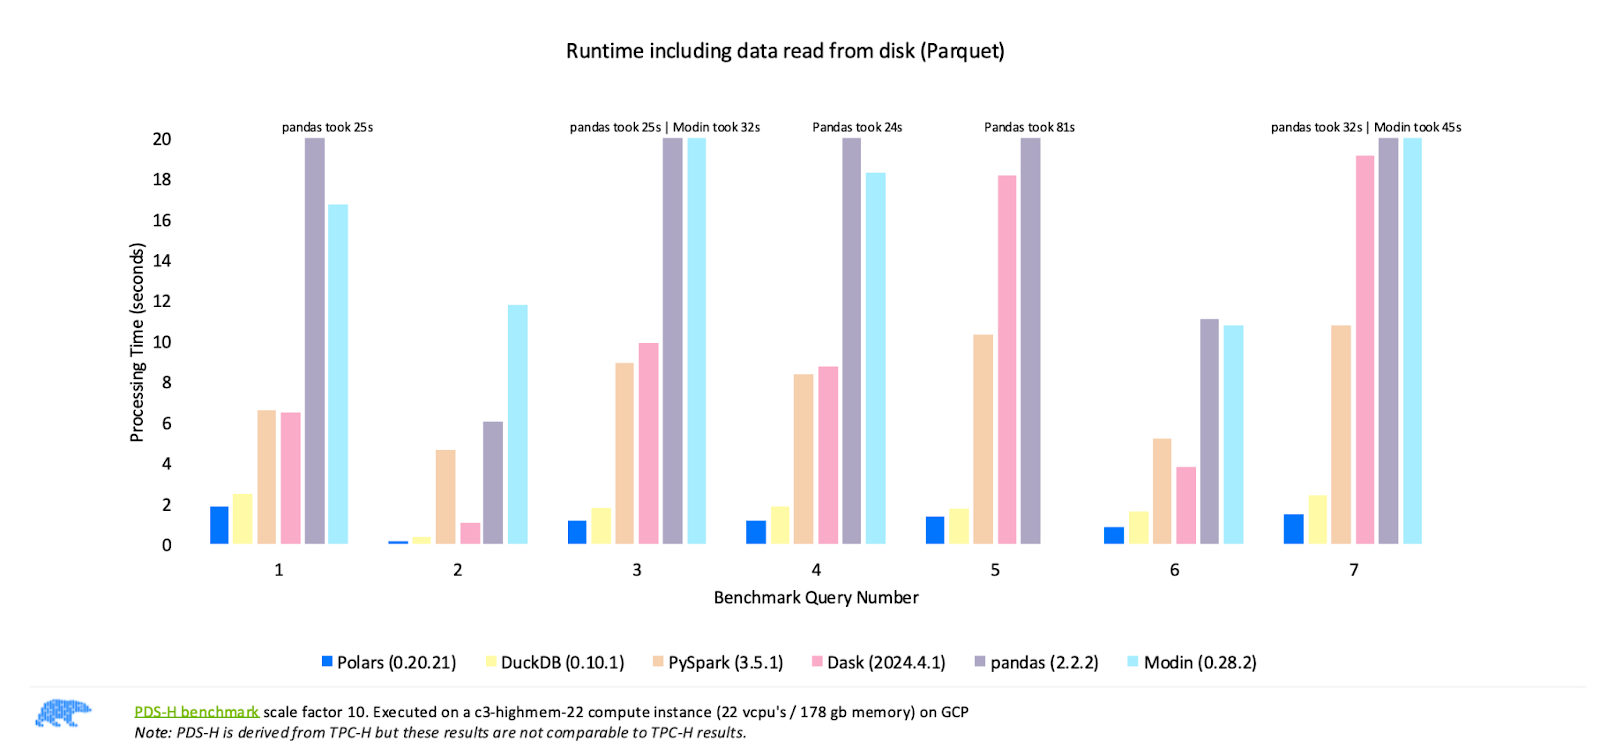
Confronto delle prestazioni delle librerie DataFrame più popolari. Fonte immagine: Polars
I benchmark pubblicati da Polars, mostrati nell’immagine sopra, dimostrano che Polars supera costantemente altre librerie come Pandas, Modin, PySpark e Dask su diverse query. Questi risultati evidenziano la forza di Polars come opzione più veloce per l’elaborazione dati ad alte prestazioni.
Ma com’è possibile? Ecco alcune caratteristiche che rendono Polars estremamente veloce:
E con il recente annuncio dell’open beta del motore GPU di Polars, sta per diventare ancora più veloce!
La domanda di elaborazione e analisi dei dati più veloce è cresciuta esponenzialmente negli ultimi anni, man mano che i dataset sono arrivati a centinaia di milioni o persino miliardi di righe. Per affrontare questa sfida, la data science ha visto un passaggio crescente dall’elaborazione basata su CPU al calcolo accelerato da GPU. È qui che entra in gioco NVIDIA RAPIDS cuDF.
NVIDIA RAPIDS è una suite open-source di librerie che abilita la data science e l’analisi accelerate da GPU. Al suo nucleo, RAPIDS è progettato per semplificare i flussi di lavoro sui dati sfruttando il massiccio parallelismo delle GPU NVIDIA per accelerare compiti tipicamente vincolati alla CPU.
All’interno di RAPIDS, cuDF è la libreria responsabile delle operazioni sui DataFrame. cuDF estende l’astrazione familiare del DataFrame alla memoria della GPU, consentendo l’integrazione nei flussi di lavoro senza ampie modifiche al codice. La libreria supporta tutte le principali operazioni che i data scientist eseguono sui DataFrame: filtro, aggregazione, join e ordinamento, tutto alimentato dalla GPU per la velocità.
NVIDIA e Polars hanno appena annunciato l’open beta del motore GPU di Polars per Python, basato su RAPIDS cuDF. Questa nuova funzionalità segna un passo avanti significativo per l’elaborazione dati ad alte prestazioni, offrendo fino a 13 volte flussi di lavoro più rapidi agli utenti Polars con GPU NVIDIA!
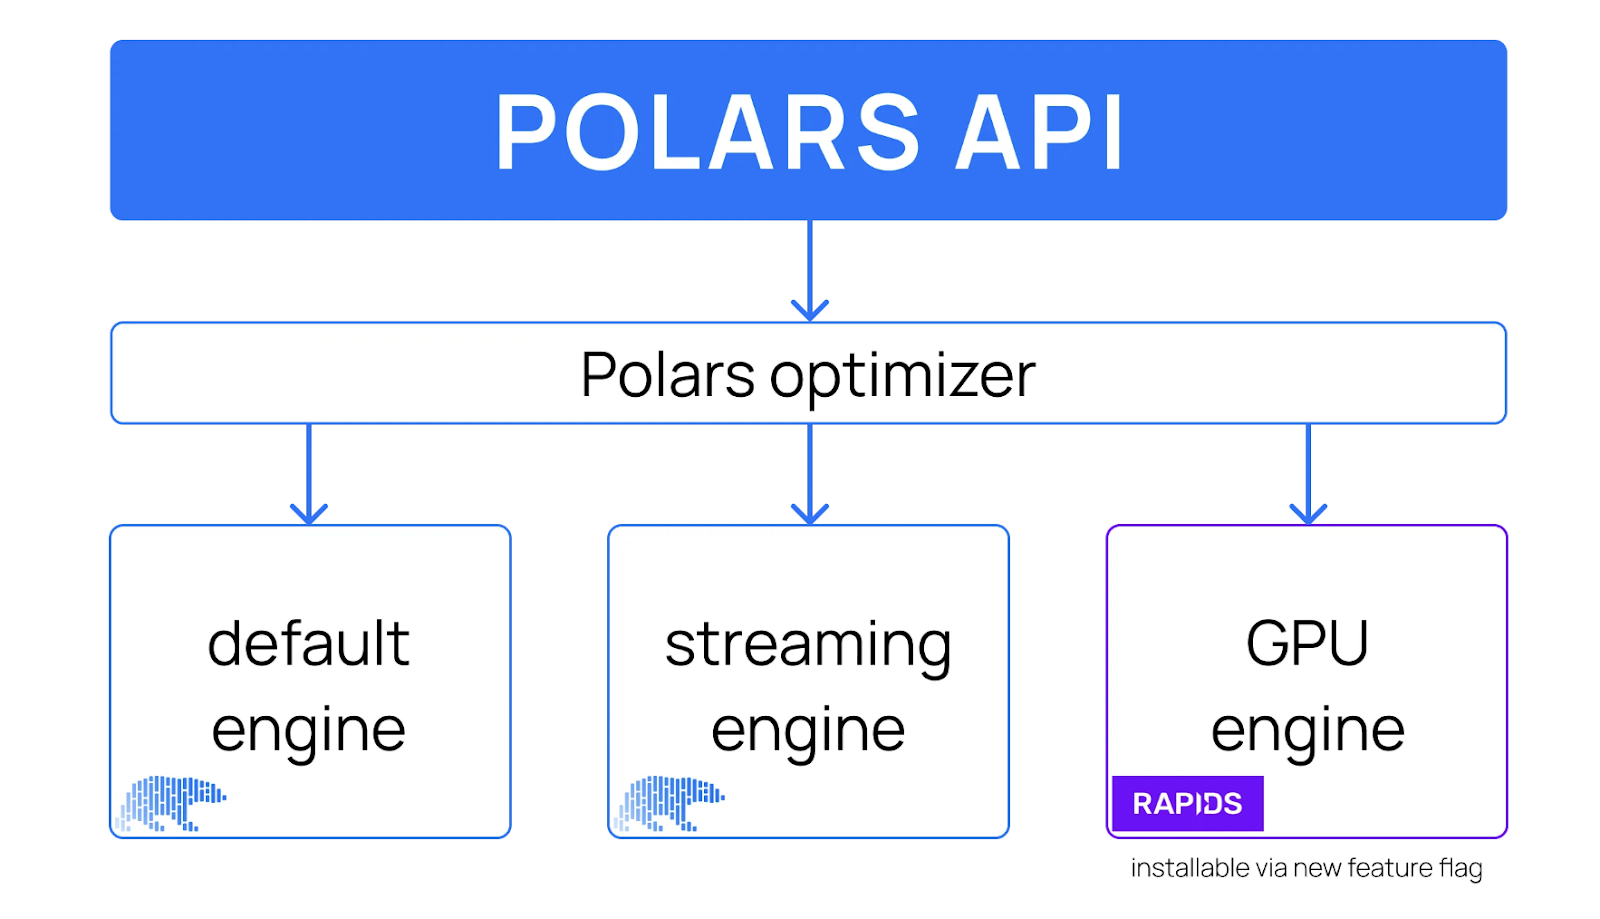
Progettazione di alto livello dell’API di Polars, incluso un motore GPU. Fonte immagine: Polars
Con l’aggiunta del motore GPU, gli utenti di Polars possono decidere su quale motore eseguire i loro carichi di lavoro. L’ottimizzatore di Polars supporta tutti i motori, determinando dinamicamente quali query possono essere eseguite su GPU o CPU.
Ora hai un po’ di contesto su Polars e sulla libreria NVIDIA RAPIDS cuDF, su come si integrano e come sono rese disponibili tramite l’API Python di Polars. Ma cosa significa tutto questo per sviluppatori e data scientist?
Ecco un riepilogo di ciò che abilita il motore GPU di Polars:
engine="gpu" all’operazione collect() della Lazy API di Polars, abilitando l’elaborazione su GPU senza modifiche significative al codice.E i risultati finora? Vediamo.
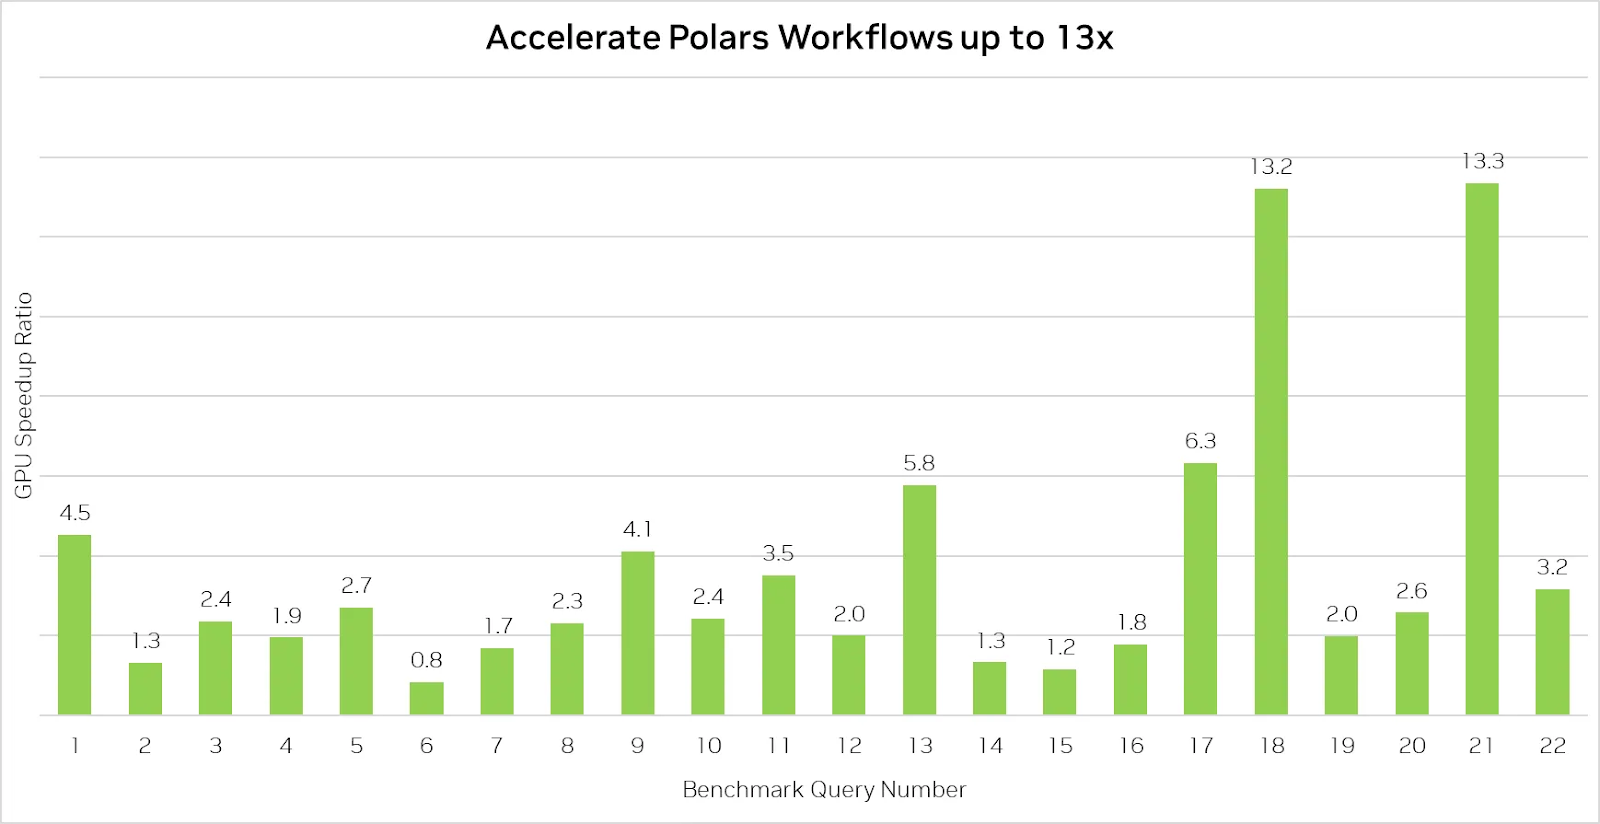
Il motore GPU di Polars accelera l’elaborazione dei dati fino a 13 volte. Fonte immagine: Polars
Il benchmark sopra dimostra le impressionanti capacità del motore GPU di Polars, accelerando le query fino a 13 volte.
Tuttavia, è importante notare che usare Polars su GPU non è sempre garantito essere più veloce rispetto alla CPU, in particolare per query semplici che non sono computazionalmente intensive. In questi casi, le prestazioni sono spesso limitate dalla velocità di lettura dei dati dal disco: quando le operazioni di input/output (I/O) sono il collo di bottiglia, l’accelerazione GPU offre un vantaggio minore.
Detto ciò, il motore GPU offre accelerazioni significative per operazioni dati più complesse, rendendolo uno strumento prezioso per i team che gestiscono grandi dataset o query con join, group-by e processamento di stringhe.
Una delle caratteristiche più interessanti di questa nuova integrazione è la sua flessibilità. Come accennato, l’ottimizzatore può passare tra esecuzione su CPU e su GPU in base alla complessità delle tue query. Ma come avviene esattamente questa transizione?
Quando esegui Polars sulla CPU, il motore segue una pipeline strutturata e altamente ottimizzata per eseguire le operazioni sui dati. Il processo prevede approssimativamente i seguenti passaggi:
Quando abiliti l’accelerazione GPU passando engine="gpu" al metodo .collect(), il processo in superficie resta essenzialmente lo stesso, ma con controlli e ottimizzazioni aggiuntivi dietro le quinte per determinare quanto carico può essere trasferito sulla GPU tramite cuDF:
Questo modello di esecuzione ibrido—dove GPU e CPU sono usate in tandem—rende Polars estremamente flessibile. Benefici dell’accelerazione GPU senza rinunciare alla compatibilità per le query non supportate su GPU. Il post di rilascio di Polars lo spiega in maggior dettaglio tecnico.
Finalmente, la parte più entusiasmante! In questa sezione ti guiderò nei passaggi necessari per configurare l’ambiente e iniziare a sfruttare l’elaborazione dati accelerata dalla GPU.
Il modo più semplice per partire è seguire questo notebook Google Colab.
Colab offre un uso GPU gratuito ma limitato, particolarmente utile se non hai accesso immediato a una GPU. Se usi il notebook fornito, partiamo dal punto 2 qui sotto, quindi puoi saltare i passaggi precedenti.
Prima di installare il motore GPU di Polars, assicurati che il tuo sistema soddisfi i requisiti per NVIDIA RAPIDS cuDF. Puoi consultare le specifiche di sistema necessarie, inclusa la compatibilità GPU e i requisiti dei driver, nella pagina di documentazione di RAPIDS.
Per iniziare con il motore GPU di Polars, è buona pratica creare un ambiente virtuale per isolare le dipendenze del progetto.
In questo esempio uso conda, ma sentiti libero di utilizzare il tuo gestore di pacchetti preferito.
Oltre a Python, puoi includere JupyterLab nell’ambiente per l’esplorazione e lo sviluppo interattivi dei dati, particolarmente utile per eseguire piccoli snippet di codice e analizzare i dataset al volo.
conda create -n polars-gpu -c conda-forge python=3.11 jupyterlabDopo aver creato l’ambiente virtuale, attivalo con:
conda activate polars-gpuOra abilitiamo l’accelerazione GPU installando Polars e il motore GPU. Questo imposterà anche cuDF e altre dipendenze necessarie per usare le GPU NVIDIA:
pip install -U polars[gpu] --extra-index-url=https://pypi.nvidia.comUna volta installato il motore GPU di Polars, usare Polars su GPU sarà simile a lavorare con la CPU, ma con risultati molto più rapidi per flussi di lavoro complessi o con molti dati.
Come spiegato in precedenza, il motore di Polars ottimizza automaticamente il piano di esecuzione, sfruttando appieno la GPU NVIDIA per velocizzare le operazioni e ridurre al minimo l’uso di memoria. Per le query che non supportano l’accelerazione GPU, il motore GPU di Polars esegue un fallback su CPU senza interruzioni, garantendo la continuità del flusso di lavoro.
Mettiamo il motore all’opera con alcuni semplici esempi!
Per questa dimostrazione useremo un dataset da 22 GB di transazioni finanziarie simulate da Kaggle. NVIDIA ospita il dataset su un bucket Google Cloud Storage (GCS), garantendo velocità di download elevate.
Per iniziare, scarica il dataset:
!wget https://storage.googleapis.com/rapidsai/polars-demo/transactions.parquet -O transactions.parquetPoiché questo dataset proviene da Kaggle, è soggetto a una licenza e termini d’uso specifici per i dataset Kaggle.
Carichiamo il dataset con Polars e ispezioniamo lo schema:
import polars as pl
from polars.testing import assert_frame_equal

transactions = pl.scan_parquet("transactions.parquet")
transactions.collect_schema()
Ecco l’output:
Schema([('CUST_ID', String),
        ('START_DATE', Date),
        ('END_DATE', Date),
        ('TRANS_ID', String),
        ('DATE', Date),
        ('YEAR', Int64),
        ('MONTH', Int64),
        ('DAY', Int64),
        ('EXP_TYPE', String),
        ('AMOUNT', Float64)])
Ora calcoliamo il volume totale delle transazioni sommando la colonna AMOUNT. Prima proviamo senza accelerazione GPU:
transactions.select(pl.col("AMOUNT").sum()).collect()Output:
AMOUNT
f64
3.6183e9
È un volume totale molto alto! Eseguiamo la stessa query sulla GPU:
transactions.select(pl.col("AMOUNT").sum()).collect(engine="gpu")Output:
AMOUNT
f64
3.6183e9
Per operazioni semplici come questa, CPU e GPU producono lo stesso risultato con velocità simili, perché la query non è abbastanza intensiva da trarre grande vantaggio dalla GPU. La GPU però brillerà con query più complesse.
Passiamo a una query più complessa. In questa query raggruppiamo le transazioni per ID cliente (CUST_ID), sommiamo gli importi totali delle transazioni e poi ordiniamo i risultati per i maggiori spender.
Per prima cosa, eseguiamola sulla CPU:
%%time
res_cpu = (
   transactions
   .group_by("CUST_ID")
   .agg(pl.col("AMOUNT").sum())
   .sort(by="AMOUNT", descending=True)
   .head()
   .collect()
)
res_cpu
Ecco l’output:
CPU times: user 4.63 s, sys: 3.75 s, total: 8.38 s
Wall time: 6.04 s
CUST_ID
AMOUNT
str
f64
"CA9UYOQ5DA"
2.0290e6
"CJUK2MTM5Q"
1.8115e6
"CYXX1NBIKL"
1.8082e6
"C6ILEYAYQ9"
1.7961e6
"CCNBC305GI"
1.7274e6
Ora eseguiamo la stessa query sulla GPU:
%%time
res_gpu = (
   transactions
   .group_by("CUST_ID")
   .agg(pl.col("AMOUNT").sum())
   .sort(by="AMOUNT", descending=True)
   .head()
   .collect(engine=”gpu”)
)
res_gpu
Output:
CPU times: user 347 ms, sys: 0 ns, total: 347 ms
Wall time: 353 ms
shape: (5, 2)
CUST_ID
AMOUNT
str
f64
"CA9UYOQ5DA"
2.0290e6
"CJUK2MTM5Q"
1.8115e6
"CYXX1NBIKL"
1.8082e6
"C6ILEYAYQ9"
1.7961e6
"CCNBC305GI"
1.7274e6
Come si vede, usare la GPU per query più complesse offre guadagni notevoli, riducendo il tempo di esecuzione da 6,04 secondi su CPU a soli 353 millisecondi su GPU!
Questo esempio dimostra la potente spinta prestazionale che il motore GPU di Polars offre per le operazioni su larga scala.
Puoi trovare esempi più avanzati nel relativo notebook Colab.
Il motore GPU di Polars, basato su NVIDIA RAPIDS cuDF, porta notevoli miglioramenti di velocità, con elaborazioni dei dati fino a 13 volte più rapide per operazioni complesse. Per dataset su larga scala, Polars offre un chiaro vantaggio rispetto alle librerie di DataFrame tradizionali.
Anche se non tutte le query trarranno lo stesso beneficio dall’accelerazione GPU, Polars resta uno strumento potente per chi lavora con grandi quantità di dati. La facilità di integrazione, unita al modello di esecuzione ibrido CPU-GPU, rende Polars un forte candidato per i flussi di lavoro moderni sui dati.
Se vuoi potenziare le tue competenze di manipolazione dei dati, soprattutto con Pandas, ti consiglio vivamente questi corsi:
Queste risorse ti daranno basi solide che si integrano con le potenti capacità di strumenti come Polars!
Approfondisci data science e Python con questi corsi!
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



