
NVIDIA RAPIDS cuDF इंटीग्रेशन को समझना
हाल के वर्षों में, जैसे-जैसे डेटासेट सैकड़ों मिलियन या अरबों पंक्तियों तक बढ़े हैं, तेज़ डेटा प्रोसेसिंग और विश्लेषण की मांग तेजी से बढ़ी है। इस चुनौती का समाधान करने के लिए, डेटा साइंस क्षेत्र में पारंपरिक CPU-आधारित प्रोसेसिंग से GPU-त्वरित कम्प्यूटिंग की ओर बदलाव देखा गया है। यहीं NVIDIA RAPIDS cuDF काम आता है।
NVIDIA RAPIDS एक ओपन-सोर्स लाइब्रेरी सूट है जो GPU-त्वरित डेटा साइंस और एनालिटिक्स सक्षम करता है। RAPIDS का मूल उद्देश्य NVIDIA GPUs की विशाल पैरेललिज़्म का उपयोग करके उन कार्यों को त्वरित करना है जो सामान्यतः CPU-बाउंड होते हैं, और इस तरह डेटा वर्कफ़्लोज़ को सरल बनाना है।
RAPIDS के भीतर, cuDF वह लाइब्रेरी है जो DataFrame ऑपरेशंस के लिए जिम्मेदार है। cuDF परिचित DataFrame एब्स्ट्रैक्शन को GPU मेमोरी तक बढ़ाता है, जिससे व्यापक कोड बदलाव के बिना डेटा वर्कफ़्लोज़ में एकीकरण संभव हो जाता है। यह लाइब्रेरी DataFrames पर डेटा वैज्ञानिकों द्वारा किए जाने वाले सभी प्रमुख ऑपरेशंस—फ़िल्टरिंग, एग्रीगेशन, मर्जिंग और सॉर्टिंग—का समर्थन करती है, जिन्हें गति के लिए GPU द्वारा संचालित किया जाता है।
NVIDIA और Polars ने अभी-अभी RAPIDS cuDF द्वारा संचालित Python Polars GPU इंजन का ओपन बीटा रिलीज़ घोषित किया है। यह नई सुविधा उच्च-प्रदर्शन डेटा प्रोसेसिंग में एक महत्वपूर्ण छलांग है, जो NVIDIA GPUs के साथ Polars उपयोगकर्ताओं के लिए वर्कफ़्लोज़ को 13x तक तेज़ कर देती है!
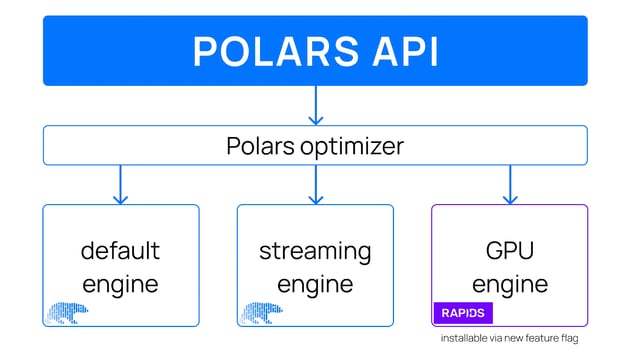
GPU इंजन सहित Polars API का उच्च-स्तरीय डिज़ाइन। चित्र स्रोत: Polars
GPU इंजन के जुड़ने के साथ, Polars उपयोगकर्ता यह तय कर सकते हैं कि अपने डेटा वर्कलोड्स किस इंजन पर चलाएँ। Polars ऑप्टिमाइज़र सभी इंजनों का समर्थन करता है, और डायनेमिक रूप से निर्धारित करता है कि कौन सी क्वेरियाँ GPU या CPU पर चल सकती हैं।
Polars GPU इंजन: एक गेम-चेंजर
अब आपके पास Polars और NVIDIA RAPIDS cuDF लाइब्रेरी के बारे में संदर्भ है—कैसे दोनों एकीकृत हैं और Python Polars API के माध्यम से उपलब्ध हैं। लेकिन इसका डेवलपर्स और डेटा वैज्ञानिकों के लिए क्या अर्थ है?
यहाँ Polars GPU इंजन द्वारा सक्षम चीज़ों का सार है:
- Python Polars Lazy API के साथ इंटीग्रेशन: उपयोगकर्ता Polars की Lazy API में
engine="gpu"कोcollect()ऑपरेशन में पास करके आसानी से GPU प्रोसेसिंग सक्षम कर सकते हैं—बिना बड़े कोड बदलाव के। - बड़े डेटासेट्स का इंटरैक्टिव प्रोसेसिंग: GPU इंजन सैकड़ों मिलियन पंक्तियों के डेटा को प्रोसेस करना इंटरैक्टिव जैसा महसूस कराने के लिए डिज़ाइन किया गया है। केवल एक GPU के साथ, आप ऐसे विशाल डेटा वॉल्यूम संभाल सकते हैं जो अन्यथा अधिक जटिल और धीले समाधान मांगते।
- दक्षता के लिए अनुकूलित: Polars GPU इंजन निष्पादन को यथासंभव कुशल बनाने के लिए Polars ऑप्टिमाइज़र का पूर्ण उपयोग करता है, प्रोसेसिंग समय और मेमोरी उपयोग को कम करता है।
- सुगम CPU फॉलबैक: जिन मामलों में कुछ क्वेरियाँ GPU पर समर्थित नहीं होतीं, इंजन में CPU फॉलबैक शामिल है। इससे वर्कफ़्लो बाधित नहीं होता और आवश्यकतानुसार अपने-आप CPU प्रोसेसिंग पर लौट आता है।
तो अब तक के नतीजे क्या हैं? आइए देखें।
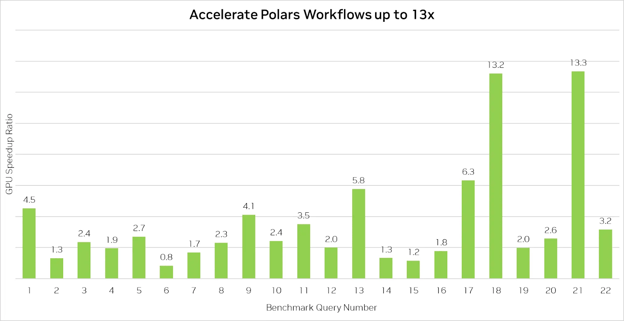
Polars GPU इंजन डेटा प्रोसेसिंग को 13x तक तेज़ करता है। चित्र स्रोत: Polars
ऊपर का बेंचमार्क दर्शाता है कि Polars GPU इंजन क्वेरियों को 13x तक तेज़ करके कितनी प्रभावशाली क्षमता प्रदान करता है।
हालाँकि, यह ध्यान देना महत्वपूर्ण है कि GPU पर Polars का उपयोग हमेशा CPU की तुलना में तेज़ होने की गारंटी नहीं है—ख़ासकर सरल क्वेरियों के लिए जो कम्प्यूट-इंटेंसिव नहीं हैं। ऐसे मामलों में, प्रदर्शन अक्सर डिस्क से डेटा पढ़ने की गति से सीमित होता है, यानी जब इनपुट/आउटपुट (I/O) ऑपरेशंस मुख्य बाधा होते हैं तो GPU त्वरक का लाभ कम मिलता है।
फिर भी, GPU इंजन अधिक जटिल डेटा ऑपरेशंस के लिए उल्लेखनीय स्पीडअप देता है, जिससे यह बड़ी मात्रा के डेटासेट्स या joins, group-bys और स्ट्रिंग प्रोसेसिंग वाली क्वेरियों को संभालने वाली टीमों के लिए एक मूल्यवान टूल बन जाता है।
CPU और GPU के बीच इंटरेक्शन
इस नए इंटीग्रेशन की सबसे आकर्षक विशेषताओं में से एक इसकी लचीलापन है। जैसा कि पहले बताया गया, ऑप्टिमाइज़र आपकी क्वेरियों की जटिलता के आधार पर CPU और GPU निष्पादन के बीच स्विच कर सकता है। लेकिन यह ट्रांज़िशन वास्तव में कैसे काम करता है?
GPU त्वरक के बिना Polars
जब Polars CPU पर चलता है, इंजन डेटा ऑपरेशंस को निष्पादित करने के लिए एक संरचित और अत्यधिक अनुकूलित पाइपलाइन का पालन करता है। यह प्रक्रिया मोटे तौर पर निम्नलिखित चरणों में होती है:
- DSL (डोमेन-स्पेसिफिक लैंग्वेज): Polars इंजन सबसे पहले आपके कोड से एक संरचित क्वेरी रूपरेखा बनाता है, जो किसी प्रोग्रामिंग लैंग्वेज सिंटैक्स ट्री के समान होती है। यह रूपरेखा उन ऑपरेशंस के क्रम को परिभाषित करती है जिन्हें आप करना चाहते हैं, जैसे फ़िल्टरिंग, ग्रुपिंग और एग्रीगेशन।
- IR (इंटरमीडिएट रिप्रेज़ेंटेशन): इसके बाद, Polars क्वेरी रूपरेखा को एक विस्तृत निष्पादन योजना में बदलता है, यह सुनिश्चित करते हुए कि सभी ऑपरेशंस सही हैं और डेटा स्कीमा मेल खाते हैं। यह चरण इस बात की नींव रखता है कि Polars डेटा को कैसे प्रोसेस करेगा।
- ऑप्टिमाइज़र: ऑप्टिमाइज़र निष्पादन योजना को ऑपरेशंस के क्रम को पुनर्व्यवस्थित करके और अनावश्यक चरणों को हटाकर सुधारता है। उदाहरण के लिए, फ़िल्टरिंग को जॉइन्स या एग्रीगेशंस से पहले ले जाया जा सकता है ताकि प्रक्रिया के शुरुआती चरण में ही डेटासेट का आकार कम हो। यह ऑप्टिमाइज़ेशन सुनिश्चित करता है कि निष्पादन से पहले योजना यथासंभव कुशल हो।
- ऑप्टिमाइज़्ड IR: ऑप्टिमाइज़ेशन के बाद, बेहतर की गई निष्पादन योजना को अंतिम रूप दिया जाता है और Polars इंजन द्वारा प्रोसेस करने के लिए तैयार होती है। यही वह ब्लूप्रिंट है जिसके अनुसार Polars डेटा पर प्रत्येक ऑपरेशन निष्पादित करेगा।
- Polars इन-मेमोरी इंजन (CPU निष्पादन): अंत में, Polars इन-मेमोरी इंजन पूरी तरह CPU पर ऑप्टिमाइज़्ड योजना को निष्पादित करता है। Polars के उच्च-प्रदर्शन ऑप्टिमाइज़ेशन के बावजूद, यदि आप बड़े डेटासेट्स के साथ काम कर रहे हैं, तो यह चरण काफ़ी समय ले सकता है क्योंकि CPUs डेटा को क्रमिक रूप से या सीमित पैरेललिज़्म के साथ प्रोसेस करते हैं।
GPU त्वरक के साथ Polars
जब आप engine="gpu" को .collect() मेथड में पास करके GPU त्वरक सक्षम करते हैं, तो सतह पर प्रक्रिया मूलतः वही रहती है, लेकिन पर्दे के पीछे अतिरिक्त जाँचें और ऑप्टिमाइज़ेशन होते हैं ताकि तय किया जा सके कि cuDF के माध्यम से वर्कलोड का कितना हिस्सा GPU को ऑफ़लोड किया जा सकता है:
- DSL (डोमेन-स्पेसिफिक लैंग्वेज): CPU मोड की तरह ही, Polars आपके कोड से एक संरचित क्वेरी रूपरेखा बनाकर शुरू करता है। आप CPU या GPU पर चला रहे हों, रूपरेखा समान रहती है और आपके इच्छित ऑपरेशंस को कैप्चर करती है।
- IR (इंटरमीडिएट रिप्रेज़ेंटेशन): Polars रूपरेखा को एक्ज़ीक्यूशन प्लान में बदलता है, शुद्धता जाँचता है और सुनिश्चित करता है कि डेटा स्कीमा मान्य हैं। इस चरण में IR तटस्थ रहता है, क्योंकि अभी यह तय नहीं हुआ होता कि ऑपरेशंस CPU संभालेगा या GPU।
- ऑप्टिमाइज़र: ऑप्टिमाइज़र CPU निष्पादन की तरह ही काम करता है—अधिकतम दक्षता के लिए ऑपरेशंस को पुनर्व्यवस्थित करता है और अनावश्यक चरणों को हटाता है। इस बिंदु पर, योजना अभी भी सामान्य निष्पादन के लिए ऑप्टिमाइज़्ड रहती है।
- ऑप्टिमाइज़्ड IR: CPU निष्पादन की तरह, ऑप्टिमाइज़्ड योजना को अंतिम रूप दिया जाता है। हालाँकि, GPU त्वरक सक्षम होने पर, अब इंजन यह जाँचता है कि इस योजना के किन हिस्सों को GPU पर ऑफ़लोड किया जा सकता है।
- cuDF कॉलबैक (GPU जाँच): यहीं जादू होता है! cuDF कॉलबैक तय करता है कि GPU एक्ज़ीक्यूशन प्लान को संभाल सकता है या नहीं। कुछ ऑपरेशंस स्वाभाविक रूप से GPU त्वरक के लिए उपयुक्त होते हैं, जबकि कुछ नहीं। यह कॉलबैक समर्थित ऑपरेशंस के लिए योजना को GPU का उपयोग करने हेतु संशोधित करता है।
- Polars इन-मेमोरी इंजन (GPU और CPU निष्पादन): अंत में, Polars इन-मेमोरी इंजन योजना को निष्पादित करता है। GPU वे क्वेरियाँ संभालता है जिन्हें GPU-त्वरित किया जा सकता है, जबकि जिन्हें GPU संभाल नहीं सकता, वे CPU पर फॉलबैक हो जाती हैं।
यह हाइब्रिड निष्पादन मॉडल—जहाँ GPU और CPU साथ मिलकर उपयोग होते हैं—Polars को अत्यधिक लचीला बनाता है। आपको GPU त्वरक का लाभ मिलता है, बिना उन क्वेरियों की संगतता गँवाए जो GPU पर समर्थित नहीं हैं। Polars का रिलीज़ ब्लॉग पोस्ट इसे तकनीकी रूप से और गहराई में समझाता है।
Polars GPU इंजन के साथ शुरुआत करना
आख़िरकार, सबसे रोमांचक हिस्सा! इस खंड में, मैं आपके वातावरण को सेटअप करने और GPU-त्वरित डेटा प्रोसेसिंग का लाभ उठाने के लिए आवश्यक चरणों से गुज़रूँगा।
सबसे आसान तरीका है इस Google Colab नोटबुक के साथ आगे बढ़ना।
Colab सीमित मुफ़्त GPU उपयोग प्रदान करता है, जो विशेष रूप से तब उपयोगी है जब आपको तुरंत GPU तक पहुँच न हो। यदि आप दिए गए नोटबुक का उपयोग कर रहे हैं, तो हम नीचे दिए गए चरण 2 से शुरू करते हैं, इसलिए आप पिछले चरणों को छोड़ सकते हैं।
पूर्वापेक्षाएँ
Polars GPU इंजन इंस्टॉल करने से पहले, सुनिश्चित करें कि आपका सिस्टम NVIDIA RAPIDS cuDF की आवश्यकताओं को पूरा करता है। आप आवश्यक सिस्टम विनिर्देश—जिसमें GPU संगतता और ड्राइवर आवश्यकताएँ शामिल हैं—RAPIDS दस्तावेज़ पृष्ठ पर देख सकते हैं।
1. एक वर्चुअल एनवायरनमेंट बनाएँ (अनुशंसित)
Polars GPU इंजन के साथ शुरुआत करने के लिए, अपने प्रोजेक्ट डिपेंडेंसीज़ को आइसोलेट करने हेतु वर्चुअल एनवायरनमेंट बनाना सर्वोत्तम अभ्यास है।
मैं इस उदाहरण में conda का उपयोग करता हूँ, लेकिन आप अपनी पसंद के पैकेज मैनेजर का उपयोग कर सकते हैं।
Python के अलावा, आप इंटरैक्टिव डेटा एक्सप्लोरेशन और विकास के लिए वातावरण में JupyterLab शामिल कर सकते हैं, जो छोटे कोड स्निपेट्स चलाने और चलते-फिरते डेटासेट्स का विश्लेषण करने के लिए विशेष रूप से उपयोगी है।
conda create -n polars-gpu -c conda-forge python=3.11 jupyterlabवर्चुअल एनवायरनमेंट बनाने के बाद, इसे इस प्रकार सक्रिय करें:
conda activate polars-gpu2. Polars GPU इंजन इंस्टॉल करें
अब, Polars और GPU इंजन इंस्टॉल करके GPU त्वरक सक्षम करें। यह cuDF और NVIDIA GPUs के उपयोग के लिए आवश्यक अन्य डिपेंडेंसीज़ भी सेटअप करेगा:
pip install -U polars[gpu] --extra-index-url=https://pypi.nvidia.comPolars GPU इंजन इंस्टॉल हो जाने के बाद, GPU पर Polars का उपयोग करना CPU जैसा ही महसूस होगा—लेकिन जटिल या डेटा-भारी वर्कफ़्लोज़ के लिए कहीं तेज़ परिणामों के साथ।
जैसा कि पहले समझाया गया, Polars इंजन अपने-आप निष्पादन योजना को ऑप्टिमाइज़ करता है, ऑपरेशंस को तेज़ करने और मेमोरी उपयोग को कम करने के लिए NVIDIA GPU का पूर्ण उपयोग करता है। जिन क्वेरियों में GPU त्वरक समर्थित नहीं है, उनके लिए Polars GPU इंजन में सुगम CPU फॉलबैक है, ताकि वर्कफ़्लो बिना रुकावट जारी रहे।
आइए कुछ सरल उदाहरणों के साथ इंजन को कार्रवाई में देखें!
Polars GPU इंजन के साथ कुछ क्वेरियाँ चलाना
इस प्रदर्शन के लिए, हम Kaggle से सिम्युलेटेड वित्तीय लेनदेन का 22GB डेटासेट उपयोग करेंगे। NVIDIA इस डेटासेट को Google Cloud Storage (GCS) बकेट पर होस्ट करता है, जिससे तेज़ डाउनलोड स्पीड सुनिश्चित होती है।
शुरू करने के लिए, डेटासेट डाउनलोड करें:
!wget https://storage.googleapis.com/rapidsai/polars-demo/transactions.parquet -O transactions.parquetक्योंकि यह डेटासेट Kaggle से प्राप्त किया गया है, यह Kaggle डेटासेट-विशिष्ट लाइसेंस और उपयोग की शर्तों द्वारा शासित है।
आइए Polars का उपयोग करके डेटासेट लोड करें और स्कीमा देखें:
import polars as pl
from polars.testing import assert_frame_equal
transactions = pl.scan_parquet("transactions.parquet")
transactions.collect_schema()आउटपुट इस प्रकार है:
Schema([('CUST_ID', String),
('START_DATE', Date),
('END_DATE', Date),
('TRANS_ID', String),
('DATE', Date),
('YEAR', Int64),
('MONTH', Int64),
('DAY', Int64),
('EXP_TYPE', String),
('AMOUNT', Float64)])अब, AMOUNT कॉलम को जोड़कर कुल लेनदेन वॉल्यूम निकालें। पहले, इसे GPU त्वरक के बिना आज़माएँ:
transactions.select(pl.col("AMOUNT").sum()).collect()आउटपुट:
AMOUNT
f64
3.6183e9यह काफ़ी ऊँचा कुल लेनदेन वॉल्यूम है! वही क्वेरी GPU पर चलाएँ:
transactions.select(pl.col("AMOUNT").sum()).collect(engine="gpu")आउटपुट:
AMOUNT
f64
3.6183e9इस तरह के सरल ऑपरेशंस में, CPU और GPU समान परिणाम समान गति से देते हैं, क्योंकि क्वेरी GPU त्वरक से विशेष लाभ लेने जितनी कम्प्यूट-इंटेंसिव नहीं है। लेकिन अधिक जटिल क्वेरियों को संभालते समय GPU चमकता है।
अब, एक अधिक जटिल क्वेरी पर चलते हैं। इस क्वेरी में, हम ग्राहक आईडी (CUST_ID) के अनुसार ट्रांज़ैक्शंस को समूहित करते हैं, कुल लेनदेन राशि जोड़ते हैं, और फिर सबसे अधिक खर्च करने वालों के अनुसार परिणामों को सॉर्ट करते हैं।
पहले, हम इसे CPU पर चलाएँगे:
%%time
res_cpu = (
transactions
.group_by("CUST_ID")
.agg(pl.col("AMOUNT").sum())
.sort(by="AMOUNT", descending=True)
.head()
.collect()
)
res_cpuआउटपुट इस प्रकार है:
CPU times: user 4.63 s, sys: 3.75 s, total: 8.38 s
Wall time: 6.04 s
CUST_ID
AMOUNT
str
f64
"CA9UYOQ5DA"
2.0290e6
"CJUK2MTM5Q"
1.8115e6
"CYXX1NBIKL"
1.8082e6
"C6ILEYAYQ9"
1.7961e6
"CCNBC305GI"
1.7274e6अब, वही क्वेरी GPU पर चलाएँ:
%%time
res_gpu = (
transactions
.group_by("CUST_ID")
.agg(pl.col("AMOUNT").sum())
.sort(by="AMOUNT", descending=True)
.head()
.collect(engine=”gpu”)
)
res_gpuआउटपुट:
CPU times: user 347 ms, sys: 0 ns, total: 347 ms
Wall time: 353 ms
shape: (5, 2)
CUST_ID
AMOUNT
str
f64
"CA9UYOQ5DA"
2.0290e6
"CJUK2MTM5Q"
1.8115e6
"CYXX1NBIKL"
1.8082e6
"C6ILEYAYQ9"
1.7961e6
"CCNBC305GI"
1.7274e6जैसा कि हम देख सकते हैं, अधिक जटिल क्वेरियों के लिए GPU का उपयोग उल्लेखनीय प्रदर्शन लाभ देता है—CPU पर 6.04 सेकंड से घटकर GPU पर मात्र 353 मिलीसेकंड में निष्पादन समय आ जाता है!
यह उदाहरण दिखाता है कि बड़े पैमाने के डेटा ऑपरेशंस के लिए Polars GPU इंजन कितना शक्तिशाली प्रदर्शन बढ़ावा देता है।
आप अधिक उन्नत उदाहरण साथ वाली Colab नोटबुक में पा सकते हैं।
निष्कर्ष
NVIDIA RAPIDS cuDF द्वारा संचालित Polars GPU इंजन जटिल ऑपरेशंस के लिए 13x तक तेज़ डेटा प्रोसेसिंग के साथ प्रभावशाली गति सुधार लाता है। बड़े पैमाने के डेटासेट्स के लिए, Polars पारंपरिक DataFrame लाइब्रेरीज़ पर स्पष्ट बढ़त देता है।
यद्यपि हर क्वेरी को GPU त्वरक से समान लाभ नहीं मिलेगा, फिर भी बड़े डेटासेट्स के साथ काम करने वाले किसी भी व्यक्ति के लिए Polars एक शक्तिशाली टूल बना रहता है। इंटीग्रेशन में सहजता और इसका हाइब्रिड CPU-GPU निष्पादन मॉडल Polars को आधुनिक डेटा वर्कफ़्लोज़ के लिए एक मज़बूत विकल्प बनाता है।
यदि आप विशेष रूप से Pandas के साथ अपनी डेटा मैनिप्युलेशन कौशल विकसित करने में रुचि रखते हैं, तो मैं निम्नलिखित कोर्सेज़ देखने की अत्यधिक अनुशंसा करता हूँ:
- Data Manipulation with Pandas
- Streamlined Data Ingestion with Pandas
- Writing Efficient Code with Pandas
ये संसाधन आपको एक ठोस नींव देंगे, जो Polars जैसे टूल्स की शक्तिशाली क्षमताओं को पूरक करती है!
FAQs
Polars में GPU त्वरक से किस प्रकार की क्वेरियों को सबसे अधिक लाभ मिलता है?
Polars में GPU त्वरक सबसे अधिक स्पीडअप उन कम्प्यूट-बाउंड क्वेरियों के लिए देता है जिनमें joins, group-bys और स्ट्रिंग प्रोसेसिंग जैसी प्रक्रियाएँ शामिल होती हैं। इन कार्यों में भारी कम्प्यूटेशन की आवश्यकता होती है और यहीं GPU की पैरेलल प्रोसेसिंग शक्ति वास्तव में चमकती है—CPU प्रोसेसिंग की तुलना में 13x तक स्पीडअप प्रदान करते हुए। हालाँकि, सरल या I/O-बाउंड क्वेरियों में उतना सुधार नहीं दिख सकता।
क्या GPU त्वरक हमेशा CPU से तेज़ होगा?
नहीं, हमेशा नहीं। जबकि GPU त्वरक जटिल एग्रीगेशंस और जोइन्स जैसी कम्प्यूट-हेवी प्रक्रियाओं को काफ़ी तेज़ कर देता है, I/O-बाउंड क्वेरियाँ—जहाँ बाधा डिस्क पर डेटा पढ़ने-लिखने की गति होती है—में उतना लाभ नहीं होता। ऐसे मामलों में GPU, CPU पर उल्लेखनीय प्रदर्शन बढ़त नहीं देता और निष्पादन समय समान रह सकता है।
क्या GPU इंजन का उपयोग करने के लिए मुझे अपनी Polars क्वेरियाँ फिर से लिखनी होंगी?
नहीं, आपको अपनी क्वेरियाँ फिर से लिखने की आवश्यकता नहीं है। Polars GPU इंजन मौजूदा Polars वर्कफ़्लोज़ के साथ सहजता से एकीकृत होता है। आपको बस engine="gpu" को collect() मेथड में पास करना है ताकि GPU त्वरक सक्षम हो जाए। यदि क्वेरी का कोई भाग GPU इंजन द्वारा समर्थित नहीं है, तो वह अपने-आप CPU पर फॉलबैक हो जाएगा—आपको कुछ भी बदलने की आवश्यकता नहीं है।
क्या मैं किसी भी मशीन पर Polars GPU इंजन का उपयोग कर सकता/सकती हूँ?
Polars GPU इंजन का उपयोग करने के लिए आपको ऐसी मशीन चाहिए जिसमें NVIDIA GPUs हों जो RAPIDS cuDF (CUDA-X लाइब्रेरीज़ का हिस्सा) के साथ संगत हों। यदि आपकी मशीन में संगत GPU नहीं है, तो आप Amazon SageMaker Studio Lab, Google Colab या PaperSpace जैसे क्लाउड सेवाओं का उपयोग कर सकते हैं जो GPU संसाधनों तक मुफ़्त या सशुल्क पहुँच प्रदान करती हैं।

थालिया बैरेरा DataCamp में सीनियर डेटा साइंस एडिटर हैं, जिनके पास कंप्यूटर साइंस में मास्टर’s डिग्री और सॉफ्टवेयर व डेटा इंजीनियरिंग में दस से अधिक वर्षों का अनुभव है। थालिया ब्लॉग पोस्ट, ट्यूटोरियल, और वीडियो कोर्स के माध्यम से इंजीनियरों और डेटा साइंटिस्ट्स के लिए तकनीकी अवधारणाओं को सरल बनाना पसंद करती हैं।
हाल ही में, मुझे NVIDIA RAPIDS cuDF द्वारा संचालित Polars GPU इंजन का ओपन बीटा रिलीज़ से पहले शुरुआती एक्सेस पाने का सौभाग्य मिला। यह अत्याधुनिक सुविधा NVIDIA GPUs के साथ Polars ऑपरेशंस को 13x तक तेज़ करके डेटा वर्कफ़्लो को बदलने की क्षमता रखती है। यदि आप Python में बड़े पैमाने के डेटासेट्स के साथ काम करते हैं, तो यह आपके लिए एक गेम-चेंजर साबित हो सकता है।
इस ब्लॉग पोस्ट में, मैं नए Polars GPU इंजन के बारे में वह सब समझाऊंगा जो आपको जानना चाहिए और शुरुआत करने के लिए चरण-दर-चरण मार्गदर्शिका दूंगा!
Polars: एक उच्च-प्रदर्शन DataFrame लाइब्रेरी
अधिकांश डेटा साइंस वर्कफ़्लोज़ के केंद्र में DataFrame होता है—एक सारणीबद्ध डेटा संरचना जो स्ट्रक्चर्ड डेटा को संभालने के लिए लचीली और सहज दोनों है। सरल शब्दों में, डेटा साइंस में हर कोई DataFrames के साथ काम कर चुका है।
DataFrames डेटा को साफ़ करने, फ़िल्टर करने, समूहित करने और ट्रांसफ़ॉर्म करने के लिए परिचित और सुसंगत इंटरफ़ेस प्रदान करते हुए आसान डेटा हेरफेर, अन्वेषण और विश्लेषण की अनुमति देते हैं।
हालाँकि, बिग डेटा के संदर्भ में, पारंपरिक DataFrame लाइब्रेरीज़ प्रदर्शन और स्केलेबिलिटी में कमी कर सकती हैं—यहीं पर Polars सामने आता है।
Polars एक तेज़, कुशल DataFrame लाइब्रेरी है जो उच्च-प्रदर्शन डेटा प्रोसेसिंग के लिए शीघ्र ही शीर्ष पसंद बन गई है। Rust में शून्य से लिखी गई, Polars को हार्डवेयर के क़रीब काम करने के लिए डिज़ाइन किया गया है, जो बाहरी निर्भरताओं पर भरोसा किए बिना गति और संसाधन उपयोग को अनुकूलित करता है।
Python में लाइब्रेरी के साथ शुरुआत करने के लिए Introduction to Polars ब्लॉग पोस्ट एक उत्कृष्ट संसाधन है।
सबसे लोकप्रिय DataFrame लाइब्रेरीज़ के प्रदर्शन की तुलना। चित्र स्रोत: Polars
ऊपर दिखाए गए Polars द्वारा प्रकाशित बेंचमार्क परिणाम दर्शाते हैं कि अलग-अलग क्वेरियों में Polars लगातार Pandas, Modin, PySpark और Dask जैसी अन्य लाइब्रेरीज़ से बेहतर प्रदर्शन करता है। ये परिणाम उच्च-प्रदर्शन डेटा प्रोसेसिंग के लिए सबसे तेज़ विकल्प के रूप में Polars की ताकत को उजागर करते हैं।
लेकिन यह संभव कैसे है? ये कुछ विशेषताएँ हैं जो Polars को बेहद तेज़ बनाती हैं:
और Polars GPU इंजन की हाल की ओपन बीटा घोषणा के साथ, यह अब और भी तेज़ होने वाला है!