
Kursus
Python Tingkat Menengah untuk Pengembang
2 jam
70.2K
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GoogleBaru-baru ini, saya berkesempatan mendapatkan akses awal ke mesin GPU Polars, yang didukung oleh NVIDIA RAPIDS cuDF, sebelum rilis open beta-nya. Fitur mutakhir ini berpotensi mengubah alur kerja data dengan mempercepat operasi Polars hingga 13x menggunakan GPU NVIDIA. Jika Anda bekerja dengan dataset berskala besar di Python, ini adalah terobosan yang tak boleh dilewatkan.
Dalam tulisan ini, saya akan menjelaskan semua yang perlu Anda ketahui tentang mesin GPU Polars yang baru dan memberikan panduan langkah demi langkah untuk membantu Anda memulai!
Di inti sebagian besar alur kerja data science terdapat DataFrame, sebuah struktur data tabular yang fleksibel dan intuitif untuk menangani data terstruktur. Singkatnya, semua orang di data science pasti pernah bekerja dengan DataFrame.
DataFrame memungkinkan manipulasi, eksplorasi, dan analisis data dengan mudah, menyediakan antarmuka yang familier dan konsisten untuk pembersihan, pemfilteran, pengelompokan, dan transformasi data.
Namun, dalam konteks big data, pustaka DataFrame tradisional bisa kurang bertenaga dan tidak skalabel—di sinilah Polars hadir.
Polars adalah pustaka DataFrame yang cepat dan efisien yang dengan cepat menjadi pilihan utama untuk pemrosesan data berkinerja tinggi. Ditulis dari nol dalam Rust, Polars dirancang untuk bekerja dekat dengan perangkat keras, mengoptimalkan kecepatan dan penggunaan sumber daya tanpa bergantung pada dependensi eksternal.
Tulisan Pengenalan Polars adalah sumber yang sangat baik untuk memulai menggunakan pustaka ini di Python.
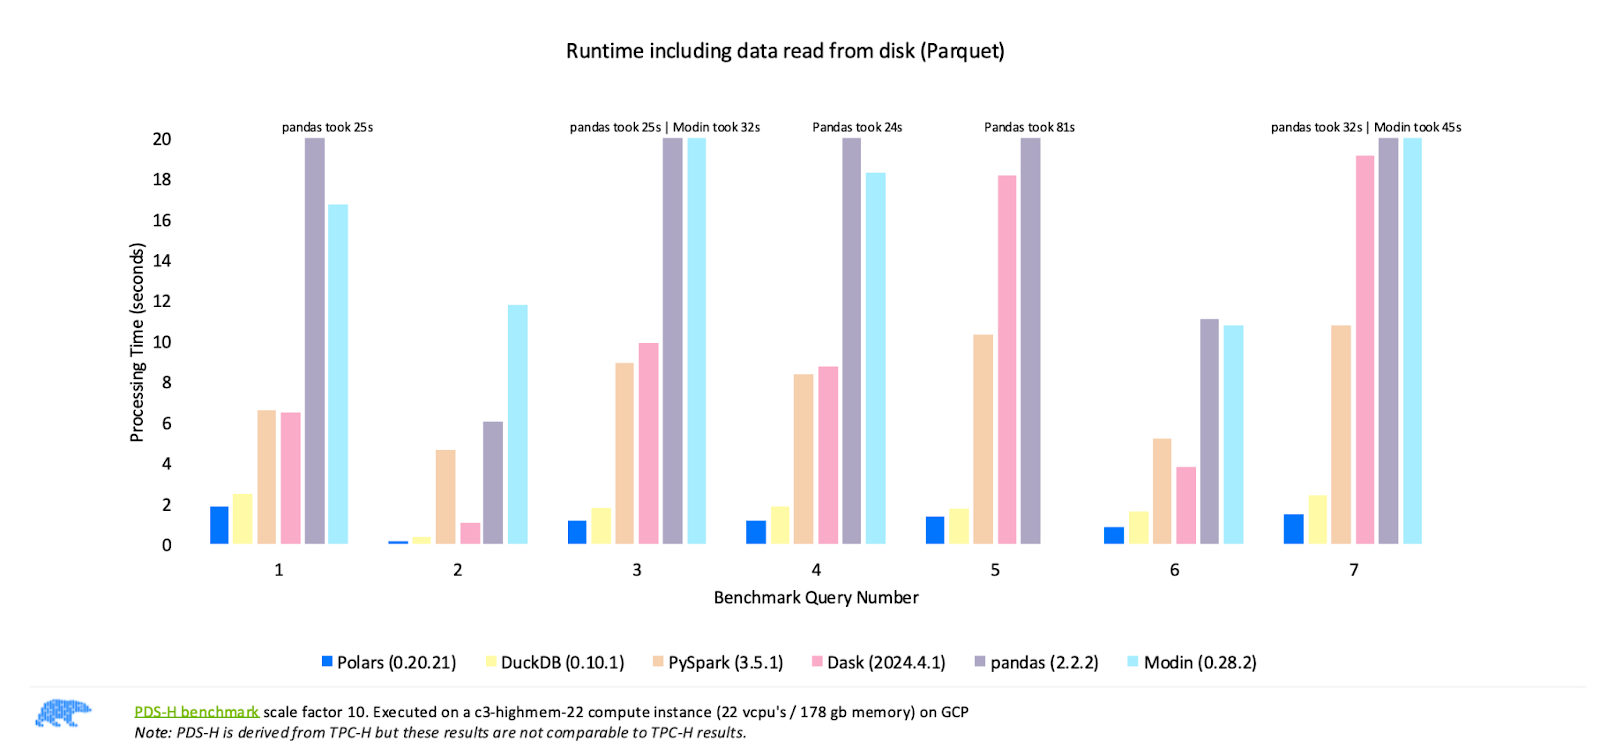
Perbandingan kinerja pustaka DataFrame paling populer. Sumber gambar: Polars
Hasil benchmark yang dipublikasikan oleh Polars, seperti pada gambar di atas, menunjukkan bahwa Polars secara konsisten mengungguli pustaka lain seperti Pandas, Modin, PySpark, dan Dask di berbagai kueri. Hasil ini menegaskan kekuatan Polars sebagai opsi tercepat untuk pemrosesan data berkinerja tinggi.
Lalu bagaimana itu bisa terjadi? Berikut beberapa fitur yang membuat Polars sangat cepat:
Dan dengan pengumuman open beta terbaru untuk mesin GPU Polars, performanya akan menjadi semakin cepat!
Permintaan untuk pemrosesan dan analisis data yang lebih cepat meningkat pesat dalam beberapa tahun terakhir seiring dataset berkembang hingga ratusan juta bahkan miliaran baris. Untuk mengatasi tantangan ini, bidang data science semakin beralih dari pemrosesan berbasis CPU tradisional ke komputasi yang dipercepat GPU. Di sinilah NVIDIA RAPIDS cuDF berperan.
NVIDIA RAPIDS adalah rangkaian pustaka open-source yang memungkinkan data science dan analitik dipercepat GPU. Intinya, RAPIDS dirancang untuk menyederhanakan alur kerja data dengan memanfaatkan paralelisme masif GPU NVIDIA guna mempercepat tugas-tugas yang biasanya terikat CPU.
Di dalam RAPIDS, cuDF adalah pustaka yang bertanggung jawab atas operasi DataFrame. cuDF memperluas abstraksi DataFrame yang familier ke memori GPU, sehingga dapat diintegrasikan ke alur kerja data tanpa perubahan kode yang ekstensif. Pustaka ini mendukung semua operasi kunci yang dilakukan data scientist pada DataFrame: pemfilteran, agregasi, penggabungan, dan pengurutan—semuanya didukung GPU untuk kecepatan.
NVIDIA dan Polars baru saja mengumumkan rilis open beta untuk mesin GPU Polars di Python, didukung oleh RAPIDS cuDF. Fitur baru ini menandai lompatan besar untuk pemrosesan data berkinerja tinggi, menghadirkan alur kerja hingga 13x lebih cepat bagi pengguna Polars dengan GPU NVIDIA!
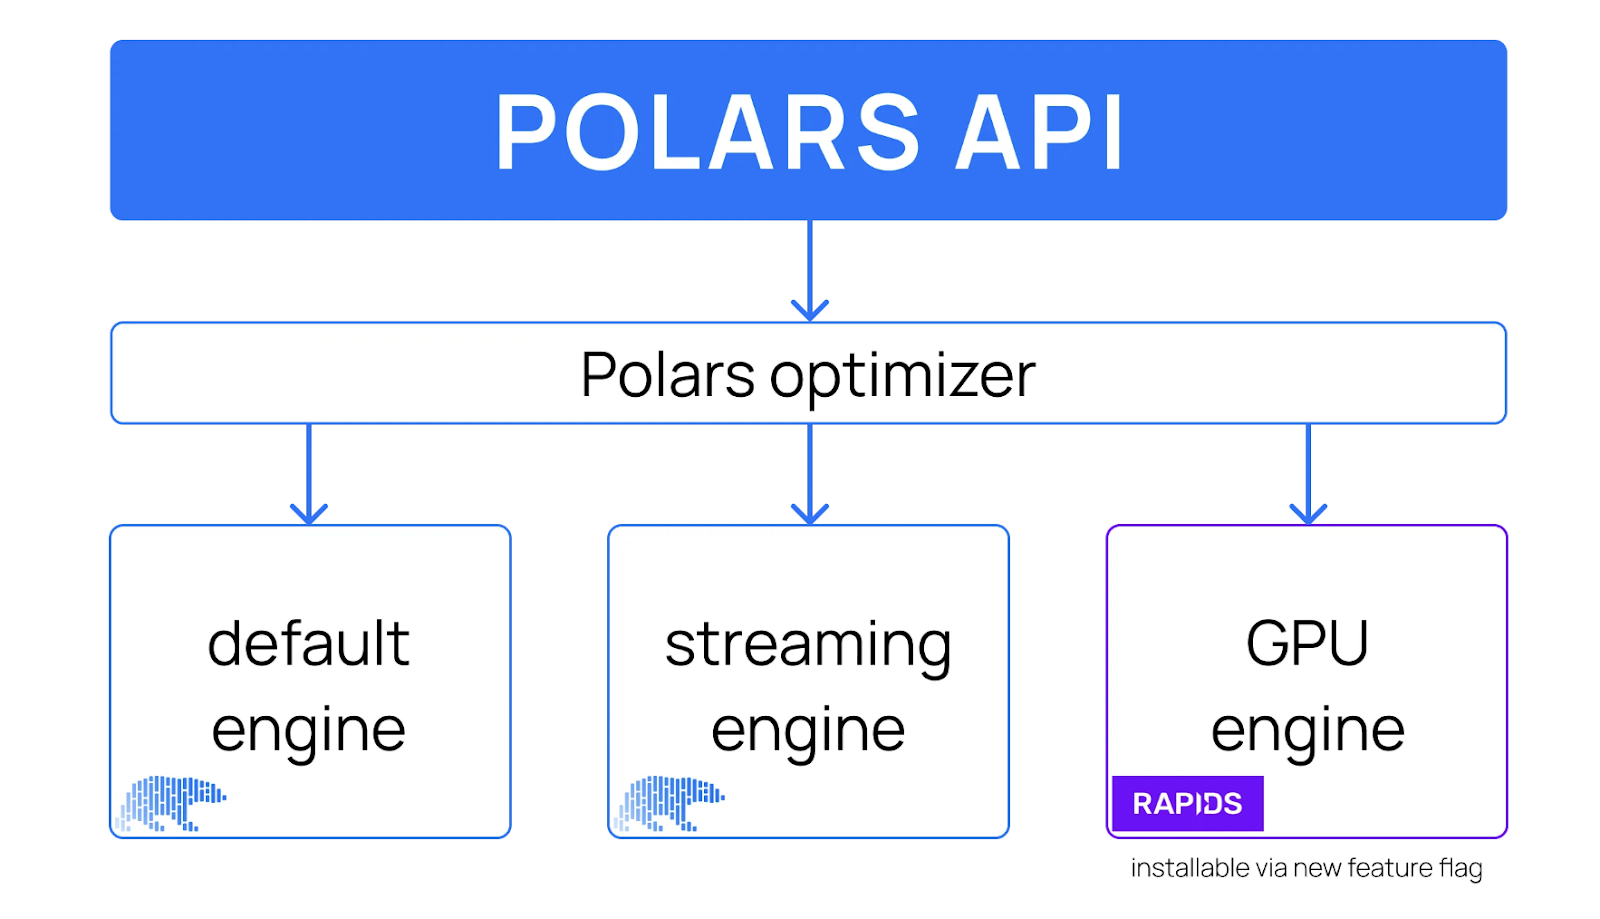
Desain tingkat tinggi API Polars, termasuk mesin GPU. Sumber gambar: Polars
Dengan tambahan mesin GPU, pengguna Polars dapat memilih mesin mana yang akan menjalankan beban kerja data mereka. Optimizer Polars mendukung semua mesin, secara dinamis menentukan kueri mana yang dapat dieksekusi di GPU atau CPU.
Sekarang Anda sudah memahami konteks Polars dan pustaka NVIDIA RAPIDS cuDF serta bagaimana keduanya terintegrasi dan tersedia melalui API Polars di Python. Lalu apa artinya ini bagi developer dan data scientist?
Berikut ringkasan kemampuan yang dihadirkan mesin GPU Polars:
engine="gpu" ke operasi collect() di Lazy API Polars, sehingga pemrosesan GPU aktif tanpa perubahan kode yang signifikan.Lalu, bagaimana hasilnya sejauh ini? Mari kita lihat.
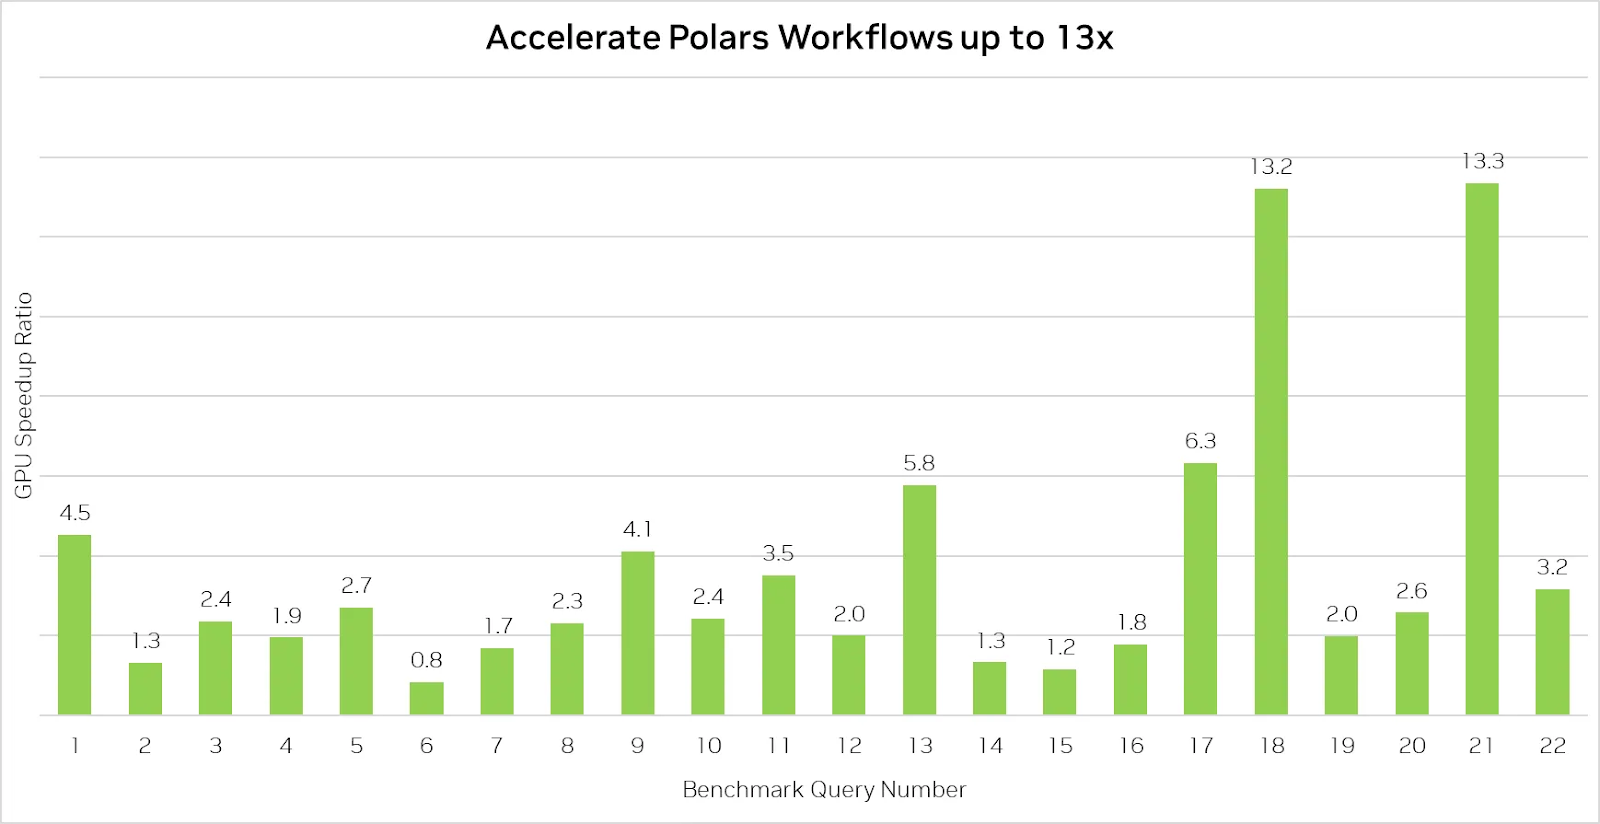
Mesin GPU Polars mempercepat pemrosesan data hingga 13x. Sumber gambar: Polars
Benchmark di atas menunjukkan kemampuan mengesankan dari mesin GPU Polars dengan mempercepat kueri hingga 13x.
Namun, penting untuk dicatat bahwa menggunakan Polars di GPU tidak selalu dijamin lebih cepat daripada di CPU, terutama untuk kueri yang lebih sederhana dan tidak intensif komputasi. Dalam kasus seperti ini, kinerja sering dibatasi oleh kecepatan membaca data dari disk, yang berarti akselerasi GPU kurang memberi keuntungan saat operasi input/output (I/O) menjadi kendala utama.
Meski demikian, mesin GPU memberikan peningkatan kecepatan yang signifikan untuk operasi data yang lebih kompleks, menjadikannya alat berharga bagi tim yang menangani dataset besar atau kueri yang melibatkan join, group-by, dan pemrosesan string.
Salah satu fitur paling menarik dari integrasi baru ini adalah fleksibilitasnya. Seperti disebutkan sebelumnya, optimizer dapat beralih antara eksekusi CPU dan GPU berdasarkan kompleksitas kueri Anda. Namun, bagaimana tepatnya transisi ini bekerja?
Saat menjalankan Polars di CPU, mesinnya mengikuti pipeline yang terstruktur dan sangat dioptimalkan untuk mengeksekusi operasi data. Proses ini kurang lebih melibatkan langkah-langkah berikut:
Saat Anda mengaktifkan akselerasi GPU dengan meneruskan engine="gpu" ke metode .collect(), prosesnya pada dasarnya tetap sama di permukaan tetapi dengan pemeriksaan dan optimisasi tambahan di balik layar untuk menentukan seberapa besar beban kerja yang dapat dialihkan ke GPU melalui cuDF:
Model eksekusi hibrida ini—di mana GPU dan CPU digunakan bersama—membuat Polars sangat fleksibel. Anda mendapatkan manfaat akselerasi GPU tanpa mengorbankan kompatibilitas untuk kueri yang belum didukung di GPU. Tulisan rilis Polars menjelaskan ini dengan detail teknis yang lebih mendalam.
Bagian paling menarik akhirnya tiba! Pada bagian ini, saya akan memandu langkah-langkah yang diperlukan untuk menyiapkan lingkungan Anda dan mulai memanfaatkan pemrosesan data yang dipercepat GPU.
Cara paling sederhana untuk mulai adalah mengikuti notebook Google Colab ini.
Colab menawarkan penggunaan GPU gratis terbatas, sangat berguna jika Anda belum memiliki akses GPU. Jika Anda menggunakan notebook yang disediakan, kita mulai dari langkah 2 di bawah ini, sehingga Anda bisa melewati langkah sebelumnya.
Sebelum memasang mesin GPU Polars, pastikan sistem Anda memenuhi persyaratan untuk NVIDIA RAPIDS cuDF. Anda dapat meninjau spesifikasi sistem yang diperlukan, termasuk kompatibilitas GPU dan persyaratan driver, di halaman dokumentasi RAPIDS.
Untuk mulai menggunakan mesin GPU Polars, praktik terbaiknya adalah membuat lingkungan virtual untuk mengisolasi dependensi proyek Anda.
Saya menggunakan conda untuk contoh ini, tetapi silakan gunakan pengelola paket pilihan Anda.
Selain Python, Anda dapat menyertakan JupyterLab di lingkungan untuk eksplorasi data interaktif dan pengembangan, yang sangat berguna untuk menjalankan potongan kode kecil dan menganalisis dataset secara langsung.
conda create -n polars-gpu -c conda-forge python=3.11 jupyterlabSetelah membuat lingkungan virtual, aktifkan dengan:
conda activate polars-gpuSekarang, mari aktifkan akselerasi GPU dengan memasang Polars dan mesin GPU. Ini juga akan menyiapkan cuDF dan dependensi lain yang diperlukan untuk menggunakan GPU NVIDIA:
pip install -U polars[gpu] --extra-index-url=https://pypi.nvidia.comSetelah mesin GPU Polars terpasang, menggunakan Polars di GPU akan terasa mirip dengan bekerja di CPU tetapi dengan hasil yang jauh lebih cepat untuk alur kerja yang kompleks atau berat data.
Seperti dijelaskan sebelumnya, mesin Polars secara otomatis mengoptimalkan rencana eksekusi, sepenuhnya memanfaatkan GPU NVIDIA untuk mempercepat operasi dan meminimalkan penggunaan memori. Untuk kueri yang tidak mendukung akselerasi GPU, mesin GPU Polars memiliki fallback CPU yang mulus, memastikan alur kerja tetap berjalan tanpa gangguan.
Mari kita coba mesinnya dengan beberapa contoh sederhana!
Untuk demonstrasi ini, kita akan menggunakan dataset 22GB berisi transaksi keuangan simulasi dari Kaggle. NVIDIA meng-host dataset ini di bucket Google Cloud Storage (GCS), memastikan kecepatan unduh yang cepat.
Untuk memulai, unduh datasetnya:
!wget https://storage.googleapis.com/rapidsai/polars-demo/transactions.parquet -O transactions.parquetKarena dataset ini bersumber dari Kaggle, maka tunduk pada lisensi dan ketentuan penggunaan khusus dataset Kaggle.
Mari muat dataset menggunakan Polars dan periksa skemanya:
import polars as pl
from polars.testing import assert_frame_equal

transactions = pl.scan_parquet("transactions.parquet")
transactions.collect_schema()
Berikut keluarannya:
Schema([('CUST_ID', String),
        ('START_DATE', Date),
        ('END_DATE', Date),
        ('TRANS_ID', String),
        ('DATE', Date),
        ('YEAR', Int64),
        ('MONTH', Int64),
        ('DAY', Int64),
        ('EXP_TYPE', String),
        ('AMOUNT', Float64)])
Sekarang, mari hitung total volume transaksi dengan menjumlahkan kolom AMOUNT. Pertama, coba tanpa akselerasi GPU:
transactions.select(pl.col("AMOUNT").sum()).collect()Keluaran:
AMOUNT
f64
3.6183e9
Itu total volume transaksi yang tinggi! Mari jalankan kueri yang sama di GPU:
transactions.select(pl.col("AMOUNT").sum()).collect(engine="gpu")Keluaran:
AMOUNT
f64
3.6183e9
Untuk operasi sederhana seperti ini, CPU dan GPU menghasilkan hasil yang sama dengan kecepatan serupa, karena kueri tidak cukup intensif komputasi untuk banyak mendapat manfaat dari akselerasi GPU. Namun, GPU akan unggul saat menangani kueri yang lebih kompleks.
Sekarang, mari beralih ke kueri yang lebih kompleks. Pada kueri ini, kita mengelompokkan transaksi berdasarkan ID pelanggan (CUST_ID), menjumlahkan total jumlah transaksi, lalu mengurutkan hasilnya berdasarkan pembelanja tertinggi.
Pertama, kita jalankan di CPU:
%%time
res_cpu = (
   transactions
   .group_by("CUST_ID")
   .agg(pl.col("AMOUNT").sum())
   .sort(by="AMOUNT", descending=True)
   .head()
   .collect()
)
res_cpu
Berikut keluarannya:
CPU times: user 4.63 s, sys: 3.75 s, total: 8.38 s
Wall time: 6.04 s
CUST_ID
AMOUNT
str
f64
"CA9UYOQ5DA"
2.0290e6
"CJUK2MTM5Q"
1.8115e6
"CYXX1NBIKL"
1.8082e6
"C6ILEYAYQ9"
1.7961e6
"CCNBC305GI"
1.7274e6
Sekarang, jalankan kueri yang sama di GPU:
%%time
res_gpu = (
   transactions
   .group_by("CUST_ID")
   .agg(pl.col("AMOUNT").sum())
   .sort(by="AMOUNT", descending=True)
   .head()
   .collect(engine=”gpu”)
)
res_gpu
Keluaran:
CPU times: user 347 ms, sys: 0 ns, total: 347 ms
Wall time: 353 ms
shape: (5, 2)
CUST_ID
AMOUNT
str
f64
"CA9UYOQ5DA"
2.0290e6
"CJUK2MTM5Q"
1.8115e6
"CYXX1NBIKL"
1.8082e6
"C6ILEYAYQ9"
1.7961e6
"CCNBC305GI"
1.7274e6
Seperti terlihat, menggunakan GPU untuk kueri yang lebih kompleks memberikan peningkatan performa yang signifikan, mengurangi waktu eksekusi dari 6,04 detik di CPU menjadi hanya 353 milidetik di GPU!
Contoh ini menunjukkan peningkatan performa yang kuat yang diberikan mesin GPU Polars untuk operasi data skala besar.
Anda dapat menemukan contoh yang lebih lanjut di notebook Colab pendamping.
Mesin GPU Polars, didukung oleh NVIDIA RAPIDS cuDF, menghadirkan peningkatan kecepatan yang mengesankan, dengan pemrosesan data hingga 13x lebih cepat untuk operasi yang kompleks. Untuk dataset skala besar, Polars menawarkan keunggulan jelas dibanding pustaka DataFrame tradisional.
Walaupun tidak setiap kueri akan sama-sama diuntungkan dari akselerasi GPU, Polars tetap merupakan alat yang kuat bagi siapa pun yang bekerja dengan dataset besar. Kemudahan integrasi, dikombinasikan dengan model eksekusi hibrida CPU-GPU, menjadikan Polars kandidat kuat untuk alur kerja data modern.
Jika Anda tertarik mengembangkan keterampilan manipulasi data, khususnya dengan Pandas, saya sangat merekomendasikan kursus berikut:
Sumber-sumber ini akan memberi Anda dasar yang kuat yang melengkapi kemampuan tangguh dari alat seperti Polars!
Pelajari lebih lanjut tentang data science dan Python dengan kursus-kursus ini!
Kursus
Kursus
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



