
了解 NVIDIA RAPIDS cuDF 集成
近年来,随着数据集规模扩大到数亿甚至数十亿行,对更快的数据处理与分析需求呈指数级增长。为应对这一挑战,数据科学领域正日益从传统的基于 CPU 的处理,转向 GPU 加速计算。这正是 NVIDIA RAPIDS cuDF 大显身手之处。
NVIDIA RAPIDS 是开源库套件,可实现 GPU 加速的数据科学与分析。RAPIDS 的核心理念是利用 NVIDIA GPU 的大规模并行能力,加速通常受制于 CPU 的任务,以此简化数据工作流。
在 RAPIDS 中,cuDF 负责 DataFrame 操作。cuDF 将熟悉的 DataFrame 抽象扩展到 GPU 内存,使其无需大量改动即可融入数据工作流。该库支持数据科学家在 DataFrame 上执行的各类关键操作:筛选、聚合、合并与排序,全部由 GPU 驱动以获得更高速度。
NVIDIA 与 Polars 刚刚宣布了由 RAPIDS cuDF 提供支持的 Python Polars GPU 引擎公开测试版发布。此新特性为高性能数据处理带来重大飞跃:在配备 NVIDIA GPU 的环境中,可将工作流加速至最高 13 倍!
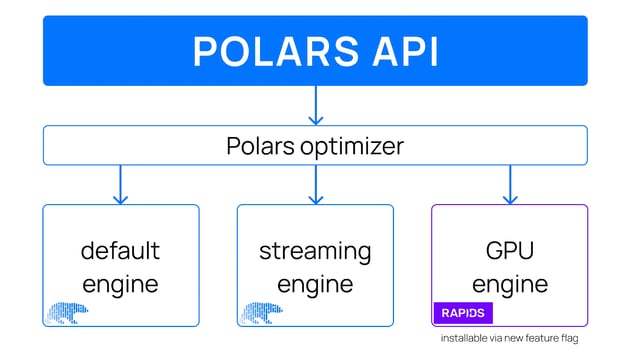
包含 GPU 引擎的 Polars API 高层设计。图片来源:Polars
随着 GPU 引擎的加入,Polars 用户可以选择在何种引擎上运行数据工作负载。Polars 优化器支持所有引擎,动态判定哪些查询可在 GPU 或 CPU 上执行。
Polars GPU 引擎:改变游戏规则
现在,您已了解 Polars 与 NVIDIA RAPIDS cuDF 的背景,以及二者如何集成并通过 Python Polars API 提供。那么这对开发者与数据科学家意味着什么?
以下是 Polars GPU 引擎所带来的能力概览:
- 与 Python Polars Lazy API 集成:用户只需在 Polars 的 Lazy API 中向
collect()操作传入engine="gpu",即可启用 GPU 处理,无需对代码作出重大修改。 - 大数据集的交互式处理:GPU 引擎旨在让处理数亿行数据也能具备“交互式”的体验。仅用一块 GPU,您即可处理原本需要更复杂且更慢方案的大体量数据。
- 效率优化:Polars GPU 引擎充分利用 Polars 优化器,确保执行尽可能高效,最大限度减少处理时间与内存占用。
- 平滑的 CPU 回退:当特定查询不受 GPU 支持时,引擎会回退到 CPU。这样可确保工作流不中断,在需要时自动转回 CPU 处理。
那么,目前的结果如何?我们来看看。
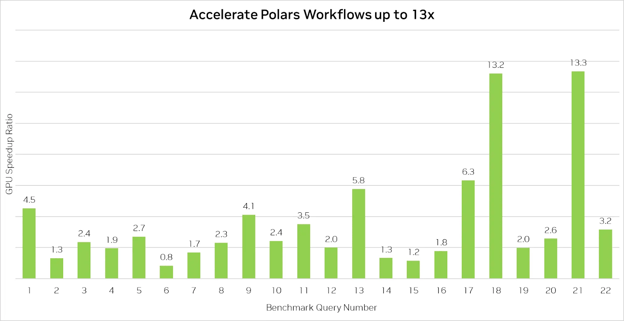
Polars GPU 引擎将数据处理加速至最高 13 倍。图片来源:Polars
上述基准测试展示了 Polars GPU 引擎的强大能力:将查询加速至最高 13 倍。
不过需要注意的是,将 Polars 跑在 GPU 上并不总是必然比 CPU 更快,尤其是对计算量不大的简单查询。在此类场景下,性能常受限于从磁盘读取数据的速度,也就是说当 I/O 操作为主要瓶颈时,GPU 加速的优势会减弱。
话虽如此,对于更复杂的数据操作,GPU 引擎能提供显著加速,对于处理大数据集或包含连接、分组汇总以及字符串处理的查询尤其有价值。
CPU 与 GPU 的协同
此集成最吸引人的特性之一是其灵活性。如前所述,优化器可根据查询复杂度在 CPU 与 GPU 执行之间切换。但这种切换究竟如何进行?
未使用 GPU 加速的 Polars
当在 CPU 上运行 Polars 时,引擎会遵循结构化且高度优化的管线来执行数据操作,大致包括以下步骤:
- DSL(领域特定语言):Polars 引擎首先根据您的代码创建结构化查询纲要,类似于编程语言的语法树。该纲要定义了您想执行的操作顺序,如筛选、分组与聚合。
- IR(中间表示):随后,Polars 将查询纲要转换为详细的执行计划,确保所有操作正确无误且数据模式匹配。此步骤为 Polars 如何处理数据奠定基础。
- 优化器:优化器通过重排操作与移除不必要步骤来改进执行计划。例如,可将筛选前移至连接或聚合之前,以更早减少数据集大小。此优化确保在执行前计划尽可能高效。
- 优化后的 IR:优化完成后,改进的执行计划被最终确定,准备由 Polars 引擎处理。这份计划就是 Polars 在数据上执行每一步操作的蓝图。
- Polars 内存引擎(CPU 执行):最后,Polars 内存引擎在 CPU 上完整执行优化计划。尽管 Polars 进行了高性能优化,但在大数据集下,此步骤仍可能耗时,因为 CPU 以顺序或有限并行的方式处理数据。
使用 GPU 加速的 Polars
当您在 .collect() 方法中传入 engine="gpu" 以启用 GPU 加速时,从表面上看流程基本一致,但在幕后会增加检查与优化,以判定可通过 cuDF 将多大比例的工作负载卸载至 GPU:
- DSL(领域特定语言):与 CPU 模式相同,Polars 首先从您的代码创建结构化查询纲要。无论运行于 CPU 还是 GPU,此纲要均相同,记录您希望执行的操作。
- IR(中间表示):Polars 将纲要转换为执行计划,检查其正确性并确保数据模式有效。此时 IR 仍保持中立,因为尚未决定由 CPU 或 GPU 来处理操作。
- 优化器:优化器如同在 CPU 执行时一样工作,重排操作以实现最高效率,并移除冗余步骤。此时计划仍是为通用执行而优化。
- 优化后的 IR:与 CPU 执行一样,优化后的计划被最终确定。但当启用 GPU 加速后,引擎会检查该计划的哪些部分可卸载至 GPU。
- cuDF 回调(GPU 检查):精彩之处在这里!cuDF 回调将判定 GPU 是否可以处理该执行计划。某些操作天生适合 GPU 加速,而另一些则未必。回调会修改计划,使受支持的操作由 GPU 执行。
- Polars 内存引擎(GPU 与 CPU 协同执行):最终,Polars 内存引擎执行该计划。可由 GPU 加速的查询交给 GPU 处理,不支持的查询则回退到 CPU。
这种 GPU 与 CPU 协同的混合执行模型,使 Polars 极具灵活性。您既能享受 GPU 加速带来的红利,又不会因某些查询不受 GPU 支持而牺牲兼容性。Polars 的发布博客对其进行了更深入的技术讲解。
Polars GPU 引擎上手指南
终于到了最令人兴奋的部分!本节我将带您完成环境配置步骤,开始利用 GPU 加速的数据处理。
最快上手的方法是跟随这份Google Colab 笔记本。
Colab 提供免费的有限 GPU 使用配额,尤其适合暂时无法使用 GPU 的情况。如果您使用上述笔记本,我们将从下方第 2 步开始,之前的步骤可跳过。
先决条件
在安装 Polars GPU 引擎之前,请确保您的系统满足 NVIDIA RAPIDS cuDF 的要求。您可在RAPIDS 文档页面查看必要的系统规格,包括 GPU 兼容性与驱动要求。
1. 创建虚拟环境(推荐)
开始使用 Polars GPU 引擎的最佳实践,是创建一个虚拟环境来隔离项目依赖。
这里以 conda 为例,您也可使用自己偏好的包管理器。
除 Python 外,您还可以在环境中加入 JupyterLab,以便进行交互式的数据探索与开发,尤其适合运行小代码片段并即时分析数据集。
conda create -n polars-gpu -c conda-forge python=3.11 jupyterlab创建虚拟环境后,使用以下命令激活:
conda activate polars-gpu2. 安装 Polars GPU 引擎
现在,让我们通过安装 Polars 及其 GPU 引擎来启用 GPU 加速。这也会设置 cuDF 及使用 NVIDIA GPU 所需的其他依赖:
pip install -U polars[gpu] --extra-index-url=https://pypi.nvidia.com安装完成后,在 GPU 上使用 Polars 的体验将与在 CPU 上类似,但对于复杂或数据量大的工作流,结果会快得多。
如前所述,Polars 引擎会自动优化执行计划,充分利用 NVIDIA GPU 加速操作并降低内存占用。对于不支持 GPU 加速的查询,Polars GPU 引擎会平滑回退至 CPU,确保工作流不中断。
下面通过几个简单示例来实际运行一下引擎!
使用 Polars GPU 引擎运行一些查询
本演示将使用 Kaggle 上的22GB 模拟金融交易数据集。NVIDIA 将该数据集托管在 Google Cloud Storage(GCS)存储桶中,下载速度更快。
首先,下载数据集:
!wget https://storage.googleapis.com/rapidsai/polars-demo/transactions.parquet -O transactions.parquet由于该数据集来源于 Kaggle,适用 Kaggle 数据集的许可与使用条款。
接下来,用 Polars 加载数据集并查看模式:
import polars as pl
from polars.testing import assert_frame_equal
transactions = pl.scan_parquet("transactions.parquet")
transactions.collect_schema()输出如下:
Schema([('CUST_ID', String),
('START_DATE', Date),
('END_DATE', Date),
('TRANS_ID', String),
('DATE', Date),
('YEAR', Int64),
('MONTH', Int64),
('DAY', Int64),
('EXP_TYPE', String),
('AMOUNT', Float64)])现在,让我们通过对 AMOUNT 列求和来计算总交易额。先在不使用 GPU 加速的情况下尝试:
transactions.select(pl.col("AMOUNT").sum()).collect()输出:
AMOUNT
f64
3.6183e9总交易额很高!我们在 GPU 上运行同样的查询:
transactions.select(pl.col("AMOUNT").sum()).collect(engine="gpu")输出:
AMOUNT
f64
3.6183e9对于这类简单操作,CPU 与 GPU 得到相同结果且速度相近,因为查询的计算量不足以从 GPU 加速中获得显著收益。但在更复杂的查询中,GPU 的优势将得到充分体现。
现在来看看更复杂的查询。我们按客户 ID(CUST_ID)对交易进行分组,汇总总交易额,并按最高消费额排序结果。
先在 CPU 上运行:
%%time
res_cpu = (
transactions
.group_by("CUST_ID")
.agg(pl.col("AMOUNT").sum())
.sort(by="AMOUNT", descending=True)
.head()
.collect()
)
res_cpu输出如下:
CPU times: user 4.63 s, sys: 3.75 s, total: 8.38 s
Wall time: 6.04 s
CUST_ID
AMOUNT
str
f64
"CA9UYOQ5DA"
2.0290e6
"CJUK2MTM5Q"
1.8115e6
"CYXX1NBIKL"
1.8082e6
"C6ILEYAYQ9"
1.7961e6
"CCNBC305GI"
1.7274e6然后在 GPU 上运行相同查询:
%%time
res_gpu = (
transactions
.group_by("CUST_ID")
.agg(pl.col("AMOUNT").sum())
.sort(by="AMOUNT", descending=True)
.head()
.collect(engine=”gpu”)
)
res_gpu输出:
CPU times: user 347 ms, sys: 0 ns, total: 347 ms
Wall time: 353 ms
shape: (5, 2)
CUST_ID
AMOUNT
str
f64
"CA9UYOQ5DA"
2.0290e6
"CJUK2MTM5Q"
1.8115e6
"CYXX1NBIKL"
1.8082e6
"C6ILEYAYQ9"
1.7961e6
"CCNBC305GI"
1.7274e6可以看到,复杂查询使用 GPU 可显著提升性能,将 CPU 上的6.04 秒缩短至353 毫秒!
该示例展示了 Polars GPU 引擎在大规模数据操作上的强力加速效果。
更多进阶示例可在配套的Colab 笔记本中找到。
结语
由 NVIDIA RAPIDS cuDF 提供支持的 Polars GPU 引擎带来令人瞩目的速度提升:在复杂操作上数据处理最高提速 13 倍。对于大规模数据集,Polars 相较传统 DataFrame 库具有显著优势。
尽管并非每个查询都能同等受益于 GPU 加速,但对于处理大数据集的人来说,Polars 依然是一款强大的工具。其易于集成的特性与 CPU-GPU 混合执行模型,使 Polars 成为现代数据工作流的有力竞争者。
如果您有兴趣提升数据处理技能,尤其是 Pandas 相关内容,强烈推荐以下课程:
这些资源将为您打下坚实基础,进一步发挥如 Polars 等工具的强大能力!
FAQs
哪些查询最能从 Polars 的 GPU 加速中受益?
在 Polars 中,涉及连接、分组汇总与字符串处理等计算密集型查询,最能从 GPU 加速中获益。这类任务计算量大,GPU 的并行处理能力能够充分发挥,相比 CPU 处理可带来最高 13 倍的加速。但较为简单或 I/O 受限的查询,提升可能不明显。
GPU 加速是否总是比使用 CPU 更快?
不一定。虽然 GPU 加速能大幅提升复杂聚合与连接等计算密集型操作的速度,但当瓶颈在于磁盘读写的 I/O 受限查询时,GPU 未必能带来显著优势,执行时间往往与 CPU 接近。
要使用 GPU 引擎,我需要重写 Polars 查询吗?
不需要重写查询。Polars GPU 引擎可与现有 Polars 工作流无缝集成。您只需在 collect() 方法中传入 engine="gpu" 即可启用 GPU 加速。若查询的某部分不受 GPU 引擎支持,将自动回退至 CPU,您无需做任何更改。
我能在任意机器上使用 Polars GPU 引擎吗?
使用 Polars GPU 引擎需要搭载与 RAPIDS cuDF(CUDA-X 库的一部分)兼容的 NVIDIA GPU 的机器。若您的机器没有兼容 GPU,可使用 Amazon SageMaker Studio Lab、Google Colab 或 PaperSpace 等云服务,这些服务提供免费或付费的 GPU 资源。

Thalia Barrera 是 DataCamp 的高级数据科学编辑,拥有计算机科学硕士学位,并在软件与数据工程领域有逾十年的从业经验。Thalia 热衷于通过博文、教程和视频课程为工程师与数据科学家简化技术概念。
最近,我有幸在其公开测试版发布之前,提前体验了由 NVIDIA RAPIDS cuDF 提供支持的 Polars GPU 引擎。这项前沿能力有望通过使用 NVIDIA GPU 将 Polars 操作加速至最高 13 倍,从而重塑数据工作流。如果您在 Python 中处理大规模数据集,这将是不可错过的重大变革。
在本文中,我将解释关于全新 Polars GPU 引擎的所有关键信息,并提供逐步指南,助您快速上手!
Polars:高性能 DataFrame 库
大多数数据科学工作流的核心是 DataFrame——一种既灵活又直观的表格数据结构,便于处理结构化数据。简而言之,几乎所有数据科学从业者都使用过 DataFrame。
DataFrame 提供便捷的数据操作、探索与分析能力,为数据清洗、筛选、分组与转换提供熟悉且一致的接口。
然而,在大数据场景下,传统的 DataFrame 库可能在性能与可扩展性上有所不足,这正是 Polars 大显身手的地方。
Polars 是一款快速高效的 DataFrame 库,迅速成为高性能数据处理的优选。Polars 由 Rust 从零编写,旨在贴近硬件层运行,在不依赖外部依赖的情况下优化速度与资源使用。
这篇Polars 入门文章,是在 Python 中学习该库的极佳资源。
最流行 DataFrame 库的性能对比。图片来源:Polars
Polars 发布的基准测试结果(如上图所示)表明,在不同查询中,Polars 均稳定领先于 Pandas、Modin、PySpark 和 Dask 等库。这些结果凸显了 Polars 作为高性能数据处理最快选项的优势。
但这如何做到?以下特性让 Polars 快如闪电:
伴随 Polars GPU 引擎公开测试版的发布,它将变得更快!