
Khóa học
Python trung cấp dành cho nhà phát triển
2 giờ
70.2K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleGần đây, tôi có cơ hội được truy cập sớm vào Polars GPU engine, được hỗ trợ bởi NVIDIA RAPIDS cuDF, trước khi ra mắt bản open beta. Tính năng tiên tiến này có tiềm năng thay đổi quy trình dữ liệu bằng cách tăng tốc các thao tác Polars lên đến 13 lần với GPU của NVIDIA. Nếu bạn làm việc với các bộ dữ liệu quy mô lớn trong Python, đây là một bước ngoặt bạn không muốn bỏ lỡ.
Trong bài viết này, tôi sẽ giải thích mọi điều bạn cần biết về Polars GPU engine mới và cung cấp hướng dẫn từng bước để bạn bắt đầu!
Trung tâm của hầu hết quy trình khoa học dữ liệu là DataFrame, một cấu trúc dữ liệu dạng bảng vừa linh hoạt vừa trực quan để xử lý dữ liệu có cấu trúc. Nói đơn giản, ai làm khoa học dữ liệu cũng đã từng làm việc với DataFrame.
DataFrame cho phép thao tác, khám phá và phân tích dữ liệu dễ dàng, cung cấp giao diện quen thuộc và nhất quán cho việc làm sạch, lọc, nhóm và biến đổi dữ liệu.
Tuy nhiên, trong bối cảnh dữ liệu lớn, các thư viện DataFrame truyền thống có thể thiếu hiệu năng và khả năng mở rộng, và đó là lúc Polars xuất hiện.
Polars là một thư viện DataFrame nhanh và hiệu quả, nhanh chóng trở thành lựa chọn hàng đầu cho xử lý dữ liệu hiệu năng cao. Được viết từ đầu bằng Rust, Polars được thiết kế để hoạt động sát phần cứng, tối ưu tốc độ và sử dụng tài nguyên mà không phụ thuộc vào các thành phần bên ngoài.
Bài viết Giới thiệu về Polars là nguồn tài liệu tuyệt vời để bắt đầu với thư viện này trong Python.
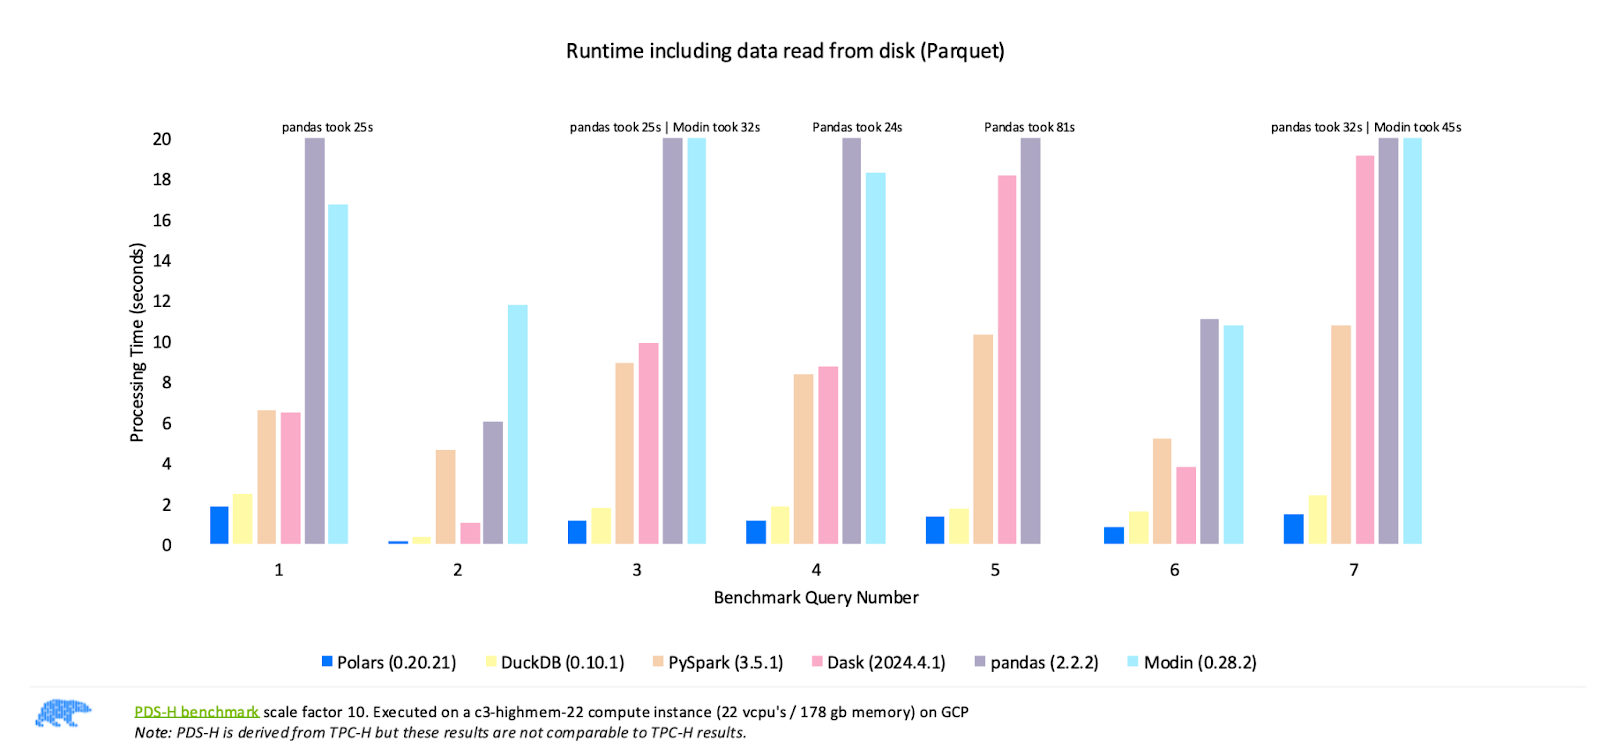
So sánh hiệu năng của các thư viện DataFrame phổ biến nhất. Nguồn ảnh: Polars
Kết quả benchmark do Polars công bố, như trong hình trên, cho thấy Polars liên tục vượt trội hơn các thư viện khác như Pandas, Modin, PySpark và Dask trên nhiều truy vấn khác nhau. Những kết quả này nhấn mạnh sức mạnh của Polars như lựa chọn nhanh nhất cho xử lý dữ liệu hiệu năng cao.
Nhưng làm sao điều đó có thể? Dưới đây là một số đặc điểm giúp Polars cực kỳ nhanh:
Và với thông báo open beta gần đây của Polars GPU engine, nó còn sắp trở nên nhanh hơn nữa!
Nhu cầu xử lý và phân tích dữ liệu nhanh hơn đã tăng theo cấp số nhân trong những năm gần đây khi các bộ dữ liệu mở rộng đến hàng trăm triệu thậm chí hàng tỷ dòng. Để giải quyết thách thức này, lĩnh vực khoa học dữ liệu đang chứng kiến sự chuyển dịch ngày càng tăng từ xử lý dựa trên CPU truyền thống sang tính toán tăng tốc bằng GPU. Đây là lúc NVIDIA RAPIDS cuDF phát huy tác dụng.
NVIDIA RAPIDS là một bộ thư viện mã nguồn mở cho phép khoa học dữ liệu và phân tích được tăng tốc bằng GPU. Cốt lõi của RAPIDS được thiết kế để tinh gọn quy trình dữ liệu bằng cách tận dụng khả năng song song khổng lồ của GPU NVIDIA để tăng tốc các tác vụ thường bị ràng buộc bởi CPU.
Trong RAPIDS, cuDF là thư viện phụ trách các thao tác DataFrame. cuDF mở rộng lớp trừu tượng DataFrame quen thuộc vào bộ nhớ GPU, cho phép tích hợp vào quy trình dữ liệu mà không cần thay đổi nhiều mã. Thư viện hỗ trợ mọi thao tác chính mà nhà khoa học dữ liệu thực hiện trên DataFrame: lọc, tổng hợp, gộp và sắp xếp, tất cả đều được tăng tốc bởi GPU để đạt tốc độ cao.
NVIDIA và Polars vừa công bố bản open beta của Polars GPU engine cho Python, được hỗ trợ bởi RAPIDS cuDF. Tính năng mới này đánh dấu bước tiến lớn cho xử lý dữ liệu hiệu năng cao, mang lại quy trình nhanh hơn đến 13 lần cho người dùng Polars sở hữu GPU NVIDIA!
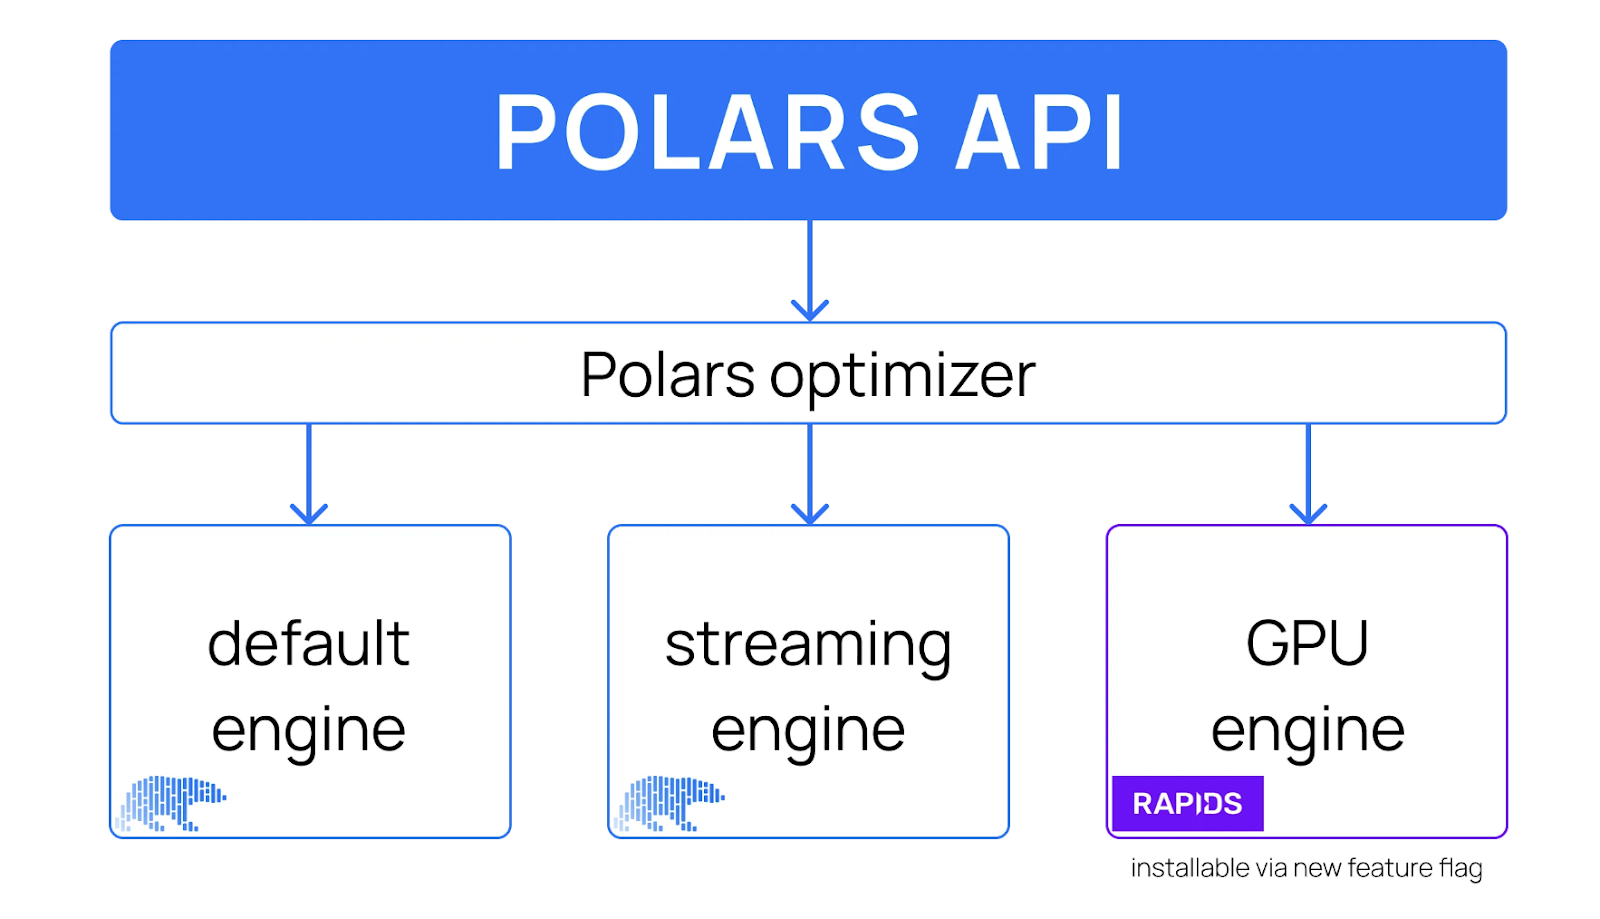
Thiết kế cấp cao của API Polars, bao gồm một động cơ GPU. Nguồn ảnh: Polars
Với việc bổ sung GPU engine, người dùng Polars có thể quyết định chạy khối lượng công việc dữ liệu của mình trên động cơ nào. Bộ tối ưu của Polars hỗ trợ tất cả động cơ, tự động xác định truy vấn nào có thể chạy trên GPU hoặc CPU.
Giờ bạn đã có bối cảnh về Polars và thư viện NVIDIA RAPIDS cuDF cũng như cách cả hai tích hợp và được cung cấp qua Python Polars API. Vậy điều này có ý nghĩa gì với nhà phát triển và nhà khoa học dữ liệu?
Dưới đây là tóm tắt những gì Polars GPU engine mang lại:
engine="gpu" vào thao tác collect() trong Lazy API của Polars, kích hoạt xử lý bằng GPU mà không cần thay đổi mã đáng kể.Vậy kết quả cho đến nay thế nào? Cùng xem nhé.
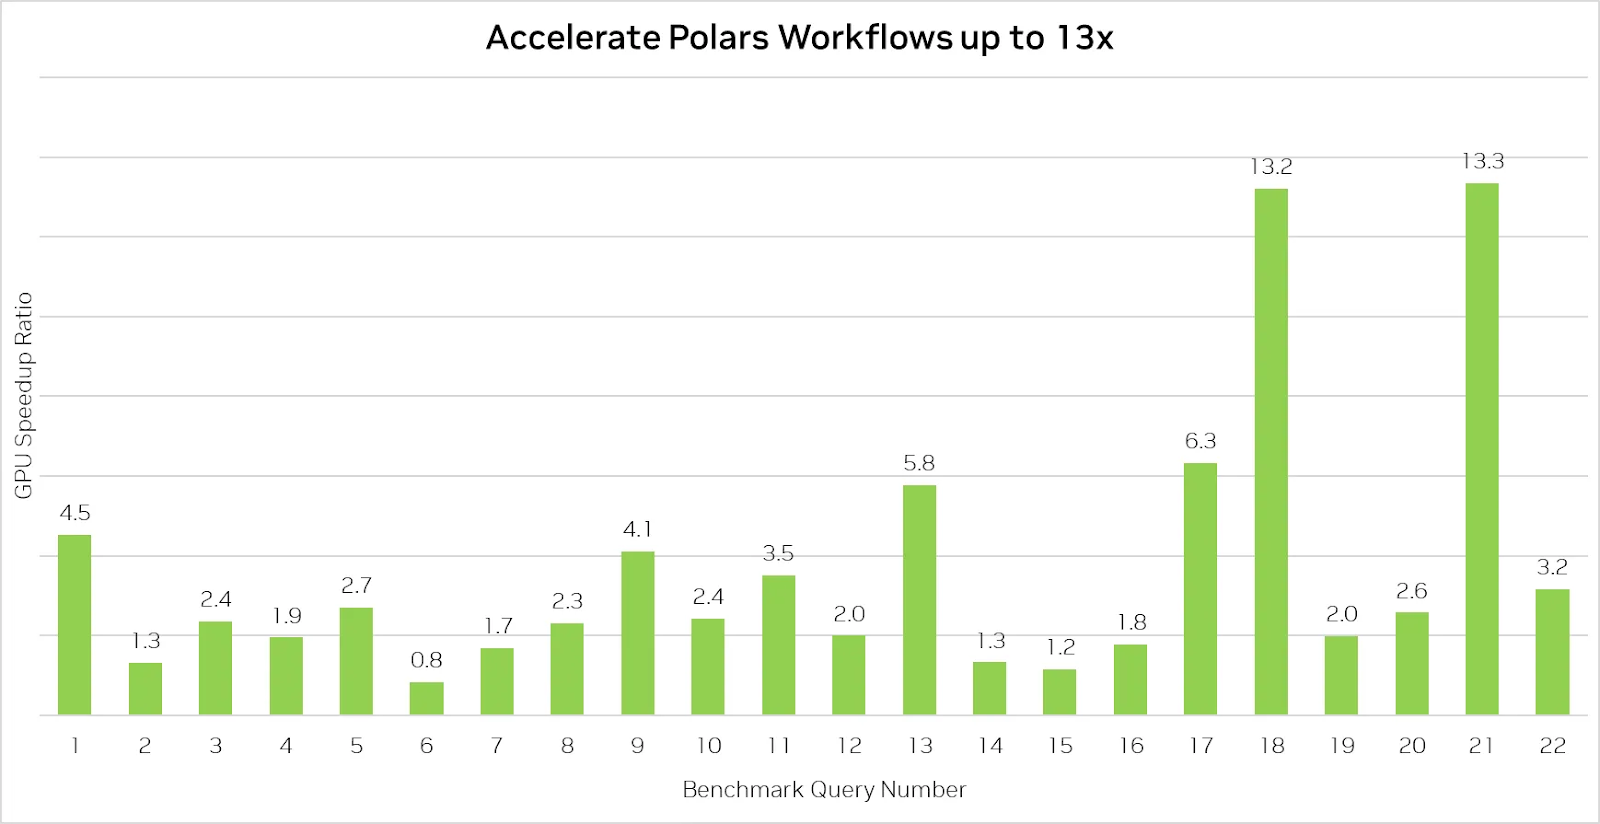
Polars GPU Engine tăng tốc xử lý dữ liệu lên đến 13 lần. Nguồn ảnh: Polars
Bài benchmark trên cho thấy khả năng ấn tượng của Polars GPU engine khi tăng tốc các truy vấn lên đến 13 lần.
Tuy nhiên, cần lưu ý rằng dùng Polars trên GPU không phải lúc nào cũng nhanh hơn CPU, đặc biệt với các truy vấn đơn giản không đòi hỏi nhiều tính toán. Trong những trường hợp này, hiệu năng thường bị giới hạn bởi tốc độ đọc dữ liệu từ đĩa, nghĩa là tăng tốc GPU sẽ ít lợi thế khi các thao tác nhập/xuất (I/O) là nút thắt chính.
Dẫu vậy, GPU engine mang lại cải thiện đáng kể cho các thao tác dữ liệu phức tạp, khiến nó trở thành công cụ giá trị cho các nhóm xử lý dữ liệu lớn hoặc truy vấn có join, group-by và xử lý chuỗi.
Một trong những điểm hấp dẫn nhất của tích hợp mới này là tính linh hoạt. Như đã đề cập, bộ tối ưu có thể chuyển đổi giữa thực thi trên CPU và GPU dựa trên độ phức tạp của truy vấn. Nhưng quá trình chuyển đổi này diễn ra như thế nào?
Khi chạy Polars trên CPU, engine tuân theo một pipeline có cấu trúc và được tối ưu cao để thực thi các thao tác dữ liệu. Quá trình này bao gồm đại khái các bước sau:
Khi bạn bật tăng tốc GPU bằng cách truyền engine="gpu" vào phương thức .collect(), quá trình về cơ bản vẫn giống trên bề mặt nhưng có thêm các kiểm tra và tối ưu phía sau để xác định khối lượng công việc nào có thể chuyển sang GPU thông qua cuDF:
Mô hình thực thi kết hợp này—nơi GPU và CPU được dùng song song—giúp Polars cực kỳ linh hoạt. Bạn hưởng lợi từ tăng tốc GPU mà không phải hy sinh khả năng tương thích cho các truy vấn không được GPU hỗ trợ. Bài đăng phát hành của Polars giải thích chi tiết kỹ thuật sâu hơn.
Và giờ là phần thú vị nhất! Trong mục này, tôi sẽ hướng dẫn các bước cần thiết để thiết lập môi trường và bắt đầu tận dụng xử lý dữ liệu tăng tốc bằng GPU.
Cách đơn giản nhất để bắt đầu là làm theo notebook Google Colab này.
Colab cung cấp mức sử dụng GPU miễn phí có giới hạn, đặc biệt hữu ích nếu bạn chưa có sẵn GPU. Nếu bạn dùng notebook kèm theo, chúng ta sẽ bắt đầu từ bước 2 bên dưới, vì vậy có thể bỏ qua các bước trước đó.
Trước khi cài đặt Polars GPU engine, hãy đảm bảo hệ thống của bạn đáp ứng yêu cầu cho NVIDIA RAPIDS cuDF. Bạn có thể xem các thông số hệ thống cần thiết, bao gồm khả năng tương thích GPU và yêu cầu driver, trên trang tài liệu RAPIDS.
Để bắt đầu với Polars GPU engine, tốt nhất bạn nên tạo môi trường ảo để tách biệt các phụ thuộc của dự án.
Tôi dùng conda cho ví dụ này nhưng bạn có thể dùng trình quản lý gói ưa thích.
Ngoài Python, bạn có thể thêm JupyterLab vào môi trường để khám phá dữ liệu tương tác và phát triển, đặc biệt hữu ích khi chạy các đoạn mã nhỏ và phân tích dữ liệu tức thì.
conda create -n polars-gpu -c conda-forge python=3.11 jupyterlabSau khi tạo môi trường ảo, kích hoạt nó bằng:
conda activate polars-gpuGiờ hãy bật tăng tốc GPU bằng cách cài đặt Polars và GPU engine. Lệnh này cũng sẽ thiết lập cuDF và các phụ thuộc khác cần thiết để dùng GPU NVIDIA:
pip install -U polars[gpu] --extra-index-url=https://pypi.nvidia.comSau khi cài đặt Polars GPU engine, dùng Polars trên GPU sẽ giống với làm việc trên CPU nhưng cho kết quả nhanh hơn nhiều với các quy trình phức tạp hoặc nặng dữ liệu.
Như đã giải thích, engine của Polars tự động tối ưu kế hoạch thực thi, tận dụng tối đa GPU NVIDIA để tăng tốc thao tác và giảm thiểu sử dụng bộ nhớ. Với các truy vấn không hỗ trợ tăng tốc GPU, Polars GPU engine có cơ chế chuyển về CPU mượt mà, đảm bảo quy trình tiếp tục không gián đoạn.
Hãy đưa engine vào thực chiến với vài ví dụ đơn giản!
Trong phần minh họa này, chúng ta sẽ dùng bộ dữ liệu 22GB các giao dịch tài chính mô phỏng từ Kaggle. NVIDIA lưu trữ bộ dữ liệu này trên bucket Google Cloud Storage (GCS), đảm bảo tốc độ tải xuống nhanh.
Đầu tiên, hãy tải bộ dữ liệu:
!wget https://storage.googleapis.com/rapidsai/polars-demo/transactions.parquet -O transactions.parquetVì bộ dữ liệu này có nguồn từ Kaggle, nó tuân theo giấy phép và điều khoản sử dụng dành riêng cho bộ dữ liệu Kaggle.
Hãy nạp bộ dữ liệu bằng Polars và kiểm tra schema:
import polars as pl
from polars.testing import assert_frame_equal

transactions = pl.scan_parquet("transactions.parquet")
transactions.collect_schema()
Đầu ra như sau:
Schema([('CUST_ID', String),
        ('START_DATE', Date),
        ('END_DATE', Date),
        ('TRANS_ID', String),
        ('DATE', Date),
        ('YEAR', Int64),
        ('MONTH', Int64),
        ('DAY', Int64),
        ('EXP_TYPE', String),
        ('AMOUNT', Float64)])
Giờ hãy tính tổng khối lượng giao dịch bằng cách cộng cột AMOUNT. Trước tiên, thử không dùng tăng tốc GPU:
transactions.select(pl.col("AMOUNT").sum()).collect()Đầu ra:
AMOUNT
f64
3.6183e9
Tổng khối lượng giao dịch khá lớn! Hãy chạy cùng truy vấn trên GPU:
transactions.select(pl.col("AMOUNT").sum()).collect(engine="gpu")Đầu ra:
AMOUNT
f64
3.6183e9
Với các thao tác đơn giản như thế này, CPU và GPU cho cùng kết quả với tốc độ tương tự, vì truy vấn không đủ nặng về tính toán để được hưởng lợi nhiều từ tăng tốc GPU. Tuy nhiên, GPU sẽ phát huy khi xử lý truy vấn phức tạp hơn.
Bây giờ, chuyển sang truy vấn phức tạp hơn. Trong truy vấn này, chúng ta nhóm giao dịch theo mã khách hàng (CUST_ID), cộng tổng số tiền giao dịch rồi sắp xếp kết quả theo người chi tiêu cao nhất.
Trước tiên, chạy trên CPU:
%%time
res_cpu = (
   transactions
   .group_by("CUST_ID")
   .agg(pl.col("AMOUNT").sum())
   .sort(by="AMOUNT", descending=True)
   .head()
   .collect()
)
res_cpu
Đầu ra như sau:
CPU times: user 4.63 s, sys: 3.75 s, total: 8.38 s
Wall time: 6.04 s
CUST_ID
AMOUNT
str
f64
"CA9UYOQ5DA"
2.0290e6
"CJUK2MTM5Q"
1.8115e6
"CYXX1NBIKL"
1.8082e6
"C6ILEYAYQ9"
1.7961e6
"CCNBC305GI"
1.7274e6
Giờ chạy cùng truy vấn trên GPU:
%%time
res_gpu = (
   transactions
   .group_by("CUST_ID")
   .agg(pl.col("AMOUNT").sum())
   .sort(by="AMOUNT", descending=True)
   .head()
   .collect(engine=”gpu”)
)
res_gpu
Đầu ra:
CPU times: user 347 ms, sys: 0 ns, total: 347 ms
Wall time: 353 ms
shape: (5, 2)
CUST_ID
AMOUNT
str
f64
"CA9UYOQ5DA"
2.0290e6
"CJUK2MTM5Q"
1.8115e6
"CYXX1NBIKL"
1.8082e6
"C6ILEYAYQ9"
1.7961e6
"CCNBC305GI"
1.7274e6
Như ta thấy, dùng GPU cho truy vấn phức tạp mang lại lợi ích hiệu năng rõ rệt, giảm thời gian thực thi từ 6,04 giây trên CPU xuống chỉ còn 353 mili giây trên GPU!
Ví dụ này minh họa cú hích hiệu năng mạnh mẽ mà Polars GPU engine mang lại cho các thao tác dữ liệu quy mô lớn.
Bạn có thể tìm thêm ví dụ nâng cao trong notebook Colab đi kèm.
Polars GPU Engine, được hỗ trợ bởi NVIDIA RAPIDS cuDF, mang lại cải thiện tốc độ ấn tượng, với xử lý dữ liệu nhanh hơn đến 13 lần cho các thao tác phức tạp. Với bộ dữ liệu quy mô lớn, Polars tạo lợi thế rõ rệt so với các thư viện DataFrame truyền thống.
Dù không phải mọi truy vấn đều được hưởng lợi như nhau từ tăng tốc GPU, Polars vẫn là công cụ mạnh mẽ cho bất kỳ ai làm việc với dữ liệu lớn. Sự dễ dàng tích hợp, kết hợp với mô hình thực thi CPU-GPU lai, khiến Polars trở thành ứng viên nặng ký cho các quy trình dữ liệu hiện đại.
Nếu bạn quan tâm phát triển kỹ năng thao tác dữ liệu, đặc biệt với Pandas, tôi rất khuyến nghị các khóa học sau:
Những tài nguyên này sẽ giúp bạn có nền tảng vững chắc, bổ trợ cho sức mạnh của các công cụ như Polars!
Tìm hiểu thêm về khoa học dữ liệu và Python với các khóa học này!
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
