Kurs
Entwicklung mit Python für Fortgeschrittene
2 Std.
67.2K
Kürzlich hatte ich das Privileg, vorab Zugriff auf die Polars GPU Engine zu erhalten, die von NVIDIA RAPIDS cuDF unterstützt wird, noch vor der Open-Beta-Veröffentlichung. Dieses hochmoderne Feature kann Daten-Workflows transformieren, indem es Polars-Operationen mit NVIDIA GPUs um bis zu 13× beschleunigt. Wenn du in Python mit sehr großen Datensätzen arbeitest, ist das ein echter Game-Changer.
In diesem Blogpost erkläre ich dir alles Wichtige zur neuen Polars GPU Engine und gebe dir eine Schritt-für-Schritt-Anleitung für den Einstieg.
Im Kern der meisten Data-Science-Workflows steht der DataFrame: eine tabellarische Datenstruktur, die flexibel und intuitiv im Umgang mit strukturierten Daten ist. Kurz gesagt: Jede Person in der Data Science hat mit DataFrames gearbeitet.
DataFrames ermöglichen eine einfache Datenmanipulation, Exploration und Analyse. Sie bieten eine vertraute, konsistente Oberfläche für das Säubern, Filtern, Gruppieren und Transformieren von Daten.
Im Big-Data-Kontext stoßen traditionelle DataFrame-Bibliotheken jedoch bei Performance und Skalierbarkeit an Grenzen – und genau hier kommt Polars ins Spiel.
Polars ist eine schnelle, effiziente DataFrame-Bibliothek, die sich rasant zur ersten Wahl für High-Performance-Datenverarbeitung entwickelt hat. Von Grund auf in Rust geschrieben, arbeitet Polars hardwarenah, optimiert Geschwindigkeit und Ressourcenverbrauch und kommt ohne externe Abhängigkeiten aus.
Der Einführungsbeitrag zu Polars ist eine hervorragende Ressource, um in Python mit der Bibliothek zu starten.
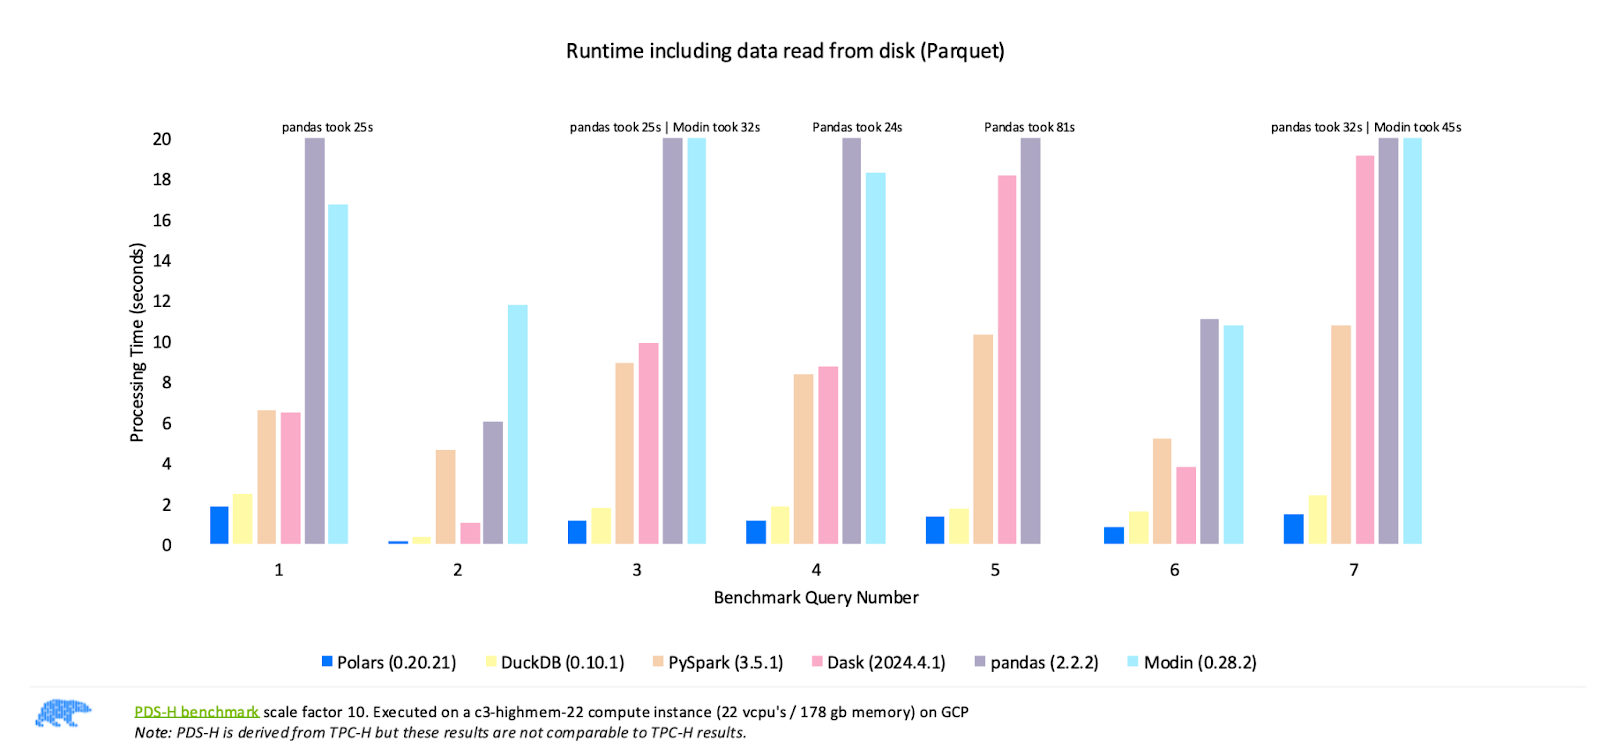
Performancevergleich der beliebtesten DataFrame-Bibliotheken. Bildquelle: Polars
Die von Polars veröffentlichten Benchmarks im obigen Bild zeigen, dass Polars andere Bibliotheken wie Pandas, Modin, PySpark und Dask über verschiedene Abfragen hinweg konstant übertrifft. Diese Ergebnisse unterstreichen die Stärke von Polars als schnellste Option für performante Datenverarbeitung.
Wie ist das möglich? Diese Features machen Polars extrem schnell:
Und mit der jüngsten Open-Beta-Ankündigung der Polars GPU Engine wird es noch schneller!
Die Nachfrage nach schnellerer Datenverarbeitung und -analyse ist in den letzten Jahren rasant gestiegen, da Datensätze auf Hunderte Millionen oder sogar Milliarden Zeilen angewachsen sind. Um diese Herausforderung zu meistern, verlagert sich die Datenverarbeitung von klassischen CPU-Workloads hin zu GPU-beschleunigtem Rechnen. Hier kommt NVIDIA RAPIDS cuDF ins Spiel.
NVIDIA RAPIDS ist eine Open-Source-Suite von Bibliotheken für GPU-beschleunigte Data Science und Analytics. RAPIDS nutzt die massive Parallelität von NVIDIA GPUs, um typischerweise CPU-gebundene Aufgaben zu beschleunigen und Daten-Workflows zu straffen.
Innerhalb von RAPIDS ist cuDF die Bibliothek für DataFrame-Operationen. cuDF erweitert die vertraute DataFrame-Abstraktion in den GPU-Speicher und lässt sich ohne große Codeänderungen in Daten-Workflows integrieren. Die Bibliothek unterstützt alle zentralen Operationen auf DataFrames: Filtern, Aggregieren, Mergen und Sortieren – alles GPU-beschleunigt.
NVIDIA und Polars haben soeben die Open-Beta der Python Polars GPU Engine angekündigt, angetrieben von RAPIDS cuDF. Dieses Feature ist ein großer Sprung für High-Performance-Datenverarbeitung und liefert Polars-Nutzenden mit NVIDIA GPUs bis zu 13× schnellere Workflows!
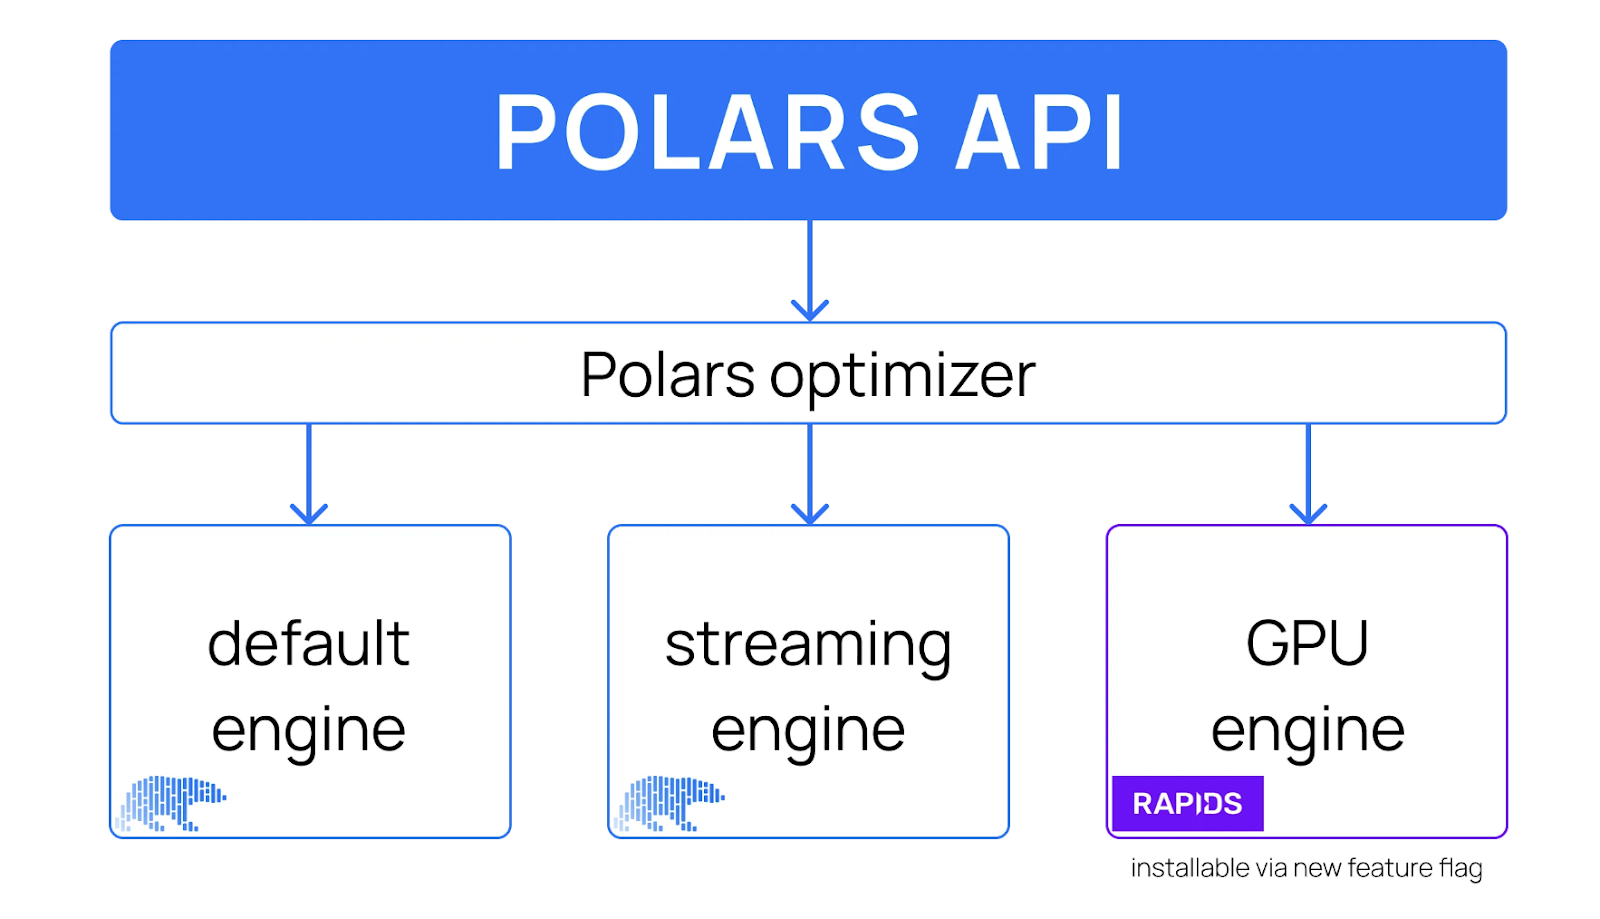
High-Level-Design der Polars API inklusive GPU Engine. Bildquelle: Polars
Mit der GPU Engine können Polars-Nutzende wählen, auf welchem Engine-Typ ihre Workloads laufen. Der Polars-Optimizer unterstützt alle Engines und entscheidet dynamisch, welche Abfragen auf der GPU oder CPU ausgeführt werden.
Du hast jetzt Kontext zu Polars, der NVIDIA RAPIDS cuDF Bibliothek und deren Integration in die Python Polars API. Was bedeutet das konkret für Entwicklerinnen, Entwickler und Data Scientists?
Hier eine Zusammenfassung dessen, was die Polars GPU Engine ermöglicht:
engine="gpu" an die collect()-Operation in der Lazy API von Polars, um GPU-Verarbeitung ohne große Codeänderungen zu aktivieren.Wie sehen die Ergebnisse bisher aus? Schauen wir rein.
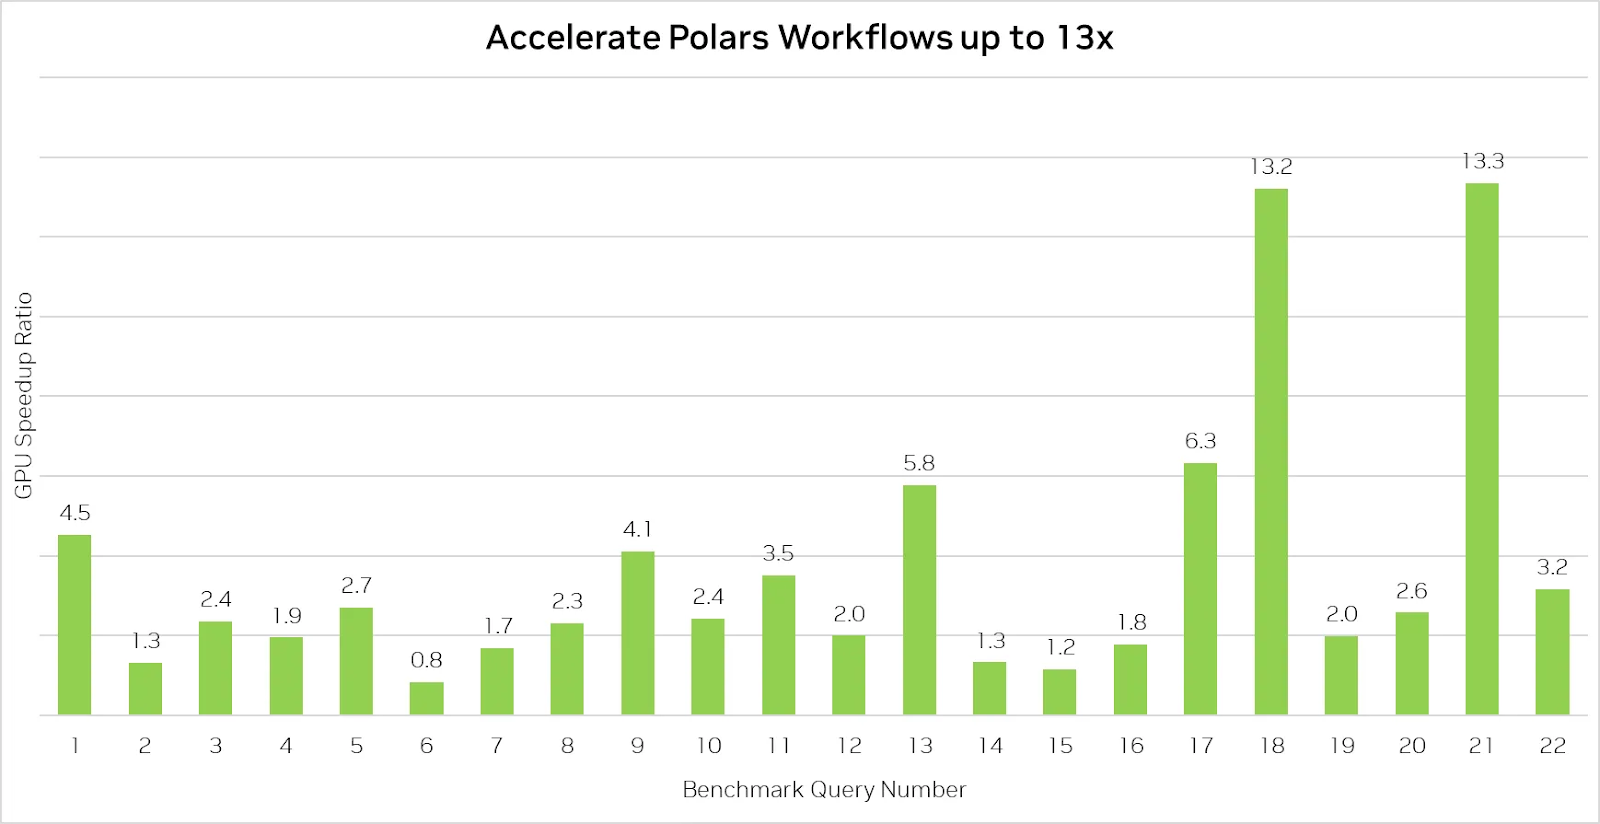
Die Polars GPU Engine beschleunigt Datenverarbeitung bis zu 13×. Bildquelle: Polars
Der obige Benchmark zeigt eindrucksvoll, dass die Polars GPU Engine Abfragen um bis zu 13× beschleunigt.
Wichtig ist aber: Polars auf einer GPU ist nicht automatisch immer schneller als auf der CPU – insbesondere bei einfachen, wenig rechenintensiven Abfragen. Oft limitiert hier die Lesegeschwindigkeit von der Festplatte. Wenn I/O der Flaschenhals ist, bringt GPU-Beschleunigung naturgemäß weniger Vorteile.
Für komplexere Operationen hingegen liefert die GPU Engine deutliche Speedups – ideal bei großen Datensätzen oder Abfragen mit Joins, Group-bys und String-Verarbeitung.
Besonders überzeugend an der Integration ist ihre Flexibilität. Wie erwähnt, kann der Optimizer je nach Komplexität zwischen CPU- und GPU-Ausführung wechseln. Aber wie funktioniert dieser Übergang genau?
Bei der Ausführung auf der CPU folgt Polars einer strukturierten, stark optimierten Pipeline. Grob passiert Folgendes:
Wenn du GPU-Beschleunigung aktivierst, indem du engine="gpu" an .collect() übergibst, bleibt der Ablauf oberflächlich gleich. Hinter den Kulissen prüfen zusätzliche Schritte, welche Teile via cuDF auf die GPU ausgelagert werden können:
Dieses hybride Ausführungsmodell – bei dem GPU und CPU Hand in Hand arbeiten – macht Polars äußerst flexibel. Du profitierst von GPU-Beschleunigung, ohne bei nicht unterstützten Abfragen Kompromisse eingehen zu müssen. Der Release-Blogpost von Polars erklärt die Technik dahinter im Detail.
Jetzt zum spannendsten Teil! In diesem Abschnitt zeige ich dir Schritt für Schritt, wie du deine Umgebung einrichtest und GPU-beschleunigte Datenverarbeitung nutzt.
Am einfachsten startest du mit diesem Google-Colab-Notebook.
Colab bietet kostenlose, wenn auch begrenzte GPU-Nutzung – praktisch, wenn du nicht direkt Zugriff auf eine GPU hast. Wenn du das Notebook verwendest, starten wir unten bei Schritt 2; die vorherigen Schritte kannst du überspringen.
Bevor du die Polars GPU Engine installierst, stelle sicher, dass dein System die Anforderungen für NVIDIA RAPIDS cuDF erfüllt. Alle nötigen Spezifikationen – inklusive GPU-Kompatibilität und Treiberanforderungen – findest du in der RAPIDS-Dokumentation.
Für den Start mit der Polars GPU Engine empfiehlt es sich, eine virtuelle Umgebung anzulegen, um Abhängigkeiten sauber zu isolieren.
Ich nutze hier conda, du kannst aber auch deinen bevorzugten Paketmanager verwenden.
Zusätzlich zu Python kannst du JupyterLab in die Umgebung aufnehmen – ideal für interaktive Exploration und schnelle Analysen.
conda create -n polars-gpu -c conda-forge python=3.11 jupyterlabAktiviere die Umgebung anschließend so:
conda activate polars-gpuAktiviere jetzt die GPU-Beschleunigung, indem du Polars samt GPU Engine installierst. Damit werden auch cuDF und weitere Abhängigkeiten für NVIDIA GPUs eingerichtet:
pip install -U polars[gpu] --extra-index-url=https://pypi.nvidia.comNach der Installation fühlt sich die Arbeit mit Polars auf der GPU ähnlich an wie auf der CPU – nur eben deutlich schneller bei komplexen oder datenintensiven Workflows.
Wie bereits erklärt, optimiert die Polars-Engine den Ausführungsplan automatisch, nutzt die NVIDIA GPU bestmöglich und reduziert den Speicherverbrauch. Für Abfragen ohne GPU-Support greift ein eleganter CPU-Fallback – dein Workflow läuft ohne Unterbrechung weiter.
Lass uns die Engine mit ein paar einfachen Beispielen in Aktion sehen!
Für diese Demo nutzen wir einen 22-GB-Datensatz mit simulierten Finanztransaktionen von Kaggle. NVIDIA hostet ihn in einem Google Cloud Storage (GCS) Bucket, was schnelle Downloads sicherstellt.
Lade den Datensatz zunächst herunter:
!wget https://storage.googleapis.com/rapidsai/polars-demo/transactions.parquet -O transactions.parquetDa dieser Datensatz von Kaggle stammt, gelten die lizenz- und nutzungsrechtlichen Bedingungen des jeweiligen Kaggle-Datensatzes.
Lass uns den Datensatz mit Polars laden und das Schema prüfen:
import polars as pl
from polars.testing import assert_frame_equal

transactions = pl.scan_parquet("transactions.parquet")
transactions.collect_schema()
Hier die Ausgabe:
Schema([('CUST_ID', String),
        ('START_DATE', Date),
        ('END_DATE', Date),
        ('TRANS_ID', String),
        ('DATE', Date),
        ('YEAR', Int64),
        ('MONTH', Int64),
        ('DAY', Int64),
        ('EXP_TYPE', String),
        ('AMOUNT', Float64)])
Nun berechnen wir das gesamte Transaktionsvolumen, indem wir die Spalte AMOUNT summieren. Zuerst ohne GPU-Beschleunigung:
transactions.select(pl.col("AMOUNT").sum()).collect()Ausgabe:
AMOUNT
f64
3.6183e9
Das ist ein hohes Gesamtvolumen! Jetzt dieselbe Abfrage auf der GPU:
transactions.select(pl.col("AMOUNT").sum()).collect(engine="gpu")Ausgabe:
AMOUNT
f64
3.6183e9
Bei so einfachen Operationen liefern CPU und GPU dasselbe Ergebnis in ähnlicher Zeit, da die Abfrage nicht rechenintensiv genug ist, um stark von der GPU zu profitieren. Ihre Stärken spielt die GPU bei komplexeren Abfragen aus.
Weiter geht’s mit einer komplexeren Abfrage: Wir gruppieren Transaktionen nach Kundennummer (CUST_ID), summieren die Beträge und sortieren anschließend nach den höchsten Ausgaben.
Zuerst auf der CPU:
%%time
res_cpu = (
   transactions
   .group_by("CUST_ID")
   .agg(pl.col("AMOUNT").sum())
   .sort(by="AMOUNT", descending=True)
   .head()
   .collect()
)
res_cpu
Hier die Ausgabe:
CPU times: user 4.63 s, sys: 3.75 s, total: 8.38 s
Wall time: 6.04 s
CUST_ID
AMOUNT
str
f64
"CA9UYOQ5DA"
2.0290e6
"CJUK2MTM5Q"
1.8115e6
"CYXX1NBIKL"
1.8082e6
"C6ILEYAYQ9"
1.7961e6
"CCNBC305GI"
1.7274e6
Jetzt dieselbe Abfrage auf der GPU:
%%time
res_gpu = (
   transactions
   .group_by("CUST_ID")
   .agg(pl.col("AMOUNT").sum())
   .sort(by="AMOUNT", descending=True)
   .head()
   .collect(engine="gpu")
)
res_gpu
Ausgabe:
CPU times: user 347 ms, sys: 0 ns, total: 347 ms
Wall time: 353 ms
shape: (5, 2)
CUST_ID
AMOUNT
str
f64
"CA9UYOQ5DA"
2.0290e6
"CJUK2MTM5Q"
1.8115e6
"CYXX1NBIKL"
1.8082e6
"C6ILEYAYQ9"
1.7961e6
"CCNBC305GI"
1.7274e6
Wie du siehst, bringt die GPU bei komplexeren Abfragen massive Vorteile: Die Laufzeit sinkt von 6,04 Sekunden auf der CPU auf nur 353 Millisekunden auf der GPU!
Dieses Beispiel zeigt, wie stark die Polars GPU Engine groß angelegte Datenoperationen beschleunigen kann.
Weitere fortgeschrittene Beispiele findest du im zugehörigen Colab-Notebook.
Die Polars GPU Engine, angetrieben von NVIDIA RAPIDS cuDF, bringt beeindruckende Geschwindigkeitsgewinne – bis zu 13× schnellere Verarbeitung bei komplexen Operationen. Für sehr große Datensätze bietet Polars klare Vorteile gegenüber klassischen DataFrame-Bibliotheken.
Nicht jede Abfrage profitiert gleichermaßen von GPU-Beschleunigung, doch Polars ist insgesamt ein starkes Werkzeug für alle, die mit großen Daten arbeiten. Die einfache Integration und das hybride CPU-GPU-Modell machen Polars zu einem Top-Kandidaten für moderne Daten-Workflows.
Wenn du deine Kompetenzen in der Datenmanipulation – insbesondere mit Pandas – ausbauen willst, kann ich dir diese Kurse sehr empfehlen:
Diese Ressourcen liefern dir ein solides Fundament und ergänzen die starken Fähigkeiten von Tools wie Polars ideal!
Unsere Zertifizierungsprogramme helfen dir, dich von anderen abzuheben und potenziellen Arbeitgebern zu beweisen, dass deine Fähigkeiten für den Job geeignet sind.

Lerne mehr über Data Science und Python mit diesen Kursen!
Kurs
Kurs
Kurs