
Kurs
Geliştiriciler için Orta Düzey Python
2 sa
70.2K
Alıştırma and program your progress.
Google Ile Devam EdinKısa süre önce, açık beta sürümünden önce NVIDIA RAPIDS cuDF tarafından desteklenen Polars GPU motoruna erken erişim ayrıcalığına sahip oldum. Bu son teknoloji özellik, NVIDIA GPU’larıyla Polars işlemlerini 13 kata kadar hızlandırarak veri iş akışlarını dönüştürme potansiyeline sahip. Python’da büyük ölçekli veri kümeleriyle çalışıyorsanız, kaçırmak istemeyeceğiniz bir oyun değiştirici.
Bu blog yazısında, yeni Polars GPU motoru hakkında bilmeniz gereken her şeyi açıklayacak ve başlamanıza yardımcı olacak adım adım bir rehber sunacağım!
Çoğu veri bilimi iş akışının merkezinde, yapılandırılmış verileri ele almak için esnek ve sezgisel olan, tabular bir veri yapısı olan DataFrame bulunur. Basitçe söylemek gerekirse, veri biliminde herkes DataFrame’lerle çalışmıştır.
DataFrame’ler veri temizleme, filtreleme, gruplama ve dönüştürme için tanıdık ve tutarlı bir arayüz sunarak verilerin kolayca işlenmesini, keşfedilmesini ve analiz edilmesini sağlar.
Ancak büyük veri bağlamında, geleneksel DataFrame kütüphaneleri performans ve ölçeklenebilirlik açısından yetersiz kalabilir; işte tam bu noktada Polars devreye girer.
Polars hızlı ve verimli bir DataFrame kütüphanesidir ve kısa sürede yüksek performanslı veri işleme için en iyi seçeneklerden biri haline gelmiştir. Baştan sona Rust ile yazılan Polars, harici bağımlılıklara dayanmadan hız ve kaynak kullanımını optimize ederek donanıma yakın çalışacak şekilde tasarlanmıştır.
Polars’a Giriş blog yazısı, kütüphaneye Python’da başlamak için mükemmel bir kaynaktır.
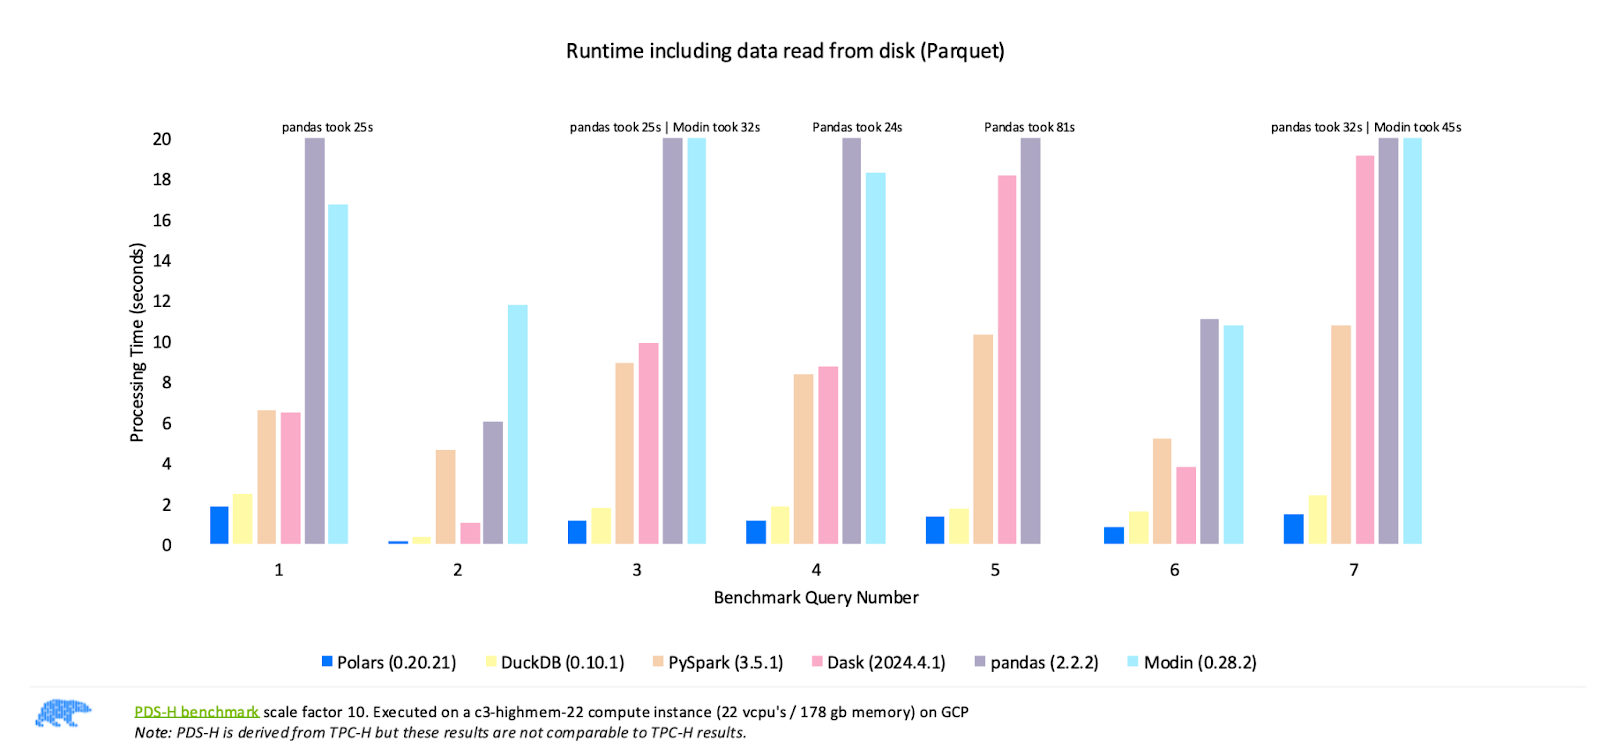
En popüler DataFrame kütüphanelerinin performans karşılaştırması. Görsel kaynağı: Polars
Yukarıdaki görselde sunulan Polars’ın yayımladığı kıyaslama sonuçları, farklı sorgularda Polars’ın Pandas, Modin, PySpark ve Dask gibi diğer kütüphaneleri sürekli olarak geride bıraktığını gösteriyor. Bu sonuçlar, yüksek performanslı veri işleme için Polars’ın en hızlı seçenek olduğunu ortaya koyuyor.
Peki bu nasıl mümkün oluyor? Polars’ı son derece hızlı kılan bazı özellikler şunlar:
Ve Polars GPU motorunun yakın zamanda duyurulan açık betasıyla birlikte, artık daha da hızlı olacak!
Veri kümeleri yüz milyonlara hatta milyarlarca satıra ölçeklendikçe, daha hızlı veri işleme ve analiz ihtiyacı son yıllarda katlanarak arttı. Bu zorluğu aşmak için veri bilimi alanında geleneksel CPU tabanlı işlemelerden GPU hızlandırmalı hesaplamaya doğru artan bir geçiş görüyoruz. İşte NVIDIA RAPIDS cuDF burada devreye giriyor.
NVIDIA RAPIDS GPU hızlandırmalı veri bilimi ve analitiği mümkün kılan, açık kaynaklı bir kütüphane paketidir. RAPIDS’in özünde, tipik olarak CPU ile sınırlı görevleri hızlandırmak için NVIDIA GPU’larının muazzam paralelliğinden yararlanarak veri iş akışlarını basitleştirmek vardır.
RAPIDS içerisinde, cuDF DataFrame işlemlerinden sorumlu kütüphanedir. cuDF, tanıdık DataFrame soyutlamasını GPU belleğine genişleterek kapsamlı kod değişiklikleri olmadan veri iş akışlarına entegre olmayı sağlar. Kütüphane, veri bilimcilerinin DataFrame’lerde gerçekleştirdiği tüm temel işlemleri destekler: filtreleme, birleştirme, bir araya getirme ve sıralama; bunların tümü hız için GPU tarafından desteklenir.
NVIDIA ve Polars kısa süre önce RAPIDS cuDF tarafından desteklenen Python Polars GPU motorunun açık beta sürümünü duyurdu. Bu yeni özellik, NVIDIA GPU’larına sahip Polars kullanıcıları için iş akışlarında 13 kata kadar hız sağlayarak yüksek performanslı veri işleme alanında önemli bir sıçrama anlamına geliyor!
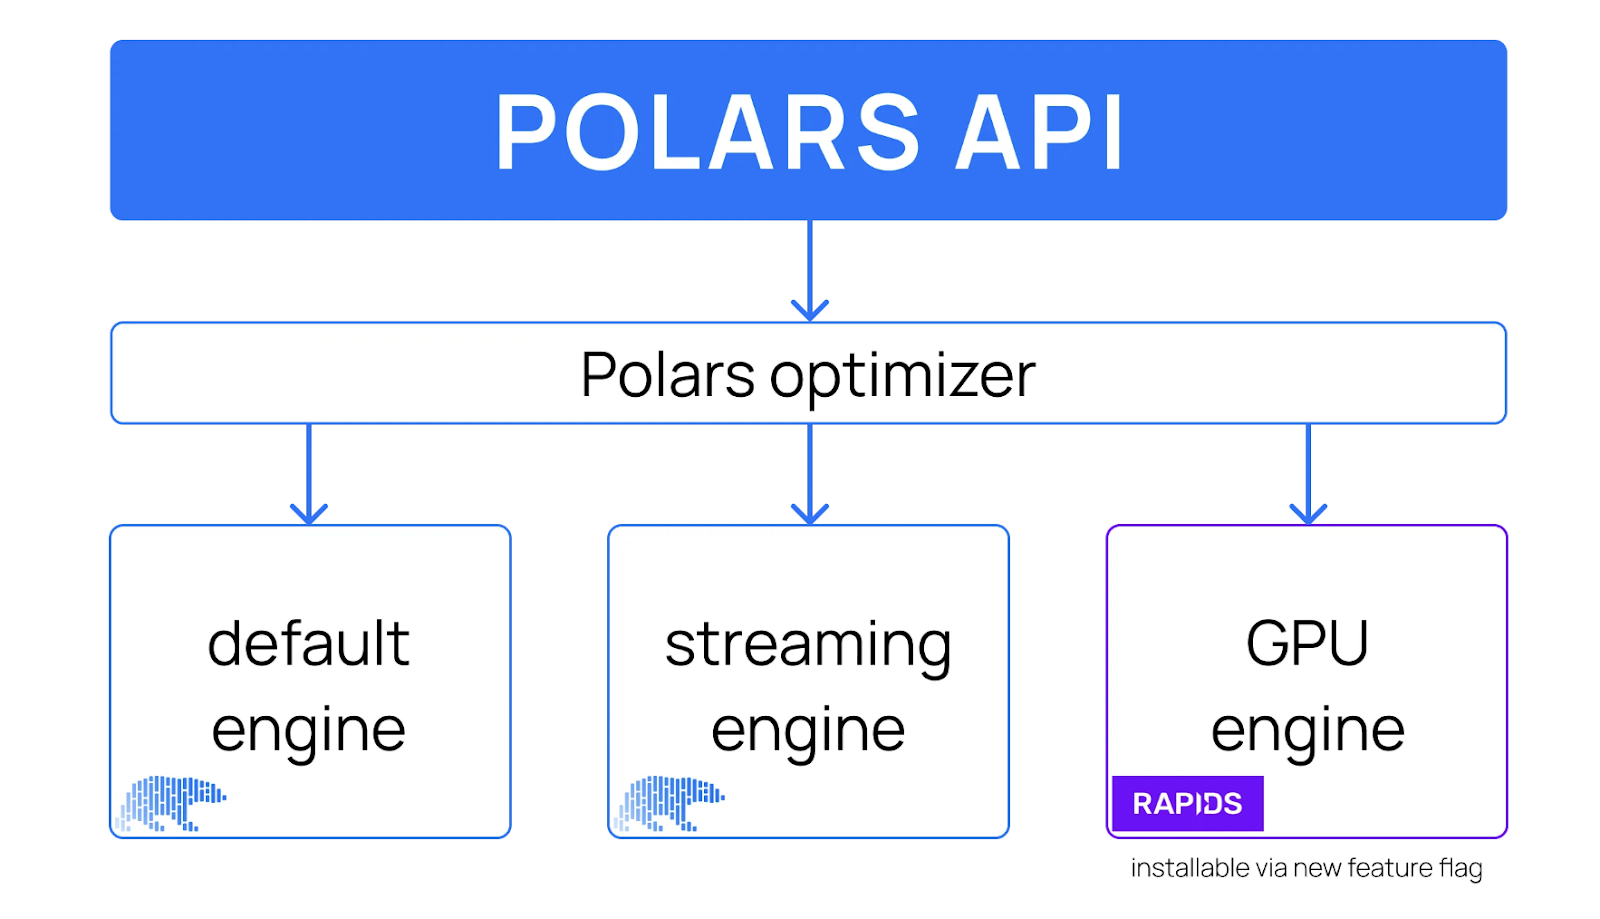
GPU motoru dahil Polars API’nin yüksek seviyeli tasarımı. Görsel kaynağı: Polars
GPU motorunun eklenmesiyle, Polars kullanıcıları veri iş yüklerini hangi motor üzerinde çalıştıracaklarına karar verebilir. Polars eniyileştiricisi tüm motorları destekler ve hangi sorguların GPU’da ya da CPU’da çalıştırılabileceğini dinamik olarak belirler.
Artık Polars ve NVIDIA RAPIDS cuDF kütüphanesi hakkında ve her ikisinin Python Polars API’si üzerinden nasıl entegre edildiğine dair biraz bağlamınız var. Peki bu geliştiriciler ve veri bilimciler için ne anlama geliyor?
Polars GPU motorunun sunduklarının özeti:
engine="gpu" parametresini collect() işlemine geçirerek, önemli kod değişiklikleri olmadan GPU işlemeyi etkinleştirebilir.Peki, şimdiye kadarki sonuçlar neler? Hadi bakalım.
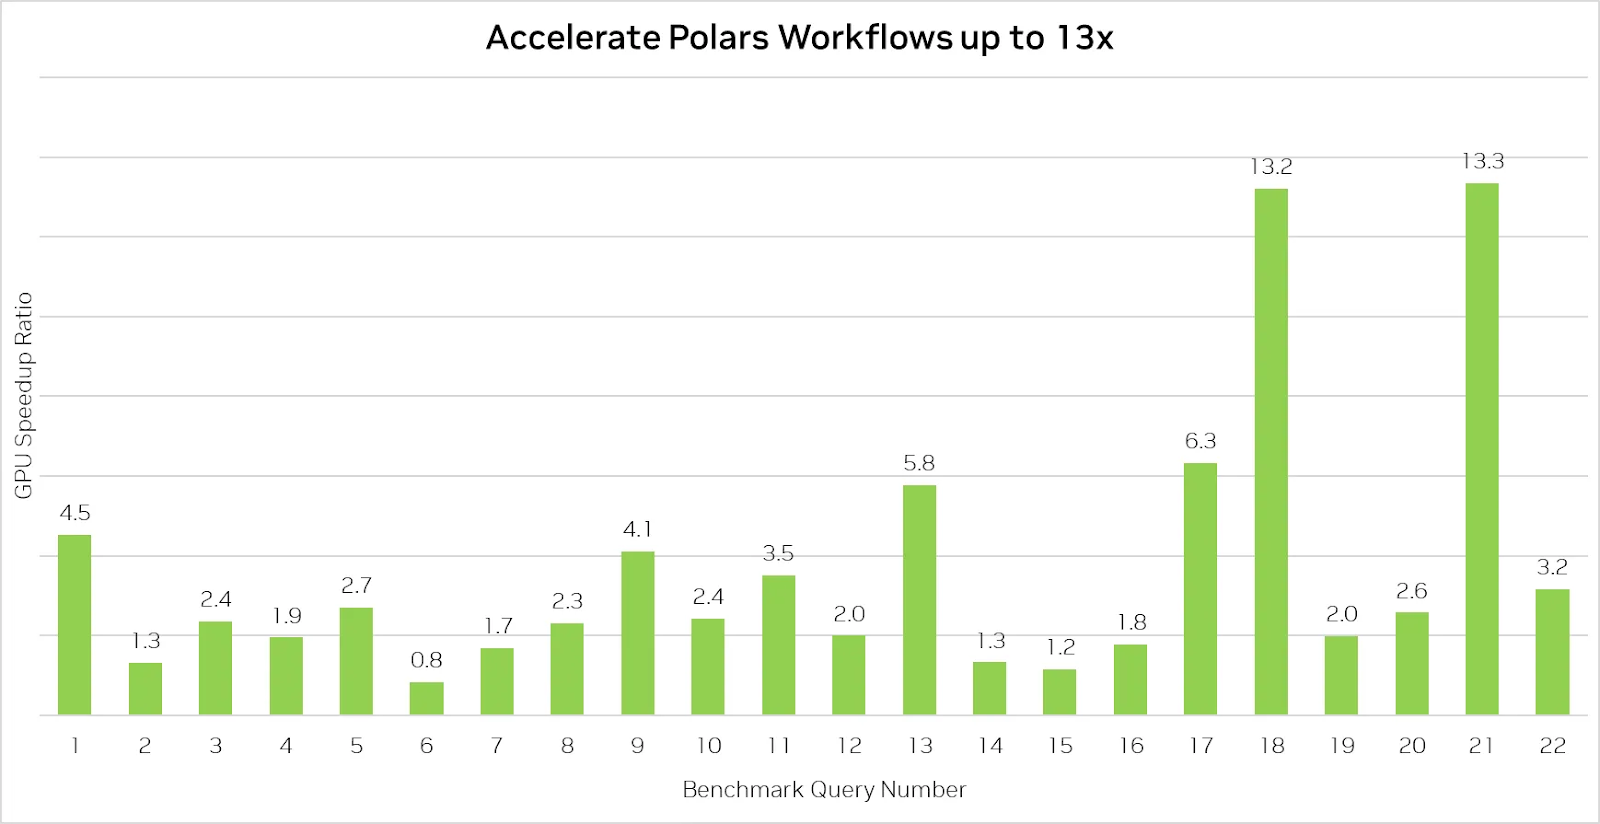
Polars GPU Motoru veri işlemeyi 13 kata kadar hızlandırır. Görsel kaynağı: Polars
Yukarıdaki kıyaslama, Polars GPU motorunun sorguları 13 kata kadar hızlandırarak etkileyici yeteneklerini gösteriyor.
Ancak, özellikle hesaplama açısından yoğun olmayan daha basit sorgular için Polars’ı GPU’da kullanmanın her zaman CPU’dan daha hızlı olacağının garanti edilmediğini unutmamak önemlidir. Bu gibi durumlarda, performans genellikle verinin diskten okuma hızıyla sınırlıdır; yani giriş/çıkış (G/Ç) işlemlerinin ana kısıt olduğu durumlarda GPU hızlandırması daha az avantaj sağlar.
Bununla birlikte, GPU motoru daha karmaşık veri işlemleri için önemli hız artışları sunar ve büyük veri kümeleriyle veya join, group-by ve metin işleme içeren sorgularla çalışan ekipler için değerli bir araçtır.
Bu yeni entegrasyonun en etkileyici özelliklerinden biri esnekliğidir. Daha önce belirtildiği gibi, eniyileştirici sorgularınızın karmaşıklığına bağlı olarak CPU ve GPU yürütmesi arasında geçiş yapabilir. Peki bu geçiş tam olarak nasıl çalışır?
Polars’ı CPU üzerinde çalıştırırken, motor veri işlemlerini yürütmek için yapılandırılmış ve yüksek düzeyde optimize edilmiş bir ardışık düzen izler. Bu süreç yaklaşık olarak şu adımlardan oluşur:
engine="gpu" parametresini .collect() metoduna geçirerek GPU hızlandırmayı etkinleştirdiğinizde, süreç yüzeyde temelde aynı kalır; ancak perde arkasında iş yükünün ne kadarının cuDF aracılığıyla GPU’ya aktarılabileceğini belirlemek için ek kontroller ve eniyileştirmeler yapılır:
GPU ve CPU’nun birlikte kullanıldığı bu hibrit yürütme modeli, Polars’ı son derece esnek kılar. GPU hızlandırmasından yararlanırken, GPU’da desteklenmeyen sorgular için uyumluluktan ödün vermezsiniz. Polars’ın sürüm blog yazısı bunu teknik olarak daha derinlemesine açıklar.
Gelelim en heyecanlı kısma! Bu bölümde, ortamınızı kurmak ve GPU hızlandırmalı veri işlemeye başlamanız için gereken adımları anlatacağım.
Başlamanın en pratik yolu, şu Google Colab defterini takip etmektir.
Colab, özellikle GPU’ya anında erişiminiz yoksa faydalı olan, sınırlı da olsa ücretsiz GPU kullanımı sunar. Sağlanan defteri kullanıyorsanız, aşağıda 2. adımdan başlıyoruz; önceki adımları atlayabilirsiniz.
Polars GPU motorunu yüklemeden önce, sisteminizin NVIDIA RAPIDS cuDF gereksinimlerini karşıladığından emin olun. Gerekli sistem özelliklerini, GPU uyumluluğunu ve sürücü gereksinimlerini RAPIDS dokümantasyon sayfasında inceleyebilirsiniz.
Polars GPU motoruyla başlamanın en iyi uygulaması, proje bağımlılıklarını yalıtmak için bir sanal ortam oluşturmaktır.
Bu örnekte conda kullanıyorum, ancak tercih ettiğiniz paket yöneticisini kullanmakta özgürsünüz.
Python’a ek olarak, özellikle küçük kod parçacıklarını çalıştırmak ve veri kümelerini anlık analiz etmek için yararlı olan JupyterLab’i de ortama dahil edebilirsiniz.
conda create -n polars-gpu -c conda-forge python=3.11 jupyterlabSanal ortamı oluşturduktan sonra şu komutla etkinleştirin:
conda activate polars-gpuŞimdi, Polars ve GPU motorunu yükleyerek GPU hızlandırmayı etkinleştirelim. Bu, ayrıca NVIDIA GPU’ları kullanmak için gerekli olan cuDF ve diğer bağımlılıkları da kuracaktır:
pip install -U polars[gpu] --extra-index-url=https://pypi.nvidia.comPolars GPU motoru kurulduktan sonra, GPU üzerinde Polars kullanımı CPU ile çalışmaya oldukça benzer hissedilecek; ancak karmaşık veya veri yoğun iş akışlarında çok daha hızlı sonuçlar verecektir.
Daha önce açıklandığı gibi, Polars motoru yürütme planını otomatik olarak optimize eder; işlemleri hızlandırmak ve bellek kullanımını en aza indirmek için NVIDIA GPU’sundan tam anlamıyla yararlanır. GPU hızlandırmasını desteklemeyen sorgular için Polars GPU motorunda zarif bir CPU geri dönüşü vardır; bu sayede iş akışı kesintisiz devam eder.
Hadi, birkaç basit örnekle motoru çalışırken görelim!
Bu demoda, Kaggle’dan 22 GB’lık simüle edilmiş finansal işlemler veri kümesini kullanacağız. NVIDIA, hızlı indirme hızlarını sağlamak için veri setini bir Google Cloud Storage (GCS) kovasında barındırıyor.
Başlamak için, veri kümesini indirin:
!wget https://storage.googleapis.com/rapidsai/polars-demo/transactions.parquet -O transactions.parquetBu veri kümesi Kaggle kaynaklı olduğundan, Kaggle veri kümesine özgü bir lisans ve kullanım şartlarına tabidir.
Veri kümesini Polars ile yükleyelim ve şemayı inceleyelim:
import polars as pl
from polars.testing import assert_frame_equal

transactions = pl.scan_parquet("transactions.parquet")
transactions.collect_schema()
Çıktı şöyle:
Schema([('CUST_ID', String),
        ('START_DATE', Date),
        ('END_DATE', Date),
        ('TRANS_ID', String),
        ('DATE', Date),
        ('YEAR', Int64),
        ('MONTH', Int64),
        ('DAY', Int64),
        ('EXP_TYPE', String),
        ('AMOUNT', Float64)])
Şimdi toplam işlem hacmini AMOUNT sütununu toplayarak hesaplayalım. Önce GPU hızlandırma olmadan deneyelim:
transactions.select(pl.col("AMOUNT").sum()).collect()Çıktı:
AMOUNT
f64
3.6183e9
Toplam işlem hacmi epey yüksek! Aynı sorguyu GPU’da çalıştıralım:
transactions.select(pl.col("AMOUNT").sum()).collect(engine="gpu")Çıktı:
AMOUNT
f64
3.6183e9
Bu tür basit işlemlerde CPU ve GPU benzer hızlarda aynı sonucu üretir; çünkü sorgu GPU hızlandırmasından kayda değer ölçüde faydalanacak kadar hesaplama açısından yoğun değildir. Ancak GPU, daha karmaşık sorgularda parlayacaktır.
Şimdi daha karmaşık bir sorguya geçelim. Bu sorguda, işlemleri müşteri kimliğine (CUST_ID) göre gruplayıp toplam işlem tutarlarını toplayacak ve ardından sonuçları en çok harcama yapana göre sıralayacağız.
Önce CPU’da çalıştıralım:
%%time
res_cpu = (
   transactions
   .group_by("CUST_ID")
   .agg(pl.col("AMOUNT").sum())
   .sort(by="AMOUNT", descending=True)
   .head()
   .collect()
)
res_cpu
Çıktı şöyle:
CPU times: user 4.63 s, sys: 3.75 s, total: 8.38 s
Wall time: 6.04 s
CUST_ID
AMOUNT
str
f64
"CA9UYOQ5DA"
2.0290e6
"CJUK2MTM5Q"
1.8115e6
"CYXX1NBIKL"
1.8082e6
"C6ILEYAYQ9"
1.7961e6
"CCNBC305GI"
1.7274e6
Şimdi aynı sorguyu GPU’da çalıştıralım:
%%time
res_gpu = (
   transactions
   .group_by("CUST_ID")
   .agg(pl.col("AMOUNT").sum())
   .sort(by="AMOUNT", descending=True)
   .head()
   .collect(engine=”gpu”)
)
res_gpu
Çıktı:
CPU times: user 347 ms, sys: 0 ns, total: 347 ms
Wall time: 353 ms
shape: (5, 2)
CUST_ID
AMOUNT
str
f64
"CA9UYOQ5DA"
2.0290e6
"CJUK2MTM5Q"
1.8115e6
"CYXX1NBIKL"
1.8082e6
"C6ILEYAYQ9"
1.7961e6
"CCNBC305GI"
1.7274e6
Gördüğümüz gibi, daha karmaşık sorgularda GPU kullanmak önemli performans kazanımları sağlar; yürütme süresini CPU’da 6,04 saniyeden GPU’da yalnızca 353 milisaniyeye düşürüyor!
Bu örnek, Polars GPU motorunun büyük ölçekli veri işlemleri için sağladığı güçlü performans artışını gösteriyor.
Daha gelişmiş örnekleri ilgili Colab defterinde bulabilirsiniz.
NVIDIA RAPIDS cuDF tarafından desteklenen Polars GPU Motoru, karmaşık işlemlerde 13 kata kadar daha hızlı veri işleme ile etkileyici hız iyileştirmeleri getiriyor. Büyük ölçekli veri kümeleri için Polars, geleneksel DataFrame kütüphanelerine kıyasla net bir avantaj sunar.
Her sorgu GPU hızlandırmasından eşit derecede faydalanmasa da, Polars büyük veri kümeleriyle çalışan herkes için güçlü bir araç olmaya devam ediyor. Entegrasyonun kolaylığı ve hibrit CPU-GPU yürütme modeli, Polars’ı modern veri iş akışları için güçlü bir aday haline getiriyor.
Özellikle Pandas ile veri işleme becerilerinizi geliştirmekle ilgileniyorsanız, şu kursları şiddetle öneririm:
Bu kaynaklar, Polars gibi araçların güçlü yeteneklerini tamamlayan sağlam bir temel sağlayacaktır!
Bu kurslarla veri bilimi ve Python hakkında daha fazla bilgi edinin!
Kurs
Kurs
Alıştırma and program your progress.
Google Ile Devam Edinblog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




