Cours
Python intermédiaire pour les développeurs
2 h
67.4K
J’ai récemment eu le privilège d’accéder en avant-première au moteur GPU de Polars, propulsé par NVIDIA RAPIDS cuDF, avant sa sortie en bêta ouverte. Cette fonctionnalité de pointe peut transformer les workflows de données en accélérant les opérations Polars jusqu’à 13x avec des GPU NVIDIA. Si vous travaillez en Python sur des jeux de données massifs, c’est un tournant à ne pas manquer.
Dans cet article, je vous explique tout ce qu’il faut savoir sur le nouveau moteur GPU de Polars et je vous propose un guide pas à pas pour bien démarrer !
Au cœur de la plupart des workflows de data science, on trouve le DataFrame, une structure tabulaire à la fois flexible et intuitive pour manipuler des données structurées. En clair, tout le monde en data science a déjà travaillé avec des DataFrames.
Les DataFrames permettent de manipuler, explorer et analyser facilement les données, avec une interface familière et cohérente pour nettoyer, filtrer, regrouper et transformer.
Cependant, à l’échelle du big data, les bibliothèques de DataFrame classiques peuvent montrer leurs limites en performance et en montée en charge : c’est là que Polars entre en scène.
Polars est une bibliothèque DataFrame rapide et efficace, rapidement devenue un choix de référence pour le traitement de données haute performance. Écrite from scratch en Rust, Polars est conçue pour opérer au plus près du matériel, optimisant vitesse et ressources sans dépendances externes.
Le billet Introduction à Polars est une excellente ressource pour débuter avec la bibliothèque en Python.
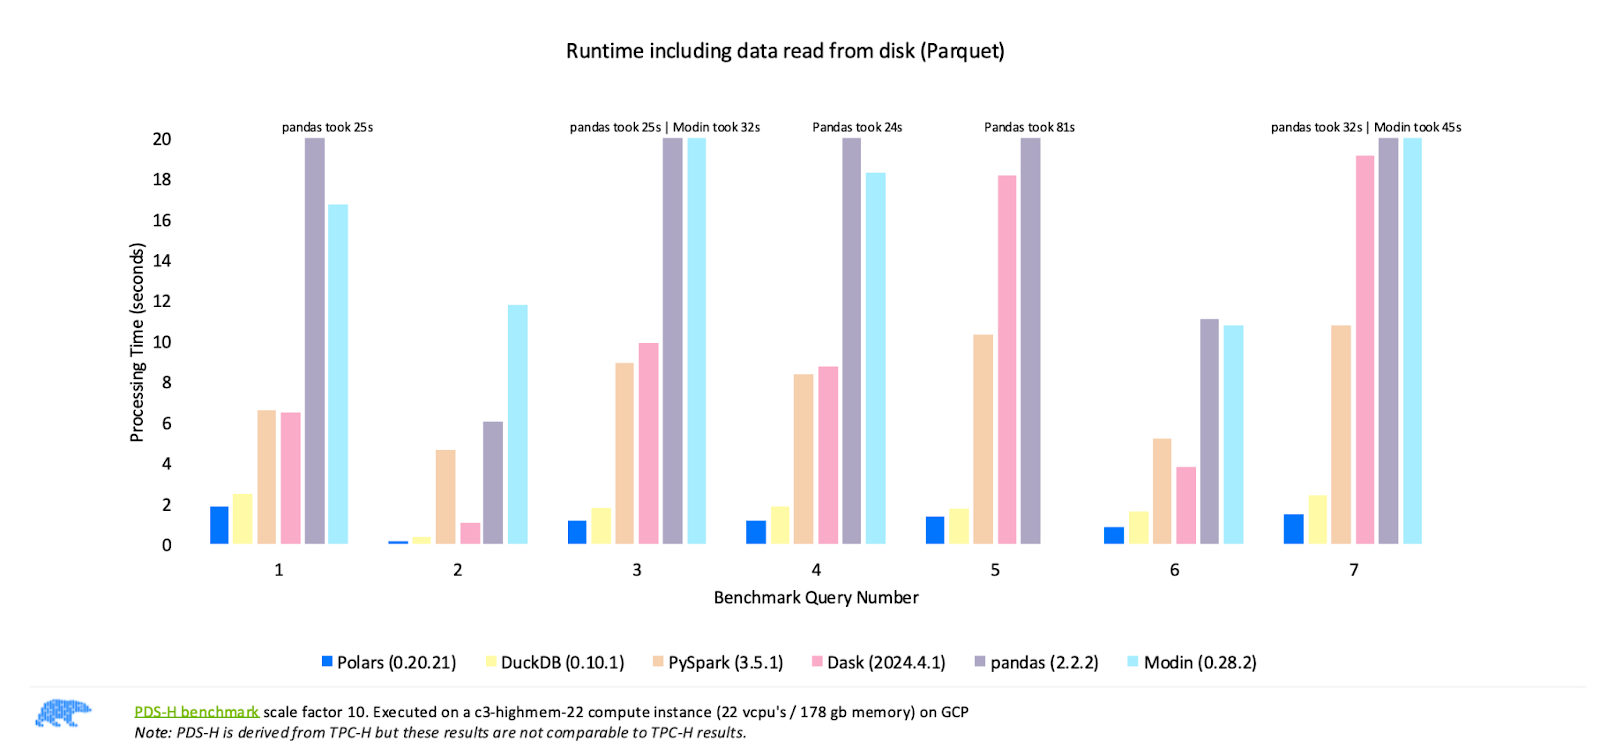
Comparaison des performances des bibliothèques DataFrame les plus populaires. Source : Polars
Les benchmarks publiés par Polars, illustrés ci-dessus, montrent que Polars surpasse systématiquement d’autres bibliothèques comme Pandas, Modin, PySpark et Dask selon les types de requêtes. Ces résultats confirment que Polars est l’option la plus rapide pour le traitement de données haute performance.
Mais comment est-ce possible ? Voici quelques atouts qui rendent Polars ultra-rapide :
Et avec l’annonce récente de la bêta ouverte du moteur GPU de Polars, cela va devenir encore plus rapide !
La demande pour un traitement et une analyse des données plus rapides a explosé ces dernières années, alors que les jeux de données ont atteint des centaines de millions, voire des milliards de lignes. Pour relever ce défi, le domaine de la data science a connu un passage croissant du traitement basé sur CPU vers le calcul accéléré par GPU. C’est là qu’intervient NVIDIA RAPIDS cuDF.
NVIDIA RAPIDS est une suite open source de bibliothèques qui permet la data science et l’analytique accélérées par GPU. Au cœur de RAPIDS, l’idée est de fluidifier les workflows de données en exploitant le parallélisme massif des GPU NVIDIA pour accélérer des tâches habituellement limitées par le CPU.
Au sein de RAPIDS, cuDF est la bibliothèque dédiée aux opérations sur DataFrame. cuDF étend l’abstraction familière du DataFrame à la mémoire GPU, ce qui permet son intégration dans les workflows de données sans modifications lourdes du code. La bibliothèque prend en charge toutes les opérations clés réalisées sur des DataFrames : filtrage, agrégation, jointure et tri, le tout accéléré par GPU.
NVIDIA et Polars viennent d’annoncer la bêta ouverte du moteur GPU de Polars pour Python, propulsé par RAPIDS cuDF. Cette nouveauté marque une avancée majeure pour le traitement de données haute performance, avec des workflows jusqu’à 13x plus rapides pour les utilisateurs de Polars équipés de GPU NVIDIA !
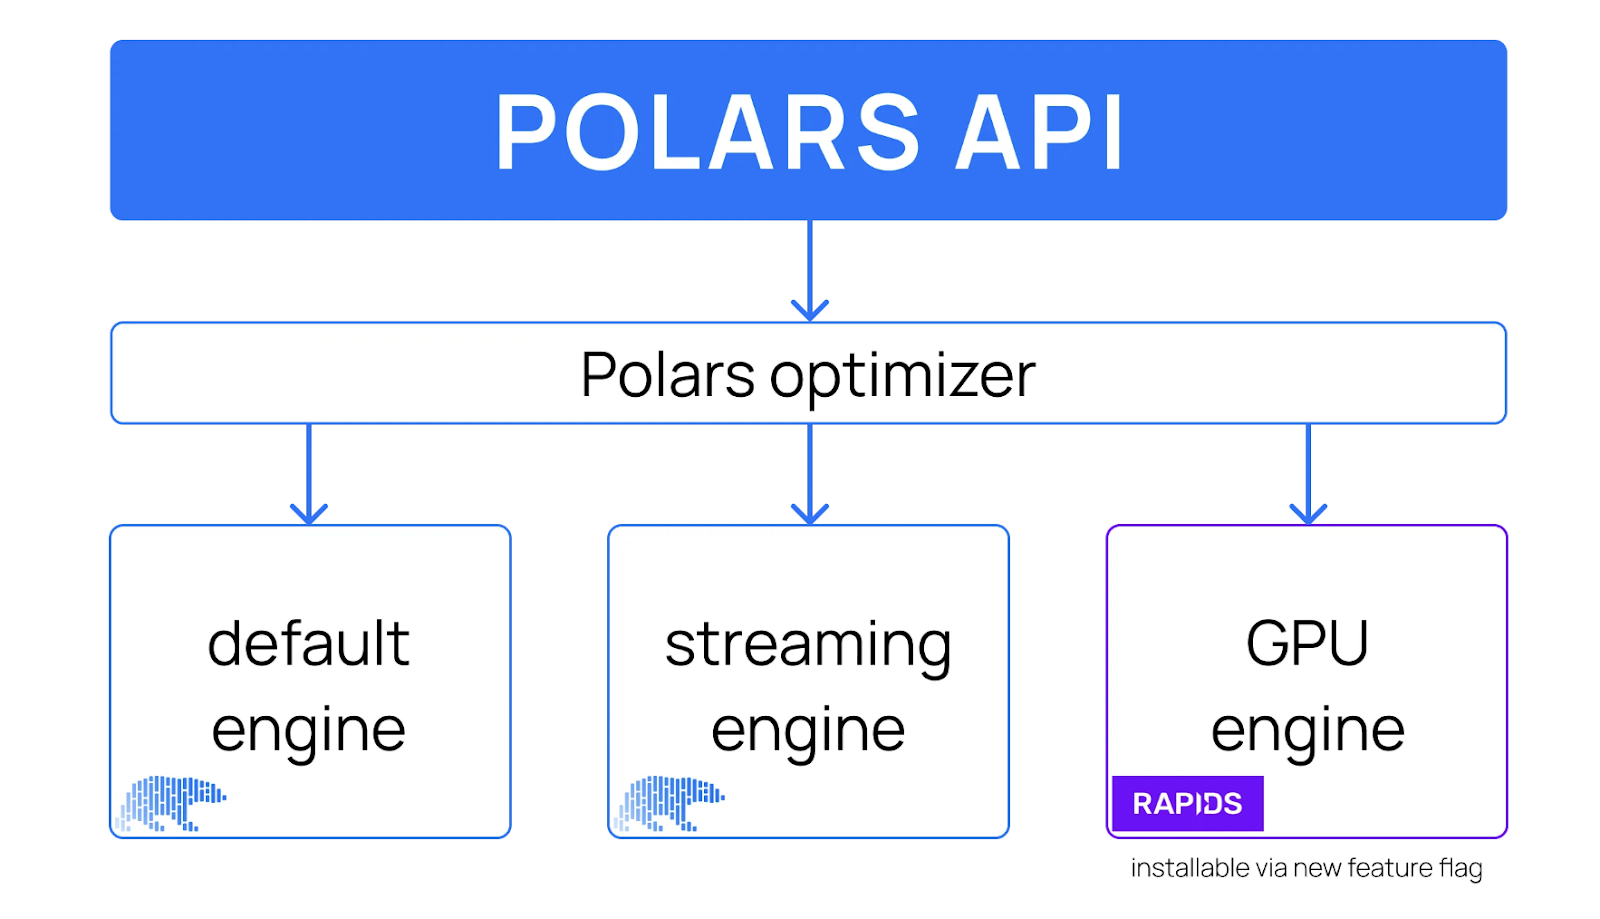
Conception haut niveau de l’API Polars, incluant un moteur GPU. Source : Polars
Avec l’ajout du moteur GPU, les utilisateurs de Polars peuvent choisir sur quel moteur exécuter leurs charges de données. L’optimiseur Polars prend en charge tous les moteurs et détermine dynamiquement quelles requêtes s’exécutent sur GPU ou CPU.
Vous avez désormais le contexte sur Polars et la bibliothèque NVIDIA RAPIDS cuDF, et comment l’ensemble s’intègre via l’API Python de Polars. Mais concrètement, qu’est-ce que cela change pour les développeurs et data scientists ?
Voici un résumé de ce que permet le moteur GPU de Polars :
engine="gpu" à l’opération collect() de la Lazy API de Polars pour activer le traitement sur GPU, sans modification majeure du code.Alors, quels sont les résultats à ce jour ? Voyons cela.
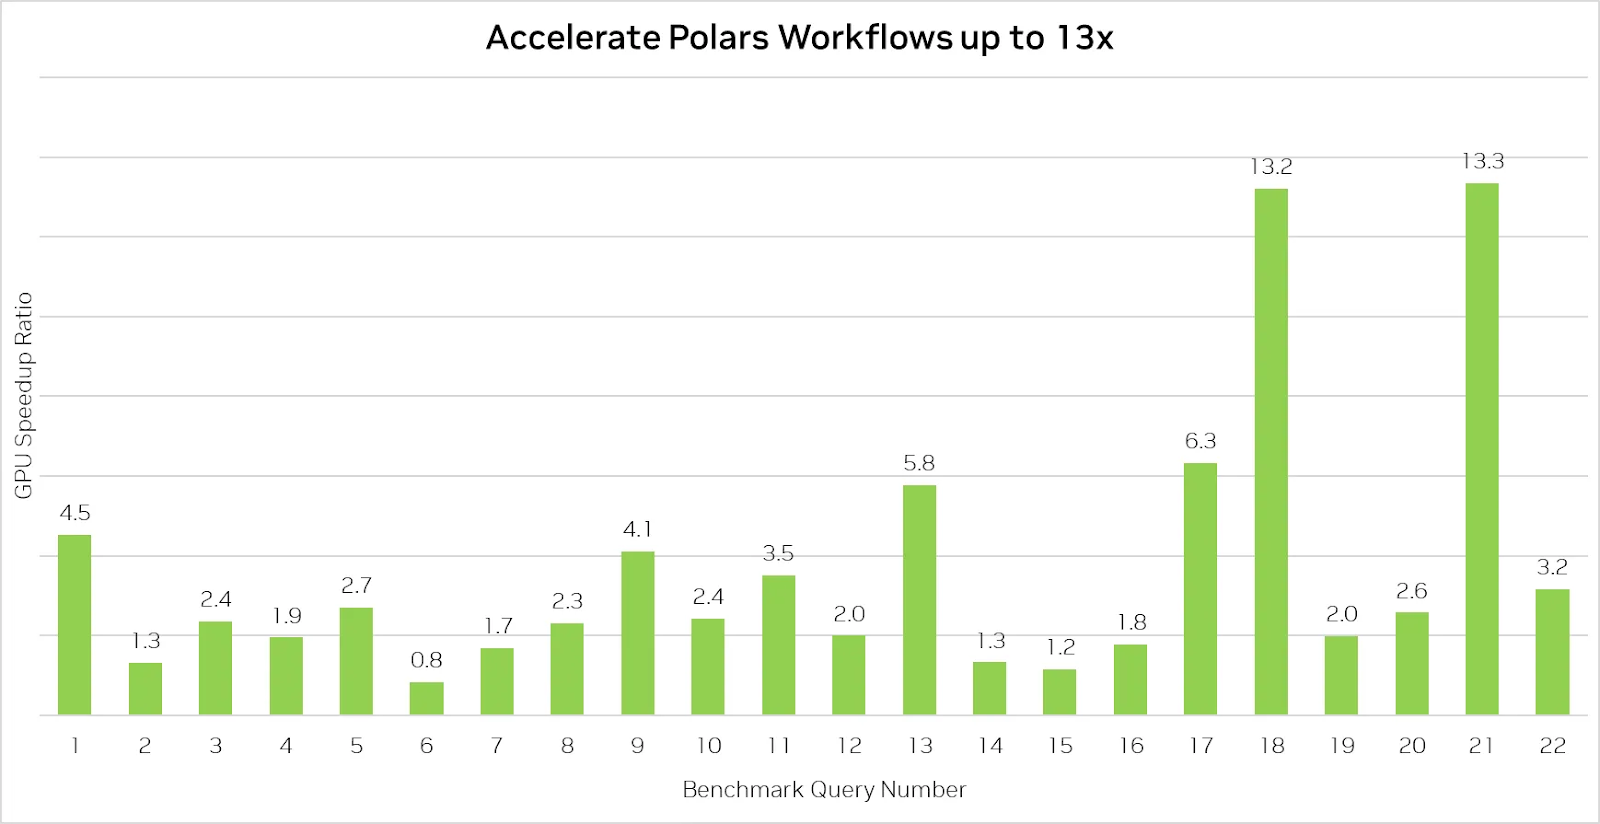
Le moteur GPU de Polars accélère le traitement des données jusqu’à 13x. Source : Polars
Le benchmark ci-dessus illustre les performances remarquables du moteur GPU de Polars, avec des requêtes accélérées jusqu’à 13x.
Cependant, il est important de noter que Polars sur GPU n’est pas toujours plus rapide que sur CPU, en particulier pour des requêtes simples et peu intensives. Dans ces cas, les performances sont souvent limitées par la vitesse de lecture disque : l’accélération GPU apporte donc peu lorsque les opérations d’entrée/sortie (I/O) constituent le principal goulot d’étranglement.
Cela dit, le moteur GPU apporte des gains substantiels pour des opérations plus complexes, ce qui en fait un outil précieux pour les équipes manipulant de larges jeux de données ou des requêtes avec jointures, group-by et traitements de chaînes.
L’une des fonctionnalités les plus convaincantes de cette intégration est sa flexibilité. Comme mentionné plus haut, l’optimiseur peut basculer entre exécution CPU et GPU selon la complexité des requêtes. Mais comment ce passage s’opère-t-il concrètement ?
Lors d’une exécution sur CPU, Polars suit un pipeline structuré et très optimisé. Le processus comporte globalement les étapes suivantes :
Quand vous activez le GPU en passant engine="gpu" à .collect(), le processus reste globalement identique en surface, mais des vérifications et optimisations supplémentaires déterminent quelles parties déporter sur le GPU via cuDF :
Ce modèle d’exécution hybride — où GPU et CPU travaillent de concert — rend Polars très flexible. Vous profitez de l’accélération GPU sans sacrifier la compatibilité des requêtes non prises en charge sur GPU. Le billet de sortie de Polars détaille l’aspect technique.
Passons au plus excitant ! Dans cette section, je vous guide pour configurer votre environnement et tirer parti du traitement accéléré par GPU.
La manière la plus simple de se lancer est de suivre ce notebook Google Colab.
Colab offre un accès gratuit et limité aux GPU, particulièrement utile si vous n’en avez pas sous la main. Si vous utilisez le notebook fourni, commencez à l’étape 2 ci-dessous et ignorez les précédentes.
Avant d’installer le moteur GPU de Polars, vérifiez que votre système répond aux exigences de NVIDIA RAPIDS cuDF. Consultez les spécifications système (compatibilité GPU, pilotes, etc.) sur la page de documentation RAPIDS.
Pour démarrer avec le moteur GPU de Polars, il est recommandé d’isoler les dépendances du projet dans un environnement virtuel.
J’utilise conda pour l’exemple, mais vous pouvez employer le gestionnaire de paquets de votre choix.
En plus de Python, vous pouvez inclure JupyterLab pour l’exploration interactive, pratique pour exécuter de petits extraits de code et analyser les jeux de données à la volée.
conda create -n polars-gpu -c conda-forge python=3.11 jupyterlabAprès avoir créé l’environnement virtuel, activez-le :
conda activate polars-gpuActivons maintenant l’accélération GPU en installant Polars et son moteur GPU. Cette commande configure aussi cuDF et les autres dépendances nécessaires pour utiliser les GPU NVIDIA :
pip install -U polars[gpu] --extra-index-url=https://pypi.nvidia.comUne fois le moteur GPU de Polars installé, l’usage sur GPU ressemble à l’expérience CPU, mais avec des gains notables pour les workflows complexes ou volumineux.
Comme expliqué plus haut, le moteur Polars optimise automatiquement le plan d’exécution, en exploitant pleinement le GPU NVIDIA pour accélérer les opérations et réduire l’empreinte mémoire. Pour les requêtes non prises en charge par le GPU, le basculement CPU est transparent afin d’assurer la continuité du traitement.
Passons à la pratique avec quelques exemples simples !
Pour cette démonstration, nous utiliserons un jeu de données de 22 Go de transactions financières simulées issu de Kaggle. NVIDIA l’héberge dans un bucket Google Cloud Storage (GCS) pour des téléchargements rapides.
Commencez par télécharger le dataset :
!wget https://storage.googleapis.com/rapidsai/polars-demo/transactions.parquet -O transactions.parquetÉtant donné que ce jeu de données provient de Kaggle, il est soumis à une licence et des conditions d’utilisation spécifiques à Kaggle.
Chargeons maintenant le dataset avec Polars et inspectons le schéma :
import polars as pl
from polars.testing import assert_frame_equal

transactions = pl.scan_parquet("transactions.parquet")
transactions.collect_schema()
Voici la sortie :
Schema([('CUST_ID', String),
        ('START_DATE', Date),
        ('END_DATE', Date),
        ('TRANS_ID', String),
        ('DATE', Date),
        ('YEAR', Int64),
        ('MONTH', Int64),
        ('DAY', Int64),
        ('EXP_TYPE', String),
        ('AMOUNT', Float64)])
Calculons maintenant le volume total des transactions en sommant la colonne AMOUNT. D’abord sans accélération GPU :
transactions.select(pl.col("AMOUNT").sum()).collect()Sortie :
AMOUNT
f64
3.6183e9
Le total est conséquent ! Exécutons la même requête sur GPU :
transactions.select(pl.col("AMOUNT").sum()).collect(engine="gpu")Sortie :
AMOUNT
f64
3.6183e9
Pour des opérations simples comme celle-ci, CPU et GPU donnent le même résultat en un temps similaire : la requête est trop légère pour profiter réellement de l’accélération GPU. Le GPU brillera sur des requêtes plus complexes.
Passons à une requête plus élaborée. Nous groupons les transactions par identifiant client (CUST_ID), nous totalisons les montants, puis nous trions par les plus gros dépensiers.
D’abord sur CPU :
%%time
res_cpu = (
   transactions
   .group_by("CUST_ID")
   .agg(pl.col("AMOUNT").sum())
   .sort(by="AMOUNT", descending=True)
   .head()
   .collect()
)
res_cpu
Sortie :
CPU times: user 4.63 s, sys: 3.75 s, total: 8.38 s
Wall time: 6.04 s
CUST_ID
AMOUNT
str
f64
"CA9UYOQ5DA"
2.0290e6
"CJUK2MTM5Q"
1.8115e6
"CYXX1NBIKL"
1.8082e6
"C6ILEYAYQ9"
1.7961e6
"CCNBC305GI"
1.7274e6
Maintenant sur GPU :
%%time
res_gpu = (
   transactions
   .group_by("CUST_ID")
   .agg(pl.col("AMOUNT").sum())
   .sort(by="AMOUNT", descending=True)
   .head()
   .collect(engine=”gpu”)
)
res_gpu
Sortie :
CPU times: user 347 ms, sys: 0 ns, total: 347 ms
Wall time: 353 ms
shape: (5, 2)
CUST_ID
AMOUNT
str
f64
"CA9UYOQ5DA"
2.0290e6
"CJUK2MTM5Q"
1.8115e6
"CYXX1NBIKL"
1.8082e6
"C6ILEYAYQ9"
1.7961e6
"CCNBC305GI"
1.7274e6
Comme on le voit, l’usage du GPU sur des requêtes plus complexes apporte des gains considérables, en passant de 6,04 secondes sur CPU à seulement 353 millisecondes sur GPU !
Cet exemple illustre la forte accélération que procure le moteur GPU de Polars pour des opérations à grande échelle.
Vous trouverez des exemples plus avancés dans le notebook Colab associé.
Le moteur GPU de Polars, propulsé par NVIDIA RAPIDS cuDF, apporte des gains de vitesse impressionnants, avec jusqu’à 13x d’accélération sur des opérations complexes. Pour des jeux de données à grande échelle, Polars offre un net avantage par rapport aux bibliothèques de DataFrame traditionnelles.
Même si toutes les requêtes ne profitent pas de la même façon de l’accélération GPU, Polars reste un outil puissant pour quiconque travaille sur de gros volumes. La facilité d’intégration, associée à son exécution hybride CPU-GPU, en fait un sérieux atout pour les workflows modernes.
Si vous souhaitez développer vos compétences en manipulation de données, notamment avec Pandas, je vous recommande vivement ces cours :
Ces ressources vous donneront de solides fondamentaux, complémentaires à la puissance d’outils comme Polars !
Nos programmes de certification vous aident à vous démarquer et à prouver aux employeurs potentiels que vos compétences sont adaptées à l'emploi.

Allez plus loin en data science et en Python avec ces cours !
Cours
Cours
Cours