Kurs
KI-Agenten mit dem Google ADK entwickeln
1 Std.
7.5K
Dieser Artikel behandelt die Grundlagen der LangChain-Tools und deren Nutzung in Python. Wir arbeiten in einem Jupyter Notebook mit installierten Bibliotheken openai und langchain. Wenn du dich zunächst mit dem LangChain-Framework vertraut machen willst, empfehle ich dir den Beitrag Introduction to LangChain for Data Engineering & Data Applications.
In diesem Tutorial nutzen wir vier bestehende LangChain-Tools, damit das Standard-GPT-Modell auf verschiedene externe Quellen zugreifen kann. Konkret sehen wir uns Tools für folgende Quellen an:
Nach dem Setup dieser Tools weißt du grundsätzlich, wie man beliebige LangChain-Tools verwendet und sie in einem Toolkit kombiniert, um dem Modell Browser-Funktionen zu geben.
Wie in der Einleitung erwähnt, erweitern LangChain-Tools die Fähigkeiten eines Modells, indem sie ihm erlauben, beim Beantworten von Prompts externe Quellen zu konsultieren. Diese Tools sind zentral für eine Prompting-Technik namens ReAct Prompting. ReAct steht für Reasoning and Acting und teilt die Verarbeitung des Modells in zwei Phasen:
Dabei entstehen Reasoning-Spuren, die das Modell auf dem Weg zur richtigen Antwort leiten. Diese Technik hilft großen Sprachmodellen (LLMs), insbesondere bei wissensintensiven Aufgaben und Entscheidungen, präzisere und verlässlichere Antworten zu geben. Ein Grund ist, dass sie dem Modell zusätzlich Zeit zum „Nachdenken“ gibt.
LangChain-Tools verstärken ReAct zusätzlich, indem sie ergänzende Informationsquellen bereitstellen. In unserem Ansatz entscheidet das Modell in der Reasoning-Phase je nach Nutzerfrage, welches Tool es verwendet. In der Acting-Phase greift es dann auf die ausgewählte externe Quelle zu, um zusätzliche Informationen zu sammeln.
Wenn du eine tiefergehende Einführung in ReAct Prompting mit LangChain suchst, ist der Artikel ChatGPT ReAct Prompting genau richtig!
Es gibt zwei zentrale Elemente im LangChain-Framework, um diese Prompting-Technik zu nutzen: Agents und Tools.
Die sogenannten Agents führen die Reasoning- und Acting-Phasen tatsächlich aus. Sie geben die Ergebnisse an das Modell zurück, sodass das LLM anhand der Zusatzinformationen eine Antwort in natürlicher Sprache generieren kann. Es gibt verschiedene Agent-Typen, jeweils für unterschiedliche Aufgaben. Eine Übersicht findest du in der offiziellen LangChain-Dokumentation zu Agents.
Tools standen bereits im Fokus unserer Diskussion. Technisch sind Tools Funktionen, die ein Agent aufrufen kann. LangChain bietet zahlreiche Tools, etwa Google-Dienste (Search, Drive, Scholar), Wikipedia-Suche, die ArXiv-Datenbank, eine Shell-Erweiterung und native ChatGPT-Plugins. In diesem Artikel lernen wir vier davon kennen. Eine vollständige Liste aller verfügbaren Tools findest du in der offiziellen Übersicht.
Steigen wir praktisch ein!
Wie bei jedem Projekt mit GPT-Modellen laden wir zunächst den OpenAI-API-Schlüssel in unsere Umgebung. Dafür nutzen wir die Module os und openai.
import openai
import os

os.environ["OPENAI_API_KEY"] = os.getenv("OPENAI_API_KEY")
Wenn du noch keinen OpenAI-API-Schlüssel hast, hilft dir dieser Artikel weiter: A Beginner’s Guide to the OpenAI API.
Da wir mit dem LangChain-Framework arbeiten, laden wir das eigentliche gpt-Modell aus der langchain-Bibliothek:
from langchain.llms.openai import OpenAI

llm = OpenAI(model_name="gpt-3.5-turbo")
Hier nutzen wir gpt-3.5-turbo als kostenfreie Option, du kannst aber jedes andere Modell deiner Wahl verwenden.
Im nächsten Abschnitt richten wir unser erstes Tool ein. Wir starten mit dem DuckDuckGo-Suchtool – du wirst sehen, dass alle Tools demselben Muster folgen!
DuckDuckGo ist eine Suchmaschine mit Fokus auf Datenschutz. Anders als manche andere Suchmaschinen protokolliert DuckDuckGo keine Suchhistorie und legt damit keine Nutzerprofile an.
Es gibt eine Python-Bibliothek, die wir für die Nutzung benötigen. Die Installation erfolgt mit pip:
!pip install duckduckgo-searchAußerdem importieren wir das DuckDuckGo-Tool aus der langchain-Bibliothek:
from langchain.tools import DuckDuckGoSearchRun

ddg_search = DuckDuckGoSearchRun()
Die Methode DuckDuckGoSearchRun() erlaubt für sich genommen bereits das Browsen im Internet – ganz ohne LLM. Ein einfaches Beispiel:
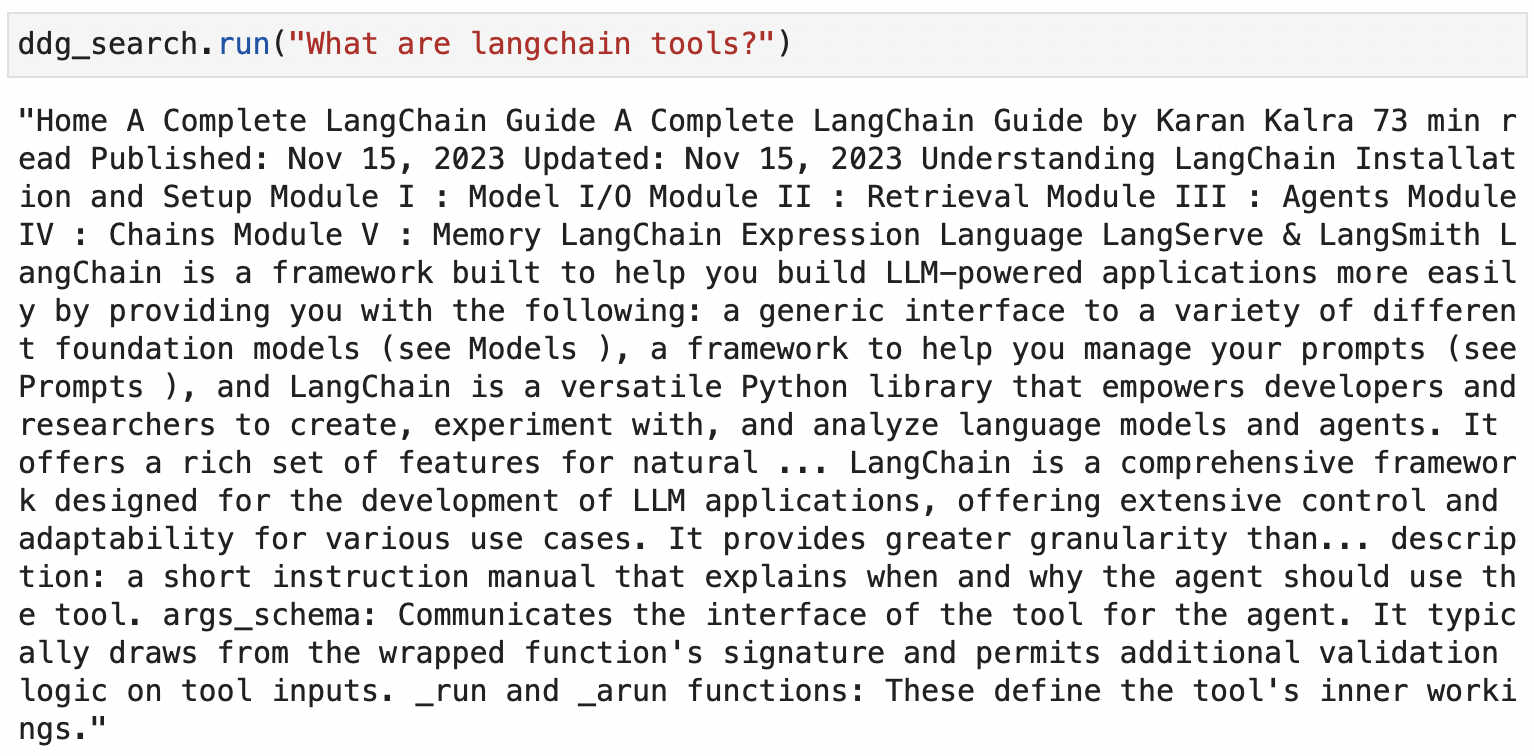
Screenshot der Ausführung von ddg_search.run() zum Browsen mit DuckDuckGo
Die Idee hinter Tools ist, diese Browsing-Funktion in ein LLM zu integrieren, damit wir eine zusammenhängende Antwort in natürlicher Sprache erhalten – und nicht nur Rohinformationen. Dafür betten wir die Methode in eine Instanz der langchain-Tool-Klasse ein:
from langchain.agents import Tool

tools = [
   Tool(
       name="DuckDuckGo Search",
       func=ddg_search.run,
       description="Useful to browse information from the Internet.",
   )
]
Jedes Tool braucht einen Namen (name), unter dem der LangChain-Agent darauf zugreift, eine Funktion (func), die der Agent zum Abfragen der externen Quelle ausführt (ddg_search.run wie oben), und eine Beschreibung (description), die dem Agent erklärt, wann es sinnvoll ist.
Für dieses Beispiel haben wir die Beschreibung gewählt: „Useful to browse information from the Internet“. Zudem gibt es weitere optionale Parameter, die du je nach Bedarf anpassen kannst.
Nachdem wir das erste Tool eingerichtet haben, ist der Rest leicht, da alle dieselbe Struktur nutzen.
Google Serper ist eine kostengünstige Google-Search-API, mit der wir – ähnlich wie mit DuckDuckGo – im Internet suchen können.
Für dieses Tool benötigen wir einen API-Schlüssel, den wir nach kostenloser Registrierung auf https://serper.dev/ erhalten.
Screenshot der Google-Serper-API-Startseite.
Im Serper-Konto findest du links im Menü die Option für den API-Schlüssel:
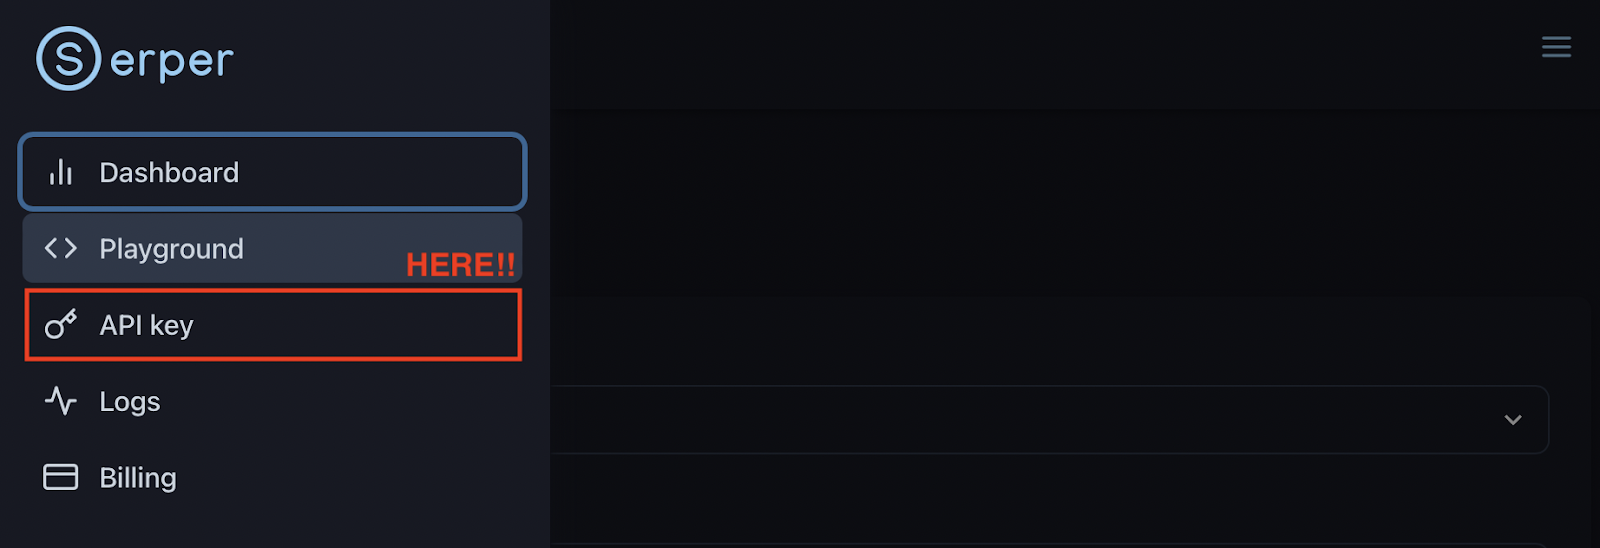
Screenshot einer Kontoseite der Google-Serper-API. API-Key-Option im linken Menü.
Mit einem Klick erhältst du den API-Schlüssel, den du einfach in deine Python-Skripte übernehmen kannst:
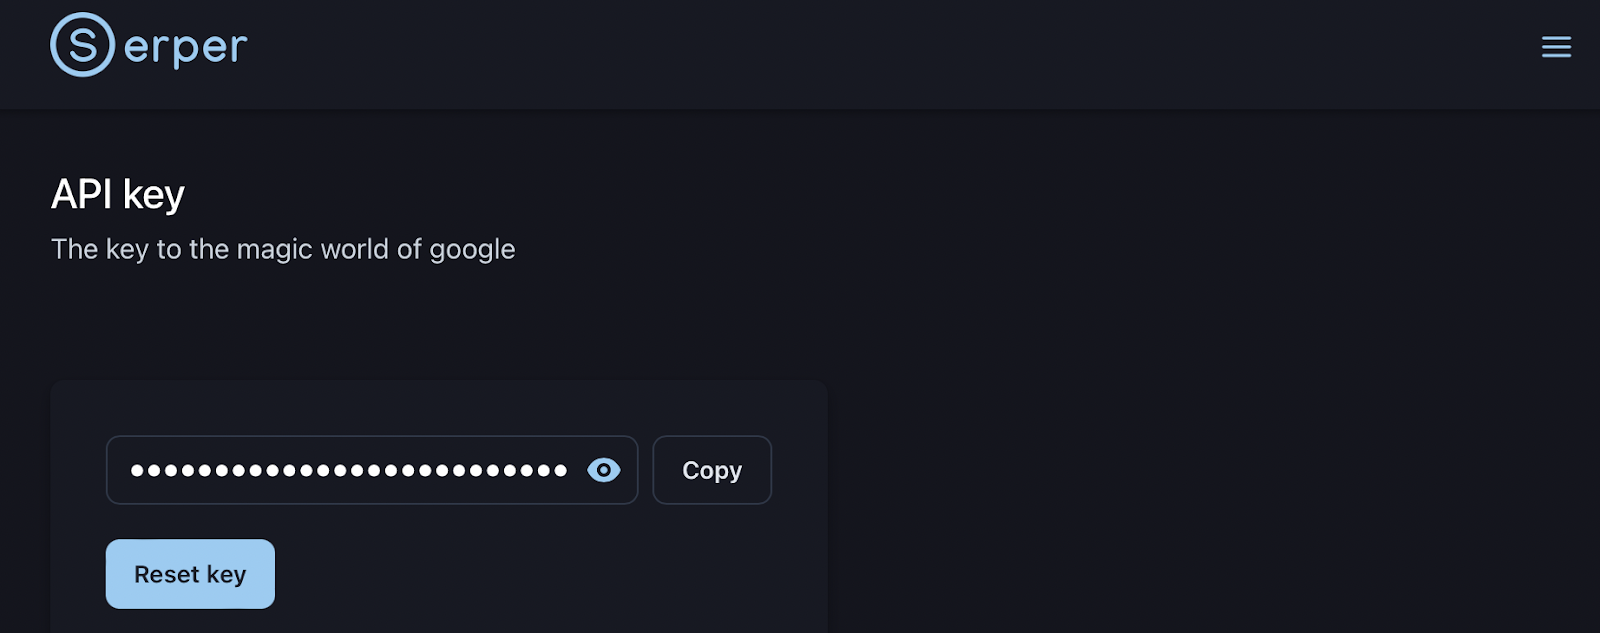
Screenshot der API-Key-Generierung auf der Google-Serper-Seite.
Zurück zum Code: So lädst du den Schlüssel in die Umgebung:
serper_api_key = os.environ["SERPER_API_KEY"]Um die Google-Serper-API zu nutzen, installieren wir zuerst die benötigte Python-Bibliothek (pip install google-serp-api). Außerdem importieren wir das GoogleSerper-Tool aus der langchain-Bibliothek:
from langchain.utilities import GoogleSerperAPIWrapper

google_search = GoogleSerperAPIWrapper()
Wie zuvor ist google_search.run() ebenfalls eine Methode, die eigenständig im Internet sucht. Unser Ziel ist aber erneut, sie als LangChain-Tool zu integrieren:
tools.append(
   Tool(
       name="Google Search",
       func=google_search.run,
       description="Useful to search in Google. Use by default.",
   )
)
Beachte, dass wir hier ein neues Tool an die Liste tools anhängen. Die Liste enthält nun beide Suchmaschinen.
Ergänzen wir unser Set an Tools um Wikipedia – nach demselben Muster wie zuvor.
Zuerst installieren wir die Python-Bibliothek wikipedia per pip (pip install wikipedia) und laden die benötigten Module aus LangChain. Aufgrund der Wikipedia-API-Architektur brauchen wir hier zwei Module:
from langchain.tools import WikipediaQueryRun
from langchain.utilities import WikipediaAPIWrapper

wikipedia = WikipediaQueryRun(api_wrapper=WikipediaAPIWrapper())
Nun fügen wir eine neue Tool-Instanz hinzu, deren Funktion die Methode wikipedia.run() ausführt:
tools.append(
   Tool(
       name="Wikipedia Search",
       func=wikipedia.run,
       description="Useful when users request biographies or historical moments.",
   )
)
Zum Schluss integrieren wir YouTube, damit das Modell neben Text auch Videos vorschlagen kann. Wieder nach dem gleichen Vorgehen:
!pip install youtube

from langchain.tools import YouTubeSearchTool
youtube = YouTubeSearchTool()

tools.append(
   Tool(
       name="Youtube Search",
       func=youtube.run,
       description="Useful for when the user explicitly asks you to look on Youtube.",
   )
)
Jetzt sind wir startklar!
Wir haben ein Toolkit (die Liste tools) mit vier Tools gebaut, die unserem Modell Browser-Funktionen geben. Bisher haben wir jedoch noch nicht mit dem Modell interagiert.
Schauen wir uns an, wie es diese Quellen nutzt!
Wie erwähnt, sind die Agents dafür zuständig, die Tools zu verwenden. Also importieren wir sie ebenfalls aus der langchain-Bibliothek:
from langchain.agents import initialize_agentMit der Methode initialize_agent richten wir unseren Agenten ein:
agent = initialize_agent(
   tools, llm, agent="zero-shot-react-description", verbose=True
)
Wie man sieht, übergeben wir die Liste der verfügbaren Tools (tools), das zu nutzende LLM (llm) und den Agent-Typ (agent="zero-shot-react-description"). Für dieses Beispiel verwenden wir den Zero-shot ReAct-Agent-Typ als allgemeinen Aktionsagenten. Außerdem setzen wir verbose=True, um den Reasoning-Prozess zu beobachten.
Sobald der Agent initialisiert ist, können wir mit agent.run() beliebige Prompts ausführen.
Grundsätzlich analysiert der Agent nach dem Absenden des Prompts die Tool-Beschreibungen und wählt das am besten passende Tool. Falls nötig, weicht er auf andere Tools aus, wenn die erste Wahl keine passenden Informationen liefert.
Starten wir mit einer Biografie-Anfrage. Dafür gibt es ein passendes Tool in unserem Setup, daher erwarten wir, dass der Agent dieses auswählt:
agent.run(
   "Harry Styles biography"
)
So sieht der Reasoning-Prozess aus:
> Entering new AgentExecutor chain...
I should look for a biography of the singer

Action: Wikipedia Search
Action Input: Harry Styles biography

Observation:

Page: Harry Styles
Summary: Harry Edward Styles (born 1 February 1994) is an English singer. His musical career began in 2010 as part of One Direction, a boy band formed on the British music competition series The X Factor after each member of the band had been eliminated from the solo contest. They became one of the best-selling boy groups of all time before going on an indefinite hiatus in 2016.
Styles released his self-titled debut solo album through Columbia Records in 2017. It debuted at number one in the UK and the US and was one of the world's top-ten best-selling albums of the year, while its lead single, "Sign of the Times", topped the UK Singles Chart. Styles' second album, Fine Line (2019), debuted atop the US Billboard 200 with the biggest ever first-week sales by an English male artist, and was the most recent album to be included in Rolling Stone's "500 Greatest Albums of All Time" in 2020. Its fourth single, "Watermelon Sugar", topped the US Billboard Hot 100. Styles' third album, Harry's House (2022), broke several records and was widely acclaimed, receiving the Grammy Award for Album of the Year in 2023. Its lead single, "As It Was", became the number-one song of 2022 globally according to Billboard.
Styles has received various accolades, including six Brit Awards, three Grammy Awards, an Ivor Novello Award, and three American Music Awards. His film roles include Dunkirk (2017), Don't Worry Darling (2022), and My Policeman (2022). Aside from music and acting, Styles is known for his flamboyant fashion. He is the first man to appear solo on the cover of Vogue.

Page: Debbie Harry
Summary: Deborah Ann Harry (born Angela Trimble; July 1, 1945) is an American singer, songwriter and actress, best known as the lead vocalist of the band Blondie. Four of her songs with the band reached No. 1 on the US charts between 1979 and 1981.
Born in Miami, Florida, Harry was adopted as an infant and raised in Hawthorne, New Jersey. After college she worked various jobs—as a dancer, a Playboy Bunny, and a secretary (including at the BBC in New York)—before her breakthrough in the music industry. She co-formed Blondie in 1974 in New York City. The band released its eponymous debut studio album in 1976 and released three more studio albums between then and 1979, including Parallel Lines, which spawned six singles, including "Heart of Glass". Their fifth studio album, Autoamerican (1980), spawned such hits as a cover of "The Tide Is High", and "Rapture", which is considered the first rap song to chart at number one in the United States.Harry released her debut solo studio album, KooKoo, in 1981. During a Blondie hiatus, she embarked on an acting career, appearing in lead roles in the neo-noir Union City (1980) and in David Cronenberg's body horror film Videodrome (1983). She released her second solo studio album, 1986's Rockbird, and starred in John Waters's cult dance film Hairspray (1988). She released two more solo albums between then and 1993, before returning to film with roles in a John Carpenter-directed segment of the horror film Body Bags (1993), and in the drama Heavy (1995).
Blondie reunited in the late 1990s, releasing No Exit (1999), followed by The Curse of Blondie (2003). Harry continued to appear in independent films throughout the 2000s, including Deuces Wild (2002), My Life Without Me (2003) and Elegy (2008). With Blondie, she released the group's ninth studio album, Panic of Girls, in 2011, followed by Ghosts of Download (2014). The band's eleventh studio album, 2017's Pollinator, charted at number 4 in the United Kingdom.

Page: Harry Potter
Summary: Harry Potter is a series of seven fantasy novels written by British author J. K. Rowling. The novels chronicle the lives of a young wizard, Harry Potter, and his friends Hermione Granger and Ron Weasley, all of whom are students at Hogwarts School of Witchcraft and Wizardry. The main story arc concerns Harry's conflict with Lord Voldemort, a dark wizard who intends

Thought: I now know the final answer
Final Answer: Harry Styles is an English singer, songwriter and actor. He rose to fame as a member of the boy band One Direction, and later embarked on a solo career. He released his debut solo album, Harry Styles, in 2017, and his second album, Fine Line, in 2019. He has also had success in film, appearing in Dunkirk (2017), Don't Worry Darling (2022) and My Policeman (2022).

> Finished chain.

"Harry Styles is an English singer, songwriter and actor. He rose to fame as a member of the boy band One Direction, and later embarked on a solo career. He released his debut solo album, Harry Styles, in 2017, and his second album, Fine Line, in 2019. He has also had success in film, appearing in Dunkirk (2017), Don't Worry Darling (2022) and My Policeman (2022)."
Wir sehen: Nach dem .run()-Aufruf verarbeitet der Agent den Prompt und startet die Reasoning-Phase, die mit „I should look for a biography of the singer“ endet. Dazu entwirft er einen Aktionsplan, der in der Nutzung des Wikipedia-Tools besteht – gemäß unserer Tool-Definition – mit „Harry Styles biography“ als Eingabe. Anschließend startet die Action-Phase: Der Agent ruft relevante Informationen aus der Wikipedia-Datenbank ab, verarbeitet die Ergebnisse und formuliert eine passende Antwort in natürlicher Sprache.
Nun formulieren wir eine allgemeine Browsing-Aufgabe, bei der im Toolkit keine Quelle explizit hervorgehoben ist:
agent.run(
   "Yesterday's latest news in Spain"
)
So lief der Reasoning-Prozess hier ab:
> Entering new AgentExecutor chain...
I should look for news from yesterday

Action: Google Search
Action Input: "Yesterday's news in Spain"

Observation: The latest breaking news, comment and features from The Independent. All the latest content about Spain from the BBC. Find all national and international information about spain. Select the subjects you want to know more about on euronews.com. Latest Spain news stories including accidents, crime and policing, politics, and Spanish sport news headlines. Latest news, essential insights and practical guides to life in Spain from The Local, Europe's leading independent voice. Missing: Yesterday's | Show results with:Yesterday's. Stay on top of Spain latest developments on the ground with Al Jazeera's fact-based news, exclusive video footage, photos and updated maps. Missing: Yesterday's | Show results with:Yesterday's. Spain · Shakira due to go on trial in Spain over tax fraud claims · The Observer view on Pedro Sánchez's election deal to take power: it undermines democracy. Missing: Yesterday's | Show results with:Yesterday's. Latest News · Hundreds leave Al-Shifa hospital as Israeli forces take control of facility · F1 fans file class-action suit over being forced to exit Las Vegas ... Missing: Yesterday's | Show results with:Yesterday's. Follow the latest Spain news stories and headlines. Get breaking news alerts when you download the ABC News App and subscribe to Spain notifications. Missing: Yesterday's | Show results with:Yesterday's. Get the latest breaking news and top news headlines at Reuters ... Spain Headlines. Shakira stands trial in Spain for alleged tax fraud. Shakira ... Missing: Yesterday's | Show results with:Yesterday's.
Thought: I found a lot of news sources with yesterday's news, so the final answer should be about that.

Final Answer: The latest news in Spain from yesterday is that Shakira is standing trial in Spain for alleged tax fraud, hundreds of people have left Al-Shifa hospital as Israeli forces take control, and F1 fans have filed a class-action suit over being forced to exit Las Vegas. Other news includes insights and practical guides to life in Spain, Pedro Sánchez's election deal to take power, and the top news headlines from Reuters.

> Finished chain.
"The latest news in Spain from yesterday is that Shakira is standing trial in Spain for alleged tax fraud, hundreds of people have left Al-Shifa hospital as Israeli forces take control, and F1 fans have filed a class-action suit over being forced to exit Las Vegas. Other news includes insights and practical guides to life in Spain, Pedro Sánchez's election deal to take power, and the top news headlines from Reuters."
Hier greift der Agent standardmäßig auf Google Serper zurück und findet aktuelle Nachrichten aus Spanien. Dieses Beispiel ist besonders interessant, weil wir eine sehr aktuelle Frage an ein LLM stellen, dessen Trainingsdaten bis September 2021 reichen – und dennoch eine zeitnahe Antwort erhalten.
Angenommen, wir suchen gezielt ein Video. Prüfen wir, ob das Modell uns dorthin leitet. Wir schalten den Verbose-Modus aus und betrachten die eigentliche Antwort:
agent = initialize_agent(
   tools, llm, agent="zero-shot-react-description"
)

agent.run(
   "Can you point me to the Procrastination TED talk by Tim Urban?"
)
Wie erwartet erhalten wir folgende Rückmeldung:
'The TED Talk "Procrastination" by Tim Urban can be found at
https://www.youtube.com/watch?v=arj7oStGLkU'
Es funktioniert! Mit diesen drei Beispielen siehst du, auf welche unterschiedlichen Quellen unser LLM zugreifen kann, um unsere Anfragen zu erfüllen.
Wenn du weitere Tools in dein Toolkit aufnehmen willst, empfehle ich den Artikel ReAct: 3 LangChain Tools To Enhance the Default GPT Capabilities.
In diesem Tutorial haben wir gesehen, wie LangChain-Tools die Browser-Funktionen von LLMs erweitern. Im Kern erleichtert LangChain die Entwicklung von LLM-basierten Anwendungen und bringt starke Features wie integrierte Speicher, vollständige Chatbots und die hier gezeigten Tools mit.
Während OpenAI mit dem Launch seiner neuesten GPT-Modelle große Schritte in Richtung anpassbarer KI macht, sehe ich weiterhin viel Raum für Wachstum und Innovation.
Gerade hier haben LangChain-Tools für Nutzer, die häufig mit GPT-Modellen über Python und die OpenAI API arbeiten, einen deutlichen Vorteil. Das steht im Kontrast zu GPTs, die eher auf ein nicht-technisches Publikum ausgerichtet sind. GPT-Nutzer können sich zwar bequem in der ChatGPT-Oberfläche spezialisierte Instanzen konfigurieren und bei Bedarf nutzen – das ist benutzerfreundlich, aber weniger flexibel.
Zudem erweitert die Fähigkeit der LangChain-Tools, externe Informationsquellen wie Google oder Wikipedia abzufragen, die Wissensbasis des Modells erheblich. Das ist ein klarer Vorteil gegenüber GPTs, die zwar das Hochladen von Informationen unterstützen, aber in kleinerem Umfang.
Kurz gesagt: LangChain-Tools sind aus meiner Sicht das stärkste Mittel, um die Fähigkeiten von Modellen auszubauen und eigene Instanzen mit frei verfügbaren öffentlichen Daten zu personalisieren. Und stell dir vor, was passiert, wenn wir Tools mit unserer privaten Datenbank kombinieren!
Neu in der Welt der LLMs? Dann schau dir unseren Kurs Large Language Models Concepts an, um schnell auf Stand zu kommen!
Entwickle deine KI-Kompetenzen!
Kurs
Kurs
Kurs
Tutorial
DataCamp Team
5 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Adel Nehme
6 Min.
Tutorial
DataCamp Team
2 Min.
Tutorial
Kurtis Pykes
15 Min.
Tutorial
Matt Crabtree
5 Min.