
Khóa học
Xây dựng AI Agent với Google ADK
1 giờ
7.7K
Bài viết này đề cập đến những điều cơ bản về LangChain Tools và cách sử dụng chúng trong Python. Chúng ta sẽ dùng Jupyter Notebook với cả hai thư viện openai và langchain đã được cài đặt. Nếu trước hết bạn muốn tìm hiểu về khuôn khổ LangChain, tôi rất khuyến nghị bạn xem bài Giới thiệu LangChain cho Kỹ thuật Dữ liệu & Ứng dụng Dữ liệu.
Trong hướng dẫn này, chúng ta sẽ học cách tận dụng bốn LangChain Tools hiện có để cung cấp cho mô hình GPT mặc định nhiều nguồn bên ngoài để tham khảo khi xử lý yêu cầu người dùng. Cụ thể, chúng ta sẽ khám phá các công cụ sử dụng các nguồn sau:
Sau khi thiết lập các công cụ này, chúng ta sẽ biết cách sử dụng bất kỳ LangChain Tool nào nói chung và cách kết hợp tất cả chúng trong một Bộ công cụ để cung cấp khả năng duyệt web cho mô hình.
Như đã thảo luận ở phần mở đầu, LangChain Tools có thể tăng cường năng lực của mô hình bằng cách cho phép nó tham khảo các nguồn bên ngoài khi trả lời lời nhắc của người dùng. Những công cụ này đóng vai trò quan trọng trong một kỹ thuật nhắc lệnh gọi là ReAct Prompting. ReAct, viết tắt của Lập luận và Hành động, chia quá trình xử lý của mô hình thành hai giai đoạn:
Quy trình này tạo ra các vết lập luận giúp chính mô hình định hướng tới câu trả lời đúng. Kỹ thuật này đã cho thấy giúp các Mô hình Ngôn ngữ Lớn (LLM) đạt được câu trả lời chính xác và đáng tin cậy hơn, đặc biệt trong các tác vụ đòi hỏi kiến thức sâu và ra quyết định. Một phần là vì nó cho phép mô hình có thêm thời gian để ‘suy nghĩ’.
LangChain Tools có thể tiếp tục nâng cao kỹ thuật ReAct bằng cách cung cấp các nguồn thông tin bổ sung. Trong cách tiếp cận của chúng ta, giai đoạn lập luận liên quan đến việc mô hình quyết định sử dụng công cụ nào dựa trên truy vấn của người dùng. Trong khi đó, giai đoạn hành động sẽ cho phép mô hình giao tiếp với nguồn bên ngoài đã chọn để thu thập thêm thông tin.
Nếu bạn quan tâm đến phần giới thiệu chuyên sâu về ReAct prompting với LangChain, bài viết ChatGPT ReAct Prompting là dành cho bạn!
Có hai thành phần quan trọng trong khuôn khổ LangChain để vận dụng kỹ thuật này: Agents và Tools.
Các agent gọi là những thực thể chịu trách nhiệm thực hiện các giai đoạn lập luận và hành động. Họ chuyển kết quả lại cho mô hình, cho phép LLM tạo ra câu trả lời bằng ngôn ngữ tự nhiên với thông tin bổ sung. Có nhiều loại agent khác nhau, mỗi loại phù hợp với các tác vụ khác nhau mà bạn có thể muốn LLM thực hiện. Tổng quan chi tiết về các loại agent có trong tài liệu chính thức của LangChain về Agents.
Tools đã được chúng ta đề cập khá nhiều. Về mặt kỹ thuật, Tools là các hàm mà một agent có thể gọi. LangChain cung cấp nhiều công cụ như tiện ích Google (như Search, Drive và Scholar), tìm kiếm Wikipedia, cơ sở dữ liệu ArXiV, phần mở rộng shell và plugin gốc của ChatGPT, v.v. Trong bài viết này, chúng ta sẽ làm quen với bốn công cụ. Tham khảo danh sách đầy đủ các Tools có sẵn trong tài liệu chính thức của LangChain.
Bắt tay vào thực hành!
Giống như bất kỳ dự án nào khác sử dụng mô hình GPT, bước đầu tiên là nạp khóa API OpenAI vào môi trường của chúng ta. Để làm điều này, chúng ta sẽ dùng các mô-đun os và openai.
import openai
import os

os.environ["OPENAI_API_KEY"] = os.getenv("OPENAI_API_KEY")
Nếu bạn chưa có khóa API OpenAI, bài viết Hướng dẫn cho người mới bắt đầu về OpenAI API là dành cho bạn!
Vì chúng ta sẽ sử dụng khuôn khổ LangChain, chúng ta cũng sẽ nạp mô hình gpt từ thư viện langchain:
from langchain.llms.openai import OpenAI

llm = OpenAI(model_name="gpt-3.5-turbo")
Ở đây, chúng ta dùng mô hình gpt-3.5-turbo như một lựa chọn không tốn phí, nhưng bạn có thể sử dụng bất kỳ mô hình nào bạn thích.
Trong phần tiếp theo, chúng ta sẽ học cách thiết lập Công cụ đầu tiên. Chúng ta sẽ dùng công cụ tìm kiếm DuckDuckGo làm ví dụ, nhưng bạn sẽ thấy rằng tất cả công cụ đều theo cùng các bước để hoạt động!
DuckDuckGo là công cụ tìm kiếm nhấn mạnh việc bảo vệ quyền riêng tư của người dùng. Không giống một số công cụ tìm kiếm khác, DuckDuckGo không theo dõi lịch sử tìm kiếm của người dùng, nghĩa là nó không tạo hoặc duy trì hồ sơ cá nhân của người dùng.
Nó có một thư viện Python mà chúng ta cần cài đặt để sử dụng công cụ tìm kiếm. Có thể cài qua pip:
!pip install duckduckgo-searchNgoài ra, chúng ta cần import công cụ DuckDuckGo từ thư viện langchain:
from langchain.tools import DuckDuckGoSearchRun

ddg_search = DuckDuckGoSearchRun()
Phương thức DuckDuckGoSearchRun() tự nó đã cho phép duyệt Internet mà không cần giao tiếp với bất kỳ LLM nào. Hãy xem một ví dụ đơn giản:
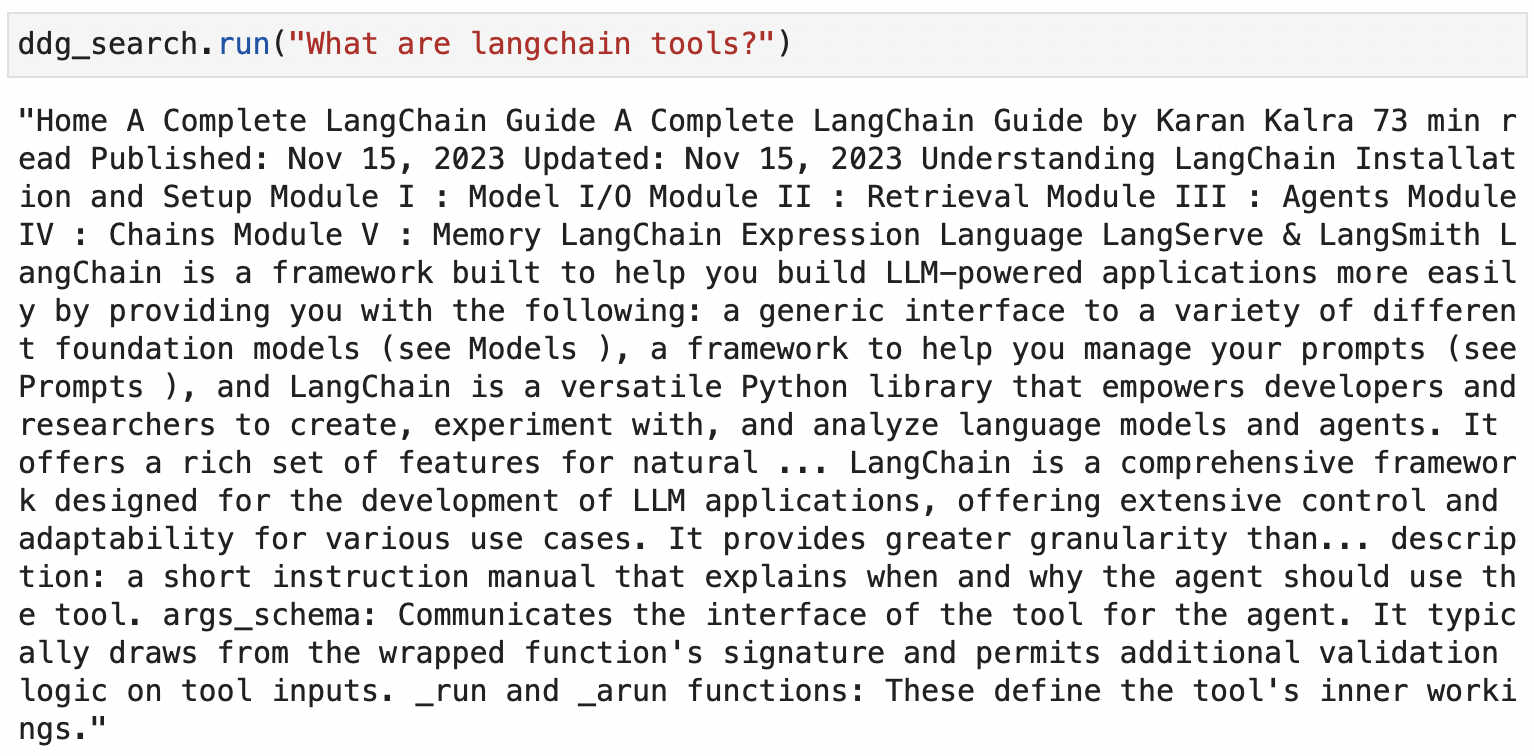
Ảnh chụp màn hình từ lần thực thi ddg_search.run() để duyệt Internet bằng DuckDuckGo
Ý tưởng đằng sau Tools là tích hợp khả năng duyệt này vào một LLM để chúng ta có thể nhận được câu trả lời mạch lạc bằng ngôn ngữ tự nhiên, thay vì chỉ truy xuất mảnh thông tin thô. Để làm vậy, chúng ta cần nhúng phương thức này vào một instance của lớp Tool trong langchain như sau:
from langchain.agents import Tool

tools = [
   Tool(
       name="DuckDuckGo Search",
       func=ddg_search.run,
       description="Useful to browse information from the Internet.",
   )
]
Bất kỳ công cụ nào cũng cần một tên (name) mà agent của LangChain sẽ dùng để tham chiếu, một hàm (func) mà agent có thể thực thi để tham khảo nguồn bên ngoài (ddg_search.run như trên) và một mô tả (description) để cung cấp thông tin cho agent về thời điểm sử dụng nó.
Trong ví dụ này, chúng ta chọn mô tả: “Useful to browse information from the Internet”. Cũng có thêm các tham số tùy chọn trong định nghĩa Tool mà bạn có thể tùy chỉnh theo nhu cầu.
Khi đã biết cách thiết lập công cụ đầu tiên, việc thiết lập phần còn lại sẽ khá đơn giản vì tất cả đều theo cùng một cấu trúc.
Google Serper là một API Google Search chi phí thấp cho phép chúng ta duyệt Internet tương tự như DuckDuckGo.
Với công cụ này, chúng ta cần một khóa API có thể nhận được bằng cách đăng ký tài khoản miễn phí tại https://serper.dev/.
Ảnh chụp màn hình từ trang chính của Google Serper API.
Khi vào tài khoản Serper, chúng ta sẽ thấy tùy chọn khóa API ở bảng điều khiển bên trái:
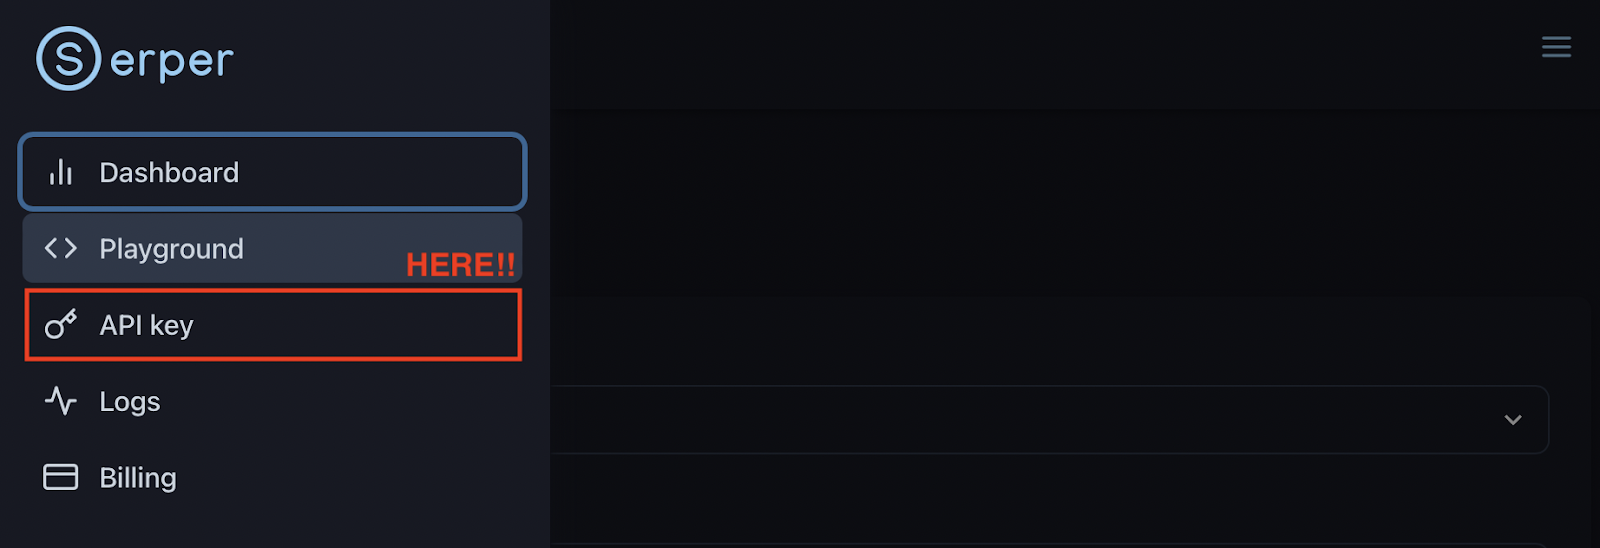
Ảnh chụp màn hình từ trang tài khoản trên Google Serper API. Tùy chọn khóa API ở bảng bên trái.
Nhấp vào đó, chúng ta sẽ nhận được khóa API có thể dễ dàng sao chép và tích hợp vào script Python:
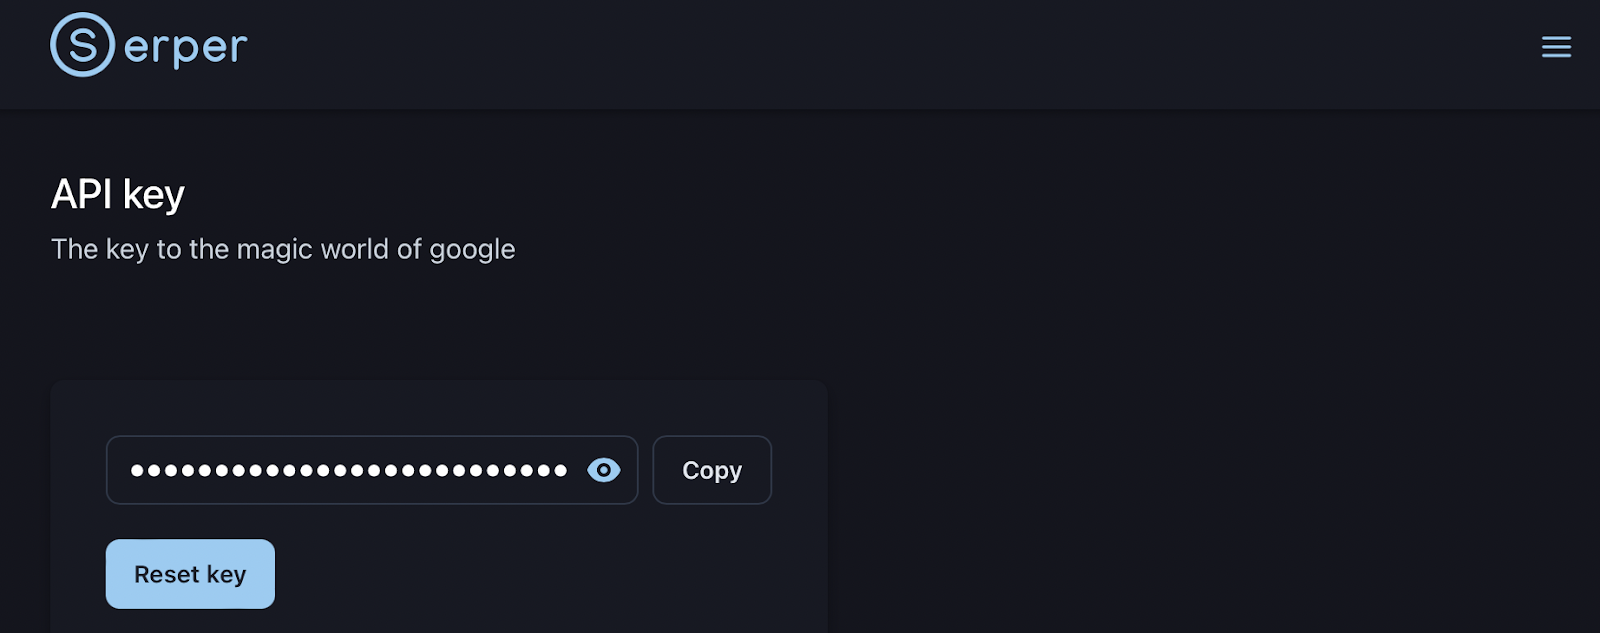
Ảnh chụp màn hình quá trình tạo khóa API trên trang Google Serper.
Quay lại phần mã, chúng ta có thể dễ dàng nạp khóa vào môi trường:
serper_api_key = os.environ["SERPER_API_KEY"]Để sử dụng Google Serper API, trước tiên chúng ta cần cài thư viện Python cần thiết (pip install google-serp-api). Ngoài ra, cần import công cụ GoogleSerper từ thư viện langchain:
from langchain.utilities import GoogleSerperAPIWrapper

google_search = GoogleSerperAPIWrapper()
Như ở trường hợp trước, google_search.run() cũng là một phương thức có thể tự duyệt Internet. Tuy nhiên, một lần nữa, ý tưởng là tích hợp nó thành một công cụ LangChain như sau:
tools.append(
   Tool(
       name="Google Search",
       func=google_search.run,
       description="Useful to search in Google. Use by default.",
   )
)
Lưu ý rằng trong trường hợp này, chúng ta đang thêm một công cụ mới vào danh sách tools. Vì vậy, danh sách tools của chúng ta hiện chứa cả hai công cụ tìm kiếm.
Hãy bổ sung bộ công cụ của chúng ta với nguồn Wikipedia nổi tiếng theo cùng quy trình như các công cụ trước.
Bước đầu tiên là cài thư viện Python wikipedia qua pip (pip install wikipedia), và nạp các mô-đun cần thiết từ thư viện LangChain. Công cụ này thực tế cần hai mô-đun do kiến trúc API của Wikipedia:
from langchain.tools import WikipediaQueryRun
from langchain.utilities import WikipediaAPIWrapper

wikipedia = WikipediaQueryRun(api_wrapper=WikipediaAPIWrapper())
Cuối cùng, chúng ta có thể thêm một instance mới của lớp Tool với hàm chạy phương thức wikipedia.run():
tools.append(
   Tool(
       name="Wikipedia Search",
       func=wikipedia.run,
       description="Useful when users request biographies or historical moments.",
   )
)
Cuối cùng, tôi thấy rất thú vị khi tích hợp nguồn YouTube để mô hình có thêm khả năng trả lời dưới dạng video, không chỉ văn bản. Làm theo cùng thủ tục như trước:
!pip install youtube

from langchain.tools import YouTubeSearchTool
youtube = YouTubeSearchTool()

tools.append(
   Tool(
       name="Youtube Search",
       func=youtube.run,
       description="Useful for when the user explicitly asks you to look on Youtube.",
   )
)
Giờ thì chúng ta đã sẵn sàng!
Chúng ta đã xây dựng một bộ công cụ (danh sách tools) với bốn công cụ cung cấp khả năng duyệt web cho mô hình. Tuy nhiên, đến giờ chúng ta vẫn chưa tương tác với mô hình.
Hãy xem mô hình có thể sử dụng các nguồn đó như thế nào!
Như đã đề cập, các agent là những thực thể chịu trách nhiệm sử dụng Tools. Do đó, chúng ta cũng cần import chúng từ thư viện langchain:
from langchain.agents import initialize_agentPhương thức initialize_agent sẽ cho phép chúng ta thiết lập agent:
agent = initialize_agent(
   tools, llm, agent="zero-shot-react-description", verbose=True
)
Như có thể thấy từ lệnh khởi tạo, chúng ta cần cung cấp cho agent danh sách các Tools khả dụng (tools), LLM sẽ dùng (llm) và loại agent (agent=”zero-shot-react-description”). Trong ví dụ này, chúng ta sẽ sử dụng loại agent Zero-shot ReAct như agent hành động đa dụng nhất. Ở đây, chúng ta cũng đặt verbose=True để quan sát quá trình lập luận của agent.
Sau khi agent được khởi tạo, chúng ta có thể chạy bất kỳ lời nhắc người dùng nào bằng phương thức agent.run().
Về nguyên tắc, khi chúng ta gửi lời nhắc, agent sẽ phân tích mô tả của các Tools và sử dụng công cụ phù hợp nhất với trường hợp sử dụng. Ngoài ra, agent vẫn sẽ chuyển sang các công cụ khác nếu không tìm thấy thông tin phù hợp khi dùng công cụ đã chọn.
Hãy chạy một thử nghiệm đầu tiên yêu cầu tiểu sử. Trong trường hợp này, có một công cụ phù hợp mà chúng ta đã cấu hình cho tiểu sử và các khoảnh khắc lịch sử, vì vậy chúng ta kỳ vọng agent sẽ chọn công cụ đã cấu hình:
agent.run(
   "Harry Styles biography"
)
Chúng ta có thể quan sát quá trình lập luận:
> Entering new AgentExecutor chain...
I should look for a biography of the singer

Action: Wikipedia Search
Action Input: Harry Styles biography

Observation:

Page: Harry Styles
Summary: Harry Edward Styles (born 1 February 1994) is an English singer. His musical career began in 2010 as part of One Direction, a boy band formed on the British music competition series The X Factor after each member of the band had been eliminated from the solo contest. They became one of the best-selling boy groups of all time before going on an indefinite hiatus in 2016.
Styles released his self-titled debut solo album through Columbia Records in 2017. It debuted at number one in the UK and the US and was one of the world's top-ten best-selling albums of the year, while its lead single, "Sign of the Times", topped the UK Singles Chart. Styles' second album, Fine Line (2019), debuted atop the US Billboard 200 with the biggest ever first-week sales by an English male artist, and was the most recent album to be included in Rolling Stone's "500 Greatest Albums of All Time" in 2020. Its fourth single, "Watermelon Sugar", topped the US Billboard Hot 100. Styles' third album, Harry's House (2022), broke several records and was widely acclaimed, receiving the Grammy Award for Album of the Year in 2023. Its lead single, "As It Was", became the number-one song of 2022 globally according to Billboard.
Styles has received various accolades, including six Brit Awards, three Grammy Awards, an Ivor Novello Award, and three American Music Awards. His film roles include Dunkirk (2017), Don't Worry Darling (2022), and My Policeman (2022). Aside from music and acting, Styles is known for his flamboyant fashion. He is the first man to appear solo on the cover of Vogue.

Page: Debbie Harry
Summary: Deborah Ann Harry (born Angela Trimble; July 1, 1945) is an American singer, songwriter and actress, best known as the lead vocalist of the band Blondie. Four of her songs with the band reached No. 1 on the US charts between 1979 and 1981.
Born in Miami, Florida, Harry was adopted as an infant and raised in Hawthorne, New Jersey. After college she worked various jobs—as a dancer, a Playboy Bunny, and a secretary (including at the BBC in New York)—before her breakthrough in the music industry. She co-formed Blondie in 1974 in New York City. The band released its eponymous debut studio album in 1976 and released three more studio albums between then and 1979, including Parallel Lines, which spawned six singles, including "Heart of Glass". Their fifth studio album, Autoamerican (1980), spawned such hits as a cover of "The Tide Is High", and "Rapture", which is considered the first rap song to chart at number one in the United States.Harry released her debut solo studio album, KooKoo, in 1981. During a Blondie hiatus, she embarked on an acting career, appearing in lead roles in the neo-noir Union City (1980) and in David Cronenberg's body horror film Videodrome (1983). She released her second solo studio album, 1986's Rockbird, and starred in John Waters's cult dance film Hairspray (1988). She released two more solo albums between then and 1993, before returning to film with roles in a John Carpenter-directed segment of the horror film Body Bags (1993), and in the drama Heavy (1995).
Blondie reunited in the late 1990s, releasing No Exit (1999), followed by The Curse of Blondie (2003). Harry continued to appear in independent films throughout the 2000s, including Deuces Wild (2002), My Life Without Me (2003) and Elegy (2008). With Blondie, she released the group's ninth studio album, Panic of Girls, in 2011, followed by Ghosts of Download (2014). The band's eleventh studio album, 2017's Pollinator, charted at number 4 in the United Kingdom.

Page: Harry Potter
Summary: Harry Potter is a series of seven fantasy novels written by British author J. K. Rowling. The novels chronicle the lives of a young wizard, Harry Potter, and his friends Hermione Granger and Ron Weasley, all of whom are students at Hogwarts School of Witchcraft and Wizardry. The main story arc concerns Harry's conflict with Lord Voldemort, a dark wizard who intends

Thought: I now know the final answer
Final Answer: Harry Styles is an English singer, songwriter and actor. He rose to fame as a member of the boy band One Direction, and later embarked on a solo career. He released his debut solo album, Harry Styles, in 2017, and his second album, Fine Line, in 2019. He has also had success in film, appearing in Dunkirk (2017), Don't Worry Darling (2022) and My Policeman (2022).

> Finished chain.

"Harry Styles is an English singer, songwriter and actor. He rose to fame as a member of the boy band One Direction, and later embarked on a solo career. He released his debut solo album, Harry Styles, in 2017, and his second album, Fine Line, in 2019. He has also had success in film, appearing in Dunkirk (2017), Don't Worry Darling (2022) and My Policeman (2022)."
Chúng ta thấy rằng khi thực thi phương thức .run(), agent xử lý lời nhắc của người dùng và bắt đầu pha lập luận, kết thúc với kết luận: "Tôi nên tìm một tiểu sử của ca sĩ". Để làm vậy, nó lập kế hoạch hành động gồm sử dụng công cụ Wikipedia Search – theo định nghĩa công cụ của chúng ta – với đầu vào "Harry Styles biography". Sau đó, kế hoạch hành động bắt đầu, agent truy xuất thông tin liên quan từ cơ sở dữ liệu Wikipedia, xử lý phát hiện và tạo ra câu trả lời phù hợp bằng ngôn ngữ tự nhiên.
Bây giờ, hãy yêu cầu một tác vụ duyệt tổng quát để agent không có công cụ cụ thể nào được nêu trong mô tả bộ công cụ:
agent.run(
   "Yesterday's latest news in Spain"
)
Hãy quan sát quá trình lập luận trong trường hợp này:
> Entering new AgentExecutor chain...
I should look for news from yesterday

Action: Google Search
Action Input: "Yesterday's news in Spain"

Observation: The latest breaking news, comment and features from The Independent. All the latest content about Spain from the BBC. Find all national and international information about spain. Select the subjects you want to know more about on euronews.com. Latest Spain news stories including accidents, crime and policing, politics, and Spanish sport news headlines. Latest news, essential insights and practical guides to life in Spain from The Local, Europe's leading independent voice. Missing: Yesterday's | Show results with:Yesterday's. Stay on top of Spain latest developments on the ground with Al Jazeera's fact-based news, exclusive video footage, photos and updated maps. Missing: Yesterday's | Show results with:Yesterday's. Spain · Shakira due to go on trial in Spain over tax fraud claims · The Observer view on Pedro Sánchez's election deal to take power: it undermines democracy. Missing: Yesterday's | Show results with:Yesterday's. Latest News · Hundreds leave Al-Shifa hospital as Israeli forces take control of facility · F1 fans file class-action suit over being forced to exit Las Vegas ... Missing: Yesterday's | Show results with:Yesterday's. Follow the latest Spain news stories and headlines. Get breaking news alerts when you download the ABC News App and subscribe to Spain notifications. Missing: Yesterday's | Show results with:Yesterday's. Get the latest breaking news and top news headlines at Reuters ... Spain Headlines. Shakira stands trial in Spain for alleged tax fraud. Shakira ... Missing: Yesterday's | Show results with:Yesterday's.
Thought: I found a lot of news sources with yesterday's news, so the final answer should be about that.

Final Answer: The latest news in Spain from yesterday is that Shakira is standing trial in Spain for alleged tax fraud, hundreds of people have left Al-Shifa hospital as Israeli forces take control, and F1 fans have filed a class-action suit over being forced to exit Las Vegas. Other news includes insights and practical guides to life in Spain, Pedro Sánchez's election deal to take power, and the top news headlines from Reuters.

> Finished chain.
"The latest news in Spain from yesterday is that Shakira is standing trial in Spain for alleged tax fraud, hundreds of people have left Al-Shifa hospital as Israeli forces take control, and F1 fans have filed a class-action suit over being forced to exit Las Vegas. Other news includes insights and practical guides to life in Spain, Pedro Sánchez's election deal to take power, and the top news headlines from Reuters."
Trong trường hợp này, agent tự động dùng công cụ Google Serper mặc định và tìm tin tức mới nhất ở Tây Ban Nha. Ví dụ duyệt này đặc biệt thú vị vì chúng ta có thể hỏi một lời nhắc rất cập nhật với LLM có dữ liệu huấn luyện kết thúc vào tháng 9/2021, nhưng vẫn nhận được câu trả lời mới nhất.
Cuối cùng, giả sử chúng ta quan tâm đến một tài nguyên video. Hãy xem mô hình có thể chỉ ra cho chúng ta hay không. Chúng ta sẽ tắt chế độ verbose và quan sát phản hồi thực tế từ mô hình:
agent = initialize_agent(
   tools, llm, agent="zero-shot-react-description"
)

agent.run(
   "Can you point me to the Procrastination TED talk by Tim Urban?"
)
Và như mong đợi, chúng ta nhận lại phản hồi sau:
'The TED Talk "Procrastination" by Tim Urban can be found at
https://www.youtube.com/watch?v=arj7oStGLkU'
Hoạt động rồi! Với ba ví dụ này, chúng ta đã minh họa các nguồn khác nhau mà LLM có thể sử dụng để đáp ứng yêu cầu của chúng ta.
Nếu bạn muốn bổ sung thêm Tools vào Bộ công cụ, tôi rất khuyến nghị bài viết ReAct: 3 LangChain Tools để tăng cường khả năng mặc định của GPT.
Trong hướng dẫn này, chúng ta đã tìm hiểu cách sử dụng LangChain Tools để tăng cường khả năng duyệt web cho LLM. Trọng tâm của LangChain là khả năng đơn giản hóa việc phát triển ứng dụng dựa trên LLM, với một bộ tính năng mạnh mẽ bao gồm bộ nhớ tích hợp, chatbot hoàn chỉnh và các Tools được khám phá trong bài viết này, cùng những tính năng khác.
Trong khi OpenAI đang tiến những bước dài trong lĩnh vực AI tùy chỉnh với việc ra mắt các mô hình GPT mới nhất, tôi tin rằng vẫn còn nhiều dư địa để phát triển và đổi mới.
Về mặt này, LangChain Tools có lợi thế đáng kể trong cuộc đua công nghệ đối với những người dùng thường xuyên tương tác với các mô hình GPT qua Python và OpenAI API. Điều này tương phản rõ với GPTs, dường như được thiết kế cho đối tượng không viết mã. Người dùng GPT có thể dễ dàng cấu hình một instance chuyên biệt từ giao diện ChatGPT và truy cập khi cần, mang lại sự thân thiện nhưng hạn chế về linh hoạt.
Hơn nữa, khả năng của LangChain Tools trong việc kiểm tra các nguồn thông tin bên ngoài như Google hoặc Wikipedia giúp tăng cường đáng kể cơ sở tri thức của mô hình. Đây là một lợi thế lớn so với GPTs, vốn hỗ trợ tải thông tin lên nhưng ở quy mô nhỏ hơn.
Tóm lại, theo tôi, LangChain Tools là những tính năng mạnh mẽ nhất để tăng cường khả năng của mô hình và tùy chỉnh các instance riêng của chúng ta bằng dữ liệu công khai sẵn có rộng rãi. Bạn có thể tưởng tượng sức mạnh của việc kết hợp Tools với cơ sở dữ liệu riêng của mình không?
Mới làm quen với thế giới LLM? Hãy xem khóa học Large Language Models Concepts để bắt kịp tốc độ!
Phát triển kỹ năng AI của bạn!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
