
Corso
Creare agenti AI con Google ADK
1 ore
7.7K
Questo articolo copre le basi dei LangChain Tools e come usarli in Python. Useremo un Jupyter Notebook con entrambe le librerie openai e langchain installate. Se prima vuoi approfondire il framework LangChain, ti consiglio vivamente l'articolo Introduzione a LangChain per Data Engineering & Data Applications.
In questo tutorial, impareremo a utilizzare quattro dei LangChain Tools esistenti per fornire al modello GPT predefinito una varietà di fonti esterne da consultare mentre soddisfa le richieste degli utenti. Nello specifico, esploreremo Tools che usano le seguenti fonti:
Dopo aver configurato questi Tools, avremo imparato come usare in generale qualsiasi LangChain Tool e come combinarli tutti in un Toolkit per fornire al modello capacità di navigazione.
Come discusso nell'introduzione, i LangChain Tools possono potenziare le capacità di un modello consentendogli di consultare fonti esterne quando risponde al prompt di un utente. Questi Tools sono fondamentali in una tecnica di prompting nota come ReAct Prompting. ReAct, acronimo di Reasoning and Acting, suddivide l'elaborazione del modello in due fasi:
Questo processo genera tracce di ragionamento che possono guidare lo stesso modello verso la risposta corretta. È stato dimostrato che questa tecnica aiuta i Large Language Model (LLM) a ottenere risposte più accurate e affidabili, in particolare in compiti intensivi di conoscenza e di decisione. Ciò in parte perché consente al modello ulteriore tempo per "pensare".
I LangChain Tools possono ulteriormente migliorare la tecnica di prompting ReAct fornendo fonti di informazione complementari. Nel nostro approccio, la fase di ragionamento prevede che il modello decida quale tool usare in base alla richiesta dell'utente. Nel frattempo, la fase di azione permetterà al modello di interfacciarsi con la fonte esterna scelta per raccogliere informazioni aggiuntive.
Se ti interessa un'introduzione approfondita al ReAct prompting con LangChain, fa per te l'articolo ChatGPT ReAct Prompting!
Ci sono due elementi importanti nel framework LangChain per utilizzare questa tecnica di prompting: Agents e Tools.
I cosiddetti agent sono entità responsabili dell'esecuzione delle effettive fasi di ragionamento e azione. Passano i risultati al modello, consentendo all'LLM di generare una risposta in linguaggio naturale con le informazioni aggiuntive. Esistono vari tipi di agent, ciascuno adatto a diversi compiti che potresti voler far svolgere all'LLM. Una panoramica dettagliata dei diversi tipi di agent è disponibile nella documentazione ufficiale di LangChain su Agents.
I Tools sono già stati un punto centrale della nostra discussione. Tecnicamente, i Tools sono funzioni che un agent può chiamare. LangChain offre un'ampia gamma di Tools come le utilità Google (come Search, Drive e Scholar), ricerche su Wikipedia, il database ArXiV, un'estensione shell e plugin nativi di ChatGPT, tra gli altri. In questo articolo, ne conosceremo quattro. Per un elenco completo di tutti i Tools disponibili, fai riferimento alla documentazione ufficiale di LangChain.
Passiamo alla pratica!
Come in qualsiasi altro progetto che utilizza modelli GPT, il primo passo è caricare la chiave API di OpenAI nel nostro ambiente. Per farlo, useremo i moduli os e openai.
import openai
import os

os.environ["OPENAI_API_KEY"] = os.getenv("OPENAI_API_KEY")
Se non hai ancora una chiave API OpenAI, questo articolo, Guida per principianti all'API di OpenAI, fa per te!
Poiché useremo il framework LangChain, caricheremo anche il modello gpt effettivo dalla libreria langchain:
from langchain.llms.openai import OpenAI

llm = OpenAI(model_name="gpt-3.5-turbo")
In questo caso, usiamo il modello gpt-3.5-turbo come opzione senza costi, ma sentiti libero di usare qualsiasi altro modello di tua preferenza.
Nella sezione seguente, vedremo come impostare il nostro primo Tool. Useremo come esempio lo strumento di ricerca DuckDuckGo, ma vedrai che tutti i Tools seguono gli stessi passaggi per mettersi in funzione!
DuckDuckGo è un motore di ricerca che pone l'accento sulla tutela della privacy degli utenti. A differenza di altri motori di ricerca, DuckDuckGo non traccia la cronologia delle ricerche dei suoi utenti, il che significa che non crea né mantiene un profilo personale degli utenti.
Dispone di una libreria Python che dobbiamo installare per usare il motore di ricerca. È installabile tramite pip:
!pip install duckduckgo-searchInoltre, dobbiamo importare il Tool DuckDuckGo dalla libreria langchain:
from langchain.tools import DuckDuckGoSearchRun

ddg_search = DuckDuckGoSearchRun()
Il metodo DuckDuckGoSearchRun() da solo consente già di navigare su Internet senza interfacciarsi con alcun LLM. Vediamo un semplice esempio:
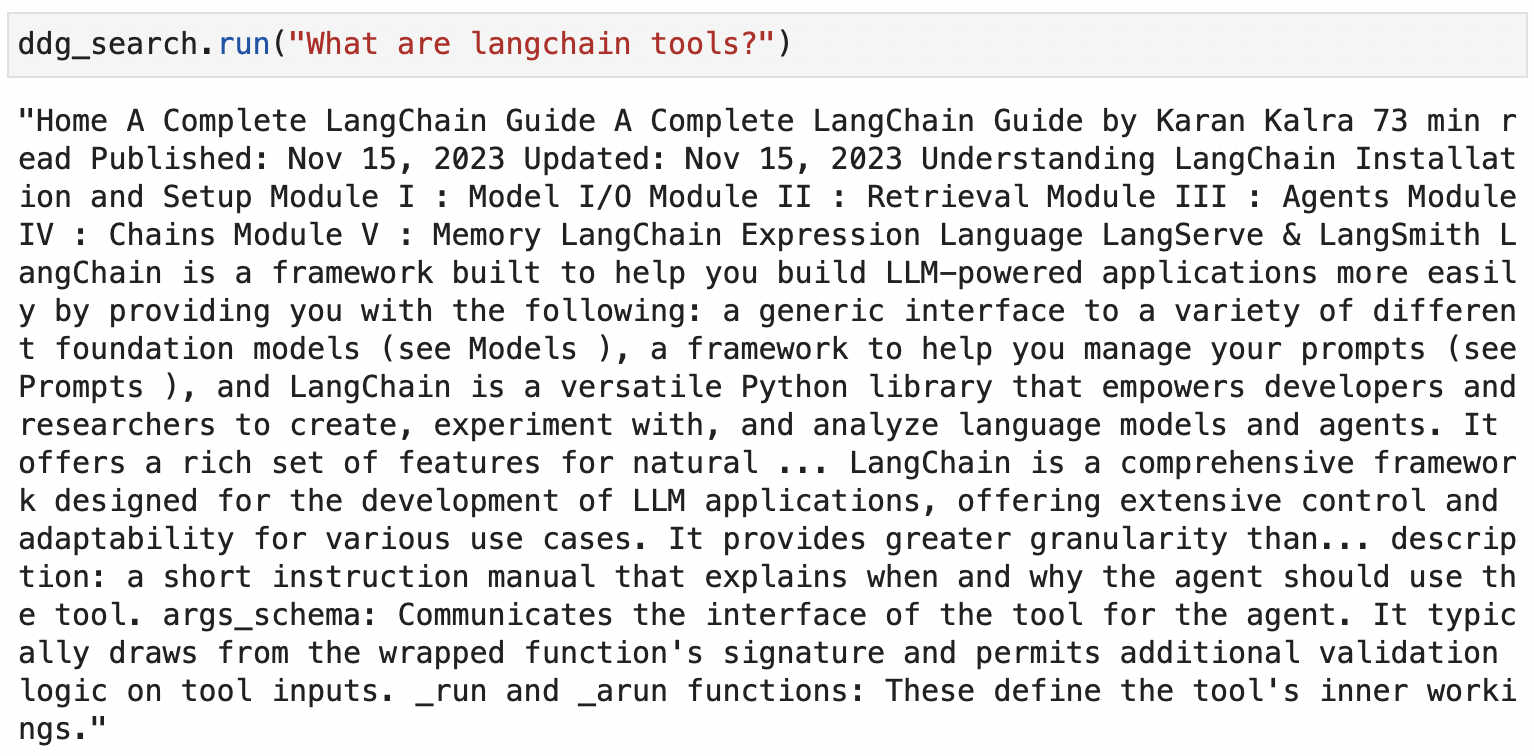
Screenshot dell'esecuzione di ddg_search.run() per navigare su Internet con DuckDuckGo
L'idea alla base dei Tools è integrare questa capacità di navigazione in un LLM, così da ottenere una risposta coerente in linguaggio naturale, invece di recuperare solo il dato grezzo. Per farlo, dobbiamo incorporare questo metodo in un'istanza della classe Tool di langchain come segue:
from langchain.agents import Tool

tools = [
   Tool(
       name="DuckDuckGo Search",
       func=ddg_search.run,
       description="Useful to browse information from the Internet.",
   )
]
Ogni tool ha bisogno di un nome (name) che l'agent di LangChain userà per riferirsi ad esso, di una funzione (func) che l'agent può eseguire per consultare le fonti esterne (ddg_search.run come mostrato sopra) e di una descrizione (description) che può essere usata per fornire informazioni all'agent su quando utilizzarlo.
Per questo esempio, abbiamo scelto la seguente descrizione: "Useful to browse information from the Internet". Esistono anche altri parametri opzionali nella definizione dei Tools che si possono personalizzare a seconda delle esigenze.
Una volta imparato a configurare il primo tool, impostare gli altri dovrebbe essere piuttosto semplice, dato che seguono tutti la stessa struttura.
Google Serper è una Google Search API a basso costo che ci consente di navigare su Internet come DuckDuckGo.
Per questo tool, ci serve una chiave API che possiamo ottenere registrandoci per un account gratuito su https://serper.dev/.
Screenshot della pagina principale della Google Serper API.
Una volta nel nostro account Serper, dovremmo vedere l'opzione della chiave API nel pannello laterale sinistro:
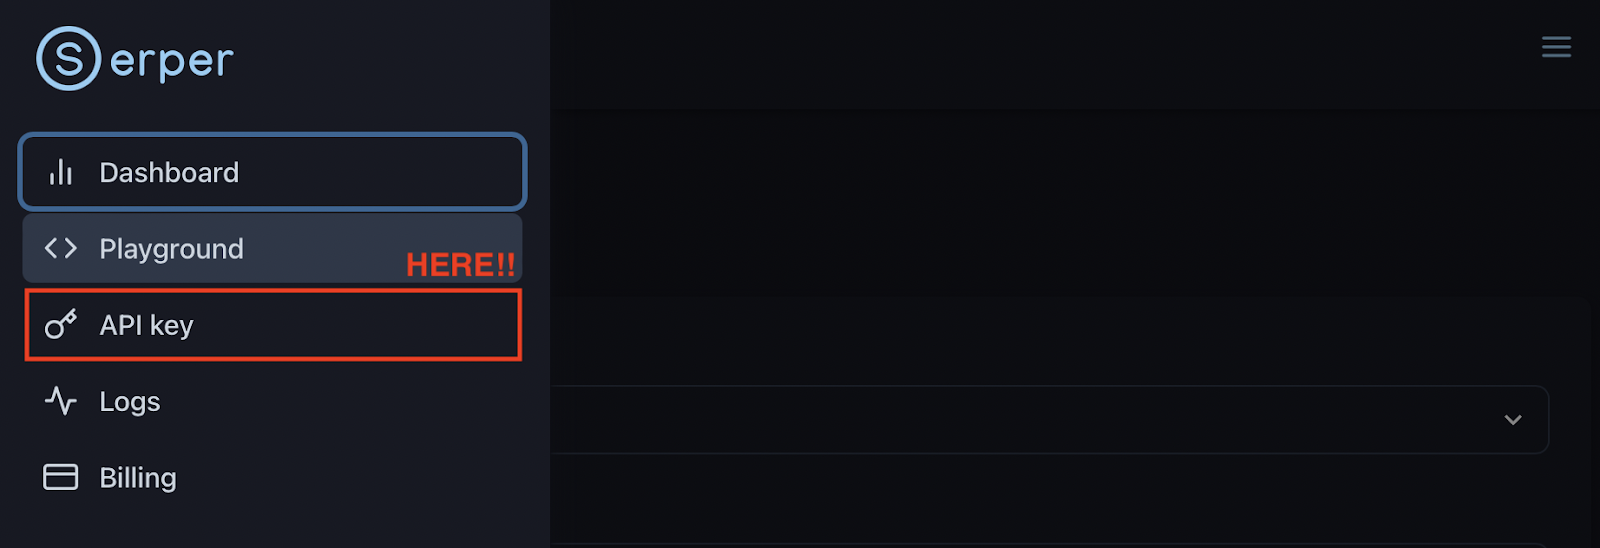
Screenshot della pagina account sulla Google Serper API. Opzione della chiave API nel pannello laterale sinistro.
Cliccandoci, otterremo la chiave API che possiamo copiare facilmente e integrare nei nostri script Python:
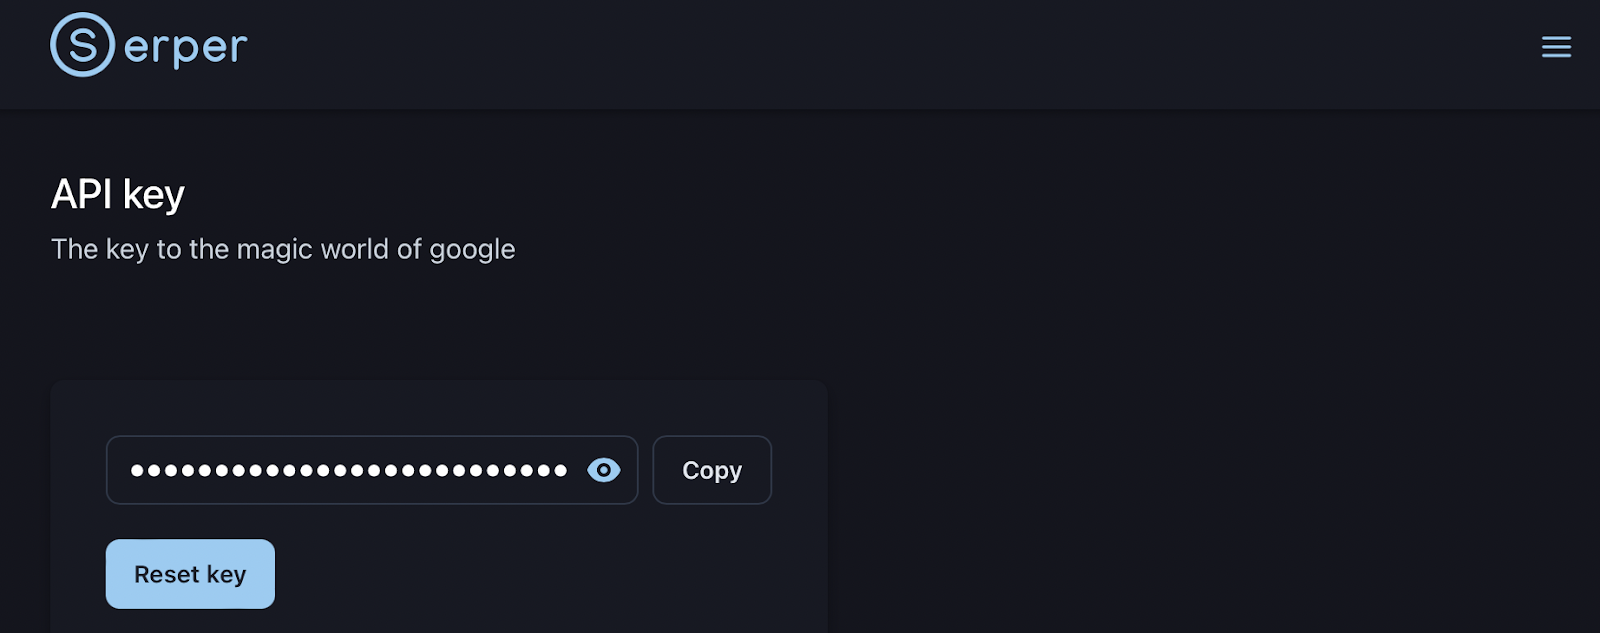
Screenshot della generazione della chiave API sulla pagina di Google Serper.
Tornando al codice, possiamo importare facilmente la chiave nel nostro ambiente:
serper_api_key = os.environ["SERPER_API_KEY"]Per usare la Google Serper API, dobbiamo prima installare la libreria Python necessaria (pip install google-serp-api). Inoltre, dobbiamo importare il Tool GoogleSerper dalla libreria langchain:
from langchain.utilities import GoogleSerperAPIWrapper

google_search = GoogleSerperAPIWrapper()
Come nel caso precedente, anche google_search.run() è un metodo che navigherà il web in modo indipendente. Tuttavia, di nuovo l'idea è integrarlo come tool di LangChain come segue:
tools.append(
   Tool(
       name="Google Search",
       func=google_search.run,
       description="Useful to search in Google. Use by default.",
   )
)
Nota che in questo caso stiamo aggiungendo un nuovo tool alla lista tools. Quindi, la nostra lista tools ora contiene entrambi i motori di ricerca.
Completiamo il nostro set di Tools con le note fonti di Wikipedia seguendo lo stesso processo dei Tools precedenti.
Il primo passo è installare la libreria Python wikipedia tramite pip (pip install wikipedia) e caricare i moduli necessari dalla libreria LangChain. Questo tool in realtà necessita di due moduli a causa dell'architettura dell'API di Wikipedia:
from langchain.tools import WikipediaQueryRun
from langchain.utilities import WikipediaAPIWrapper

wikipedia = WikipediaQueryRun(api_wrapper=WikipediaAPIWrapper())
Infine, possiamo aggiungere una nuova istanza della classe Tool con una funzione che esegue il metodo wikipedia.run():
tools.append(
   Tool(
       name="Wikipedia Search",
       func=wikipedia.run,
       description="Useful when users request biographies or historical moments.",
   )
)
Infine, ho trovato molto interessante integrare le fonti di YouTube in modo che il modello abbia una capacità aggiuntiva: rispondere sotto forma di video, non solo di testo scritto. Seguendo la stessa procedura di prima:
!pip install youtube

from langchain.tools import YouTubeSearchTool
youtube = YouTubeSearchTool()

tools.append(
   Tool(
       name="Youtube Search",
       func=youtube.run,
       description="Useful for when the user explicitly asks you to look on Youtube.",
   )
)
Ora siamo pronti per partire!
Abbiamo costruito un toolkit (lista tools) con i quattro Tools che forniscono capacità di navigazione al nostro modello. Tuttavia, finora non abbiamo interagito con il modello.
Vediamo come può sfruttare queste fonti!
Come abbiamo già detto, i cosiddetti agent sono le entità responsabili dell'uso dei Tools. Pertanto, dobbiamo importarli anche dalla libreria langchain:
from langchain.agents import initialize_agentIl metodo initialize_agent ci permetterà di impostare il nostro agent:
agent = initialize_agent(
   tools, llm, agent="zero-shot-react-description", verbose=True
)
Come possiamo osservare dall'inizializzazione, dobbiamo fornire all'agent l'elenco dei Tools disponibili (tools), l'LLM da usare (llm) e il tipo di agent (agent="zero-shot-react-description"). Per questo esempio, useremo l'agent Zero-shot ReAct come agent d'azione più generico. In questo caso, abbiamo anche impostato verbose=True per osservare il processo di ragionamento dell'agent.
Una volta inizializzato l'agent, possiamo eseguire qualsiasi prompt utente usando il metodo agent.run().
In linea di principio, una volta inviato un prompt utente, l'agent analizzerà le descrizioni dei Tools e userà quello più adatto al caso d'uso. Inoltre, l'agent ricorrerà comunque agli altri Tools se non trova le informazioni appropriate usando lo strumento selezionato.
Eseguiamo un primo test chiedendo una biografia. In questo caso, c'è un tool adatto che abbiamo configurato per biografie e momenti storici, quindi ci aspettiamo che l'agent selezioni il tool configurato:
agent.run(
   "Harry Styles biography"
)
Possiamo osservare il processo di ragionamento:
> Entering new AgentExecutor chain...
I should look for a biography of the singer

Action: Wikipedia Search
Action Input: Harry Styles biography

Observation:

Page: Harry Styles
Summary: Harry Edward Styles (born 1 February 1994) is an English singer. His musical career began in 2010 as part of One Direction, a boy band formed on the British music competition series The X Factor after each member of the band had been eliminated from the solo contest. They became one of the best-selling boy groups of all time before going on an indefinite hiatus in 2016.
Styles released his self-titled debut solo album through Columbia Records in 2017. It debuted at number one in the UK and the US and was one of the world's top-ten best-selling albums of the year, while its lead single, "Sign of the Times", topped the UK Singles Chart. Styles' second album, Fine Line (2019), debuted atop the US Billboard 200 with the biggest ever first-week sales by an English male artist, and was the most recent album to be included in Rolling Stone's "500 Greatest Albums of All Time" in 2020. Its fourth single, "Watermelon Sugar", topped the US Billboard Hot 100. Styles' third album, Harry's House (2022), broke several records and was widely acclaimed, receiving the Grammy Award for Album of the Year in 2023. Its lead single, "As It Was", became the number-one song of 2022 globally according to Billboard.
Styles has received various accolades, including six Brit Awards, three Grammy Awards, an Ivor Novello Award, and three American Music Awards. His film roles include Dunkirk (2017), Don't Worry Darling (2022), and My Policeman (2022). Aside from music and acting, Styles is known for his flamboyant fashion. He is the first man to appear solo on the cover of Vogue.

Page: Debbie Harry
Summary: Deborah Ann Harry (born Angela Trimble; July 1, 1945) is an American singer, songwriter and actress, best known as the lead vocalist of the band Blondie. Four of her songs with the band reached No. 1 on the US charts between 1979 and 1981.
Born in Miami, Florida, Harry was adopted as an infant and raised in Hawthorne, New Jersey. After college she worked various jobs—as a dancer, a Playboy Bunny, and a secretary (including at the BBC in New York)—before her breakthrough in the music industry. She co-formed Blondie in 1974 in New York City. The band released its eponymous debut studio album in 1976 and released three more studio albums between then and 1979, including Parallel Lines, which spawned six singles, including "Heart of Glass". Their fifth studio album, Autoamerican (1980), spawned such hits as a cover of "The Tide Is High", and "Rapture", which is considered the first rap song to chart at number one in the United States.Harry released her debut solo studio album, KooKoo, in 1981. During a Blondie hiatus, she embarked on an acting career, appearing in lead roles in the neo-noir Union City (1980) and in David Cronenberg's body horror film Videodrome (1983). She released her second solo studio album, 1986's Rockbird, and starred in John Waters's cult dance film Hairspray (1988). She released two more solo albums between then and 1993, before returning to film with roles in a John Carpenter-directed segment of the horror film Body Bags (1993), and in the drama Heavy (1995).
Blondie reunited in the late 1990s, releasing No Exit (1999), followed by The Curse of Blondie (2003). Harry continued to appear in independent films throughout the 2000s, including Deuces Wild (2002), My Life Without Me (2003) and Elegy (2008). With Blondie, she released the group's ninth studio album, Panic of Girls, in 2011, followed by Ghosts of Download (2014). The band's eleventh studio album, 2017's Pollinator, charted at number 4 in the United Kingdom.

Page: Harry Potter
Summary: Harry Potter is a series of seven fantasy novels written by British author J. K. Rowling. The novels chronicle the lives of a young wizard, Harry Potter, and his friends Hermione Granger and Ron Weasley, all of whom are students at Hogwarts School of Witchcraft and Wizardry. The main story arc concerns Harry's conflict with Lord Voldemort, a dark wizard who intends

Thought: I now know the final answer
Final Answer: Harry Styles is an English singer, songwriter and actor. He rose to fame as a member of the boy band One Direction, and later embarked on a solo career. He released his debut solo album, Harry Styles, in 2017, and his second album, Fine Line, in 2019. He has also had success in film, appearing in Dunkirk (2017), Don't Worry Darling (2022) and My Policeman (2022).

> Finished chain.

"Harry Styles is an English singer, songwriter and actor. He rose to fame as a member of the boy band One Direction, and later embarked on a solo career. He released his debut solo album, Harry Styles, in 2017, and his second album, Fine Line, in 2019. He has also had success in film, appearing in Dunkirk (2017), Don't Worry Darling (2022) and My Policeman (2022)."
Possiamo vedere che, una volta eseguito il metodo .run(), l'agent elabora il prompt utente e avvia la fase di ragionamento, che si conclude con il seguente esito: "Dovrei cercare una biografia del cantante". Per farlo, elabora un piano d'azione che consiste nell'usare lo strumento Wikipedia Search – secondo la nostra definizione di tool – con "Harry Styles biography" come input. Quindi, il piano d'azione parte e l'agent recupera informazioni correlate dal database di Wikipedia, elabora i risultati e genera una risposta adeguata in linguaggio naturale.
Ora richiediamo un'attività di navigazione generica in modo che l'agent non abbia un tool specifico menzionato nella descrizione del toolkit:
agent.run(
   "Yesterday's latest news in Spain"
)
Osserviamo il processo di ragionamento in questo caso:
> Entering new AgentExecutor chain...
I should look for news from yesterday

Action: Google Search
Action Input: "Yesterday's news in Spain"

Observation: The latest breaking news, comment and features from The Independent. All the latest content about Spain from the BBC. Find all national and international information about spain. Select the subjects you want to know more about on euronews.com. Latest Spain news stories including accidents, crime and policing, politics, and Spanish sport news headlines. Latest news, essential insights and practical guides to life in Spain from The Local, Europe's leading independent voice. Missing: Yesterday's | Show results with:Yesterday's. Stay on top of Spain latest developments on the ground with Al Jazeera's fact-based news, exclusive video footage, photos and updated maps. Missing: Yesterday's | Show results with:Yesterday's. Spain · Shakira due to go on trial in Spain over tax fraud claims · The Observer view on Pedro Sánchez's election deal to take power: it undermines democracy. Missing: Yesterday's | Show results with:Yesterday's. Latest News · Hundreds leave Al-Shifa hospital as Israeli forces take control of facility · F1 fans file class-action suit over being forced to exit Las Vegas ... Missing: Yesterday's | Show results with:Yesterday's. Follow the latest Spain news stories and headlines. Get breaking news alerts when you download the ABC News App and subscribe to Spain notifications. Missing: Yesterday's | Show results with:Yesterday's. Get the latest breaking news and top news headlines at Reuters ... Spain Headlines. Shakira stands trial in Spain for alleged tax fraud. Shakira ... Missing: Yesterday's | Show results with:Yesterday's.
Thought: I found a lot of news sources with yesterday's news, so the final answer should be about that.

Final Answer: The latest news in Spain from yesterday is that Shakira is standing trial in Spain for alleged tax fraud, hundreds of people have left Al-Shifa hospital as Israeli forces take control, and F1 fans have filed a class-action suit over being forced to exit Las Vegas. Other news includes insights and practical guides to life in Spain, Pedro Sánchez's election deal to take power, and the top news headlines from Reuters.

> Finished chain.
"The latest news in Spain from yesterday is that Shakira is standing trial in Spain for alleged tax fraud, hundreds of people have left Al-Shifa hospital as Israeli forces take control, and F1 fans have filed a class-action suit over being forced to exit Las Vegas. Other news includes insights and practical guides to life in Spain, Pedro Sánchez's election deal to take power, and the top news headlines from Reuters."
In questo caso, l'agent ricorre con successo al tool predefinito Google Serper e trova le ultime notizie in Spagna. Questo esempio di navigazione è particolarmente interessante perché riusciamo a porre un prompt molto attuale a un LLM il cui addestramento si è fermato a settembre 2021, e tuttavia otteniamo una risposta aggiornata.
Infine, supponiamo che ci interessi una risorsa video. Vediamo se il modello può effettivamente indicarci quale. Disattiveremo la modalità verbose e osserveremo la risposta effettiva del modello:
agent = initialize_agent(
   tools, llm, agent="zero-shot-react-description"
)

agent.run(
   "Can you point me to the Procrastination TED talk by Tim Urban?"
)
E, come previsto, otteniamo con successo la seguente risposta:
'The TED Talk "Procrastination" by Tim Urban can be found at
https://www.youtube.com/watch?v=arj7oStGLkU'
Funziona! Con questi tre esempi, abbiamo mostrato le diverse fonti che il nostro LLM può utilizzare per soddisfare le nostre richieste.
Se ti interessa integrare altri Tools nel nostro Toolkit, ti consiglio l'articolo ReAct: 3 LangChain Tools per potenziare le capacità del GPT predefinito.
In questo tutorial, abbiamo visto l'uso dei LangChain Tools per migliorare le capacità di navigazione negli LLM. Al centro di LangChain c'è la sua capacità di semplificare lo sviluppo di applicazioni basate su LLM, offrendo una suite di funzionalità potenti tra cui memorie integrate, chatbot completi e i Tools esplorati in questo articolo, tra gli altri.
Mentre OpenAI sta facendo passi avanti nel campo dell'AI personalizzata con il lancio dei suoi ultimi modelli GPT, credo ci sia ancora ampio margine di crescita e innovazione.
In tal senso, i LangChain Tools hanno un notevole vantaggio in questa corsa tecnologica per gli utenti che interagiscono frequentemente con i modelli GPT tramite Python e l'API di OpenAI. Questo contrasta nettamente con i GPT, che sembrano pensati per un pubblico non tecnico. Gli utenti di GPT possono configurare facilmente un'istanza specializzata dall'interfaccia utente di ChatGPT e accedervi quando necessario, offrendo facilità d'uso ma una flessibilità limitata.
Inoltre, la capacità dei LangChain Tools di consultare fonti di informazione esterne come Google o Wikipedia amplia notevolmente la base di conoscenze del modello. Questo rappresenta un vantaggio considerevole rispetto ai GPT, che supportano il caricamento di informazioni ma su scala più ridotta.
In conclusione, i LangChain Tools sono, a mio avviso, le funzionalità più potenti per aumentare le capacità del modello e personalizzare le nostre istanze utilizzando dati pubblici ampiamente disponibili. Riesci a immaginare ora la potenza di combinare i Tools con il nostro database privato?
Nuovo nel mondo degli LLM? Dai un'occhiata al nostro corso Concetti sui Large Language Models per metterti in pari!
Sviluppa le tue competenze in AI!
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



