
Cursus
Inleiding tot AI-agents
1 uur 30 min
147.4K
De live demo van ChatGPT Agent zag er indrukwekkend uit: op het web browsen voor cadeaus, reizen boeken, presentaties maken. De aankondiging toonde sterke benchmarkresultaten, wat suggereerde dat de Agent complexe taken uit de echte wereld aankan.
Maar live demo’s gebruiken altijd zorgvuldig gekozen voorbeelden, en benchmarks vangen niet de complexe realiteit van dagelijkse workflows die OpenAI zegt dat de Agent kan oplossen.
Dus heb ik de Agent vijf veeleisende tests laten doen die echte werkscenario’s nabootsen — taken die vragen om meerdere browsertabbladen te beheren, informatie tussen verschillende websites te kruisen en resultaten op te leveren die ik echt zou gebruiken. Dit artikel laat zien wat er gebeurt wanneer marketingbeloften de praktische werkelijkheid ontmoeten.
We houden onze lezers op de hoogte van het laatste AI-nieuws via The Median, onze gratis vrijdagse nieuwsbrief die de belangrijkste verhalen van de week uitlegt. Abonneer je en blijf scherp in slechts een paar minuten per week:
ChatGPT Agent is OpenAI’s nieuwste premiumfunctie voor Plus-, Pro- en Enterprise-gebruikers. Het brengt drie tools samen die eerder los van elkaar werkten: Deep Research, Operator en het redeneervermogen van het kernmodel. Het grote verschil? De Agent krijgt een eigen virtuele computer om mee te werken.
Dat is belangrijk omdat de oude opzet problemen had. Deep Research was geweldig in analyse maar kon nergens op klikken. De Operator kon websites navigeren maar miste het redeneervermogen dat deep research zo nuttig maakte. De Agent lost dit op door beide vaardigheden te combineren op één plek.
Je vindt de Agent als een extra optie in je chatwerkbalk. Maar in tegenstelling tot de gewone ChatGPT draait hij op een virtuele computer met volledige toegang tot:
Dankzij de virtuele computer kan de Agent dingen doen die eerder niet mogelijk waren.
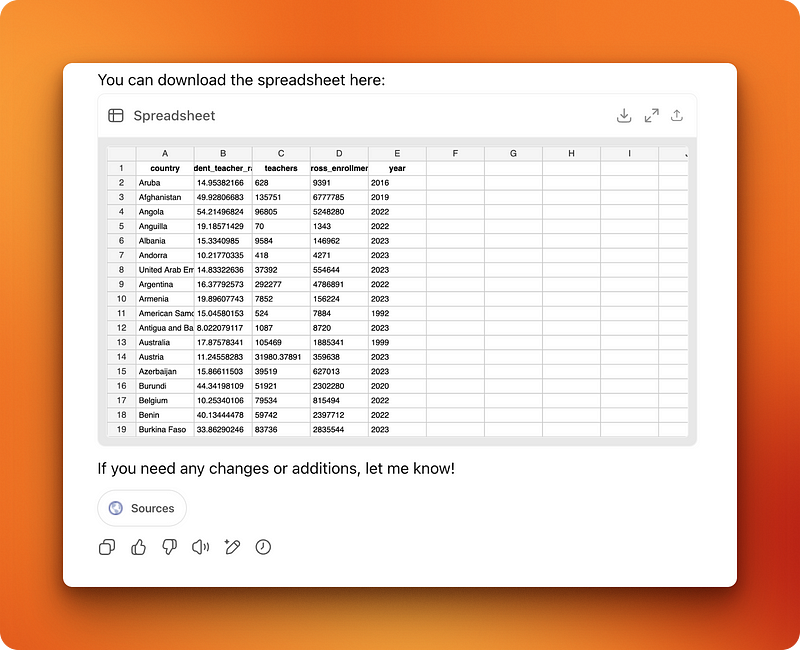
Toen ik hem testte met een UNESCO-onderwijsdatataak, zag ik hem 14 minuten achter elkaar werken. Dit was de prompt (voorgesteld door ChatGPT zelf tijdens mijn eerste interactie met de Agent):
Pull the latest available data from the UNESCO Institute for Statistics on national student-teacher ratios and total teaching staff counts for primary and secondary education.
Create a spreadsheet with two tabs: one for primary education and one for secondary.
Each should include country name, student-teacher ratio, total number of teachers, gross enrollment, and year of reporting.
Add a summary tab highlighting the countries with the most strained and most favorable ratios, sorted accordingly.
Ensure consistent country naming across tabs.
Dit kon hij aan tijdens het uitvoeren van de prompt:
Ik gaf zowel de Agent als o3-pro dezelfde complexe prompt hierboven: haal UNESCO-data over leerling-leraarverhoudingen op en maak een opgemaakte spreadsheet met meerdere tabbladen. De resultaten lieten duidelijke verschillen zien.
De Agent werkte 14 minuten en leverde een spreadsheet met 222 landen. Het miste één vereiste (het samenvattingstabblad met beste/slechtste verhoudingen) en sorteerde de lijst alfabetisch in plaats van op verhoudingen. Dit kan contextbloat — waardoor het model de oorspronkelijke details vergeet tijdens een lange taak.
o3-pro daarentegen nam 18 minuten om over het probleem na te denken. Vervolgens liep het tegen obstakels aan die de Agent eerder automatisch oploste. Omdat o3-pro geen bestanden kan downloaden, vroeg het me om twee resources handmatig te downloaden, ze uit te pakken en een Python-script uit te voeren dat het had geschreven. Ik heb het script niet getest, maar duidelijk was dat deze aanpak minstens 10 minuten aan mijn workflow zou toevoegen.
Als de Agent draait, kun je alles in realtime zien gebeuren. Je kunt op elk moment de browser overnemen, maar bij taken zonder gevoelige data of interacties werkt hij prima zelfstandig.
Na afloop krijg je twee manieren om te zien wat er is gebeurd. Er is een volledige video-opname die je kunt pauzeren en terugspoelen (best saai om te bekijken zodra de nieuwigheid eraf is). En een gedetailleerde teksttijdlijn met de redenatie achter elke stap, de daadwerkelijk uitgevoerde commando’s en de bestandsbewerkingen.
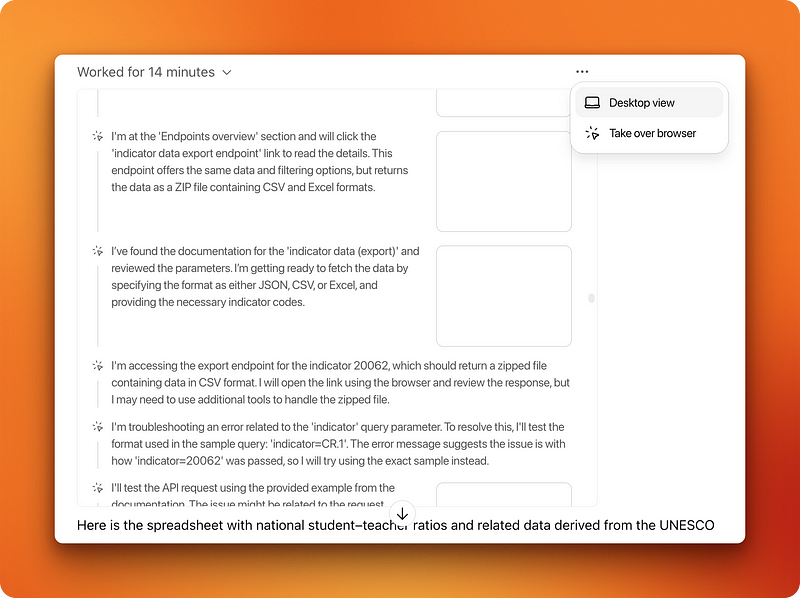
Het leuke? Zodra de Agent klaar is, kun je vervolgvragen stellen in de normale chatmodus. Hij onthoudt alles wat hij heeft geleerd en kan verwijzen naar de verzamelde data.
De eerste onderzoekstaak liet zien dat de Agent complexe dataverzameling aankan. Maar ik wilde iets anders testen — taken die constant muisgebruik vereisen met webpagina-elementen. Anders houd ik het bij mijn sneltoetsen en doe ik het zelf.
Figuren en diagrammen maken kwam meteen in me op. Dat doe ik vaak voor blogposts, dus het voelde als een logische test.
Tijdens het onderzoek voor dit artikel las ik OpenAI’s aankondiging over ChatGPT Agent. De post bevat 6–7 benchmarkafbeeldingen met de indrukwekkende prestaties van de Agent. In plaats van elke benchmark apart op te sommen, vroeg ik de Agent om een visuele collage te maken die ik aan deze blogpost kon toevoegen.
I want you to open the following link, combine all benchmark results' images into a single collage and highlight the columns where ChatGPT's agent results are given.

<link>
https://openai.com/index/introducing-chatgpt-agent/
</link>
Wat ik wilde was simpel — pak alle benchmarkdiagrammen van de webpagina, zet ze naast elkaar in rijen en teken rode rechthoeken rond de kolommen met de prestaties van de Agent. Voor een doorsnee Canva-gebruiker kost dit een paar minuten: afbeeldingen pakken, rangschikken, wat rechthoeken tekenen.
Maar voor een AI-programma vereist dit complexe redenatie en veel muiswerk. De Agent nam 9 minuten en leverde iets teleurstellends op.
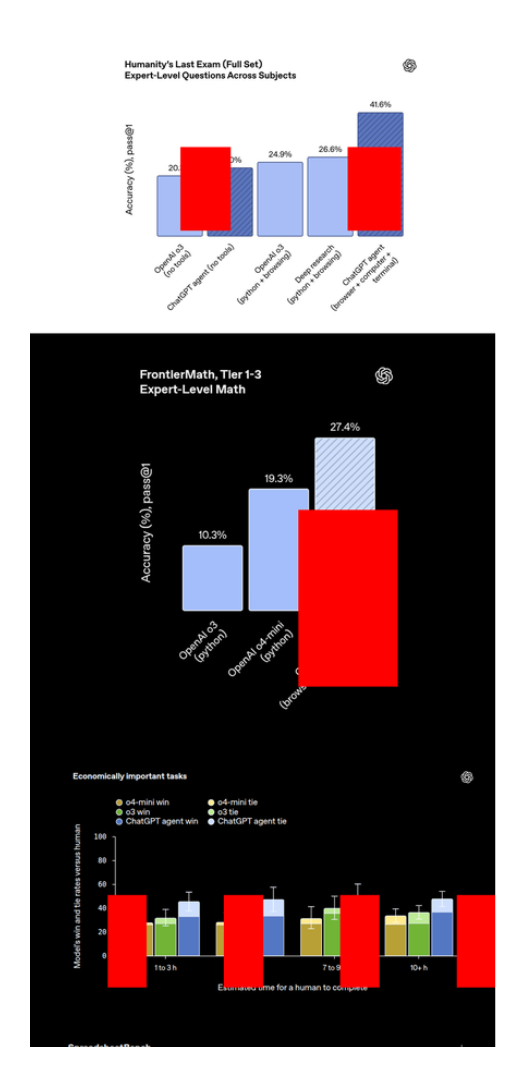
De afbeelding was volledig verticaal in plaats van een nette rasterindeling. De rode rechthoeken waren geen strakke omlijningen maar gevulde vormen die overal over de beelden lagen. Erger nog, hij was zelfs naar andere websites afgedwaald en had benchmarks van willekeurige pagina’s gehaald in plaats van de aangekondigde post die ik had opgegeven.
Ook negeerde hij Canva volledig, terwijl ik dat aan mijn account had gekoppeld.
Ik begon een nieuw gesprek met specifiekere instructies:
I want you to open the following webpage where you will find a bunch of benchmark results given in the form of images on the performance of ChatGPT Agent. Your task is to combine all those images given in the webpage (ONLY IN THAT WEBPAGE, DON'T SEARCH FOR ADDITIONAL INFORMATION) into a single collage where you organize the images side-by-side in rows. Afterward, highlight the columns where ChatGPT Agent's performance is shown with a red rectangle. Use Canva to do this task

<link>
https://openai.com/index/introducing-chatgpt-agent/
</link>
Eerst liep de Agent tegen een CAPTCHA aan bij het lezen van de aankondiging. Ik moest het overnemen en zelf de zebrapaden selecteren. Daarna werkte hij 18 minuten door voordat hij me vroeg in te loggen op Canva.
De inlogervaring was niet soepel. De virtuele computer en browser haperen — niet zoals de vlotte respons die je verwacht bij het inloggen op websites. Sneltoetsen zoals Cmd + V om wachtwoorden te plakken reageren trager.
Toen ik de Agent eenmaal had ingelogd op Canva, ging hij weer aan de slag met de interface.
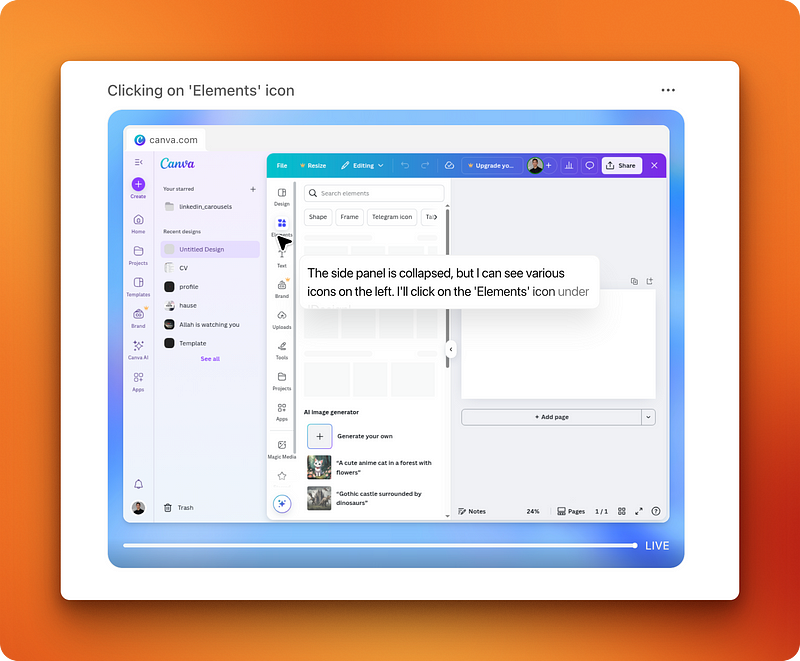
Na 8 minuten stuntelen moest ik ingrijpen. De Agent probeerde de benchmarkafbeeldingen één voor één handmatig na te tekenen in plaats van de daadwerkelijk gedownloade afbeeldingen te gebruiken.
Ik verduidelijkte met een nieuwe prompt:
No, you are going in the wrong direction on Canva.
What I meant was that after you grabbed the benchmark results' images, paste them into canva and organize them one-by-one into a 16:9 collage with ChatGPT Agent's performance highlighted with a red rectangle
Dit keer begreep de Agent het, maar duidelijk was dat hij niet echt wist hoe hij de taak moest uitvoeren.
Het kostte hem flink wat tijd om de aankondiging opnieuw te lezen en de benchmarkafbeeldingen te downloaden. Het downloadproces was pijnlijk traag — de Agent bleef twijfelen tussen ‘Afbeeldingslink kopieëren’, ‘Afbeelding opslaan’ of andere opties in het contextmenu versus de knop ‘Afbeelding downloaden’ rechtsboven.
Na het uploaden van de afbeeldingen naar Canva begon de Agent aan de lay-out. Toen bleek hoe zwak zijn ruimtelijke controle is. Het was alsof je een kind ziet proberen een computer te gebruiken. Hij miste steeds uitlijningen en logische posities waar elementen zouden moeten komen.
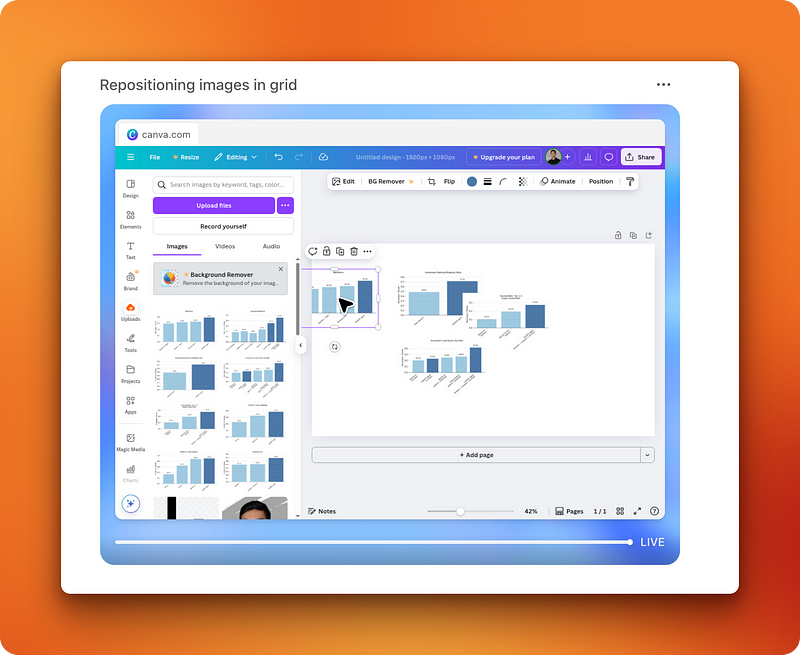
Nog een probleem dook op toen de Agent rechthoeken rond de benchmarkbalken wilde tekenen. Voor mensen is dit triviaal — één vloeiende muisbeweging tekent een rechthoek. Voor de Agent werd dit moeilijk. Omdat hij ruimtelijk en visueel ontwerpbegrip mist, greep hij naar Python-scripts en OCR om te detecteren welke balken de prestaties van de Agent lieten zien en berekende vervolgens exacte coördinaten voor de plaatsing van rechthoeken.
Alles bij elkaar duurde de operatie meer dan 75 minuten, inclusief het heen en weer. De Agent liet me achter met een “Untitled Design Page 2” in mijn Canva-account.
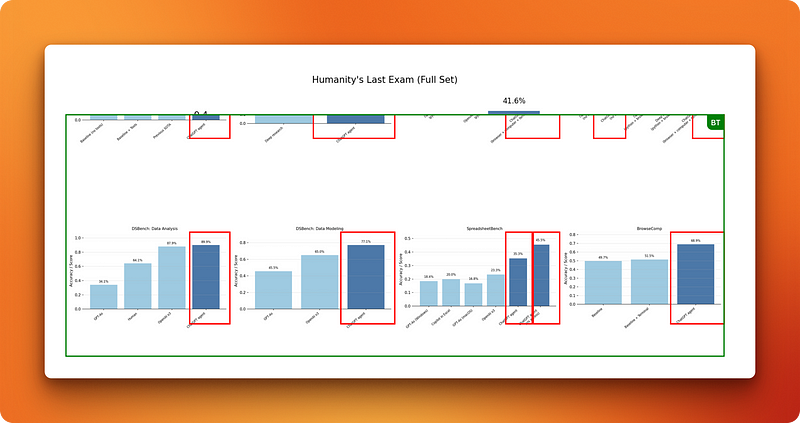
De afbeelding leek bijgesneden omdat de Agent een titeltekst had toegevoegd, waardoor het bovenste deel verborgen raakte. Na wat handmatig vergroten en verkleinen kreeg ik een bruikbare collage die nog steeds vrij ruw was vergeleken met wat een onervaren menselijke ontwerper in minuten kan maken.
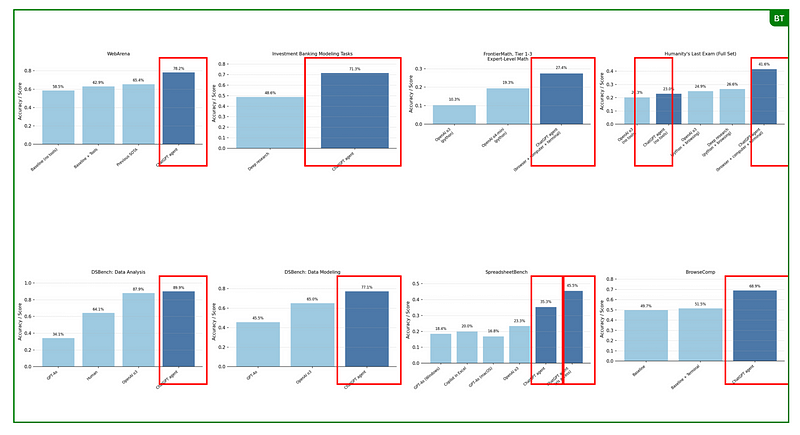
De tijdsinvestering rechtvaardigde de kwaliteit absoluut niet. Erger nog, later ontdekte ik dat de Agent Canva’s rechthoektools helemaal niet had gebruikt — hij had de rechthoeken in Python getekend en vervolgens de aangepaste afbeelding naar Canva geüpload. Daardoor kon ik die scheve rechthoeken achteraf niet meer handmatig aanpassen of verplaatsen.
Op dit punt besefte ik dat ik een te complexe taak had gevraagd. De collage vergde te veel stappen — webscrapen, ruimtelijk redeneren, meerdere afbeeldingen bewerken en nauwkeurig ontwerpwerk tegelijk.
Dus probeerde ik iets simpelers: headerafbeeldingen voor blogposts maken. Dat is een taak die ik zelf niet graag doe, dus als de Agent dit aankan, is dat echt nuttig.
Ik hield de eisen basic: “Ik schrijf een tutorial over de nieuwe Agent-modus van ChatGPT. Jouw taak is een 16:9-headerafbeelding maken met DataCamps merkkleuren voor de tutorial. Het moet het trefwoord ‘ChatGPT Agent’ bevatten en een robotfiguur die je naast dat trefwoord kunt vinden. Gebruik Canva om deze taak te voltooien.”
Dit keer had ik veel betere resultaten. De Agent zocht correct naar DataCamps merkkleuren en voegde de twee elementen zij aan zij toe in Canva. De uitlijning was nog steeds niet perfect — tekst en beelden stonden niet helemaal goed ten opzichte van elkaar — maar hij gebruikte tenminste echte Canva-elementen.
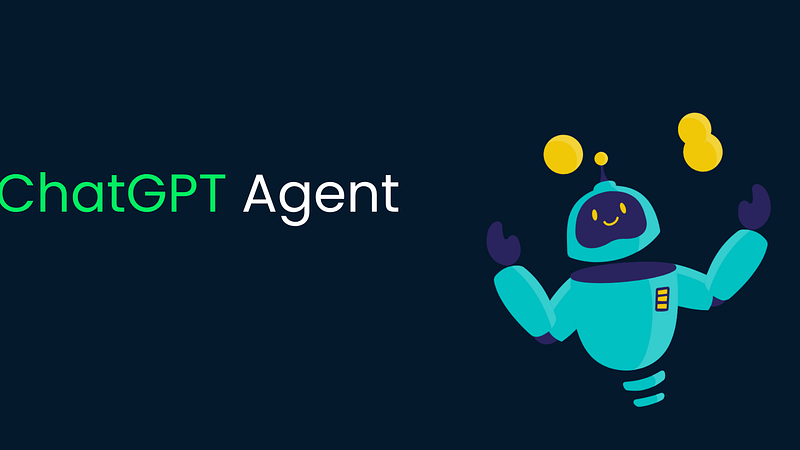
Daardoor kon ik ze zelf gemakkelijk naar betere posities slepen. Een paar snelle aanpassingen en ik had een bruikbare headerafbeelding.
Een interessant detail: hoewel ik tijdens de vorige complexe taak had ingelogd op Canva in een andere chatthread, hoefde ik hier niet opnieuw in te loggen. De virtuele computer bewaart blijkbaar browsergeschiedenis, cookies en logininfo over sessies heen. Handig voor workflows, maar het is goed om te weten als je niet wilt dat ChatGPT die info bewaart — je moet het dan handmatig wissen.
Dit keer besloot ik de Agent te testen op iets waar ik eerder mee worstelde. Ik ben een AFOL (adult fan of Lego) en een paar maanden geleden vroeg ik ChatGPT om met het o3-model een CSV-bestand te genereren voor een startpakket Technic in bulk van 10.000 onderdelen.
Lange CSV-generatie is lastig voor LLM’s omdat er te veel kleine details zijn om bij te houden. Dus toen het een CSV maakte met minstens 50 verschillende onderdelen, hun ID’s, namen en aantallen, bleek het op bepaalde onderdeel-ID’s te hallucineren, ondanks toegang tot webzoekopdrachten.
Mijn onderzoek stopte daar omdat ik niet het geduld had om elke onderdeel-ID dubbel te checken en te verifiëren dat de ID’s echt bestaan en overeenkomen met het daadwerkelijke onderdeel dat o3 me wilde laten kopen op BrickLink, een officiële marketplace voor Lego-onderdelen en -sets.
Maar nu ik toegang had tot de Agent, die het dubbelcheck-browsen voor me kon doen, vroeg ik o3 opnieuw om een CSV, maar dan voor een kleiner pakket van 3.000 onderdelen voor de eenvoud:
I want you to generate me a 3000-piece bulk pack for getting started with Lego Technic.
I am interested in building cars and motorized mechanisms as a hobby.
The bulk pack you generate must be saved to a CSV file with the following columns:

- Part ID
- Part name
- Amount

Use the official part IDs and names so that when I upload the CSV to bricklink, I can place an order with a single click
Het model dacht 5 minuten na en gaf me het CSV-bestand. Daarna schakelde ik over naar een nieuwe thread (want het blijkt dat de Agent-modus uitstaat wanneer de eerste prompt in een chat niet voor de Agent is).
Ik uploadde het bestand en schreef de volgende prompt:
I attached a 3,000-piece Lego Technic starter pack list. Your task is to double-check that each part listed in the list actually exists and that part IDs actually match part names. You must use BrickLink website (only BrickLink) as a single source of truth.

If certain part IDs or names are incorrect, correct them. Afterward, create a wishlist on BrickLink that will allow me to one-click order them later. When creating the wishlist, ask me to log in to BrickLink and I will do that for you.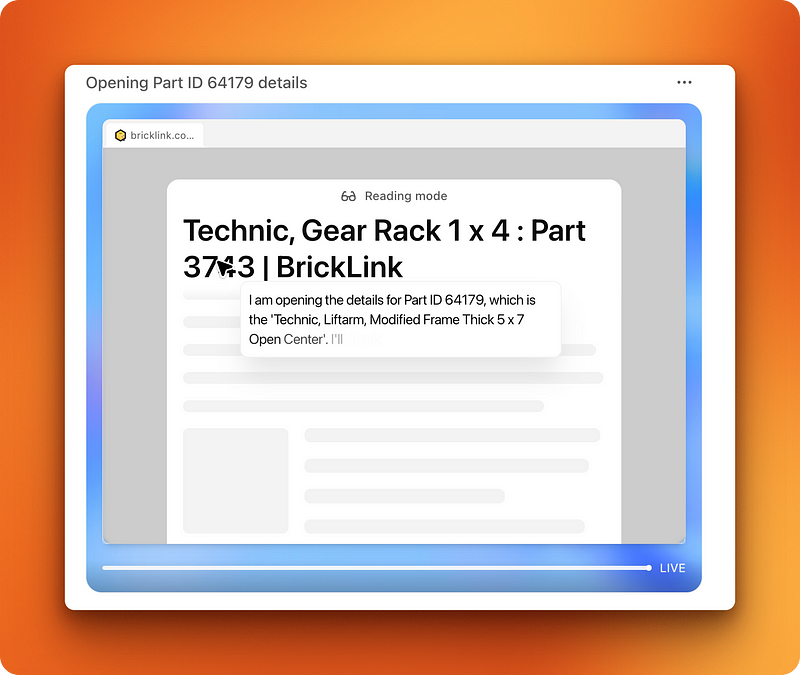
De Agent ging aan de slag. Na 5 minuten werken op de BrickLink-website vond hij dat drie onderdelen anders heetten op de site en corrigeerde die. Precies het soort monnikenwerk dat ik zelf wilde vermijden.
Daarna vroeg hij me in te loggen om een verlanglijstje onder mijn account te maken. Ik logde in met mijn gegevens, en de Agent nam de controle terug om een wishlist te maken.
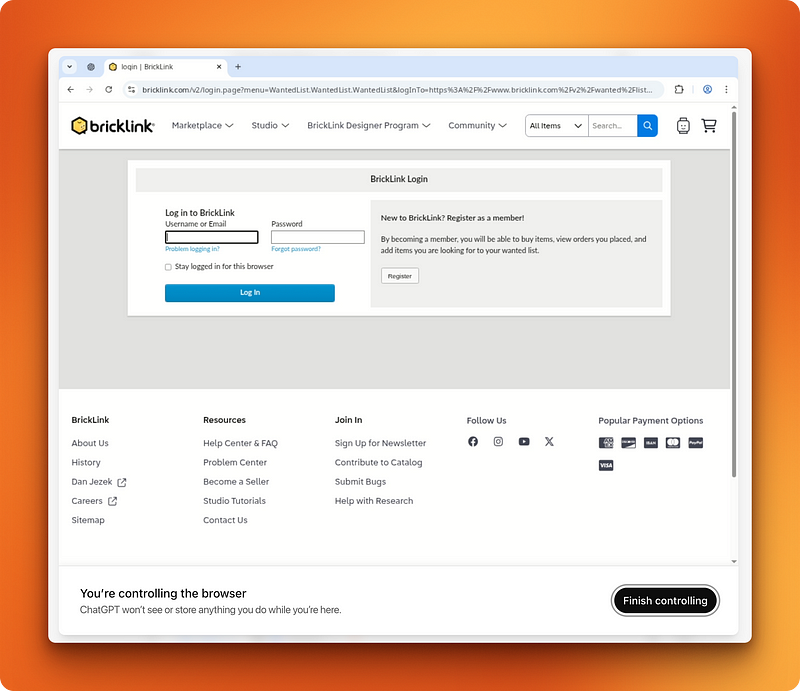
Vóór het definitief op ‘Create wishlist’ klikken, vroeg hij om bevestiging, zoals hij is getraind bij belangrijke handelingen. Ik zei ja, en dáár ging het mis.
De Agent zei dat hij het verlanglijstje had aangemaakt, maar in mijn account was niets te vinden. In feite had hij op de laatste knop moeten drukken en vervolgens de CSV moeten uploaden om de taak te voltooien. Dat laatste deel bleef achterwege.
Maar natuurlijk was het moeilijke deel — het eigenlijke onderzoekswerk dat vroeg om telkens te schakelen tussen CSV en BrickLink — correct uitgevoerd door de Agent. Hij had tientallen onderdeel-ID’s geverifieerd, naamafwijkingen gevonden en gecorrigeerd. Dit bespaarde me uren handmatig kruislings controleren.
De fout zat helemaal aan het einde bij het aanmaken van de wishlist, waarschijnlijk doordat de Agent het meerstaps uploadproces van BrickLink verkeerd begreep. Frustrerend, maar de kernwaarde was geleverd: ik had nu een geverifieerde CSV met correcte onderdeel-ID’s die ik zelf handmatig naar BrickLink kon uploaden.
Tot slot wilde ik de PowerPoint-vaardigheden van de Agent testen, omdat in de aankondiging het maken van presentaties als een van de echte toepassingen werd genoemd. PowerPoint ontwijk ik het liefst, en ik gebruik Gamma als ik toch moet presenteren.
Nu wilde ik zien of de Agent vergelijkbaar was met Gamma. Dit was mijn prompt:
I want you to build me a presentation pitch deck for convincing existing Manus users to the newly released ChatGPT Agent.
Here is the announcement post that you can use for information: https://openai.com/index/introducing-chatgpt-agent/
De Agent stelde meteen een vervolgvraag:
Do you have any specific preferences for slide count, visual style, or key points you'd like emphasized?Waarop ik antwoordde:
Yes, keep it to 10 slides max, use a minimalistic white, black and red (gradients are allowed) for the style.
If possible, look for direct comparisons between Manus and ChatGPT AgentDe Agent werkte 13 minuten aan de presentatie. Opvallend genoeg gebruikte hij geen Google Slides — hij gebruikte de terminal om een combinatie van Python- en JavaScript-code te draaien!
Leer AI met deze cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

