
50% off DataCamp Premium. 700+ courses, half price. Start learning today.
Een databaseschema is de blauwdruk van de structuur en relaties binnen een database. Het specificeert hoe data wordt georganiseerd in tabellen, velden, datatypes en de relaties tussen deze elementen. Laten we kijken wat de belangrijkste componenten zijn en hoe ze bijdragen aan het algehele databaseschema:
Een goed ontworpen databaseschema zorgt ervoor dat de data klopt, de queryprestaties geoptimaliseerd zijn en je database de groei van het bedrijf kan ondersteunen.
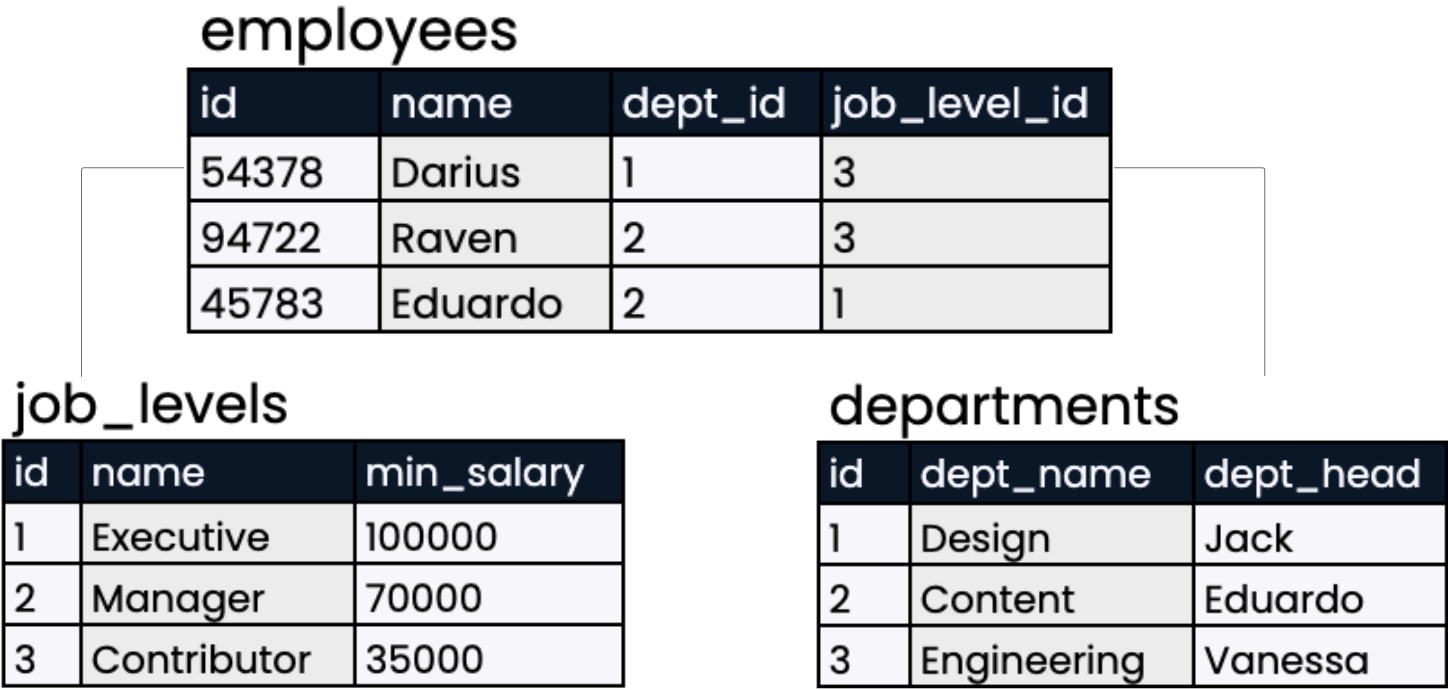
Data organiseren in tabellen. Afbeelding door de auteur
Maar hoe ziet een goed ontworpen databaseschema eruit? Dit moet je weten:
Er zijn meerdere typen databaseschema’s, elk met een ander doel en een eigen niveau van organisatie. Soms worden schema’s losser gebruikt om algemene databasestructuren te beschrijven, terwijl ze andere keren verwijzen naar specifieke architecturale elementen en ontwerdetails. Op hoog abstractieniveau kun je databaseschema’s in drie typen indelen: conceptueel, logisch en fysiek.
Een conceptueel databaseschema is een high-level schema dat een totaaloverzicht geeft van het hele databasesysteem zonder implementatiedetails te tonen, zoals datatypes of constraints. Ze helpen gebruikers de datastromen binnen een organisatie te begrijpen en maken het eenvoudiger voor zowel technische als niet-technische gebruikers.
Het logisch schema schetst de logische structuur van de data in de database. Het definieert hoe de data is georganiseerd en de relaties tussen de data-entiteiten zonder te tonen hoe deze fysiek wordt opgeslagen. Dit schematype bewaakt dataconsistentie en -integriteit door datatypes en constraints te specificeren die invoer valideren tijdens de ontwerpfase van de database.
Een fysiek databaseschema beschrijft waar de data zich in een systeem bevindt. Dit kan bestandslocaties, indexeringsstrategieën en opslagformaten per tabel omvatten om maximale prestaties te garanderen wanneer je met grote hoeveelheden data werkt.
Als het gaat om het organiseren van data, is er geen one-size-fits-all. Verschillende datawarehouses hebben uiteenlopende zakelijke behoeften en vereisen dus verschillende databaseschema’s. Enkele van de populairste stijlen zijn het sterrenschema, snowflake-schema, hiërarchisch schema en relationeel schema.
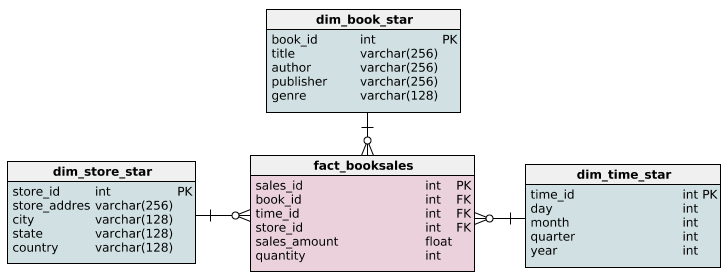
Het sterrenschema rangschikt en beheert grote datasets op basis van twee essentiële principes: feiten en dimensies. Feiten lijken op bedrijfsoperaties waarvan de drijvende factoren belangrijk zijn, zoals verkoopcijfers of transactievolumes. De dimensies breiden deze feiten uit met beschrijvende context. Dat kan tijd, locatie of zelfs productdetails zijn.
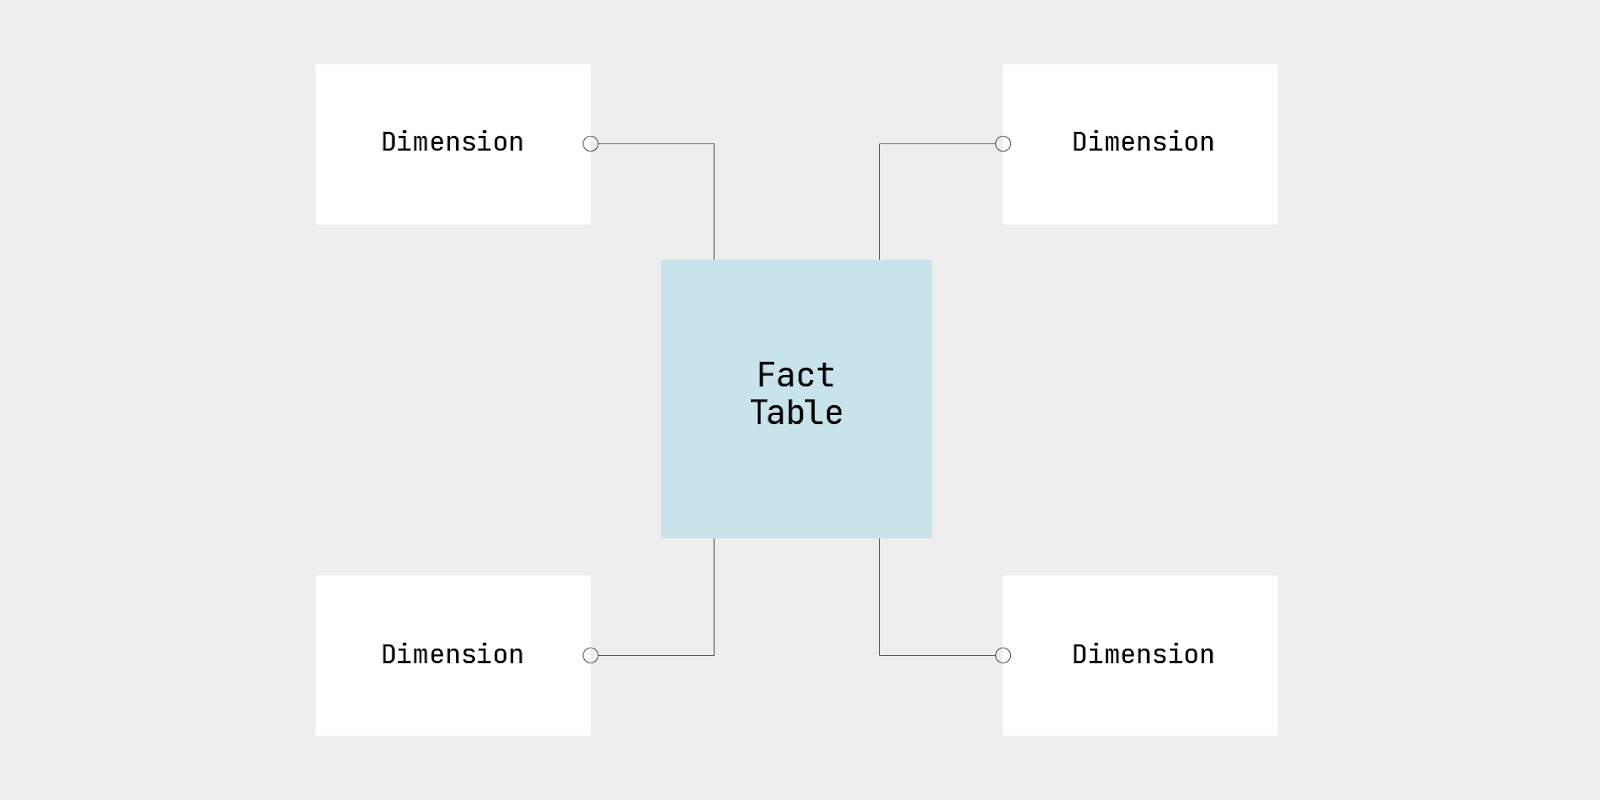
Sterrenschema. Afbeelding door de auteur.
Een snowflake-schema lijkt op een sterrenschema. Het heeft een centrale feitentabel die is verbonden met meerdere dimensietabellen, maar er is een klein verschil. In het snowflake-schema zijn niet alle dimensies vlak—elke dimensietabel is verder genormaliseerd in meerdere gerelateerde tabellen. Dit betekent dat elke dimensietabel wordt opgedeeld in kleinere, samenhangende tabellen.
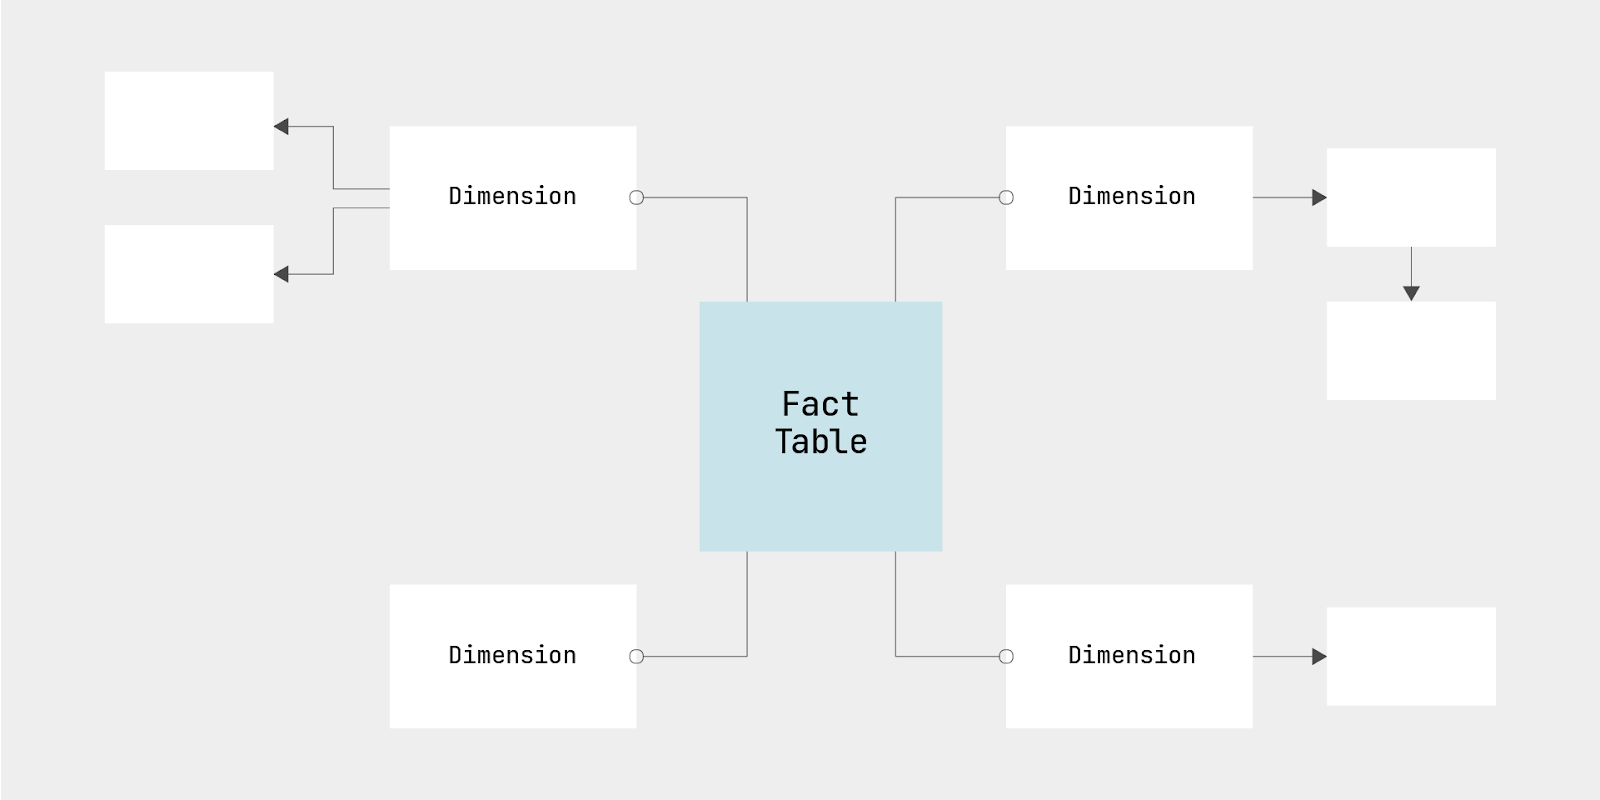
Snowflake-schema. Afbeelding door de auteur
Dit schema is het best geschikt voor objectgeoriënteerde programmeertalen die data over objecten waardevoller vinden dan logica en functies. In een relationeel databaseschema krijgt elk object zijn eigen tabel, en deze tabellen zijn allemaal met elkaar verbonden.
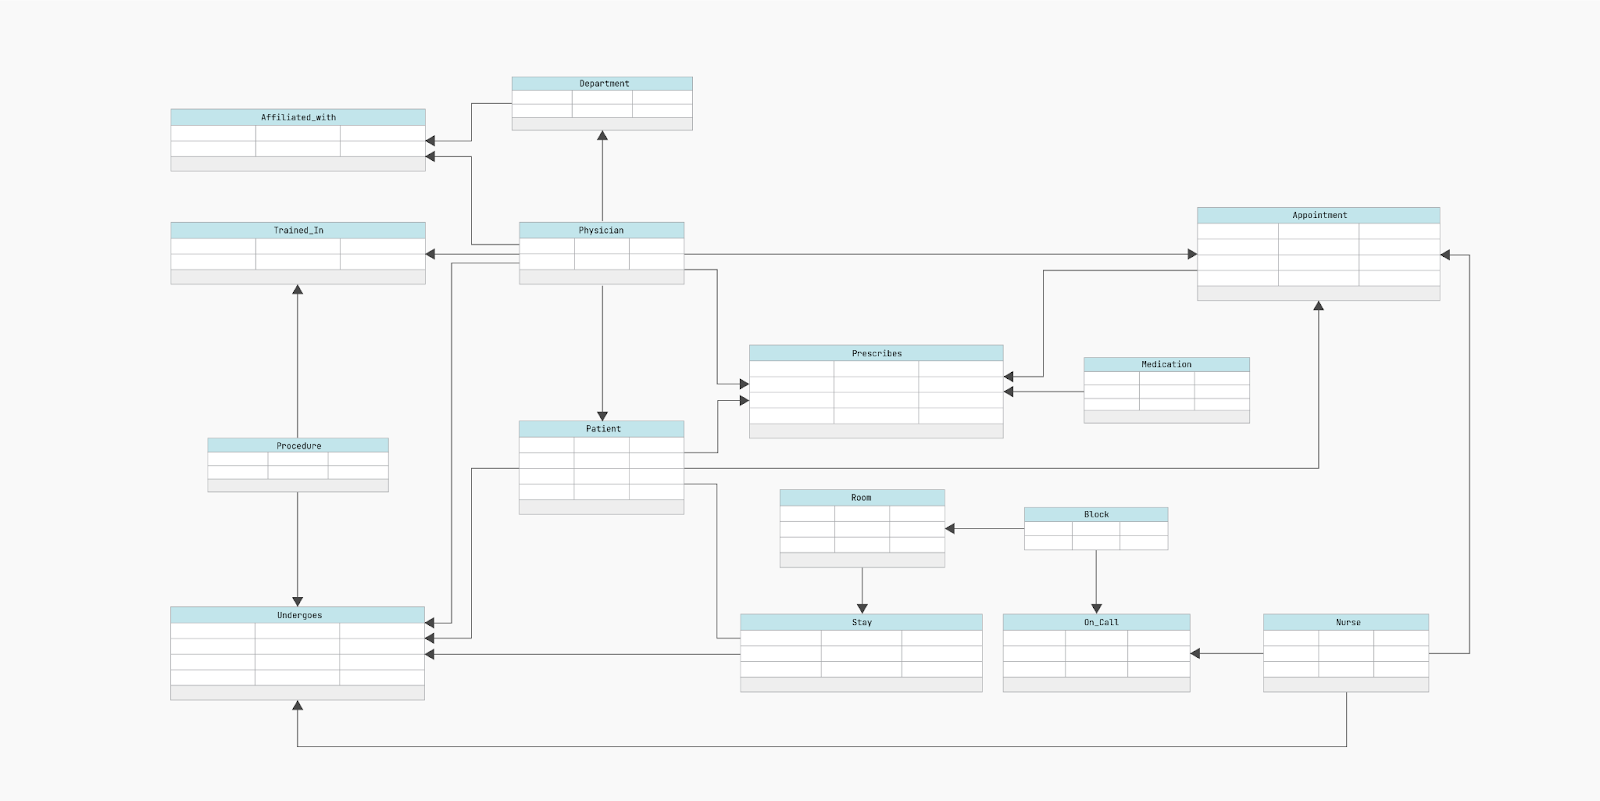
Relationeel databasemodel. Afbeelding door de auteur.
Zo heeft een e-commercedatabase tabellen met producten, klanten, bestellingen en reviews—allemaal gerelateerd. In tegenstelling tot het sterren- of snowflake-schema is er geen centrale feitentabel. In plaats daarvan zijn er flexibele relaties tussen objecten om de efficiëntie in het beheren en ophalen van data te vergroten.
In dit schema is er één root-tabel die verbonden is met meerdere child-tabellen waarbij elke child precies één parent heeft.
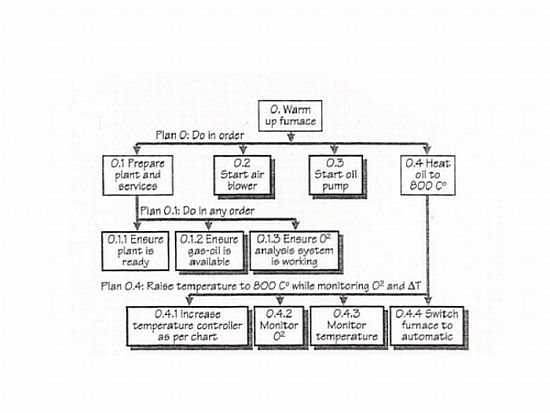
Hiërarchisch model van een databaseschema. Bron: Wikipedia
In een universiteitssysteem kan een root-tabel bijvoorbeeld afdelingen bevatten, waarbij elke afdeling is gekoppeld aan child-tabellen voor docenten en cursussen. Docenten kunnen tot slechts één afdeling behoren, maar cursussen worden toegewezen aan een specifieke docent. De structuur maakt het eenvoudiger om vaak gebruikte data te benaderen, zoals roosters en docentgegevens.
Databaseschema’s verbeteren de algehele systeemprestaties en -beveiliging door relaties, constraints en dataopslag duidelijk te definiëren. Dit zijn enkele belangrijke voordelen van goed ontworpen databaseschema’s:
De volgende stappen horen bij het ontwerpen van een schema voor een database.
Om een goede database te ontwerpen, bepaal je eerst het primaire doel: welke data deze bevat en wie hem gebruikt. Betrek stakeholders om gedetailleerde vereisten op te halen, inclusief de specifieke data die nodig is, het type queries dat erop wordt uitgevoerd en de vereiste rapportages. Zo krijg je een duidelijke projectscope en zorg je dat de database aan de gebruikersbehoeften voldoet zonder onnodige complexiteit.
Nu je de vereisten kent, maak je een conceptueel overzicht of model van je database. Dat kan met een Entity Relationship Diagram (ERD), dat illustreert hoe tabellen of entiteiten binnen een databaseschema zich tot elkaar verhouden.
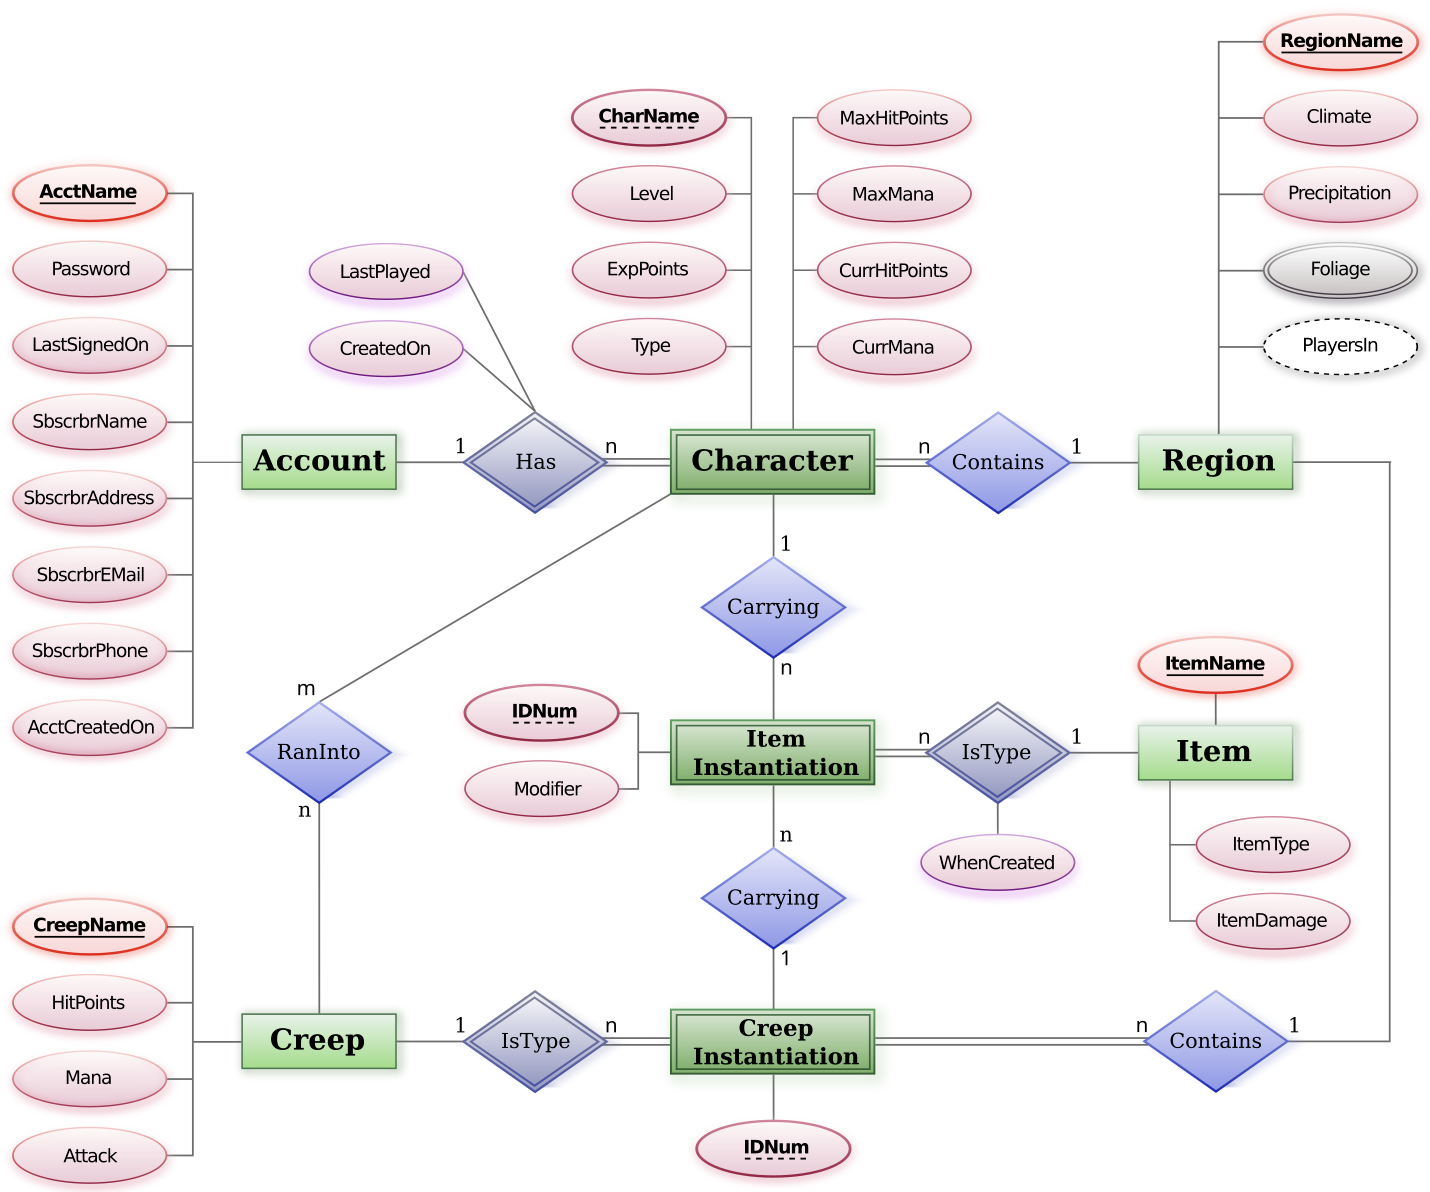
Voorbeeld van een entity-relationshipdiagram. Bron: Wikimedia Commons
Er zijn drie soorten relaties tussen entiteiten:
Organiseer vervolgens je data in tabellen. Maak voor elke entiteit binnen je database een tabel en geef de kolommen aan die elk attribuut van die entiteiten bevatten. Voorzie elke tabel van een primaire sleutel zodat elk record een unieke identifier heeft en data eenvoudig kan worden opgehaald.
Normalisatie optimaliseert de data in je database door redundantie te verminderen en de integriteit te verbeteren. Er zijn meerdere normal forms (1NF, 2NF, 3NF, BCNF en meer), maar je zou moeten normaliseren tot en met de derde normaalvorm (3NF).
Bekijk hier de drie normalisatievormen en hun doel:
Normalisatie in databases. Afbeelding door de auteur
Definieer voor robuuste databasebeveiliging duidelijk wie toegang heeft tot de database en specificeer hun rechten, zoals lees-, schrijf- of verwijderrechten. Zo beperk je de toegang tot alleen geautoriseerde gebruikers en voorkom je dat onbevoegden gevoelige data bekijken of wijzigen. Bovendien versterkt het versleutelen van gevoelige data, zowel in rust als tijdens transport, de beveiliging door de informatie te versleutelen, zodat deze onleesbaar is, zelfs als deze door onbevoegden wordt onderschept.
Bij het beschrijven van het databaseontwerp moeten de naamgevingsconventies voor tabellen, kolommen, indexen en andere objecten consistent zijn. Namen moeten beschrijvend genoeg zijn om aan te geven wat er precies in een tabel of kolom staat, zodat gebruikers dit snel en moeiteloos begrijpen. Zo voorkom je mogelijke conflicten tijdens databasehandelingen door jou of andere teamleden.
Als je alles hebt afgerond, test je het schema grondig met voorbeelddata om bewerkingen en queries uit te voeren en de prestaties te beoordelen. Op basis van de feedback uit deze testfase verfijn en pas je het schema waar nodig aan. Zo identificeer en verhelp je potentiële problemen en zorg je dat je databaseschema efficiënt is.
Een goed ontworpen schema is de basis voor een efficiënt databasesysteem. Het ontwerpen van een goed schema kent echter ook diverse uitdagingen. Laten we ernaar kijken, inclusief de oplossingen.
Wanneer relaties tussen tabellen niet duidelijk zijn gedefinieerd, worden gestructureerde queries erg complex. Dit maakt de uitvoering trager en beïnvloedt de algehele performance van de applicatie. Bijvoorbeeld: verweesde records en gebrek aan consistente data-updates leiden tot onnauwkeurigheden en kwaliteitsproblemen. Om dit te voorkomen, kun je geavanceerde modelleringshulpmiddelen zoals graph-databases inzetten om transparante en efficiënte relatierestructuren te definiëren en complexe relaties effectiever te beheren.
Databases zijn kwetsbaar voor SQL-injectie en datalekken, die gevoelige informatie kunnen compromitteren. Houd je data veilig met meerlaagse beveiligingsstrategieën, waaronder geavanceerde data-encryptiemethoden en AI-gebaseerde systemen voor anomaliedetectie. Dit helpt potentiële bedreigingen te identificeren en te beperken. Voer daarnaast regelmatig security-audits uit om mogelijke bedreigingen te monitoren, als die er zijn.
Verschillende niveaus van normalisatie beïnvloeden queryprestaties en maken onderhoud complexer. Over-normalisatie kan leiden tot complexe joins, terwijl onder-normalisatie data-anomalieën kan veroorzaken. Los dit op met flexibele normalisatiestrategieën op basis van patronen in datatoegang. Gebruik refactoringtools voor databases om de huidige staat van normalisatie regelmatig te beoordelen en, indien nodig, het normalisatieniveau aan te passen. Zo behaal je optimale prestaties door een balans te vinden tussen genormaliseerde en gede-normaliseerde structuren.
Zonder duidelijke documentatie kunnen wijzigingen aan het databaseschema risicovol en tijdrovend worden. Update de documentatie daarom regelmatig om te garanderen dat deze accuraat is en synchroon loopt met de nieuwste databasestructuren.
Slechte indexering kan leiden tot trage queryprestaties en schrijfoperaties beïnvloeden. Zonder goede indexen kost zoeken in de database veel tijd. Gebruik om dit aan te pakken geautomatiseerde indexeringstools, zoals de query store, om querypatronen te analyseren en indexaanmaak voorspellend te optimaliseren. Deze tools hebben machinelearning-algoritmen die indexen aanpassen op basis van gebruikspatronen.
Een goed gestructureerd databaseschema waarborgt dataintegriteit en ondersteunt schaalbaarheid door een solide raamwerk te bieden voor het omgaan met groeiende datavolumes en complexiteit.
DataCamp heeft meerdere uitstekende cursussen om je hierbij te helpen als je je vaardigheden wilt uitbreiden. Onze tutorial Managing Databases in PostgreSQL biedt praktische inzichten in PostgreSQL, een van de krachtigste open-sourcedatabasesystemen. Onze tutorial Using PostgreSQL in Python overbrugt de kloof tussen databasemanagement en programmeren. Ben je databasebeheerder, start dan met onze skill track SQL for Database Administrators. Wie geïnteresseerd is in datapreparatie, kan onze cursus Cleaning Data in PostgreSQL Databases bekijken.
Leer met DataCamp
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min


