Cours
Modélisation des données dans Power BI
3 h
99.6K
Un schéma de base de données est le plan de la structure et des relations au sein d’une base. Il précise comment les données sont organisées en tables, en champs, en types de données et comment ces éléments sont reliés. Voici ses composants clés et leur contribution au schéma global :
Un schéma bien conçu garantit l’exactitude des données, optimise les performances des requêtes et permet à votre base de données d’accompagner la croissance de l’entreprise.
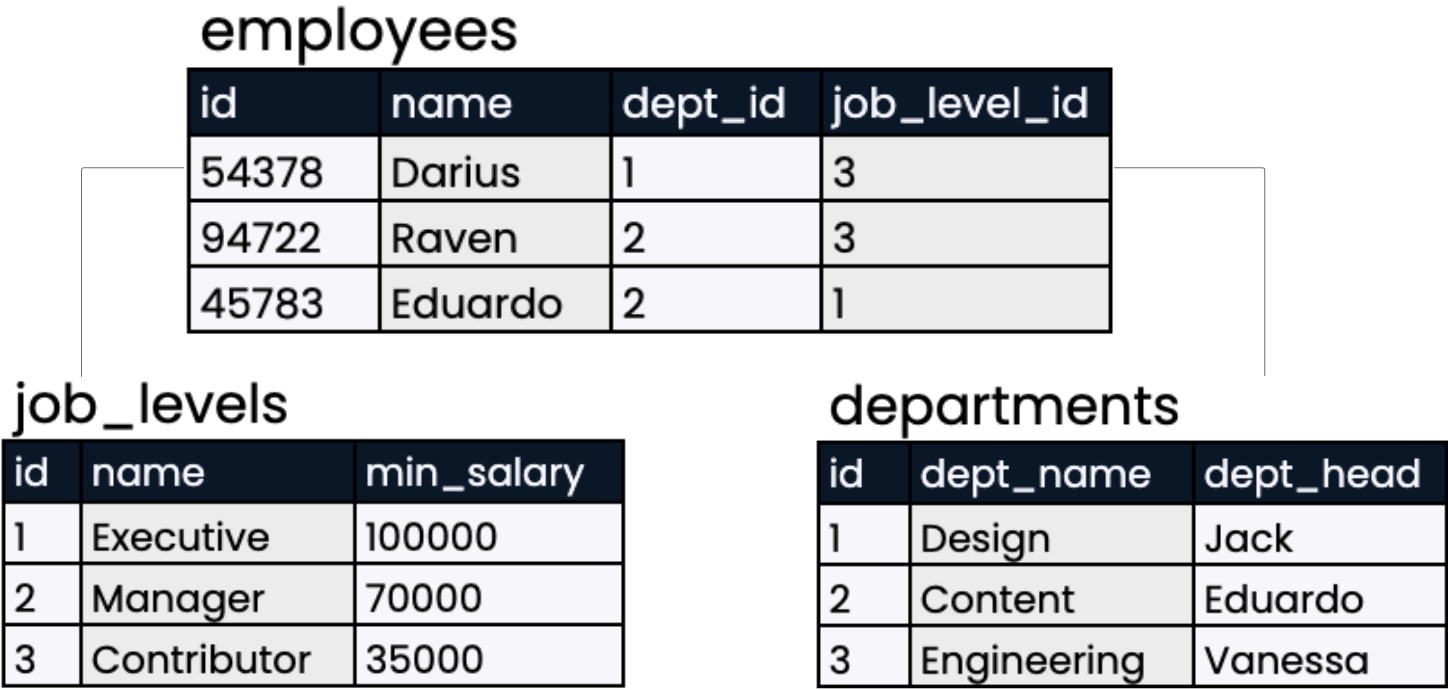
Organisation des données en tables. Image de l’auteur
À quoi ressemble un schéma bien conçu ? Retenez l’essentiel :
Il existe plusieurs types de schémas, chacun répondant à des objectifs différents et à des niveaux d’organisation variés. Parfois, on parle de schémas de manière générale pour décrire la structure d’une base ; d’autres fois, il s’agit d’éléments architecturaux précis et de détails de conception. À un niveau d’abstraction élevé, on distingue trois catégories : conceptuel, logique et physique.
Le schéma conceptuel offre une vue d’ensemble du système de bases sans entrer dans les détails d’implémentation, comme les types de données ou les contraintes. Il aide à comprendre les flux de données au sein d’une organisation, aussi bien pour des profils techniques que non techniques.
Le schéma logique décrit la structure logique des données dans la base. Il définit l’organisation des données et les relations entre entités, sans préciser leur stockage physique. Ce type de schéma assure la cohérence et l’intégrité des données en spécifiant types de données et contraintes pour valider les entrées dès la phase de conception.
Le schéma physique décrit l’emplacement des données dans le système. Il peut couvrir l’emplacement des fichiers, les stratégies d’indexation et les formats de stockage de chaque table pour garantir des performances maximales avec de grands volumes de données.
Il n’existe pas de modèle unique pour organiser les données. Les data warehouses ont des besoins métiers différents, et requièrent donc des schémas adaptés. Parmi les styles les plus courants : le schéma en étoile, le schéma en flocon, le schéma hiérarchique et le schéma relationnel.
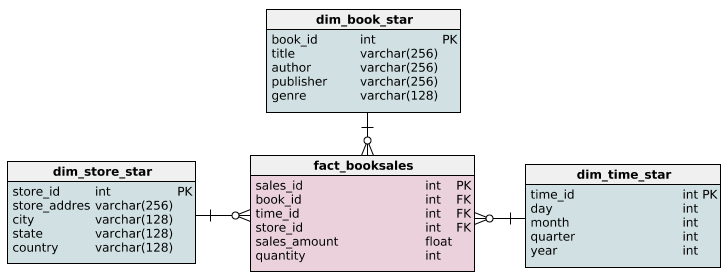
Le schéma en étoile organise et gère de grands jeux de données autour de deux principes essentiels : les faits et les dimensions. Les faits représentent des opérations métier (chiffre d’affaires, volumes de transactions, etc.). Les dimensions apportent le contexte descriptif à ces faits : temps, lieu, caractéristiques produit, etc.
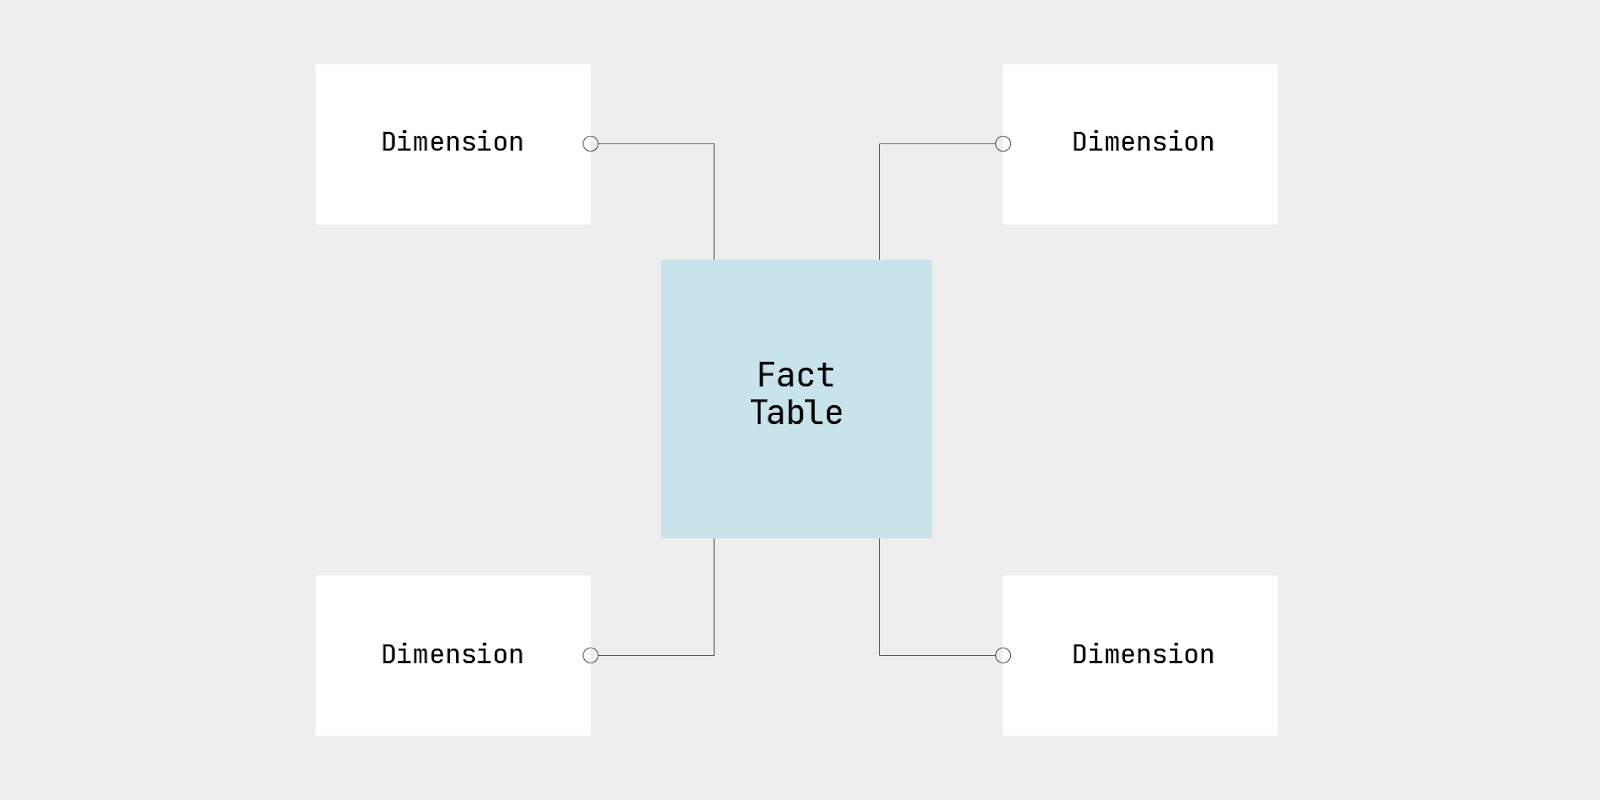
Schéma en étoile. Image de l’auteur.
Le schéma en flocon est proche du schéma en étoile, avec une table des faits centrale reliée à plusieurs tables de dimensions, mais avec une différence : les dimensions ne sont pas « plates ». Chaque table de dimension est normalisée en plusieurs tables liées. Autrement dit, chaque dimension est découpée en tables plus petites et associées.
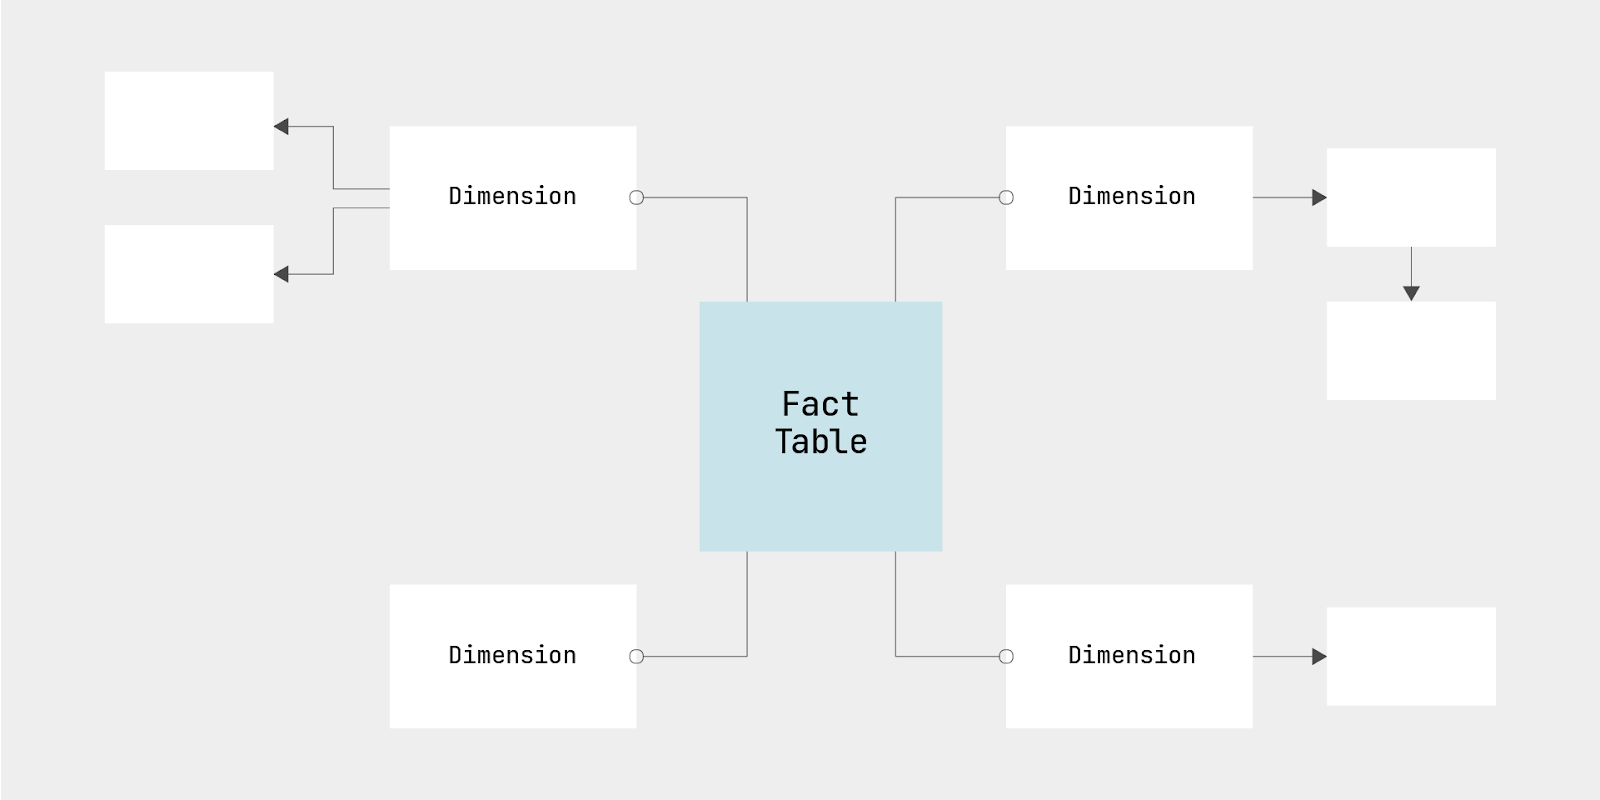
Schéma en flocon. Image de l’auteur
Ce schéma convient particulièrement aux langages orientés objet, où les données sur les objets priment sur la logique et les fonctions. Dans un schéma de base relationnelle, chaque objet dispose de sa table, et ces tables sont reliées entre elles.
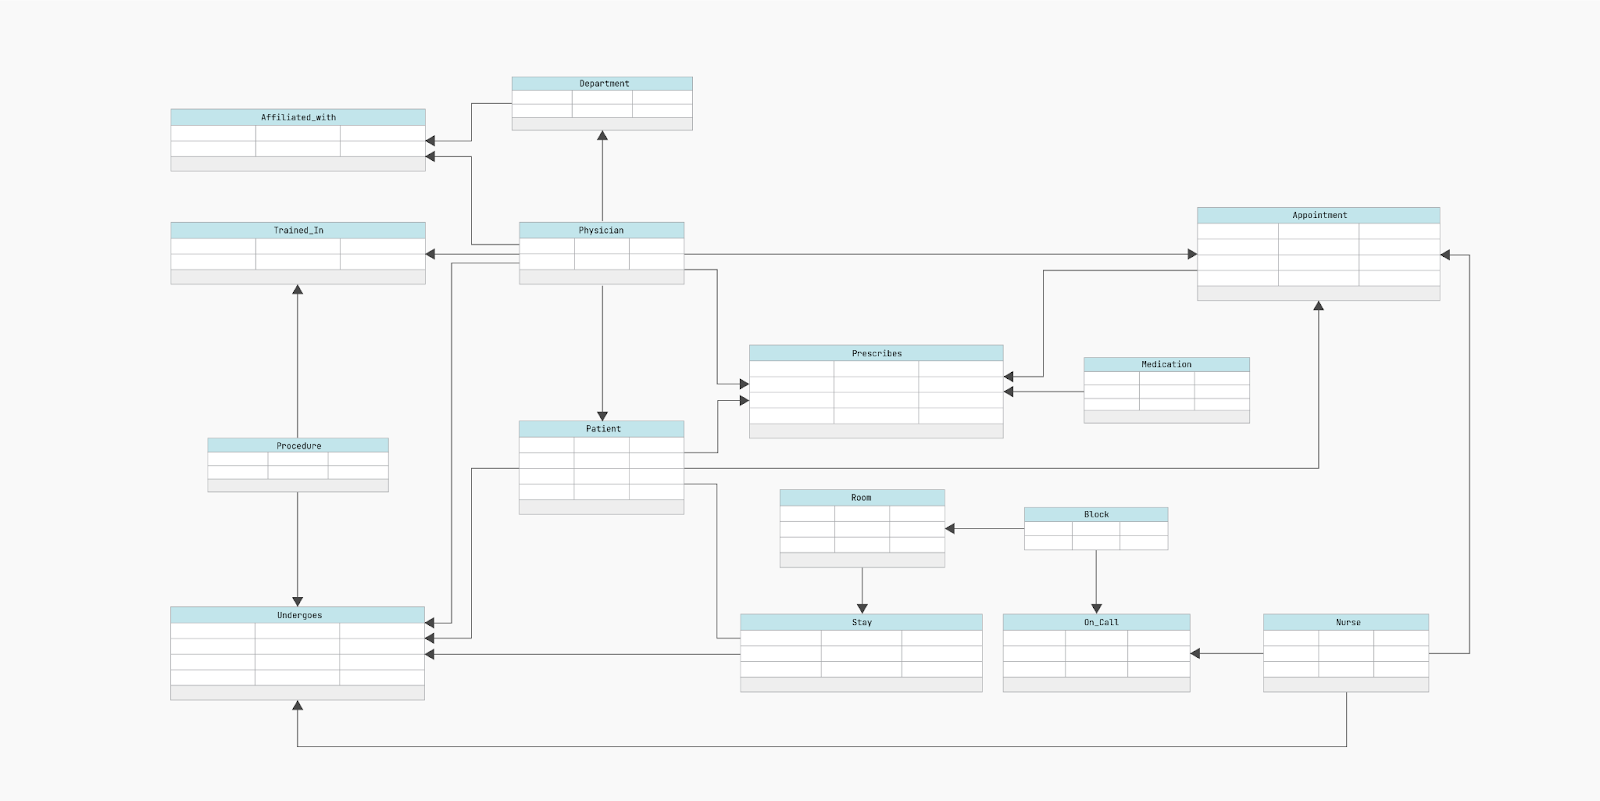
Modèle de base de données relationnelle. Image de l’auteur.
Par exemple, une base e-commerce comporte des tables Produits, Clients, Commandes et Avis—toutes liées. Contrairement aux schémas en étoile ou en flocon, il n’existe pas de table des faits centrale. On trouve plutôt des relations souples entre objets pour gagner en efficacité lors de la gestion et de la restitution des données.
Dans ce schéma, une table racine est reliée à plusieurs tables enfants, où chaque enfant n’a qu’un seul parent.
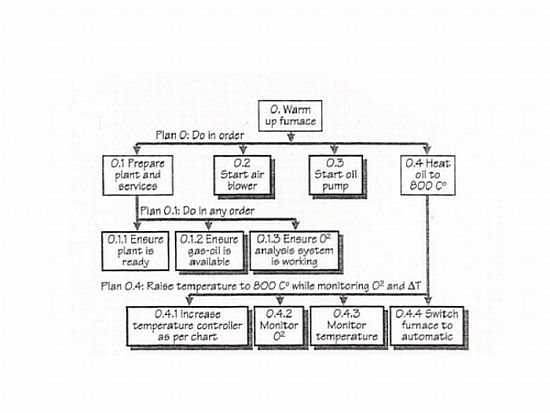
Modèle hiérarchique d’un schéma de base de données. Source : Wikipedia
Par exemple, dans un système universitaire, une table racine peut lister les départements, chacun relié à des tables enfants pour les professeurs et les cours. Un professeur n’appartient qu’à un seul département, et un cours est rattaché à un professeur précis. Cette structure facilite l’accès aux données fréquemment consultées, comme les plannings ou les fiches professeur.
Les schémas améliorent les performances et la sécurité du système en définissant clairement relations, contraintes et stockage. Voici quelques atouts clés d’un schéma bien conçu :
La conception d’un schéma suit les étapes suivantes.
Commencez par définir l’objectif principal de la base : quelles données contiendra-t-elle et qui les utilisera ? Impliquez les parties prenantes pour préciser les besoins : données requises, types de requêtes exécutées, rapports à produire. Vous obtiendrez ainsi un périmètre clair et vous assurerez que la base répondra aux usages sans complexité inutile.
Une fois les besoins clarifiés, élaborez une vision conceptuelle de la base. Utilisez pour cela un diagramme entité-association (ERD) qui illustre les relations entre tables (ou entités) dans le schéma.
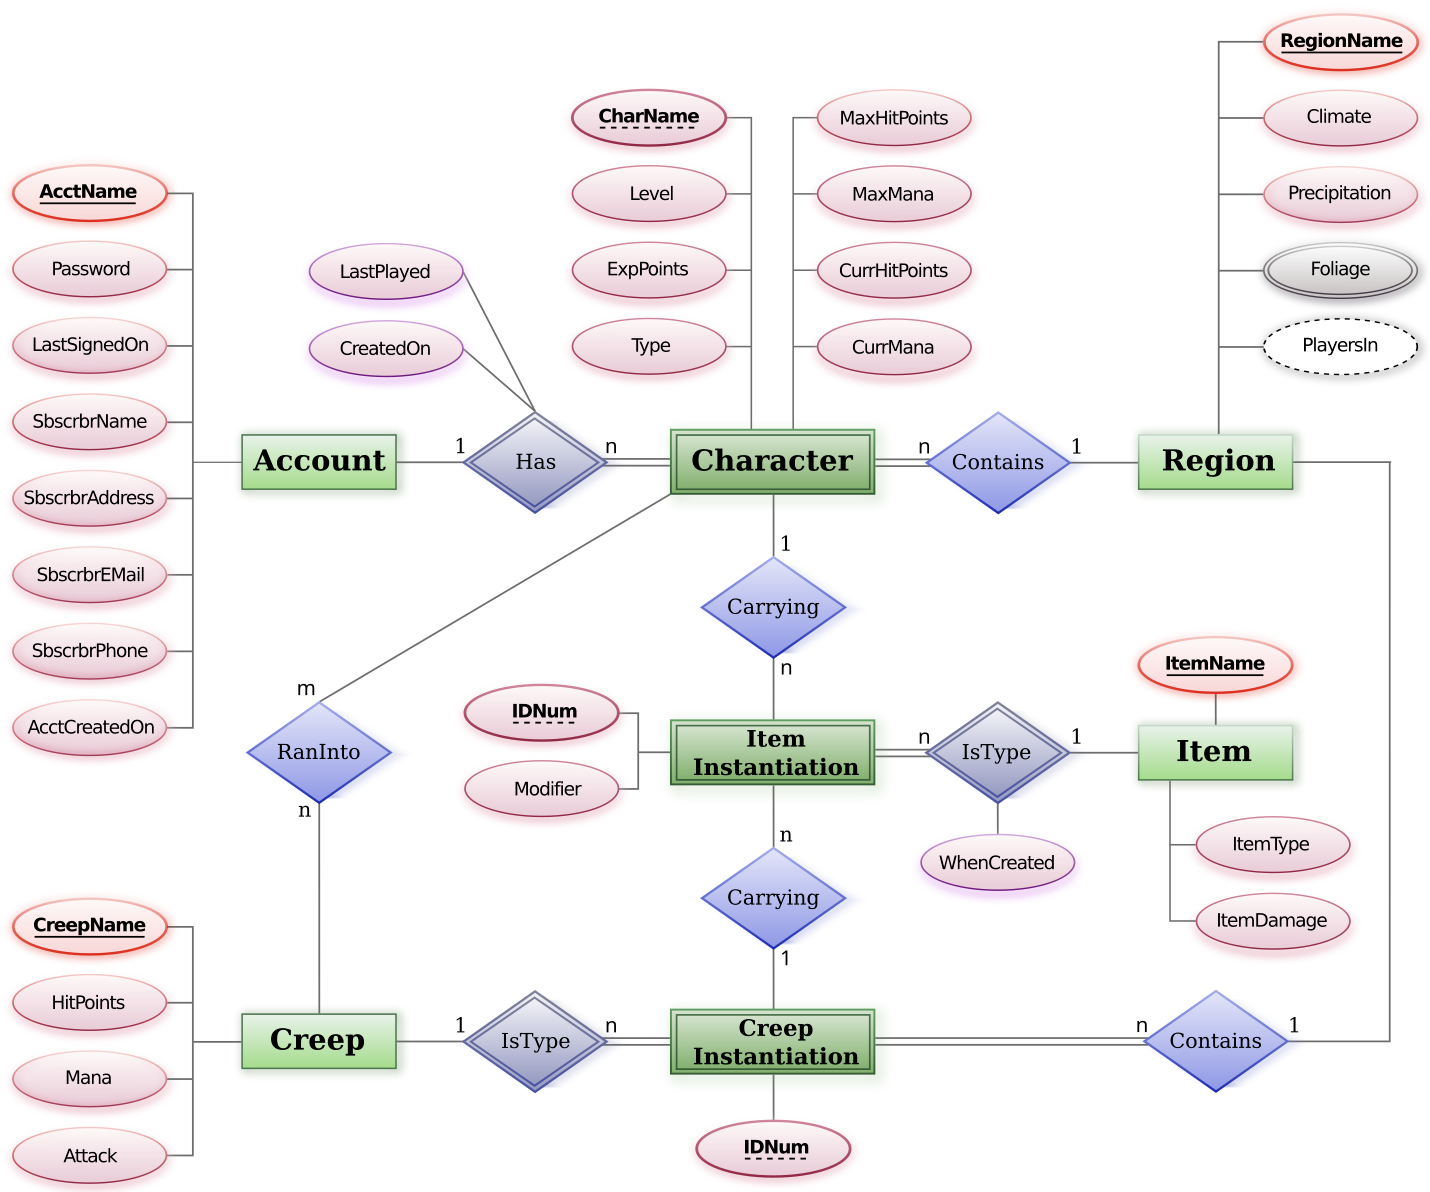
Exemple de diagramme entité-association. Source : Wikimedia Commons
On distingue trois types de relations entre entités :
Organisez ensuite vos données en tables. Créez une table pour chaque entité et définissez les colonnes correspondant aux attributs de ces entités. Attribuez une clé primaire à chaque table pour identifier chaque enregistrement de façon unique et faciliter la recherche.
La normalisation optimise les données en réduisant les redondances et en améliorant l’intégrité. Plusieurs formes normales existent (1NF, 2NF, 3NF, BCNF, etc.), mais il est recommandé d’aller au moins jusqu’à la troisième forme normale (3NF).
Voici les trois premières formes normales et leur objectif :
Normalisation en base de données. Image de l’auteur
Pour une sécurité robuste, définissez clairement qui peut accéder à la base et leurs permissions (lecture, écriture, suppression). Vous limiterez ainsi l’accès aux seuls utilisateurs autorisés et éviterez toute consultation ou modification non souhaitée de données sensibles. Chiffrez par ailleurs les données sensibles au repos et en transit pour les rendre illisibles en cas d’interception.
Lors de la description de la conception—tables, colonnes, index et autres objets—les conventions de nommage doivent être cohérentes. Les noms doivent être suffisamment explicites pour indiquer le contenu d’une table ou d’une colonne et être compris rapidement par les utilisateurs. Cela évitera les conflits lors des opérations sur la base.
Une fois l’ensemble prêt, testez le schéma de manière approfondie avec des données d’exemple pour exécuter opérations et requêtes et en évaluer les performances. Sur la base des retours, affinez et ajustez le schéma si nécessaire. Vous identifierez ainsi les problèmes potentiels et garantirez l’efficacité de votre schéma.
Un schéma bien conçu est la base d’un système de base de données performant. Sa conception peut toutefois soulever plusieurs défis. Voici les principaux et comment les adresser.
Quand les relations entre tables sont mal définies, les requêtes structurées deviennent complexes, ralentissent l’exécution et dégradent les performances de l’application. Par exemple, des enregistrements orphelins et un manque de cohérence lors des mises à jour entraînent des inexactitudes et des problèmes de qualité des données. Pour éviter cela, mettez en œuvre des outils de modélisation avancés comme les bases de données de graphes afin de définir des structures relationnelles claires et efficaces et de mieux gérer les relations complexes.
Les bases sont vulnérables aux injections SQL et aux violations de données, qui peuvent exposer des informations sensibles. Pour sécuriser vos données, appliquez des stratégies de sécurité multicouches, incluant des méthodes de chiffrement avancées et des systèmes de détection d’anomalies basés sur l’IA. Ils aident à identifier et atténuer les menaces potentielles. Réalisez en complément des audits de sécurité réguliers.
Des niveaux de normalisation inadaptés affectent les performances des requêtes et compliquent la maintenance. Une sur‑normalisation peut imposer des jointures complexes, tandis qu’une sous‑normalisation engendre des anomalies. Pour y remédier, adoptez des stratégies de normalisation flexibles fondées sur les modes d’accès aux données. Utilisez des outils de refactorisation de bases pour réévaluer régulièrement l’état de la normalisation et ajuster le niveau si nécessaire. Vous équilibrerez ainsi structures normalisées et dénormalisées pour des performances optimales.
Sans documentation claire, les changements de schéma deviennent risqués et chronophages. Mettez donc la documentation à jour régulièrement afin qu’elle reste exacte et synchronisée avec les dernières structures.
Un indexage médiocre ralentit les requêtes et impacte les écritures. Sans index adaptés, les recherches prennent beaucoup de temps. Pour relever ce défi, utilisez des outils d’indexation automatisés, comme le Query Store, qui analysent les schémas de requêtes et optimisent de manière prédictive la création d’index. Ces outils s’appuient sur des algorithmes d’apprentissage automatique qui ajustent les index selon les usages.
Un schéma de base de données bien structuré préserve l’intégrité des données et facilite la montée en charge grâce à un cadre solide capable d’absorber la croissance des volumes et des cas d’usage.
Si vous souhaitez monter en compétences, DataCamp propose plusieurs excellents cours pour vous accompagner. Notre tutoriel Managing Databases in PostgreSQL offre des conseils pratiques sur PostgreSQL, l’un des systèmes open source les plus puissants. Le tutoriel Using PostgreSQL in Python fait le lien entre gestion de bases et programmation. Si vous êtes administrateur de bases de données, démarrez notre parcours de compétences SQL for Database Administrators. Enfin, pour la préparation des données, consultez notre cours Cleaning Data in PostgreSQL Databases.
Apprenez avec DataCamp
Cours
Cursus
Cours