Curso
Modelagem de dados no Power BI
3 h
101.8K
Um schema de banco de dados é o plano da estrutura e dos relacionamentos dentro de um banco. Ele especifica como os dados serão organizados em tabelas, campos, tipos de dados e como esses elementos se relacionam. Veja os principais componentes e como eles contribuem para o schema como um todo:
Um schema bem projetado garante dados corretos, desempenho otimizado nas consultas e capacidade do banco de dados de acompanhar o crescimento do negócio.
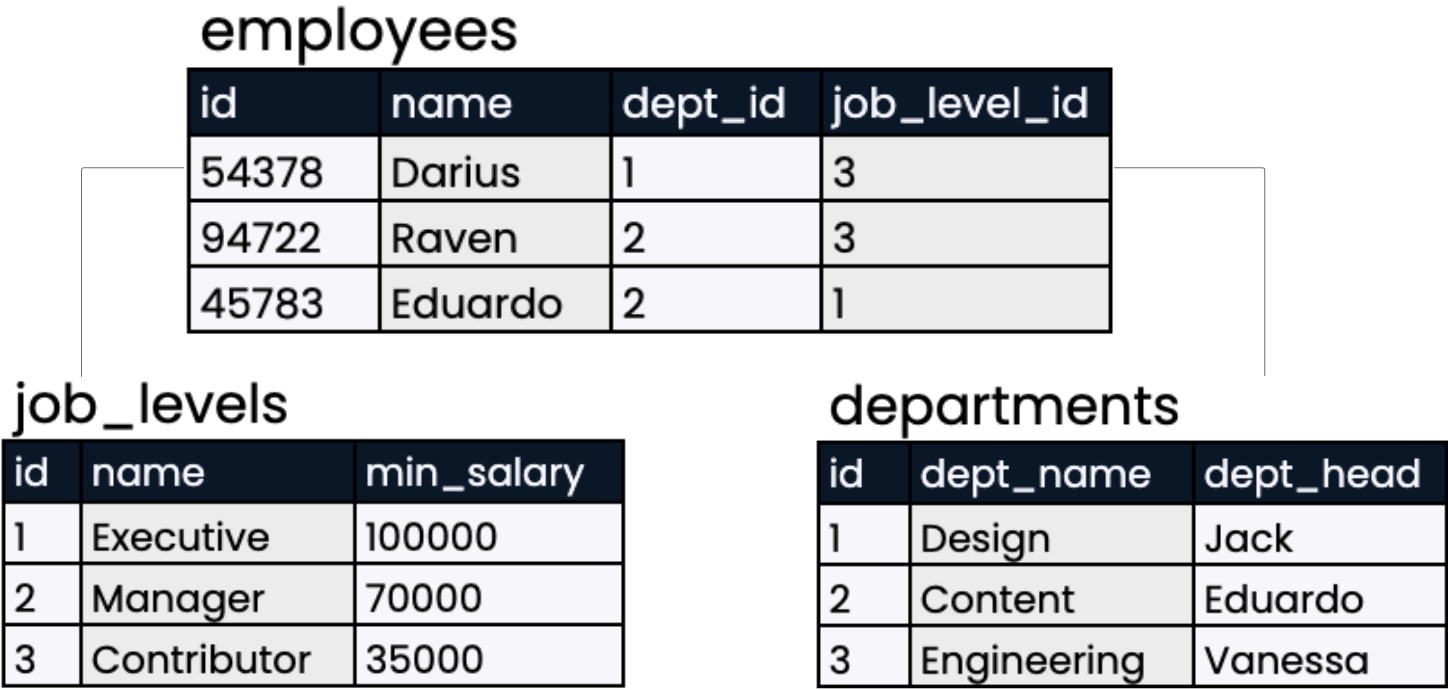
Organização de dados em tabelas. Imagem do autor
Mas como é um schema bem projetado na prática? Aqui vai o essencial:
Existem vários tipos de schemas, cada um com um propósito e um nível de organização diferentes. Às vezes o termo é usado de forma geral para descrever estruturas de banco de dados; em outras, refere-se a elementos arquiteturais específicos e detalhes de design. Em alto nível de abstração, schemas podem ser categorizados em três tipos: conceitual, lógico e físico.
O schema conceitual é um schema de alto nível que fornece uma visão geral de todo o sistema de bancos, sem mostrar detalhes de implementação como tipos de dados ou restrições. Ele ajuda a entender o fluxo de dados na organização e facilita a vida de usuários técnicos e não técnicos.
O schema lógico descreve a estrutura lógica dos dados no banco. Ele define como os dados são organizados e os relacionamentos entre as entidades, sem expor como são armazenados fisicamente. Esse tipo mantém consistência e integridade ao especificar tipos de dados e restrições para validar entradas na fase de design do banco.
O schema físico descreve onde os dados ficam no sistema. Isso abrange locais de arquivos, estratégias de indexação e formatos de armazenamento de cada tabela para garantir o máximo desempenho ao lidar com grandes volumes de dados.
Na hora de organizar dados, não existe uma única abordagem ideal. Diferentes data warehouses têm necessidades de negócio distintas e, portanto, pedem schemas diferentes. Alguns dos estilos mais usados são star schema, snowflake schema, schema hierárquico e schema relacional.
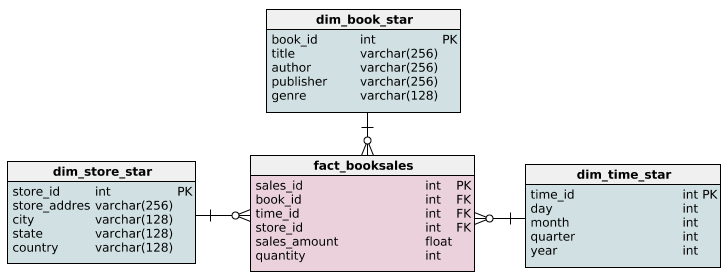
O star schema organiza e gerencia grandes conjuntos de dados com base em dois princípios essenciais: fatos e dimensões. Fatos são operações de negócio cujos direcionadores importam, como números de vendas ou volumes de transação. As dimensões enriquecem esses fatos com contexto descritivo, como tempo, localização ou detalhes do produto.
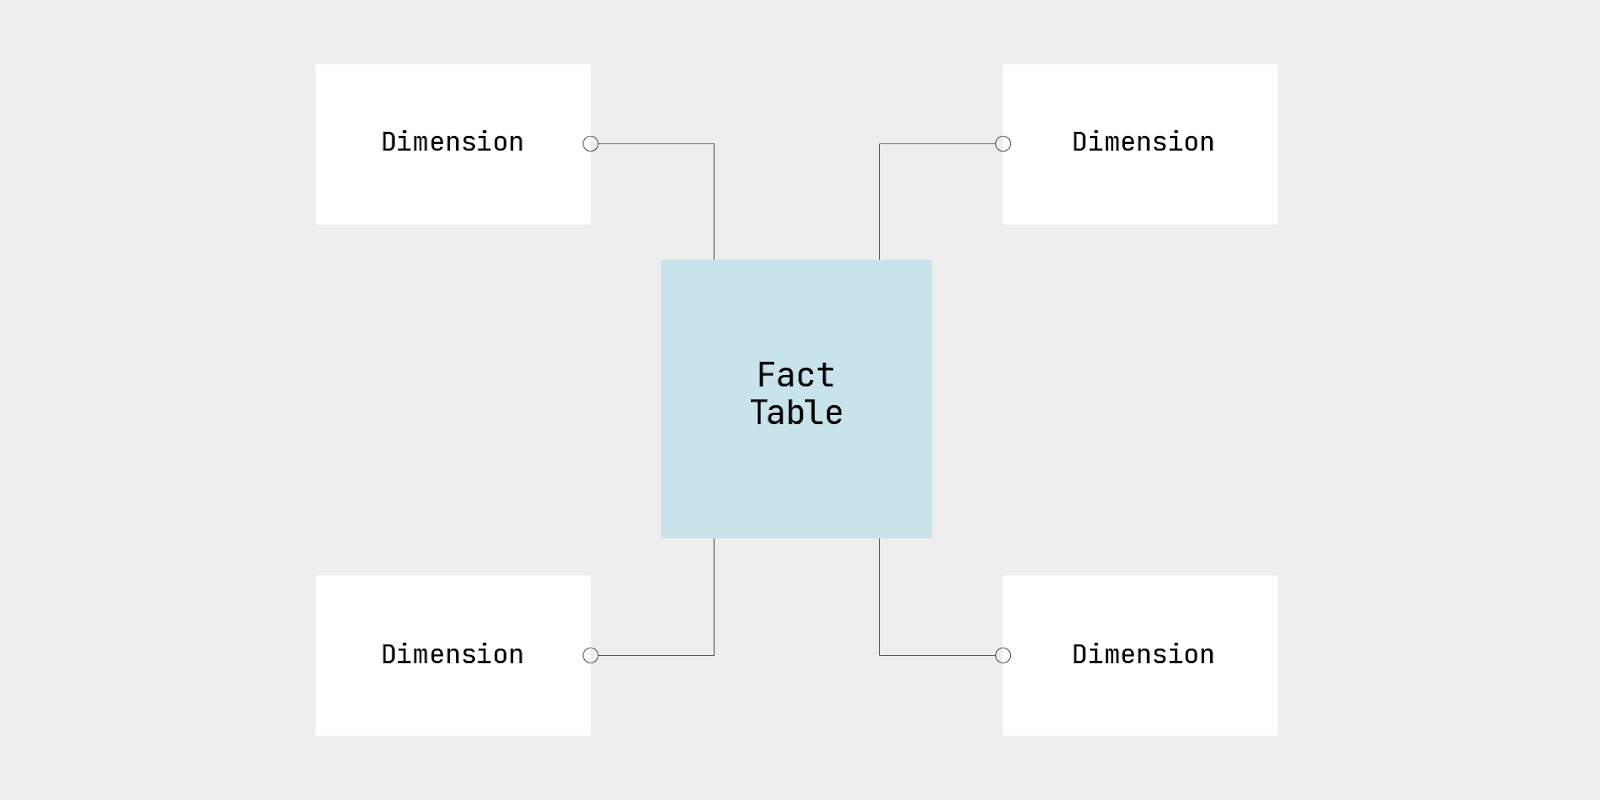
Star schema. Imagem do autor.
O snowflake schema é parecido com o star schema. Ele tem uma tabela fato central conectada a várias tabelas dimensão, mas com uma diferença: no snowflake, as dimensões não são planas — cada tabela dimensão é normalizada em várias tabelas relacionadas. Ou seja, cada dimensão é dividida em tabelas menores e associadas.
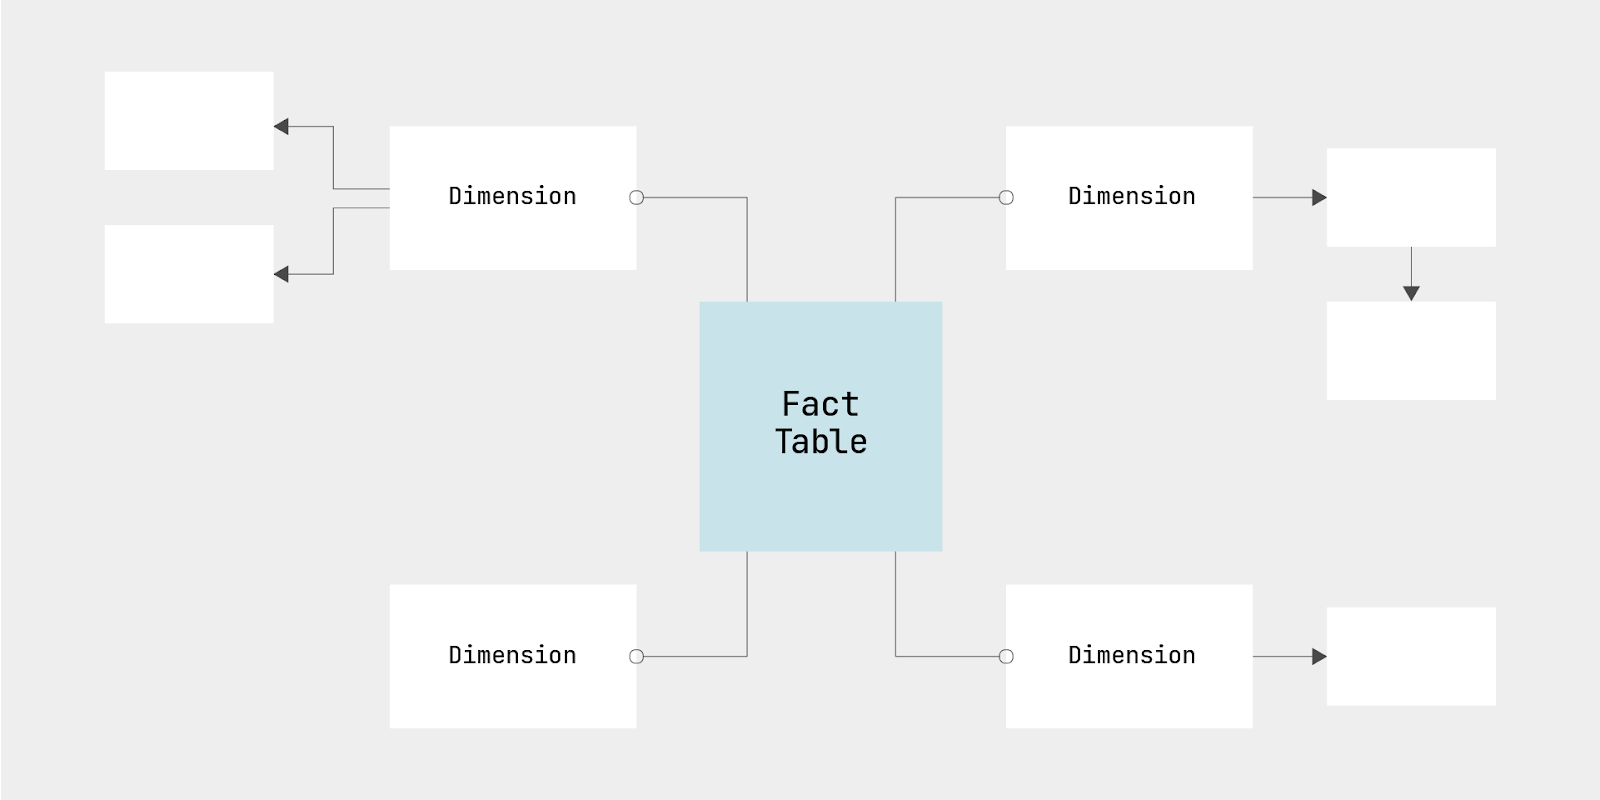
Snowflake schema. Imagem do autor
Esse schema é especialmente adequado a linguagens de programação orientadas a objetos que valorizam dados sobre objetos mais do que lógica e funções. Em um schema de banco relacional, cada objeto tem sua própria tabela, e essas tabelas se conectam entre si.
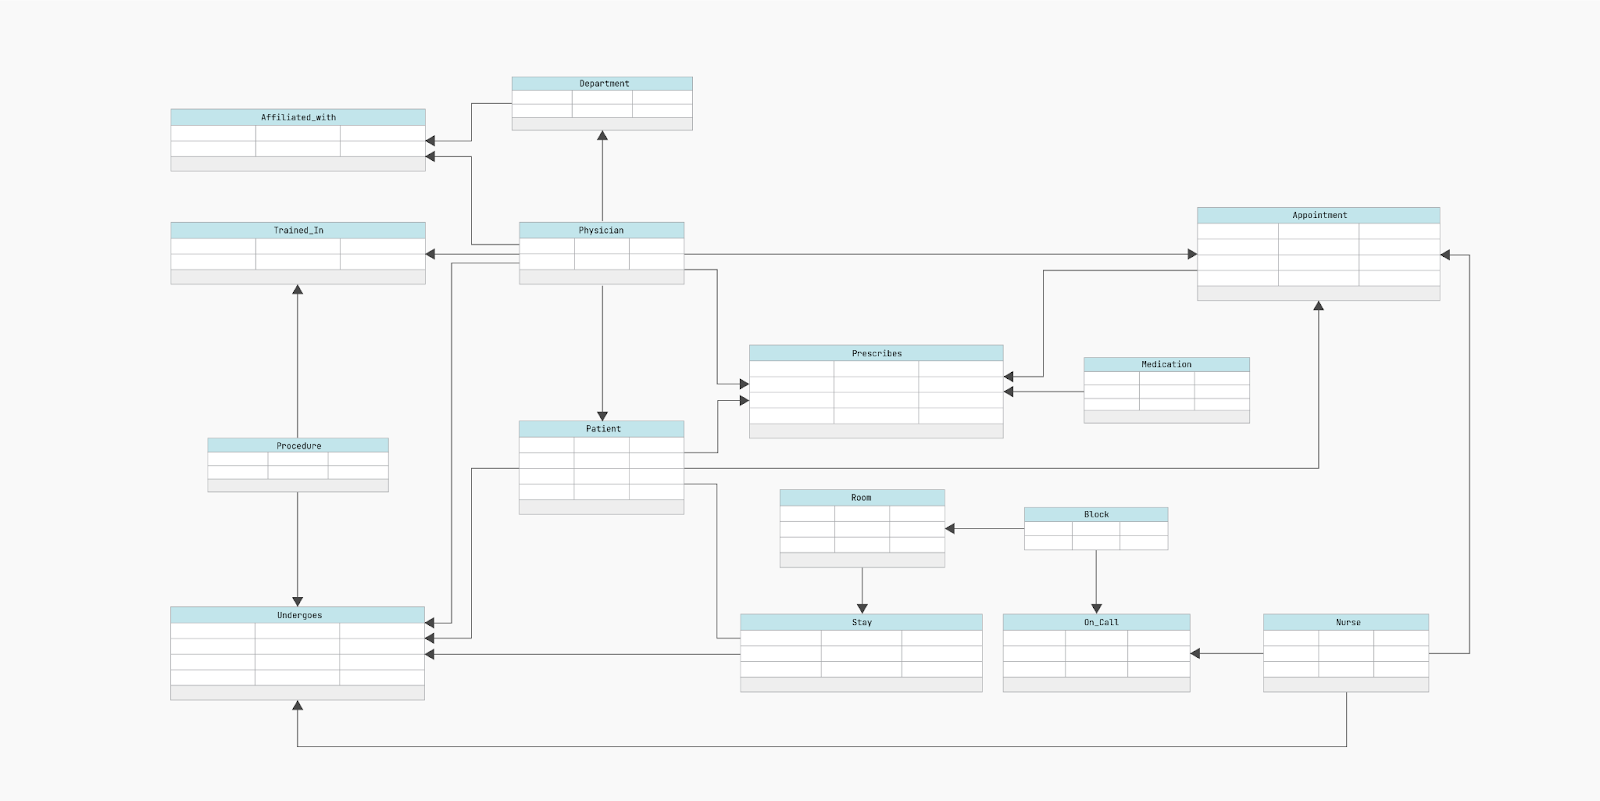
Modelo de banco de dados relacional. Imagem do autor.
Por exemplo, um banco de dados de e-commerce tem tabelas de produtos, clientes, pedidos e avaliações — todas relacionadas. Diferente do star ou do snowflake, ele não tem uma tabela fato central. Em vez disso, mantém relacionamentos flexíveis entre objetos para aumentar a eficiência na gestão e na recuperação de dados.
Nesse schema, uma tabela raiz se conecta a várias tabelas filhas, e cada filha tem exatamente um pai.
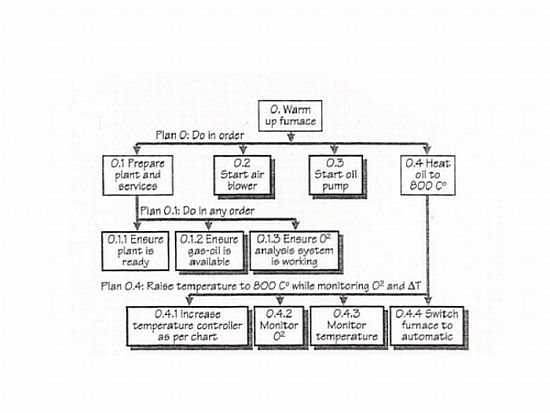
Modelo hierárquico de schema de banco de dados. Fonte: Wikipedia
Por exemplo, em um sistema universitário, uma tabela raiz poderia listar departamentos, e cada departamento se conecta a tabelas filhas de professores e disciplinas. Professores pertencem a apenas um departamento, e disciplinas são atribuídas a um professor específico. Essa estrutura facilita o acesso a dados usados com frequência, como grades de horários e dados de professores.
Schemas de banco de dados melhoram o desempenho e a segurança do sistema ao definir claramente relacionamentos, restrições e armazenamento de dados. Veja alguns dos principais ganhos de um bom design de schema:
Estas são as etapas envolvidas no design de um schema.
Para projetar um bom banco, primeiro defina seu objetivo principal: quais dados ele terá e quem vai usá-lo. Envolva as partes interessadas para coletar requisitos detalhados, incluindo quais dados são necessários, que tipos de consultas serão executadas e quais relatórios precisam ser gerados. Assim você terá um escopo claro e garante que o banco atenda às necessidades dos usuários sem complexidade desnecessária.
Com os requisitos em mãos, crie uma visão conceitual ou modelo do seu banco. Você pode usar um Diagrama Entidade-Relacionamento (ERD) para ilustrar como as tabelas ou entidades se relacionam dentro do schema.
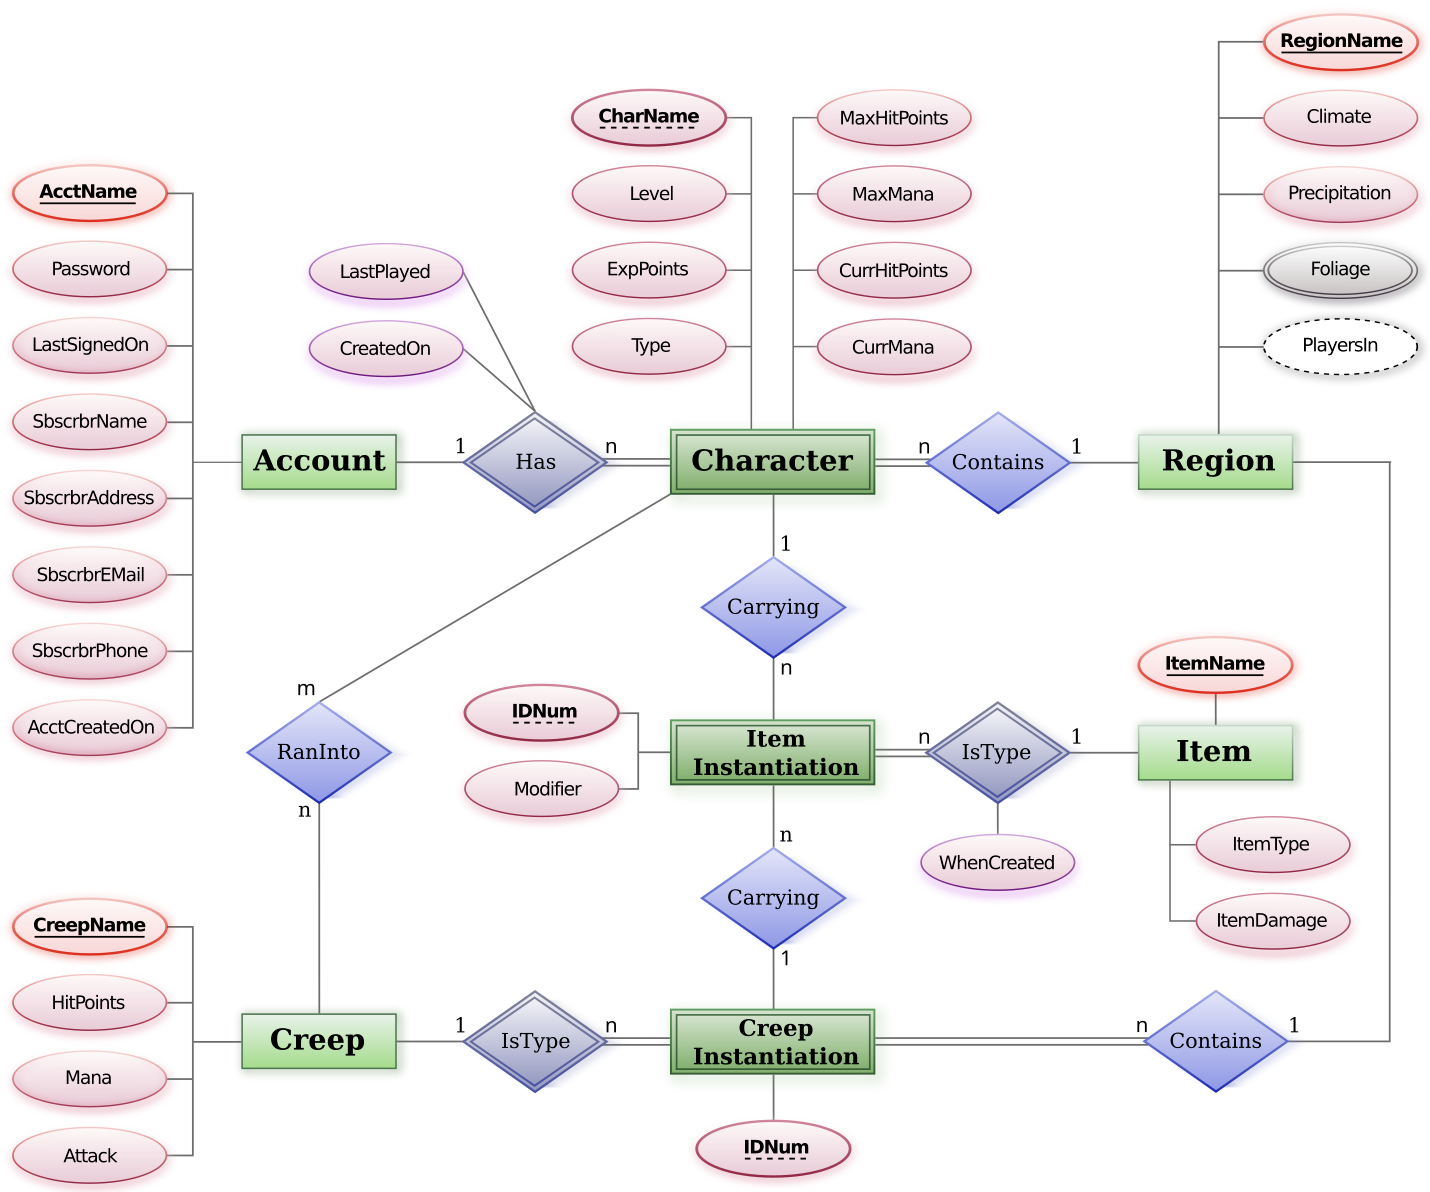
Exemplo de Diagrama Entidade-Relacionamento. Fonte: Wikimedia Commons
Há três tipos de relacionamentos entre entidades:
Em seguida, organize os dados em tabelas. Crie uma tabela para cada entidade do seu banco e defina as colunas para cada atributo relacionado a essas entidades. Atribua uma chave primária a cada tabela para que todo registro tenha um identificador único e os dados sejam facilmente recuperados.
A normalização otimiza os dados do seu banco ao reduzir redundâncias e melhorar a integridade. Existem várias formas normais (1FN, 2FN, 3FN, BCNF e outras), mas, em geral, normalize até a terceira forma normal (3FN).
Veja as três primeiras formas normais e seus objetivos:
Normalização em bancos de dados. Imagem do autor
Para garantir segurança robusta, defina claramente quem pode acessar o banco e quais permissões tem, como leitura, escrita ou exclusão. Assim, você limita o acesso a usuários autorizados e evita que pessoas não autorizadas vejam ou modifiquem dados sensíveis. Além disso, criptografar dados sensíveis em repouso e em trânsito fortalece a segurança ao embaralhar as informações, tornando-as ilegíveis mesmo se forem interceptadas por terceiros.
Ao descrever o design do banco — tabelas, colunas, índices e outros objetos — mantenha convenções de nomes consistentes. Os nomes devem ser descritivos o suficiente para indicar claramente o que há em uma tabela ou coluna, facilitando o entendimento rápido pelos usuários. Isso evita conflitos quando você ou qualquer pessoa do time executar operações no banco.
Quando tudo estiver pronto, teste o schema a fundo com dados de exemplo para executar operações e consultas e avaliar o desempenho. Com base no feedback dessa fase, refine e ajuste o schema conforme necessário. Assim, você identifica e resolve possíveis problemas e garante eficiência.
Um schema bem projetado é a base de um sistema de banco de dados eficiente. Porém, criá-lo pode trazer alguns desafios. Veja os mais comuns e como resolvê-los.
Quando os relacionamentos entre tabelas não estão claramente definidos, consultas estruturadas ficam muito complicadas. Isso torna a execução mais lenta e afeta o desempenho geral da aplicação. Por exemplo, registros órfãos e falta de consistência nas atualizações geram imprecisões e problemas de qualidade dos dados. Para evitar isso, implemente ferramentas avançadas de modelagem como bancos de dados em grafo para definir estruturas de relacionamento transparentes e eficientes e gerenciar relacionamentos complexos com mais eficácia.
Bancos de dados são vulneráveis a SQL injection e vazamentos, que podem comprometer informações sensíveis. Para manter seus dados seguros, implemente estratégias de segurança em várias camadas, incluindo criptografia avançada e sistemas de detecção de anomalias baseados em IA. Isso ajuda a identificar e mitigar ameaças em potencial. Além disso, realize auditorias de segurança regulares para monitorar possíveis riscos.
Níveis diferentes de normalização impactam o desempenho das consultas e dificultam a manutenção. O excesso de normalização pode gerar junções complexas, enquanto a falta de normalização causa anomalias. Para resolver, adote estratégias flexíveis baseadas no padrão de acesso aos dados. Use ferramentas de refatoração de bancos para revisar regularmente o estado atual e ajustar, quando necessário, o nível de normalização. Assim você equilibra estruturas normalizadas e desnormalizadas para obter desempenho ideal.
Sem documentação clara, mudanças no schema podem ser arriscadas e consumir muito tempo. Por isso, atualize a documentação regularmente para mantê-la correta e alinhada às estruturas mais recentes do banco.
Índices mal projetados levam a consultas lentas e afetam operações de escrita. Sem índices adequados, pesquisar no banco leva muito mais tempo. Para superar esse desafio, use ferramentas de indexação automática, como o Query Store, para analisar padrões de consulta e otimizar a criação de índices de forma preditiva. Essas ferramentas usam algoritmos de machine learning que ajustam os índices conforme os padrões de uso.
Um schema bem estruturado mantém a integridade dos dados e dá suporte à escalabilidade ao fornecer uma base sólida para lidar com volumes e complexidades crescentes.
Se você quer se capacitar, a DataCamp tem vários cursos excelentes para te ajudar nessa jornada. Nosso tutorial Managing Databases in PostgreSQL traz práticas essenciais de PostgreSQL, um dos SGBDs open-source mais poderosos. O tutorial Using PostgreSQL in Python faz a ponte entre gestão de bancos e programação. Se você é administrador de banco, comece nossa trilha de habilidades SQL for Database Administrators. Já quem se interessa por preparação de dados pode conferir o curso Cleaning Data in PostgreSQL Databases.
Aprenda com a DataCamp
Curso
Programa
Curso
blog
Kurtis Pykes
11 min
blog
Summer Worsley
13 min
blog
Zoumana Keita
12 min
Tutorial
DataCamp Team
3 min
Tutorial
Javier Canales Luna
15 min
Tutorial
Sejal Jaiswal
15 min