Curso
Modelado de datos en Power BI
3 h
99.6K
Un esquema de base de datos es el plano de la estructura y las relaciones dentro de una base de datos. Especifica cómo se organiza la información en tablas, campos, tipos de datos y las relaciones entre estos elementos. Veamos sus componentes clave y cómo contribuyen al esquema global:
Un esquema bien diseñado garantiza la corrección de los datos, mejora el rendimiento de las consultas y permite que tu base de datos acompañe el crecimiento del negocio.
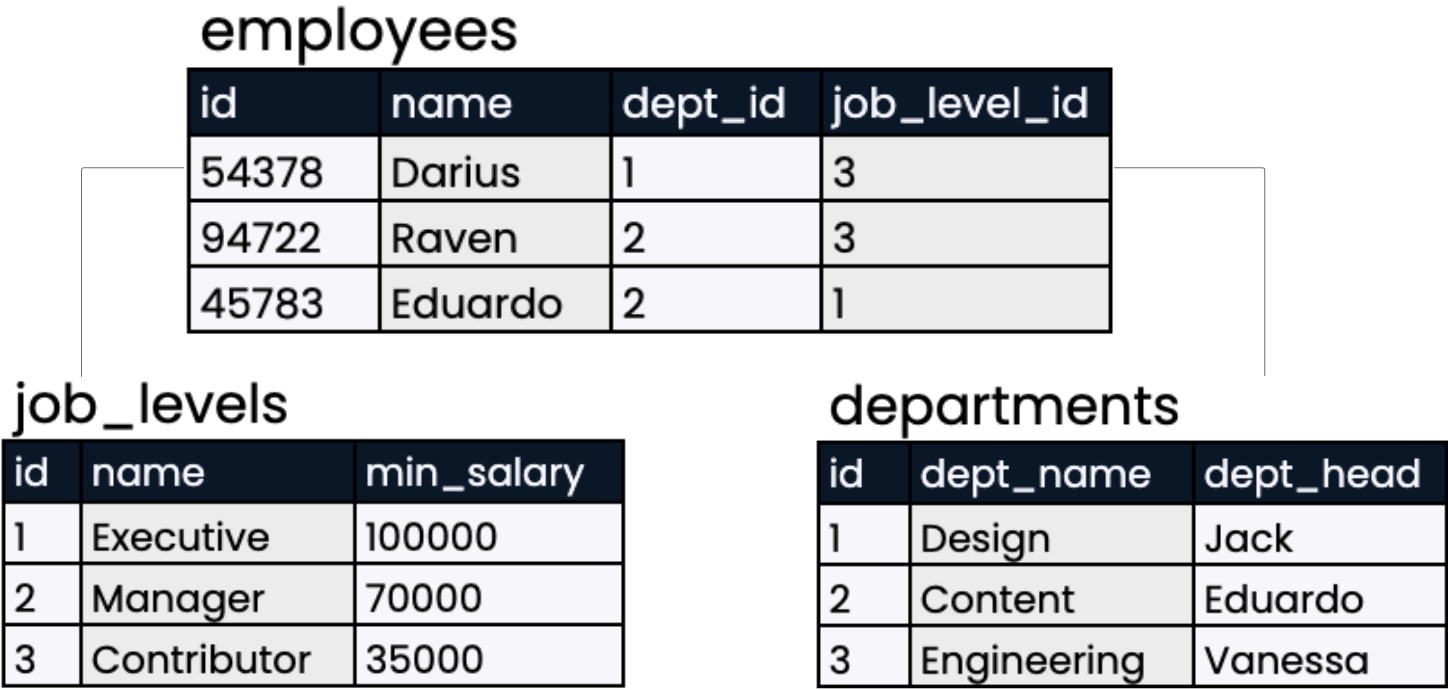
Organización de datos en tablas. Imagen del autor
Pero ¿cómo es un esquema bien diseñado? Aquí tienes lo esencial:
Existen varios tipos de esquemas de base de datos, cada uno con un propósito distinto y diferentes niveles de organización. A veces se habla de esquemas de forma general para describir estructuras de base de datos, y otras veces se refieren a elementos arquitectónicos concretos y detalles de diseño. A alto nivel, se suelen clasificar en tres tipos: conceptual, lógico y físico.
Un esquema conceptual es un esquema de alto nivel que ofrece una visión global de todo el sistema de bases de datos sin mostrar detalles de implementación, como tipos de datos o restricciones. Ayuda a entender los flujos de datos en una organización y resulta accesible tanto para perfiles técnicos como no técnicos.
El esquema lógico describe la estructura lógica de los datos en la base de datos. Define cómo se organizan los datos y las relaciones entre entidades, sin mostrar cómo se almacenan físicamente. Este tipo de esquema mantiene la consistencia e integridad de los datos al especificar tipos y restricciones para validar inserciones durante la fase de diseño.
Un esquema físico describe dónde se ubican los datos en el sistema. Incluye ubicaciones de archivos, estrategias de indexación y formatos de almacenamiento para cada tabla, con el fin de maximizar el rendimiento cuando trabajas con grandes volúmenes de datos.
No existe un enfoque único para organizar datos. Cada data warehouse tiene necesidades de negocio distintas, por lo que requiere esquemas diferentes. Entre los estilos más populares están el star schema, el snowflake schema, el esquema jerárquico y el esquema relacional.
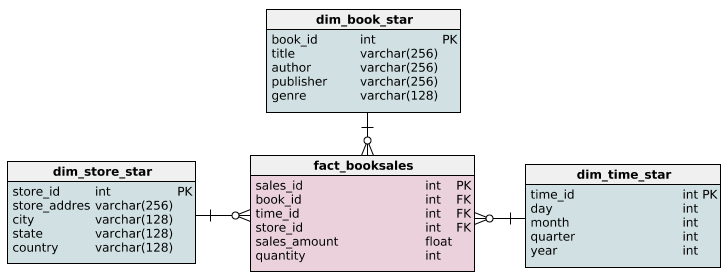
El star schema organiza y gestiona grandes conjuntos de datos en torno a dos principios esenciales: hechos y dimensiones. Los hechos representan operaciones del negocio con sus métricas clave, como ventas o volumen de transacciones. Las dimensiones aportan el contexto descriptivo: tiempo, ubicación o detalles de producto, por ejemplo.
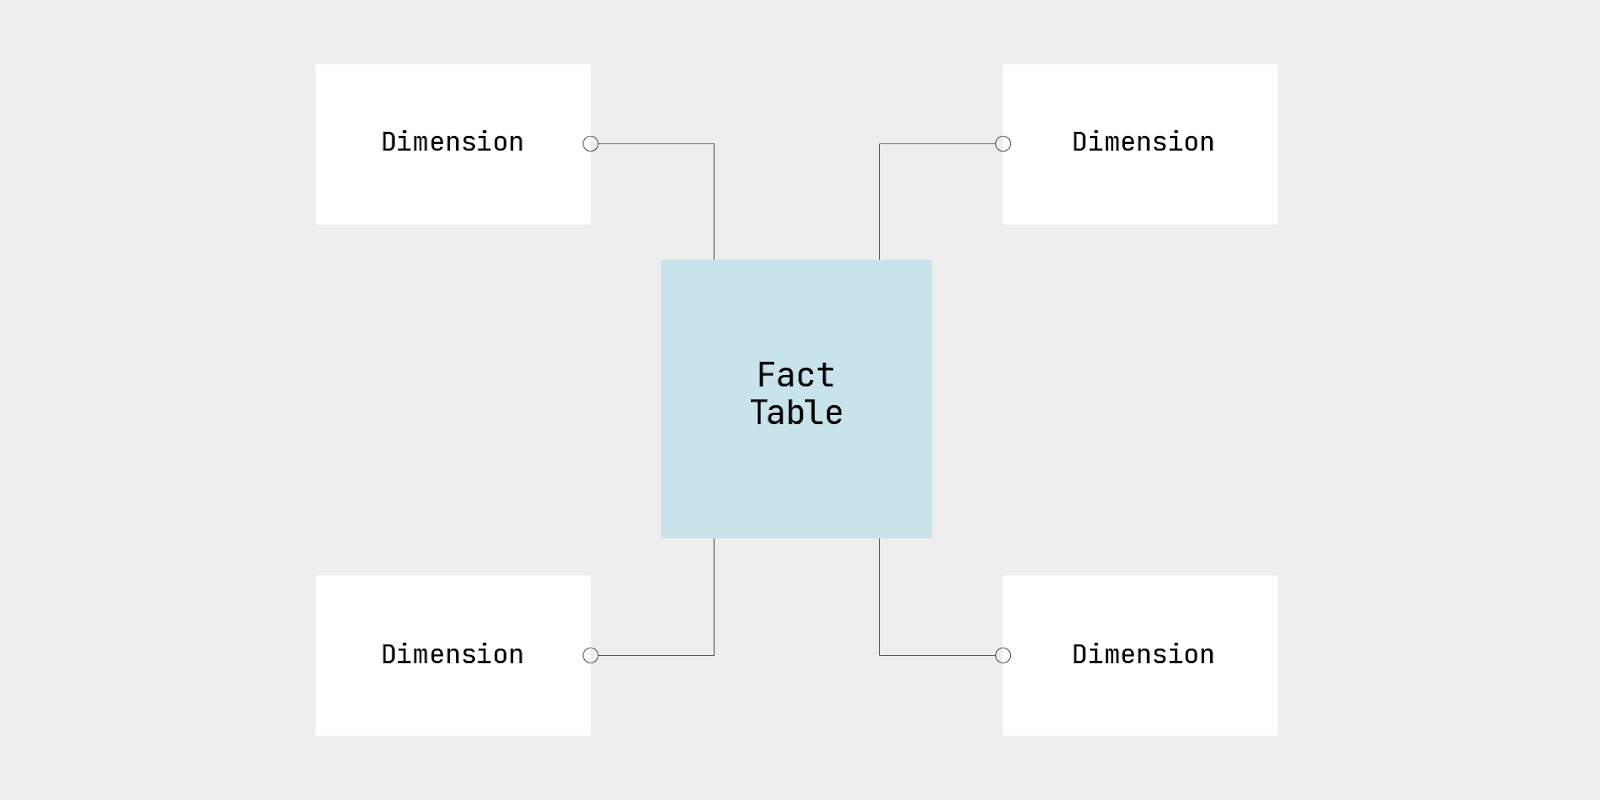
Star schema. Imagen del autor.
El snowflake schema es similar al star schema: parte de una tabla de hechos central conectada a múltiples tablas de dimensiones, pero con una diferencia. En el snowflake schema, las dimensiones no son planas: cada tabla de dimensión se normaliza en varias tablas relacionadas. Es decir, cada dimensión se divide en tablas más pequeñas asociadas entre sí.
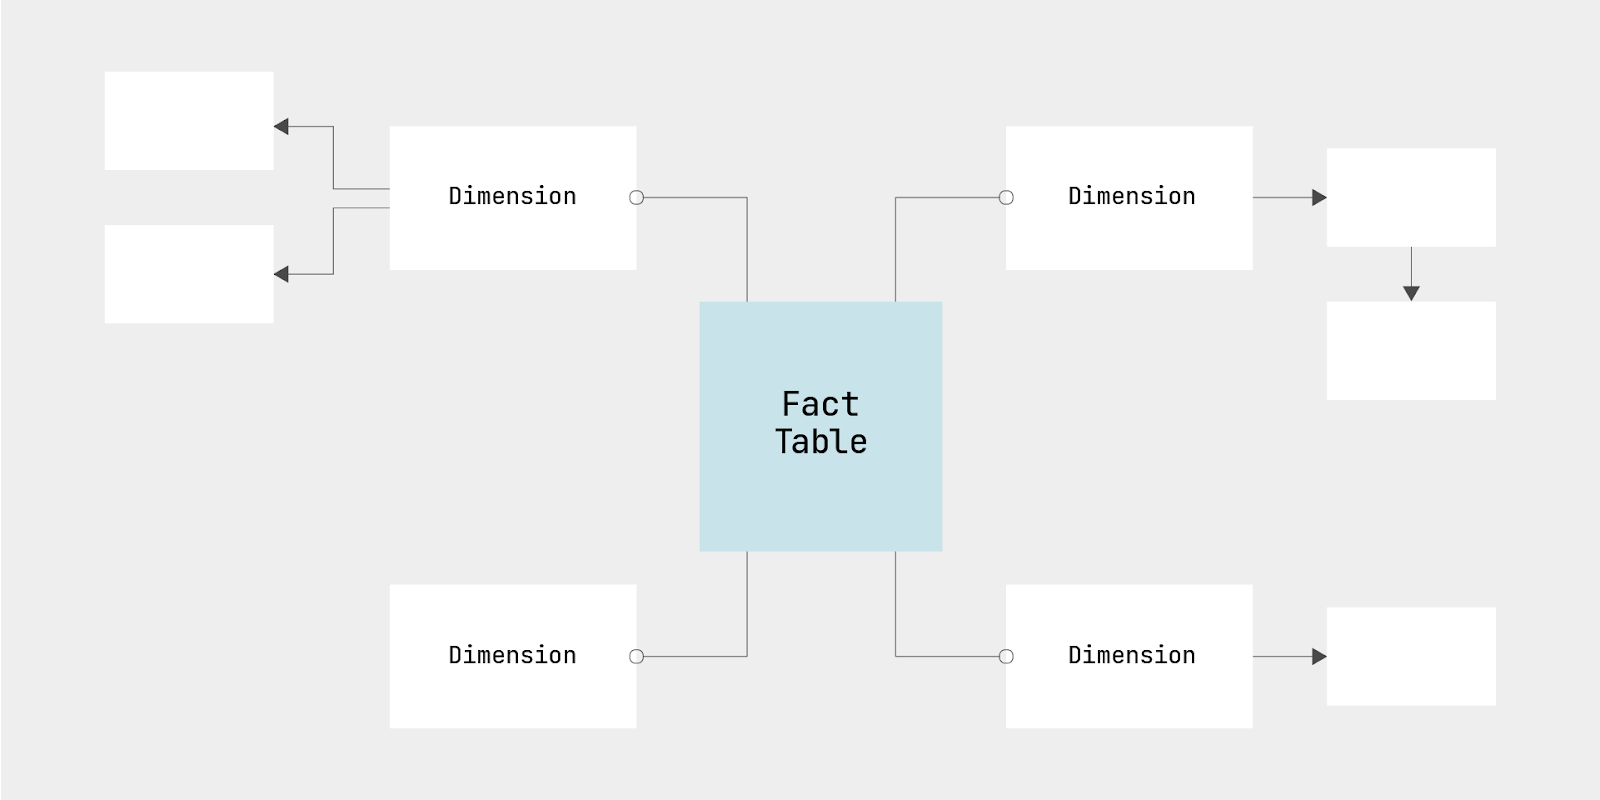
Snowflake schema. Imagen del autor
Este esquema encaja especialmente bien con lenguajes de programación orientados a objetos en los que los datos sobre objetos tienen más peso que la lógica o las funciones. En un esquema relacional, a cada objeto se le asigna su propia tabla, y todas estas tablas se relacionan entre sí.
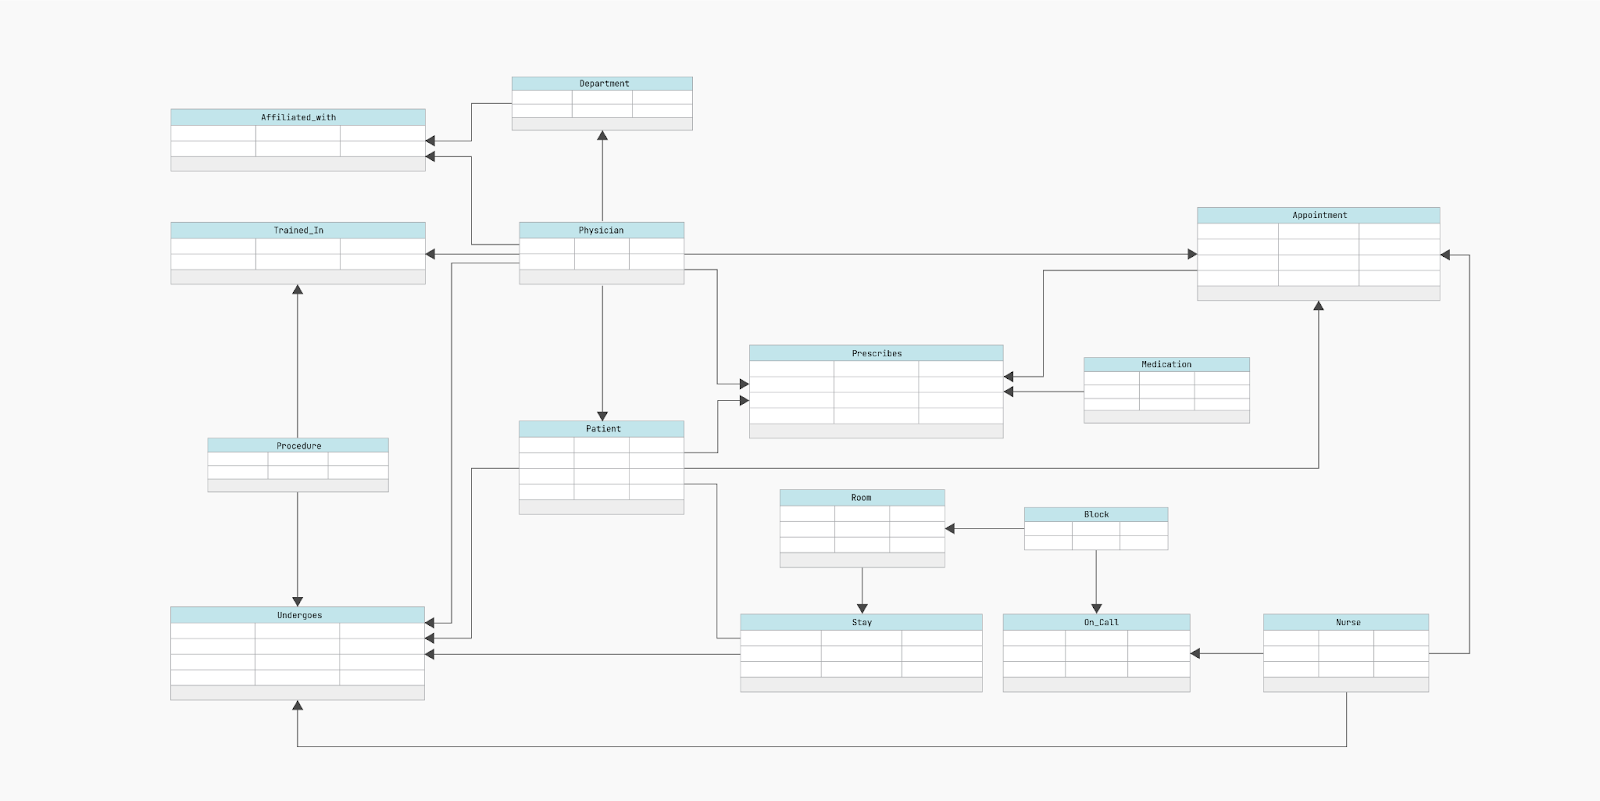
Modelo de base de datos relacional. Imagen del autor.
Por ejemplo, una base de datos de comercio electrónico incluye tablas de productos, clientes, pedidos y reseñas, todas relacionadas. A diferencia del star o el snowflake schema, no existe una tabla de hechos central. En su lugar, mantiene relaciones flexibles entre objetos para gestionar y recuperar datos con mayor eficiencia.
En este esquema, una tabla raíz se conecta con múltiples tablas hijo, donde cada hijo tiene exactamente un único padre.
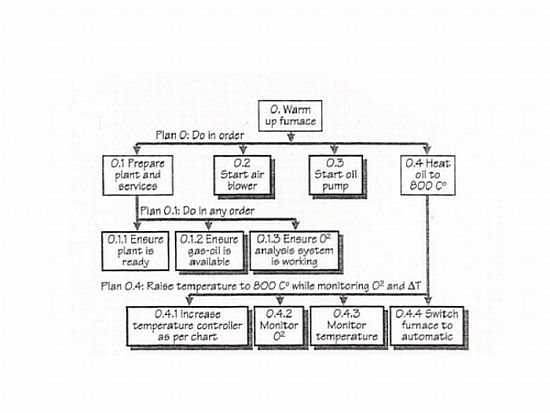
Modelo jerárquico de esquema de base de datos. Fuente: Wikipedia
Por ejemplo, en un sistema universitario, una tabla raíz podría incluir los departamentos, y cada departamento conectarse con tablas hijo de profesores y asignaturas. Los profesores pertenecen a un único departamento y las asignaturas se asignan a un profesor concreto. Esta estructura facilita el acceso a datos consultados con frecuencia, como horarios y datos de profesorado.
Los esquemas de base de datos mejoran el rendimiento general del sistema y su seguridad al definir claramente relaciones, restricciones y almacenamiento de datos. Estas son algunas de sus principales ventajas:
Estos son los pasos implicados en el diseño de un esquema.
Para diseñar una buena base de datos, lo primero es determinar su propósito principal: qué datos contendrá y quién los usará. Involucra a las partes interesadas para obtener requisitos detallados: qué datos se necesitan, qué tipos de consultas se ejecutarán y qué informes hay que generar. Así tendrás un alcance claro y te asegurarás de que la base de datos cubre las necesidades sin añadir complejidad innecesaria.
Con los requisitos claros, crea una vista o modelo conceptual de tu base de datos. Puedes hacerlo con un diagrama entidad–relación (ERD), que ilustra cómo se relacionan las tablas o entidades dentro del esquema.
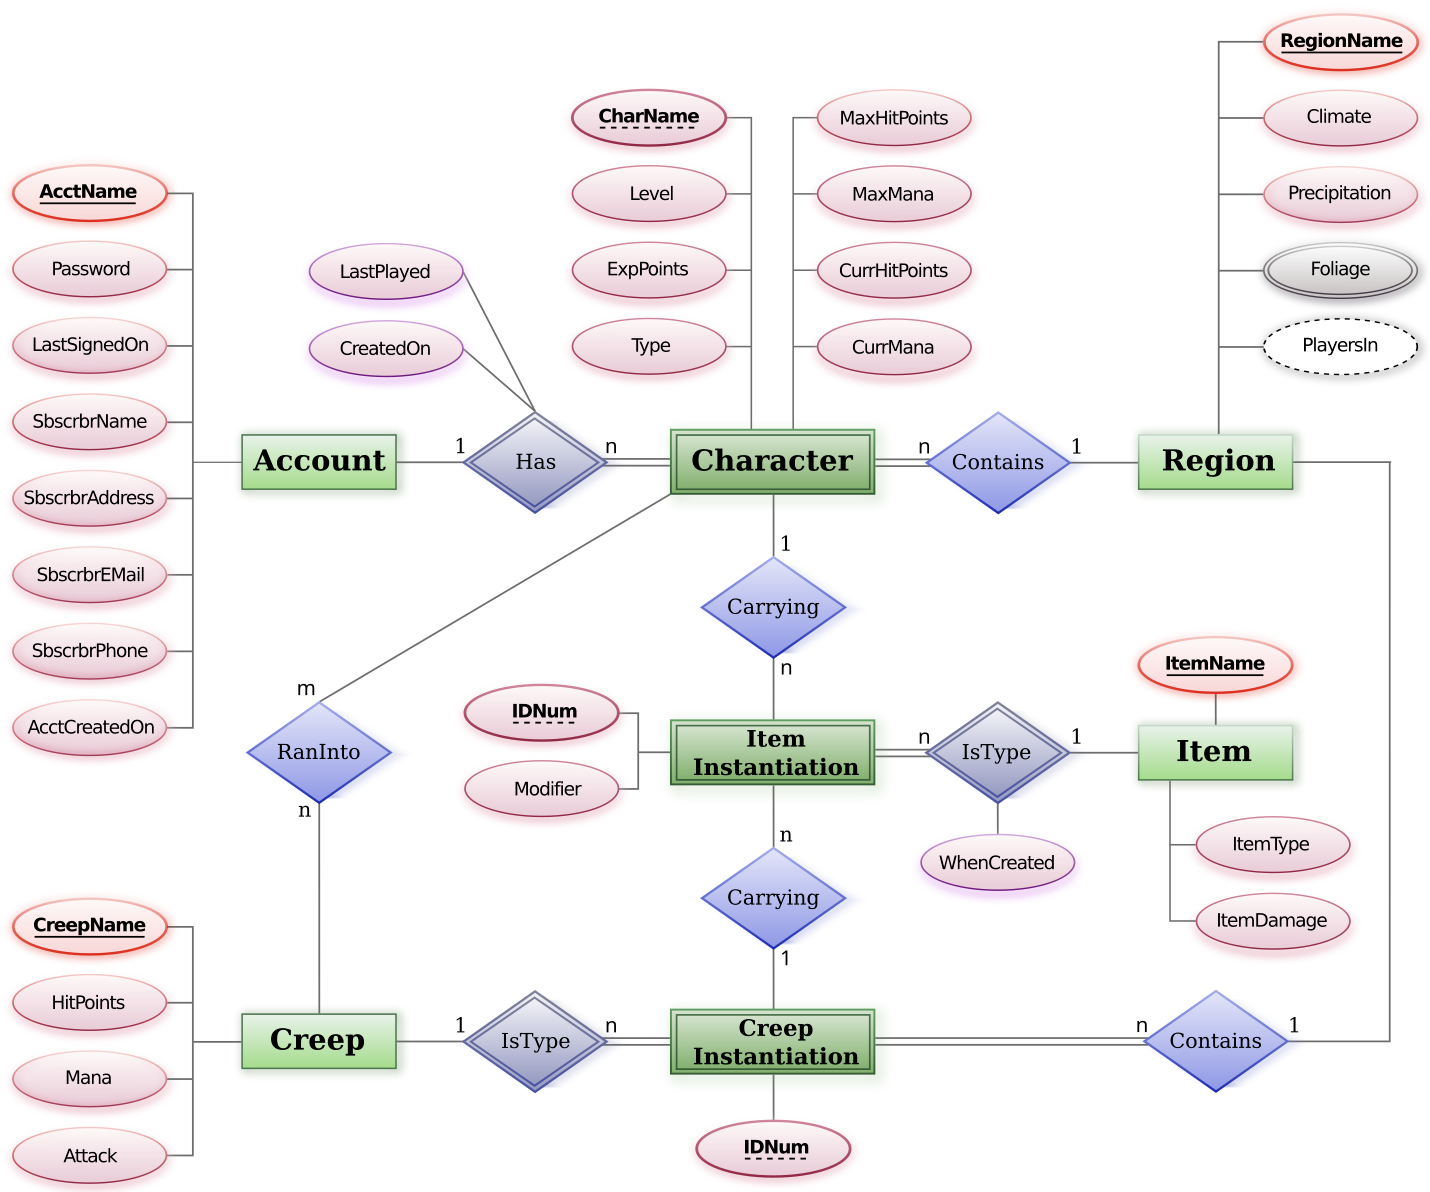
Diagrama entidad–relación de ejemplo. Fuente: Wikimedia Commons
Existen tres tipos de relaciones entre entidades:
A continuación, organiza tus datos en tablas. Crea una tabla para cada entidad de la base de datos e indica las columnas para cada atributo relacionado. Asigna una clave primaria a cada tabla, de manera que cada registro tenga un identificador único y la información se recupere fácilmente.
La normalización optimiza los datos reduciendo redundancias y mejorando su integridad. Existen varias formas normales (1NF, 2NF, 3NF, BCNF y más), pero lo habitual es normalizar hasta la tercera forma normal (3NF).
Aquí tienes las tres primeras formas y su propósito:
Normalización en bases de datos. Imagen del autor
Para garantizar una seguridad robusta, define claramente quién puede acceder a la base de datos y especifica sus permisos (lectura, escritura o eliminación). Así limitarás el acceso a usuarios autorizados y evitarás que terceros vean o modifiquen datos sensibles. Además, cifra los datos sensibles en reposo y en tránsito para reforzar la seguridad: el cifrado hace que la información sea ilegible incluso si alguien no autorizado la intercepta.
Al describir el diseño de la base de datos, las convenciones de nombres de tablas, columnas, índices y demás objetos deben ser coherentes. Los nombres han de ser lo bastante descriptivos como para indicar qué contiene exactamente una tabla o columna, de modo que los usuarios lo entiendan de un vistazo. Así evitarás conflictos cuando tú u otras personas del equipo realicéis operaciones en la base de datos.
Cuando lo tengas todo, prueba el esquema a fondo con datos de ejemplo para ejecutar operaciones y consultas y evaluar su rendimiento. A partir del feedback de esta fase, afina y ajusta el esquema según sea necesario. Esto te ayudará a detectar y resolver posibles problemas y a asegurar que el esquema sea eficiente.
Un esquema bien pensado es la base de un sistema de bases de datos eficiente. Aun así, su diseño plantea varios desafíos. Veamos los más comunes y cómo resolverlos.
Cuando las relaciones entre tablas no están bien definidas, las consultas estructuradas se vuelven complejas. Esto ralentiza la ejecución de consultas y afecta al rendimiento general de la aplicación. Por ejemplo, los registros huérfanos y la falta de consistencia en las actualizaciones generan inexactitudes y problemas de calidad de datos. Para evitarlo, recurre a herramientas de modelado avanzadas como las bases de datos de grafos para definir relaciones claras y eficientes y gestionar mejor la complejidad.
Las bases de datos son vulnerables a inyección SQL y brechas de seguridad que pueden comprometer información sensible. Para mantener tus datos seguros, aplica estrategias de seguridad en múltiples capas, incluyendo cifrado avanzado y sistemas de detección de anomalías basados en IA. Esto ayudará a identificar y mitigar amenazas potenciales. Además, realiza auditorías de seguridad periódicas para monitorizar posibles riesgos.
Los distintos niveles de normalización influyen en el rendimiento de las consultas y complican el mantenimiento. La sobre-normalización puede generar joins complejos, mientras que la infra-normalización provoca anomalías de datos. Para resolverlo, aplica estrategias de normalización flexibles basadas en los patrones de acceso. Utiliza herramientas de refactorización de bases de datos para revisar periódicamente el estado actual y ajustar, si hace falta, el nivel de normalización. Así lograrás un rendimiento óptimo equilibrando estructuras normalizadas y desnormalizadas.
Sin una documentación clara, los cambios en el esquema pueden ser arriesgados y consumir mucho tiempo. Actualiza la documentación con regularidad para asegurar que sea precisa y esté sincronizada con las últimas estructuras de la base de datos.
Un mal indexado puede llevar a consultas lentas y afectar a las operaciones de escritura. Sin índices adecuados, buscar en toda la base de datos llevará mucho tiempo. Para superarlo, puedes usar herramientas de indexación automática, como el Query Store, que analizan patrones de consulta y optimizan de forma predictiva la creación de índices. Estas herramientas emplean algoritmos de aprendizaje automático que ajustan los índices según los patrones de uso.
Un esquema de base de datos bien estructurado mantiene la integridad de los datos y favorece la escalabilidad al proporcionar un marco sólido para gestionar volúmenes y complejidad crecientes.
Si quieres seguir formándote, DataCamp tiene varios cursos excelentes para acompañarte. Nuestro tutorial Managing Databases in PostgreSQL ofrece recomendaciones prácticas sobre PostgreSQL, uno de los sistemas open-source más potentes. El tutorial Using PostgreSQL in Python conecta la gestión de bases de datos con la programación. Si eres administrador de bases de datos, puedes empezar el itinerario de habilidades SQL for Database Administrators. Y si te interesa la preparación de datos, échale un vistazo a nuestro curso Cleaning Data in PostgreSQL Databases.
Aprende con DataCamp
Curso
programa
Curso
blog
Kurtis Pykes
11 min
blog
Tim Lu
12 min
blog
Matt Crabtree
10 min
Tutorial
Anneleen Rummens
12 min
Tutorial
Joleen Bothma
11 min
Tutorial
Sejal Jaiswal
15 min