
कोर्स
Power BI में डेटा मॉडलिंग
3 घंटा
100.7K
डेटाबेस स्कीमा, डेटाबेस के भीतर संरचना और रिलेशनशिप का ब्लूप्रिंट होता है। यह निर्दिष्ट करता है कि डेटा को टेबल, फील्ड, डेटा टाइप, और इन तत्वों के रिलेशनशिप में कैसे संगठित किया जाएगा। आइए देखें इसके मुख्य घटक क्या हैं और वे समग्र डेटाबेस स्कीमा में कैसे योगदान देते हैं:
अच्छी तरह से डिज़ाइन किया गया डेटाबेस स्कीमा सुनिश्चित करता है कि डेटा सही है, क्वेरी प्रदर्शन अनुकूलित है, और आपका डेटाबेस व्यावसायिक वृद्धि का समर्थन कर सकता है।
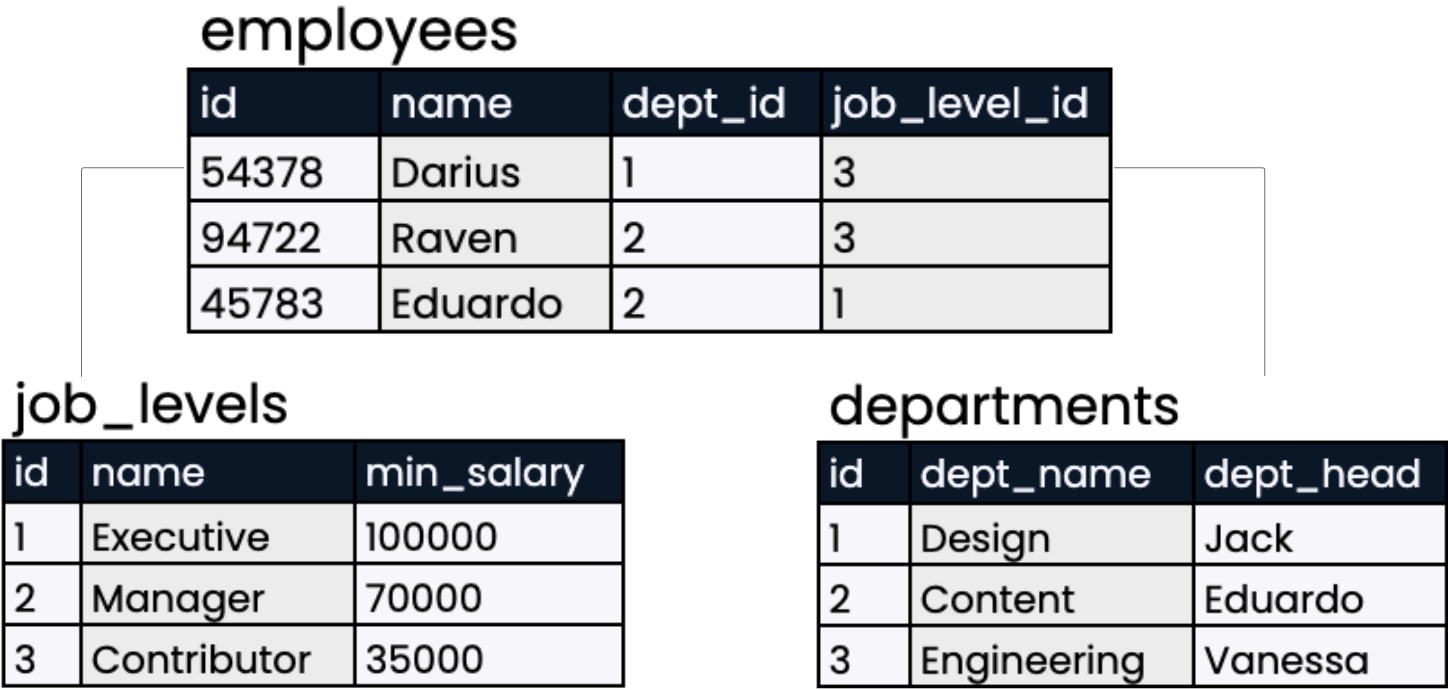
डेटा को टेबलों में व्यवस्थित करना। चित्र: लेखक
लेकिन एक अच्छे डेटाबेस स्कीमा का स्वरूप कैसा होता है? यह जानना आवश्यक है:
डेटाबेस स्कीमा के कई प्रकार होते हैं और प्रत्येक अलग उद्देश्य की पूर्ति करता है और संगठन के विभिन्न स्तर प्रदान करता है। कभी-कभी, स्कीमा का उपयोग सामान्य डेटाबेस संरचनाओं का ब्योरा देने के लिए अनौपचारिक रूप से किया जाता है, जबकि अन्य समय वे विशिष्ट आर्किटेक्चरल तत्वों और डिज़ाइन विवरणों को संदर्भित करते हैं। उच्च स्तरीय अमूर्तन पर, डेटाबेस स्कीमा को तीन प्रकारों—कॉन्सेप्चुअल, लॉजिकल, और फिजिकल—में वर्गीकृत किया जा सकता है।
कॉन्सेप्चुअल डेटाबेस स्कीमा, एक उच्च-स्तरीय स्कीमा है जो डेटा टाइप या कॉन्स्ट्रेंट जैसे इम्प्लीमेंटेशन विवरण दिखाए बिना, पूरे डेटाबेस सिस्टम का समग्र दृश्य प्रदान करता है। यह उपयोगकर्ताओं को संगठन के भीतर डेटा प्रवाह समझने में मदद करता है और तकनीकी तथा गैर-तकनीकी दोनों उपयोगकर्ताओं के लिए चीज़ों को आसान बनाता है।
लॉजिकल स्कीमा, डेटाबेस में डेटा की तार्किक संरचना को रेखांकित करता है। यह बताता है कि डेटा कैसे संगठित है और डेटा एंटिटी के बीच के रिलेशनशिप क्या हैं, बिना यह दिखाए कि इसे भौतिक रूप से कैसे संग्रहीत किया गया है। यह स्कीमा प्रकार, डेटाबेस के डिज़ाइन चरण के दौरान एंट्री को मान्य करने के लिए डेटा टाइप और कॉन्स्ट्रेंट निर्दिष्ट करके डेटा की सुसंगतता और अखंडता बनाए रखता है।
फिजिकल डेटाबेस स्कीमा बताता है कि सिस्टम में डेटा कहाँ स्थित है। इसमें फाइल लोकेशन, इंडेक्सिंग स्ट्रैटेजी, और प्रत्येक टेबल के स्टोरेज फॉर्मैट जैसे पहलू शामिल हो सकते हैं ताकि बड़े पैमाने पर डेटा से निपटते समय अधिकतम प्रदर्शन सुनिश्चित किया जा सके।
डेटा को व्यवस्थित करने के मामले में, एक ही तरीका सब पर लागू नहीं होता। अलग-अलग डेटा वेयरहाउस की व्यावसायिक आवश्यकताएँ भिन्न होती हैं, इसलिए उन्हें अलग-अलग डेटाबेस स्कीमा चाहिए। कुछ सबसे लोकप्रिय शैलियों में स्टार स्कीमा, स्नोफ्लेक स्कीमा, हाइरार्किकल स्कीमा, और रिलेशनल स्कीमा शामिल हैं।
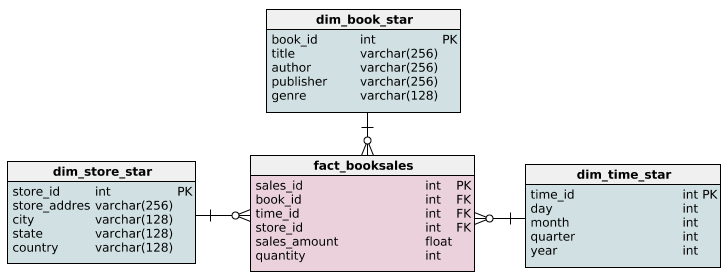
स्टार स्कीमा बड़े डेटा सेट को दो महत्वपूर्ण सिद्धांतों—फैक्ट और डायमेंशन—के आधार पर व्यवस्थित और प्रबंधित करता है। फैक्ट, व्यावसायिक संचालन होते हैं जिनके प्रेरक कारक पर विचार करना होता है, जैसे बिक्री आंकड़े या लेनदेन की मात्रा। डायमेंशन, इन फैक्ट को वर्णनात्मक संदर्भ देकर विस्तृत करते हैं। यह समय, स्थान, या उत्पाद विवरण भी हो सकते हैं।
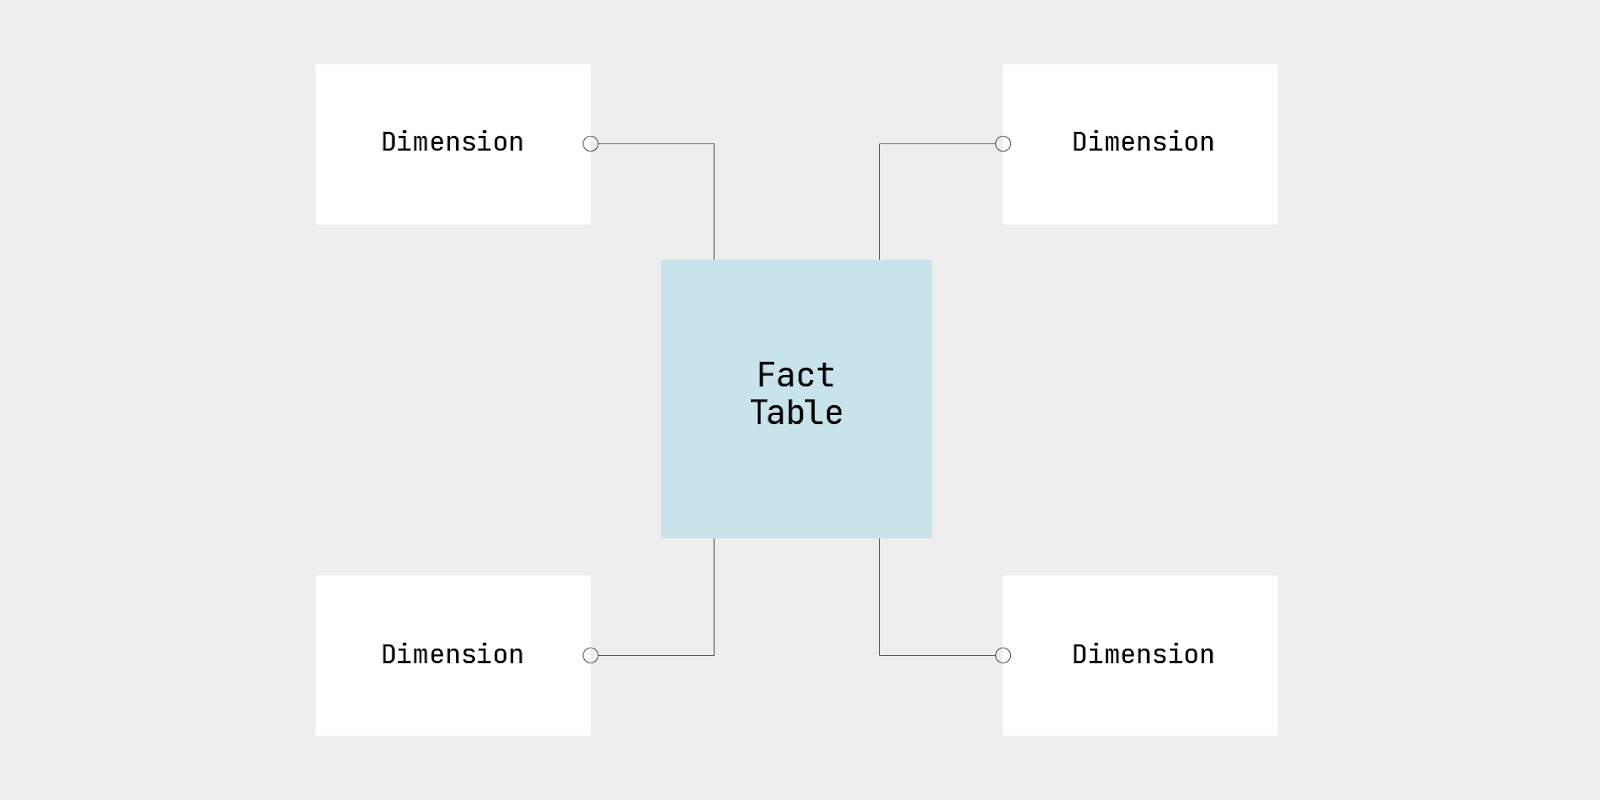
स्टार स्कीमा। चित्र: लेखक।
स्नोफ्लेक स्कीमा, स्टार स्कीमा के समान होता है। इसमें एक केंद्रीय फैक्ट टेबल होती है जो कई डायमेंशन टेबलों से जुड़ी होती है, लेकिन इसमें एक हल्का सा अंतर है। स्नोफ्लेक स्कीमा में सभी डायमेंशन फ्लैट नहीं होते—प्रत्येक डायमेंशन टेबल को आगे सामान्यीकृत (normalized) कर कई संबंधित टेबलों में बांटा जाता है। इसका मतलब है कि प्रत्येक डायमेंशन टेबल छोटे और संबद्ध टेबलों में विभाजित होती है।
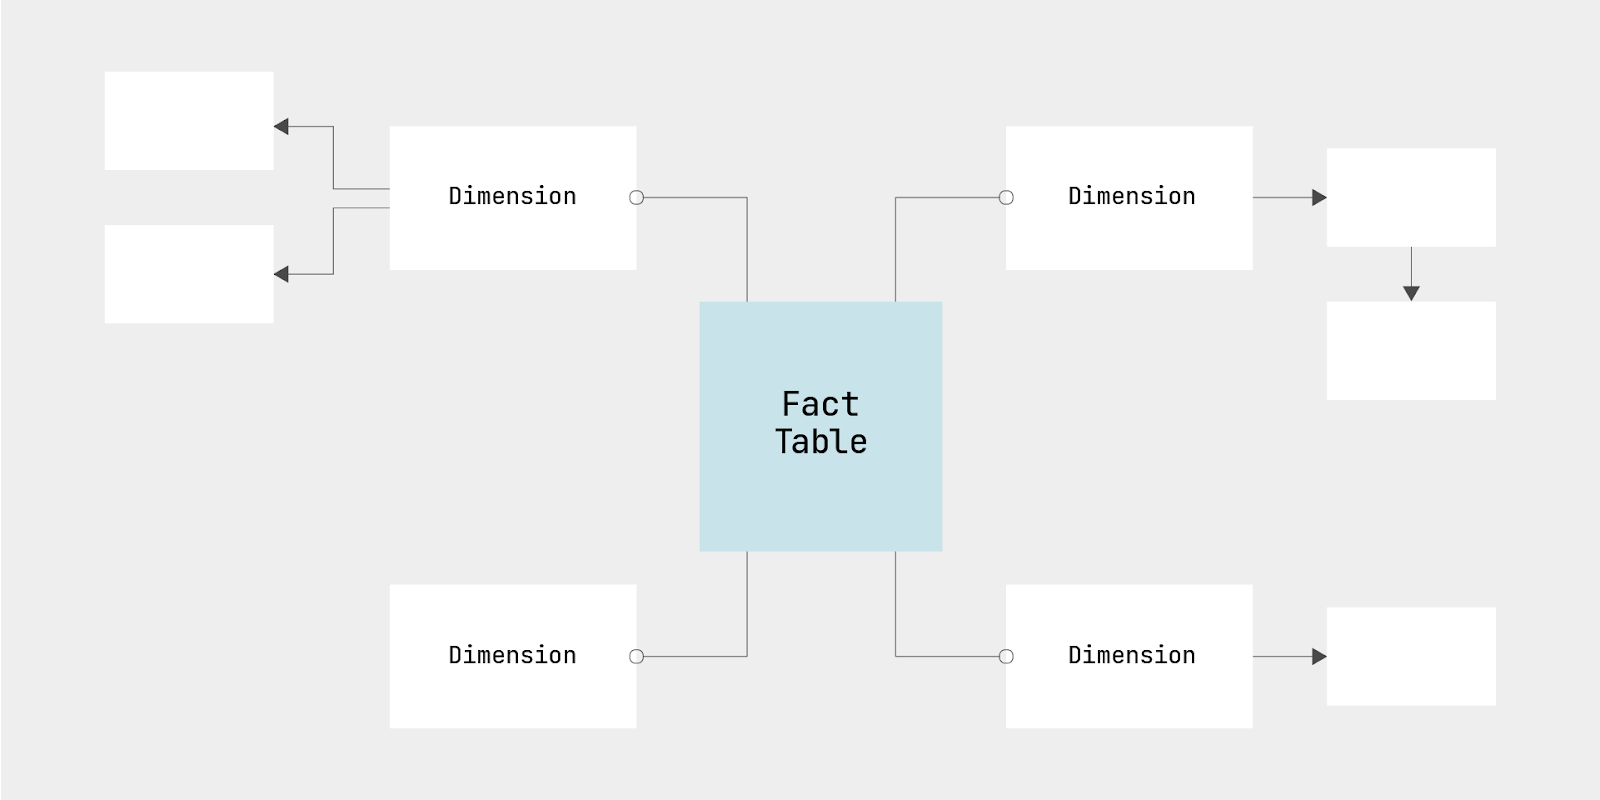
स्नोफ्लेक स्कीमा। चित्र: लेखक
यह स्कीमा उन ऑब्जेक्ट-ओरिएंटेड प्रोग्रामिंग भाषाओं के लिए सबसे उपयुक्त है जो लॉजिक और फंक्शन की तुलना में ऑब्जेक्ट्स के बारे में डेटा को अधिक महत्त्व देती हैं। एक रिलेशनल डेटाबेस स्कीमा में, प्रत्येक ऑब्जेक्ट को उसकी अपनी टेबल सौंपी जाती है, और ये सभी टेबलें एक-दूसरे से जुड़ी होती हैं।
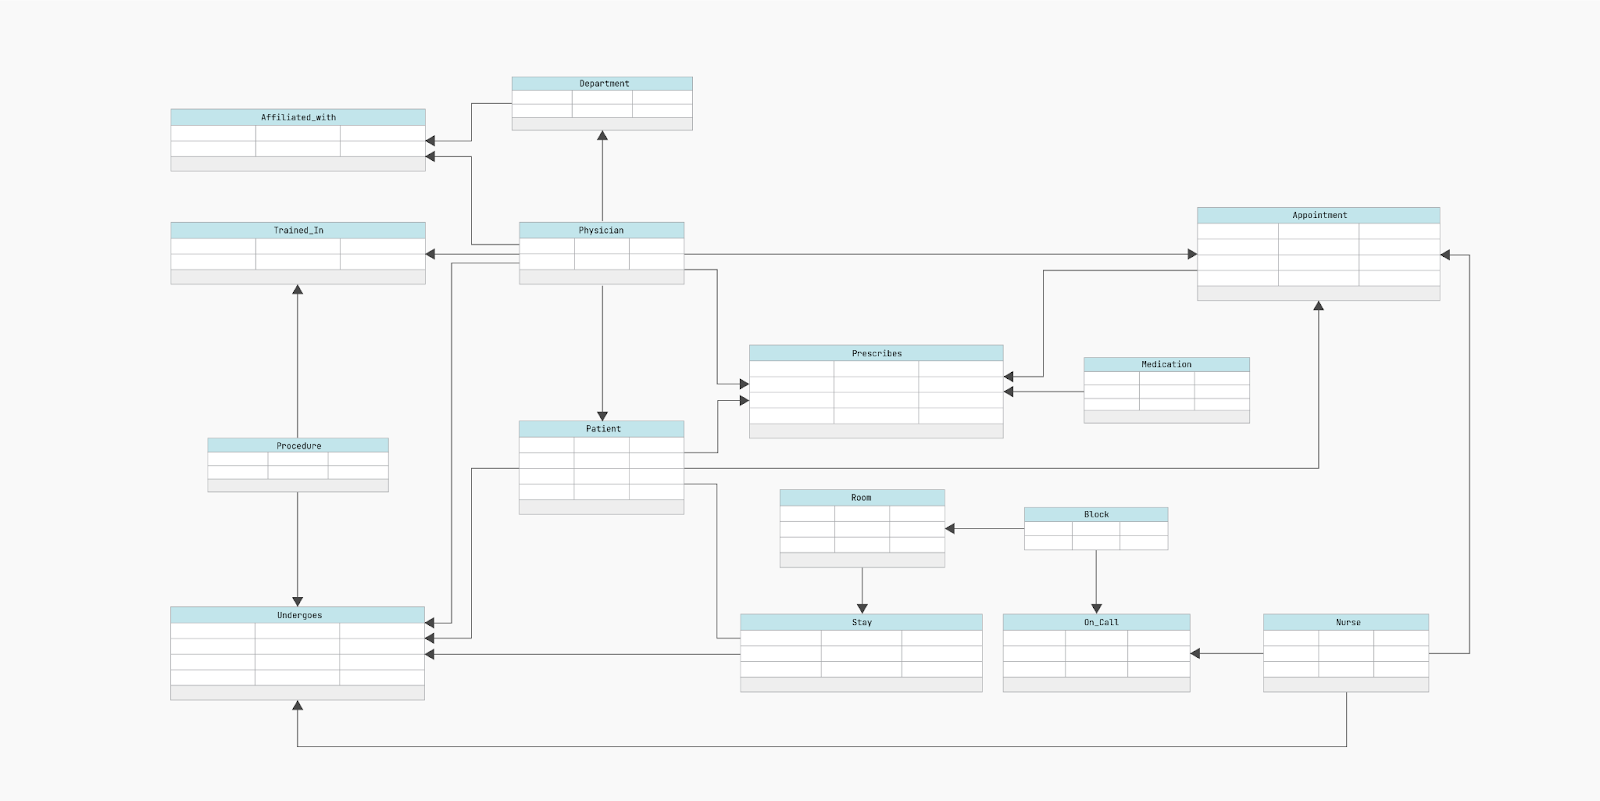
रिलेशनल डेटाबेस मॉडल। चित्र: लेखक।
उदाहरण के लिए, एक ई-कॉमर्स डेटाबेस में प्रोडक्ट्स, कस्टमर, ऑर्डर, और रिव्यू की टेबलें होती हैं—जो सभी परस्पर संबंधित होती हैं। स्टार या स्नोफ्लेक स्कीमा के विपरीत, इसमें कोई केंद्रीय फैक्ट टेबल नहीं होती। इसके बजाय, डेटा प्रबंधन और पुनर्प्राप्ति में दक्षता बढ़ाने के लिए ऑब्जेक्ट्स के बीच लचीले रिलेशनशिप होते हैं।
इस स्कीमा में, एक रूट टेबल कई चाइल्ड टेबलों से जुड़ती है जहाँ प्रत्येक चाइल्ड का ठीक एक पैरेंट होता है।
डेटाबेस स्कीमा का हाइरार्किकल मॉडल। स्रोत: Wikipedia
उदाहरण के लिए, किसी विश्वविद्यालय प्रणाली में, एक रूट टेबल में विभाग शामिल हो सकते हैं, जहाँ प्रत्येक विभाग प्रोफेसर और कोर्स के लिए चाइल्ड टेबलों से जुड़ता है। प्रोफेसर केवल एक ही विभाग से संबंधित हो सकते हैं, लेकिन कोर्स किसी विशिष्ट प्रोफेसर को ही सौंपे जाते हैं। यह संरचना, कोर्स शेड्यूल और प्रोफेसर विवरण जैसे अक्सर उपयोग होने वाले डेटा तक पहुँच को आसान बनाती है।
डेटाबेस स्कीमा, रिलेशनशिप, कॉन्स्ट्रेंट, और डेटा स्टोरेज को स्पष्ट रूप से परिभाषित करके समग्र सिस्टम प्रदर्शन और सुरक्षा में सुधार करते हैं। यहाँ अच्छी तरह से डिज़ाइन किए गए डेटाबेस स्कीमा के कुछ प्रमुख लाभ हैं:
डेटाबेस के लिए स्कीमा डिज़ाइन करने में निम्न चरण शामिल होते हैं।
एक अच्छा डेटाबेस डिज़ाइन करने के लिए, पहले आपको इसका प्राथमिक उद्देश्य निर्धारित करना होगा: इसमें कौन-सा डेटा होगा और इसे कौन उपयोग करेगा। विस्तृत आवश्यकताएँ पाने के लिए आप स्टेकहोल्डर्स से संवाद कर सकते हैं, जिनमें आवश्यक विशिष्ट डेटा, उस पर चलने वाली क्वेरी के प्रकार, और बनाये जाने वाले रिपोर्ट शामिल हैं। इस तरह आपको प्रोजेक्ट का स्पष्ट दायरा मिलेगा और आप सुनिश्चित कर सकेंगे कि डेटाबेस, अनावश्यक जटिलता के बिना, उपयोगकर्ता आवश्यकताओं को पूरा करेगा।
अब जब आपको आवश्यकताएँ पता हैं, तो अपने डेटाबेस का एक कॉन्सेप्चुअल व्यू या मॉडल बनाएं। आप यह एक एंटिटी रिलेशनशिप डायग्राम (ERD) का उपयोग करके कर सकते हैं, जो दर्शाता है कि डेटाबेस स्कीमा के भीतर टेबलें या एंटिटीज एक-दूसरे से कैसे संबंधित हैं।
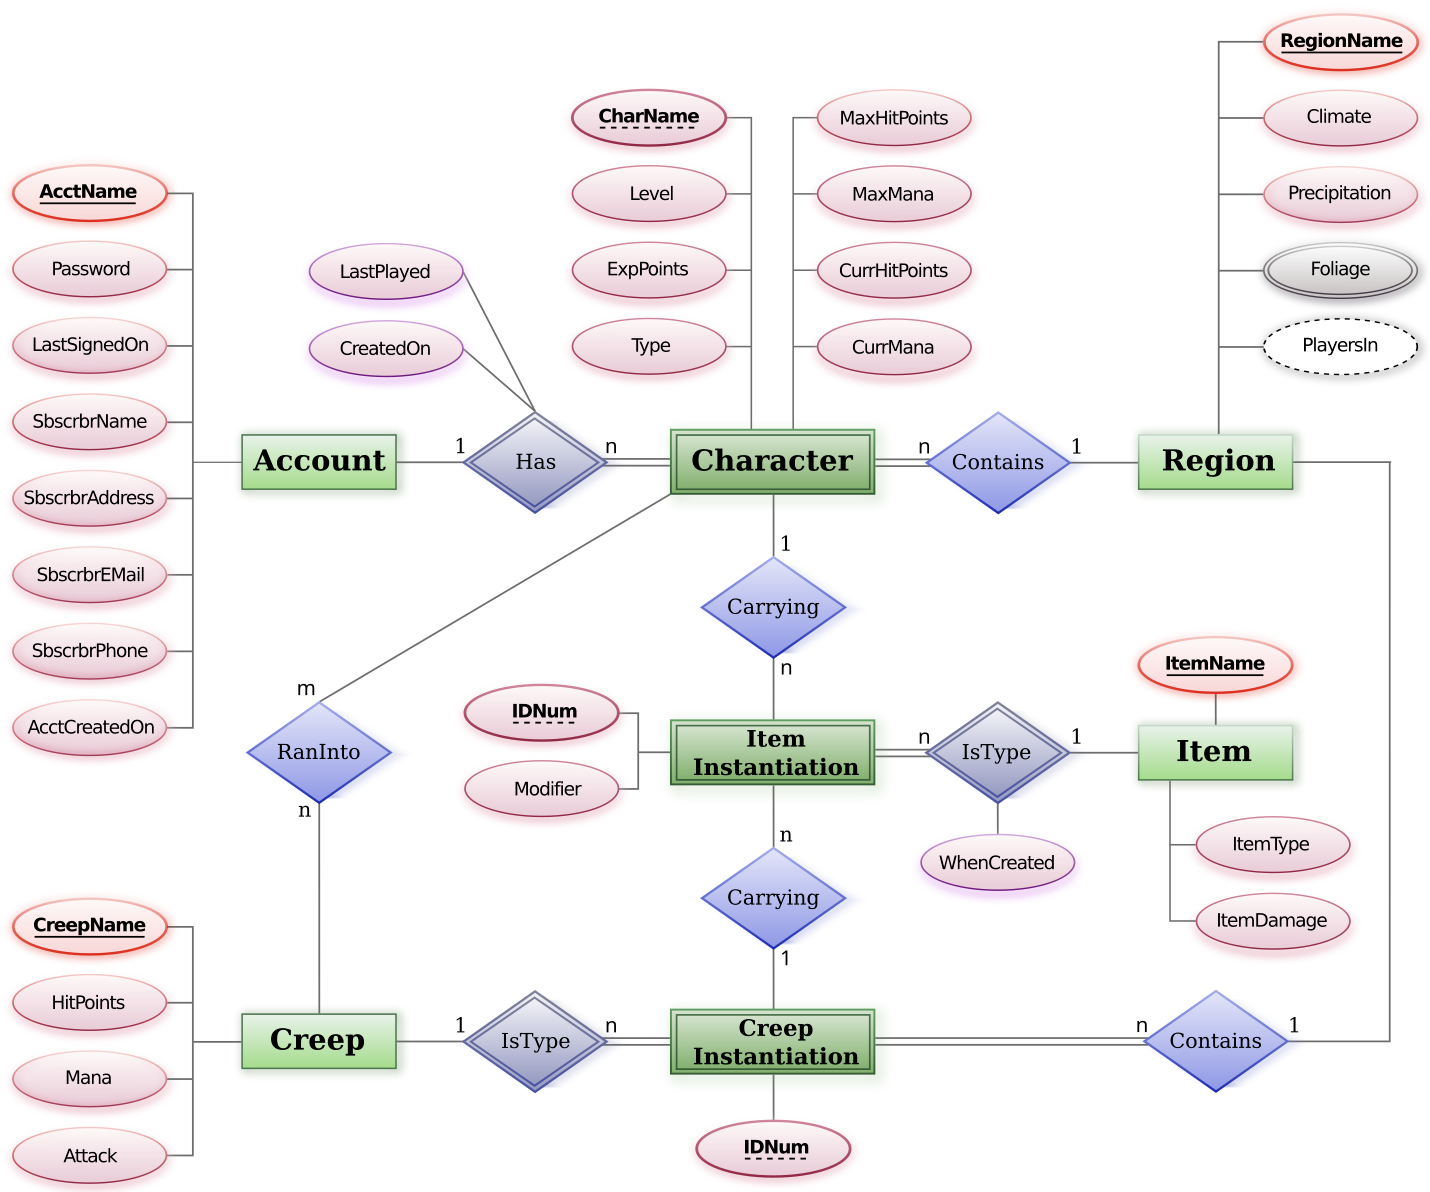
नमूना एंटिटी रिलेशनशिप डायग्राम। स्रोत: Wikimedia Commons
एंटिटीज के बीच तीन तरह के रिलेशनशिप होते हैं:
अगला, अपने डेटा को टेबलों में व्यवस्थित करें। अपने डेटाबेस के भीतर प्रत्येक एंटिटी के लिए एक टेबल बनाएं और उन एंटिटीज से संबंधित प्रत्येक एट्रिब्यूट को रखने के लिए कॉलम निर्दिष्ट करें। प्रत्येक टेबल को एक प्राइमरी की दें ताकि हर रिकॉर्ड का एक अद्वितीय आइडेंटिफायर हो और डेटा को आसानी से प्राप्त किया जा सके।
नॉर्मलाइज़ेशन आपके डेटाबेस के भीतर डेटा को अनुकूलित करता है, दोहरावदार डेटा को कम करता है और इसकी अखंडता में सुधार करता है। कई नॉर्मल फॉर्म (1NF, 2NF, 3NF, BCNF, आदि) होते हैं, लेकिन आपको कम-से-कम थर्ड नॉर्मल फॉर्म (3NF) तक नॉर्मलाइज़ करना चाहिए।
यहाँ तीन नॉर्मलाइज़ेशन फॉर्म और उनके उद्देश्य देखें:
डेटाबेस में नॉर्मलाइज़ेशन। चित्र: लेखक
मजबूत डेटाबेस सुरक्षा सुनिश्चित करने के लिए, स्पष्ट रूप से परिभाषित करें कि डेटाबेस तक कौन पहुँच सकता है और उनकी क्या परमिशन होंगी, जैसे पढ़ना, लिखना, या हटाना। ऐसा करने से, आप केवल अधिकृत उपयोगकर्ताओं तक पहुँच सीमित करेंगे और अनधिकृत व्यक्तियों को संवेदनशील डेटा देखने या संशोधित करने से रोकेंगे। इसके अलावा, स्थिर (at rest) और संचारित (in transit) संवेदनशील डेटा को एन्क्रिप्ट करना सुरक्षा को और मजबूत करता है, क्योंकि यह जानकारी को इस तरह उलझा देता है कि यदि यह अनधिकृत उपयोगकर्ताओं द्वारा इंटरसेप्ट भी हो जाए, तो पढ़ी न जा सके।
डेटाबेस डिज़ाइन का वर्णन करते समय—टेबल, कॉलम, इंडेक्स, और अन्य ऑब्जेक्ट्स के नेमिंग कन्वेंशन सुसंगत होने चाहिए। नाम इतने वर्णनात्मक होने चाहिए कि टेबल या कॉलम में ठीक-ठीक क्या रखा है, इसका संकेत दें ताकि उपयोगकर्ता बिना मेहनत के जल्दी समझ सकें। इससे तब होने वाले संभावित टकराव से बचा जा सकेगा जब आप या टीम का कोई अन्य सदस्य डेटाबेस ऑपरेशन करेगा।
जब आप सब कुछ कर लें, तो सैंपल डेटा के साथ स्कीमा का अच्छी तरह परीक्षण करें, ऑपरेशन और क्वेरी चलाएँ और उसके प्रदर्शन का आकलन करें। इस टेस्टिंग चरण से मिले फीडबैक के आधार पर, आवश्यकतानुसार स्कीमा को परिष्कृत और समायोजित करें। इससे संभावित समस्याओं की पहचान और समाधान होगा और आपका डेटाबेस स्कीमा कुशल बना रहेगा।
अच्छा स्कीमा, कुशल डेटाबेस सिस्टम की नींव है। हालाँकि, उचित स्कीमा डिज़ाइन करना कई चुनौतियाँ भी पेश कर सकता है। तो, आइए उन्हें और उनके समाधानों को देखते हैं।
जब टेबलों के बीच रिलेशनशिप स्पष्ट रूप से परिभाषित नहीं होते, तो संरचित क्वेरी बहुत जटिल हो जाती हैं। इससे क्वेरी निष्पादन धीमा होता है और एप्लिकेशन के समग्र प्रदर्शन पर असर पड़ता है। उदाहरण के लिए, अनाथ रिकॉर्ड (orphaned records) और डेटा स्थिरता अपडेट की कमी, डेटा में अशुद्धियाँ और गुणवत्ता समस्याएँ पैदा करेगी। इन मुद्दों से बचने के लिए, आपको graph databases जैसे उन्नत मॉडलिंग टूल लागू करने चाहिए ताकि पारदर्शी और कुशल रिलेशनशिप संरचनाएँ परिभाषित की जा सकें और जटिल रिलेशनशिप को अधिक प्रभावी ढंग से प्रबंधित किया जा सके।
डेटाबेस, SQL इंजेक्शन और डेटा ब्रीच के प्रति संवेदनशील होते हैं, जो संवेदनशील जानकारी को जोखिम में डाल सकते हैं। अपने डेटा को सुरक्षित रखने के लिए, मल्टी-लेयर्ड सुरक्षा रणनीतियाँ लागू करें, जिनमें उन्नत डेटा एन्क्रिप्शन विधियाँ और AI-आधारित विसंगति पहचान (anomaly detection) सिस्टम शामिल हों। यह संभावित खतरों की पहचान करने और उन्हें कम करने में मदद करेगा। इसके अलावा, संभावित खतरों की निगरानी के लिए नियमित सुरक्षा ऑडिट करें।
नॉर्मलाइज़ेशन के विभिन्न स्तर, क्वेरी प्रदर्शन को प्रभावित करते हैं और मेंटेनेंस को जटिल बनाते हैं। इसके अलावा, ओवर-नॉर्मलाइज़ेशन से जटिल जॉइन बन सकते हैं, जबकि अंडर-नॉर्मलाइज़ेशन डेटा विसंगतियाँ (anomalies) पैदा कर सकता है। इन समस्याओं को हल करने के लिए, आपको डेटा एक्सेस पैटर्न के आधार पर लचीली नॉर्मलाइज़ेशन रणनीतियाँ लागू करनी चाहिए। रिफैक्टरिंग डेटाबेस टूल का उपयोग करके वर्तमान नॉर्मलाइज़ेशन स्थिति की नियमित समीक्षा करें और आवश्यकता होने पर नॉर्मलाइज़ेशन स्तर समायोजित करें। इस तरह, आप नॉर्मलाइज़्ड और डी-नॉर्मलाइज़्ड संरचनाओं के बीच संतुलन बनाकर इष्टतम प्रदर्शन हासिल कर सकते हैं।
स्पष्ट डॉक्यूमेंटेशन के बिना, डेटाबेस स्कीमा में बदलाव जोखिम भरे और समयसाध्य हो सकते हैं। इसलिए, डॉक्यूमेंटेशन को नियमित रूप से अपडेट करें ताकि यह सटीक रहे और नवीनतम डेटाबेस संरचनाओं के साथ सिंक में रहे।
खराब इंडेक्सिंग, धीमे क्वेरी प्रदर्शन का कारण बन सकती है और लिखने के ऑपरेशन को प्रभावित कर सकती है। उचित इंडेक्स के बिना, डेटाबेस में खोज करने में बहुत समय लगेगा। इस चुनौती से पार पाने के लिए, आप क्वेरी स्टोर जैसे स्वचालित इंडेक्सिंग टूल का उपयोग कर सकते हैं, जो क्वेरी पैटर्न का विश्लेषण करते हैं और पूर्वानुमानित रूप से इंडेक्स निर्माण को अनुकूलित करते हैं। इन टूल्स में मशीन लर्निंग एल्गोरिद्म होते हैं जो उपयोग पैटर्न के आधार पर इंडेक्स समायोजित करते हैं।
अच्छी तरह संरचित डेटाबेस स्कीमा, बढ़ती डेटा मात्रा और जटिलताओं से निपटने के लिए एक ठोस ढाँचा प्रदान करके डेटा अखंडता बनाए रखता है और स्केलेबिलिटी का समर्थन करता है।
यदि आप अपस्किल करना चाहते हैं, तो इस यात्रा में आपकी मदद के लिए DataCamp के कई उत्कृष्ट कोर्स हैं। हमारा Managing Databases in PostgreSQL ट्यूटोरियल, PostgreSQL—सबसे शक्तिशाली ओपन-सोर्स डेटाबेस सिस्टम में से एक—पर व्यावहारिक जानकारी प्रदान करता है। हमारा Using PostgreSQL in Python ट्यूटोरियल, डेटाबेस प्रबंधन और प्रोग्रामिंग के बीच की खाई को पाटता है। यदि आप डेटाबेस एडमिनिस्ट्रेटर हैं, तो आप हमारा SQL for Database Administrators स्किल ट्रैक शुरू कर सकते हैं। जो डेटा प्रिपरेशन में रुचि रखते हैं, वे हमारे Cleaning Data in PostgreSQL Databases कोर्स को ज़रूर देखें।
DataCamp के साथ सीखें
कोर्स
लर्निंग पाथ
कोर्स