Kurs
Datenmodellierung in Power BI
3 Std.
99.6K
Ein Datenbankschema ist der Bauplan für Struktur und Beziehungen innerhalb einer Datenbank. Es legt fest, wie Daten in Tabellen, Feldern, Datentypen und den Beziehungen dieser Elemente organisiert werden. Schauen wir uns die zentralen Bausteine an und wie sie zum Gesamtschema beitragen:
Ein gut entworfenes Datenbankschema stellt sicher, dass die Daten korrekt sind, Abfragen performant laufen und deine Datenbank mit dem Geschäft mitwachsen kann.
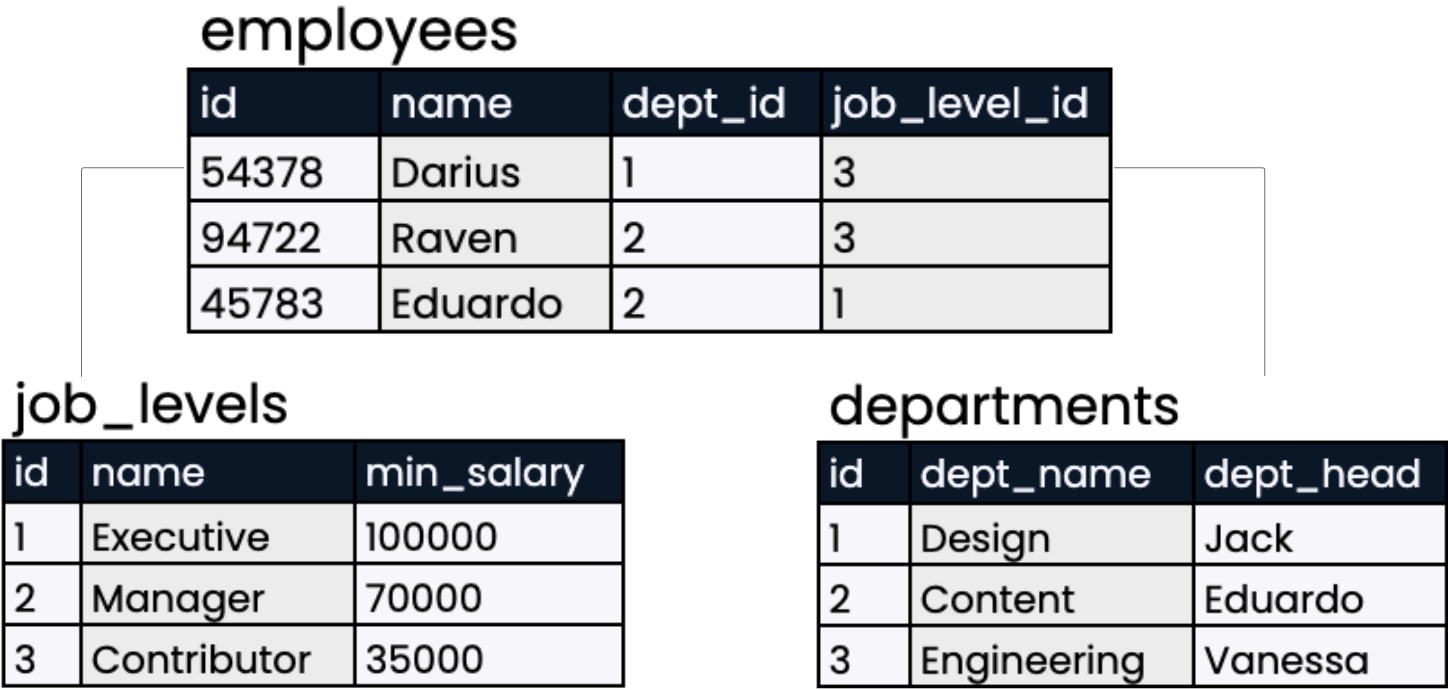
Daten in Tabellen organisieren. Bild: Autorin/Autor
Wie sieht nun ein gutes Schema aus? Darauf kommt es an:
Es gibt verschiedene Arten von Datenbankschemata. Jede erfüllt einen anderen Zweck und bietet unterschiedliche Organisationsgrade. Manchmal beschreibt man damit allgemein Datenbankstrukturen, ein andermal sehr konkrete Architektur- und Designdetails. Auf hoher Abstraktionsebene lassen sich drei Typen unterscheiden – konzeptuell, logisch und physisch.
Ein konzeptuelles Datenbankschema ist eine grobe Gesamtansicht des gesamten Systems ohne Implementierungsdetails wie Datentypen oder Constraints. Es hilft, den Datenfluss in einem Unternehmen zu verstehen – sowohl für technische als auch nicht-technische Nutzer.
Das logische Schema beschreibt die logische Struktur der Daten in der Datenbank. Es definiert, wie Daten organisiert sind und wie sich die Datenentitäten zueinander verhalten – ohne offenzulegen, wie sie physisch gespeichert werden. Dieser Typ stellt Konsistenz und Integrität sicher, indem er Datentypen und Constraints festlegt, die Eingaben bereits in der Designphase validieren.
Ein physisches Datenbankschema beschreibt, wo die Daten im System liegen. Dazu gehören Dateispeicherorte, Indexierungsstrategien und Speicherformate je Tabelle, um bei großen Datenmengen maximale Performance sicherzustellen.
Beim Organisieren von Daten gibt es keine Einheitslösung. Unterschiedliche Data Warehouses haben unterschiedliche Anforderungen und brauchen daher verschiedene Schemata. Zu den gängigsten Stilen zählen Star-Schema, Snowflake-Schema, hierarchisches Schema und relationales Schema.
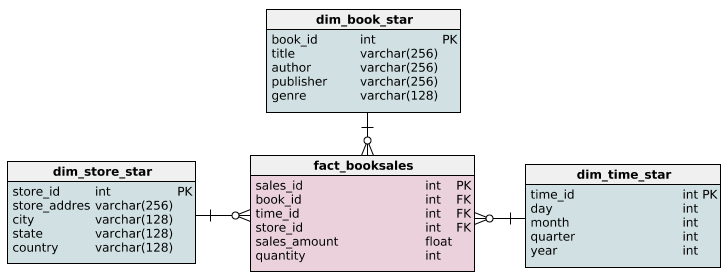
Das Star-Schema strukturiert große Datensätze anhand zweier Grundprinzipien – Fakten und Dimensionen. Fakten sind Geschäftsereignisse, deren Treiber relevant sind, etwa Umsatzzahlen oder Transaktionsvolumina. Dimensionen ergänzen diese Fakten um beschreibenden Kontext, zum Beispiel Zeit, Ort oder Produktdetails.
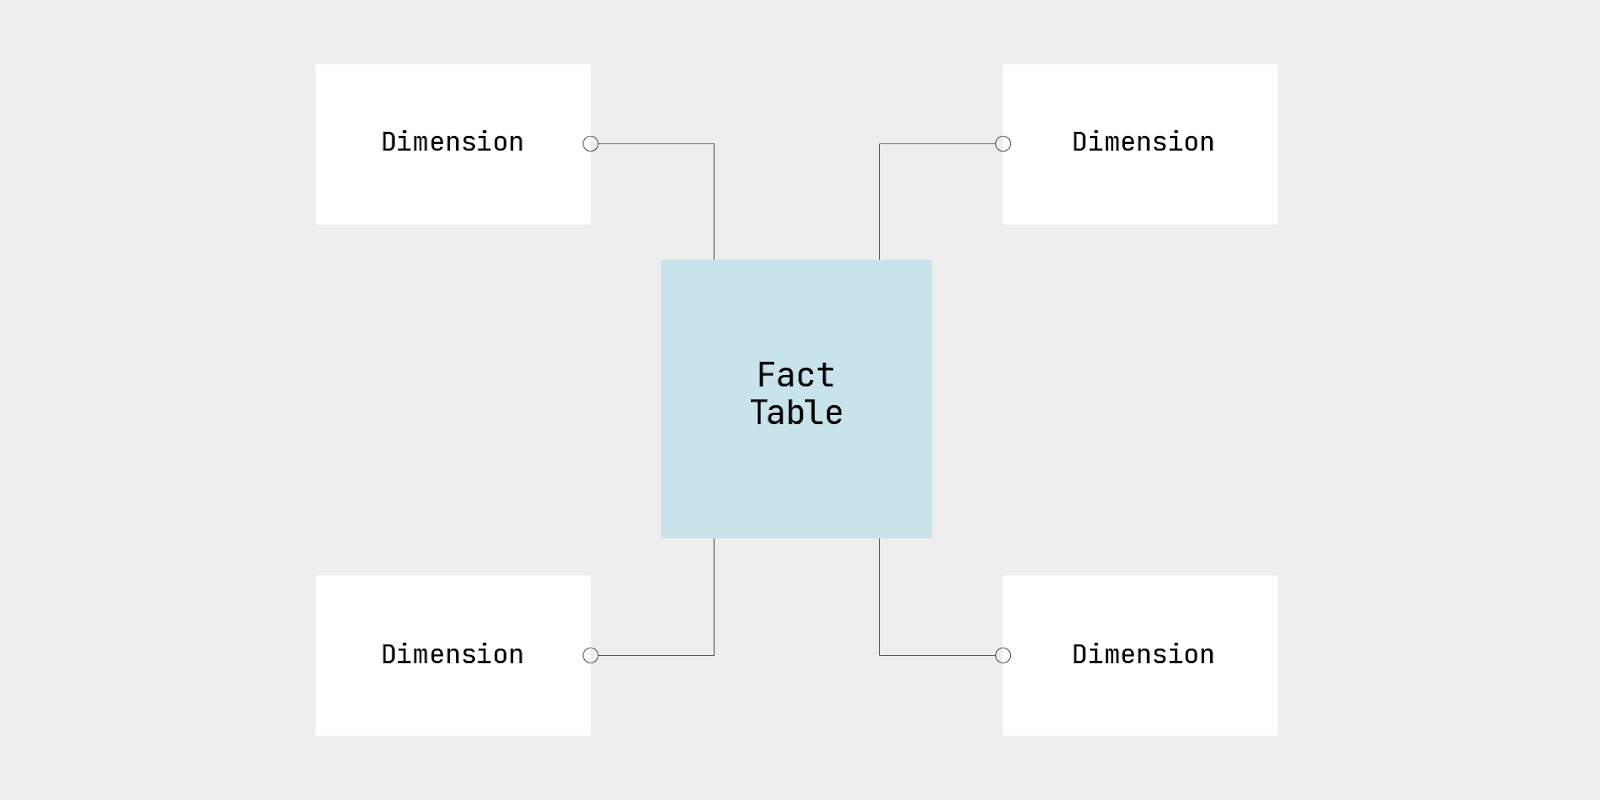
Star-Schema. Bild: Autorin/Autor.
Ein Snowflake-Schema ähnelt dem Star-Schema: Eine zentrale Faktentabelle ist mit mehreren Dimensionstabellen verbunden – mit einem Unterschied. Im Snowflake-Schema sind die Dimensionen nicht flach: Jede Dimensionstabelle wird weiter normalisiert und in mehrere verbundene Tabellen aufgeteilt. Das heißt, Dimensionen werden in kleinere, verknüpfte Tabellen zerlegt.
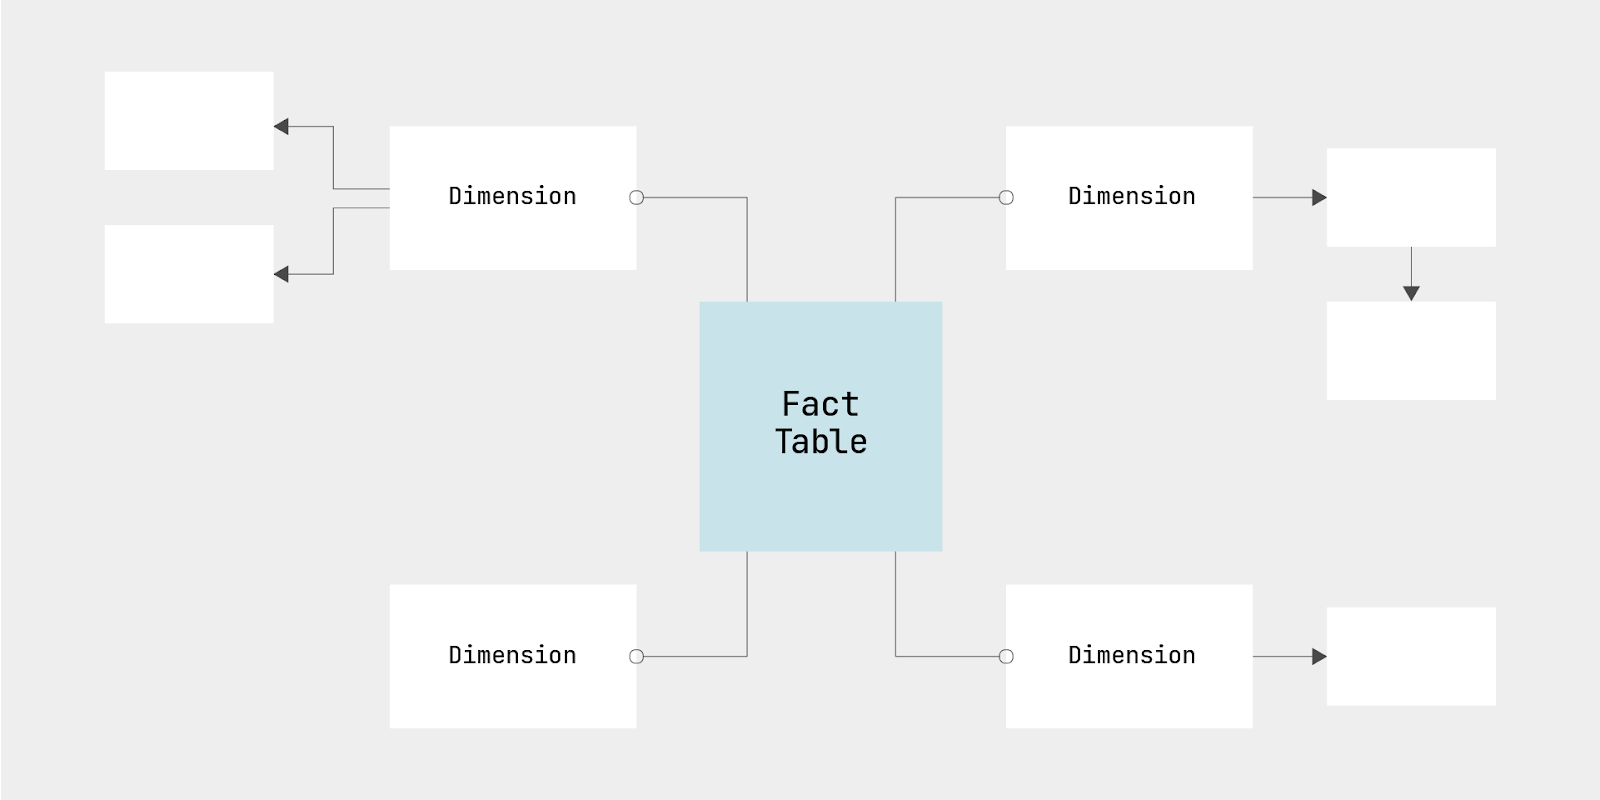
Snowflake-Schema. Bild: Autorin/Autor
Dieses Schema passt besonders gut zu objektorientierten Programmiersprachen, in denen Daten über Objekte wichtiger sind als Logik und Funktionen. In einem relationalen Datenbankschema erhält jedes Objekt eine eigene Tabelle, und diese Tabellen sind miteinander verknüpft.
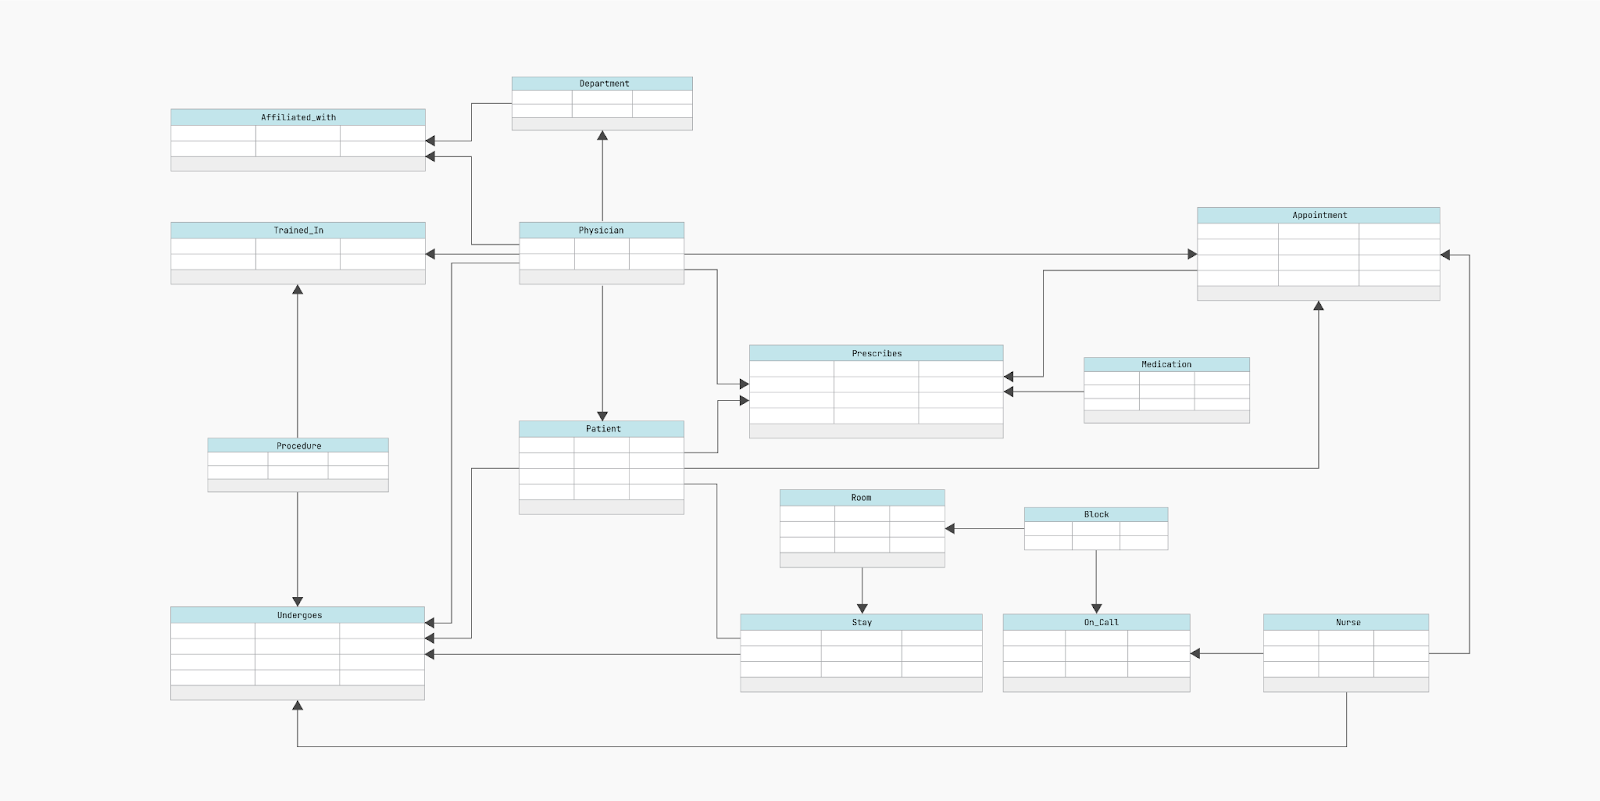
Relationales Datenbankmodell. Bild: Autorin/Autor.
Ein E-Commerce-System hat zum Beispiel Tabellen für Produkte, Kundinnen und Kunden, Bestellungen und Bewertungen – alle miteinander verknüpft. Im Unterschied zum Star- oder Snowflake-Schema gibt es keine zentrale Faktentabelle. Stattdessen sorgen flexible Beziehungen zwischen Objekten für effizientes Verwalten und Abfragen von Daten.
In diesem Schema verbindet eine Wurzeltabelle mehrere Kindtabellen, wobei jedes Kind genau einen Elternknoten hat.
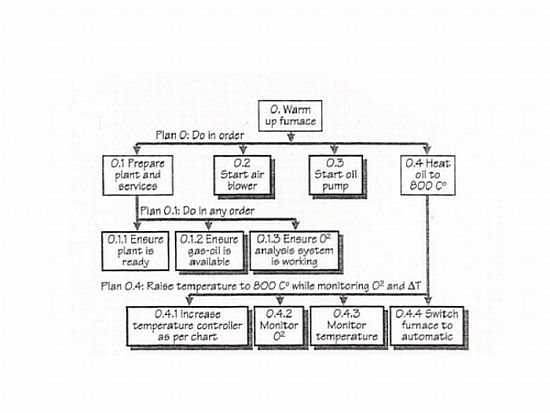
Hierarchisches Datenbankschema. Quelle: Wikipedia
In einem Hochschulsystem könnte eine Wurzeltabelle die Fachbereiche enthalten. Jeder Fachbereich ist mit Kindtabellen für Professorinnen/Professoren und Kurse verknüpft. Professorinnen/Professoren gehören genau einem Fachbereich an, Kurse sind einer bestimmten Person zugeordnet. Die Struktur erleichtert den Zugriff auf häufig benötigte Daten wie Stundenpläne und Profildetails.
Datenbankschemata verbessern die Gesamtleistung und Sicherheit, indem sie Beziehungen, Constraints und Datenspeicherung klar definieren. Zu den wichtigsten Vorteilen gut entworfener Schemata zählen:
Diese Schritte gehören zum Design eines Datenbankschemas.
Bestimme zunächst den Hauptzweck der Datenbank: Welche Daten soll sie enthalten und wer nutzt sie? Beziehe Stakeholder ein, um Anforderungen im Detail zu erfassen – benötigte Daten, typische Abfragen und zu erzeugende Reports. So definierst du einen klaren Projektumfang und stellst sicher, dass die Datenbank die Bedürfnisse der Nutzer erfüllt, ohne unnötige Komplexität.
Auf Basis der Anforderungen erstellst du eine konzeptionelle Sicht bzw. ein Modell deiner Datenbank. Dazu eignet sich ein Entity-Relationship-Diagramm (ERD), das zeigt, wie sich Tabellen bzw. Entitäten innerhalb des Schemas zueinander verhalten.
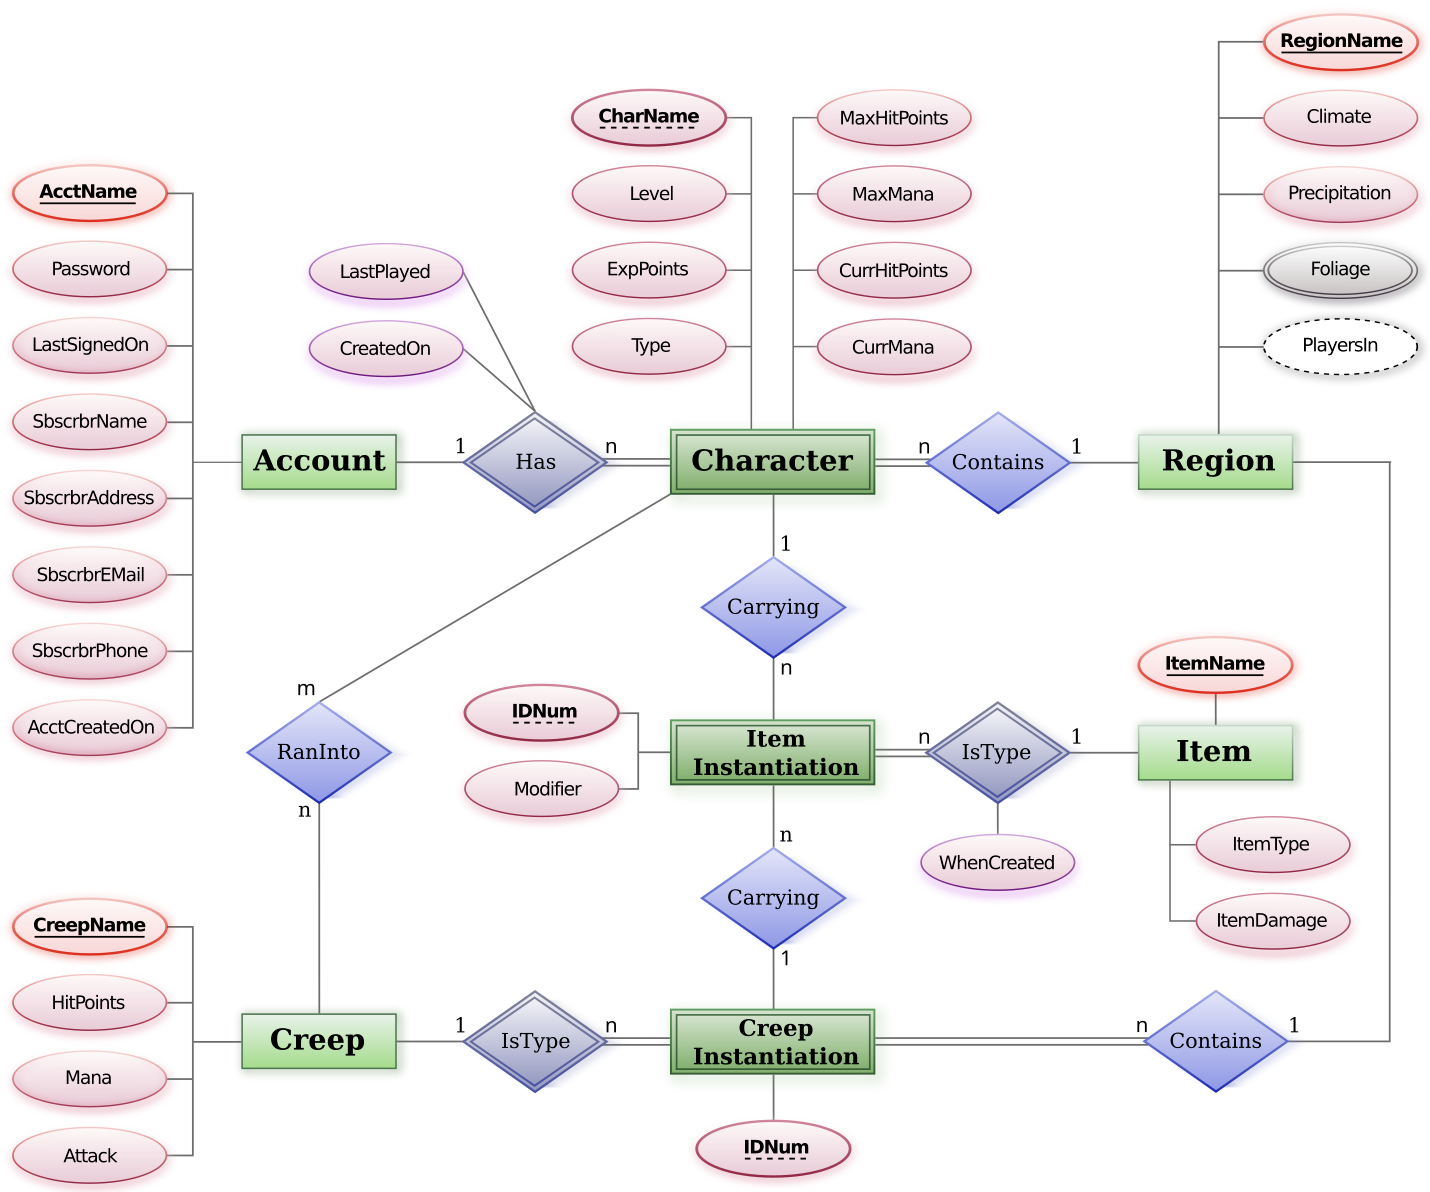
Beispiel für ein Entity-Relationship-Diagramm. Quelle: Wikimedia Commons
Zwischen Entitäten gibt es drei Arten von Beziehungen:
Organisiere deine Daten anschließend in Tabellen. Lege für jede Entität eine Tabelle an und definiere die Spalten für die zugehörigen Attribute. Vergib für jede Tabelle einen Primärschlüssel, damit jeder Datensatz eine eindeutige ID hat und sich Daten leicht abrufen lassen.
Normalisierung optimiert Daten, indem sie Redundanzen reduziert und Integrität verbessert. Es gibt mehrere Normalformen (1NF, 2NF, 3NF, BCNF und weitere), in der Praxis normalisierst du in der Regel bis zur dritten Normalform (3NF).
Die drei wichtigsten Normalformen und ihr Zweck:
Normalisierung in der Datenbank. Bild: Autorin/Autor
Definiere klar, wer auf die Datenbank zugreifen darf, und welche Rechte gelten – etwa Lesen, Schreiben oder Löschen. So beschränkst du den Zugriff auf autorisierte Personen und verhinderst, dass Unbefugte sensible Daten einsehen oder ändern. Verschlüssele sensible Daten zudem im Ruhezustand und während der Übertragung. Dadurch werden Informationen unlesbar, selbst wenn sie abgefangen werden.
Beim Beschreiben des Datenbankdesigns – also Tabellen, Spalten, Indizes und weiterer Objekte – müssen Namenskonventionen konsistent sein. Namen sollten so aussagekräftig sein, dass sofort klar ist, was eine Tabelle oder Spalte enthält. Das beugt Konflikten vor, wenn du oder Teammitglieder Datenbankoperationen durchführen.
Teste das Schema zum Abschluss gründlich mit Beispieldaten: Führe Operationen und Abfragen aus und bewerte die Performance. Optimiere das Schema anhand des Feedbacks aus dieser Phase. So erkennst und behebst du potenzielle Probleme und stellst sicher, dass dein Schema effizient ist.
Ein gutes Schema ist die Basis für ein effizientes Datenbanksystem. Beim Design treten jedoch oft Herausforderungen auf. Hier sind typische Probleme und wie du sie löst.
Wenn Beziehungen zwischen Tabellen nicht eindeutig sind, werden strukturierte Abfragen unnötig kompliziert. Das verlangsamt die Ausführung und beeinträchtigt die Gesamtperformance der Anwendung. Verwaiste Datensätze und fehlende Konsistenz beim Aktualisieren führen zu Ungenauigkeiten und Qualitätsproblemen. Setze fortgeschrittene Modellierungswerkzeuge wie Graphdatenbanken ein, um transparente, effiziente Beziehungsstrukturen zu definieren und komplexe Verknüpfungen besser zu verwalten.
Datenbanken sind anfällig für SQL-Injection und Datenlecks, die sensible Informationen gefährden können. Schütze deine Daten mit mehrschichtigen Strategien, darunter starke Datenverschlüsselung und KI-gestützte Anomalieerkennung. So lassen sich potenzielle Bedrohungen früh erkennen und eindämmen. Führe zusätzlich regelmäßige Sicherheitsaudits durch, um Risiken kontinuierlich zu überwachen.
Der Normalisierungsgrad beeinflusst die Abfrageleistung und erschwert mitunter die Wartung. Über-Normalisierung kann komplexe Joins erzeugen, Unter-Normalisierung Datenanomalien. Nutze flexible Strategien je nach Zugriffsmustern. Mit Refactoring-Tools prüfst du den aktuellen Normalisierungsstand regelmäßig und passt ihn bei Bedarf an. So erreichst du optimale Performance mit dem richtigen Mix aus normalisierten und denormalisierten Strukturen.
Ohne klare Dokumentation werden Änderungen am Schema riskant und zeitaufwändig. Aktualisiere die Doku daher regelmäßig, damit sie korrekt ist und mit der aktuellen Struktur im Einklang steht.
Schlechte Indizierung führt zu langsamen Abfragen und beeinträchtigt Schreiboperationen. Ohne passende Indizes dauern Suchen unnötig lange. Nutze automatisierte Indexing-Tools wie den Query Store, um Muster zu analysieren und Indizes vorausschauend zu optimieren. Solche Tools passen Indizes mithilfe von Machine-Learning-Algorithmen an Nutzungsmuster an.
Ein durchdachtes Datenbankschema wahrt die Datenintegrität und unterstützt Skalierung, indem es einen stabilen Rahmen für wachsende Datenmengen und steigende Komplexität bietet.
Wenn du dich weiterbilden möchtest, hat DataCamp mehrere hervorragende Kurse. Das Tutorial Managing Databases in PostgreSQL vermittelt praxisnahe Einblicke in PostgreSQL, eines der leistungsfähigsten Open-Source-Datenbanksysteme. Das Tutorial Using PostgreSQL in Python schlägt die Brücke zwischen Datenbankmanagement und Programmierung. Für Datenbankadministratorinnen/-administratoren empfehlen wir den Skill-Lernpfad SQL for Database Administrators. Wer sich für Datenaufbereitung interessiert, sollte unseren Kurs Cleaning Data in PostgreSQL Databases ansehen.
Lerne mit DataCamp
Kurs
Lernpfad
Kurs