
Corso
Modellazione dei dati in Power BI
3 ore
100.9K
Uno schema di database è il progetto della struttura e delle relazioni all’interno di un database. Specifica come i dati saranno organizzati in tabelle, campi, tipi di dato e le relazioni tra questi elementi. Vediamo quali sono i suoi componenti chiave e come contribuiscono allo schema complessivo:
Uno schema di database ben progettato garantisce che i dati siano corretti, che le prestazioni delle query siano ottimizzate e che il tuo database possa supportare la crescita del business.
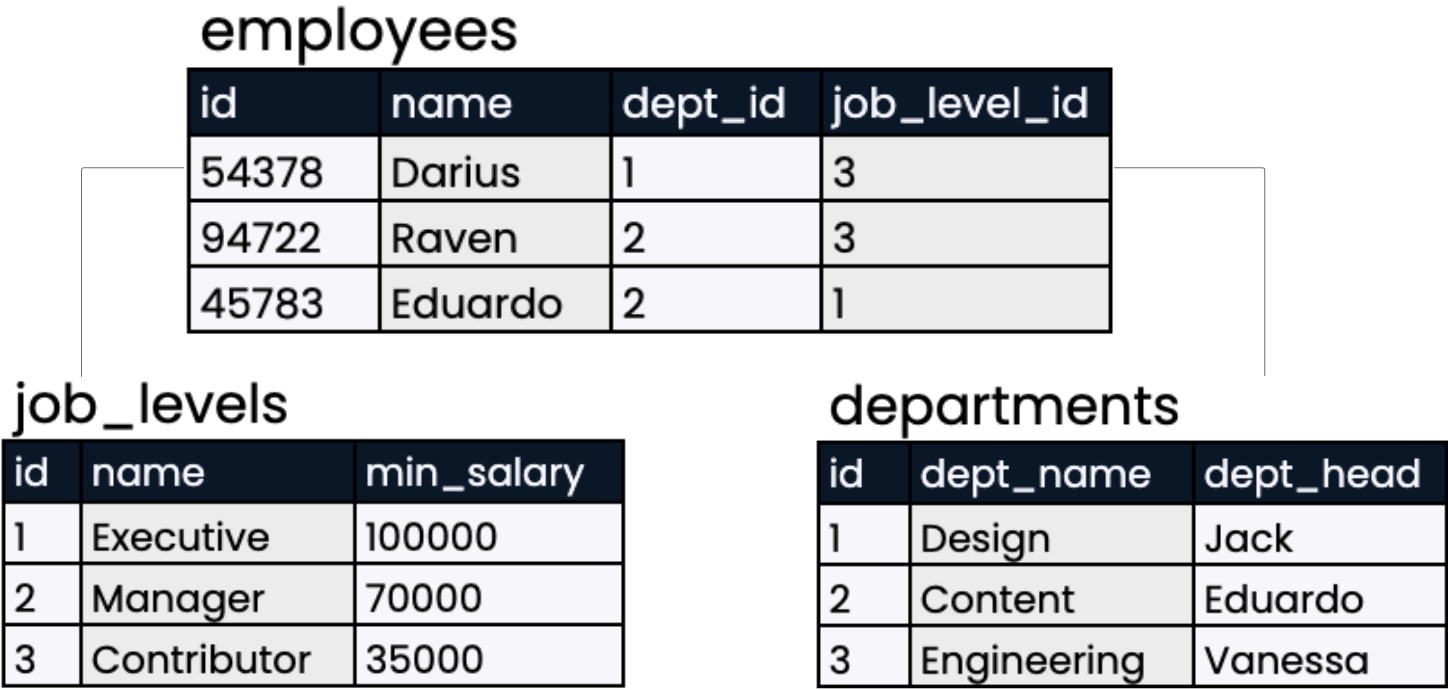
Organizzare i dati in tabelle. Immagine dell’autore
Ma com’è uno schema di database ben progettato? Ecco cosa devi sapere:
Esistono diversi tipi di schemi di database e ognuno serve a uno scopo diverso e offre vari livelli di organizzazione. A volte si parla di schemi in modo informale per descrivere strutture generali di database, altre volte ci si riferisce a elementi architetturali specifici e dettagli di progettazione. Ad alto livello di astrazione, gli schemi di database possono essere classificati in tre tipi: concettuale, logico e fisico.
Uno schema di database concettuale è uno schema di alto livello che fornisce una visione d’insieme dell’intero sistema di database senza mostrare dettagli di implementazione, come tipi di dato o vincoli. Aiuta gli utenti a comprendere il flusso dei dati all’interno di un’organizzazione ed è utile sia per utenti tecnici che non tecnici.
Lo schema logico delinea la struttura logica dei dati nel database. Definisce come i dati sono organizzati e le relazioni tra le entità senza mostrare come sono memorizzati fisicamente. Questo tipo di schema mantiene coerenza e integrità dei dati specificando tipi di dato e vincoli per validare gli inserimenti durante la fase di progettazione del database.
Uno schema di database fisico descrive dove sono collocati i dati in un sistema. Può coprire la posizione dei file, le strategie di indicizzazione e i formati di archiviazione per ciascuna tabella, al fine di garantire le massime prestazioni quando si gestiscono grandi quantità di dati.
Quando si tratta di organizzare i dati, non esiste un approccio valido per tutti. I diversi data warehouse hanno esigenze di business differenti, quindi richiedono schemi di database diversi. Alcuni degli stili più diffusi includono star schema, snowflake schema, schema gerarchico e schema relazionale.
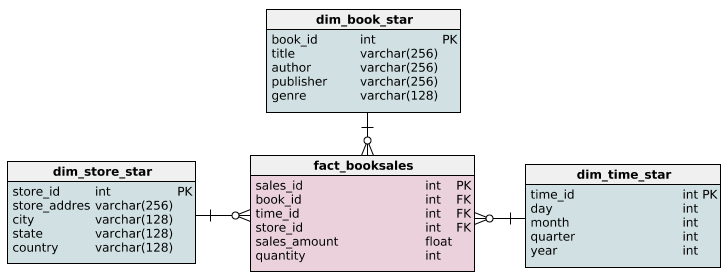
Lo star schema organizza e gestisce grandi set di dati basandosi su due principi essenziali: fatti e dimensioni. I fatti sono come operazioni di business i cui fattori trainanti sono da considerare, come i dati di vendita o i volumi di transazioni. Le dimensioni arricchiscono questi fatti con un contesto descrittivo. Potrebbero essere il tempo, la località o anche i dettagli del prodotto.
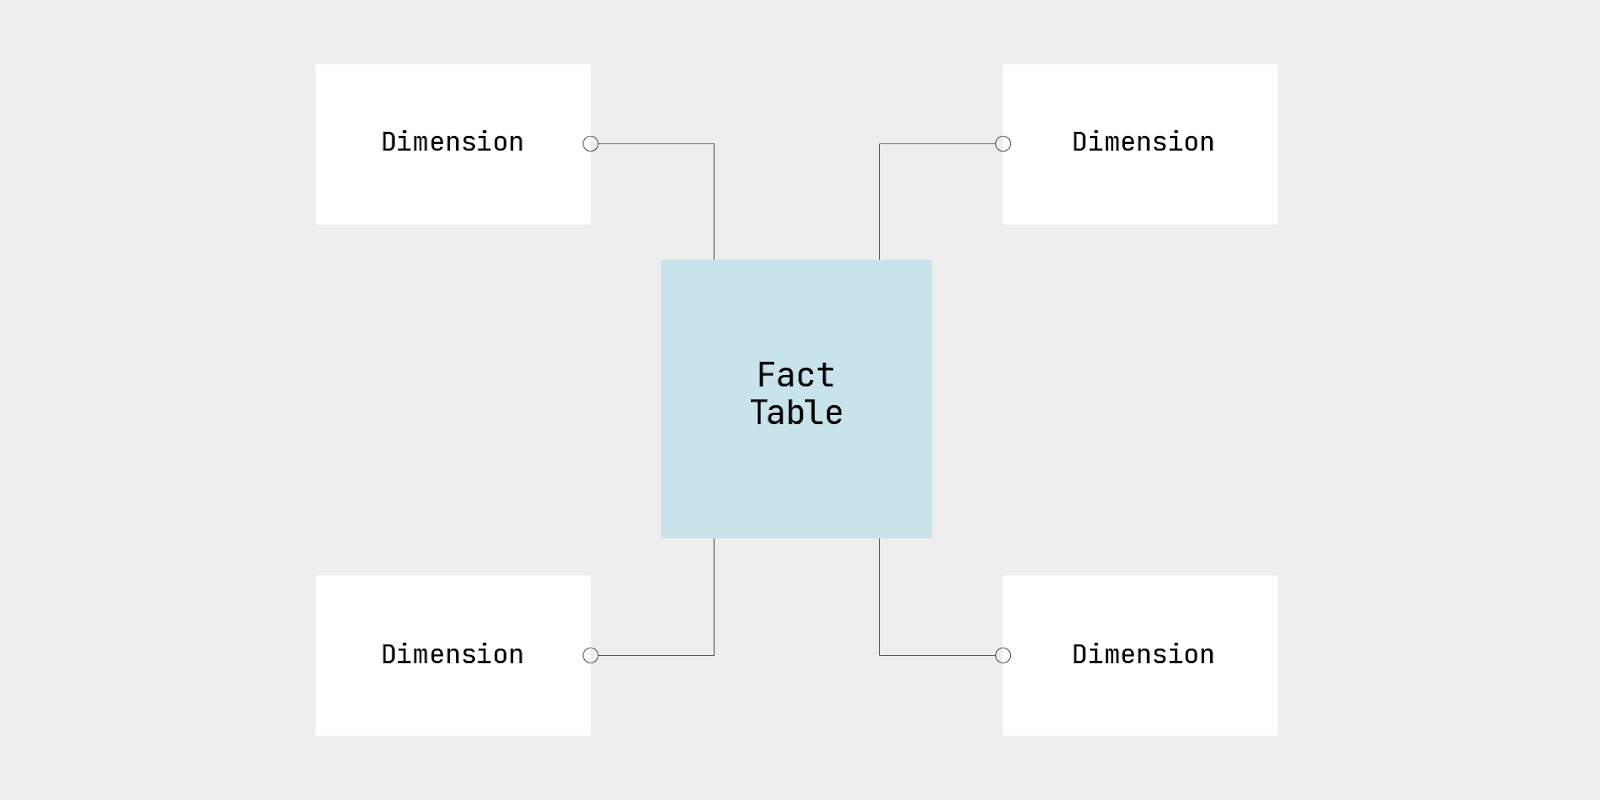
Star schema. Immagine dell’autore.
Uno snowflake schema è simile a uno star schema. Ha una tabella dei fatti centrale collegata a più tabelle delle dimensioni, ma c’è una piccola differenza. Nello snowflake schema, non tutte le dimensioni sono piatte: ogni tabella delle dimensioni è ulteriormente normalizzata in molte tabelle correlate. Ciò significa che ogni tabella delle dimensioni è suddivisa in tabelle più piccole e associate.
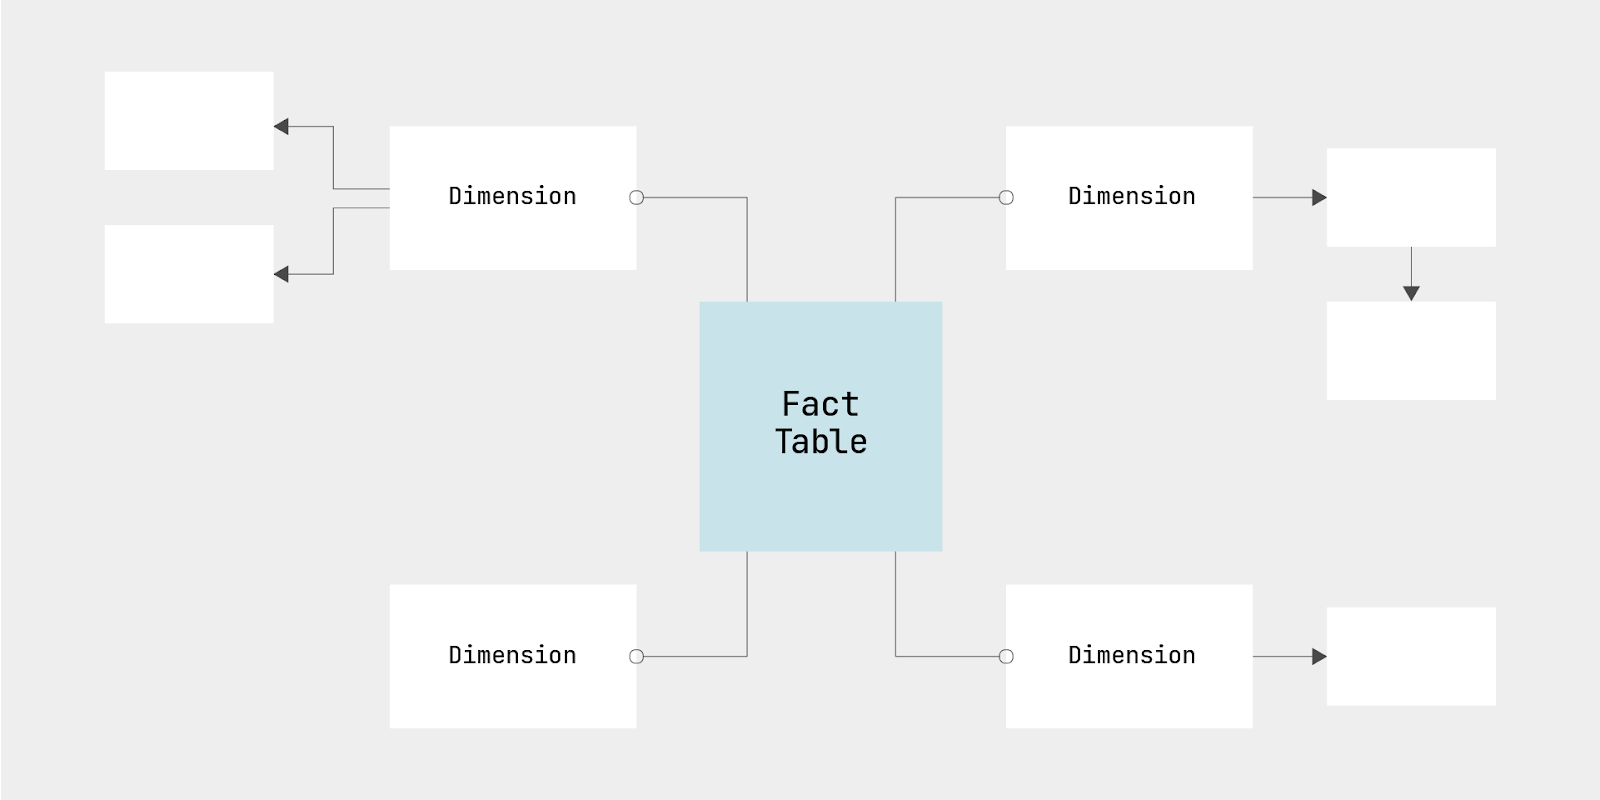
Snowflake schema. Immagine dell’autore
Questo schema è più adatto ai linguaggi di programmazione orientati agli oggetti che considerano i dati sugli oggetti più importanti della logica e delle funzioni. In uno schema di database relazionale, a ogni oggetto viene assegnata la propria tabella e queste tabelle sono tutte collegate tra loro.
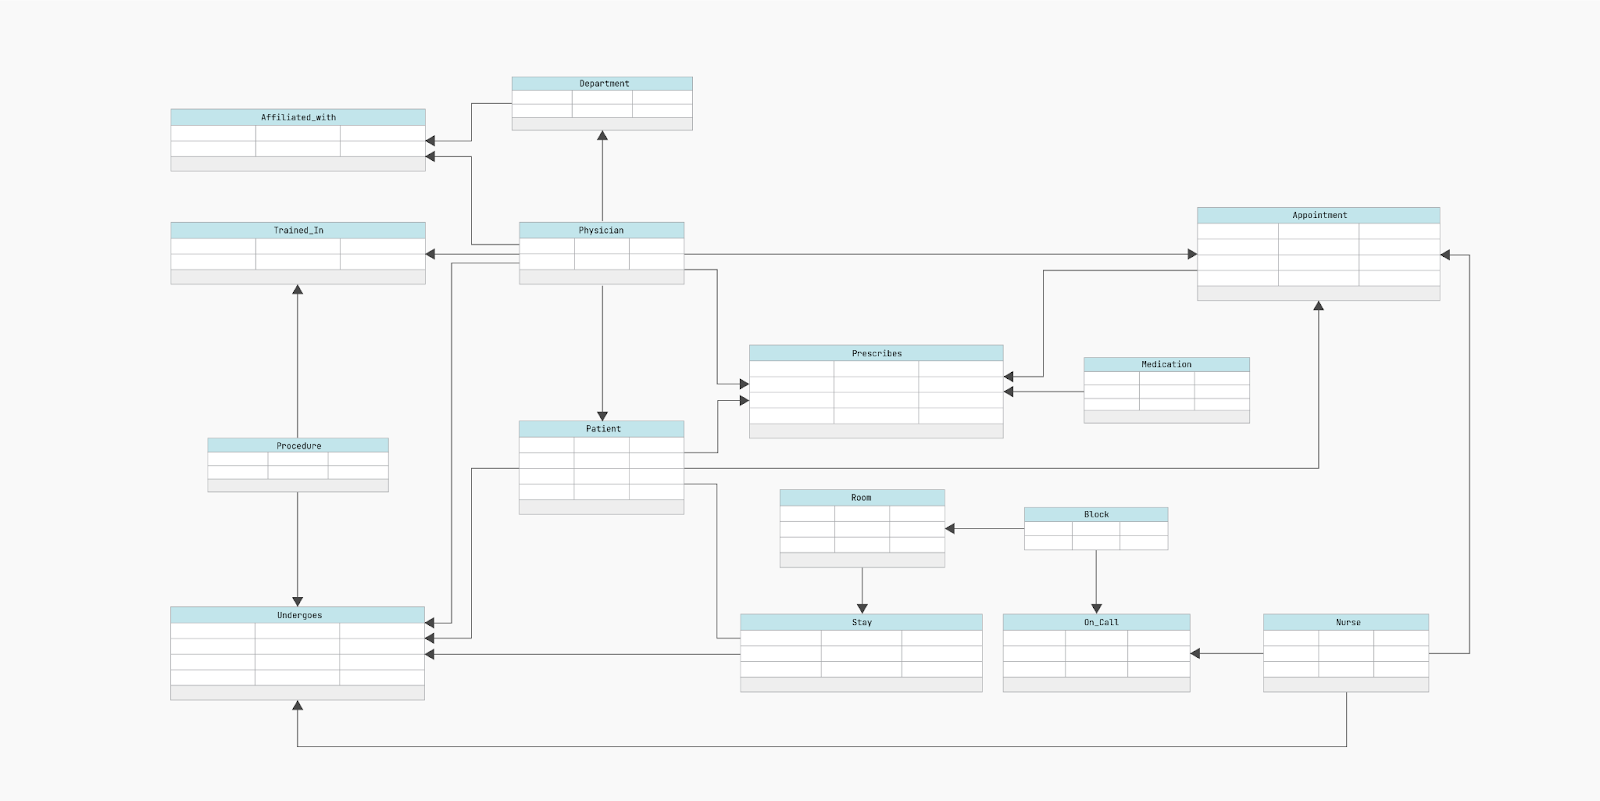
Modello di database relazionale. Immagine dell’autore.
Per esempio, un database di e-commerce ha tabelle con prodotti, clienti, ordini e recensioni: tutte correlate. A differenza dello star o dello snowflake schema, non ha una tabella dei fatti centrale. Invece, presenta relazioni flessibili tra oggetti per aumentare l’efficienza nella gestione e nel recupero dei dati.
In questo schema, una tabella radice si collega a più tabelle figlie, dove ciascun figlio ha esattamente un solo genitore.
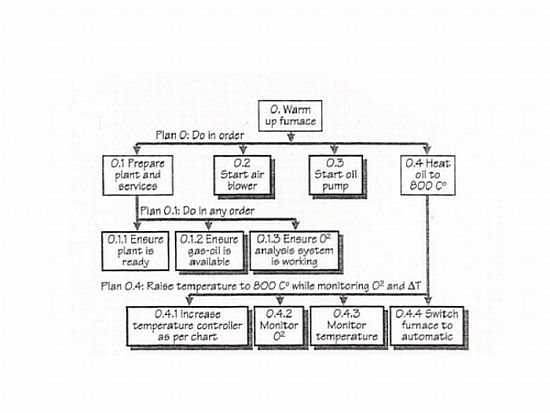
Modello gerarchico di schema di database. Fonte: Wikipedia
Per esempio, in un sistema universitario, una tabella radice potrebbe includere i dipartimenti, con ciascun dipartimento collegato a tabelle figlie per docenti e corsi. I docenti possono appartenere a un solo dipartimento, ma i corsi sono assegnati a un docente specifico. La struttura rende più semplice accedere ai dati usati di frequente, come gli orari dei corsi e i dettagli dei docenti.
Gli schemi di database migliorano le prestazioni e la sicurezza complessive del sistema definendo chiaramente relazioni, vincoli e archiviazione dei dati. Ecco alcuni dei principali vantaggi di schemi di database ben progettati:
I seguenti passaggi sono coinvolti nella progettazione di uno schema per un database.
Per progettare un buon database, per prima cosa devi determinarne lo scopo principale: quali dati conterrà e chi lo utilizzerà. Coinvolgi gli stakeholder per ottenere requisiti dettagliati, inclusi i dati specifici necessari, il tipo di query che verranno eseguite e i report da generare. In questo modo avrai un perimetro di progetto chiaro e potrai assicurarti che il database soddisfi le esigenze degli utenti senza complessità superflue.
Ora che conosci i requisiti, crea una vista o un modello concettuale del tuo database. Puoi farlo utilizzando un Entity Relationship Diagram (ERD), che illustra come le tabelle o entità all’interno di uno schema di database sono correlate.
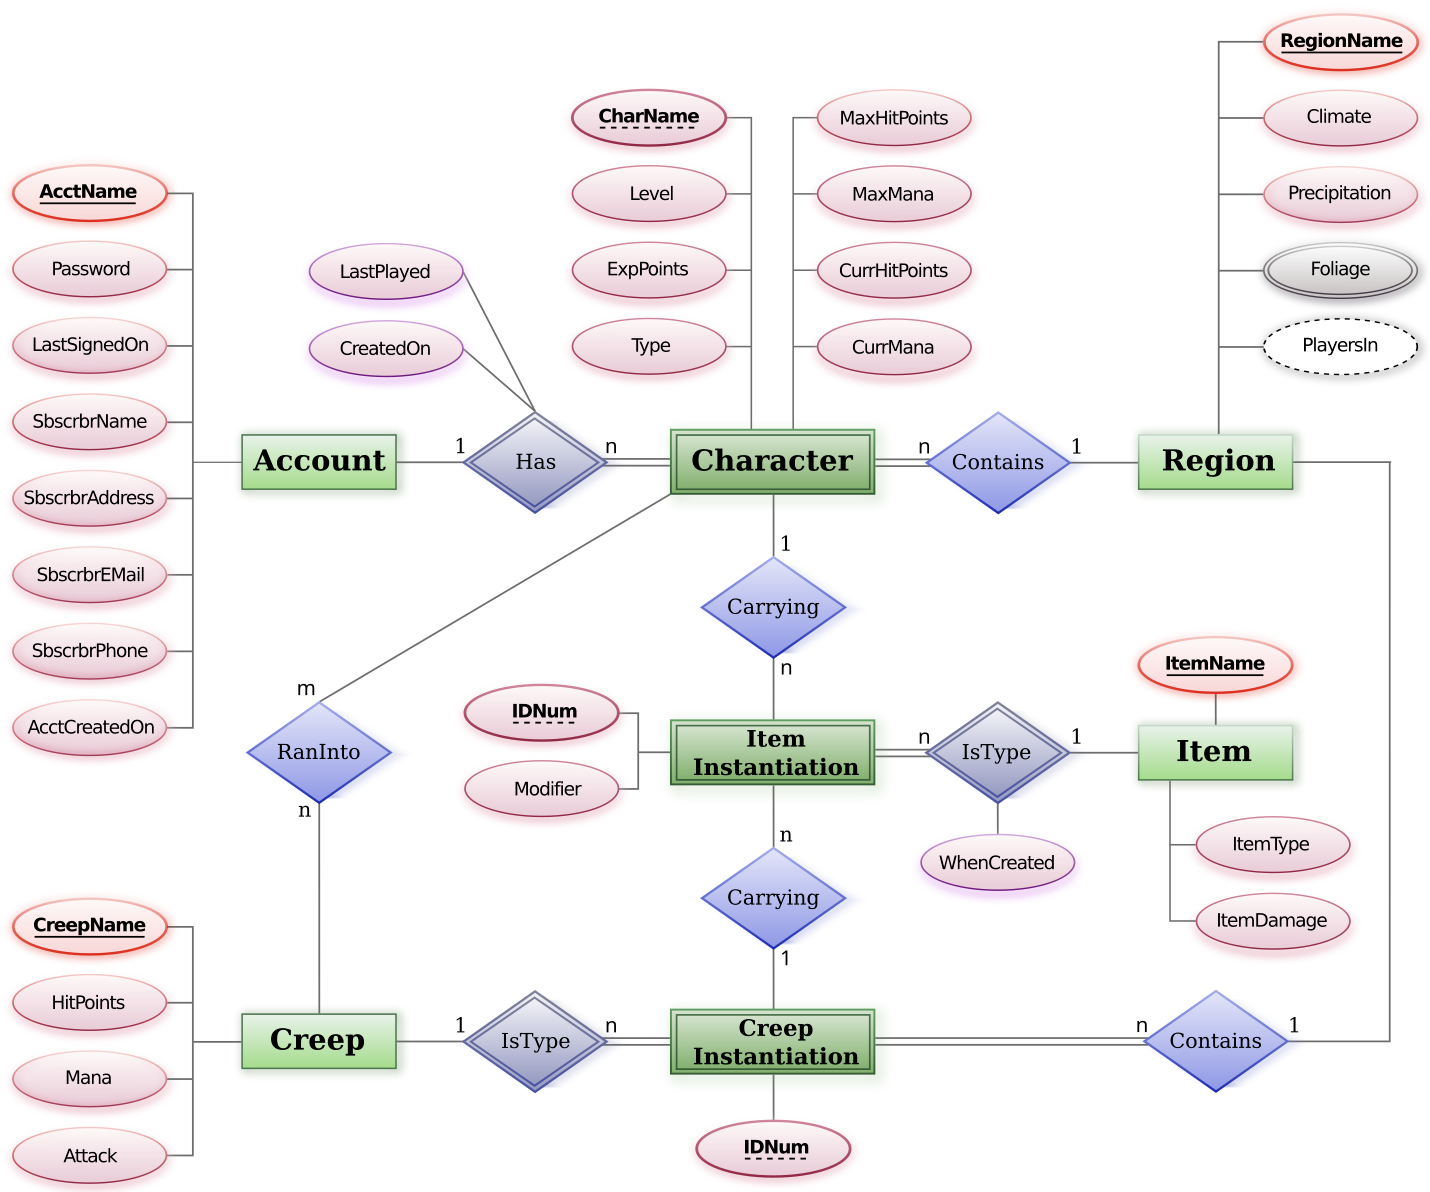
Esempio di diagramma entità-relazioni. Fonte: Wikimedia Commons
Esistono tre tipi di relazioni tra le entità:
Successivamente, organizza i tuoi dati in tabelle. Crea una tabella per ciascuna entità all’interno del database e indica le colonne per contenere ogni attributo relativo a quelle entità. Fornisci a ogni tabella una chiave primaria in modo che ogni record abbia un identificatore univoco e i dati possano essere recuperati facilmente.
La normalizzazione ottimizza i dati all’interno del tuo database riducendo i dati ridondanti e migliorandone l’integrità. Esistono diverse forme normali (1NF, 2NF, 3NF, BCNF e altre), ma dovresti normalizzare fino alla terza forma normale (3NF).
Ecco uno sguardo alle tre forme di normalizzazione e al loro scopo:
Normalizzazione nel database. Immagine dell’autore
Per garantire una sicurezza robusta del database, definisci chiaramente chi può accedervi e specifica i relativi permessi, come diritti di lettura, scrittura o eliminazione. In questo modo limiterai l’accesso ai soli utenti autorizzati ed eviterai che persone non autorizzate visualizzino o modifichino dati sensibili. Inoltre, la cifratura dei dati sensibili a riposo e in transito rafforza ulteriormente la sicurezza offuscando le informazioni, rendendole illeggibili anche se intercettate da utenti non autorizzati.
Nel descrivere il design del database, tabelle, colonne, indici e le altre convenzioni di denominazione degli oggetti devono essere coerenti. I nomi dovrebbero essere sufficientemente descrittivi da suggerire esattamente cosa è contenuto in una tabella o colonna, così che gli utenti possano capire rapidamente senza sforzo. Questo eviterà possibili conflitti mentre tu o altri membri del team eseguite le operazioni sul database.
Una volta completato tutto, testa accuratamente lo schema con dati di esempio per eseguire operazioni e query e valutarne le prestazioni. In base ai riscontri raccolti in questa fase di test, affina e regola lo schema secondo necessità. Questo permetterà di identificare e risolvere potenziali problemi e garantire che il tuo schema di database sia efficiente.
Uno schema ben progettato è la base di un sistema di database efficiente. Tuttavia, progettare uno schema adeguato può presentare diverse sfide. Vediamo quindi quali sono e come risolverle.
Quando le relazioni tra tabelle non sono chiaramente definite, le query strutturate diventano molto complicate. Questo rende l’esecuzione delle query più lenta e influisce sulle prestazioni generali dell’applicazione. Per esempio, record orfani e mancanza di coerenza negli aggiornamenti possono creare inesattezze e problemi di qualità dei dati. Per evitare questi problemi, dovresti implementare strumenti di modellazione avanzati come i graph database per definire strutture di relazione trasparenti ed efficienti e gestire in modo più efficace relazioni complesse.
I database sono vulnerabili a SQL injection e violazioni dei dati, che possono compromettere informazioni sensibili. Per mantenere i dati al sicuro, implementa strategie di sicurezza multilivello, includendo metodi avanzati di cifratura dei dati e sistemi di rilevamento delle anomalie basati sull’IA. Questo aiuterà a identificare e mitigare potenziali minacce. Inoltre, esegui audit di sicurezza regolari per monitorare eventuali rischi.
Diversi livelli di normalizzazione influenzano le prestazioni delle query e complicano la manutenzione. Inoltre, un’eccessiva normalizzazione può creare join complessi, mentre una scarsa normalizzazione può causare anomalie nei dati. Per risolvere questi problemi, dovresti implementare strategie di normalizzazione flessibili basate sui pattern di accesso ai dati. Usa strumenti di refactoring del database per rivedere regolarmente lo stato attuale della normalizzazione e, se necessario, adeguarne il livello. In questo modo, puoi ottenere prestazioni ottimali bilanciando strutture normalizzate e denormalizzate.
Senza una documentazione chiara, le modifiche allo schema del database possono diventare rischiose e richiedere più tempo. Aggiorna regolarmente la documentazione per assicurarti che sia accurata e sincronizzata con le strutture del database più recenti.
Un’indicizzazione scadente può portare a prestazioni lente delle query e influire sulle operazioni di scrittura. Senza indici appropriati, la ricerca nel database richiederà molto tempo. Per superare questa sfida, puoi usare strumenti di indicizzazione automatica come il Query Store per analizzare i pattern delle query e ottimizzare in modo predittivo la creazione degli indici. Questi strumenti dispongono di algoritmi di machine learning che adeguano gli indici in base ai pattern di utilizzo.
Uno schema di database ben strutturato mantiene l’integrità dei dati e supporta la scalabilità fornendo una solida struttura per affrontare l’aumento dei volumi e della complessità dei dati.
Se vuoi migliorare le tue competenze, DataCamp offre diversi ottimi corsi per aiutarti in questo percorso. Il nostro tutorial Managing Databases in PostgreSQL offre indicazioni pratiche su PostgreSQL, uno dei sistemi di database open source più potenti. Il tutorial Using PostgreSQL in Python colma il divario tra gestione dei database e programmazione. Se sei un amministratore di database, puoi iniziare il nostro percorso di competenze SQL for Database Administrators. Chi è interessato alla preparazione dei dati dovrebbe dare un’occhiata al corso Cleaning Data in PostgreSQL Databases.
Impara con DataCamp
Corso
Programma
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min



