
Cursus
Basis van PySpark
4 uur
157.8K
Stel, je beheert een e-commerceplatform dat dagelijks duizenden transacties verwerkt. Je wilt verkooptrends analyseren, omzetgroei volgen en toekomstige inkomsten voorspellen. Traditionele databasequery’s kunnen deze schaal of snelheid niet aan. Je hebt dus een snellere manier nodig om grote datasets te verwerken en realtime inzichten te krijgen.
Apache Spark laadt je enorme hoeveelheden data efficiënt analyseren. In deze tutorial laat ik je zien hoe je Django, MongoDB en Apache Spark met elkaar verbindt om transactiedata van e-commerce te analyseren.
Je zet een Django-project op met MongoDB als database en slaat daar transactiedata in op. Vervolgens gebruik je PySpark, de Python-API voor Apache Spark, om de data te lezen en te filteren. Je voert ook basisberekeningen uit en slaat de verwerkte data op in MongoDB. Tot slot toon je de verwerkte data in je Django-applicatie.
Om het meeste uit deze tutorial te halen, is basiskennis van Python en het Django-webframework handig.
Laten we beginnen.
django-mongodb-backend om Django te verbinden met MongoDB Atlas met native ondersteuning voor ObjectId-primaire sleutelsadmin, auth, contenttypes) met custom app-configs om MongoDB-compatibele velden te gebruikenspark.read.format('mongodb').load() om MongoDB-collecties in PySpark DataFrames te laden.write.format('mongodb').save() en toon resultaten in Django-templatesBegin met het maken van een virtuele omgeving voor je Django-project:
python -m venv venv
source venv/bin/activate
Zorg dat Python 3.10 of hoger is geïnstalleerd in je virtuele omgeving. Installeer daarna Django MongoDB Backend:
pip install django-mongodb-backendMet het bovenstaande commando installeer je ook de nieuwste versies van PyMongo 4.x en Django 5.2.x.
Zodra je Django MongoDB Backend hebt gedownload, maak je een nieuw Django-project:
django-admin startproject pyspark_tutorialNavigeer nu naar de projectmap en start de development server om te controleren of je project goed is opgezet:
cd pyspark_tutorial
python manage.py runserver
Bezoek http://127.0.0.1:8000/ om te verifiëren dat je Django-project succesvol draait.
Standaard gebruikt Django AutoField integer-ID’s voor primaire sleutels, wat goed werkt met SQL-databases. MongoDB gebruikt echter ObjectId voor document-ID’s. Om je modellen compatibel te maken, moet Django primaire sleutels genereren als ObjectId in plaats van integers.
Open pyspark_tutorial/settings.py en wijzig de instelling DEFAULT_AUTO_FIELD:
DEFAULT_AUTO_FIELD = 'django_mongodb_backend.fields.ObjectIdAutoField'Zelfs met deze globale instelling blijven Django’s ingebouwde apps zoals admin, auth en contenttypes standaard op AutoField staan. Maak aangepaste appconfiguraties zodat ze overal consequent ObjectId gebruiken.
Maak een bestand pyspark_tutorial/apps.py en voeg het volgende toe:
from django.contrib.admin.apps import AdminConfig
from django.contrib.auth.apps import AuthConfig
from django.contrib.contenttypes.apps import ContentTypesConfig


class MongoAdminConfig(AdminConfig):
    default_auto_field = 'django_mongodb_backend.fields.ObjectIdAutoField'

class MongoAuthConfig(AuthConfig):
    default_auto_field = 'django_mongodb_backend.fields.ObjectIdAutoField'

class MongoContentTypesConfig(ContentTypesConfig):
    default_auto_field = 'django_mongodb_backend.fields.ObjectIdAutoField'
Werk nu in pyspark_tutorial/settings.py je INSTALLED_APPS-instelling bij:
INSTALLED_APPS = [
    'pyspark_tutorial.apps.MongoAdminConfig',
    'pyspark_tutorial.apps.MongoAuthConfig',
    'pyspark_tutorial.apps.MongoContentTypesConfig',
    'django.contrib.sessions',
    'django.contrib.messages',
    'django.contrib.staticfiles',
]
Omdat alle modellen ObjectIdAutoField moeten gebruiken, heeft elke third-party- en contrib-app die je gebruikt eigen, voor MongoDB specifieke migraties nodig. Voeg daarom het volgende toe aan je pyspark_tutorial/setting.py-bestand:
MIGRATION_MODULES = {
    'admin': 'mongo_migrations.admin',
    'auth': 'mongo_migrations.auth',
    'contenttypes': 'mongo_migrations.contenttypes',
}
Maak een map mongo_migrations in je projectmap, op hetzelfde niveau als je manage.py-bestand. Je mapstructuur zou er nu zo uit moeten zien:
pyspark_tutorial/
├── pyspark_tutorial/
├── mongo_migrations/
└── manage.py
Stop de server met Ctrl + C en genereer vervolgens je migraties:
python manage.py makemigrations admin auth contenttypesAls je je mongo_migrations-map bekijkt, zie je een map voor elke ingebouwde app. Elke map bevat de bijbehorende migraties.
Voor een Django-projecttemplate met alle bovenstaande MongoDB-configuraties voer je het volgende uit:
django-admin startproject pyspark_tutorial --template https://github.com/mongodb-labs/django-mongodb-project/archive/refs/heads/5.2.x.zipLet op: Gebruik je een andere versie van Django dan 5.2.x, vervang dan de twee cijfers zodat ze overeenkomen met de eerste twee cijfers van jouw versie.
De volgende stap is een Django-app maken om je ruwe en verwerkte transactiegegevens op te slaan.
python manage.py startapp salesOm je nieuwe app te configureren voor het gebruik van ObjectId, open je sales/apps.py en vervang je de regel default_auto_field = 'django.db.models.BigAutoField':
from django.apps import AppConfig


class SalesConfig(AppConfig):
    # Use ObjectId as the default primary key field type for MongoDB:
    default_auto_field = 'django_mongodb_backend.fields.ObjectIdAutoField'
    name = 'sales'
Als alternatief kun je de volgende startapp-template gebruiken, waarin bovenstaande wijziging al is opgenomen:
python manage.py startapp sales --template https://github.com/mongodb-labs/django-mongodb-app/archive/refs/heads/5.2.x.zipVoeg nu in pyspark_tutorial/settings.py je sales-app toe aan de lijst INSTALLED_APPS:
INSTALLED_APPS = [
    # Add your sales app:
    'sales.apps.SalesConfig',
    ...
]Omdat je je data in MongoDB gaat opslaan, laat ik je zien hoe je een free-tier deployment maakt op MongoDB Atlas om je data in de cloud op te slaan en te beheren.
Registreer voor een Atlas-account met je Google-account of een e-mailadres.
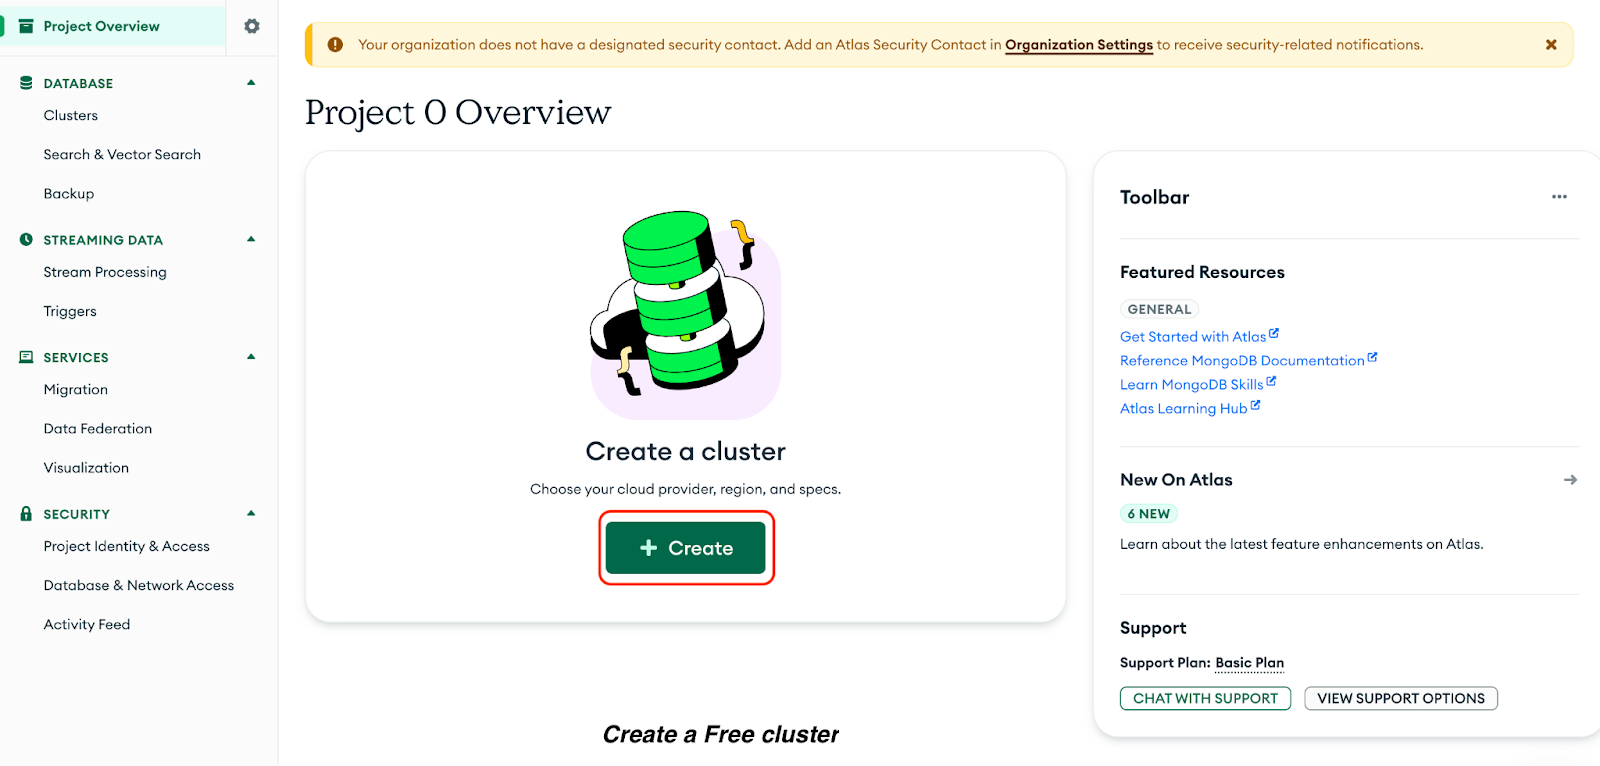
Klik op Create om een Free cluster te maken:
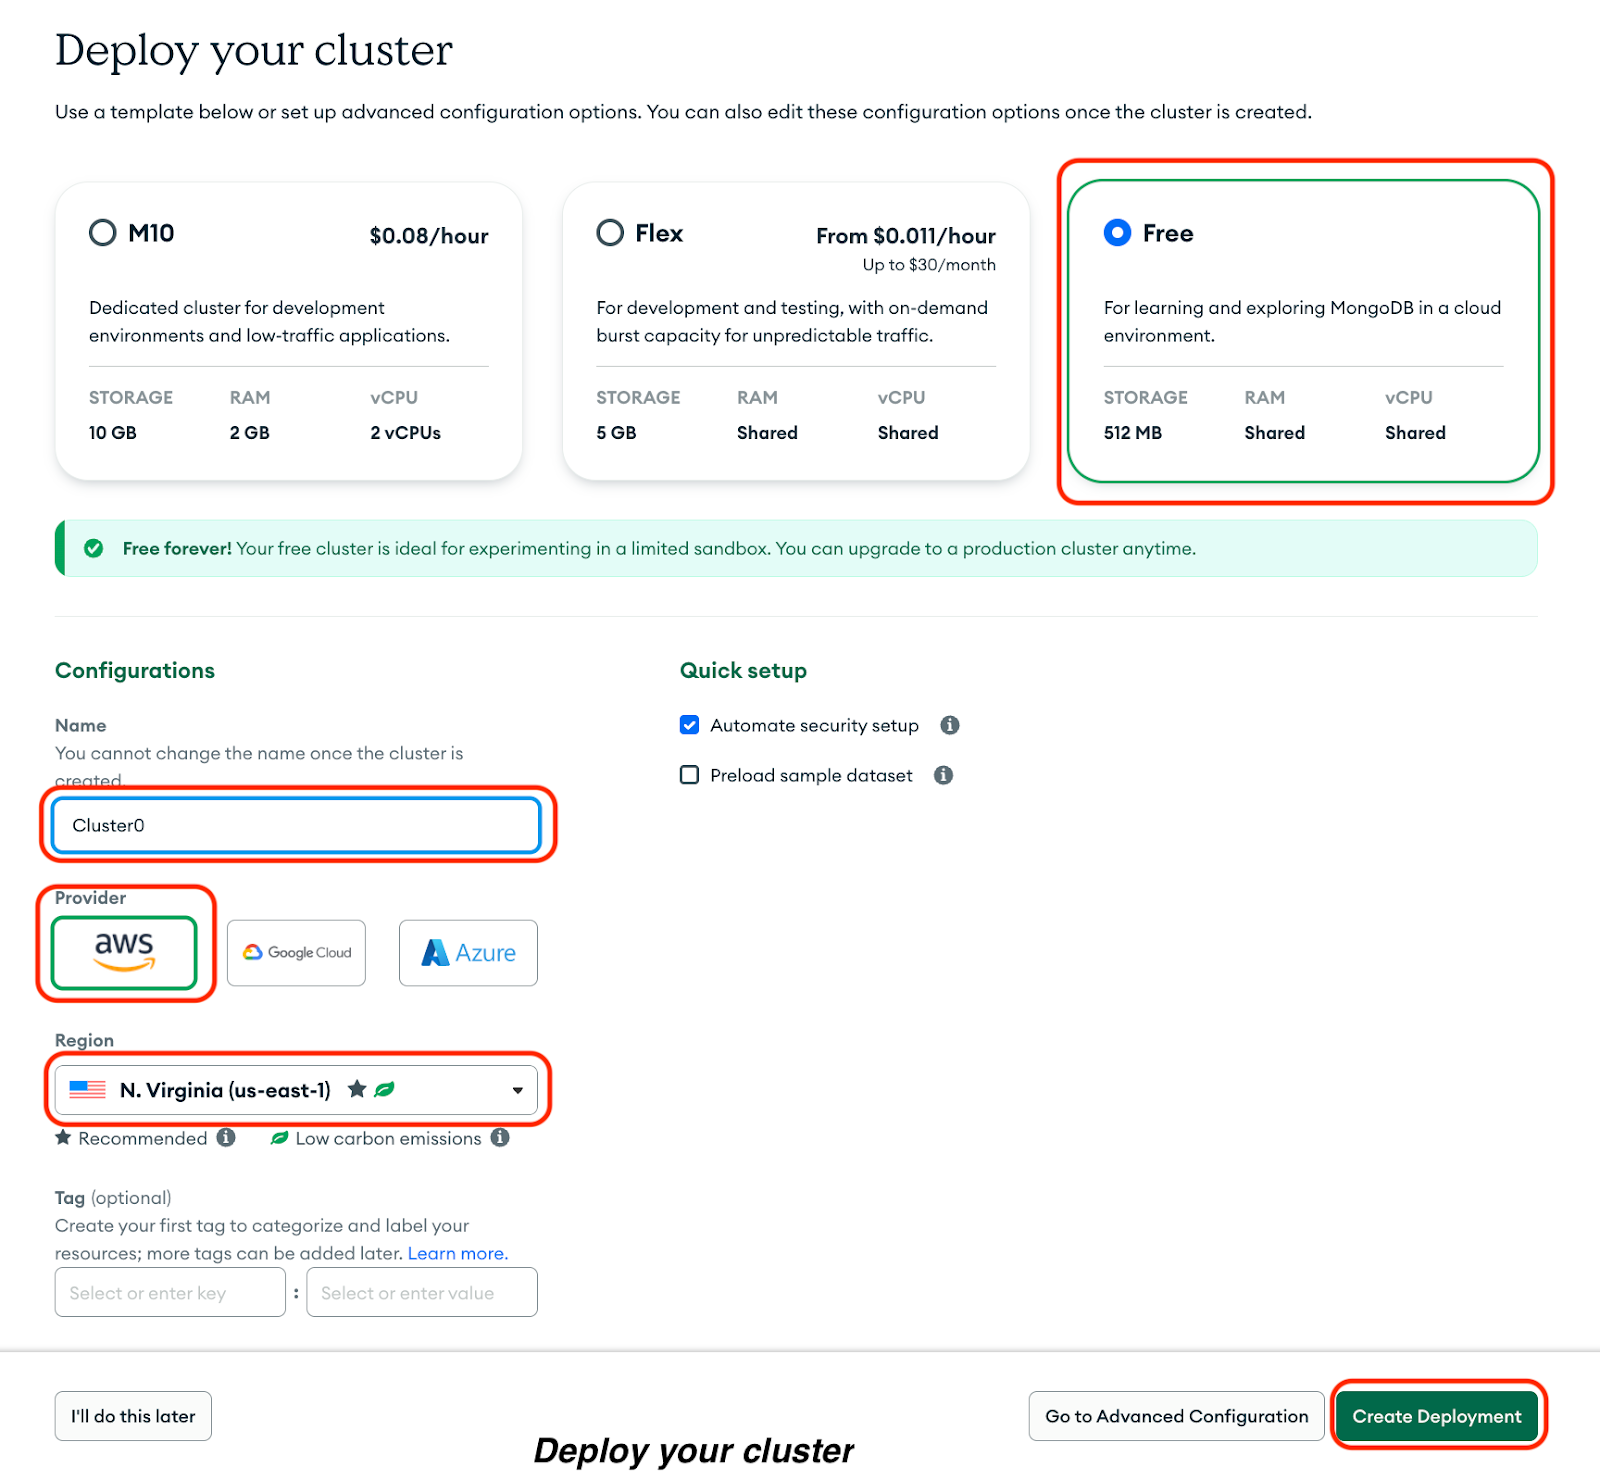
Selecteer op de volgende pagina de volgende opties:
Klik op Create Deployment:
Je ziet nu je gebruikersnaam en wachtwoord. Doe het volgende:
1. Kopieer je gebruikersnaam en wachtwoord naar een veilig document.
2. Klik op Create Database User.
3. Klik op Choose a connection method om een verbindings-IP-adres in te stellen.
Doe het volgende op de volgende pagina:
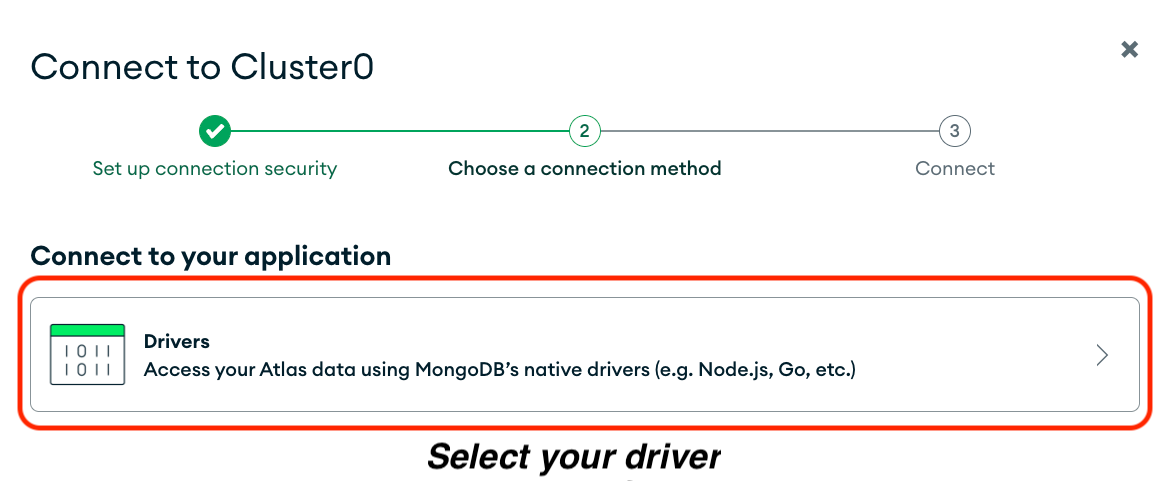
1. Selecteer Drivers.
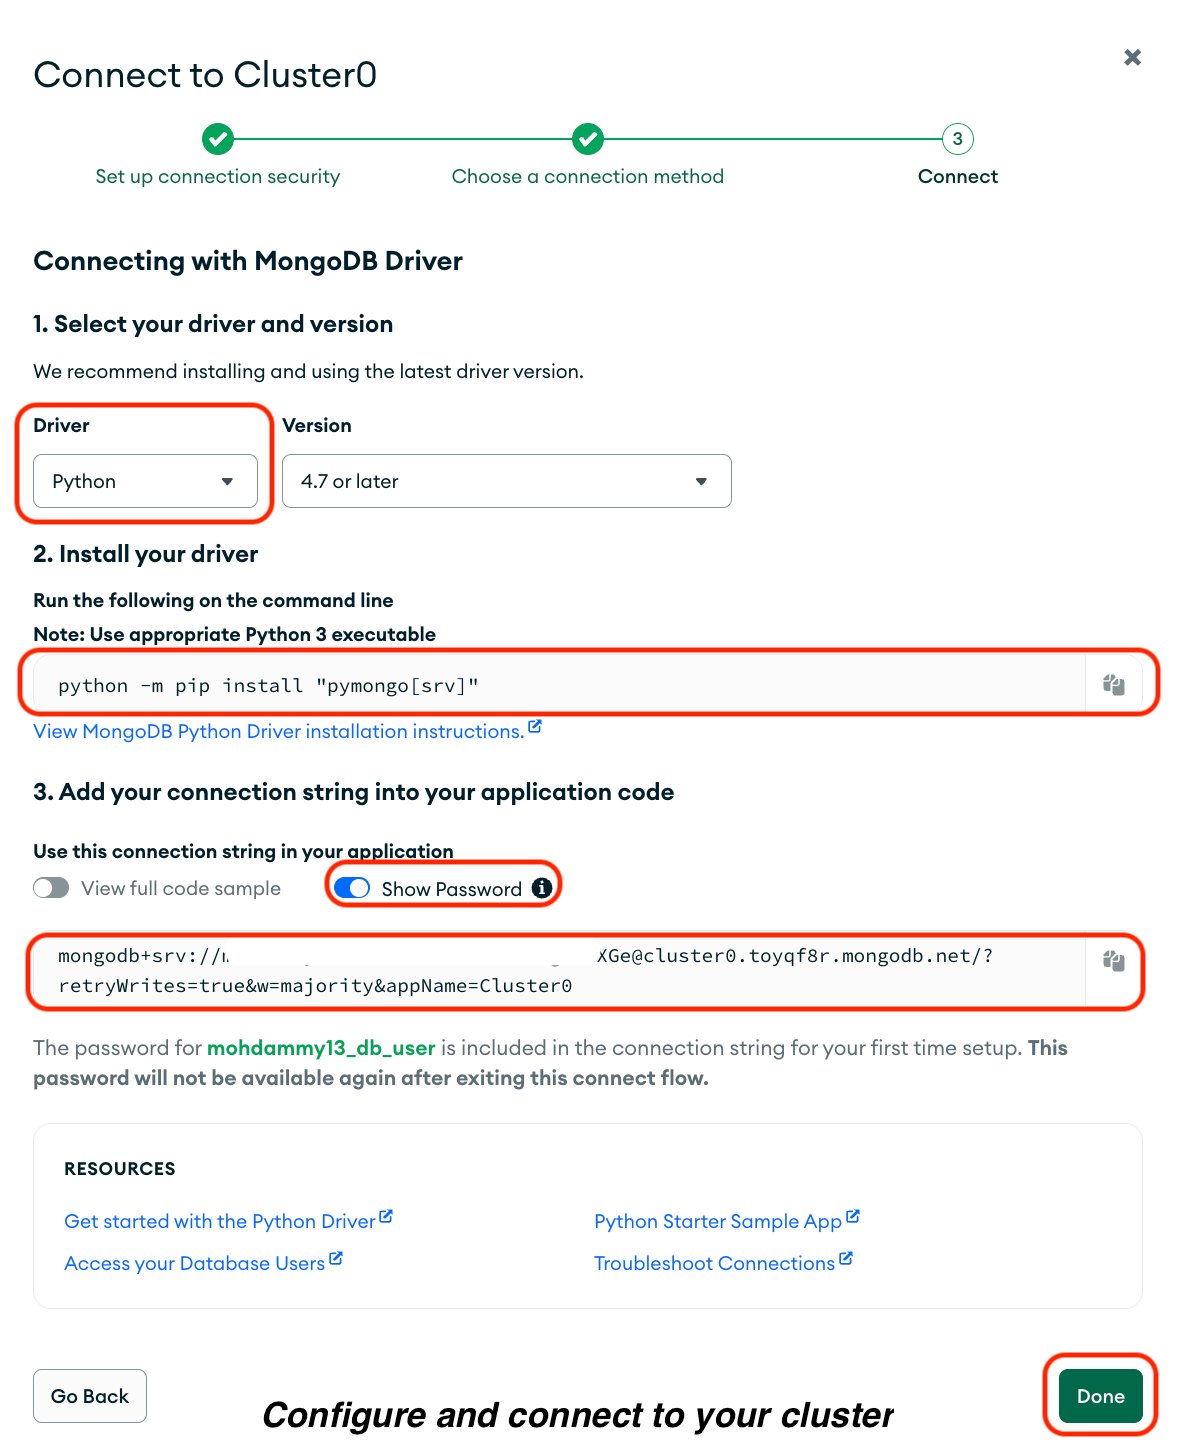
2. Selecteer Python als je driver.
3. Kopieer het commando bij de optie Install your driver en voer dit uit in je terminal.
4. Kopieer je connection string, inclusief je wachtwoord, onder Add your connection string into your application code en sla deze op in een veilig document.
5. Klik op Done.
Open pyspark_tutorial/settings.py en werk de instelling DATABASES bij om Django MongoDB Backend te gebruiken met je opgeslagen connection string. Stel ook een databasenaam in:
DATABASES = {
    'default': {
        # Change to use Django MongoDB Backend:
        'ENGINE': 'django_mongodb_backend',
        # Use your saved connection string:
        'HOST': '<connection string>',
        # Set a database name:
        'NAME': 'pyspark_tutorial',
    },
}
Zorg er in de bovenstaande code voor dat je <connection string> vervangt door je opgeslagen connection string.
Deze configuratie verbindt Django met je MongoDB Atlas-cluster. De ENGINE verwijst naar de MongoDB-backend, HOST bevat je connection string en NAME definieert de databasenaam die Django zal gebruiken.
Nu je app is geconfigureerd, maak je de models, views, URL’s en templates die nodig zijn om transactiedata in je browser te tonen.
Models beschrijven de structuur van je data. Maak een model om transactiegegevens te representeren. Open sales/models.py en vervang de code:
from django.db import models

# Define a model to represent each transaction record:
class Transaction(models.Model):
    order_id = models.CharField(max_length=50, unique=True)
    user_id = models.CharField(max_length=50)
    product = models.CharField(max_length=100)
    price = models.DecimalField(max_digits=10, decimal_places=2)
    quantity = models.PositiveIntegerField()
    timestamp = models.DateTimeField()
    country = models.CharField(max_length=50)

    class Meta:
        # Sort transactions by order ID:
        ordering = ['order_id']
        # Add indexes to improve query performance for common lookup fields
        indexes = [
            models.Index(fields=['timestamp']),
            models.Index(fields=['country']),
            models.Index(fields=['product']),
        ]

    def __str__(self):
        return f'{self.order_id} - {self.product}'

    @property
    def total_amount(self):
        # Calculate and return the total transaction amount:
        return self.price * self.quantity
Dit model definieert elke transactie met velden voor productdetails, prijs, aantal en land. De transacties worden gesorteerd op order_id. Er zijn ook indexen op belangrijke velden voor betere queryprestaties en een property die het totale transactiebedrag berekent.
Views bepalen hoe die records in de browser verschijnen. Maak een view om de transacties weer te geven. Open sales/views.py en vervang de code:
from django.shortcuts import render
from .models import Transaction

# Define a view to display all transactions and total revenue:
def transaction_list_view(request):
    # Retrieve all transaction records from the database:
    transactions = Transaction.objects.all()
    # Calculate the total revenue from all transactions:
    total_revenue = sum(t.total_amount for t in transactions)
    # Render the transaction list template with context data
    return render(request, 'sales/transaction_list.html', {
        'transactions': transactions,
        'total_revenue': total_revenue,
    })
De bovenstaande view haalt alle transacties op uit MongoDB via het Transaction-model. De totale omzet wordt berekend door het total_amount-veld van elke transactie op te tellen. Vervolgens stuurt de view twee waarden naar een transaction_list.html -template, die we later maken:
* transactions: een lijst met alle transactierecords om in een tabel te tonen
* total_revenue: het totale bedrag dat uit alle transacties is gegenereerd
De template gebruikt deze waarden om elke transactie en de totale omzet te tonen.
Je moet routes maken zodat Django weet welke view geladen moet worden wanneer gebruikers een URL bezoeken. Maak een bestand sales/urls.py en voeg het volgende toe:
from django.urls import path
from . import views

# Define URL patterns for the sales app:
urlpatterns = [
    # Route the root URL to the transaction list view:
    path('', views.transaction_list_view, name='transaction_list'),
]
Neem de URL’s van je app op in de URL-configuratie van je project. Open pyspark_tutorial/urls.py en werk het als volgt bij:
from django.contrib import admin
from django.urls import path, include

urlpatterns = [
    path('admin/', admin.site.urls),
    # Include your app’s URLs:
    path("", include('sales.urls')),
]Templates bepalen hoe je data in de browser verschijnt. Maak een map sales/templates/sales en voeg daarin een bestand transaction_list.html toe.
De structuur van je sales-app zou er zo uit moeten zien:
sales/
├── __init__.py
├── admin.py
├── apps.py
├── migrations/
├── models.py
├── views.py
├── tests.py
├── urls.py
└── templates/
   └── sales/
       └── transaction_list.html
Voeg het volgende toe aan je transaction_list.html-bestand:
<!DOCTYPE html>
<html>
<head>
    <title>Transactions</title>
</head>
<body>
    <h1>E-commerce Transactions</h1>
    <h3>Total Revenue: ${{ total_revenue }}</h3>

    <table>
        <thead>
            <tr>
                <th>Order ID</th>
                <th>User ID</th>
                <th>Product</th>
                <th>Price</th>
                <th>Quantity</th>
                <th>Country</th>
                <th>Timestamp</th>
            </tr>
        </thead>
        <tbody>
            {% for t in transactions %}
            <tr>
                <td>{{ t.order_id }}</td>
                <td>{{ t.user_id }}</td>
                <td>{{ t.product }}</td>
                <td>${{ t.price }}</td>
                <td>{{ t.quantity }}</td>
                <td>{{ t.country }}</td>
                <td>{{ t.timestamp }}</td>
            </tr>
            {% empty %}
            <tr><td colspan="7">No transactions available.</td></tr>
            {% endfor %}
        </tbody>
    </table>
</body>
</html>
De bovenstaande template gebruikt de templatingtaal van Django om data die vanuit de view is doorgegeven, dynamisch weer te geven.
Bovenaan wordt de totale omzet getoond met {{ total_revenue }}. Vervolgens doorloopt de template alle transacties in transactions met de {% for t in transactions %}-tag en toont elk record als een rij in de tabel. Elke kolom toont een specifiek attribuut van een transactie, zoals order_id, product, price, quantity en country. Als er geen records zijn, zorgt de {% empty %}-tag ervoor dat de melding “No transactions available” verschijnt in plaats van een lege tabel.
Om je transactiepagina aantrekkelijker en leesbaarder te maken, voeg je aangepaste CSS-styling toe. Django serveert statische bestanden zoals CSS, JavaScript en afbeeldingen via een speciale map genaamd static. Zo blijven ontwerpbestanden gescheiden van je code.
Maak nu een map sales/static/sales en voeg daarin een bestand styles.css toe. De mapstructuur van sales zou er zo uit moeten zien:
sales/
├── __init__.py
├── admin.py
├── apps.py
├── migrations/
├── models.py
├── views.py
├── tests.py
├── urls.py
├── templates/
│   └── sales/
│       └── transaction_list.html
└── static/
   └── sales/
       └── styles.css
Zorg in pyspark_tutorial/settings.py dat STATIC_URL is gedefinieerd:
STATIC_URL = 'static/'Voeg dit toe aan je sales/static/sales/styles.css-bestand:
table {
  width: 100%;
  border-collapse: collapse;
  margin-top: 20px;
}

th, td {
  border: 1px solid #ddd;
  padding: 8px;
  text-align: left;
}

th {
  background-color: #f5f5f5;
}

body {
  font-family: Arial, sans-serif;
  margin: 20px;
}

h1 {
  color: #333;
}

a {
  text-decoration: none;
  color: #007bff;
}
a:hover {
  text-decoration: underline;
}
Vertel tenslotte aan Django dat het de statische bestanden moet laden en neem het CSS-bestand op in je HTML-template.
Voeg bovenaan in sales/templates/sales/transaction_list.html {% load static %} toe en werk vervolgens het <head>-element bij om te linken naar het bestand styles.css:
<!-- Load static files:-->
{% load static %}
<!DOCTYPE html>
<html>
<head>
    <title>Transactions</title>
    <!-- Link the CSS file for styling the template:-->
    <link rel="stylesheet" href="{% static 'sales/styles.css' %}">
</head>Genereer en pas je migraties toe zodat Django de benodigde collecties in MongoDB kan aanmaken:
python manage.py makemigrations
python manage.py migrateLaten we nu de models van je applicatie gebruiken om transactierecords toe te voegen aan je pyspark_tutorial-database via de interactieve Django-shell:
python manage.py shellImporteer vervolgens het Transaction-model uit je sales-app en timezone uit de utilities van Django:
from sales.models import Transaction
from django.utils import timezone
Voeg nu transactierecords in met bulk_create():
Transaction.objects.bulk_create([
    Transaction(order_id='T1001', user_id='U001', product='Laptop', price=1000.00, quantity=1, timestamp=timezone.now(), country='US'),
    Transaction(order_id='T1002', user_id='U002', product='Smartphone', price=800.00, quantity=2, timestamp=timezone.now(), country='NG'),
    Transaction(order_id='T1003', user_id='U003', product='Headphones', price=150.00, quantity=1, timestamp=timezone.now(), country='UK'),
    Transaction(order_id='T1004', user_id='U004', product='Laptop', price=1200.00, quantity=1, timestamp=timezone.now(), country='US'),
    Transaction(order_id='T1005', user_id='U005', product='Keyboard', price=45.00, quantity=3, timestamp=timezone.now(), country='DE'),
    Transaction(order_id='T1006', user_id='U006', product='Monitor', price=300.00, quantity=2, timestamp=timezone.now(), country='FR'),
    Transaction(order_id='T1007', user_id='U007', product='Smartwatch', price=199.00, quantity=1, timestamp=timezone.now(), country='IN'),
    Transaction(order_id='T1008', user_id='U008', product='Speaker', price=150.00, quantity=2, timestamp=timezone.now(), country='CA'),
    Transaction(order_id='T1009', user_id='U009', product='Camera', price=800.00, quantity=1, timestamp=timezone.now(), country='NG'),
    Transaction(order_id='T1010', user_id='U010', product='Tablet', price=350.00, quantity=1, timestamp=timezone.now(), country='UK'),
    Transaction(order_id='T1011', user_id='U011', product='Headphones', price=75.00, quantity=2, timestamp=timezone.now(), country='US'),
    Transaction(order_id='T1012', user_id='U012', product='Laptop', price=1300.00, quantity=1, timestamp=timezone.now(), country='NG'),
    Transaction(order_id='T1013', user_id='U013', product='Mouse', price=30.00, quantity=3, timestamp=timezone.now(), country='IN'),
    Transaction(order_id='T1014', user_id='U014', product='Smartphone', price=950.00, quantity=1, timestamp=timezone.now(), country='KE'),
    Transaction(order_id='T1015', user_id='U015', product='Keyboard', price=55.00, quantity=2, timestamp=timezone.now(), country='CA'),
    Transaction(order_id='T1016', user_id='U016', product='Smartwatch', price=250.00, quantity=1, timestamp=timezone.now(), country='DE'),
    Transaction(order_id='T1017', user_id='U017', product='Speaker', price=180.00, quantity=1, timestamp=timezone.now(), country='FR'),
    Transaction(order_id='T1018', user_id='U018', product='Monitor', price=400.00, quantity=2, timestamp=timezone.now(), country='NG'),
    Transaction(order_id='T1019', user_id='U019', product='Laptop', price=1250.00, quantity=1, timestamp=timezone.now(), country='IN'),
    Transaction(order_id='T1020', user_id='U020', product='Camera', price=780.00, quantity=1, timestamp=timezone.now(), country='US'),
])
Controleer of de records succesvol zijn toegevoegd:
Transaction.objects.count()Als de count 20 teruggeeft, zijn je records succesvol opgeslagen.
Verlaat nu de shell door exit() uit te voeren en start je Django-server om je transacties in de browser te bekijken:
python manage.py runserverBezoek http://127.0.0.1:8000/ om te bevestigen dat je data wordt weergegeven.
Nu je records in je MongoDB-database zijn opgeslagen, gebruik je Apache Spark om je data te verwerken. Apache Spark heeft een Python-API, PySpark, die je in je Django-project kunt gebruiken om grote datasets te verwerken. Ben je nieuw met PySpark, bekijk dan onze PySpark-installatiegids.
Je maakt een Python-script dat PySpark gebruikt om verbinding te maken met MongoDB en je transactierecords te lezen. Je voert basisbewerkingen op deze data uit, zoals filteren. Daarna groepeer je ze per land en bereken je de totale omzet per land. Tot slot schrijf je de verwerkte data weg naar een nieuwe MongoDB-collectie in je database.
Stop je server en installeer de versie van PySpark die compatibel is met de nieuwste MongoDB Spark-connector:
pip install pyspark==3.5.0Controleer of de installatie is gelukt:
pyspark --versionJe zou een melding moeten krijgen die je welkom heet bij Spark.
Maak vervolgens een bestand transactions.py in je projectmap, op hetzelfde niveau als manage.py. Je mapstructuur ziet er nu zo uit:
pyspark_tutorial/
├── mongo_migrations/
├── pyspark_tutorial/
├── sales/
├── manage.py
└── transactions.pyOm PySpark met MongoDB te verbinden, moet je een connection string opbouwen die je databasenaam en collectienaam bevat. Een collectie in MongoDB lijkt op een tabel in relationele databases en slaat gerelateerde documenten op. Je collectienaam bestaat uit je appnaam en modelnaam, gescheiden door een underscore (_).
Gebruik de opgebouwde connection string in je transactions.py -bestand. Het juiste formaat is:
mongodb+srv://<mongodb username>:<mongodb password>@<cluster address>/<database name>.<app name>_<model name>?retryWrites=true&w=majority&appName=Cluster0Hier is de uitleg van de placeholderwaarden:
<mongodb username> en <mongodb password> zijn je MongoDB Atlas-gebruikersnaam en -wachtwoord.<cluster address> is het domein dat in je Atlas-connection string staat—bijvoorbeeld cluster0.2rvn82q.mongodb.net.<database name> is de naam die je je database hebt gegeven in settings.py.<app name>_<model name> is de naam van de collectie die is gegenereerd op basis van je Django-app en -model—bijvoorbeeld sales_transaction.In deze sectie ziet de connection string die je in je PySpark-code gebruikt er zo uit:
mongodb+srv://db_user:password@cluster.mongodb.net/pyspark_tutorial.sales_transaction?retryWrites=true&w=majority&appName=Cluster0Voeg de volgende code toe aan je transactions.py-bestand:
from pyspark.sql import SparkSession

# Initialize SparkSession with MongoDB connector:
spark = SparkSession.builder \
    .appName('ReadTransactions') \
    .config(
        'spark.mongodb.read.connection.uri',
        # Replace with your built MongoDB connection string:
        '<built connection string>'
    ) \
    .config(
        # Add the MongoDB Spark connector package:
        'spark.jars.packages',
        'org.mongodb.spark:mongo-spark-connector_2.12:10.4.1'
    ) \
    .getOrCreate()

# Read data from MongoDB into a Spark DataFrame:
df = spark.read.format('mongodb').load()

# Show result:
df.show()

# Stop the Spark session:
spark.stop()
from pyspark.sql import SparkSession is het startpunt voor het gebruik van PySpark. Hiermee kun je met Spark werken en data-operaties uitvoeren.
De regel spark = SparkSession.builder initialiseert een nieuwe Spark-sessie en geeft deze de naam ReadTransactions. De twee opties .config() bepalen hoe Spark met MongoDB moet verbinden:
spark.mongodb.read.connection.uri: de MongoDB-connection string die aangeeft waar je database zich bevindtspark.jars.packages: downloadt het MongoDB Spark-connectorpakket zodat Spark met MongoDB kan communicerendf = spark.read.format('mongodb').load() laadt alle documenten uit de collectie die in je connection string is gedefinieerd in een PySpark DataFrame, zodat je je data makkelijk kunt opvragen en transformeren..show() toont een preview van je MongoDB-data in tabelvorm direct in de terminal.spark.stop() beëindigt de Spark-applicatie en geeft systeemresources vrij zodra de taak klaar is.Vervang tot slot <built connection string> door je samengestelde MongoDB-connection string. Zorg er ook voor dat je huidige IP-adres op de whitelist staat in je MongoDB Atlas-netwerktoegangslijst voordat je verbinding maakt.
Voer nu python transactions.py uit en je krijgt de opgeslagen transactiegegevens uit je database in je terminal.
Je kunt je records ook filteren met PySpark SQL-functies—bijvoorbeeld om alleen transacties uit Nigeria (NG) te tonen. Pas de code in je transactions.py-bestand aan:
from pyspark.sql import SparkSession

# Import col to reference DataFrame column names:
from pyspark.sql.functions import col

spark = SparkSession.builder \
    .appName('ReadTransactions') \
    .config(
        'spark.mongodb.read.connection.uri',
        # Replace with your built MongoDB connection string:
        '<built connection string>'
    ) \
    .config(
        'spark.jars.packages',
        'org.mongodb.spark:mongo-spark-connector_2.12:10.4.0'
    ) \
    .getOrCreate()

df = spark.read.format('mongodb').load()

# Filter transactions from Nigeria:
ng_df = df.filter(col('country') == 'NG')

# Show filtered results:
ng_df.show()

# Stop the Spark session:
spark.stop()
Voer python transactions.py opnieuw uit en je ziet transacties uit NG.
Je kunt je transactierecords ook groeperen per land en de totale omzet voor elk berekenen. Pas de code in je transactions.py aan:
from pyspark.sql import SparkSession
# Import col to reference DataFrame columns and import sum as _sum to avoid naming conflicts:
from pyspark.sql.functions import col, sum as _sum

spark = SparkSession.builder \
    .appName('ReadTransactions') \
    .config(
        'spark.mongodb.read.connection.uri',
        # Replace with your built MongoDB connection string:
        '<Built Connection String>'
    ) \
    .config(
        'spark.jars.packages',
        'org.mongodb.spark:mongo-spark-connector_2.12:10.4.0'
    ) \
    .getOrCreate()

df = spark.read.format('mongodb').load()

# Calculate total revenue per country:
revenue_per_country = df.groupBy('country').agg(
   _sum(col('price') * col('quantity')).alias('total_revenue')
)

# Show total revenue per country:
revenue_per_country.show()

# Stop the Spark session:
spark.stop()
Voer python transactions.py uit. Je ziet een tabel met de totale omzet per land.
Nu je begrijpt hoe je PySpark gebruikt om je data te lezen en te verwerken, laat ik je zien hoe je de verwerkte data naar een MongoDB-collectie schrijft.
Hier schrijf je het DataFrame met de totale omzet per land weg in een nieuwe collectie.
Pas de code in je transactions.py-bestand aan:
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, sum as _sum

spark = SparkSession.builder \
    .appName('ReadTransactions') \
    .config(
        'spark.mongodb.read.connection.uri',
        # Replace with your built MongoDB connection string:
        '<Built Connection String>'
    ) \
    .config(
        'spark.jars.packages',
        'org.mongodb.spark:mongo-spark-connector_2.12:10.4.0'
    ) \
    .getOrCreate()

df = spark.read.format('mongodb').load()

# Calculate total revenue per country
revenue_per_country = df.groupBy('country').agg(
   _sum(col('price') * col('quantity')).alias('total_revenue')
)

# Write aggregated records into a new MongoDB collection:
revenue_per_country.write \
    .format('mongodb') \
    .mode('overwrite') \
    .option(
        'spark.mongodb.write.connection.uri',
        # Replace with your built MongoDB connection string:
        '<Built Connection String>'
    ) \
    .option(
        # Specify the target database name:
        'spark.mongodb.write.database',
        'pyspark_tutorial'
    ) \
    .option(
        # Specify the target collection name:
        'spark.mongodb.write.collection',
        'revenue_per_country'
    ) \
    .save()

# Stop the Spark session:
spark.stop()
In de bovenstaande code schrijft Spark het geaggregeerde DataFrame, revenue_per_country, naar een nieuwe collectie met de naam revenue_per_country in je pyspark_tutorial-database op MongoDB.
Zorg er tot slot voor dat je '<built connection string>' in beide connectieconfiguraties vervangt door je samengestelde MongoDB-connection string. Voer daarna python transactions.py uit.
Laten we nu je totale omzet per land op een Django-pagina tonen.
Maak eerst een nieuw model voor de omzet per land. Voeg dit toe onderaan je sales/models.py-bestand:
class RevenuePerCountry(models.Model):
    country = models.CharField(max_length=50)
    total_revenue = models.DecimalField(max_digits=15, decimal_places=2)

    class Meta:
        # Define the collection (table) name in MongoDB:
        db_table = 'revenue_per_country'
        # Order results by total_revenue when querying:
        ordering = ['total_revenue']

    def __str__(self):
        # Return a readable string representation of the record:
        return f'{self.country}: ${self.total_revenue}'
Pas daarna je sales/views.py-bestand aan om de collectie revenue_per_country op te halen en weer te geven:
from django.shortcuts import render
from .models import Transaction

# Import the RevenuePerCountry model:
from .models import RevenuePerCountry

def transaction_list_view(request):
    transactions = Transaction.objects.all()
    total_revenue = sum(t.total_amount for t in transactions)
    return render(request, 'sales/transaction_list.html', {
        'transactions': transactions,
        'total_revenue': total_revenue,
    })

# Add a new view to fetch and display your revenue per country:
def revenue_per_country_view(request):
    revenue_per_country = RevenuePerCountry.objects.all()
    return render(request, 'sales/revenue_per_country.html', {'revenue_per_country': revenue_per_country})
Voeg een route naar de nieuwe view toe in sales/urls.py:
from django.urls import path
from . import views

urlpatterns = [
    path('', views.transaction_list_view, name='transaction_list'),

    # Add new URL route:
    path('revenue_per_country/', views.revenue_per_country_view, name='revenue_per_country'),
]
Maak vervolgens een nieuwe template om de totale omzet per land weer te geven.
Maak in de map sales/templates/sales het bestand revenue_per_country.html en voeg het volgende toe:
{% load static %}
<!DOCTYPE html>
<html lang="en">
<head>
    <title>Transactions</title>
    <link rel="stylesheet" href="{% static 'sales/styles.css' %}">
</head>
<body>
    <h1>Total Revenue by Country</h1>
    <a href="{% url 'transaction_list' %}">← Back to Transactions</a>
    <table>
        <tr>
            <th>Country</th>
            <th>Total Revenue (USD)</th>
        </tr>
        {% for r in revenue_per_country %}
        <tr>
            <td>{{ r.country }}</td>
            <td>${{ r.total_revenue|floatformat:2 }}</td>
        </tr>
        {% endfor %}
    </table>
</body>
</html>
Je moet ook de template sales/templates/sales/transaction_list.html aanpassen om een link naar de pagina met omzet per land op te nemen. Voeg de volgende code toe na <h3> maar vóór <table>:
<a href="{% url 'revenue_per_country' %}">View Total Revenue by Country</a>Start de Django-server:
python manage.py runserverGa naar http://127.0.0.1:8000/revenue_per_country/ om te bevestigen dat de nieuwe pagina correct wordt weergegeven.
Gefeliciteerd! Je hebt Apache Spark succesvol gebruikt om je data te verwerken, deze opgeslagen in MongoDB en de verwerkte data op een webpagina met Django weergegeven.
Topcursussen bij DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

