
50% off DataCamp Premium. 700+ courses, half price. Start learning today.
In de wereld van big data kijken we zelden naar ruwe data. Om data beter behapbaar te maken, is het groeperen en aggregeren van data een veelgebruikte en krachtige bewerking. Wanneer je met gedistribueerde systemen als Apache Spark en Python werkt, stelt PySpark’s groupBy-functie ons in staat om onze gedistribueerde data te verzamelen en samen te vatten. Het weerspiegelt de functionaliteit van SQL’s GROUP BY-clausule, maar is ontworpen om gedistribueerde dataverwerking over enorme datasets efficiënt af te handelen.
PySpark’s groupBy stelt gebruikers in staat data te partitioneren op basis van allerlei kolommen, die vervolgens kunnen worden geaggregeerd tot verschillende maten zoals sommen, gemiddelden, enzovoort. Om dit efficiënt te doen, volgt PySpark het split-apply-combine-paradigma:
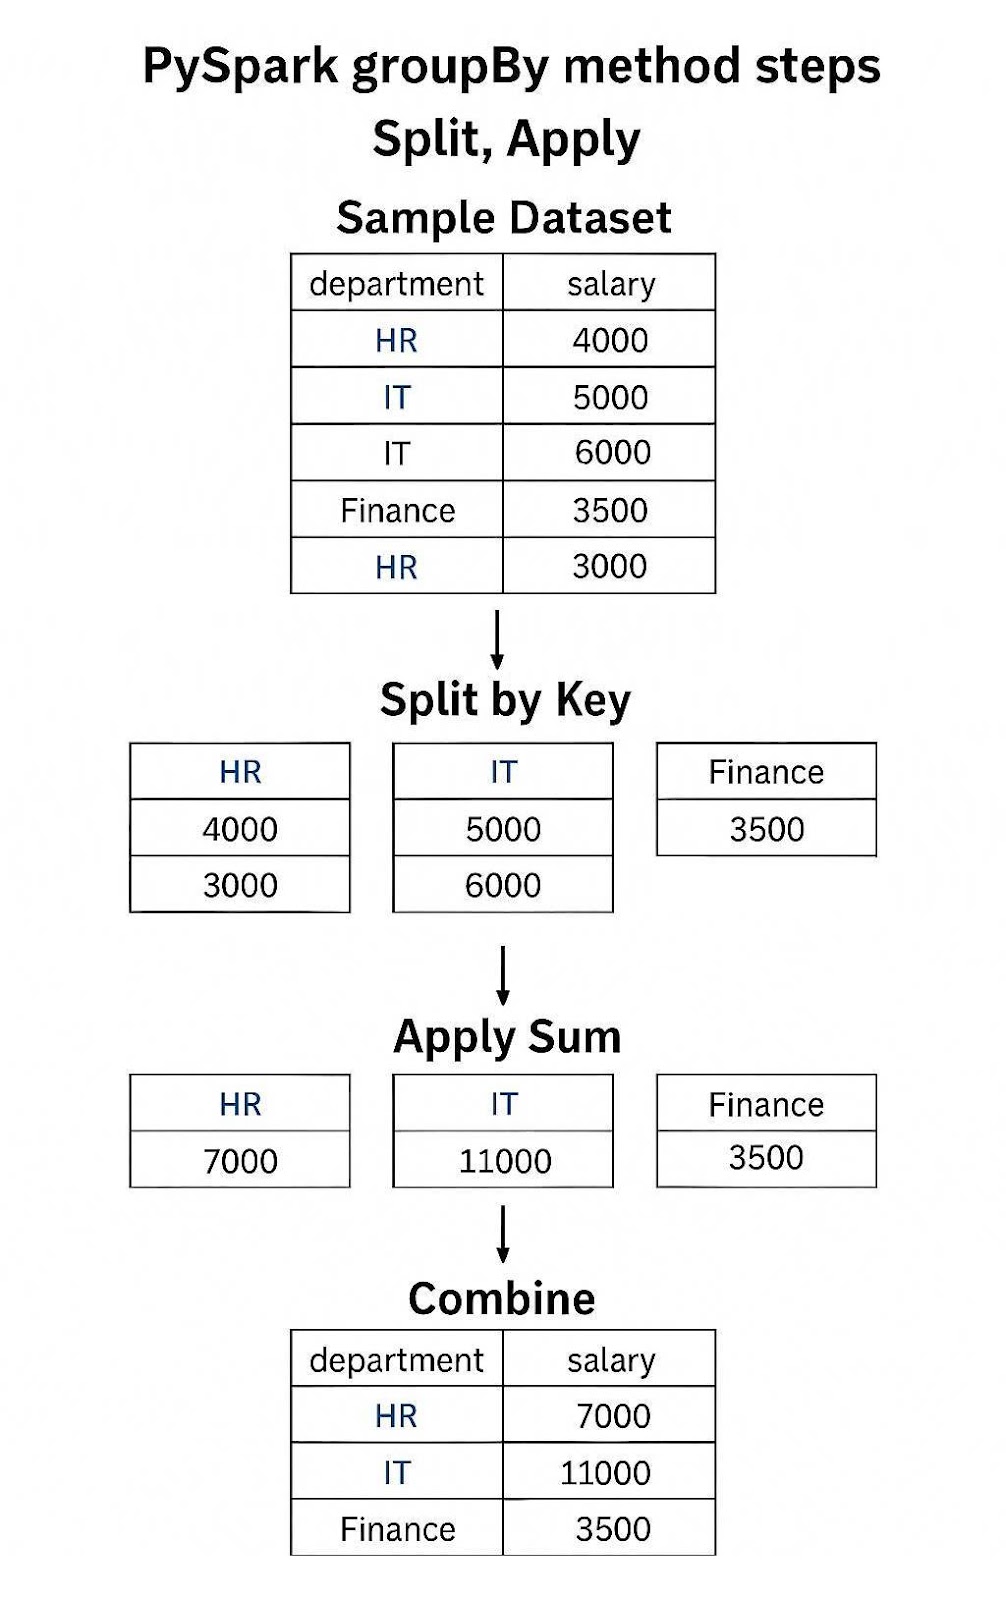
Voorbeeld van PySpark’s groupBy()-methode met Sum
PySpark maakt gebruik van luie evaluatie, wat betekent dat bewerkingen zoals groupBy pas worden uitgevoerd wanneer er acties (zoals show() of collect()) worden aangeroepen. In plaats daarvan bouwt PySpark eerst een initiële DAG (Directed Acyclic Graph) die voor performance wordt verfijnd. Dit helpt Spark om het queryplan te optimaliseren voordat het wordt uitgevoerd.
Als je nog niet met PySpark hebt gewerkt, raad ik je aan om de Big Data Fundamentals with PySpark door te nemen.
Eerst en vooral hebben we een PySpark DataFrame nodig. Heb je een opfrisser nodig van de verschillende PySpark-commando’s, bekijk dan deze handige PySpark DataFrame Cheatsheet.
We lopen een aantal kernstappen en -commando’s door die ons op weg helpen met PySpark. Zorg voordat je begint dat PySpark in je Python-omgeving is geïnstalleerd, evenals Java en de Java JDK. Als je hulp nodig hebt, volg dan deze gids over aan de slag gaan met PySpark.
Stap één is je PySpark aan de praat krijgen!
from pyspark.sql import SparkSession

# Start a SparkSession
spark = SparkSession.builder \
    .appName("GroupByExample") \
.getOrCreate()Laten we een voorbeeld-DataFrame maken om mee te werken.
from pyspark.sql import Row

data = [
    Row(department="Sales", employee="Alice", salary=5000),
    Row(department="Sales", employee="Bob", salary=4800),
    Row(department="HR", employee="Carol", salary=4000),
    Row(department="HR", employee="David", salary=3900),
    Row(department="IT", employee="Eve", salary=6000)
]

df = spark.createDataFrame(data)
df.show()Output:
	+----------+--------+------+
	|department|employee|salary|
	+----------+--------+------+
	|     Sales|   Alice|  5000|
	|     Sales|     Bob|  4800|
	|        HR|   Carol|  4000|
	|        HR|   David|  3900|
	|        IT|     Eve|  6000|
+----------+--------+------+PySpark groupBy is een transformatie die wordt gebruikt om data op te splitsen in groepen op basis van één of meer kolommen, die vervolgens onafhankelijk kunnen worden geaggregeerd of getransformeerd.
De groupBy-methode gebruiken is eenvoudig; je roept deze aan op het dataframe van interesse. Je kunt het op elk kolomtype gebruiken zolang het geschikt is om op te partitioneren. Zo wil je bijvoorbeeld floats vermijden.
grouped = df.groupBy("department")Dit maakt een GroupedData-object aan, wat geen DataFrame op zichzelf is. Het vertelt Spark wel hoe het zou beginnen met het partitioneren van de data. Zodra je dit GroupedData-object hebt, kun je aggregaties toepassen zoals .count() of .sum() om een nieuw DataFrame te verkrijgen.
grouped.count().show()De enige parameter voor de methode is *cols, die kolomnamen, kolomexpressies, kolomindexen (int) of een lijst met kolommen accepteert. Zolang het een kolom is waarop je wilt partitioneren, kun je die gebruiken in de bewerking. De methode retourneert altijd een GroupedData-object.
# grouping by column name like above
	df.groupBy("department")

# grouping by column expression
	df.groupBy(df.department)

#grouping by column ordinal
	df.groupBy(1)

#grouping by list of columns, you can mix the methods!
df.groupBy(["department", 2])Zoals hierboven te zien is, kun je groeperen op één of meerdere kolommen. Een enkele kolom is handig als je alleen geïnteresseerd bent in één as, zoals afdelingen of jaren. Meerdere kolommen zijn handig als je meer lagen detail wilt, bijvoorbeeld specifieke verkopers in verschillende afdelingen, of specifieke maanden binnen een jaar.
# grouping by single column
	df.groupBy("department").sum(“salary”).show()

#grouping by multiple columns
	df.groupBy(["department", 2]).sum(“salary”).show()
Zoals je waarschijnlijk hebt gemerkt, werkt de groupBy-methode erg vergelijkbaar met SQL’s GROUP BY-statements. We laten later ook zien hoe je die taal in PySpark kunt gebruiken.
PySpark ondersteunt een breed scala aan ingebouwde aggregatiemethoden voor gegroepeerde data. Als je bekend bent met SQL, zul je veel ervan herkennen, zoals count(), sum(), avg(), enzovoort. Bekijk onze gids over aggregatiefuncties in SQL als opfrisser.
Laten we de ingebouwde aggregatiefuncties doornemen:
count(): telt het aantal records in deze partitiesum(): somt de totale numerieke waarden opavg(): berekent het gemiddelde van de numerieke waardenmin(): retourneert de kleinste waarde van de partitiemax(): retourneert de grootste waarde van de partitieNaast de aggregatiefuncties kun je de methode .alias() toevoegen om de kolommen te hernoemen zodat ze makkelijker te begrijpen zijn. We laten hieronder een voorbeeld zien.
In plaats van elke aggregatie afzonderlijk uit te voeren, kun je meerdere aggregaties tegelijk doen met de methode agg(). Elke aggregatie maakt een nieuwe kolom aan in je dataframe. Dit vermindert ook de noodzaak voor meerdere groupBy-aanroepen, wat de performance verbetert. We hoeven niet op dezelfde kolom te aggregeren met agg(); je kunt voor elke aggregatiefunctie een andere kolom definiëren.
# After already starting your session
from pyspark.sql import functions as sf

df.groupBy("department").agg(
    sf.count("employee").alias("employee_count"),
    sf.avg("salary").alias("avg_salary"),
    sf.max("salary").alias("max_salary")
).show()Output:
+----------+--------------+----------+----------+
|department|employee_count|avg_salary|max_salary|
+----------+--------------+----------+----------+
|     Sales|             2|    4900.0|      5000|
|        HR|             2|    3950.0|      4000|
|        IT|             1|    6000.0|      6000|
+----------+--------------+----------+----------+Het voordeel van PySpark is de mogelijkheid om geavanceerdere aggregatiepatronen te gebruiken, zoals het pivotten van je data, rollups en het maken van datacubes. Je kunt ook grouping sets maken.
Net als het maken van een draaitabel in Excel kun je je data pivotten op verschillende kolommen. In dit geval groeperen we op department en pivotten we op de kolom employee om het totale salaris van elke werknemer te zien.
Dit betekent dat elke rij de afdeling laat zien, en elke kolom de werknemers van die afdeling. Je ziet hoe dit krachtig kan zijn als we data per jaar hadden en we wilden zien hoe elke afdeling jaar-op-jaar presteerde.
df.groupBy("department").pivot("employee").sum("salary").show()Twee zeer krachtige manieren om data te aggregeren zijn rollup() en cube(). Terwijl een gewone groupby() de resultaten laat zien voor bestaande aggregaties, zijn rollup() en cube() beide hiërarchische structuren. Dat betekent dat ze data op een fijnmaziger niveau aggregeren.
rollup() aggregeert bijvoorbeeld van links naar rechts en toont elke mogelijke permutatie als we de iteraties stap voor stap zouden doorlopen. Voor elke afdeling tonen we elke persoon in de afdeling en ook de uiteindelijke groep van degenen die dat niet zijn.
cube() daarentegen toont alle mogelijke permutaties voor alle geaggregeerde kolommen, dus voor elke afdeling afzonderlijk, elke werknemer afzonderlijk, en elke combinatie van beide.
Samengevat:
Je ziet hieronder een voorbeeld in de code en de output:
rollup() Code:
# using rollup
df.rollup("department", “employee”).sum("salary").show()
rollup() Output:
+----------+--------+-----------+
|department|employee|sum(salary)|
+----------+--------+-----------+
|      NULL|    NULL|      23700|
|     Sales|   Alice|       5000|
|     Sales|    NULL|       9800|
|     Sales|     Bob|       4800|
|        HR|   Carol|       4000|
|        HR|    NULL|       7900|
|        HR|   David|       3900|
|        IT|     Eve|       6000|
|        IT|    NULL|       6000|
+----------+--------+-----------+
cube() Code:
#using cube
df.cube("department", "employee").sum("salary").show()
cube() Output:
+----------+--------+-----------+
|department|employee|sum(salary)|
+----------+--------+-----------+
|      NULL|   Alice|       5000|
|      NULL|    NULL|      23700|
|     Sales|   Alice|       5000|
|     Sales|    NULL|       9800|
|     Sales|     Bob|       4800|
|      NULL|     Bob|       4800|
|      NULL|   Carol|       4000|
|        HR|   Carol|       4000|
|        HR|    NULL|       7900|
|        HR|   David|       3900|
|      NULL|   David|       3900|
|        IT|     Eve|       6000|
|        IT|    NULL|       6000|
|      NULL|     Eve|       6000|
+----------+--------+-----------+
Grouping sets stellen je in staat meerdere aggregatieniveaus te definiëren. In dit voorbeeld aggregeer ik op het niveau van afdeling en werknemer, op afdelingsniveau, en op alle niveaus om het totale salaris te krijgen.
Je ziet dat de syntaxis wat anders is voor de methode groupingSets(). Je definieert eerst de lijst met sets [(“department”, “employee”), (“department”, ), ()] waarbij de eerste set afdeling en werknemer is, de tweede set alleen afdelingen, en de laatste set () alles betekent.
Vervolgens definieer je de aggregatiekolommen binnen de sets. De rest schrijf je zoals gebruikelijk met .agg().
df.groupingSets([("department", "employee"), ("department",), ()], "department","employee").agg(sf.sum("salary")).sort("department","employee").show()Output:
+----------+--------+-----------+
|department|employee|sum(salary)|
+----------+--------+-----------+
|      NULL|    NULL|      23700|
|        HR|    NULL|       7900|
|        HR|   Carol|       4000|
|        HR|   David|       3900|
|        IT|    NULL|       6000|
|        IT|     Eve|       6000|
|     Sales|    NULL|       9800|
|     Sales|   Alice|       5000|
|     Sales|     Bob|       4800|
+----------+--------+-----------+Tot slot kunnen we aangepaste aggregatiefuncties maken met User Defined Functions (UDF’s) in PySpark. Er zijn twee manieren: udf en pandas_udf. Beide stellen je in staat je eigen functies te maken, met voor- en nadelen voor beide.
De standaard Spark-udf stelt je in staat Spark-native functies te maken. Dat betekent dat de syntaxis en datatypes native in Spark moeten werken. Hoewel dit sommige mogelijkheden in de UDF beperkt, kun je zo wel optimaal profiteren van de gedistribueerde rekenkracht van Spark en is het beter voor grotere datasets.
from pyspark.sql.functions import udf
from pyspark.sql.types import IntegerType

@udf(returnType=IntegerType())
def bonus(salary):
    return int(salary * 0.1)

df.withColumn("bonus", bonus(df.salary)).show()
Aan de andere kant stelt pandas_udf je in staat om meer Pythonic, aangepaste functies te maken. Je bent nu alleen gebonden aan wat in Pandas mogelijk is en niet alleen in Spark.
Dat betekent echter dat je niet kunt profiteren van de gedistribueerde rekenkracht van Spark, en je rekent lokaal. Dit past beter bij kleine tot middelgrote datasets.
import pandas as pd
from pyspark.sql.functions import pandas_udf

@pandas_udf("double")
def salary_bonus(s: pd.Series) -> pd.Series:
    return s * 0.1

df.withColumn("bonus", salary_bonus(df.salary)).show()
Kortom, gebruik aangepaste functies alleen als er echt geen betere manieren zijn om de aggregatie uit te voeren. Ga het wiel niet opnieuw uitvinden!
Als iets gevectoriseerd kan worden (zoals onze bovenstaande functies), kies dan voor een gevectoriseerde versie van de functie in plaats van een aggregatie-UDF. Voor meer info over groupBy() lees je dit artikel dat dieper ingaat op het split-apply-combine-framework met pandas.
In PySpark kun je groepen filteren op basis van aggregatiemetrics na het groeperen met de methode filter(). In deze methode geef je een voorwaarde op in Python- of SQL-expressies.
Overigens kun je ook where() gebruiken als je dat liever hebt; dit is simpelweg een alias voor filter() en voert dezelfde bewerking uit.
Je kunt ervoor kiezen om vóór of na de aggregatie te filteren. Filteren vóór de aggregatie beïnvloedt de aggregatie door te beperken welke data wordt geaggregeerd en kan de performance verbeteren.
Misschien willen we bijvoorbeeld alleen het aantal werknemers boven een bepaald salaris tellen om het aantal “hoog-salaris”-werknemers te vinden.
#filter for high salaries
filter_df = df.filter(df.salary > 4000)

#aggregate and find the total of high salary employees
agg_filter_df = filter_df.groupBy("department").agg(sf.count("*").alias("high_salary_emp"))
agg_filter_df.show()
Filteren na de aggregatie daarentegen heeft geen invloed op de oorspronkelijke aggregatie. Misschien willen we alle werknemers in een afdeling tellen en alleen afdelingen boven een bepaalde grootte zien. Dit voegt een extra laag verwerking toe, maar zou de rekenlast niet sterk moeten verhogen.
# creating a dataframe counting the number of employees
agg_df = df.groupBy("department").agg(sf.count("*").alias("num_employees"))

# filtering for departments where there is more than 1 employee
agg_df.where("num_employees > 1").show()
Kies wijs wanneer je filtert, want het beïnvloedt de nauwkeurigheid en het eindresultaat. Filteren vóór kan de uiteindelijke totalen verlagen, terwijl filteren na mogelijk te veel in het eindantwoord laat staan.
Hoewel PySpark de groupBy-bewerking automatisch optimaliseert, zijn er strategieën die de verwerkingssnelheid verder kunnen verbeteren. Zaken als het minimaliseren van data shuffle, het mitigeren van skew en het optimaliseren van uitvoering spelen allemaal een rol bij het verbeteren van de groupBy-performance.
groupBy veroorzaakt een shuffle, die data over partities herverdeelt om vergelijkbare sleutels bij elkaar te brengen. Shuffles belasten netwerk en schijf zwaar, dus het minimaliseren of optimaliseren ervan is cruciaal. Enkele belangrijke optimalisatietechnieken:
repartition() verstandig; je kunt PySpark aangeven op welke kolom de data gepartitioneerd moet worden zodat het op minder plekken hoeft te zoeken.Hier zijn enkele voorbeelden om shufflebeheer te verbeteren.
# reduce the number of shuffle partitions
spark.conf.set("spark.sql.shuffle.partitions", "64")  # Adjust based on cluster size

# make sure spark compresses the data
spark.conf.set("spark.shuffle.compress", "true") # compresses network transfer
spark.conf.set("spark.shuffle.spill.compress", "true") # compresses disk spillage

# repartitions the data prior to grouping to optimize aggregation
df.repartition("department").groupBy("department").sum("salary").show()Data skew ontstaat wanneer bepaalde sleutels onevenredig vaker voorkomen dan andere, wat leidt tot ongelijke partitiebelasting en trage taken. Dit belast sommige workers zwaarder dan andere. We kunnen skew minimaliseren en werk gelijkmatiger verdelen door salting, het minimaliseren van scheve joins en broadcast-joins voor kleinere dimensies.
# Salting example:

df = df.withColumn("salted_key", sf.rand()) #Create column of random
df = df.repartition(2, 'salted_key') # use this to repartition data
df.groupBy(sf.spark_partition_id()).count().show()De logische en fysieke uitvoeringsplannen van PySpark-jobs kunnen worden geoptimaliseerd met ingebouwde features. Deze kunnen de performance van je groupBy-aggregaties verbeteren.
grouped_df = df.groupBy("department").sum("salary").cache()
grouped_df.show() # you can cache your intermediate results

# use broadcasting (pseudocode here):
from pyspark.sql.functions import broadcast
df.join(broadcast(smaller_df), "department").show()
Voor meer details over hoe we PySpark-bewerkingen kunnen optimaliseren, lees dit artikel over PySpark Joins om enkele under-the-hood-mechanismen te begrijpen.
Hoewel de DataFrame-API de aanbevolen interface is voor de meeste PySpark-gebruikers vanwege de hogere abstractie en performance-efficiëntie, dankzij de Catalyst Optimizer, kan inzicht in de Resilient Distributed Dataset (RDD)-laag waardevol zijn, vooral voor wie meer controle wil of legacy Spark-code migreert. Over het algemeen levert het gebruik van de DataFrame- of SQL-API betere performance op.
De RDD is de kerncomponent van PySpark, waar alles (inclusief de DataFrame-API) op is gebouwd. Het werkt vaak in het geheugen en gaat iets beter om met streamingdata dan de DataFrame-API. Data is echter immutabel en kan dus niet worden gewijzigd zodra de RDD is gemaakt.
Dit onderdeel vergelijkt groupBy in de DataFrame-API met de equivalenten in de RDD-API, waarbij zowel performance als toepassingsgebied worden geanalyseerd.
Laten we eerst het dataframe naar een RDD omzetten.
# Convert DataFrame to RDD of (key, value)
rdd = df[['department','salary']].rdd
rdd.collect()
Nu kunnen we dingen uitvoeren zoals groupByKey() en reduceByKey() op de RDD. Laten we eerst groupByKey() behandelen.
De methode groupByKey() shufflet alle waarden met dezelfde sleutel naar dezelfde executor en groepeert ze vervolgens. Hierdoor kan het lang duren voordat de data naar de juiste sleutel is geschuffeld. Dit kan ook tot data skew leiden.
rdd.groupByKey().mapValues(list).collect()In plaats daarvan kunnen we de methode reduceByKey() proberen. Deze methode aggregeert eerst op elke partitie en verplaatst de data vervolgens over het netwerk. Dit minimaliseert de hoeveelheid data die wordt geschuffeld en werkt daardoor sneller.
Dus, reduceByKey verdient sterk de voorkeur boven groupByKey omdat het shuffle-bewerkingen aanzienlijk vermindert.
Dit aggregeert dus in elke partitie, combineert vervolgens de data en aggregeert die daarna samen. Dit is het beste voor aggregaties die de sleutels samenbrengen, zoals sum() en max().
from operator import add

rdd.reduceByKey(add).collect()Hier is een tabel die de voordelen van elke aggregatiemethode samenvat.
|
Feature |
DataFrame groupBy |
RDD groupByKey() |
RDD reduceByKey() |
|
Abstractieniveau |
Hoog |
Laag |
Laag |
|
Geoptimaliseerde uitvoering |
Ja (Catalyst & Tungsten) |
Nee |
Nee |
|
Shuffle minimalisatie |
Ja |
❌ (Volledige shuffle) |
✅ (Met combiner) |
|
Geheugenefficiëntie |
Hoog |
Laag |
Middel–Hoog |
|
Flexibiliteit |
Gemiddeld |
Hoog |
Gemiddeld |
|
Performance op Big Data |
Uitstekend |
Slecht |
Goed |
|
Aanbevolen gebruik |
Meeste gevallen |
Zeldzaam/gespecialiseerd |
Aangepaste, low-level aggregaties |
De Big Data Fundamentals with PySpark behandelt programmeren met RDD’s uitgebreider en beschrijft hoe ze de ruggengraat van PySpark vormen.
Een andere manier om aggregaties in PySpark uit te voeren, is door de SQL-API te gebruiken om statements in SQL te schrijven. Dit kan fijn zijn als je je prettiger voelt bij het schrijven van SQL.
De eerste stap is het maken van een tijdelijke view met de methode createOrReplaceTempView() van de DataFrame. Vervolgens kun je spark.sql() gebruiken om je statement te schrijven.
# Create a temporary view using the DataFrame
df.createOrReplaceTempView("employees")

# Write a SQL-like statement
spark.sql("""
    SELECT department, AVG(salary) AS avg_salary
    FROM employees
    GROUP BY department
""").show()Output:
+----------+----------+
|department|avg_salary|
+----------+----------+
|     Sales|    4900.0|
|        HR|    3950.0|
|        IT|    6000.0|
+----------+----------+
Zoals je ziet, is het net zo eenvoudig als het schrijven van een normale SQL-query. De SQL-API gebruik je vooral voor vertrouwdheid en makkelijker schrijven van je queries. De DataFrame-API is vaak beter omdat die consistente datatypes biedt en meestal beter optimaliseert.
Je krijgt toegang tot DataFrame-methoden waar je met de Spark SQL-API geen toegang toe zou hebben. Voor meer informatie over SQL’s GROUP BY kun je dit artikel lezen over GROUP BY en HAVING in SQL.
Er zijn tal van praktische toepassingen voor het aggregeren van je data. Sterker nog, je zult je data bijna zeker op de een of andere manier moeten aggregeren om deze te kunnen analyseren en delen.
Hieronder geven we enkele voorbeelden van verschillende use-cases voor aggregaties. Sommige hiervan kunnen pseudo-code zijn of niet precies van toepassing op onze testdataset, maar ze zijn bedoeld om je een idee te geven hoe je deze aggregaties zou kunnen schrijven.
Een terugkerend thema is het gebruik van groupBy als middel voor hiërarchische analyses. Stel dat we een kolom “revenue” hadden en we geïnteresseerd waren in hoe elke afdeling presteerde. We kunnen per afdeling groeperen en de omzetbijdrage van elke afdeling beoordelen.
CopyEdit
df.groupBy("department").agg(sum("revenue").alias("total_revenue")).show()Aggregaties geven je toegang tot vensterfuncties. Deze functies kijken naar een glijdend venster van data, ofwel een reeks rijen sequentieel of een periode in de tijd sequentieel.
We definiëren eerst een venster met het object Window om aan te geven waarop we willen partitonBy en orderBy. Vervolgens gebruiken we dit object in de methode over() van onze aggregatiefunctie naar keuze. Een voortschrijdend gemiddelde ziet er bijvoorbeeld uit als sf.avg().over(window).show().
Stel dat we een voortschrijdend gemiddelde van salarissen per afdeling wilden zien. We zouden groeperen op department en sorteren op een nieuwe kolom die we employeeId kunnen noemen. Aangezien werknemer-ID’s vaak sequentieel zijn, kunnen we zien hoe het gemiddelde salaris in de tijd is veranderd.
from pyspark.sql.window import Window

#Define the window we wish to partition and order by
windowSpec = Window.partitionBy("department").orderBy("employeeId")

#Perform the sf.avg function on the “salary” column over the windowSpec.
df.withColumn("rolling_avg", sf.avg("salary").over(windowSpec)).show()
Dit lijkt sterk op hoe we vensterfuncties in SQL zouden doen.
Misschien willen we verschillende gebruikersstatistieken voor ons mediabedrijf begrijpen. We willen zaken als totale kijktijd en unieke video’s. We kunnen groupBy() uitvoeren op een kolom user_id gevolgd door .agg() met verschillende functies zoals sum() en countDistinct() voor verschillende metrics.
df.groupBy("user_id").agg(
    sf.sum("watch_time").alias("total_watch"), #sum minutes watched
    sf.countDistinct("video_id").alias("unique_views") #count unique videos watched
).show()Bij het aggregeren van data in PySpark is het makkelijk om in valkuilen te trappen die tot slechte performance en lange runtimes leiden. Het volgen van deze best practices helpt om performance, correctheid en schaalbaarheid te waarborgen.
Hier zijn enkele veelvoorkomende manieren waarop eenvoudige queries in langlopende programma’s veranderen.
groupByKey() in RDD’s:groupByKey() in RDD’s, aangezien het mechanisme PySpark dwingt om data over partities te shufflen. Dit kan tot veel netwerk- en schijfoverhead leiden.reduceByKey() of blijf bij de DataFrame-API.repartition().sum() in één groupBy en vervolgens count() op dezelfde gegroepeerde dataset op een andere regel, leidt tot inefficiënte plannen doordat PySpark minder goed kan optimaliseren.persist() of cache() te gebruiken wanneer je gegroepeerde data hergebruikt.Hier zijn manieren om je PySpark-aggregaties te optimaliseren zodat ze soepel blijven draaien!
na.fill() of na.drop() vóór de aggregatie.df.na.fill({"salary": 0}).groupBy("department").sum("salary").show()spark.sql.shuffle.partitions af op het datavolume en kijk welk aantal partities het beste werkt voor jouw data..explain() om de fysieke uitvoering te begrijpen.df.groupBy("department").sum("salary").explain(True)Output:
	== Parsed Logical Plan ==
	'Aggregate ['department], ['department, unresolvedalias('sum(salary#600L))]
	+- LogicalRDD [department#598, employee#599, salary#600L], false

	== Analyzed Logical Plan ==
	department: string, sum(salary): bigint
	Aggregate [department#598], [department#598, sum(salary#600L) AS sum(salary)#679L]
	+- LogicalRDD [department#598, employee#599, salary#600L], false

	== Optimized Logical Plan ==
	Aggregate [department#598], [department#598, sum(salary#600L) AS sum(salary)#679L]
	+- Project [department#598, salary#600L]
	   +- LogicalRDD [department#598, employee#599, salary#600L], false

	== Physical Plan ==
	AdaptiveSparkPlan isFinalPlan=false
	+- HashAggregate(keys=[department#598], functions=[sum(salary#600L)], output=[department#598, sum(salary)#679L])
	   +- Exchange hashpartitioning(department#598, 200), ENSURE_REQUIREMENTS, [plan_id=1841]
	      +- HashAggregate(keys=[department#598], functions=[partial_sum(salary#600L)], output=[department#598, sum#681L])
	         +- Project [department#598, salary#600L]
	            +- Scan ExistingRDD[department#598,employee#599,salary#600L]
Spark heeft veel configuraties die je kunt tunen voor grote groupBy-workloads. Raadpleeg de tabel hieronder voor enkele sleutelconfiguraties.
|
Configuratie |
Beschrijving |
|
|
Bepaalt het aantal partities voor shuffles. Verlaag voor kleine jobs, verhoog voor grote. (Standaard: 200) |
|
|
Schakelt automatisch broadcasten van kleine tabellen in. Stel in op -1 om uit te schakelen of verhoog om grotere joins te ondersteunen. (Standaard: 10MB) |
|
|
Bepaalt het beschikbare geheugen per executor. Verhoog dit voor grote aggregaties. (Standaard: 4g) |
|
|
Schakelt Adaptive Query Execution (AQE) in, dat dynamisch shuffles, skew en joins optimaliseert. (Standaard: true) |
Voor gevorderde gebruikers of wie met zeer grote datasets werkt, is het essentieel om te begrijpen hoe groupBy onder de motorkap werkt. Laten we enkele nuances bespreken.
Alle DataFrame-bewerkingen in PySpark, inclusief groupBy, worden lui geëvalueerd. Dat betekent dat er geen daadwerkelijke berekening plaatsvindt totdat een actie (zoals show() of collect()) wordt getriggerd.
Dit stelt de Catalyst-optimizer in staat om bewerkingen te herschikken, combineren of verwijderen om de performance te verbeteren. Profiteer hiervan en chain meerdere aggregaties en methoden zodat Spark een geoptimaliseerd plan kan maken.
Bij gebruik van groupBy() retourneert het een GroupedData-object. Het uitvoeren van een aggregatiefunctie, zoals sum(), retourneert vervolgens een DataFrame-achtig object. Met show() worden de resultaten weergegeven.
Onthoud dat groupBy().agg() een nieuw DataFrame met nieuw benoemde kolommen retourneert. Gebruik altijd aliassen met de methode alias() om naamgevingsconflicten te voorkomen en outputs duidelijker te maken. Als je kolommen zonder alias laat, kan dat leiden tot kolomnaamconflicten of problemen met joins later.
from pyspark.sql import functions as F

df.groupBy("department") \

  .agg(

      sum("salary").alias("total_salary"),

      count("*").alias("employee_count")

)Iets om op te merken over PySpark is dat de geretourneerde aggregatie de rijenvolgorde niet bewaart. Gebruik orderBy() voor voorspelbare outputs en consistente rijsortering.
df.groupBy("department").sum("salary").orderBy("department").show()Er zijn enkele versiespecifieke veranderingen en beperkingen in elke versie van PySpark. Catalyst werd geïntroduceerd in 1.3 en aanzienlijk verbeterd in 2.0. Sommige methoden werden pas in latere versies van PySpark geïntroduceerd, zoals groupingSets().
Hier is een overzichtstabel van enkele grotere functionele veranderingen voor PySpark. Zorg dat je de juiste versie van Spark en PySpark gebruikt voor de features die je nodig hebt!
|
Feature |
Spark-versie |
Beschrijving |
|
|
1.4+ |
Hiërarchische aggregaties bruikbaar in OLAP-achtige analytics (3.4+ ondersteunt Spark Connect) |
|
|
2.3+ |
Gevectoriseerde UDF’s met Apache Arrow voor snellere uitvoering (3.4+ ondersteunt Spark Connect, 4.0+ ondersteunt SCALAR) |
|
Adaptive Query Execution (AQE) |
3.0+ |
Past joins, shuffles en skew-afhandeling dynamisch aan tijdens runtime |
|
ANSI SQL-compatibiliteitsmodus |
3.0+ |
Nauwkeurigere foutmeldingen en expressiegedrag |
|
|
4.0+ |
Maakt meerdere groeperingen in één aggregatie mogelijk (bijv. voor subtotalen) |
PySpark’s groupBy-functie is een essentieel hulpmiddel voor data-aggregatie in gedistribueerde omgevingen. Of je nu data samenvat per regio, gemiddelde metrics berekent of complexe meerlaagse analyses uitvoert, groupBy biedt een schaalbare en flexibele API voor het verwerken van big data-workloads.
Onthoud deze best practices om runtime en kosten te minimaliseren:
Naarmate PySpark zich verder ontwikkelt, kunnen we nog intelligentere optimalisaties verwachten, native ondersteuning voor complexe aggregaties en een betere integratie met Pandas- en SQL-achtige syntaxis. Mogelijk ook betere integratie voor grootschaligere modellen. Wil je meer leren over PySpark, bekijk dan deze uitgebreide resources van DataCamp:
Topcursussen PySpark
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min


