
Corso
Fondamenti di PySpark
4 ore
157.8K
Immagina di gestire una piattaforma e-commerce che elabora migliaia di transazioni ogni giorno. Vuoi analizzare i trend di vendita, monitorare la crescita dei ricavi e fare previsioni sui guadagni futuri. Le query tradizionali al database non riescono a gestire questa scala o velocità. Ti serve quindi un modo più rapido per elaborare grandi dataset e ottenere insight in tempo reale.
Apache Spark lets ti consente di analizzare enormi volumi di dati in modo efficiente. In questo tutorial, ti mostrerò come collegare Django, MongoDB e Apache Spark per analizzare i dati delle transazioni e-commerce.
Imposterai un progetto Django con MongoDB come database e vi memorizzerai i dati delle transazioni. Poi userai PySpark, l'API Python per Apache Spark, per leggere e filtrare i dati. Eseguirai anche calcoli di base e salverai i dati elaborati in MongoDB. Infine, visualizzerai i dati elaborati nella tua applicazione Django.
Per ottenere il massimo da questo tutorial, dovresti avere una conoscenza di base di Python e del framework web Django.
Ora tuffiamoci subito.
django-mongodb-backend per collegare Django a MongoDB Atlas con supporto nativo per chiavi primarie ObjectIdadmin, auth, contenttypes) con configurazioni personalizzate per usare campi compatibili con MongoDBspark.read.format('mongodb').load() per caricare le collection MongoDB in DataFrame PySpark.write.format('mongodb').save() e mostra i risultati nei template DjangoInizia creando un ambiente virtuale per il tuo progetto Django:
python -m venv venv
source venv/bin/activate
Assicurati di avere Python 3.10 o successivo installato nel tuo ambiente virtuale. Poi installa il Django MongoDB Backend:
pip install django-mongodb-backendIl comando precedente installa anche le versioni più recenti di PyMongo 4.x e Django 5.2.x.
Una volta scaricato Django MongoDB Backend, crea un nuovo progetto Django:
django-admin startproject pyspark_tutorialOra vai nella cartella del progetto ed esegui il server di sviluppo per confermare che il progetto sia configurato correttamente:
cd pyspark_tutorial
python manage.py runserver
Visita http://127.0.0.1:8000/ per verificare che il progetto Django sia in esecuzione.
Per impostazione predefinita, Django usa ID interi AutoField come chiavi primarie, il che funziona bene con i database SQL. Tuttavia, MongoDB usa ObjectId per gli ID dei documenti. Per rendere i tuoi modelli compatibili, devi fare in modo che Django generi chiavi primarie come ObjectId invece che interi.
Apri pyspark_tutorial/settings.py e aggiorna l'impostazione DEFAULT_AUTO_FIELD:
DEFAULT_AUTO_FIELD = 'django_mongodb_backend.fields.ObjectIdAutoField'Anche con questa impostazione globale, le app integrate di Django come admin, auth e contenttypes continueranno a usare AutoField per impostazione predefinita. Per garantire coerenza in tutte le app, crea configurazioni personalizzate in modo che usino ObjectId.
Crea un file pyspark_tutorial/apps.py e aggiungi quanto segue:
from django.contrib.admin.apps import AdminConfig
from django.contrib.auth.apps import AuthConfig
from django.contrib.contenttypes.apps import ContentTypesConfig


class MongoAdminConfig(AdminConfig):
    default_auto_field = 'django_mongodb_backend.fields.ObjectIdAutoField'

class MongoAuthConfig(AuthConfig):
    default_auto_field = 'django_mongodb_backend.fields.ObjectIdAutoField'

class MongoContentTypesConfig(ContentTypesConfig):
    default_auto_field = 'django_mongodb_backend.fields.ObjectIdAutoField'
Ora, in pyspark_tutorial/settings.py, aggiorna l'impostazione INSTALLED_APPS:
INSTALLED_APPS = [
    'pyspark_tutorial.apps.MongoAdminConfig',
    'pyspark_tutorial.apps.MongoAuthConfig',
    'pyspark_tutorial.apps.MongoContentTypesConfig',
    'django.contrib.sessions',
    'django.contrib.messages',
    'django.contrib.staticfiles',
]
Poiché tutti i modelli devono usare ObjectIdAutoField, ogni app di terze parti e contrib che usi deve avere le proprie migrazioni specifiche per MongoDB. Quindi aggiungi quanto segue al file pyspark_tutorial/setting.py:
MIGRATION_MODULES = {
    'admin': 'mongo_migrations.admin',
    'auth': 'mongo_migrations.auth',
    'contenttypes': 'mongo_migrations.contenttypes',
}
Crea una cartella mongo_migrations nella cartella del progetto, allo stesso livello del file manage.py. A questo punto, la struttura delle cartelle dovrebbe essere simile a questa:
pyspark_tutorial/
├── pyspark_tutorial/
├── mongo_migrations/
└── manage.py
Ferma il server con Ctrl + C, poi genera le migrazioni:
python manage.py makemigrations admin auth contenttypesSe controlli la cartella mongo_migrations, vedrai una cartella per ogni app integrata. Ogni cartella contiene le sue migrazioni.
Per un template di progetto Django che includa tutte le configurazioni MongoDB viste sopra, esegui:
django-admin startproject pyspark_tutorial --template https://github.com/mongodb-labs/django-mongodb-project/archive/refs/heads/5.2.x.zipNota: Se usi una versione di Django diversa dalla 5.2.x, sostituisci i due numeri per farli corrispondere ai primi due numeri della tua versione.
Il passo successivo è creare un'app Django per memorizzare i record delle transazioni grezzi e quelli elaborati.
python manage.py startapp salesPer configurare la tua nuova app in modo che usi ObjectId, apri sales/apps.py e sostituisci la riga default_auto_field = 'django.db.models.BigAutoField':
from django.apps import AppConfig


class SalesConfig(AppConfig):
    # Use ObjectId as the default primary key field type for MongoDB:
    default_auto_field = 'django_mongodb_backend.fields.ObjectIdAutoField'
    name = 'sales'
In alternativa, puoi usare il seguente template di startapp, che include la modifica precedente:
python manage.py startapp sales --template https://github.com/mongodb-labs/django-mongodb-app/archive/refs/heads/5.2.x.zipOra, in pyspark_tutorial/settings.py, aggiungi la tua app sales alla lista INSTALLED_APPS:
INSTALLED_APPS = [
    # Add your sales app:
    'sales.apps.SalesConfig',
    ...
]Dal momento che memorizzerai i tuoi dati in MongoDB, ti guiderò nella creazione di un deployment free tier su MongoDB Atlas per archiviare e gestire i tuoi dati nel cloud.
Registrati per un account Atlas usando il tuo account Google o un indirizzo email.
Clicca su Create per creare un cluster Free:
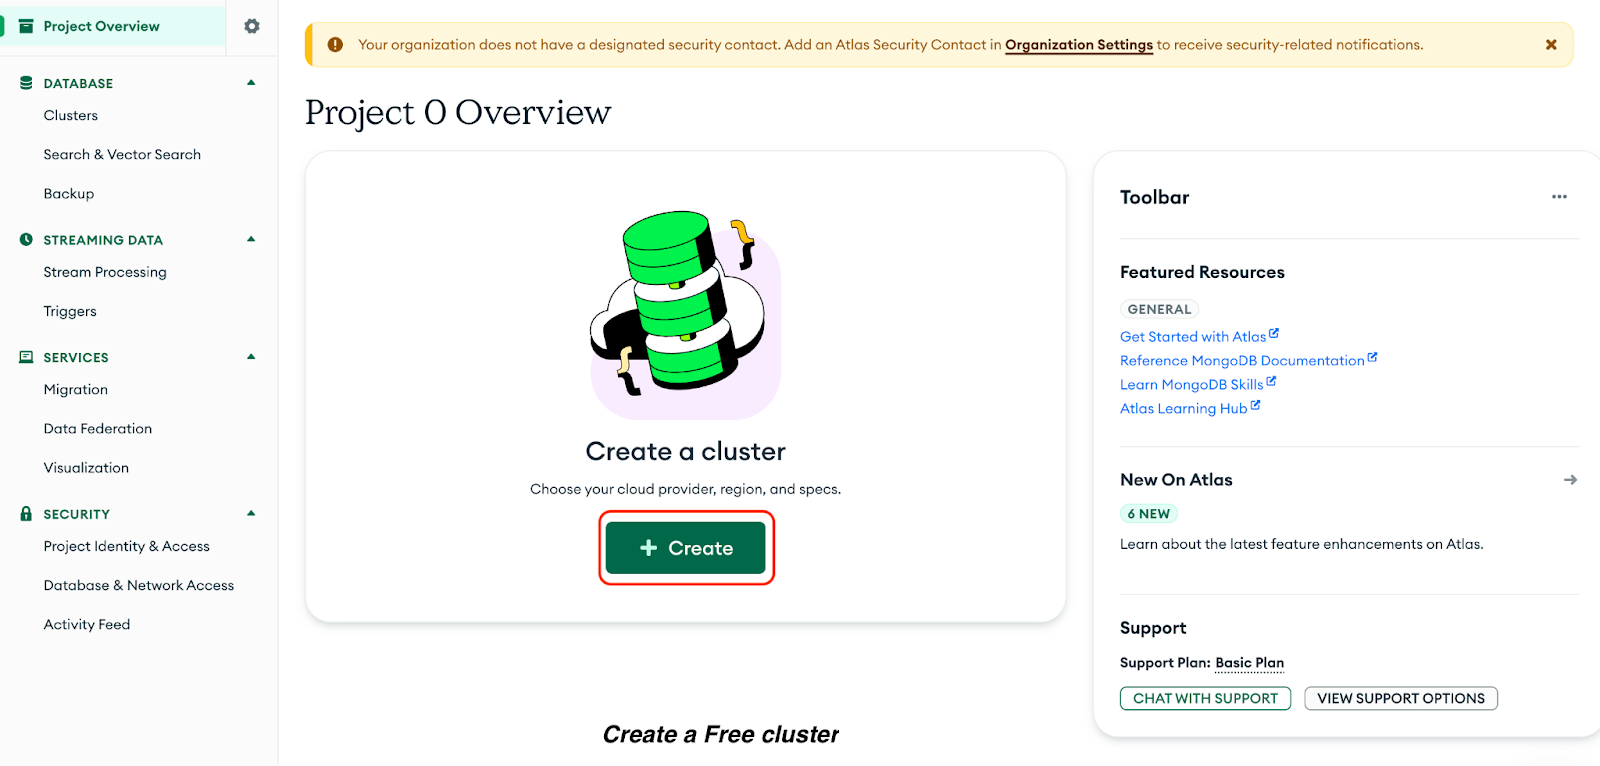
Ora seleziona le seguenti opzioni nella pagina risultante:
Clicca su Create Deployment:
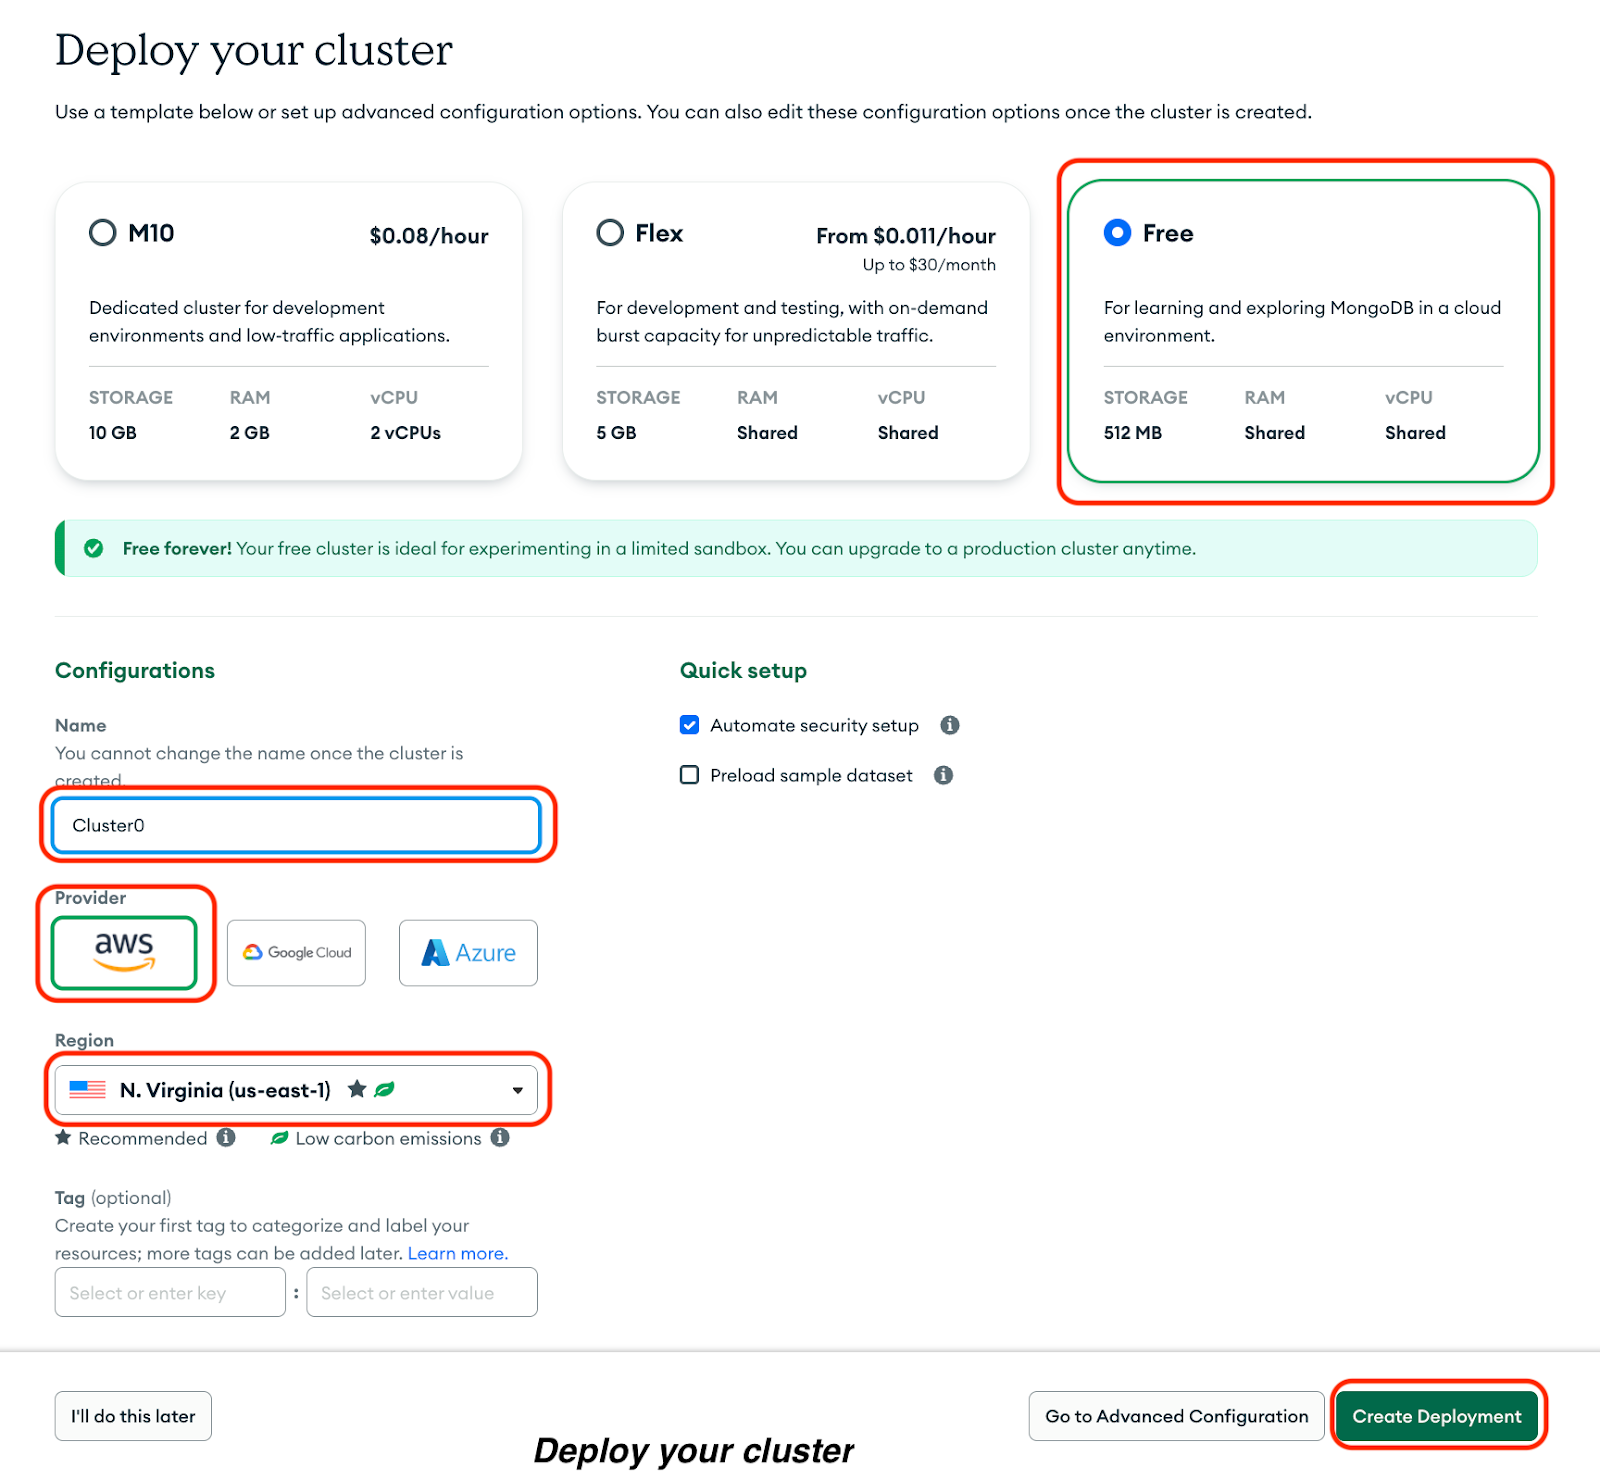
Vedrai il tuo nome utente e la tua password. Fai quanto segue:
1. Copia nome utente e password in un documento sicuro.
2. Clicca su Create Database User.
3. Clicca su Choose a connection method per impostare un indirizzo IP di connessione.
Nella pagina risultante, esegui quanto segue:
1. Seleziona Drivers.
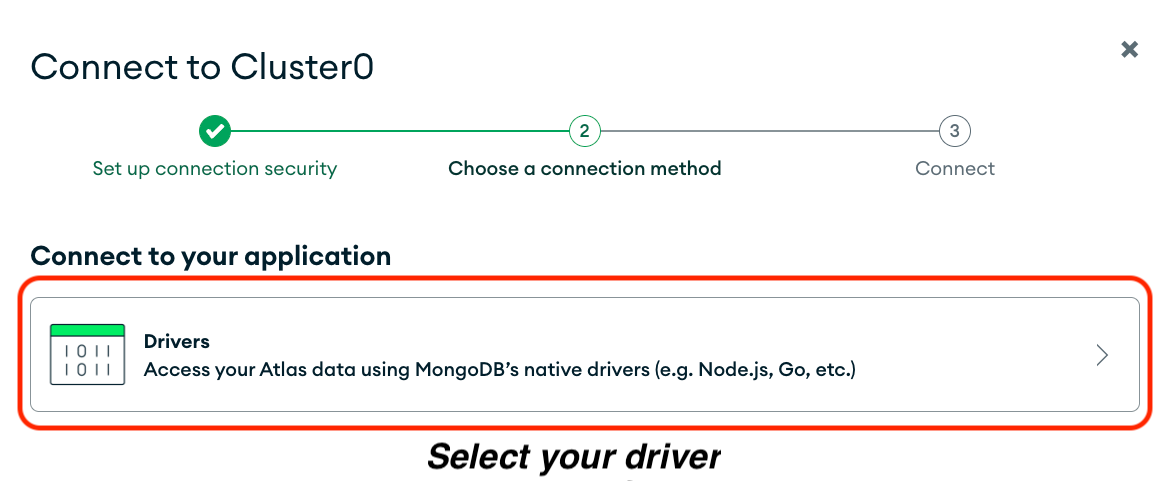
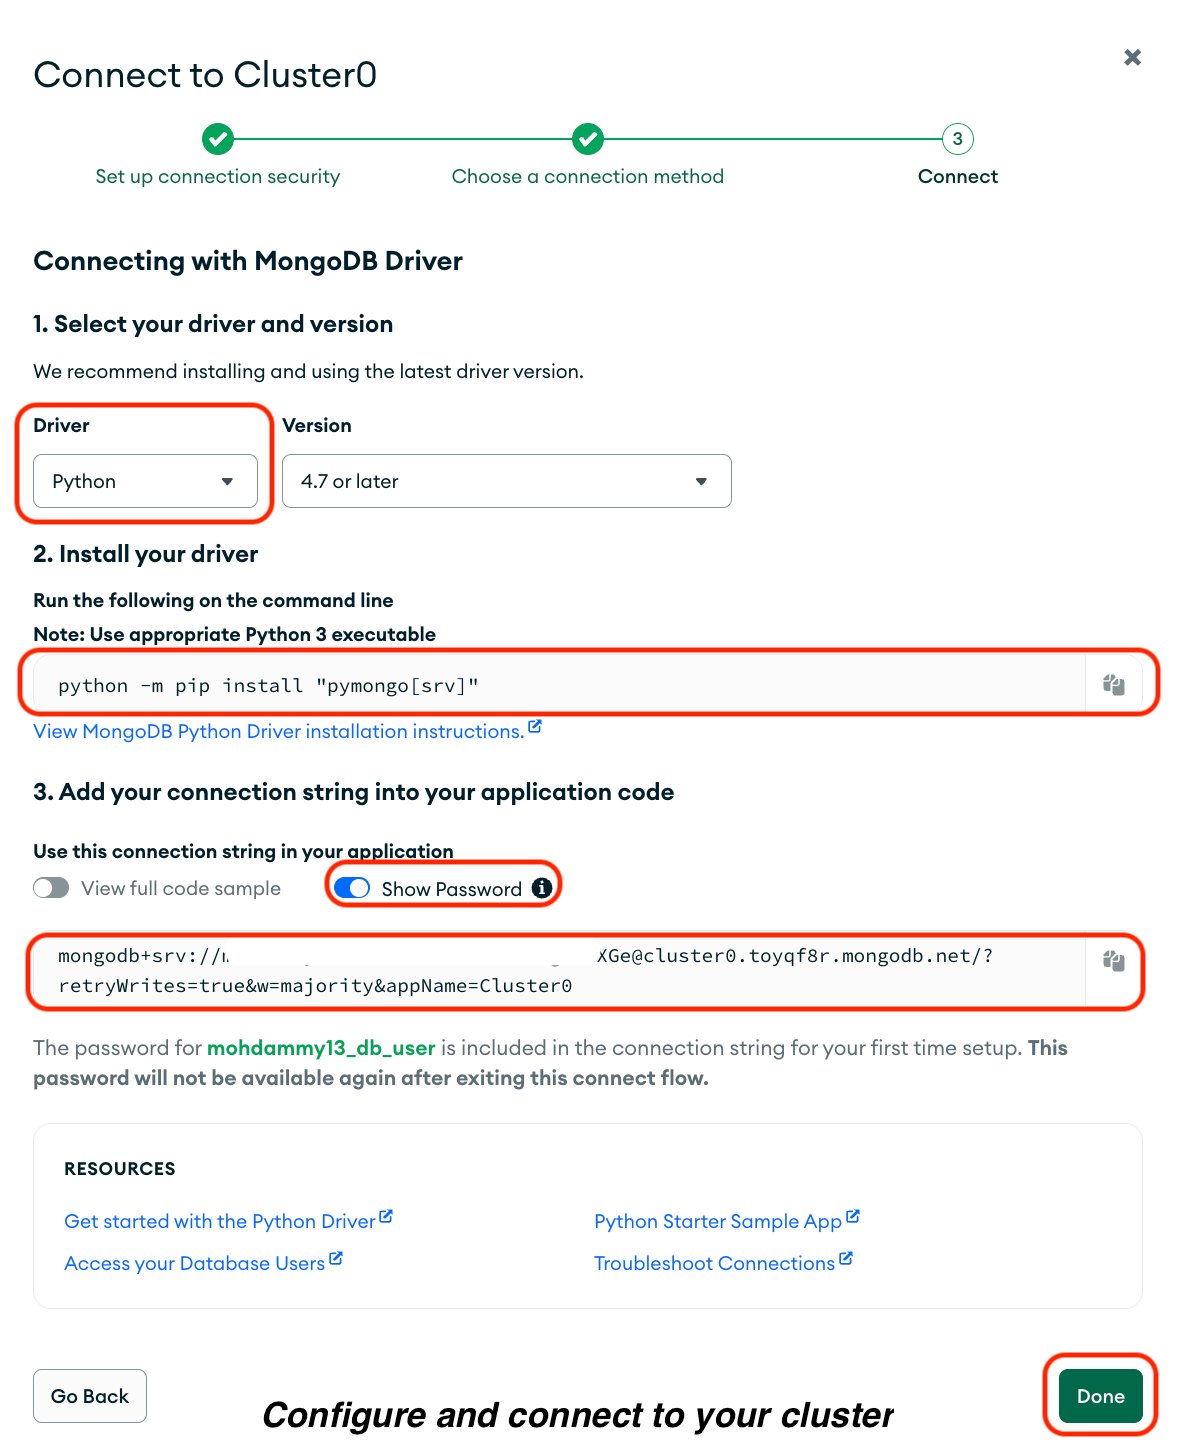
2. Seleziona Python come driver.
3. Copia il comando nell'opzione Install your driver ed eseguilo nel tuo terminale.
4. Copia la tua connection string, inclusa la password, sotto Add your connection string into your application code e salvala in un documento sicuro.
5. Clicca su Done.
Apri pyspark_tutorial/settings.py e aggiorna l'impostazione DATABASES per usare Django MongoDB Backend con la tua connection string salvata. Imposta anche un nome del database:
DATABASES = {
    'default': {
        # Change to use Django MongoDB Backend:
        'ENGINE': 'django_mongodb_backend',
        # Use your saved connection string:
        'HOST': '<connection string>',
        # Set a database name:
        'NAME': 'pyspark_tutorial',
    },
}
Nel codice precedente, assicurati di sostituire <connection string> con la tua connection string salvata.
Questa configurazione collega Django al tuo cluster MongoDB Atlas. ENGINE punta al backend MongoDB, HOST memorizza la tua connection string e NAME definisce il nome del database che Django userà.
Ora che la tua app è configurata, creerai i model, le view, gli URL e i template necessari per visualizzare i dati delle transazioni nel browser.
I model descrivono la struttura dei tuoi dati. Crea un model per rappresentare i record delle transazioni. Apri sales/models.py e sostituisci il codice:
from django.db import models

# Define a model to represent each transaction record:
class Transaction(models.Model):
    order_id = models.CharField(max_length=50, unique=True)
    user_id = models.CharField(max_length=50)
    product = models.CharField(max_length=100)
    price = models.DecimalField(max_digits=10, decimal_places=2)
    quantity = models.PositiveIntegerField()
    timestamp = models.DateTimeField()
    country = models.CharField(max_length=50)

    class Meta:
        # Sort transactions by order ID:
        ordering = ['order_id']
        # Add indexes to improve query performance for common lookup fields
        indexes = [
            models.Index(fields=['timestamp']),
            models.Index(fields=['country']),
            models.Index(fields=['product']),
        ]

    def __str__(self):
        return f'{self.order_id} - {self.product}'

    @property
    def total_amount(self):
        # Calculate and return the total transaction amount:
        return self.price * self.quantity
Questo model definisce ogni transazione con campi per i dettagli del prodotto, prezzo, quantità e paese. Ordina le transazioni per order_id. Include anche un indice sui campi chiave per migliorare le prestazioni delle query e una proprietà che calcola l'importo totale della transazione.
Le view controllano come quei record appaiono nel browser. Crea una view per mostrare i record delle transazioni. Apri sales/views.py e sostituisci il codice:
from django.shortcuts import render
from .models import Transaction

# Define a view to display all transactions and total revenue:
def transaction_list_view(request):
    # Retrieve all transaction records from the database:
    transactions = Transaction.objects.all()
    # Calculate the total revenue from all transactions:
    total_revenue = sum(t.total_amount for t in transactions)
    # Render the transaction list template with context data
    return render(request, 'sales/transaction_list.html', {
        'transactions': transactions,
        'total_revenue': total_revenue,
    })
La view precedente recupera tutti i record delle transazioni da MongoDB usando il model Transaction. Calcola il ricavo totale sommando il campo total_amount di ogni transazione. Poi invia due valori a un template transaction_list.html , che creeremo più avanti:
* transactions: un elenco di tutti i record da mostrare in tabella
* total_revenue: l'importo totale generato da tutte le transazioni
Il template userà questi valori per mostrare ogni transazione e il ricavo totale.
Devi creare le route in modo che Django sappia quale view caricare quando gli utenti visitano un URL. Crea un file sales/urls.py e aggiungi quanto segue:
from django.urls import path
from . import views

# Define URL patterns for the sales app:
urlpatterns = [
    # Route the root URL to the transaction list view:
    path('', views.transaction_list_view, name='transaction_list'),
]
Includi gli URL della tua app nella configurazione degli URL del progetto. Apri pyspark_tutorial/urls.py e aggiornalo così:
from django.contrib import admin
from django.urls import path, include

urlpatterns = [
    path('admin/', admin.site.urls),
    # Include your app’s URLs:
    path("", include('sales.urls')),
]I template definiscono come i tuoi dati appaiono nel browser. Crea una cartella sales/templates/sales e aggiungi un file chiamato transaction_list.html al suo interno.
La struttura della tua app sales dovrebbe assomigliare a questa:
sales/
├── __init__.py
├── admin.py
├── apps.py
├── migrations/
├── models.py
├── views.py
├── tests.py
├── urls.py
└── templates/
   └── sales/
       └── transaction_list.html
Aggiungi quanto segue al tuo file transaction_list.html:
<!DOCTYPE html>
<html>
<head>
    <title>Transactions</title>
</head>
<body>
    <h1>E-commerce Transactions</h1>
    <h3>Total Revenue: ${{ total_revenue }}</h3>

    <table>
        <thead>
            <tr>
                <th>Order ID</th>
                <th>User ID</th>
                <th>Product</th>
                <th>Price</th>
                <th>Quantity</th>
                <th>Country</th>
                <th>Timestamp</th>
            </tr>
        </thead>
        <tbody>
            {% for t in transactions %}
            <tr>
                <td>{{ t.order_id }}</td>
                <td>{{ t.user_id }}</td>
                <td>{{ t.product }}</td>
                <td>${{ t.price }}</td>
                <td>{{ t.quantity }}</td>
                <td>{{ t.country }}</td>
                <td>{{ t.timestamp }}</td>
            </tr>
            {% empty %}
            <tr><td colspan="7">No transactions available.</td></tr>
            {% endfor %}
        </tbody>
    </table>
</body>
</html>
Il template precedente usa il linguaggio dei template di Django per mostrare dinamicamente i dati passati dalla view.
All'inizio viene mostrato il ricavo totale usando {{ total_revenue }}. Poi il template itera su tutti i record delle transazioni in transactions usando il tag {% for t in transactions %} e mostra ogni record come riga della tabella. Ogni colonna visualizza un attributo specifico della transazione, come order_id, product, price, quantity e country. Se non ci sono record, il tag {% empty %} fa sì che appaia il messaggio “No transactions available” al posto di una tabella vuota.
Per rendere la tua pagina delle transazioni più gradevole e facile da leggere, aggiungerai CSS personalizzato. Django serve i file statici, come CSS, JavaScript e immagini, attraverso una directory speciale chiamata static. Questo mantiene i file di design separati dal codice.
Ora crea una cartella sales/static/sales e aggiungi un file chiamato styles.css al suo interno. La struttura della tua cartella sales dovrebbe essere così:
sales/
├── __init__.py
├── admin.py
├── apps.py
├── migrations/
├── models.py
├── views.py
├── tests.py
├── urls.py
├── templates/
│   └── sales/
│       └── transaction_list.html
└── static/
   └── sales/
       └── styles.css
In pyspark_tutorial/settings.py, assicurati che STATIC_URL sia definito:
STATIC_URL = 'static/'Aggiungi questo al tuo file sales/static/sales/styles.css:
table {
  width: 100%;
  border-collapse: collapse;
  margin-top: 20px;
}

th, td {
  border: 1px solid #ddd;
  padding: 8px;
  text-align: left;
}

th {
  background-color: #f5f5f5;
}

body {
  font-family: Arial, sans-serif;
  margin: 20px;
}

h1 {
  color: #333;
}

a {
  text-decoration: none;
  color: #007bff;
}
a:hover {
  text-decoration: underline;
}
Infine, dì a Django di caricare i file statici e includi il file CSS nel tuo template HTML.
All'inizio di sales/templates/sales/transaction_list.html, aggiungi {% load static %}, e poi aggiorna l'elemento <head> per collegare il file styles.css:
<!-- Load static files:-->
{% load static %}
<!DOCTYPE html>
<html>
<head>
    <title>Transactions</title>
    <!-- Link the CSS file for styling the template:-->
    <link rel="stylesheet" href="{% static 'sales/styles.css' %}">
</head>Genera e applica le migrazioni così che Django possa creare le collection necessarie in MongoDB:
python manage.py makemigrations
python manage.py migrateOra, usiamo i model della tua applicazione per aggiungere record di transazioni al database pyspark_tutorial usando la shell interattiva di Django:
python manage.py shellPoi importa il model Transaction dalla tua app sales e timezone dalle utility di Django:
from sales.models import Transaction
from django.utils import timezone
Ora inserisci record di transazioni usando bulk_create():
Transaction.objects.bulk_create([
    Transaction(order_id='T1001', user_id='U001', product='Laptop', price=1000.00, quantity=1, timestamp=timezone.now(), country='US'),
    Transaction(order_id='T1002', user_id='U002', product='Smartphone', price=800.00, quantity=2, timestamp=timezone.now(), country='NG'),
    Transaction(order_id='T1003', user_id='U003', product='Headphones', price=150.00, quantity=1, timestamp=timezone.now(), country='UK'),
    Transaction(order_id='T1004', user_id='U004', product='Laptop', price=1200.00, quantity=1, timestamp=timezone.now(), country='US'),
    Transaction(order_id='T1005', user_id='U005', product='Keyboard', price=45.00, quantity=3, timestamp=timezone.now(), country='DE'),
    Transaction(order_id='T1006', user_id='U006', product='Monitor', price=300.00, quantity=2, timestamp=timezone.now(), country='FR'),
    Transaction(order_id='T1007', user_id='U007', product='Smartwatch', price=199.00, quantity=1, timestamp=timezone.now(), country='IN'),
    Transaction(order_id='T1008', user_id='U008', product='Speaker', price=150.00, quantity=2, timestamp=timezone.now(), country='CA'),
    Transaction(order_id='T1009', user_id='U009', product='Camera', price=800.00, quantity=1, timestamp=timezone.now(), country='NG'),
    Transaction(order_id='T1010', user_id='U010', product='Tablet', price=350.00, quantity=1, timestamp=timezone.now(), country='UK'),
    Transaction(order_id='T1011', user_id='U011', product='Headphones', price=75.00, quantity=2, timestamp=timezone.now(), country='US'),
    Transaction(order_id='T1012', user_id='U012', product='Laptop', price=1300.00, quantity=1, timestamp=timezone.now(), country='NG'),
    Transaction(order_id='T1013', user_id='U013', product='Mouse', price=30.00, quantity=3, timestamp=timezone.now(), country='IN'),
    Transaction(order_id='T1014', user_id='U014', product='Smartphone', price=950.00, quantity=1, timestamp=timezone.now(), country='KE'),
    Transaction(order_id='T1015', user_id='U015', product='Keyboard', price=55.00, quantity=2, timestamp=timezone.now(), country='CA'),
    Transaction(order_id='T1016', user_id='U016', product='Smartwatch', price=250.00, quantity=1, timestamp=timezone.now(), country='DE'),
    Transaction(order_id='T1017', user_id='U017', product='Speaker', price=180.00, quantity=1, timestamp=timezone.now(), country='FR'),
    Transaction(order_id='T1018', user_id='U018', product='Monitor', price=400.00, quantity=2, timestamp=timezone.now(), country='NG'),
    Transaction(order_id='T1019', user_id='U019', product='Laptop', price=1250.00, quantity=1, timestamp=timezone.now(), country='IN'),
    Transaction(order_id='T1020', user_id='U020', product='Camera', price=780.00, quantity=1, timestamp=timezone.now(), country='US'),
])
Verifica che i record siano stati aggiunti correttamente:
Transaction.objects.count()Se il conteggio restituisce 20, i record sono stati salvati correttamente.
Ora esci dalla shell eseguendo exit() e avvia il server Django per visualizzare le transazioni nel browser:
python manage.py runserverVisita http://127.0.0.1:8000/ per confermare che i dati siano visualizzati.
Ora che i tuoi record sono memorizzati nel database MongoDB, userai Apache Spark per elaborare i dati. Apache Spark include un'API Python, PySpark, che puoi usare nel tuo progetto Django per elaborare grandi dataset. Se sei alle prime armi con PySpark, dai un'occhiata alla nostra guida all'installazione di PySpark.
Creerai uno script Python che usa PySpark per connettersi a MongoDB e leggere i record delle transazioni. Eseguirai operazioni di base su questi dati, come filtrarli. Poi li raggrupperai per paese e calcolerai il ricavo totale per ciascuno. Infine, scriverai i dati elaborati in una nuova collection MongoDB nel tuo database.
Ferma il server e installa la versione di PySpark compatibile con l'ultima versione del connettore MongoDB Spark:
pip install pyspark==3.5.0Verifica che l'installazione sia andata a buon fine:
pyspark --versionDovresti ricevere una risposta di benvenuto a Spark.
Successivamente, crea un file transactions.py nella cartella del progetto, allo stesso livello di manage.py. La struttura delle cartelle ora dovrebbe essere così:
pyspark_tutorial/
├── mongo_migrations/
├── pyspark_tutorial/
├── sales/
├── manage.py
└── transactions.pyPer connettere PySpark a MongoDB, devi costruire una connection string che includa il nome del tuo database e il nome della collection. Una collection in MongoDB è simile a una tabella nei database relazionali e memorizza documenti correlati. Il nome della tua collection è composto dal nome della tua app e dal nome del model, separati da un underscore (_).
Usa la connection string costruita nel tuo file transactions.py . Il formato corretto è:
mongodb+srv://<mongodb username>:<mongodb password>@<cluster address>/<database name>.<app name>_<model name>?retryWrites=true&w=majority&appName=Cluster0Ecco la spiegazione dei valori segnaposto:
<mongodb username> e <mongodb password> sono il tuo nome utente e la tua password di MongoDB Atlas.<cluster address> è il dominio mostrato nella tua connection string di Atlas, ad esempio cluster0.2rvn82q.mongodb.net.<database name> è il nome che hai dato al tuo database in settings.py.<app name>_<model name> è il nome della collection generata dalla tua app e dal tuo model Django, ad esempio sales_transaction.In questa sezione, la connection string che userai nel codice PySpark sarà simile a questa:
mongodb+srv://db_user:password@cluster.mongodb.net/pyspark_tutorial.sales_transaction?retryWrites=true&w=majority&appName=Cluster0Aggiungi il seguente codice al tuo file transactions.py:
from pyspark.sql import SparkSession

# Initialize SparkSession with MongoDB connector:
spark = SparkSession.builder \
    .appName('ReadTransactions') \
    .config(
        'spark.mongodb.read.connection.uri',
        # Replace with your built MongoDB connection string:
        '<built connection string>'
    ) \
    .config(
        # Add the MongoDB Spark connector package:
        'spark.jars.packages',
        'org.mongodb.spark:mongo-spark-connector_2.12:10.4.1'
    ) \
    .getOrCreate()

# Read data from MongoDB into a Spark DataFrame:
df = spark.read.format('mongodb').load()

# Show result:
df.show()

# Stop the Spark session:
spark.stop()
from pyspark.sql import SparkSession è il punto di ingresso per usare PySpark. Ti permette di interagire con Spark ed eseguire operazioni sui dati.
La riga spark = SparkSession.builder inizializza una nuova sessione Spark e le assegna un nome, ReadTransactions. Le due opzioni .config() definiscono come Spark deve connettersi a MongoDB:
spark.mongodb.read.connection.uri: la connection string di MongoDB che indica a Spark dove si trova il tuo databasespark.jars.packages: scarica il pacchetto del connettore MongoDB Spark così che Spark possa comunicare con MongoDBdf = spark.read.format('mongodb').load() carica tutti i documenti dalla collection definita nella tua connection string in un DataFrame PySpark, rendendo semplice interrogare e trasformare i dati..show() stampa un'anteprima dei dati MongoDB in formato tabellare direttamente nel terminale.spark.stop() termina l'applicazione Spark e rilascia le risorse di sistema una volta completato il job.Infine, sostituisci <built connection string> con la connection string MongoDB costruita da te. Inoltre, assicurati che il tuo indirizzo IP corrente sia in whitelist nella lista di accesso alla rete di MongoDB Atlas prima di connetterti.
Ora esegui python transactions.py e otterrai nel terminale i record delle transazioni memorizzati nel tuo database.
Puoi anche filtrare i tuoi record usando le funzioni di PySpark SQL, ad esempio per mostrare solo le transazioni dalla Nigeria (NG). Modifica il codice nel tuo file transactions.py:
from pyspark.sql import SparkSession

# Import col to reference DataFrame column names:
from pyspark.sql.functions import col

spark = SparkSession.builder \
    .appName('ReadTransactions') \
    .config(
        'spark.mongodb.read.connection.uri',
        # Replace with your built MongoDB connection string:
        '<built connection string>'
    ) \
    .config(
        'spark.jars.packages',
        'org.mongodb.spark:mongo-spark-connector_2.12:10.4.0'
    ) \
    .getOrCreate()

df = spark.read.format('mongodb').load()

# Filter transactions from Nigeria:
ng_df = df.filter(col('country') == 'NG')

# Show filtered results:
ng_df.show()

# Stop the Spark session:
spark.stop()
Esegui di nuovo python transactions.py e vedrai le transazioni da NG.
Puoi anche raggruppare i record delle transazioni per paese e calcolare il ricavo totale per ciascuno. Modifica il codice nel tuo transactions.py:
from pyspark.sql import SparkSession
# Import col to reference DataFrame columns and import sum as _sum to avoid naming conflicts:
from pyspark.sql.functions import col, sum as _sum

spark = SparkSession.builder \
    .appName('ReadTransactions') \
    .config(
        'spark.mongodb.read.connection.uri',
        # Replace with your built MongoDB connection string:
        '<Built Connection String>'
    ) \
    .config(
        'spark.jars.packages',
        'org.mongodb.spark:mongo-spark-connector_2.12:10.4.0'
    ) \
    .getOrCreate()

df = spark.read.format('mongodb').load()

# Calculate total revenue per country:
revenue_per_country = df.groupBy('country').agg(
   _sum(col('price') * col('quantity')).alias('total_revenue')
)

# Show total revenue per country:
revenue_per_country.show()

# Stop the Spark session:
spark.stop()
Esegui python transactions.py. Vedrai una tabella con il ricavo totale per paese.
Ora che hai capito come usare PySpark per leggere ed elaborare i tuoi dati, ti mostrerò come scrivere i dati elaborati in una collection MongoDB.
Qui scriverai il DataFrame contenente il ricavo totale per paese in una nuova collection.
Modifica il codice nel tuo file transactions.py:
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, sum as _sum

spark = SparkSession.builder \
    .appName('ReadTransactions') \
    .config(
        'spark.mongodb.read.connection.uri',
        # Replace with your built MongoDB connection string:
        '<Built Connection String>'
    ) \
    .config(
        'spark.jars.packages',
        'org.mongodb.spark:mongo-spark-connector_2.12:10.4.0'
    ) \
    .getOrCreate()

df = spark.read.format('mongodb').load()

# Calculate total revenue per country
revenue_per_country = df.groupBy('country').agg(
   _sum(col('price') * col('quantity')).alias('total_revenue')
)

# Write aggregated records into a new MongoDB collection:
revenue_per_country.write \
    .format('mongodb') \
    .mode('overwrite') \
    .option(
        'spark.mongodb.write.connection.uri',
        # Replace with your built MongoDB connection string:
        '<Built Connection String>'
    ) \
    .option(
        # Specify the target database name:
        'spark.mongodb.write.database',
        'pyspark_tutorial'
    ) \
    .option(
        # Specify the target collection name:
        'spark.mongodb.write.collection',
        'revenue_per_country'
    ) \
    .save()

# Stop the Spark session:
spark.stop()
Nel codice precedente, Spark scrive il DataFrame aggregato, revenue_per_country, in una nuova collection chiamata revenue_per_country nel tuo database pyspark_tutorial su MongoDB.
Infine, assicurati di sostituire '<built connection string>' in entrambe le configurazioni di connessione con la tua connection string MongoDB costruita. Poi esegui python transactions.py.
Ora mostriamo il tuo ricavo totale per paese su una pagina Django.
Per prima cosa, creiamo un nuovo model per il ricavo per paese. Aggiungi questo in fondo al file sales/models.py:
class RevenuePerCountry(models.Model):
    country = models.CharField(max_length=50)
    total_revenue = models.DecimalField(max_digits=15, decimal_places=2)

    class Meta:
        # Define the collection (table) name in MongoDB:
        db_table = 'revenue_per_country'
        # Order results by total_revenue when querying:
        ordering = ['total_revenue']

    def __str__(self):
        # Return a readable string representation of the record:
        return f'{self.country}: ${self.total_revenue}'
Successivamente, modifica il file sales/views.py per recuperare e visualizzare la collection revenue_per_country:
from django.shortcuts import render
from .models import Transaction

# Import the RevenuePerCountry model:
from .models import RevenuePerCountry

def transaction_list_view(request):
    transactions = Transaction.objects.all()
    total_revenue = sum(t.total_amount for t in transactions)
    return render(request, 'sales/transaction_list.html', {
        'transactions': transactions,
        'total_revenue': total_revenue,
    })

# Add a new view to fetch and display your revenue per country:
def revenue_per_country_view(request):
    revenue_per_country = RevenuePerCountry.objects.all()
    return render(request, 'sales/revenue_per_country.html', {'revenue_per_country': revenue_per_country})
Aggiungi una route alla nuova view in sales/urls.py:
from django.urls import path
from . import views

urlpatterns = [
    path('', views.transaction_list_view, name='transaction_list'),

    # Add new URL route:
    path('revenue_per_country/', views.revenue_per_country_view, name='revenue_per_country'),
]
Poi crea un nuovo template per mostrare il ricavo totale per paese.
Nella cartella sales/templates/sales, crea un file revenue_per_country.html e aggiungi quanto segue:
{% load static %}
<!DOCTYPE html>
<html lang="en">
<head>
    <title>Transactions</title>
    <link rel="stylesheet" href="{% static 'sales/styles.css' %}">
</head>
<body>
    <h1>Total Revenue by Country</h1>
    <a href="{% url 'transaction_list' %}">← Back to Transactions</a>
    <table>
        <tr>
            <th>Country</th>
            <th>Total Revenue (USD)</th>
        </tr>
        {% for r in revenue_per_country %}
        <tr>
            <td>{{ r.country }}</td>
            <td>${{ r.total_revenue|floatformat:2 }}</td>
        </tr>
        {% endfor %}
    </table>
</body>
</html>
Devi anche modificare il template sales/templates/sales/transaction_list.html per includere un link alla pagina del ricavo per paese. Aggiungi il seguente codice dopo <h3> ma prima di <table>:
<a href="{% url 'revenue_per_country' %}">View Total Revenue by Country</a>Esegui il server Django:
python manage.py runserverVisita http://127.0.0.1:8000/revenue_per_country/ per confermare che la nuova pagina venga visualizzata correttamente.
Complimenti! Hai usato con successo Apache Spark per elaborare i tuoi dati, li hai archiviati in MongoDB e hai mostrato i dati elaborati su una pagina web usando Django.
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



