Cursus
Werken met Llama 3
2 uur
15.5K
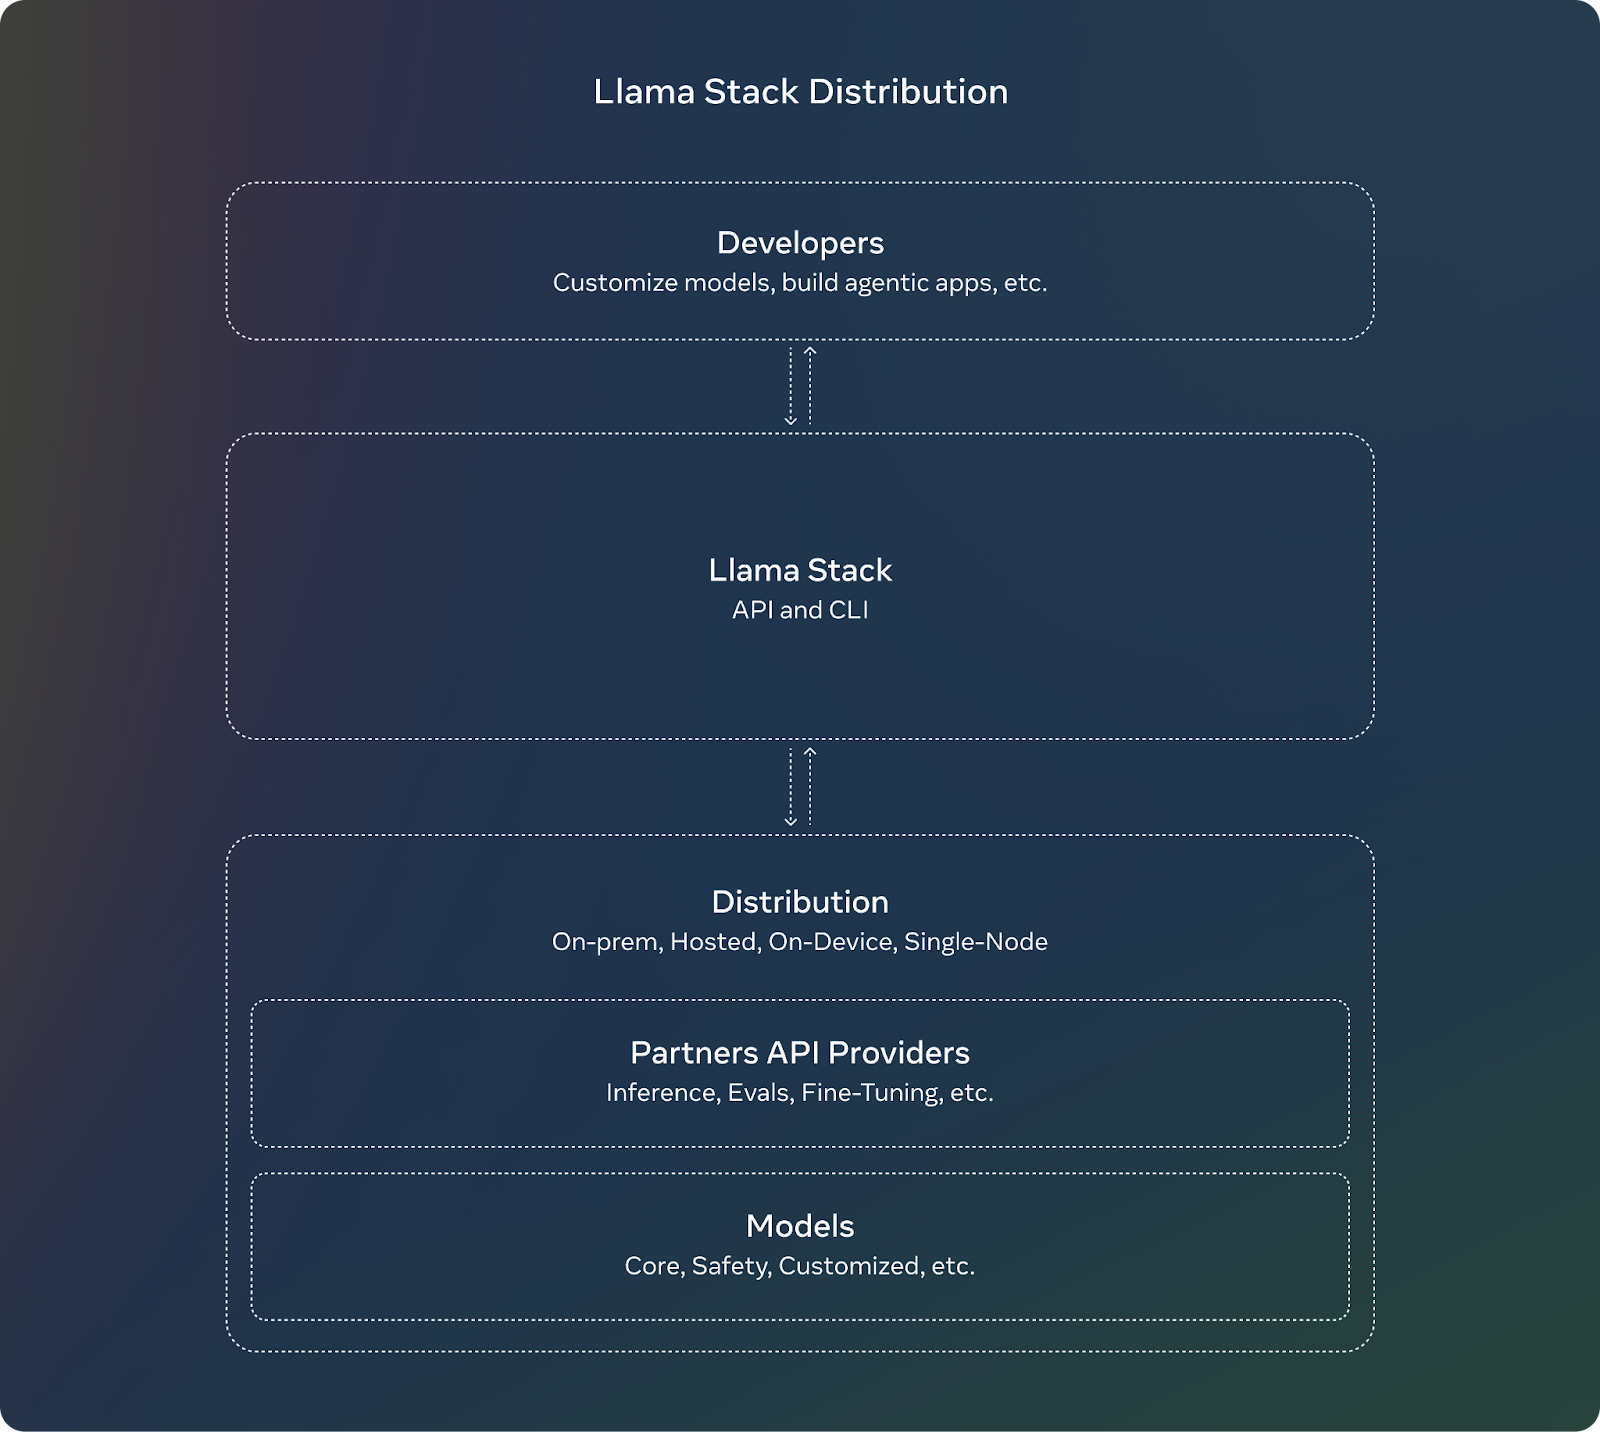
Llama Stack is een framework dat is gebouwd om de ontwikkeling en uitrol van generatieve AI-applicaties bovenop Meta’s Llama-modellen te stroomlijnen. Het doet dit door een verzameling gestandaardiseerde API’s en componenten te bieden voor taken zoals inferentie, veiligheid, geheugengebruik en agentfunctionaliteiten.
Dit zijn de doelen en voordelen:
Bron: Meta AI
Llama Stack bevat verschillende API’s die elk een specifieke set taken aanpakken bij het bouwen van een generatieve AI-applicatie.
De Inference API verzorgt de generatie van tekst of het aansturen van multimodale Llama-varianten. De belangrijkste features zijn:
De API definieert verschillende configuraties waarmee developers het modelgedrag kunnen sturen (bijv. FP8- of BF16-kwantisatie) op basis van de eisen van hun toepassing.
De Safety API is ontworpen voor verantwoorde uitrol van AI-modellen door content te modereren en schadelijke of mogelijk bevooroordeelde outputs te filteren. Je kunt schendingsniveaus configureren (bijv. INFO, WARN, ERROR) en bruikbare meldingen aan gebruikers teruggeven.
De Memory API maakt het mogelijk om eerdere interacties te behouden en erop te verwijzen, zodat gesprekken coherenter en contextbewuster worden. Dankzij de verschillende geheugenconfiguraties kunnen developers opslagtypen kiezen op basis van de behoeften van de applicatie. De belangrijkste features zijn:
De Agentic API stelt LLM’s in staat om externe tools en functies te gebruiken, zodat ze taken kunnen uitvoeren zoals websearch, code uitvoeren of geheugen ophalen. Met de API kunnen developers agents configureren met specifieke tools en doelen. Het ondersteunt multi-turn interacties waarbij elke beurt uit meerdere stappen bestaat. De belangrijkste features zijn:
Dit zijn de andere API’s die Llama Stack biedt:
We implementeren een voorbeeldproject op Llama Stack om vertrouwd te raken met het algemene idee en de mogelijkheden van dit framework.
Voordat we beginnen, let op het volgende:
Laten we beginnen met het instellen van de Llama command-line interface (CLI).
Llama Stack biedt een command-line interface (CLI) om distributies te beheren, modellen te installeren en omgevingen te configureren. Dit zijn de installatiestappen die we moeten nemen:
a. Maak en activeer een virtual environment:
conda create -n llama_stack python=3.10
conda activate llama_stack
b. Clone de Llama Stack-repository:
git clone <https://github.com/meta-llama/llama-stack.git>
cd llama-stack
c. Installeer de vereiste dependencies:
pip install llama-stack
pip install -r requirements.txtDocker-containers vereenvoudigen de uitrol van de Llama Stack-server en agent-API-providers. Er zijn kant-en-klare Dockerimages beschikbaar voor een eenvoudige setup:
docker pull llamastack/llamastack-local-gpu
llama stack build
llama stack configure llamastack-local-gpu
Deze commando’s halen het Dockerimage op, bouwen het en configureren de stack.
Laten we een eenvoudige chatbot bouwen met de Llama Stack-API’s. Dit zijn de stappen die we moeten nemen:
We draaien de server op poort 5000. Zorg dat de server actief is voordat je met de API’s werkt:
llama stack run local-gpu --port 5000Na installatie van Llama Stack kun je clientcode gebruiken om met de API’s te communiceren. Gebruik de Inference API om responses te genereren op basis van gebruikersinput:
from llama_stack_client import LlamaStackClient
client = LlamaStackClient(base_url="<http://localhost:5000>")
user_input = "Hello! How are you?"
response = client.inference.chat_completion(
    model="Llama3.1-8B-Instruct",
    messages=[{"role": "user", "content": user_input}],
    stream=False
)
print("Bot:", response.text)
Let op: Vervang "Llama3.1-8B-Instruct" door de daadwerkelijke modelnaam die in jouw setup beschikbaar is.
Implementeer de Safety API om responses te modereren en te zorgen dat ze passend zijn:
safety_response = client.safety.run_shield(
    messages=[{"role": "assistant", "content": response.text}],
    shield_type="llama_guard",
    params={}
)
if safety_response.violation:
    print("Unsafe content detected.")
else:
print("Bot:", response.text)Maak contextbewustzijn voor de chatbot door gespreksgeschiedenis op te slaan en op te halen:
### building a memory bank that can be used to store and retrieve context.
bank = client.memory.create_memory_bank(
    name="chat_memory",
    config=VectorMemoryBankConfig(
        type="vector",
        embedding_model="all-MiniLM-L6-v2",
        chunk_size_in_tokens=512,
        overlap_size_in_tokens=64,
    )
)We kunnen de API’s verder combineren om een robuuste chatbot te bouwen:
Hier is de volledige code nadat we alle stappen hebben doorlopen:
import uuid
client = LlamaStackClient(base_url="<http://localhost:5000>")
### create a memory bank at the start
bank = client.memory.create_memory_bank(
    name="chat_memory",
    config=VectorMemoryBankConfig(
        type="vector",
        embedding_model="all-MiniLM-L6-v2",
        chunk_size_in_tokens=512,
        overlap_size_in_tokens=64,
    )
)
def get_bot_response(user_input):
    ### retrieving conversation history
    query_response = client.memory.query_documents(
        bank_id=bank.bank_id,
        query=[user_input],
        params={"max_chunks": 10}
    )
    history = [chunk.content for chunk in query_response.chunks]
    ### preparing messages with history
    messages = [{"role": "user", "content": user_input}]
    if history:
        messages.insert(0, {"role": "system", "content": "\\n".join(history)})

    ### generate response
    response = client.inference.chat_completion(
        model="llama-2-7b-chat",
        messages=messages,
        stream=False
    )
    bot_response = response.text
    ### safety check
    safety_response = client.safety.run_shield(
        messages=[{"role": "assistant", "content": bot_response}],
        shield_type="llama_guard",
        params={}
    )
    if safety_response.violation:
        return "I'm sorry, but I can't assist with that request."
    ### memory storing
    documents = [
        MemoryBankDocument(
            document_id=str(uuid.uuid4()),
            content=user_input,
            mime_type="text/plain"
        ),
        MemoryBankDocument(
            document_id=str(uuid.uuid4()),
            content=bot_response,
            mime_type="text/plain"
        )
    ]
    client.memory.insert_documents(
        bank_id=bank.bank_id,
        documents=documents
    )
    return bot_response
### putting all together
while True:
    user_input = input("You: ")
    if user_input.lower() == "bye":
        break
    bot_response = get_bot_response(user_input)
print("Bot:", bot_response)Om voorbeelden te zien en je implementatie van applicaties met Llama Stack snel op gang te brengen, heeft Meta de llama-stack-apps-repository beschikbaar gesteld waar je voorbeeldapplicaties kunt bekijken. Zorg dat je het framework bekijkt en er vertrouwd mee raakt.
Als open-sourceproject drijft Llama Stack op bijdragen van de community. De API’s evolueren snel en het project staat open voor feedback en participatie van developers, die zo mee de toekomst van het platform vormgeven. Als je Llama Stack test, help je andere developers door je project als voorbeeld te delen of bij te dragen aan de documentatie.
In dit artikel hebben we stap voor stap bekeken hoe je start met Llama Stack.
Houd bij het uitrollen van je AI-applicaties de Llama Stack-repository in de gaten voor de nieuwste updates en verbeteringen.
Wil je meer weten over het Llama-ecosysteem? Bekijk dan deze resources:
Leer AI met deze cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

