{count, plural, one {Cursus} other {Cursussen}}
Werken met Llama 3
{hours} uur
15.6K
Volgens de voorbeelden van Meta kunnen de modellen grafieken in documenten analyseren en belangrijke trends samenvatten. Ze kunnen ook kaarten interpreteren, bepalen welk deel van een wandelpad het steilst is of de afstand tussen twee punten berekenen.
Deze integratie van tekst- en beeldredeneren biedt een breed scala aan mogelijke toepassingen, waaronder:
De vision-modellen van Llama 3.2 zijn open en aanpasbaar. Ontwikkelaars kunnen fine-tunen op zowel voorgetrainde als uitgelijnde versies van deze modellen met behulp van Meta’s Torchtune-framework.
Bovendien kunnen deze modellen lokaal worden uitgerold via Torchchat, waardoor de afhankelijkheid van cloud-infrastructuur afneemt en er een oplossing is voor ontwikkelaars die AI-systemen willen uitrollen on-prem of in omgevingen met beperkte resources.
De vision-modellen zijn ook beschikbaar om te testen via Meta AI, Meta’s intelligente assistent.
Om de Llama 3.2-visionmodellen zowel tekst als afbeeldingen te laten begrijpen, integreerde Meta een voorgetrainde beeldencoder in het bestaande taalmodel met speciale adapters. Deze adapters koppelen beelddata aan de tekstverwerkingsonderdelen van het model, zodat het beide soorten input kan afhandelen.
Het trainingsproces begon met het Llama 3.1-taalmodel. Eerst trainde het team op grote sets afbeeldingen gekoppeld aan tekstbeschrijvingen om het model te leren de twee te verbinden. Vervolgens verfijnden ze het met schonere, specifiekere data om het vermogen om visuele content te begrijpen en te beredeneren te verbeteren.
In de laatste fasen gebruikte Meta technieken zoals fine-tuning en synthetische data-generatie om ervoor te zorgen dat het model behulpzame antwoorden geeft en veilig gedrag vertoont.
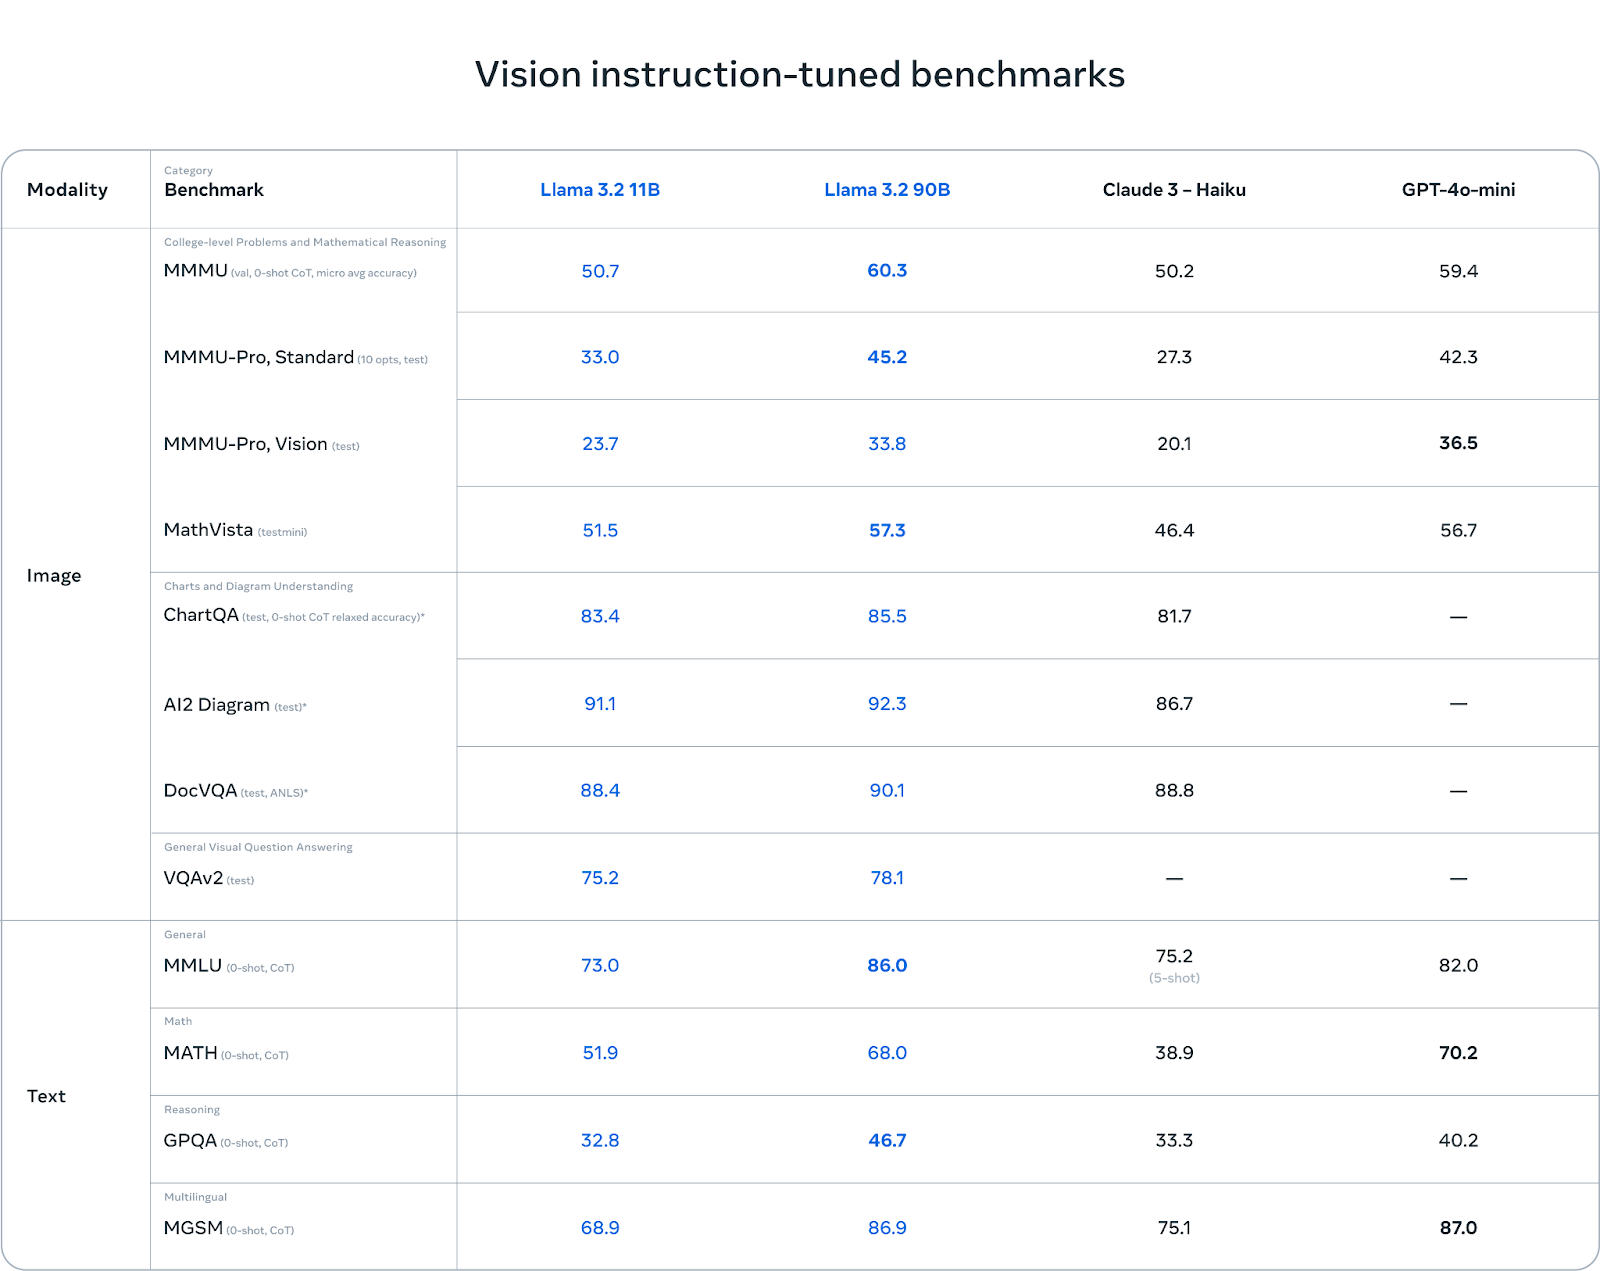
De Llama 3.2-visionmodellen blinken uit in het begrijpen van grafieken en diagrammen. In benchmarks zoals AI2 Diagram (92,3) en DocVQA (90,1) presteert Llama 3.2 beter dan Claude 3 Haiku. Dit maakt het een uitstekende keuze voor taken met documentniveau-begrip, visuele vraagbeantwoording en data-extractie uit grafieken.
Bij meertalige taken (MGSM) presteert Llama 3.2 ook goed en evenaart het bijna GPT-4o-mini met een score van 86,9, wat het een solide optie maakt voor ontwikkelaars die met meerdere talen werken.
Bron: Meta AI
Hoewel Llama 3.2 goed presteert in vision-taken, ondervindt het uitdagingen in andere domeinen. In MMMU-Pro Vision, dat wiskundig redeneren over visuele data test, overtreft GPT-4o-mini Llama 3.2 met een score van 36,5 tegenover Llama’s 33,8.
Ook in de MATH-benchmark presteert GPT-4o-mini (70,2) aanzienlijk beter dan Llama 3.2 (51,9), wat laat zien dat Llama nog ruimte heeft voor verbetering bij wiskundige redeneertaken.
Een andere belangrijke vooruitgang in Llama 3.2 is de introductie van lichtgewicht modellen voor edge- en mobiele apparaten. Deze modellen, met 1 en 3 miljard parameters, zijn geoptimaliseerd om op kleinere hardware te draaien met een redelijke compromis op prestaties.
Deze modellen zijn ontworpen om op mobiele apparaten te draaien, met snelle, lokale verwerking zonder data naar de cloud te sturen. Lokaal draaien op edge-apparaten biedt twee belangrijke voordelen:
De lichtgewicht modellen van Llama 3.2 zijn geoptimaliseerd voor Arm-processors en ingeschakeld op hardware van Qualcomm en MediaTek, die veel mobiele en edge-apparaten van vandaag aandrijven.
De lichtgewicht modellen zijn ontworpen voor diverse praktische on-device toepassingen, zoals:
1. Samenvatten: Gebruikers kunnen grote hoeveelheden tekst, zoals e-mails of vergadernotities, direct op hun apparaat samenvatten zonder afhankelijk te zijn van clouddiensten.
De lichtgewicht modellen van Llama 3.2 (1B en 3B) zijn gebouwd om efficiënt op mobiele en edge-apparaten te passen, terwijl ze sterke prestaties behouden. Hiervoor gebruikte Meta twee belangrijke technieken: pruning en distillatie.
Bron: Meta AI
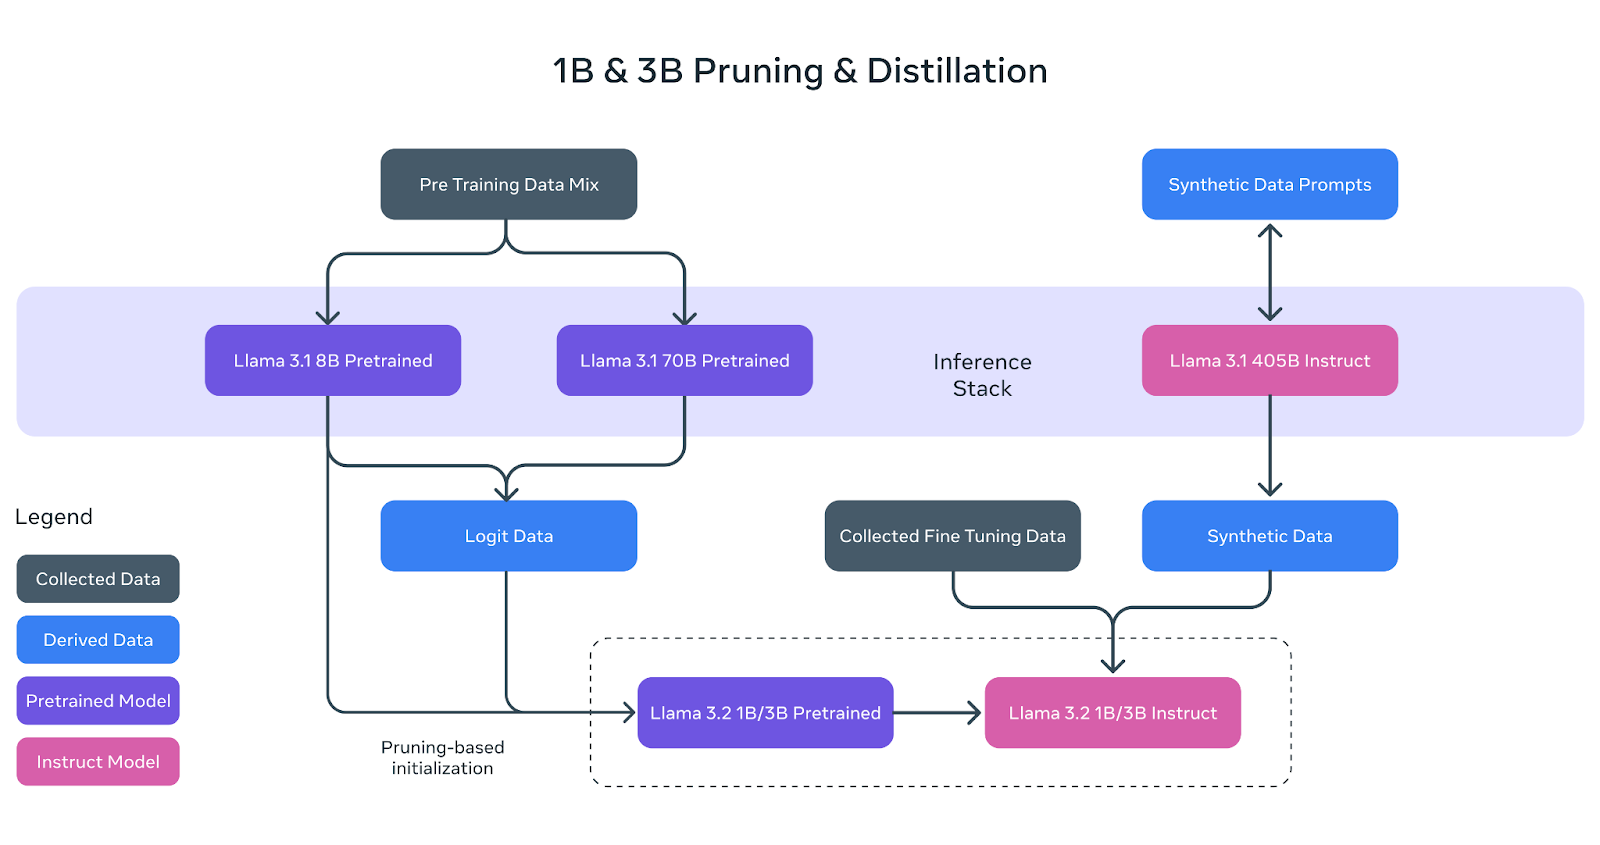
Pruning helpt de oorspronkelijke Llama-modellen te verkleinen door minder cruciale delen van het netwerk te verwijderen, met behoud van zoveel mogelijk kennis. In het geval van de 1B- en 3B-modellen van Llama 3.2 begon dit proces met het grotere voorgetrainde Llama 3.1 8B-model.
Door systematisch te prunen kon het Meta AI-team kleinere, efficiëntere versies van het model creëren zonder noemenswaardig prestatiedverlies. Dit wordt weergegeven in het bovenstaande diagram, waar het 8B-voorgetrainde model (paarse kader) wordt gepruned en verfijnd tot de basis voor de kleinere Llama 3.2 1B/3B-modellen.
Distillatie is het overdragen van kennis van een groter, krachtiger model (de “leraar”) naar een kleiner model (de “student”). In Llama 3.2 werden logits (voorspellingen) van de grotere Llama 3.1 8B- en Llama 3.1 70B-modellen gebruikt om de kleinere modellen te trainen.
Zo konden de kleinere 1B- en 3B-modellen taken effectiever leren uitvoeren, ondanks hun beperkte omvang. Het bovenstaande diagram toont hoe dit proces logits-data van de grotere modellen gebruikt om de 1B- en 3B-modellen tijdens pre-training te sturen.
Na pruning en distillatie ondergingen de 1B- en 3B-modellen post-training, vergelijkbaar met eerdere Llama-modellen. Dit omvatte technieken zoals supervised fine-tuning, rejection sampling en direct preference optimization om de uitkomsten van de modellen af te stemmen op gebruikersverwachtingen.
Er werd ook synthetische data gegenereerd om te waarborgen dat de modellen een breed scala aan taken aankunnen, zoals samenvatten, herschrijven en opvolgen van instructies.
Zoals in het diagram te zien is, zijn de uiteindelijke Llama 3.2 1B/3B instruct-modellen het resultaat van pruning, distillatie en uitgebreide post-training.
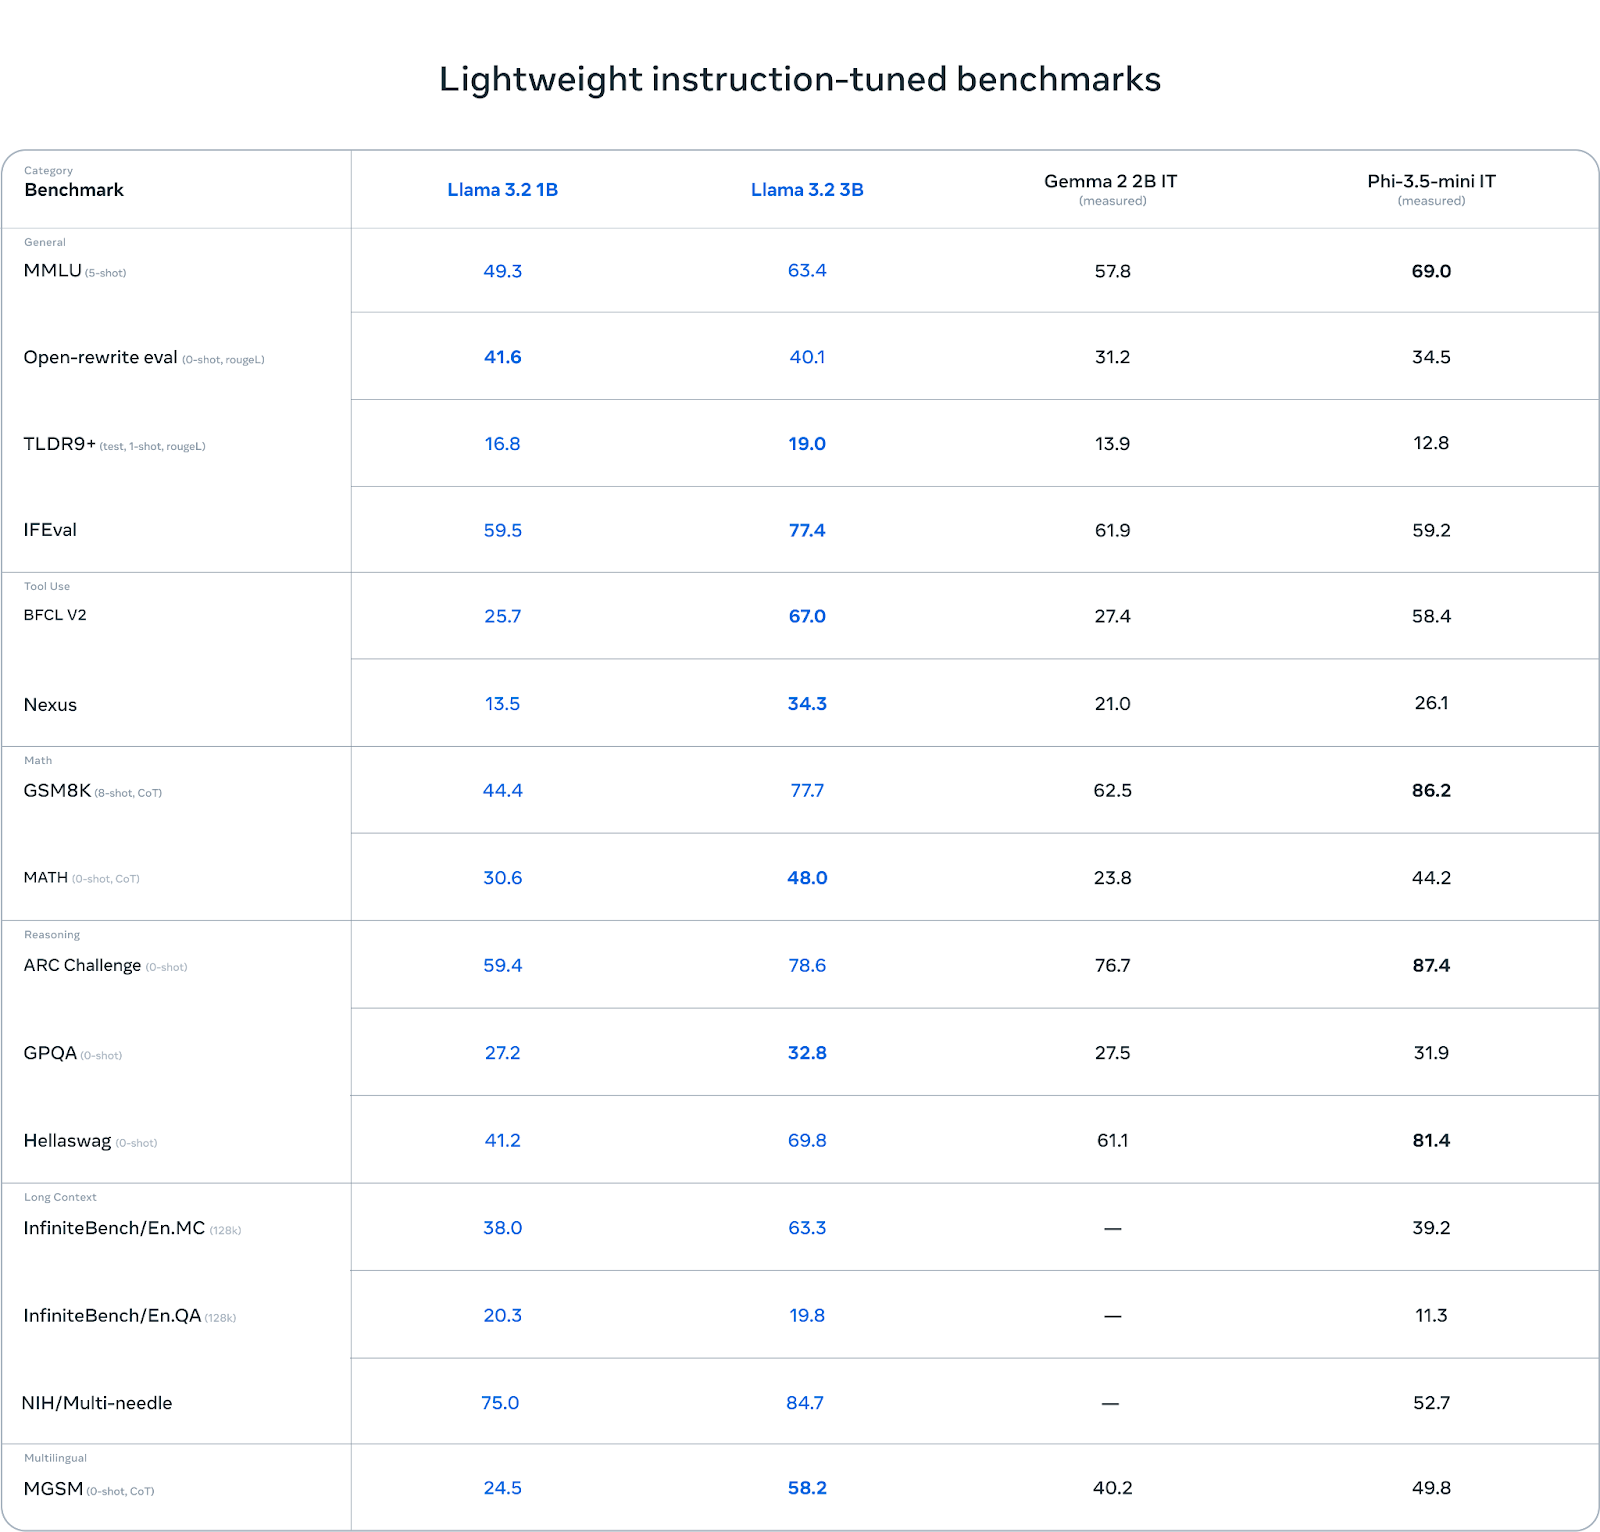
Llama 3.2 3B springt eruit in bepaalde categorieën, vooral bij taken met redeneren. In de ARC Challenge bijvoorbeeld scoort het 78,6, beter dan Gemma (76,7) en net achter Phi-3.5-mini (87,4). Ook in de Hellawag-benchmark doet het het goed met 69,8, waarmee het Gemma verslaat en competitief blijft met Phi.
Bij toolgebruiktaken zoals BFCL V2 blinkt Llama 3.2 3B ook uit met een score van 67,0, vóór beide concurrenten. Dit toont aan dat het 3B-model instructie-opvolging en toolgerelateerde taken effectief aankan.
Bron: Meta AI
Ter aanvulling op de release van Llama 3.2 introduceert Meta de Llama Stack. Voor ontwikkelaars betekent het gebruik van de Llama Stack dat ze zich geen zorgen hoeven te maken over de complexe details van het opzetten of uitrollen van grote modellen. Ze kunnen zich richten op het bouwen van hun applicaties en erop vertrouwen dat de Llama Stack het zware werk uit handen neemt.
Dit zijn de belangrijkste kenmerken van de Llama Stack:
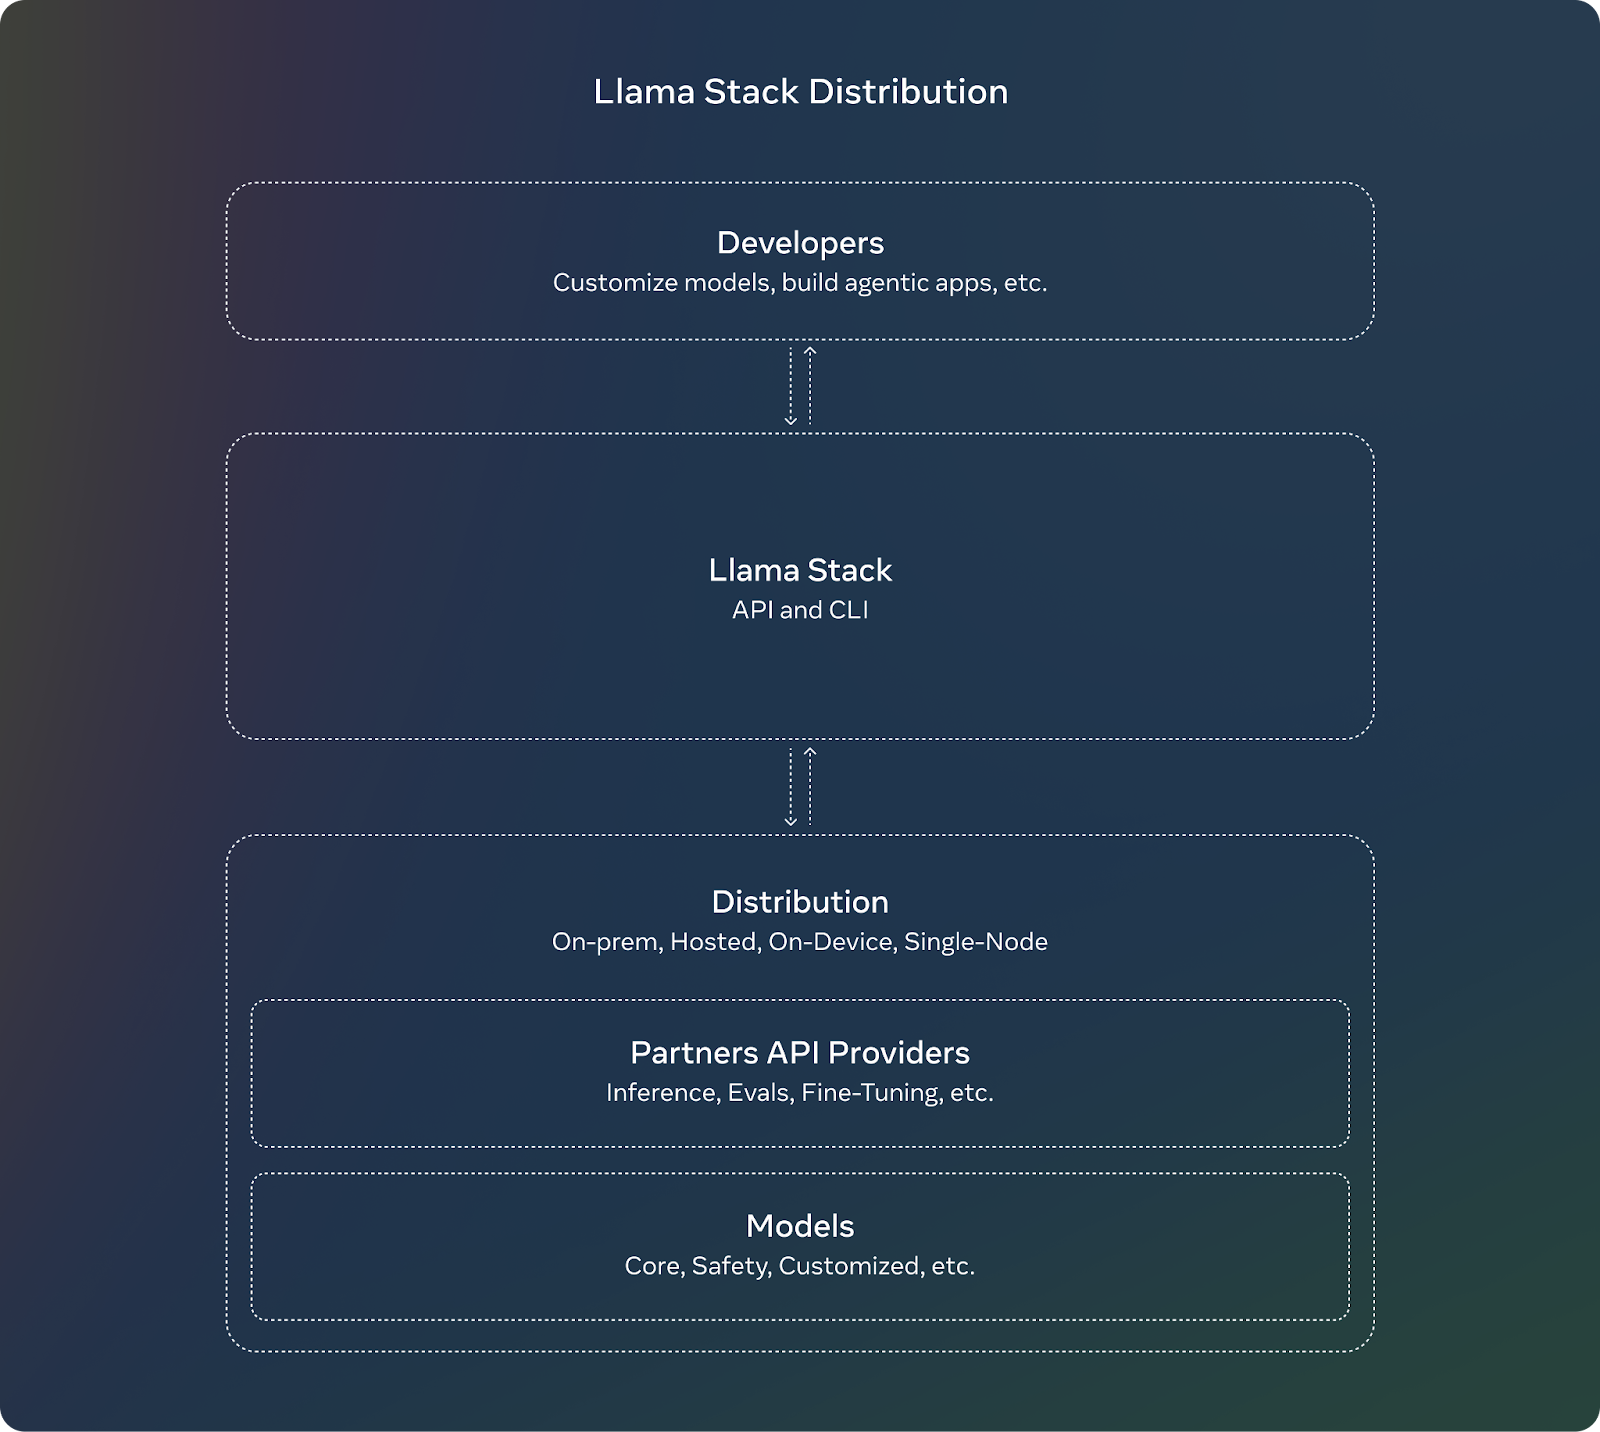
Bron: Meta AI
Meta zet met Llama 3.2 zijn focus op verantwoorde AI voort. Llama Guard 3 is geüpdatet met een vision-geschakelde versie die de nieuwe multimodale mogelijkheden van Llama 3.2 ondersteunt. Zo blijven toepassingen die de nieuwe beeldbegripfuncties gebruiken veilig en in lijn met ethische richtlijnen.
Daarnaast is Llama Guard 3 1B geoptimaliseerd voor uitrol in omgevingen met nog beperktere resources, waardoor het kleiner en efficiënter is dan eerdere versies.
Toegang krijgen tot en het downloaden van de Llama 3.2-modellen is vrij eenvoudig. Meta heeft deze modellen beschikbaar gemaakt op meerdere platforms, waaronder hun eigen website en Hugging Face, een populair platform voor het hosten en delen van AI-modellen.
Je kunt Llama 3.2-modellen rechtstreeks downloaden van de officiële Llama-website. Meta biedt zowel de kleinere, lichtgewicht modellen (1B en 3B) als de grotere vision-geschakelde modellen (11B en 90B) aan voor ontwikkelaars.
Hugging Face is een ander platform waar Llama 3.2-modellen beschikbaar zijn. Het biedt makkelijke toegang en wordt veel gebruikt door ontwikkelaars in de AI-community.
De Llama 3.2-modellen zijn direct inzetbaar voor ontwikkeling op ons brede ecosysteem van partnerplatforms, waaronder AMD, AWS, Databricks, Dell, Google Cloud, Groq, IBM, Intel, Microsoft Azure, NVIDIA, Oracle Cloud, Snowflake en andere.
Meta’s release van Llama 3.2 introduceert de eerste multimodale modellen in de serie, met focus op twee kerndomeinen: vision-geschakelde modellen en lichtgewicht modellen voor edge- en mobiele apparaten.
De multimodale modellen van 11B en 90B kunnen nu zowel tekst- als beeldverwerking aan, terwijl de 1B- en 3B-modellen geoptimaliseerd zijn voor efficiënte, lokale inzet op kleinere apparaten.
In dit artikel heb ik de essentie uiteengezet: hoe deze modellen werken, hun praktische toepassingen en hoe je er toegang toe krijgt.
Leer AI met deze cursussen!
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

