
{count, plural, one {Cursus} other {Cursussen}}
Introductie tot dbt
{hours} uur
34.1K
Load balancing is een concept dat op meer plekken opduikt dan je zou verwachten.
Neem een zaterdagochtend in een overvolle supermarkt met maar één open kassa. Vijftien mensen staan in de rij, iedereen is geïrriteerd, en de arme caissière lijkt elk levensbesluit dat tot dit moment leidde opnieuw te overwegen. De spanning loopt op, totdat er ineens 3 medewerkers verschijnen, een paar extra kassa’s openen en mensen naar de kortste rijen sturen. Alles gaat sneller, de druk valt weg en de rijen beginnen normaal te bewegen. Dat is, in essentie, load balancing.
In dit artikel neem ik je mee door wat load balancing is, waarom het belangrijk is, hoe het onder de motorkap werkt en hoe het voorkomt dat de digitale wereld uit elkaar valt als het druk wordt. Je hebt geen specifieke voorkennis nodig om dit artikel te volgen, dus maak je geen zorgen als je niet diep in netwerken of cloudarchitectuur zit! Deze gids blijft duidelijk, praktisch en (hopelijk) een beetje leuk.
In de techwereld is load balancing de manier waarop we inkomend verkeer of taken over meerdere servers of resources verdelen. In plaats van één machine te laten verzuipen onder alle druk, spreidt een load balancer het werk zodat alles snel, stabiel en schaalbaar blijft. Het is overal in moderne infrastructuur: cloudplatforms gebruiken het om miljoenen gebruikers aan te kunnen, AI-pijplijnen leunen erop om datalasten over nodes te verdelen en e-commercesites rekenen erop om Black Friday te overleven.
Stel je even voor dat je app geen load balancer heeft. Eén server krijgt alle requests, al het verkeer, alle druk. Misschien houdt die het even vol, tot het (onvermijdelijk) niet meer gaat. Hij wordt traag, gebruikers raken gefrustreerd, misschien crasht hij helemaal. Ondertussen zitten de andere servers digitaal duimen te draaien, zonder iets te doen.
Zonder load balancing zit je in feite met:
Met een load balancer ziet het er heel anders uit. Die zit vóór je backendservers, houdt in de gaten hoe het met elke server gaat en verdeelt inkomende requests naar degene die het gezondst of het minst druk is. Sommige monitoren zelfs zaken als responstijd of serverresources in real time.
Dit levert je op:
Als je nog aan het supermarktvoorbeeld denkt: stel je die rij van 15 mensen voor die slim wordt verdeeld over vijf kassa’s. Niemand raakt in paniek, niemand schreeuwt, en jij bent sneller bij het diepvriespaden met pizza. Dat is het doel.
We hebben het gehad over waarom load balancing nuttig is. Laten we nu kijken naar hoe het onder de motorkap werkt.
Op hoofdlijnen zit een load balancer tussen de clients (mensen of systemen die requests doen) en je backendservers (degene die het werk doen). Zijn taak is elk inkomend verzoek ontvangen en beslissen waar het naartoe moet.
Dit is de basisstroom:
In theorie vrij eenvoudig, maar achter de schermen gebeurt er veel, en er zijn een paar kernconcepten die zorgen dat het werkt:
Kleine sidenote: “load balancing” is het concept (verkeer verdelen), en een “load balancer” is de tool of service die het mogelijk maakt. Je hoort beide termen vaak door elkaar, maar het helpt om het onderscheid te kennen.
Hoewel load balancers soms gewoon willekeurig een server kiezen, zijn er echte strategieën, zogeheten load balancing-algoritmen, die bepalen hoe inkomend verkeer over backendresources wordt verdeeld.
Sommige zijn vrij simpel en voorspelbaar, terwijl andere zich in real time aanpassen op basis van serverprestaties, aantal verbindingen of responssnelheid. Laten we ze opdelen in twee brede categorieën.
Deze passen zich niet aan wat er in het systeem gebeurt; ze volgen gewoon een vooraf gedefinieerde regel. Dat maakt ze voorspelbaar en makkelijk te implementeren, maar niet altijd ideaal onder druk in de echte wereld.
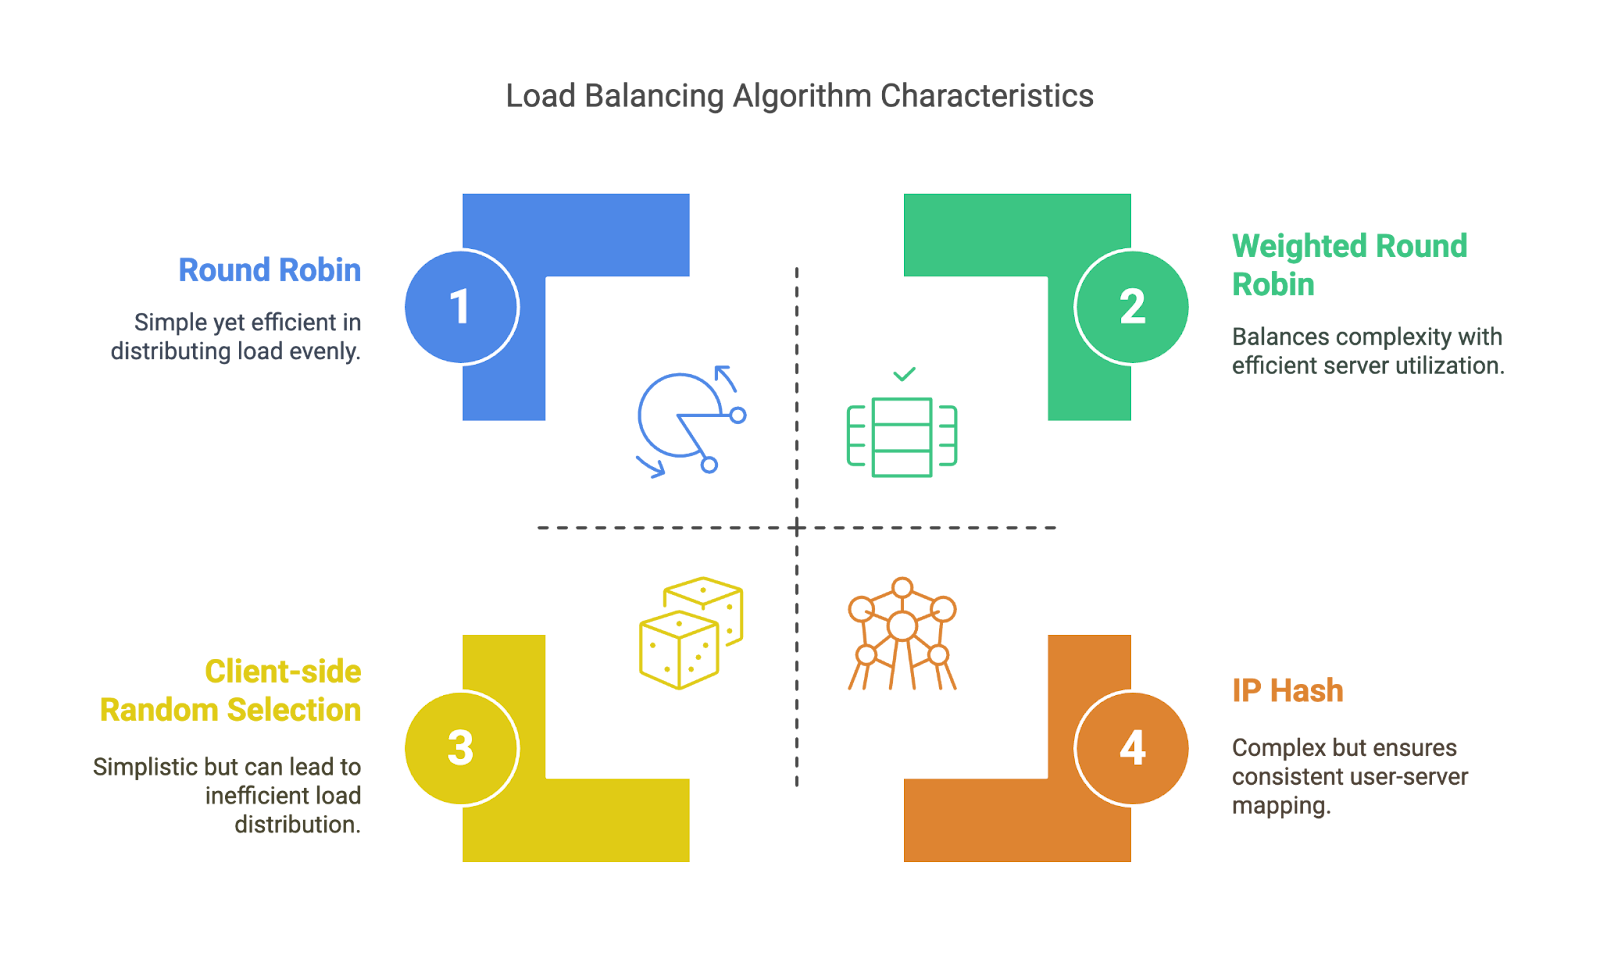
Statische algoritmen. Afbeelding door de auteur
Deze algoritmen passen zich aan op basis van wat er daadwerkelijk in het systeem gebeurt. Ze zijn slimmer, maar vereisen meer monitoring en systeeminzicht.
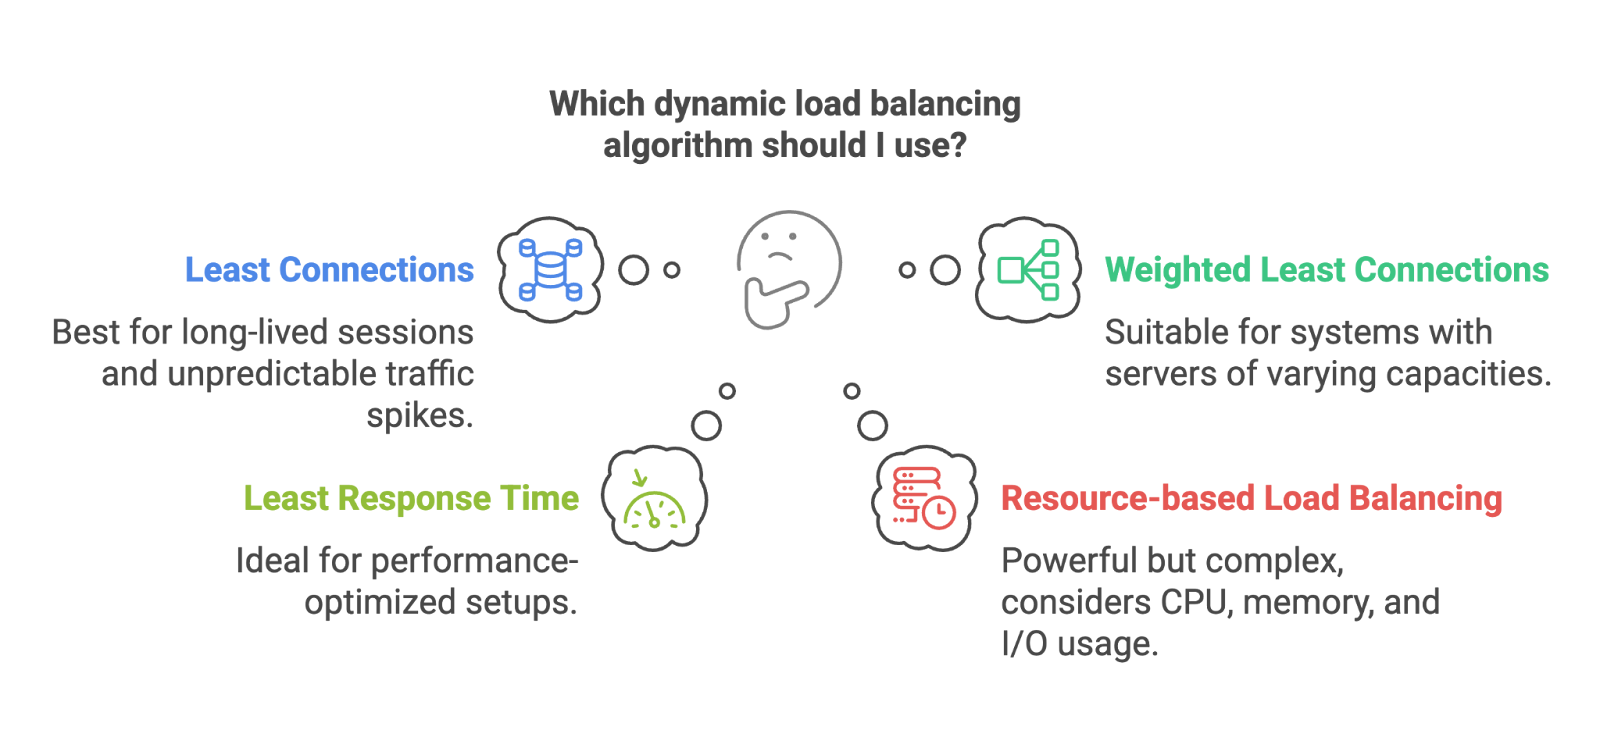
Dynamische algoritmen. Afbeelding door de auteur
Statische algoritmen zijn top als je verkeer voorspelbaar is en je servers gelijkwaardig zijn. Dynamische algoritmen blinken uit als het allemaal wat chaotischer is.
Oké, laten we nu praten over de verschillende soorten load balancers zelf: hardware, software, cloud-native en meer.
Niet alle load balancers zijn gelijk. Sommige leven in hardware, sommige draaien als software, sommige worden meegeleverd met clouddiensten en sommige zijn gespecialiseerd in heel specifieke use-cases. Welke je gebruikt hangt af van je architectuur, je schaal en soms gewoon je budget.
Dit zijn fysieke appliances in je datacenter, speciaal gebouwd om verkeer te balanceren. Ze zijn krachtig en snel, maar duur en lastiger on-demand te schalen. Denk aan grote enterprises en on-prem-opstellingen.
Deze draaien als applicaties op general-purpose servers. Tools zoals HAProxy, nginx (eigendom van F5) of Envoy vallen in deze categorie. Ze zijn goedkoper, flexibeler en makkelijker te integreren in de meeste omgevingen.
Als je AWS, Azure of GCP gebruikt, gebruik je waarschijnlijk al een cloud-native load balancer, zoals AWS ELB, Azure Load Balancer of GCP Load Balancing. Ze worden voor je beheerd, schalen automatisch en integreren netjes met andere services.
Wil je zien hoe AWS dit aanpakt (en nog een heleboel andere infrastructuuronderdelen), bekijk dan onze cursus AWS Cloud Technology and Services Concepts.
Je hebt misschien gehoord van elastische load balancers. Die zijn ontworpen om mee te schalen met je workload. Ze maken vaak deel uit van cloud-native systemen, maar de term “elastisch” betekent simpelweg dat ze zich dynamisch aan verkeer kunnen aanpassen, ideaal bij pieken of onvoorspelbare belasting.
Het OSI-model is een conceptueel raamwerk dat beschrijft hoe data door een netwerk beweegt. Het heeft zeven lagen, van de fysieke kabel tot aan de app in je browser. Voor load balancing zijn laag 4 en 7 het meest relevant.
Deze nemen routeringsbeslissingen op basis van IP-adressen, poorten en TCP/UDP-verkeer. Ze zijn snel en efficiënt, maar weten niets van de inhoud die wordt verstuurd.
Deze kijken naar de daadwerkelijke inhoud van de request, zoals HTTP-headers, cookies of URL’s. Daarmee kunnen ze geavanceerdere dingen doen, zoals routeren op basis van URL-pad, A/B-testen of taalvoorkeuren. Als je bijvoorbeeld wilt dat /api/-requests naar het ene cluster gaan en /login naar een ander, dan heb je laag 7 nodig.
Gebruikt om verkeer over geografisch verspreide datacenters te verdelen. Handig voor multiregio-, low-latency- of disaster recovery-opstellingen.
Werken volledig binnen private netwerken, gebruikt om verkeer tussen services binnen een cloud of cluster te balanceren.
Gespecialiseerd voor telecomsystemen die het Diameter-protocol gebruiken, vaak te vinden in mobiele netwerken voor routering, authenticatie en billing-requests.
Deze zijn geoptimaliseerd voor specifiek HTTP- en HTTPS-verkeer. Ze bevatten vaak SSL-terminatie, op URL gebaseerde routing en ingebouwde DDoS-bescherming.
Elk type load balancer lost een ander soort probleem op. Sommige focussen op schaal, andere op latency, beveiliging of gebruiksgemak. Weten welke je moet kiezen kan een groot verschil maken in hoe soepel (of pijnlijk) je infrastructuur draait.
Tot nu toe hebben we besproken wat load balancers doen en welke types je kunt gebruiken, maar hoe zitten ze onder de motorkap in elkaar? De architectuur van een loadbalancingsysteem beïnvloedt alles: van hoe goed het schaalt tot hoe gracieus het met storingen omgaat.
Dit is de klassieke opzet: één “leader”-node neemt de beslissingen en verdeelt werk over meerdere “worker”-nodes. Simpel en overzichtelijk, maar de leader kan een bottleneck of single point of failure worden als die niet goed is geback-upt.
In plaats van één centraal brein is elke load balancer zich bewust van zijn peers en deelt het werk. Dit verbetert fouttolerantie en schaalbaarheid, maar maakt coördinatie wat lastiger. Je ziet dit vaak in grootschalige systemen met anycast-routing of DNS-gebaseerde verdeling.
In gecontaineriseerde omgevingen, vooral met Kubernetes, wordt load balancing nog interessanter. Services, ingress controllers en sidecars werken samen om verkeer slim binnen clusters te routeren. Als je net begint met die wereld, is onze cursus Introduction to Kubernetes een praktische manier om de basis te leren.
In deze opzet kunnen idle workers taken “stelen” van drukke workers. Wordt vaak gebruikt in rekenintensieve omgevingen zoals taakqueues of datapijplijnen, maar minder bij webverkeer. Het is wel een nuttig patroon voor het balanceren van onvoorspelbare workloads.
Sommige systemen stapelen hun load balancers, bijvoorbeeld één op globaal niveau (regio-overstijgend), een andere op datacenterniveau en een derde binnen een specifieke servicecluster. Dit helpt om complexiteit te beheersen en houdt elke laag gefocust op een specifieke scope.
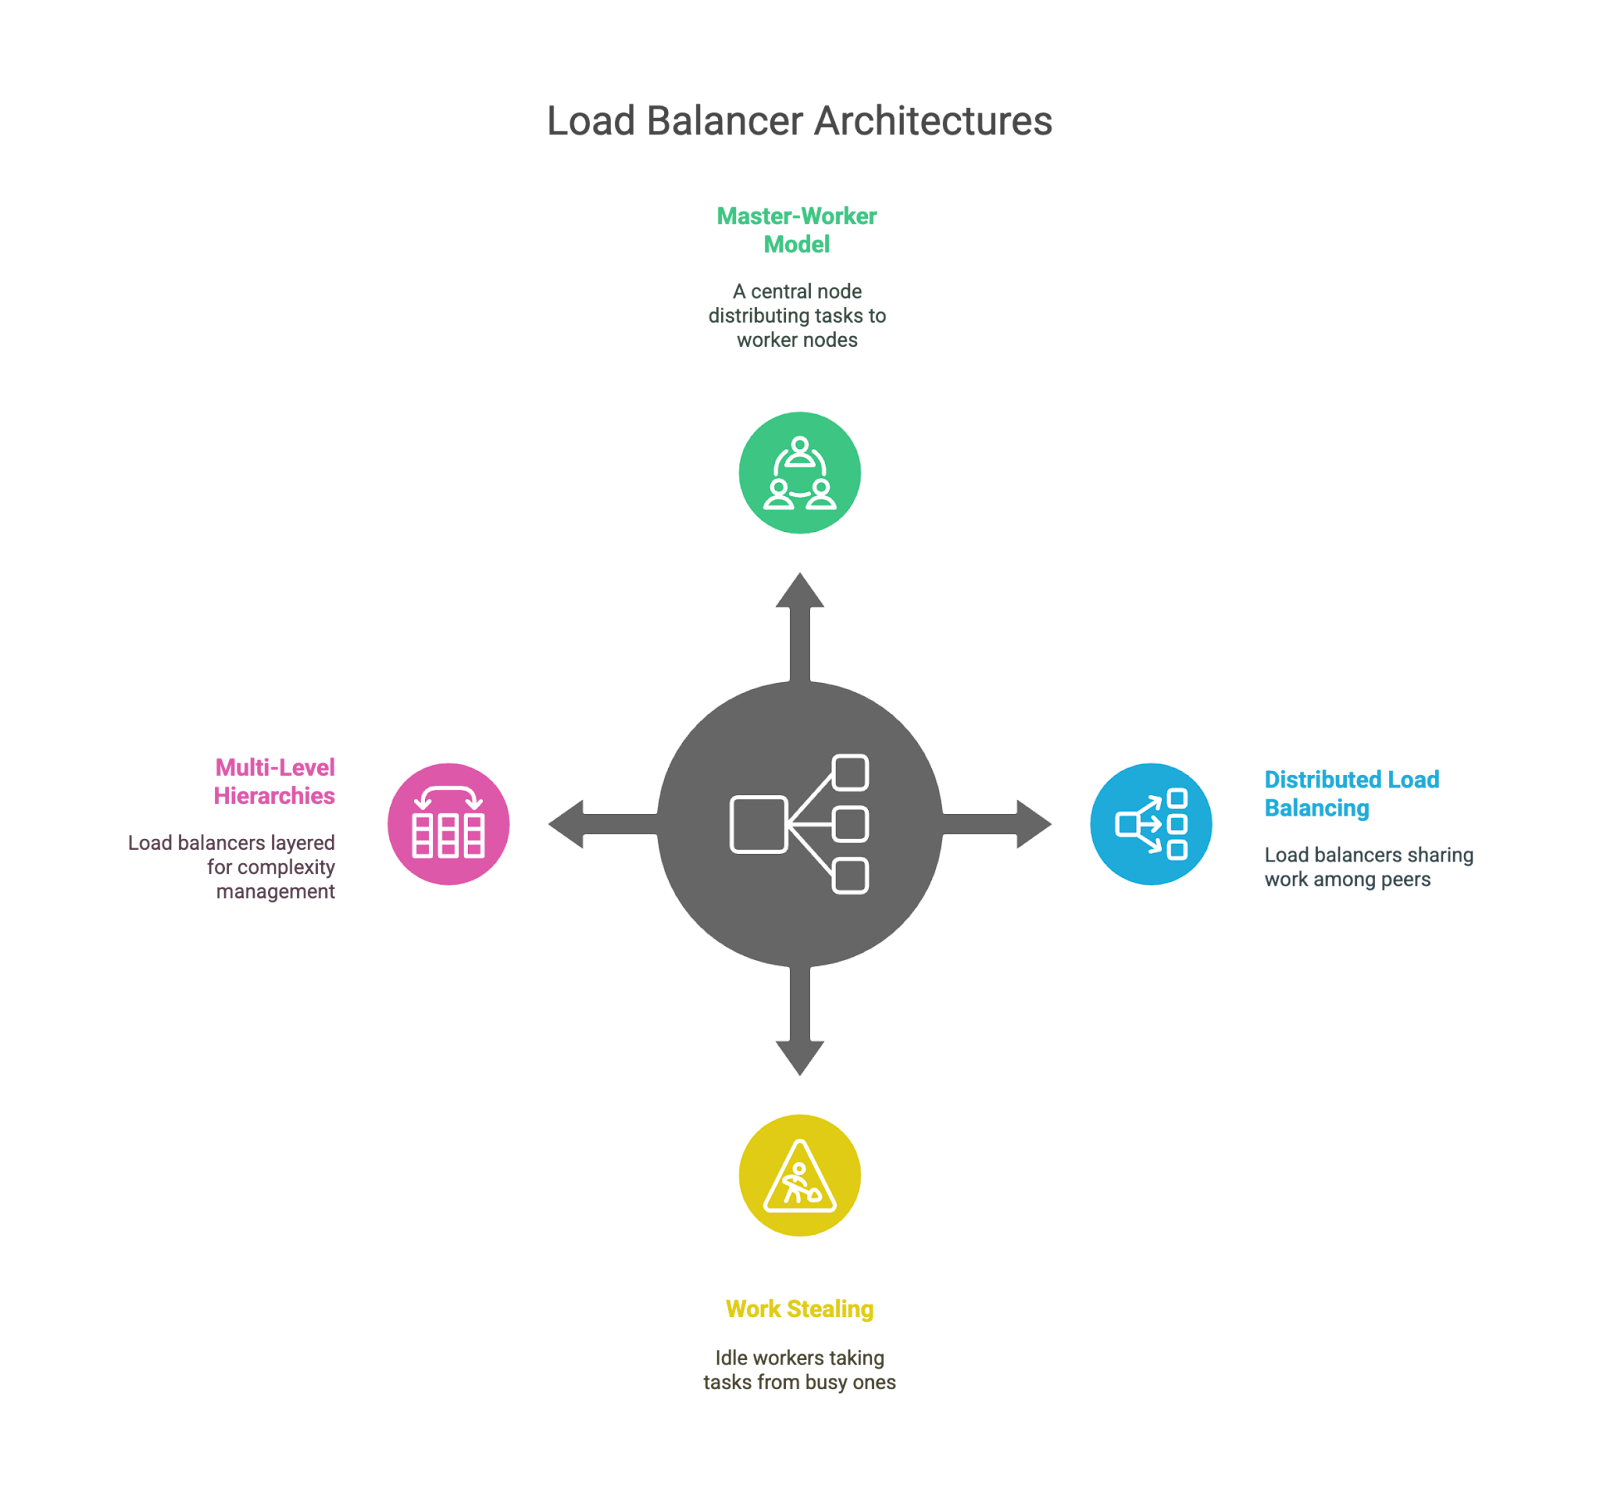
Architecturen voor load balancing.
Elk van deze architecturen kent trade-offs. Gecentraliseerde modellen zijn makkelijk te begrijpen maar riskeren knelpunten te worden, gedistribueerde modellen schalen beter maar voegen complexiteit toe, en gelaagde topologieën bieden modulariteit maar kunnen latency introduceren als ze niet zorgvuldig zijn ontworpen. Zoals gewoonlijk is er geen one-size-fits-all antwoord. Het hangt af van de grootte van je systeem, verkeerspatronen en risicotolerantie.
Load balancing is krachtig, maar geen magie. Hoewel het systemen betrouwbaarder, schaalbaarder en efficiënter kan maken, introduceert het ook nieuwe lagen van complexiteit en potentiële faalpunten. Laten we enkele trade-offs bespreken waar engineers tegenaan lopen, zowel technisch als operationeel.
Ironisch genoeg kan juist de tool die verkeer verdeelt een single point of failure worden als de architectuur niet deugt, zeker in gecentraliseerde of leader-gebaseerde modellen. Daarom gebruiken veel systemen meerdere load balancers, failovermechanismen of zelfs DNS-niveau-balancering om het risico te spreiden.
Hoe snel ook, een load balancer voegt alsnog een extra hop toe tussen client en backend. Dat kan latency introduceren, vooral in meerlagige architecturen of bij routering op applicatielaag (laag 7).
HTTPS-verkeer op het niveau van de load balancer afhandelen (oftewel SSL-terminatie) kan CPU-werk bij backendservers wegnemen, maar betekent ook dat de load balancer meer doet en verantwoordelijk wordt voor gevoelige beveiligingsinstellingen en certificaten.
Sticky sessions zijn handig om gebruikers aan dezelfde backend te koppelen (zoals tijdens inloggen), maar maken schalen complexer en bemoeilijken volledig stateless services. Engineers moeten vaak kiezen tussen gebruikerservaring en architecturale elegantie.
Hoe intelligenter je routeringslogica, hoe meer ruimte voor bugs, misrouting of subtiele performanceproblemen die lastig te traceren zijn. Je voelt je slim bij het opzetten, en een stuk minder als je om 2 uur ’s nachts wakker wordt gebeld om flakey health checks te debuggen.
Elke applicatie gedraagt zich anders onder load. Kiezen tussen statische of dynamische algoritmen en het tunen van zaken als verbindingdrempels of health check-intervallen kost vaak veel trial-and-error en ervaring.
Als er iets misgaat, is de load balancer een extra plek om te onderzoeken. Misgeconfigureerde routes, gedropte requests, cachinglagen of inconsistente health check-resultaten kunnen het beeld vertroebelen.
Als je load balancer SSL afhandelt, moet je zorgen dat die correct geconfigureerd, gepatcht en gemonitord is. Elke misstap kan kwetsbaarheden creëren of beveiligde communicatie breken.
Dit hangt samen met het punt over extra complexiteit. Je hebt sterke logging, metrics en tracing nodig om te begrijpen hoe requests door het systeem stromen. Zonder goede observability is een slecht gedragende load balancer lastig te spotten en nog lastiger te fixen.
Om duidelijk te zijn: geen van deze punten zijn redenen om géén load balancing te gebruiken. Het is gewoon de realiteit van het bouwen van veerkrachtige systemen: elke laag die je toevoegt helpt, maar brengt ook nieuwe uitdagingen met zich mee.
Zoals alles in tech evolueert load balancing mee. Naarmate systemen complexer, meer gedistribueerd en dynamischer worden, komen traditionele aanpakken onder druk te staan en worden nieuwe strategieën uitgeprobeerd.
Dat is een vrij logische, gezien de wereldwijde techtrend. Moderne platforms beginnen machine learning te integreren om verkeerspatronen te voorspellen en slimmere routeringsbeslissingen te nemen. In plaats van alleen te reageren op de huidige load, kunnen deze systemen pieken anticiperen (zoals een productlancering of breaking news) en de verkeersstroom vooraf aanpassen. Het is nog vroeg, maar het potentieel voor zelf-optimaliserende infrastructuur is echt.
Als je die kant wilt verkennen, is onze tutorial Machine Learning, Pipelines, Deployment en MLOps een mooi startpunt.
Traditionele load balancers weten niet echt wat je app doet; ze kijken alleen naar verkeer. Applicatie-bewuste load balancing gaat dieper. Het kan beslissen op basis van gebruikersidentiteit, apparaattype of het zakelijke belang van de request. Zo kan het ingelogde gebruikers prioriteren tijdens een piek of gevoelige traffic naar clusters met hogere beveiliging sturen.
Nu bedrijven workloads over meerdere cloudproviders spreiden (of on-prem met cloud mixen), passen load balancers zich aan. Ze moeten locatiebewuster zijn, cross-cloud failover ondersteunen en routing beheren tussen zeer verschillende omgevingen. Verwacht in deze setups meer wereldwijde verkeersregisseurs en DNS-niveau-orkestratie.
Met de opkomst van edge computing verschuift load balancing dichter naar de gebruiker. In plaats van alles via een centrale cloud te routeren, worden requests vanaf edge-nodes bediend, waardoor latency flink daalt. Load balancing aan de edge moet lichtgewicht, slim en hyperlokaal zijn.
Sommige experimentele platforms verkennen agent-gebaseerde load balancing, waarbij individuele services helpen beslissen hoe verkeer moet stromen op basis van wat ze lokaal zien. Het is meer gedistribueerd en kan snel reageren op kleinschalige verschuivingen, maar introduceert ook coördinatie-uitdagingen.
Ik denk dat het wel duidelijk is dat al deze trends in één richting wijzen: meer dynamische, intelligente en contextbewuste load balancing. De dagen van simpele round-robin-routering zijn nog steeds springlevend (waarom iets weggooien dat werkt?), maar ze delen het podium steeds meer met systemen die leren, zich aanpassen en realtime beslissingen nemen op basis van veel meer dan serverload.
In dit artikel hebben we gekeken naar wat load balancing is, waarom het ertoe doet en hoe het onder de motorkap werkt. We hebben het gehad over algoritmen, architecturen en toepassingen in de praktijk en hopelijk alles net wat minder mysterieus gemaakt. Hopelijk gaf dit je een duidelijker beeld van hoe alles samenkomt!
Als volgende stap, als je meer wilt leren, schrijf je in voor onze gerichte cursussen. Ik raad onze cursus Introduction to Kubernetes en onze cursus AWS Cloud Technology and Services Concepts aan.
Leren met DataCamp
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

