
Last chance! 50% off DataCamp Premium
Sale ends in
लोड बैलेंसिंग एक ऐसा सिद्धांत है जो आपकी उम्मीद से कहीं ज़्यादा जगहों पर नज़र आता है।
सोचिए, शनिवार की सुबह भीड़भाड़ वाले सुपरमार्केट में सिर्फ़ एक ही चेकआउट खुला है। पंद्रह लोग लाइन में खड़े हैं, सब चिड़चिड़े, और बेचारा कैशियर अपनी अब तक की हर जीवन-निर्णय पर सवाल कर रहा है। तनाव बढ़ ही रहा होता है कि अचानक 3 कर्मचारी आकर कुछ और काउंटर खोलते हैं और लोगों को सबसे छोटी कतारों में बाँटना शुरू करते हैं। सब कुछ तेज़ हो जाता है, दबाव कम होता है, और लाइनें सामान्य रूप से चलने लगती हैं। यही, सार रूप में, लोड बैलेंसिंग है।
इस लेख में, मैं आपको बताऊँगा कि लोड बैलेंसिंग क्या है, यह क्यों मायने रखती है, यह अंदर से कैसे काम करती है, और जब चीज़ें व्यस्त हो जाती हैं तो यह डिजिटल दुनिया को बिखरने से कैसे बचाती है। इस लेख को समझने के लिए किसी विशेष पूर्वज्ञान की ज़रूरत नहीं है, तो चिंता न करें अगर आप नेटवर्किंग या क्लाउड आर्किटेक्चर में बहुत गहराई तक नहीं गए हैं! यह गाइड बातें साफ़, व्यावहारिक, और (उम्मीद है) थोड़ी मज़ेदार रखेगी।
टेक में, लोड बैलेंसिंग वह तरीका है जिससे हम आने वाले ट्रैफ़िक या कार्यों को कई सर्वरों या संसाधनों में बाँटते हैं। एक मशीन को सब भार के नीचे दबने देने के बजाय, लोड बैलेंसर काम को फैला देता है ताकि चीज़ें तेज़, स्थिर, और स्केलेबल रहें। यह आधुनिक इन्फ्रास्ट्रक्चर में हर जगह है: क्लाउड प्लेटफ़ॉर्म इसे लाखों यूज़र्स सँभालने के लिए इस्तेमाल करते हैं, AI पाइपलाइंस डेटा लोड को नोड्स में बाँटने के लिए इस पर निर्भर रहती हैं, और ईकॉमर्स साइटें ब्लैक फ्राइडे में टिके रहने के लिए इसी पर भरोसा करती हैं।
ज़रा कल्पना कीजिए कि आपके ऐप में कोई लोड बैलेंसर नहीं है। एक ही सर्वर को सारी रिक्वेस्ट्स, सारा ट्रैफ़िक, सारा दबाव मिल रहा है। शायद वह कुछ देर तक साथ निभा ले, पर (लाजिमी तौर पर) फिर नहीं। वह धीमा पड़ जाता है, यूज़र्स झुँझला जाते हैं, और मुमकिन है कि वह बिल्कुल क्रैश हो जाए। उधर, बाकी सर्वर डिजिटल अंगूठे घुमाते बैठे हैं, कुछ कर ही नहीं रहे।
लोड बैलेंसिंग के बिना, आप मूलतः फँस जाते हैं:
अब, एक लोड बैलेंसर जोड़ दीजिए, और तस्वीर बदल जाती है। यह आपके बैकएंड सर्वरों के आगे बैठता है, हर एक की स्थिति पर नज़र रखता है और आने वाली रिक्वेस्ट्स को उस सर्वर तक भेजता है जो सबसे स्वस्थ या सबसे कम व्यस्त हो। कुछ तो रियल टाइम में रिस्पॉन्स टाइम या सर्वर संसाधनों जैसी चीज़ों की भी निगरानी करते हैं।
आपको क्या मिलता है:
अगर आप अब भी सुपरमार्केट वाले उदाहरण के बारे में सोच रहे हैं, तो कल्पना कीजिए कि 15 लोगों की कतार को समझदारी से पाँच चेकआउट में बाँट दिया गया है। न कोई घबराहट, न कोई चिल्ल-पों, और आप जमे हुए पिज़्ज़ा वाले गलियारे तक जल्दी पहुँच जाते हैं। यही लक्ष्य है।
तो, हमने क्यों लोड बैलेंसिंग उपयोगी है, यह बात कर ली। अब देखें कि यह अंदर से कैसे वास्तविक रूप से काम करती है।
उच्च स्तर पर, लोड बैलेंसर क्लाइंट्स (रिक्वेस्ट करने वाले लोग या सिस्टम) और आपके बैकएंड सर्वरों (जो असल काम करते हैं) के बीच बैठता है। इसका काम हर आने वाली रिक्वेस्ट को लेना और तय करना है कि उसे कहाँ भेजना है।
मूल प्रवाह कुछ यूँ होता है:
सिद्धांत में काफ़ी सीधा लगता है, लेकिन पर्दे के पीछे बहुत कुछ चलता है, और कुछ अहम अवधारणाएँ हैं जो सुनिश्चित करती हैं कि सब ठीक से काम करे:
एक छोटा सा नोट: “लोड बैलेंसिंग” एक अवधारणा है (ट्रैफ़िक का वितरण), और “लोड बैलेंसर” वह उपकरण या सेवा है जो इसे संभव बनाती है। अक्सर दोनों शब्द एक-दूसरे के स्थान पर इस्तेमाल होते हैं, पर यह भेद जानना मदद करता है।
कभी-कभी लोड बैलेंसर यूँ ही किसी सर्वर को यादृच्छिक रूप से चुन लेते हैं, लेकिन वास्तव में कुछ रणनीतियाँ होती हैं, जिन्हें लोड बैलेंसिंग एल्गोरिद्म कहा जाता है, जो तय करती हैं कि आने वाले ट्रैफ़िक को बैकएंड संसाधनों में कैसे बाँटा जाए।
इनमें से कुछ काफी सरल और पूर्वानुमेय हैं, जबकि कुछ सर्वर के प्रदर्शन, कनेक्शन गिनती, या रिस्पॉन्स स्पीड के आधार पर रियल टाइम में समायोजित होती हैं। आइए उन्हें दो बड़ी श्रेणियों में बाँटें।
ये सिस्टम में क्या चल रहा है, उसके अनुसार नहीं बदलते; ये बस पूर्वनिर्धारित नियम का पालन करते हैं। इससे ये पूर्वानुमेय और लागू करने में आसान होते हैं, लेकिन वास्तविक दुनिया के दबाव के तहत हमेशा आदर्श नहीं।
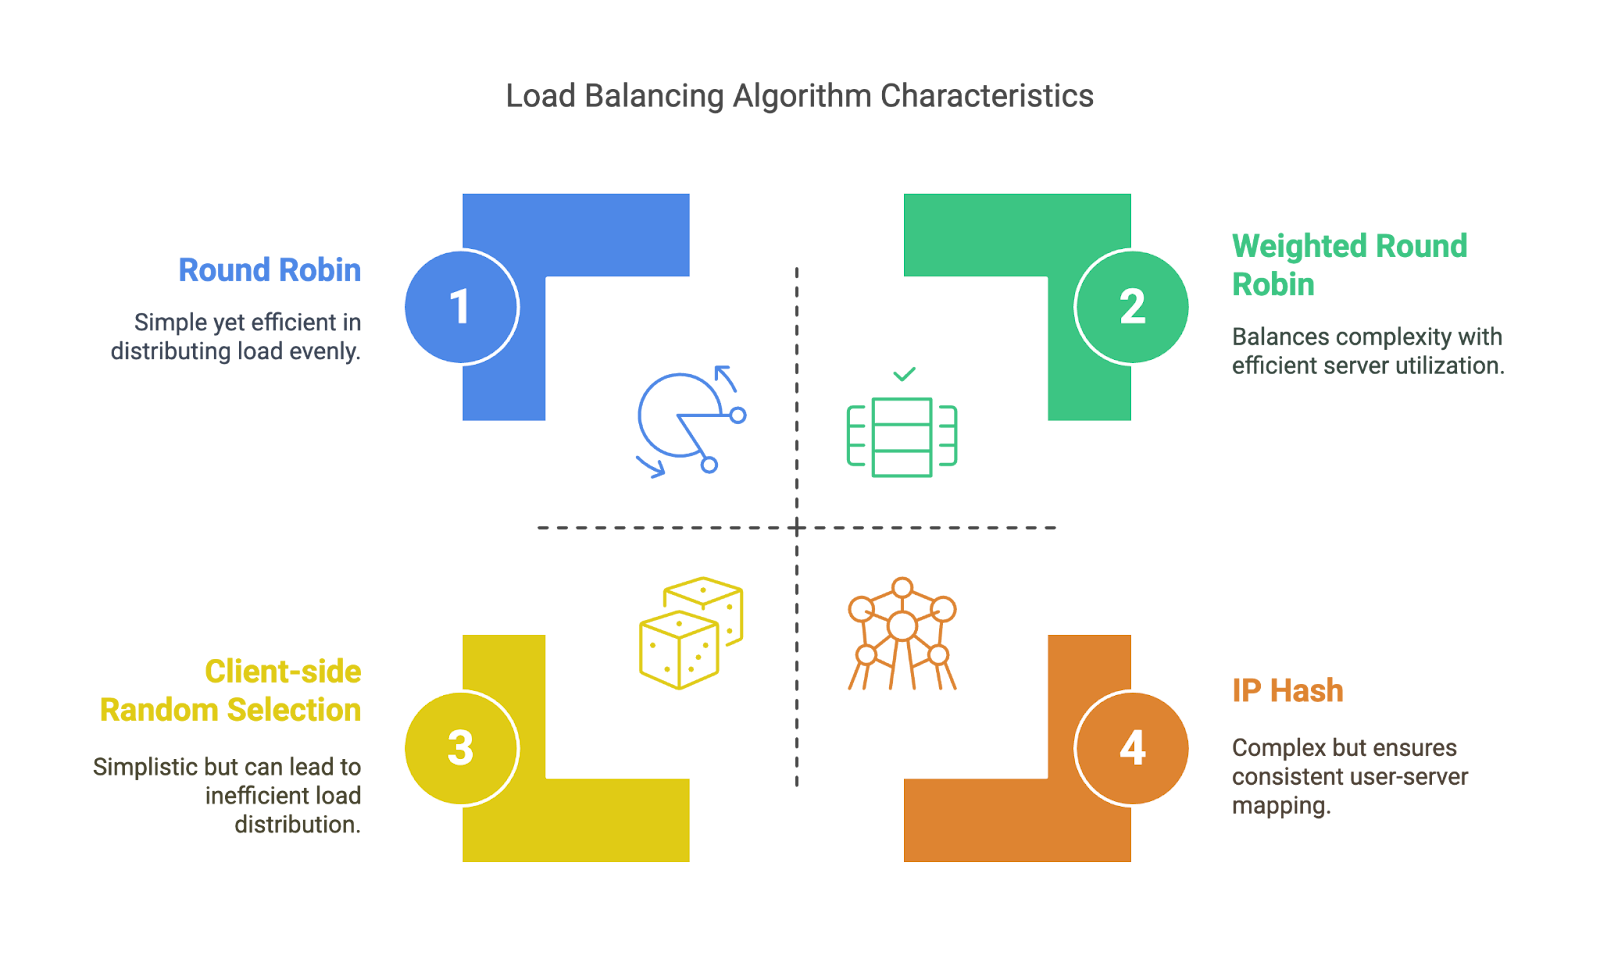
स्टैटिक एल्गोरिद्म। चित्र: लेखक
ये एल्गोरिद्म सिस्टम में वास्तव में क्या घटित हो रहा है, उसके आधार पर अनुकूलित होते हैं। ये अधिक समझदार हैं, पर ज़्यादा मॉनिटरिंग और सिस्टम-अवेयरनेस की ज़रूरत होती है।
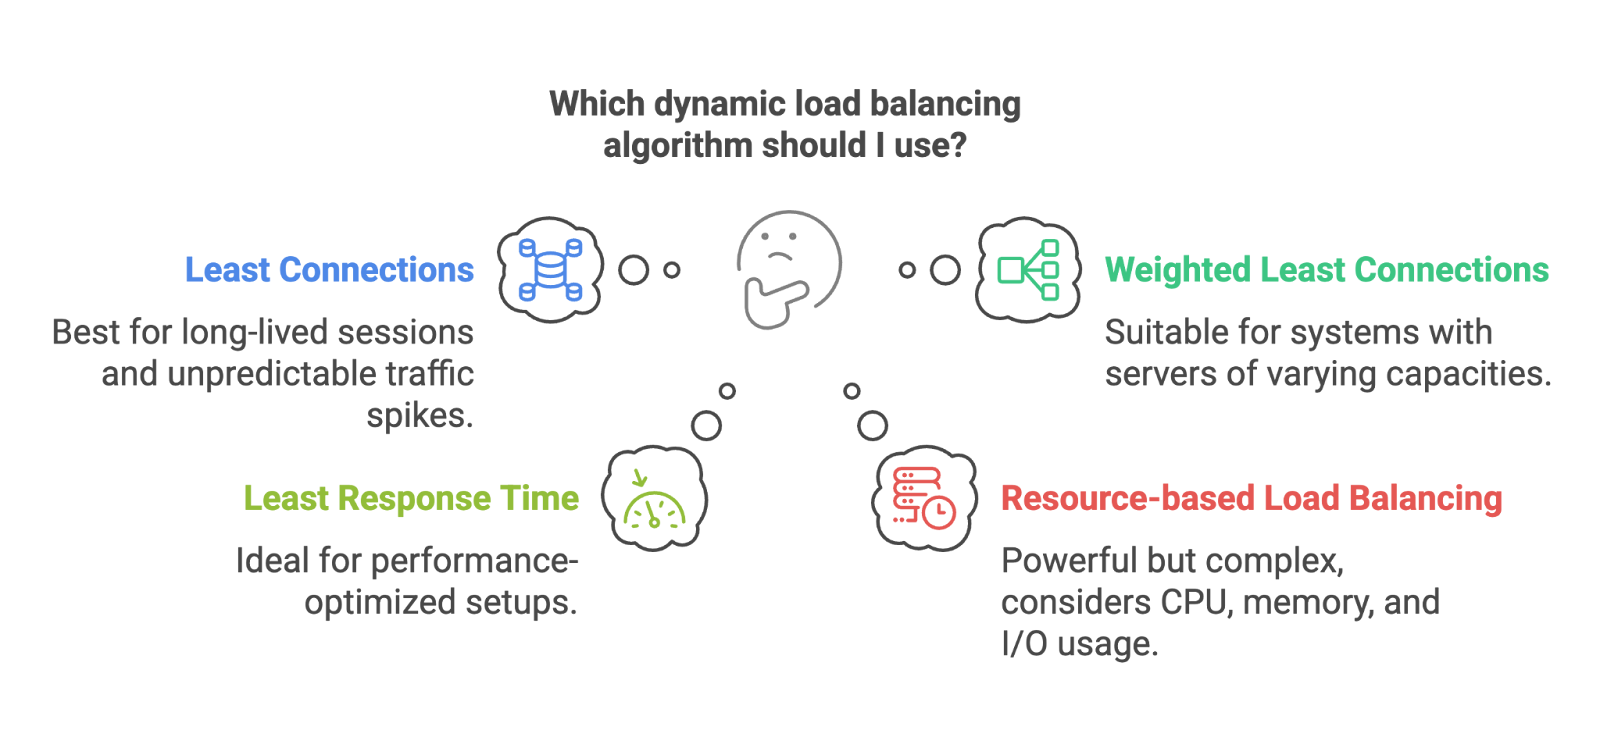
डायनेमिक एल्गोरिद्म। चित्र: लेखक
जब आपका ट्रैफ़िक पूर्वानुमेय हो और सर्वर समान रूप से सक्षम हों, तो स्टैटिक एल्गोरिद्म बढ़िया होते हैं। चीज़ें थोड़ी अराजक हों, तो डायनेमिक एल्गोरिद्म चमकते हैं।
अच्छा, अब खुद लोड बैलेंसर के अलग-अलग प्रकारों की बात करें: हार्डवेयर, सॉफ़्टवेयर, क्लाउड-नेटिव, और अन्य।
सभी लोड बैलेंसर एक जैसे नहीं होते। कुछ हार्डवेयर में रहते हैं, कुछ सॉफ़्टवेयर के रूप में चलते हैं, कुछ क्लाउड सेवाओं के साथ बंडल आते हैं, और कुछ बहुत विशेष उपयोग मामलों में विशेषज्ञ होते हैं। आप कौन सा चुनते हैं, यह आपकी आर्किटेक्चर, आपके स्केल, और कभी-कभी सिर्फ़ आपके बजट पर निर्भर करता है।
ये फिजिकल अप्लायंसेज़ होते हैं जो आपके डेटा सेंटर में बैठते हैं, विशेष रूप से ट्रैफ़िक को बैलेंस करने के लिए बनाए गए। ये शक्तिशाली और तेज़ होते हैं, लेकिन महंगे और ऑन-डिमांड स्केल करना मुश्किल। बड़े एंटरप्राइज़ और ऑन-प्रेम सेटअप्स के बारे में सोचें।
ये जनरल-पर्पज़ सर्वरों पर एप्लिकेशन के रूप में चलते हैं। Tools like HAProxy, nginx (owned by F5), or Envoy fall into this category. They’re cheaper, more flexible, and easier to integrate into most environments.
अगर आप AWS, Azure, या GCP उपयोग कर रहे हैं, तो संभवतः आप पहले से ही क्लाउड-नेटिव लोड बैलेंसर इस्तेमाल कर रहे हैं, जैसे AWS ELB, Azure Load Balancer, या GCP Load Balancing। ये आपके लिए मैनेज्ड होते हैं, अपने-आप स्केल करते हैं, और अन्य सेवाओं के साथ अच्छे से इंटीग्रेट होते हैं।
यदि आप यह समझना चाहते हैं कि AWS इसे (और अन्य कई इंफ्रास्ट्रक्चर हिस्सों को) कैसे संभालता है, तो हमारा AWS Cloud Technology and Services Concepts कूर्स देखें।
आपने इलास्टिक लोड बैलेंसर के बारे में सुना होगा। इन्हें आपके वर्कलोड के साथ ऊपर-नीचे स्केल करने के लिए डिज़ाइन किया गया है। ये अक्सर क्लाउड-नेटिव सिस्टम का हिस्सा होते हैं, लेकिन “इलास्टिक” का मतलब बस इतना है कि ये ट्रैफ़िक के अनुसार डायनामिक रूप से अनुकूल हो सकते हैं—अनियमित या अप्रत्याशित लोड के लिए आदर्श।
OSI मॉडल एक वैचारिक ढांचा है जो बताता है कि डेटा नेटवर्क के माध्यम से कैसे चलता है। इसमें सात लेयर होती हैं, भौतिक तार से लेकर आपके ब्राउज़र में ऐप तक। लोड बैलेंसिंग के लिए सबसे प्रासंगिक लेयर 4 और 7 हैं।
ये IP पते, पोर्ट्स और TCP/UDP ट्रैफ़िक के आधार पर रूटिंग निर्णय लेते हैं। ये तेज़ और कुशल होते हैं, लेकिन भेजी जा रही सामग्री के बारे में कुछ नहीं जानते।
ये अनुरोध की वास्तविक सामग्री देखते हैं, जैसे HTTP हेडर, कुकीज़ या URL। इससे ये अधिक उन्नत काम कर सकते हैं, जैसे URL पाथ के आधार पर रूटिंग, A/B टेस्टिंग, या भाषा वरीयताएँ। उदाहरण के लिए, यदि आप चाहते हैं कि /api/ अनुरोध एक क्लस्टर में जाएँ और /login दूसरे में, तो आपको लेयर 7 की ज़रूरत होगी।
भौगोलिक रूप से वितरित डेटा सेंटर्स में ट्रैफ़िक बाँटने के लिए उपयोग किए जाते हैं। मल्टी-रीजन, लो-लेटेंसी या डिज़ास्टर रिकवरी सेटअप्स के लिए उपयोगी।
पूरी तरह निजी नेटवर्क्स के भीतर संचालित होते हैं, क्लाउड या क्लस्टर के अंदर सेवाओं के बीच ट्रैफ़िक संतुलित करने के लिए उपयोग किए जाते हैं।
टेलीकॉम सिस्टम के लिए विशेषीकृत, जो Diameter प्रोटोकॉल का उपयोग करते हैं—अक्सर मोबाइल नेटवर्क में रूटिंग, प्रमाणीकरण और बिलिंग अनुरोधों के लिए पाए जाते हैं।
ये विशेष रूप से HTTP और HTTPS ट्रैफ़िक को संभालने के लिए अनुकूलित होते हैं। इनमें अक्सर SSL टर्मिनेशन, URL-आधारित रूटिंग और बिल्ट-इन DDoS सुरक्षा शामिल होती है।
प्रत्येक प्रकार का लोड बैलेंसर अलग तरह की समस्या हल करता है। कुछ स्केल पर केंद्रित होते हैं, कुछ लेटेंसी, सुरक्षा या उपयोग में आसानी पर। यह जानना कि किसे चुनना है, आपके इंफ्रास्ट्रक्चर को चलाने की सुगमता (या मुश्किल) में बड़ा फर्क डाल सकता है।
अब तक, हमने बात की कि लोड बैलेंसर क्या करते हैं और आप किन प्रकारों का उपयोग कर सकते हैं, लेकिन यह अंदर से कैसे बने होते हैं? लोड बैलेंसिंग सिस्टम की आर्किटेक्चर यह तय करती है कि वह कितनी अच्छी तरह स्केल करता है और विफलता को कितनी सहजता से संभालता है—सब कुछ।
यह क्लासिक सेटअप है: एक “लीडर” नोड निर्णय लेता है और कई “वर्कर” नोड्स को काम बाँटता है। इसे समझना सरल है, लेकिन यदि ठीक से बैकअप न हो तो लीडर एक बॉटलनेक या सिंगल प्वाइंट ऑफ फेल्योर बन सकता है।
एक केंद्रीकृत “ब्रेन” के बजाय, हर लोड बैलेंसर अपने साथियों से अवगत रहता है और काम साझा करता है। इससे फ़ॉल्ट टॉलरेंस और स्केलेबिलिटी बेहतर होती है, पर समन्वय थोड़ा जटिल हो जाता है। आप इसे बड़े पैमाने के सिस्टम में अक्सर देखते हैं, जहाँ anycast रूटिंग या DNS-आधारित डिस्ट्रीब्यूशन होता है।
कंटेनराइज़्ड वातावरणों में, खासकर Kubernetes के साथ, लोड बैलेंसिंग और भी दिलचस्प हो जाती है। सर्विसेज़, इन्ग्रेस कंट्रोलर और साइडकार मिलकर क्लस्टर्स के अंदर स्मार्ट तरीके से ट्रैफ़िक रूट करते हैं। यदि आप उस दुनिया में अभी शुरुआत कर रहे हैं, तो हमारा Introduction to Kubernetes कोर्स बुनियादी बातें सीखने का एक ठोस हैंड्स-ऑन तरीका है।
इस सेटअप में, निष्क्रिय वर्कर व्यस्त वर्करों से कार्य “चुरा” सकते हैं। इसका उपयोग आम तौर पर कंप्यूट-हेवी वातावरणों में होता है, जैसे टास्क क्यूज़ या डेटा प्रोसेसिंग पाइपलाइंस, लेकिन वेब ट्रैफ़िक के लिए कम। यह अप्रत्याशित वर्कलोड को संतुलित करने का एक उपयोगी पैटर्न है।
कुछ सिस्टम अपने लोड बैलेंसर को लेयर करते हैं, जैसे एक ग्लोबल स्तर (उदा., रीजन के पार), दूसरा डेटा सेंटर स्तर पर, और तीसरा किसी विशेष सर्विस क्लस्टर के भीतर। यह जटिलता प्रबंधित करने में मदद करता है और हर लेयर को उसके विशिष्ट दायरे पर केंद्रित रखता है।
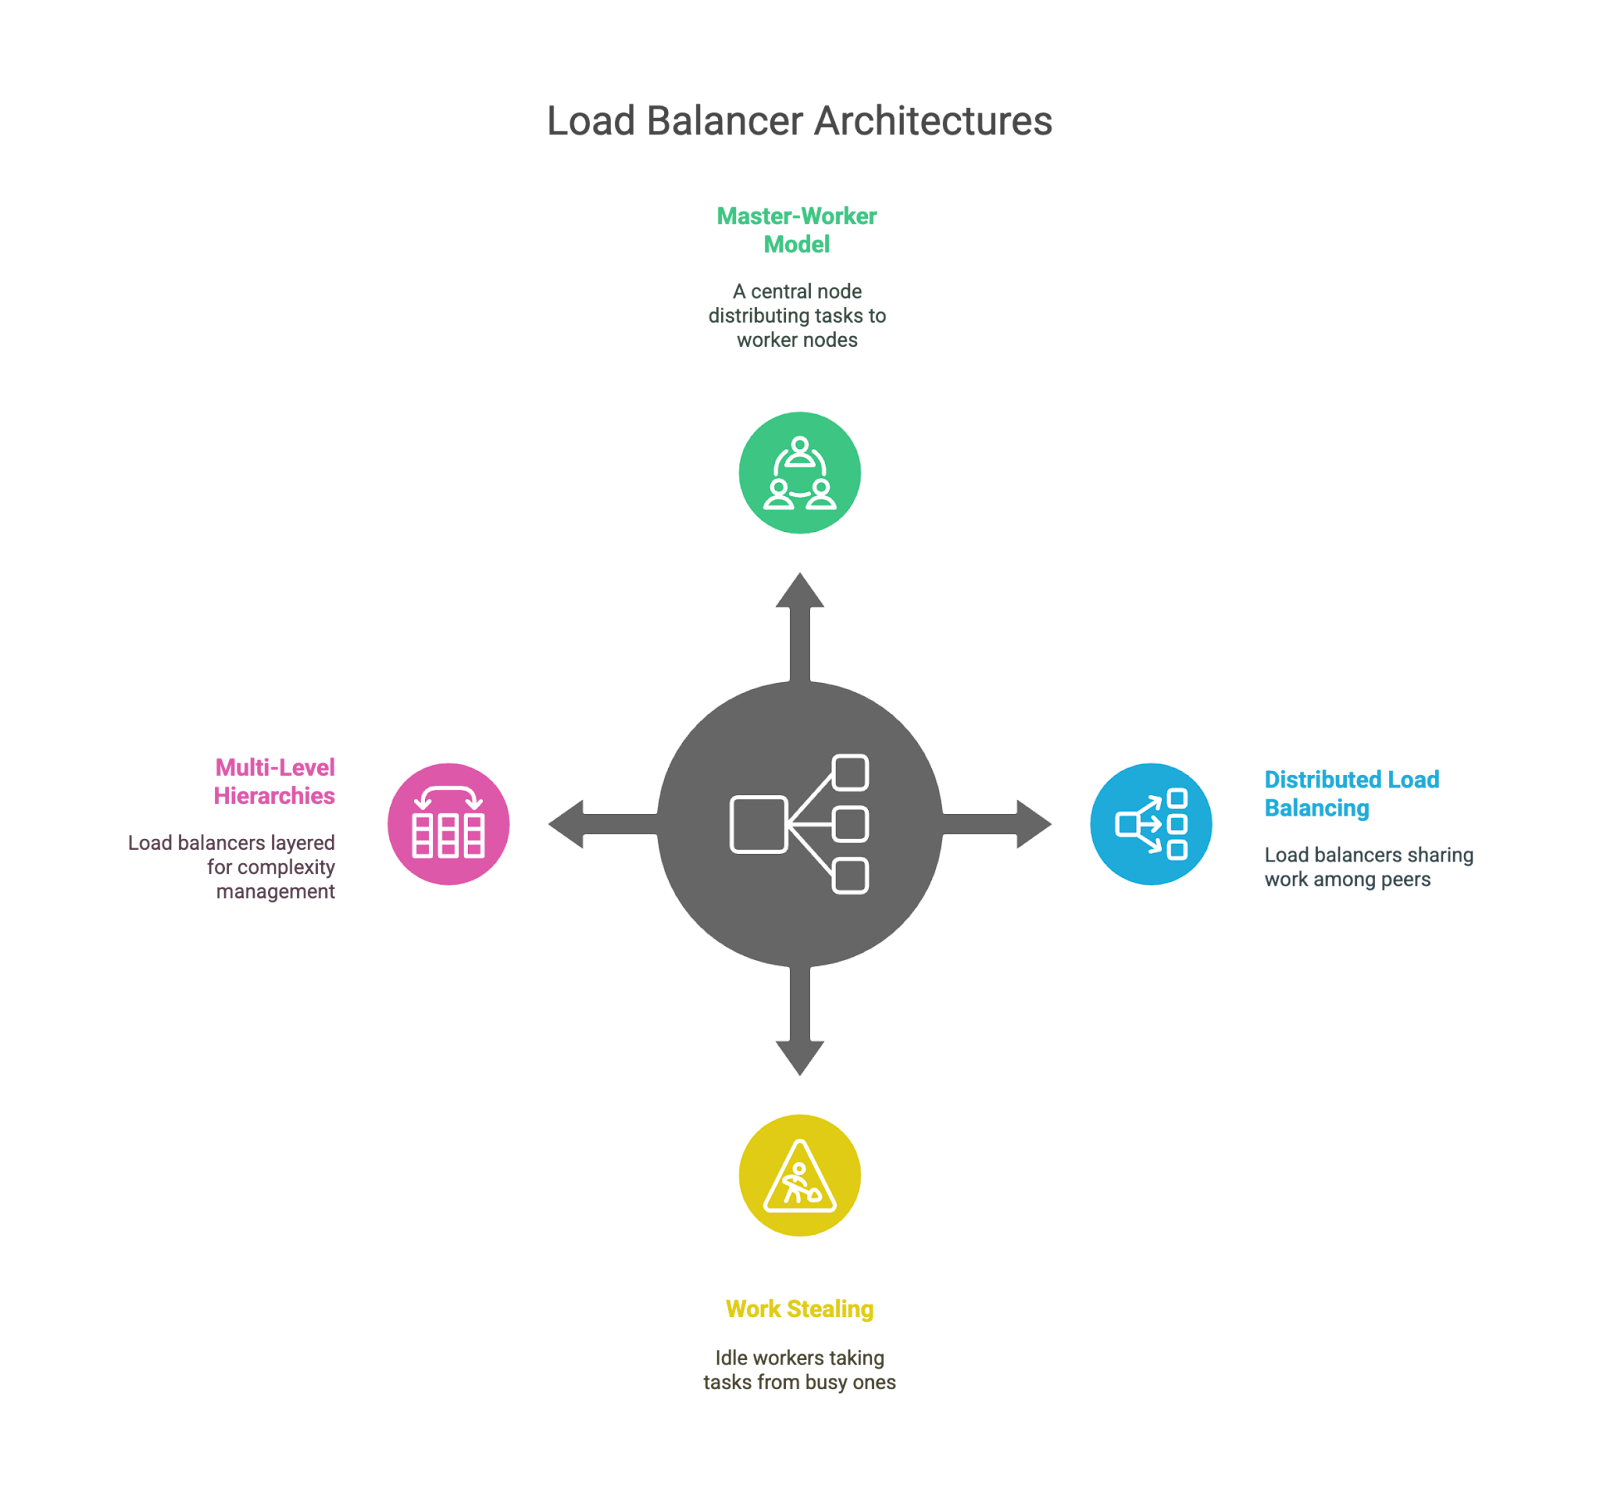
लोड बैलेंसिंग आर्किटेक्चर।
इनमें से प्रत्येक आर्किटेक्चर के अपने समझौते हैं। केंद्रीकृत मॉडल समझने में आसान होते हैं लेकिन चोकपॉइंट बन सकते हैं; वितरित मॉडल बेहतर स्केल करते हैं पर जटिलता बढ़ाते हैं; और लेयर्ड टोपोलॉजी मॉड्युलैरिटी देती है, लेकिन यदि सावधानी से न डिज़ाइन की जाए तो लेटेंसी ला सकती है। हमेशा की तरह, एक ही समाधान सभी पर लागू नहीं होता—यह आपके सिस्टम के आकार, ट्रैफ़िक पैटर्न और जोखिम सहनशीलता पर निर्भर करता है।
लोड बैलेंसिंग शक्तिशाली है, लेकिन जादू नहीं। यह सिस्टम को अधिक विश्वसनीय, स्केलेबल और कुशल बना सकता है, पर साथ ही नई परतों की जटिलता और संभावित विफलता बिंदु भी जोड़ता है। आइए उन ट्रेड-ऑफ़्स के बारे में बात करें जिनका इंजीनियर तकनीकी और ऑपरेशनल—दोनों स्तरों पर सामना करते हैं।
विडंबना यह है कि जो टूल ट्रैफ़िक बाँटने के लिए बनाया गया है, वही यदि ठीक से आर्किटेक्ट न किया जाए तो एकल विफलता बिंदु बन सकता है—खासकर केंद्रीकृत या लीडर-आधारित मॉडलों में। इसलिए कई सिस्टम एकाधिक लोड बैलेंसर, फ़ेलओवर मैकेनिज़्म या यहाँ तक कि DNS-स्तरीय बैलेंसिंग का उपयोग करके जोखिम बाँटते हैं।
चाहे वह कितना भी तेज़ हो, लोड बैलेंसर क्लाइंट और बैकएंड के बीच एक अतिरिक्त हॉप जोड़ता है। यह लेटेंसी ला सकता है—खासकर मल्टी-लेयर्ड आर्किटेक्चर में या एप्लिकेशन-लेयर (लेयर 7) रूटिंग के साथ।
लोड बैलेंसर स्तर पर HTTPS ट्रैफ़िक संभालना (उर्फ़ SSL टर्मिनेशन) बैकएंड सर्वरों से CPU कार्य उतार सकता है, लेकिन इसका मतलब यह भी है कि लोड बैलेंसर अधिक काम करता है और संवेदनशील सुरक्षा सेटिंग्स व सर्टिफिकेट्स के लिए ज़िम्मेदार बन जाता है।
स्टिकी सेशन्स उपयोगकर्ताओं को उसी बैकएंड से जोड़े रखने में सहायक होते हैं (जैसे लॉगिन के दौरान), लेकिन ये स्केलिंग को जटिल बनाते हैं और पूरी तरह स्टेटलेस सेवाएँ चलाना कठिन कर देते हैं। इंजीनियरों को अक्सर उपयोगकर्ता अनुभव और आर्किटेक्चरल सादगी के बीच चुनना पड़ता है।
जितनी स्मार्ट आपकी रूटिंग लॉजिक होगी, बग्स, मिसरूटिंग, या सूक्ष्म प्रदर्शन समस्याओं के लिए उतनी ही गुंजाइश होगी—जिन्हें ट्रेस करना कठिन होता है। सेटअप करते समय आप ख़ुद को स्मार्ट महसूस करेंगे, और बहुत कम जब आपको रात 2 बजे हेल्थ चेक की अनियमितता डिबग करने के लिए जगाया जाएगा।
प्रत्येक एप्लिकेशन लोड के तहत अलग तरह से व्यवहार करता है। स्थिर या डायनामिक एल्गोरिद्म के बीच चयन करना और कनेक्शन थ्रेशहोल्ड या हेल्थ चेक इंटरवल जैसी चीज़ों को ट्यून करना काफी परीक्षण, त्रुटि और अनुभव ले सकता है।
जब कुछ गड़बड़ होता है, तो लोड बैलेंसर देखने के लिए एक और जगह जोड़ देता है। गलत कॉन्फ़िगर रूट्स, ड्रॉप्ड रिक्वेस्ट, कैशिंग लेयर, या असंगत हेल्थ चेक परिणाम—सब चीज़ों को उलझा सकते हैं।
यदि आपका लोड बैलेंसर SSL संभाल रहा है, तो आपको सुनिश्चित करना होगा कि वह सही ढंग से कॉन्फ़िगर, पैच और मॉनिटर किया गया है। यहाँ कोई भी चूक कमजोरियाँ पैदा कर सकती है या सुरक्षित संचार तोड़ सकती है।
यह कुछ हद तक उस बिंदु से जुड़ा है जो हमने बढ़ी हुई जटिलता के बारे में कहा। आपको मज़बूत लॉगिंग, मेट्रिक्स और ट्रेसिंग की ज़रूरत होती है ताकि समझ सकें कि अनुरोध सिस्टम में कैसे बहते हैं। अच्छी ऑब्ज़र्वेबिलिटी के बिना, गड़बड़ करता लोड बैलेंसर पहचानना मुश्किल और ठीक करना उससे भी कठिन हो सकता है।
साफ़-साफ़ कहें, तो इनमें से कोई भी कारण ऐसा नहीं है कि लोड बैलेंसिंग का उपयोग न किया जाए। ये बस मज़बूत सिस्टम बनाने की वास्तविकताएँ हैं: हर परत मदद कर सकती है, लेकिन साथ ही नए प्रबंधन-योग्य चुनौतियाँ भी जोड़ती है।
तकनीक की हर चीज़ की तरह, लोड बैलेंसिंग भी विकसित हो रही है। जैसे-जैसे सिस्टम अधिक जटिल, अधिक वितरित और अधिक डायनामिक होते जा रहे हैं, पारंपरिक तरीकों पर दबाव पड़ रहा है और नई रणनीतियों का परीक्षण हो रहा है।
वैश्विक टेक ट्रेंड को देखते हुए यह काफ़ी स्पष्ट है। आधुनिक प्लेटफ़ॉर्म ट्रैफ़िक पैटर्न का पूर्वानुमान लगाने और अधिक स्मार्ट रूटिंग निर्णय लेने के लिए मशीन लर्निंग को एकीकृत करना शुरू कर रहे हैं। केवल मौजूदा लोड पर प्रतिक्रिया करने के बजाय, ये सिस्टम स्पाइक्स (जैसे प्रोडक्ट लॉन्च या ब्रेकिंग न्यूज़) का अंदाज़ा लगा सकते हैं और पहले से ही ट्रैफ़िक फ्लो समायोजित कर सकते हैं। अभी शुरुआती दिन हैं, लेकिन सेल्फ-ऑप्टिमाइज़िंग इंफ्रास्ट्रक्चर की संभावना वास्तविक है।
यदि आप इस पहलू को खंगालना चाहते हैं, तो हमारा ट्यूटोरियल Machine Learning, Pipelines, Deployment and MLOps एक बढ़िया शुरुआती बिंदु है।
पारंपरिक लोड बैलेंसर सच में नहीं जानते कि आपका ऐप क्या करता है; वे सिर्फ ट्रैफ़िक देखते हैं। एप्लिकेशन-अवेयर लोड बैलेंसिंग और गहराई में जाती है। यह उपयोगकर्ता पहचान, डिवाइस प्रकार, या अनुरोध के व्यावसायिक महत्व के आधार पर निर्णय ले सकती है। उदाहरण के लिए, यह स्पाइक के दौरान लॉग-इन उपयोगकर्ताओं को प्राथमिकता दे सकती है या संवेदनशील ट्रैफ़िक को उच्च-सुरक्षा वाले क्लस्टर्स में रूट कर सकती है।
जैसे-जैसे कंपनियाँ कई क्लाउड प्रदाताओं में वर्कलोड फैलाती हैं (या ऑन-प्रेम को क्लाउड के साथ मिलाती हैं), लोड बैलेंसर अनुकूल हो रहे हैं। इन्हें अधिक लोकेशन-अवेयर होना, क्रॉस-क्लाउड फ़ेलओवर सपोर्ट करना, और बहुत भिन्न वातावरणों के बीच रूटिंग प्रबंधित करना पड़ता है। ऐसे सेटअप्स में अधिक ग्लोबल ट्रैफ़िक डायरेक्टर्स और DNS-स्तरीय ऑर्केस्ट्रेशन की उम्मीद करें।
एज कंप्यूटिंग के उदय के साथ, लोड बैलेंसिंग उपयोगकर्ता के और करीब शिफ्ट हो रही है। हर चीज़ को केंद्रीय क्लाउड से गुज़ारने के बजाय, अनुरोध एज नोड्स से परोसे जाते हैं, जिससे लेटेंसी काफ़ी कम हो जाती है। एज पर लोड बैलेंसिंग को हल्का-फुल्का, स्मार्ट और हाइपर-लोकल होना पड़ता है।
कुछ प्रयोगात्मक प्लेटफ़ॉर्म एजेंट-आधारित लोड बैलेंसिंग का अन्वेषण कर रहे हैं, जहाँ व्यक्तिगत सेवाएँ स्थानीय रूप से जो वे देख रही हैं उसके आधार पर यह तय करने में मदद करती हैं कि ट्रैफ़िक कैसे बहे। यह अधिक वितरित है और छोटे पैमाने के बदलावों पर तेज़ी से प्रतिक्रिया दे सकता है, लेकिन समन्वय की चुनौतियाँ भी लाता है।
मुझे लगता है यह काफ़ी स्पष्ट है कि ये सभी प्रवृत्तियाँ एक ही दिशा की ओर इशारा करती हैं: अधिक डायनामिक, बुद्धिमान और संदर्भ-प्रबुद्ध लोड बैलेंसिंग। साधारण राउंड-रॉबिन रूटिंग के दिन अभी भी जारी हैं (जो काम करता है उसे क्यों छोड़ा जाए?), लेकिन अब वे ऐसे सिस्टम्स के साथ मंच साझा कर रहे हैं जो सीखते हैं, अनुकूल होते हैं, और सर्वर लोड से कहीं अधिक कारकों के आधार पर रीयल-टाइम निर्णय लेते हैं।
पूरे लेख में, हमने देखा कि लोड बैलेंसिंग क्या है, यह क्यों महत्वपूर्ण है, और यह अंदर से कैसे काम करती है। हमने एल्गोरिद्म, आर्किटेक्चर और वास्तविक दुनिया के उपयोगों पर बात की—और उम्मीद है कि इस प्रक्रिया में सब कुछ थोड़ा कम रहस्यमय लगा होगा। आशा है इस लेख ने आपको यह समझने में एक स्पष्ट तस्वीर दी कि यह सब कैसे साथ आता है!
अगले कदम के रूप में, यदि आप और सीखने में रुचि रखते हैं, तो हमारे समर्पित कोर्स में नामांकन करें। मैं हमारा recommend हमारा Introduction to Kubernetes कोर्स और हमारा AWS Cloud Technology and Services Concepts कोर्स करता/करती हूँ।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स
