
Corso
Introduzione a dbt
4 ore
34K
Il load balancing è un concetto che si presenta in più contesti di quanto potresti pensare.
Prendi un sabato mattina in un supermercato pieno con una sola cassa aperta. Quindici persone in fila, tutti irritati, e il povero cassiere che sembra riconsiderare ogni scelta di vita che lo ha portato fin lì. La tensione sta davvero salendo quando all’improvviso arrivano 3 membri dello staff, aprono qualche cassa in più e iniziano a indirizzare le persone verso le code più corte. Tutto accelera, la pressione diminuisce e le file ricominciano a scorrere normalmente. Questo, in sostanza, è il load balancing.
In questo articolo ti guiderò attraverso cos’è il load balancing, perché è importante, come funziona sotto il cofano e come impedisce al mondo digitale di andare in pezzi quando le cose si fanno intense. Non ti serve alcuna conoscenza specifica per seguire: non preoccuparti se non sei dentro reti o architetture cloud! Questa guida manterrà tutto chiaro, pratico e (si spera) anche un po’ divertente.
In ambito tech, il load balancing è il modo in cui distribuiamo il traffico o i task in arrivo tra più server o risorse. Invece di lasciare che una macchina affoghi sotto il peso di tutto, un load balancer distribuisce il lavoro così che tutto resti veloce, stabile e scalabile. È ovunque nelle infrastrutture moderne: le piattaforme cloud lo usano per gestire milioni di utenti, le pipeline di AI si affidano a esso per distribuire i carichi di dati tra i nodi e i siti ecommerce ci contano per sopravvivere al Black Friday.
Immagina, solo per un secondo, che la tua app non abbia un load balancer. Un server riceve tutte le richieste, tutto il traffico, tutta la pressione. Magari regge per un po’, finché (inevitabilmente) non regge più. Rallenta, gli utenti si frustrano, magari va persino in crash. Nel frattempo, gli altri server se ne stanno con le mani in mano, a fare nulla.
Senza load balancing, in pratica ti ritrovi con:
Ora, aggiungi un load balancer e lo scenario cambia del tutto. Si mette davanti ai server di backend, tiene d’occhio come sta andando ciascuno e distribuisce le richieste in arrivo a quello più in salute o meno occupato. Alcuni monitorano persino in tempo reale tempi di risposta o risorse del server.
Ecco cosa ottieni:
Se stai ancora pensando all’esempio del supermercato, immagina quella fila di 15 persone suddivisa in modo intelligente tra cinque casse. Nessuno va in panico, nessuno urla e tu arrivi più in fretta al reparto pizze surgelate. Questo è l’obiettivo.
Abbiamo parlato del perché il load balancing è utile. Ora vediamo come funziona davvero sotto il cofano.
A livello alto, un load balancer si posiziona tra i client (persone o sistemi che fanno richieste) e i server di backend (quelli che fanno il lavoro). Il suo compito è ricevere ogni richiesta in arrivo e decidere dove inviarla.
Ecco il flusso di base:
In teoria è piuttosto lineare, ma dietro le quinte succede parecchio, e ci sono alcuni concetti chiave che fanno sì che tutto funzioni:
Nota veloce: “load balancing” è il concetto (distribuire il traffico), mentre un “load balancer” è lo strumento o servizio che lo rende possibile. Spesso sentirai usare i due termini in modo intercambiabile, ma aiuta conoscere la distinzione.
Anche se a volte i load balancer scelgono un server a caso, esistono strategie vere e proprie, chiamate algoritmi di load balancing, che determinano come il traffico in arrivo viene distribuito tra le risorse di backend.
Alcuni sono piuttosto semplici e prevedibili, mentre altri si adattano in tempo reale in base alle prestazioni del server, al numero di connessioni o alla velocità di risposta. Suddividiamoli in due grandi categorie.
Questi non si adattano a ciò che sta succedendo nel sistema; seguono solo una regola predefinita. Questo li rende prevedibili e facili da implementare, ma non sempre ideali sotto la pressione del mondo reale.
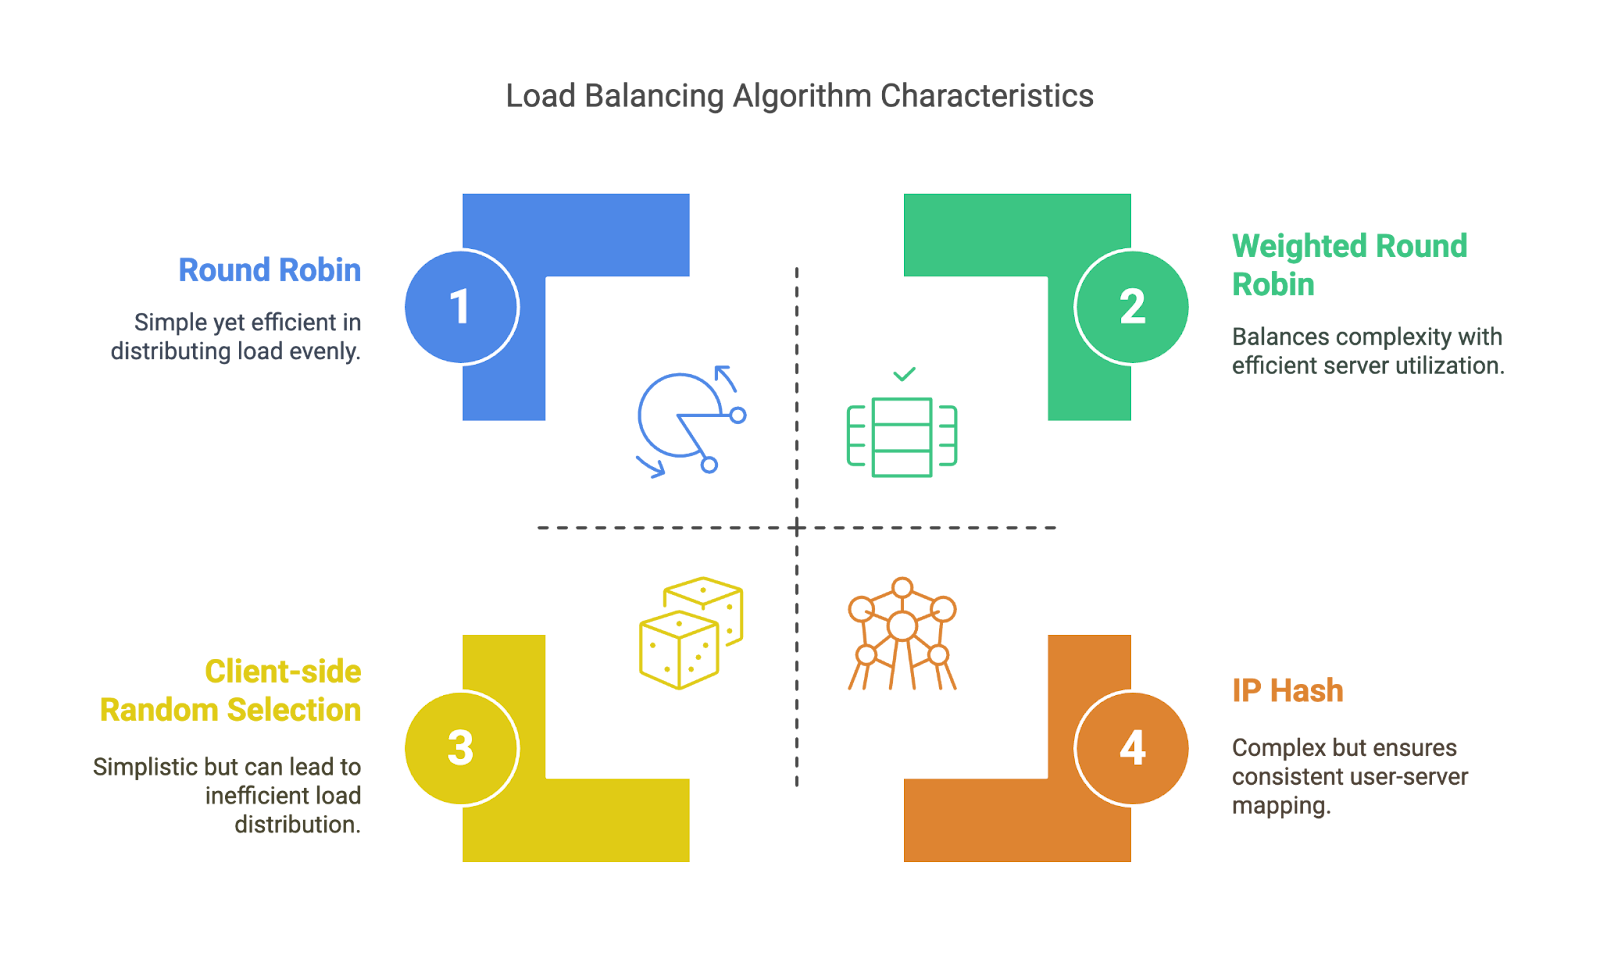
Algoritmi statici. Immagine dell’Autore
Questi algoritmi si adattano in base a ciò che sta realmente accadendo nel sistema. Sono più intelligenti, ma richiedono più monitoraggio e consapevolezza del sistema.
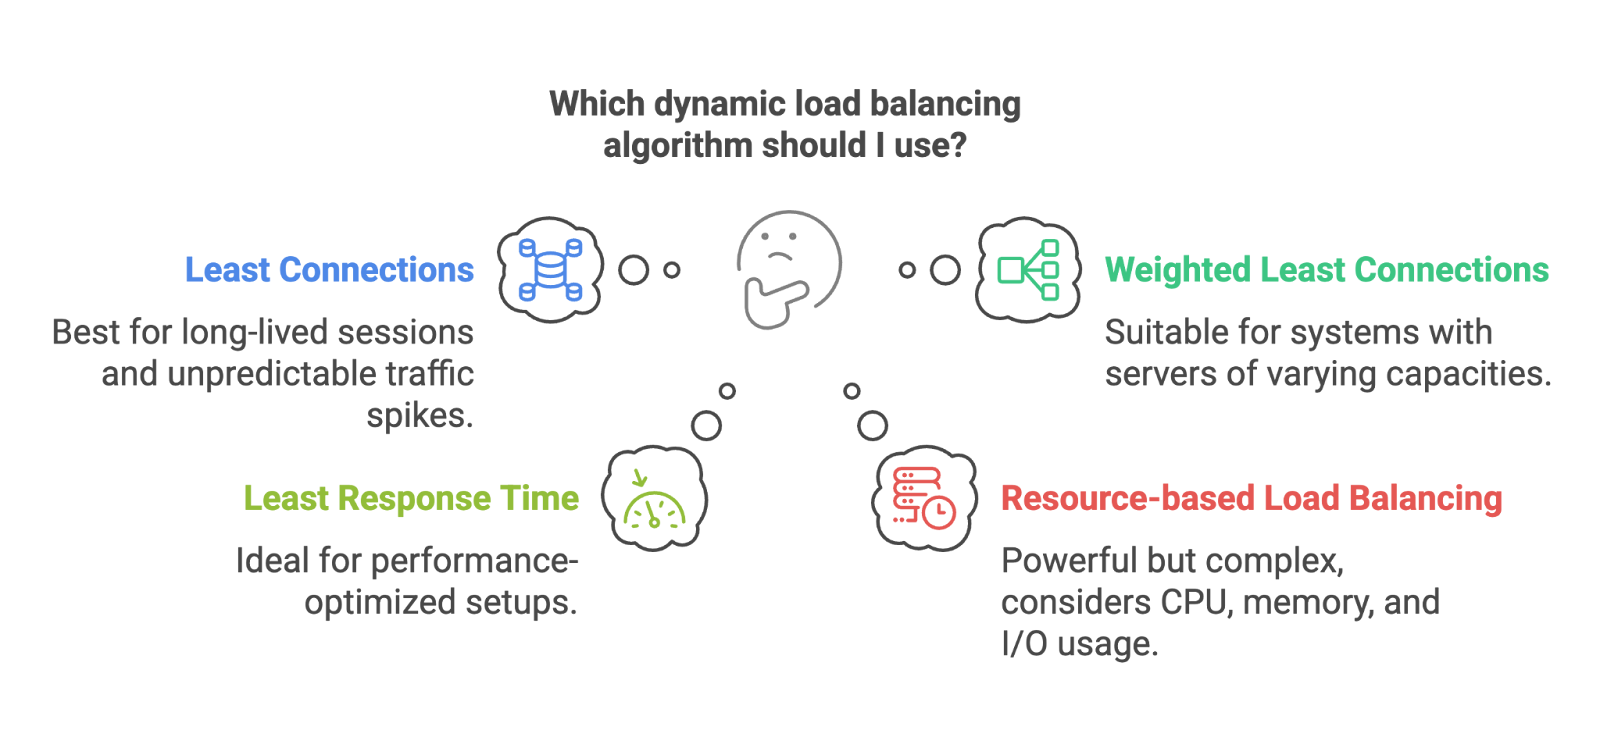
Algoritmi dinamici. Immagine dell’Autore
Gli algoritmi statici sono perfetti quando il tuo traffico è prevedibile e i server sono omogenei. Quelli dinamici brillano quando le cose sono un po’ più caotiche.
Bene, ora parliamo dei diversi tipi di load balancer: hardware, software, cloud-native e altro ancora.
Non tutti i load balancer sono uguali. Alcuni vivono nell’hardware, alcuni girano come software, altri sono inclusi nei servizi cloud e alcuni sono specializzati in casi d’uso molto specifici. Quale usare dipende dalla tua architettura, dalla tua scala e, a volte, semplicemente dal budget.
Sono appliance fisiche presenti nel tuo data center, costruite ad hoc per bilanciare il traffico. Sono potenti e veloci, ma costose e più difficili da scalare on demand. Pensa a grandi enterprise e ambienti on-prem.
Girano come applicazioni su server generici. Strumenti come HAProxy, nginx (di F5) o Envoy rientrano in questa categoria. Sono più economici, flessibili e facili da integrare nella maggior parte degli ambienti.
Se usi AWS, Azure o GCP, probabilmente stai già usando un load balancer cloud-native, come AWS ELB, Azure Load Balancer o GCP Load Balancing. Sono gestiti per te, scalano automaticamente e si integrano bene con gli altri servizi.
Se vuoi familiarizzare con come AWS gestisce questo (e molte altre componenti di infrastruttura), dai un’occhiata al nostro corso AWS Cloud Technology and Services Concepts.
Forse hai sentito parlare di elastic load balancer. Sono progettati per scalare su e giù con il tuo carico di lavoro. Spesso fanno parte di sistemi cloud-native, ma il termine “elastic” significa solo che possono adattarsi dinamicamente al traffico, ideale per carichi a picchi o imprevedibili.
Il modello OSI è un framework concettuale usato per descrivere come i dati si muovono in rete. Ha sette layer, dal cavo fisico fino all’app nel tuo browser. Per il load balancing, i layer più rilevanti sono il 4 e il 7.
Prendono decisioni di routing basate su indirizzi IP, porte e traffico TCP/UDP. Sono veloci ed efficienti, ma non sanno nulla del contenuto inviato.
Guardano al contenuto effettivo della richiesta, come header HTTP, cookie o URL. Questo consente cose più avanzate come il routing basato sul percorso URL, l’A/B testing o le preferenze di lingua. Per esempio, se vuoi che le richieste /api/ vadano a un cluster e /login a un altro, ti serve il Layer 7.
Usati per distribuire il traffico tra data center geograficamente distribuiti. Utili per setup multi-regione, a bassa latenza o per il disaster recovery.
Operano interamente all’interno di reti private, usati per bilanciare il traffico tra servizi dentro un cloud o un cluster.
Specializzati per i sistemi di telecomunicazione che usano il protocollo Diameter, spesso presenti nelle reti mobili per l’instradamento, l’autenticazione e le richieste di billing.
Ottimizzati specificamente per gestire traffico HTTP e HTTPS. Spesso includono terminazione SSL, routing basato su URL e protezione DDoS integrata.
Ogni tipo di load balancer risolve un problema diverso. Alcuni sono focalizzati sulla scala, altri sulla latenza, la sicurezza o la facilità d’uso. Sapere quale scegliere può fare una grande differenza su quanto sia fluida (o dolorosa) la gestione della tua infrastruttura.
Finora abbiamo parlato di cosa fanno i load balancer e dei tipi che potresti usare, ma come sono costruiti sotto il cofano? L’architettura di un sistema di load balancing influisce su tutto: da quanto bene scala a quanto elegantemente gestisce i guasti.
Questo è il setup classico: un nodo “leader” prende le decisioni e distribuisce il lavoro a più nodi “worker”. È semplice e facile da comprendere, ma il leader può diventare un collo di bottiglia o un single point of failure se non è adeguatamente ridondato.
Invece di un cervello centrale, ogni load balancer è consapevole dei propri pari e si divide il lavoro. Questo migliora la tolleranza ai guasti e la scalabilità, ma rende il coordinamento un po’ più complicato. Lo vedi spesso in sistemi su larga scala con routing anycast o distribuzione basata su DNS.
Negli ambienti containerizzati, soprattutto con Kubernetes, il load balancing diventa ancora più interessante. Services, ingress controller e sidecar collaborano per instradare il traffico in modo intelligente all’interno dei cluster. Se stai iniziando a esplorare questo mondo, il nostro corso Introduction to Kubernetes è un ottimo modo pratico per imparare le basi.
In questo setup, i worker inattivi possono “rubare” task da quelli più occupati. È comunemente usato in ambienti ad alta computazione come code di task o pipeline di elaborazione dati, ma non molto per il traffico web. È comunque un pattern utile per bilanciare carichi imprevedibili.
Alcuni sistemi stratificano i propri load balancer, ad esempio uno a livello globale (tra regioni), un altro a livello di data center e un terzo all’interno di uno specifico cluster di servizi. Questo aiuta a gestire la complessità e mantiene ogni layer focalizzato su un ambito specifico.
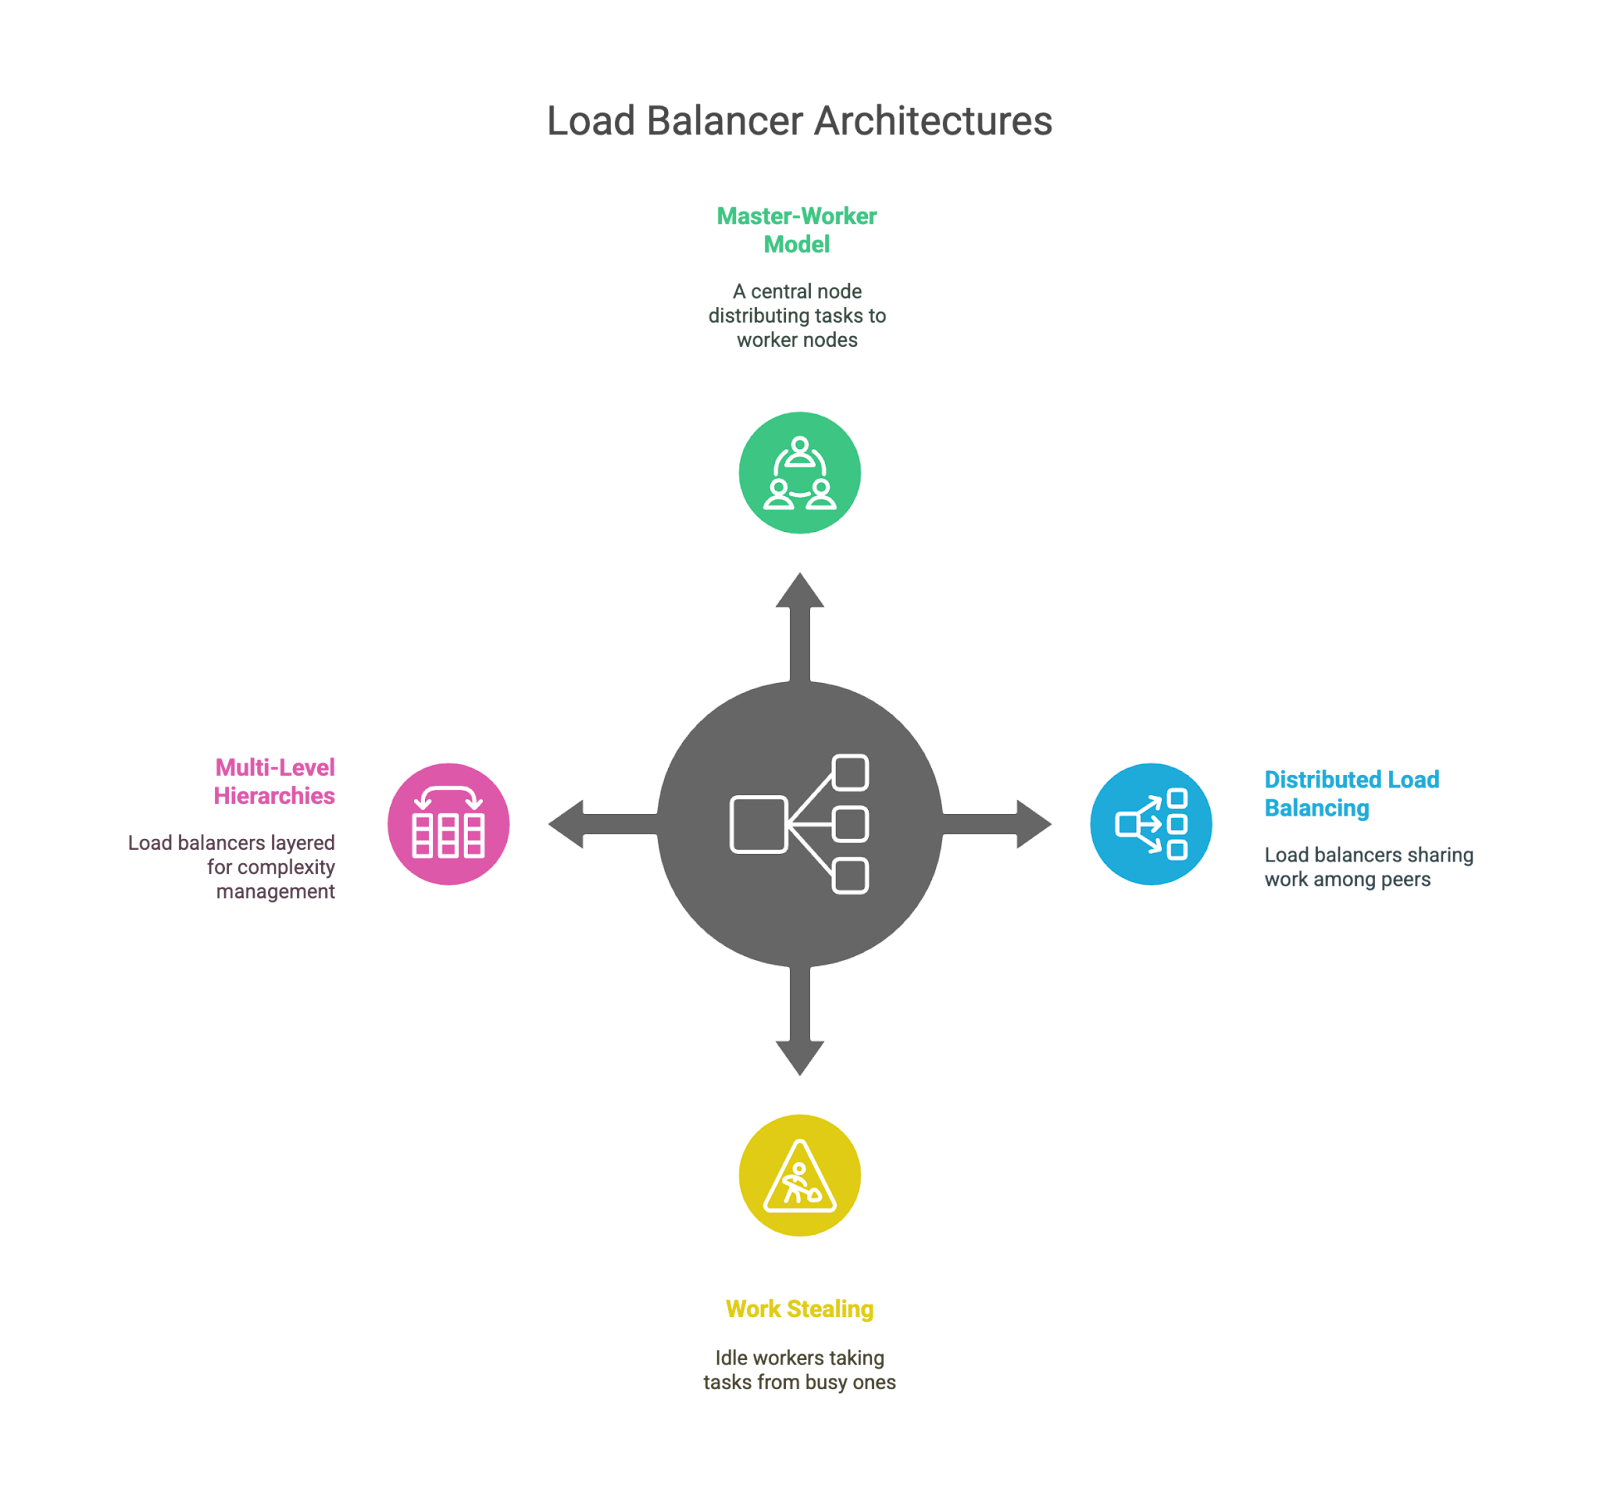
Architetture di load balancing.
Ciascuna di queste architetture ha dei compromessi. I modelli centralizzati sono facili da capire ma rischiano di diventare colli di bottiglia; i modelli distribuiti scalano meglio ma aggiungono complessità; le topologie a livelli offrono modularità ma possono introdurre latenza se non progettate con attenzione. Come al solito, non esiste una risposta valida per tutti. Dipende dalle dimensioni del tuo sistema, dai pattern di traffico e dalla tua tolleranza al rischio.
Il load balancing è potente, ma non è magia. Sebbene possa rendere i sistemi più affidabili, scalabili ed efficienti, introduce anche nuovi livelli di complessità e potenziali punti di failure. Parliamo di alcuni dei compromessi con cui si confrontano gli ingegneri, sia tecnici sia operativi.
Paradossalmente, lo strumento pensato per distribuire il traffico può diventare un single point of failure se non è architettato correttamente, soprattutto nei modelli centralizzati o basati su leader. Per questo molti sistemi usano più load balancer, meccanismi di failover o persino bilanciamento a livello DNS per distribuire il rischio.
Per quanto veloce, un load balancer aggiunge comunque un hop tra client e backend. Questo può introdurre latenza, specialmente in architetture multilivello o con routing a livello applicativo (Layer 7).
Gestire il traffico HTTPS al livello del load balancer (cioè la terminazione SSL) può scaricare lavoro CPU dai server di backend, ma significa anche che il load balancer fa di più e diventa responsabile di impostazioni di sicurezza e certificati sensibili.
Le sessioni sticky sono utili per mantenere gli utenti legati allo stesso backend (ad esempio durante il login), ma complicano la scalabilità e rendono più difficile avere servizi completamente stateless. Spesso gli ingegneri devono scegliere tra esperienza utente ed eleganza architetturale.
Più è intelligente la tua logica di routing, più spazio c’è per bug, instradamenti errati o problemi prestazionali sottili e difficili da tracciare. Ti sentirai brillante quando la imposti, molto meno quando vieni svegliato alle 2 di notte per fare debug di health check ballerini.
Ogni applicazione si comporta in modo diverso sotto carico. Scegliere tra algoritmi statici o dinamici e regolare soglie di connessione o intervalli degli health check può richiedere molti tentativi, errori ed esperienza.
Quando qualcosa va storto, il load balancer aggiunge un altro posto in cui cercare. Route mal configurate, richieste perse, layer di caching o risultati incoerenti degli health check possono confondere le acque.
Se il tuo load balancer gestisce l’SSL, devi assicurarti che sia configurato correttamente, aggiornato e monitorato. Qualsiasi passo falso può creare vulnerabilità o rompere la comunicazione sicura.
Questo è in parte collegato al punto sulla complessità aggiunta. Hai bisogno di log, metriche e tracing solidi per capire come scorrono le richieste nel sistema. Senza una buona osservabilità, un load balancer che si comporta male può essere difficile da individuare e ancora più difficile da correggere.
Chiariamo: nessuno di questi è un motivo per non usare il load balancing. Sono solo la realtà di costruire sistemi resilienti: ogni layer che aggiungi può aiutare, ma introduce anche nuove sfide da gestire.
Come tutto nella tecnologia, il load balancing sta evolvendo. Man mano che i sistemi diventano più complessi, distribuiti e dinamici, gli approcci tradizionali vengono messi alla prova e si sperimentano nuove strategie.
Questo è abbastanza ovvio, vista la tendenza globale. Le piattaforme moderne stanno iniziando a integrare il machine learning per prevedere i pattern di traffico e prendere decisioni di routing più intelligenti. Invece di reagire solo al carico attuale, questi sistemi possono anticipare i picchi (come un lancio di prodotto o una breaking news) e pre-regolare il flusso di traffico. È ancora presto, ma il potenziale per un’infrastruttura auto-ottimizzante è reale.
Se vuoi esplorare questo lato, il nostro tutorial su Machine Learning, Pipelines, Deployment and MLOps è un ottimo punto di partenza.
I load balancer tradizionali non sanno davvero cosa fa la tua app; guardano solo il traffico. Il load balancing application-aware va più a fondo. Può prendere decisioni basate sull’identità dell’utente, il tipo di dispositivo o l’importanza business della richiesta. Per esempio, potrebbe dare priorità agli utenti loggati durante un picco o instradare il traffico sensibile verso cluster con sicurezza più elevata.
Man mano che le aziende distribuiscono i carichi tra più provider cloud (o mescolano on-prem e cloud), i load balancer si adattano. Devono essere più consapevoli della collocazione, supportare il failover cross-cloud e gestire il routing tra ambienti molto diversi. Aspettati di vedere più direttori di traffico globali e orchestrazione a livello DNS in questi setup.
Con l’ascesa dell’edge computing, il load balancing si sposta più vicino all’utente. Invece di instradare tutto attraverso un cloud centrale, le richieste vengono servite da nodi edge, abbattendo la latenza. Il load balancing all’edge deve essere leggero, intelligente e iper-locale.
Alcune piattaforme sperimentali stanno esplorando il load balancing basato su agent, in cui i singoli servizi contribuiscono a decidere come dovrebbe fluire il traffico in base a ciò che vedono localmente. È più distribuito e può rispondere rapidamente a variazioni su piccola scala, ma introduce anche sfide di coordinamento.
Mi sembra abbastanza chiaro che tutte queste tendenze puntano verso una cosa: un load balancing più dinamico, intelligente e consapevole del contesto. I giorni del semplice round robin sono ancora vivi e vegeti (perché buttare via qualcosa che funziona?), ma iniziano a condividere il palco con sistemi che imparano, si adattano e prendono decisioni in tempo reale basate su molto più che il carico del server.
In tutto l’articolo abbiamo visto cos’è il load balancing, perché conta e come funziona sotto il cofano. Abbiamo parlato di algoritmi, architetture e applicazioni reali e, si spera, reso il tutto un po’ meno misterioso. Spero che questo articolo ti abbia dato un quadro più chiaro di come tutto si incastri!
Come passo successivo, se ti interessa approfondire, iscriviti ai nostri corsi dedicati. Ti consiglio il nostro corso Introduction to Kubernetes e il corso AWS Cloud Technology and Services Concepts.
Impara con DataCamp
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min



