Cursus
AI-toepassingen bouwen met Pinecone
3 uur
12.2K
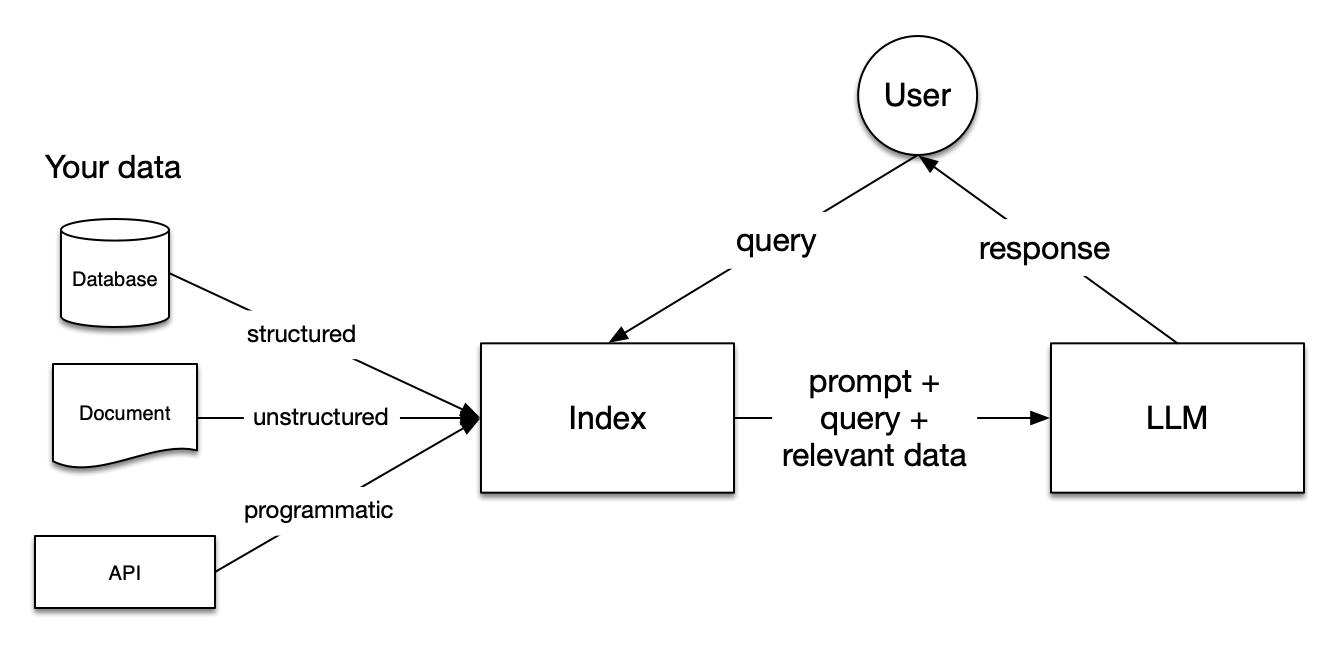
Afbeelding uit de LlamaIndex-documentatie
Retrieval Augmented Generation (RAG)-pijplijnen bestaan uit drie stappen: Indexing, Retrieval en Generation.
Indexeren is essentieel om nauwkeurige en contextbewuste antwoorden met LLM’s te krijgen. Het begint met het extraheren en opschonen van data in verschillende bestandsformaten, zoals Word-documenten, PDF-bestanden of HTML-bestanden. Zodra de data is opgeschoond, wordt deze omgezet naar gestandaardiseerde platte tekst. Om contextlimieten binnen LLM’s te vermijden, wordt de tekst opgedeeld in kleinere blokken (chunks). Dit proces heet Chunking. Daarna wordt elke chunk omgezet in een numerieke vector of embedding met een embeddingmodel. Tot slot wordt een index gebouwd om de chunks en hun bijbehorende embeddings als key-valueparen op te slaan.
Tijdens de retrievalfase wordt de gebruikersvraag ook omgezet naar een vectorrepresentatie met hetzelfde embeddingmodel. Vervolgens worden de similariteitsscores tussen de vraagvector en de gevectoriseerde chunks berekend. Het systeem haalt de top K chunks op die het meest lijken op de gebruikersvraag.
De gebruikersvraag en de opgehaalde chunks worden in een prompttemplate gezet. De verrijkte prompt uit de vorige stappen wordt vervolgens als input aan de LLM gegeven.
Bij het bouwen van RAG-systemen kun je in alle drie de hierboven beschreven stappen flinke uitdagingen tegenkomen, zoals:
Hieronder verkennen we strategieën om deze beperkingen te omzeilen. We bespreken drie brede strategieën: Chunking, Re-Ranking en Querytransformaties. Daarnaast laten we zien hoe deze strategieën de prestaties van RAG kunnen verbeteren door een RAG-systeem te bouwen dat vragen over Wikipedia-berichten beantwoordt met LlamaIndex en de OpenAI API. Laten we erin duiken!
Voordat we de trucs verkennen om de prestaties van een RAG-systeem te verbeteren, hebben we een baseline nodig door een eenvoudige RAG-pijplijn op te zetten. Laten we beginnen met het installeren van de pakketten llama-index en openai.
!pip install llama-index
!pip install openai
LlamaIndex is een dataframework voor applicaties op basis van Large Language Models (LLM’s). Het maakt het mogelijk om verschillende soorten externe databronnen in te lezen, Retrieval Augmentation Generation (RAG)-systemen te bouwen en integraties met andere LLM’s terug te brengen tot enkele regels code. Bovendien biedt het verschillende technieken om nauwkeurigere outputs met LLM’s te genereren.
Standaard gebruikt het voor tekstgeneratie het OpenAI-model gpt-3.5-turbo en voor retrieval en embeddings het model text-embedding-ada-002. Om deze modellen te gebruiken, moet je een gratis account op het OpenAI-platform aanmaken en een OpenAI API-sleutel verkrijgen. Ga voor de sleutel naar de OpenAI API-documentatie.
import os
os.environ["OPENAI_API_KEY"] = "YOUR_OPENAI_API_KEY"
Nu onze pakketten zijn geïnstalleerd, bouwen we een RAG-systeem dat vragen beantwoordt op basis van de Wikipedia-pagina’s van Emma Stone, Ryan Gosling en La La Land. Eerst moeten we de bibliotheek wikipedia installeren om de Wikipedia-pagina’s te extraheren:
!pip install wikipediaVervolgens kunnen we de data eenvoudig van Wikipedia downloaden:
# Import packages
from llama_index.core import (VectorStoreIndex,ServiceContext, download_loader)

# Download the documents from Wikipedia and load them
WikipediaReader = download_loader("WikipediaReader")
loader = WikipediaReader()
pages = ['Emma_Stone', 'La_La_Land', 'Ryan_Gosling']
documents = loader.load_data(pages=pages, auto_suggest=False, redirect = False)
Zodra de data is geëxtraheerd, kunnen we de documenten opdelen in chunks van 256 tekens zonder overlap. Daarna worden deze chunks met het embeddingmodel omgezet in numerieke vectoren en geïndexeerd in een Vector Store.
# Initialize the gpt3.5 model
gpt3 = OpenAI(temperature=0, model="gpt-3.5-turbo-instruct", api_key=OPENAI_API_KEY)
# Initialize the embedding model
embed_model = OpenAIEmbedding(model= OpenAIEmbeddingModelType.TEXT_EMBED_ADA_002, api_key=OPENAI_API_KEY)
# Transform chunks into numerical vectors using the embedding model
service_context_gpt3 = ServiceContext.from_defaults(llm=gpt3, chunk_size = 256, chunk_overlap=0, embed_model=embed_model)
index = VectorStoreIndex.from_documents(documents, service_context=service_context_gpt3)
retriever = index.as_retriever(similarity_top_k=3)
Om het risico op hallucinaties te verkleinen, gebruiken we de module PromptTemplate om ervoor te zorgen dat de antwoorden van de LLM alleen op de aangeleverde context zijn gebaseerd.
from llama_index.core.prompts import PromptTemplate
# Build a prompt template to only provide answers based on the loaded documents
template = (
"We have provided context information below. \n"
    "---------------------\n"
    "{context_str}"
    "\n---------------------\n"
    "Given this information, please answer the question: {query_str}\n"
    "Don't give an answer unless it is supported by the context above.\n"
)

qa_template = PromptTemplate(template)
Nu we ons RAG-systeem hebben opgezet, kunnen we het testen met vragen op basis van opgehaalde documenten. Tijd voor de proef op de som!
Query 1: “Wat is de verhaallijn van de film die Emma Stone haar eerste Academy Award opleverde?”
Deze eerste vraag is lastig omdat het model verschillende stukjes informatie moet combineren:
# Create a prompt for the model
question = "What is the plot of the film that led Emma Stone to win her first Academy Award?"

# Retrieve the context from the model
contexts = retriever.retrieve(question)
context_list = [n.get_content() for n in contexts]
prompt = qa_template.format(context_str="\n\n".join(context_list), query_str=question)

# Generate the response
response = gpt3.complete(prompt)
print(str(response))
Output:
The plot of the film that made Emma Stone win her first Academy Award is not explicitly mentioned in the provided context.Query 2: "Vergelijk de families van Emma Stone en Ryan Gosling”
Deze tweede vraag is nog uitdagender dan de vorige, omdat er relevante chunks over de families van beide acteurs geselecteerd moeten worden.
# Create a prompt for the model
question = "Compare the families of Emma Stone and Ryan Gosling"
# Retrieve the context from the model
contexts = retriever.retrieve(question)
context_list = [n.get_content() for n in contexts]
prompt = qa_template.format(context_str="\n\n".join(context_list), query_str=question)
# Generate the response
response = gpt3.complete(prompt)
print(str(response))
We krijgen de volgende output:
Based on the context provided, it is not possible to compare the families of Emma Stone and Ryan Gosling as the information focuses on their professional collaboration and experiences while working on the film "La La Land." There is no mention of their personal family backgrounds or relationships in the context provided.Zoals je ziet, kregen we in beide gevallen matige antwoorden. In de volgende secties bekijken we manieren om de prestaties van dit RAG-systeem te verbeteren!
We kunnen beginnen met het aanpassen van de chunkgrootte en de overlap. Zoals hierboven gezegd, worden documenten opgesplitst in chunks met een specifieke overlap. Standaard gebruikt LlamaIndex 1024 als chunkgrootte en 20 als overlap. Daarnaast haalt het systeem standaard de top 2 chunks op.
Zo kunnen we bijvoorbeeld de chunkgrootte op 512 zetten, de overlap op 50 en het aantal opgehaalde topchunks verhogen:
# modify default values of chunk size and chunk overlap
service_context_gpt3 = ServiceContext.from_defaults(llm=gpt3, chunk_size = 512, chunk_overlap=50, embed_model=embed_model)

# build index
index = VectorStoreIndex.from_documents(
    documents, service_context=service_context_gpt3

)
# returns the engine for the index
query_engine = index.as_query_engine(similarity_top_k=4)
Query 1: “Wat is de verhaallijn van de film die Emma Stone haar eerste Academy Award opleverde?”
# generate the response
response = query_engine.query("What is the plot of the film that led Emma Stone to win her first Academy Award?")
print(response)
Output:
The film that made Emma Stone win her first Academy Award is a romantic musical called La La Land.Vergeleken met het vorige antwoord is dit iets beter. Het herkent succesvol La La Land als de film die Emma Stone haar eerste Academy Award opleverde, maar beschrijft de verhaallijn niet.
Query 2: "Vergelijk de families van Emma Stone en Ryan Gosling”
# generate the response
response = query_engine.query("Compare the families of Emma Stone and Ryan Gosling")
print(response)
Output:
Emma Stone has expressed her close relationship with her family and mentioned being blessed with great family and people around her. She has also shared about her mother's battle with breast cancer and their celebration by getting matching tattoos. On the other hand, there is no specific information provided about Ryan Gosling's family or his personal relationships in the context.Wederom is de output van de RAG-pijplijn verbeterd, maar er wordt nog steeds geen informatie over Ryan Goslings familie opgepikt.
Naarmate de dataset groeit in omvang en complexiteit, wordt het selecteren van relevante informatie voor complexe vragen cruciaal. Hiervoor bestaat een familie van technieken, Re-Ranking, die helpt bepalen welke chunks belangrijk zijn in de tekst. Ze herordenen en filteren documenten, waarbij de meest relevante bovenaan komen.
Er zijn twee hoofdbenaderingen voor Re-Ranking:
Voordat we deze Re-Ranking-aanpakken toepassen, evalueren we eerst wat het baseline RAG-systeem als top drie chunks teruggeeft voor onze tweede vraag:
# Retrieve the top three chunks for the second query
retriever = index.as_retriever(similarity_top_k=3)
query = "Compare the families of Emma Stone and Ryan Gosling"
nodes = retriever.retrieve(query)
# Print the chunks
for node in nodes:
    print('----------------------------------------------------')
    display_source_node(node, source_length = 500)
Dit is de output vóór Re-Ranking; elke chunk heeft een Node ID met een similariteitsscore.
Node ID: 9b3817fe-3a3f-4417-83d2-2e2996c8b468
Similarity: 0.8415899563985404
Text: Emily Jean "Emma" Stone (born November 6, 1988) is an American actress and producer. She is the recipient of various accolades, including two Academy Awards, two British Academy Film Awards, and two Golden Globe Awards. In 2017, she was the world's highest-paid actress and named by Time magazine as one of the 100 most influential people in the world. Born and raised in Scottsdale, Arizona, Stone began acting as a child in a theater production of The Wind in the Willows in 2000. As a teenager,...
----------------------------------------------------

Node ID: 1bef0308-8b0f-4f7e-9cd6-92ce5acf811f
Similarity: 0.831147173341674
Text: Coincidentally, Gosling turned down the Beast role in Beauty and the Beast in favor of La La Land. Chazelle subsequently decided to make his characters somewhat older, with experience in struggling to make their dreams, rather than younger newcomers just arriving in Los Angeles. Emma Stone plays Mia, an aspiring actress in Los Angeles. Stone has loved musicals since she saw Les Misérables when she was eight years old. She said "bursting into song has always been a real dream of mine", and her ...
----------------------------------------------------

Node ID: 576ae445-b12e-4d20-99b7-5e5a91ee7d74
Similarity: 0.8289486590392277
Text: Stone was named the best-dressed woman of 2012 by Vogue and was included on similar listings by Glamour in 2013 and 2015, and People in 2014.
== Personal life == Stone moved from Los Angeles to Greenwich Village, New York, in 2009. In 2016, she moved back to Los Angeles. Despite significant media attention, she refuses to publicly discuss her personal life. Concerned with living a normal life, Stone has said she dislikes receiving paparazzi attention outside her home. She has expressed her ...Om de relevante chunks op te halen, kunnen we een open-source Re-Ranking-model van Hugging Face gebruiken, het bge-ranker-base-model.
Net als bij de OpenAI API heb je voor Hugging Face een user access token nodig. Je kunt een user access token aanmaken via deze documentatie.
HF_TOKEN = userdata.get('HF_TOKEN')
os.environ['HF_TOKEN'] = HF_TOKEN
Voordat we verder gaan, moeten we ook de benodigde libraries installeren om het Re-Ranking-model te gebruiken:
%pip install llama-index-postprocessor-flag-embedding-reranker
!pip install git+https://github.com/FlagOpen/FlagEmbedding.git
Tot slot gebruiken we het model bge-ranker-base om de meest relevante chunks terug te geven.
# Import packages
from llama_index.postprocessor.flag_embedding_reranker import FlagEmbeddingReranker

from llama_index.core.schema import QueryBundle
# Re-Rank chunks based on the bge-reranker-base-model
reranker = FlagEmbeddingReranker(
    top_n = 3,
    model = "BAAI/bge-reranker-base",
)
# Return the updated chunks
query_bundle = QueryBundle(query_str=query)
ranked_nodes = reranker._postprocess_nodes(nodes, query_bundle = query_bundle)
for ranked_node in ranked_nodes:
    print('----------------------------------------------------')
    display_source_node(ranked_node, source_length = 500)
Dit is het resultaat na Re-Ranking:
Node ID: 9b3817fe-3a3f-4417-83d2-2e2996c8b468
Similarity: 3.0143558979034424
Text: Emily Jean "Emma" Stone (born November 6, 1988) is an American actress and producer. She is the recipient of various accolades, including two Academy Awards, two British Academy Film Awards, and two Golden Globe Awards. In 2017, she was the world's highest-paid actress and named by Time magazine as one of the 100 most influential people in the world. Born and raised in Scottsdale, Arizona, Stone began acting as a child in a theater production of The Wind in the Willows in 2000. As a teenager,...
----------------------------------------------------

Node ID: 576ae445-b12e-4d20-99b7-5e5a91ee7d74
Similarity: 2.2117154598236084
Text: Stone was named the best-dressed woman of 2012 by Vogue and was included on similar listings by Glamour in 2013 and 2015, and People in 2014.
== Personal life == Stone moved from Los Angeles to Greenwich Village, New York, in 2009. In 2016, she moved back to Los Angeles. Despite significant media attention, she refuses to publicly discuss her personal life. Concerned with living a normal life, Stone has said she dislikes receiving paparazzi attention outside her home. She has expressed her ...
----------------------------------------------------

Node ID: 1bef0308-8b0f-4f7e-9cd6-92ce5acf811f
Similarity: 1.6185210943222046
Text: Coincidentally, Gosling turned down the Beast role in Beauty and the Beast in favor of La La Land. Chazelle subsequently decided to make his characters somewhat older, with experience in struggling to make their dreams, rather than younger newcomers just arriving in Los Angeles.Emma Stone plays Mia, an aspiring actress in Los Angeles. Stone has loved musicals since she saw Les Misérables when she was eight years old. She said "bursting into song has always been a real dream of mine", and her ...
Uit de output blijkt dat de node met ID 1bef0308-8b0f-4f7e-9cd6-92ce5acf811f van de tweede naar de derde positie verschuift. Ook valt op dat er meer variatie in de similariteitsscores zit.
Nu we Re-Ranking hebben gebruikt, bekijken we hoe het RAG-antwoord op de oorspronkelijke vraag er nu uitziet:
# Initialize the query engine with Re-Ranking
query_engine = index.as_query_engine(
    similarity_top_k = 3,
    node_postprocessors=[reranker]
)

# Print the response from the model
response = query_engine.query("Compare the families of Emma Stone and Ryan Gosling")

print(response)
Dit is het antwoord na toepassing van het Re-Ranking-model:
Both Emma Stone and Ryan Gosling have close relationships with their families. Stone has expressed her gratitude for having a great family and people around her who keep her grounded. Gosling, on the other hand, has drawn from his own experiences as an aspiring artist, indicating a connection to his personal background.Er is een duidelijke verbetering ten opzichte van eerdere antwoorden, maar het is nog steeds niet volledig. Laten we bekijken hoe een LLM-gebaseerde Re-Ranking-aanpak de RAG-prestaties verder kan verbeteren.
Dit keer kunnen we een LLM als Re-Ranker inzetten. We gebruiken hier de module RankGPT, die de capaciteiten van het GPT-model benut om documenten binnen het RAG-systeem te ranken. We beginnen met de vereiste pakketten installeren:
%pip install llama-index-postprocessor-rankgpt-rerankWe gebruiken de functie RankGPTRerank om de chunks te herordenen met het model gpt-3.5-turbo-0125.
# Import packages
from llama_index.postprocessor.rankgpt_rerank import RankGPTRerank
# Re-Rank the top 3 chunks based on the gpt-3.5-turbo-0125 model
reranker = RankGPTRerank(
    top_n = 3,
    llm = OpenAI(model="gpt-3.5-turbo-0125"),
)
# Display the top 3 chunks based on RankGPT
query_bundle = QueryBundle(query_str=query)
ranked_nodes = reranker._postprocess_nodes(nodes, query_bundle = query_bundle)

for ranked_node in ranked_nodes:
    print('----------------------------------------------------')
    display_source_node(ranked_node, source_length = 500)
Met RankGPT krijgen we de volgende chunks:
----------------------------------------------------

Node ID: 1bef0308-8b0f-4f7e-9cd6-92ce5acf811f
Similarity: 1.6185210943222046
Text: Coincidentally, Gosling turned down the Beast role in Beauty and the Beast in favor of La La Land. Chazelle subsequently decided to make his characters somewhat older, with experience in struggling to make their dreams, rather than younger newcomers just arriving in Los Angeles.Emma Stone plays Mia, an aspiring actress in Los Angeles. Stone has loved musicals since she saw Les Misérables when she was eight years old. She said "bursting into song has always been a real dream of mine", and her ...
----------------------------------------------------

Node ID: 9b3817fe-3a3f-4417-83d2-2e2996c8b468
Similarity: 3.0143558979034424
Text: Emily Jean "Emma" Stone (born November 6, 1988) is an American actress and producer. She is the recipient of various accolades, including two Academy Awards, two British Academy Film Awards, and two Golden Globe Awards. In 2017, she was the world's highest-paid actress and named by Time magazine as one of the 100 most influential people in the world. Born and raised in Scottsdale, Arizona, Stone began acting as a child in a theater production of The Wind in the Willows in 2000. As a teenager,...
----------------------------------------------------

Node ID: 576ae445-b12e-4d20-99b7-5e5a91ee7d74
Similarity: 2.2117154598236084
Text: Stone was named the best-dressed woman of 2012 by Vogue and was included on similar listings by Glamour in 2013 and 2015, and People in 2014.
== Personal life == Stone moved from Los Angeles to Greenwich Village, New York, in 2009. In 2016, she moved back to Los Angeles. Despite significant media attention, she refuses to publicly discuss her personal life. Concerned with living a normal life, Stone has said she dislikes receiving paparazzi attention outside her home. She has expressed her ...
Omdat RankGPT de passages niet op similariteitsscore sorteert, worden de scores in de output niet bijgewerkt. We zien wel dat de eerste node, beschouwd als het meest relevant, zowel Emma Stone als Ryan Gosling noemt, terwijl de overige nodes meer details over Emma Stones leven bevatten.
Als we nu het modelantwoord met deze Re-Ranking-methode printen, krijgen we de volgende output:
Both Emma Stone and Ryan Gosling have close relationships with their families. Stone has expressed gratitude for having a great family and supportive people around her, while Gosling has drawn from his own experiences as an aspiring artist, indicating a connection to his family as well. Stone's family has played a significant role in her life, supporting her career pursuits and celebrating important milestones with her. Similarly, Gosling's experiences as an actor have likely been influenced by his family dynamics and relationships.Het antwoord is langer en bevat meer details dan bij de vorige Re-Ranking-techniek.
Querytransformatie, ook wel query rewriting, zet een vraag om in een andere vraag in plaats van de ruwe vraag te gebruiken om de top k chunks op te halen. We gaan de volgende technieken verkennen:
HyDE staat voor Hypothetical Document Embeddings. Het bestaat uit twee stappen. Eerst wordt een hypothetisch antwoord op een gebruikersvraag gecreëerd. Zodra het hypothetische antwoord/document is bepaald, worden het antwoord en de vraag omgezet in embeddings. Vervolgens haalt het systeem de documenten op die het dichtst bij deze embeddings in de vectorruimte liggen. Aan de slag!
# Import packages
from llama_index.core.indices.query.query_transform import HyDEQueryTransform
from llama_index.core.query_engine.transform_query_engine import (
    TransformQueryEngine,
)
# build index and query engine for the index
index = VectorStoreIndex.from_documents(documents, service_context=service_context_gpt3)
query_engine = index.as_query_engine(similarity_top_k=4)

# HyDE setup
hyde = HyDEQueryTransform(include_original=True)
# Transform the query engine using HyDE
hyde_query_engine = TransformQueryEngine(query_engine, hyde)

# Print the response from the model
response = hyde_query_engine.query("Compare the families of Emma Stone and Ryan Gosling")
print(response)
Dit is de output:
Both Emma Stone and Ryan Gosling come from diverse family backgrounds. Ryan Gosling's parents were of part French Canadian descent, along with some German, English, Scottish, and Irish. He grew up in a family that practiced the Church of Jesus Christ of Latter-day Saints. On the other hand, Emma Stone was born and raised in Scottsdale, Arizona, without specific details provided about her family's ethnic background or religious affiliation.In vergelijking met de Re-Ranking-methodes zien we een gedeeltelijke verbetering. Eerder gingen de antwoorden meer over de relatie van de acteurs met hun families. Nu ligt de focus meer op herkomst.
De multi-step querytransformatie splitst de gebruikersvraag op in opeenvolgende deelvragen. Deze methode is handig bij complexe vragen.
We zagen dat LLM’s moeite kunnen hebben met het vergelijken van twee feiten, ook als ze een vraag over één specifiek onderwerp wel goed kunnen beantwoorden. Hieronder zie je multi-step querytransformaties in actie.
# Multi-step query setup
step_decompose_transform_gpt3 = StepDecomposeQueryTransform(gpt3, verbose=True)
index_summary = "Breaks down the initial query"
# Return query engine for the index
multi_step_query_engine = MultiStepQueryEngine(
    query_engine=query_engine,
    query_transform=step_decompose_transform_gpt3,
    index_summary=index_summary
)

# print the response from the model
response = multi_step_query_engine.query("Compare the families of Emma Stone and Ryan Gosling")
We kunnen de tussenliggende vragen zien die tot de uiteindelijke output leiden:
> Current query: Compare the families of Emma Stone and Ryan Gosling
> New query: What is the family background of Emma Stone and Ryan Gosling?
> Current query: Compare the families of Emma Stone and Ryan Gosling
> New query: What is the specific family background of Emma Stone?
> Current query: Compare the families of Emma Stone and Ryan Gosling
> New query: What is Emma Stone's relationship with her family like?
Dit is het volgende antwoord op de gebruikersvraag:
Both Ryan Gosling and Emma Stone have strong family connections, with Emma Stone emphasizing the importance of her family in keeping her grounded. Ryan Gosling's family background includes a mix of French Canadian, German, English, Scottish, and Irish heritage.In dit geval was het gebruik van multi-step querytransformatie om de families van Emma Stone en Ryan Gosling te vergelijken effectief.
In dit artikel heb je verschillende technieken geleerd om de prestaties van RAG te verbeteren. Of het nu gaat om Chunking, Re-Ranking of Querytransformaties: de beste aanpak hangt vaak af van de usecase en het gewenste antwoord op een bepaalde vraag.
Wil je dieper in RAG duiken? Bekijk dan onze code-alongs over Retrieval Augmented Generation met LlamaIndex en Retrieval Augmented Generation met GPT en Milvus. Deze video’s laten zien hoe je LLM’s met vectordatabases combineert via retrieval augmented generation in verschillende usecases.
Zet je AI-reis vandaag voort!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

