Cursus
Werken met de OpenAI API
3 uur
184.5K
OpenAI’s meest geavanceerde model, Generative Pre-trained Transformer 4 (GPT-4), gelanceerd in maart 2023, is een sprong voorwaarts in kunstmatige intelligentie en zet een nieuwe standaard voor AI-capaciteiten. Beschikbaar via ChatGPT Plus, de API van OpenAI en Microsoft Copilot, onderscheidt GPT-4 zich door zijn multimodale mogelijkheden, met name via GPT-4V, waarmee het naast tekst ook afbeeldingen kan verwerken. Dat opent de deur naar innovatieve toepassingen in uiteenlopende domeinen.
De kern van GPT-4’s vooruitgang is het transformer-gebaseerde raamwerk, uitgebreid voorgetraind op een enorme variëteit aan data van het internet en gelicentieerde bronnen, en fijn-afgestemd met een mix van menselijke feedback en AI-gestuurde reinforcement learning. Deze aanpak is erop gericht de afstemming van het model op menselijke ethische standaarden en beleidsregels te verbeteren.
Hoewel GPT-4 een verbetering is ten opzichte van zijn voorganger GPT-3, erft het enkele van diens beperkingen, wat de complexe uitdagingen van Large Language Models en Generatieve AI onderstreept. Een deel van die uitdagingen kun je aanpakken via een proces dat fine-tuning heet, het onderwerp van deze tutorial. De doelstellingen van deze tutorial zijn:
Houd er wel rekening mee dat GPT-4-fine-tuning momenteel alleen met experimentele toegang beschikbaar is. In aanmerking komende ontwikkelaars kunnen toegang aanvragen via de fine-tuning-UI. Dat gezegd hebbende: de besproken fine-tuningtechnieken zijn toepasbaar op alle GPT-modellen.
Fine-tuning is een geavanceerd proces waarmee je voorgetrainde modellen (zoals GPT-4) verfijnt voor specifieke taken of domeinen, door gebruik te maken van de brede basiskennis die het model tijdens de initiële training op diverse datasets heeft opgedaan. Dit houdt in dat je de parameters van het model aanpast op basis van taak-specifieke data, zodat de prestaties verbeteren en het model bepaalde toepassingen nauwkeuriger en efficiënter aankan.
Een illustratief voorbeeld van de impact van fine-tuning is het verbeteren van reacties op specialistische vragen. Een voorgetraind model geeft bijvoorbeeld een eenvoudige uitleg op de vraag waarom de lucht blauw is. Door fine-tuning kan dit antwoord worden verrijkt met gedetailleerde wetenschappelijke context, waardoor het geschikter wordt voor gespecialiseerde toepassingen zoals educatieve platforms.
Fine-tuningmethoden variëren van instruction fine-tuning, waarbij modellen worden getraind met specifieke voorbeelden die de gewenste reacties laten zien, tot parameter-efficient fine-tuning (PEFT), waarbij slechts een deel van de modelparameters wordt bijgewerkt om rekenresources te besparen en catastrofale vergeetachtigheid te voorkomen.
Daartegenover staat Retrieval Augmented Generation (RAG), een andere benadering. RAG combineert elementen van retrieval-based en generatieve modellen om de kwaliteit van gegenereerde content te verbeteren door tijdens het genereren informatie uit externe bronnen op te halen.
Waar fine-tuning zich richt op het optimaliseren van bestaande modellen voor specifieke taken, integreert RAG externe kennis om het generatieproces te verrijken.
De keuze tussen fine-tuning en RAG hangt af van de specifieke eisen van de toepassing, waaronder de behoefte aan actuele informatie, beschikbare rekenkracht en de gewenste mate van taakspecificiteit. Fine-tuning biedt een directe manier om de brede kennisbasis van voorgetrainde modellen voor specifieke taken te benutten, terwijl RAG een dynamische aanpak biedt om de relevantie en nauwkeurigheid van de informatie die het model gebruikt te waarborgen.
Fine-tuning van OpenAI’s tekstgeneratiemodellen is een krachtige manier om ze af te stemmen op specifieke behoeften, maar vergt flink wat tijd en resources. Voordat je aan fine-tuning begint, is het verstandig eerst te proberen de prestaties te maximaliseren met prompt engineering, prompt chaining (complexe taken opdelen in eenvoudigere, opeenvolgende prompts) en het gebruiken van functies. Deze aanpak is om meerdere redenen aan te raden:
Fine-tuning kan vooral nuttig zijn in de volgende situaties:
Vanwege het propriëtaire karakter van OpenAI’s modellen moet je de fine-tuning-API van OpenAI gebruiken als je een van de OpenAI-modellen wilt fine-tunen. Dit proces houdt in dat je je data uploadt naar de servers van OpenAI om het model te trainen.
Momenteel worden via de API alleen de volgende modellen ondersteund voor fine-tuning.
GPT-4-fine-tuning is met experimentele toegang beschikbaar; in aanmerking komende ontwikkelaars kunnen toegang aanvragen via de fine-tuning-UI. Ongeacht het gebruikte model veranderen het fine-tuningproces en de code in deze tutorial niet.
Dit is de belangrijkste stap. De kwaliteit van een fijn-afgestemd model is rechtstreeks afhankelijk van de data die je maakt om het model te fine-tunen. Voor de OpenAI-API moet de data zijn opgeslagen in jsonl-formaat.
JSONL is een tekstformaat waarbij elke regel een apart JSON-object is, wat het geschikt maakt om grote datasets regel voor regel te verwerken. Dit formaat is met name handig voor data die je eenvoudig kunt opsplitsen in individuele records zonder structuur te verliezen.
Voorbeeld:
{"prompt": "<prompt text>", "completion": "<ideal generated text>"}
{"prompt": "<prompt text>", "completion": "<ideal generated text>"}
{"prompt": "<prompt text>", "completion": "<ideal generated text>"}
Voor deze tutorial heb ik voorbeelddata gemaakt met slechts vijf voorbeelden. De data bestaat uit vragen over diverse onderwerpen in machine learning en antwoorden in de stijl van Shakespeare.
Voorbeelddata die ik voor deze tutorial heb gemaakt:
{"messages": [{"role": "system", "content": "You are teaching assistant for Machine Learning. You should help to user to answer on his question."}, {"role": "user", "content": "What is machine learning?"}, {"role": "assistant", "content": "'Tis but the art of teaching machines to think, to learn from data most fine, and decisions to link."}]}

{"messages": [{"role": "system", "content": "You are teaching assistant for Machine Learning. You should help to user to answer on his question."}, {"role": "user", "content": "How doth neural networks work?"}, {"role": "assistant", "content": "They're like the brains of yon digital beast, with layers many, and nodes that cease."}]}De eerste stap bij het aanmaken van een fine-tuningjob met de OpenAI-API is het uploaden van het bestand. Om deze API te gebruiken, moet de openai-bibliotheek in Python zijn geïnstalleerd.
!pip install openaiLog nu in op je platform.openai.com-account en genereer een API-token:
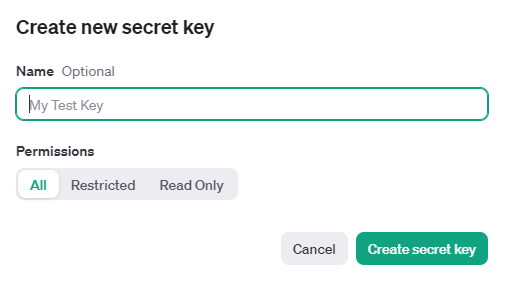
Je kunt de token vervolgens als omgevingsvariabele instellen met de os-bibliotheek.
import os


# Set the OPENAI_API_KEY environment variable
os.environ['OPENAI_API_KEY'] = '...'Je trainingsbestand moet in jsonl-formaat zijn. Na uploaden kan de verwerking even duren. De maximale grootte voor bestandsuploads is 1 GB. Om een bestand naar de OpenAI-server te uploaden:
from openai import OpenAI
client = OpenAI()


client.files.create(
  file=open("train.jsonl", "rb"),
  purpose="fine-tune"
)
Output:
FileObject(id='file-rIua39sJX1O64gzxTYfpvJx7', bytes=11165, created_at=1709499930, filename='train.jsonl', object='file', purpose='fine-tune', status='processed', status_details=None)Nadat je hebt gecontroleerd dat het bestand succesvol is geüpload, is de volgende stap het aanmaken van een fine-tuningjob. training_file is de bestands-ID die werd teruggegeven toen het trainingsbestand naar de OpenAI-API werd geüpload. Om een fine-tuningjob te starten:
from openai import OpenAI
client = OpenAI()


client.fine_tuning.jobs.create(
  training_file="file-rIua39sJX1O64gzxTYfpvJx7",
  model="gpt-3.5-turbo" #change to gpt-4-0613 if you have access
)
Voor extra fine-tuninginstellingen, zoals het validation_file of hyperparameters, bekijk de API-documentatie over fine-tuning.
De doorlooptijd van fine-tuningjobs varieert van minuten tot uren, afhankelijk van het model en de datasetgrootte. Met bijvoorbeeld slechts 50 voorbeelden in onze train.jsonl-dataset en gebruik van het gpt-3.5-turbo-model, was de job in slechts 7 minuten klaar.
Na voltooiing van de job ontvang je ook een bevestigingsmail.
Naast het starten van een fine-tuningjob kun je ook een lijst met huidige jobs bekijken, de status van een specifieke job controleren of een job annuleren.
from openai import OpenAI
client = OpenAI()


# List 10 fine-tuning jobs
client.fine_tuning.jobs.list(limit=10)


# Retrieve the state of a fine-tune
client.fine_tuning.jobs.retrieve("...")


# Cancel a job
client.fine_tuning.jobs.cancel("...")


# List up to 10 events from a fine-tuning job
client.fine_tuning.jobs.list_events(fine_tuning_job_id="...", limit=10)


# Delete a fine-tuned model (must be an owner of the org the model was created in)
client.models.delete("ft:gpt-3.5-turbo:xxx:xxx")\OpenAI biedt belangrijke trainingsstatistieken zoals training loss, token-accuratesse voor training, test loss en test token-accuratesse. Deze metrics helpen te verifiëren dat de training verloopt zoals verwacht, met dalende loss en verbeterende token-accuratesse. Je kunt deze nuttige metrics bekijken in een eventobject tijdens een actieve fine-tuningjob.
{
    "object": "fine_tuning.job.event",
    "id": "ftjob-Na7BnF5y91wwGJ4EgxtzVyDD",
    "created_at": 1693582679,
    "level": "info",
    "message": "Step 100/100: training loss=0.00",
    "data": {
        "step": 100,
        "train_loss": 1.805623287509661e-5,
        "train_mean_token_accuracy": 1.0
    },
    "type": "metrics"
}
Je kunt deze informatie ook in de UI bekijken.
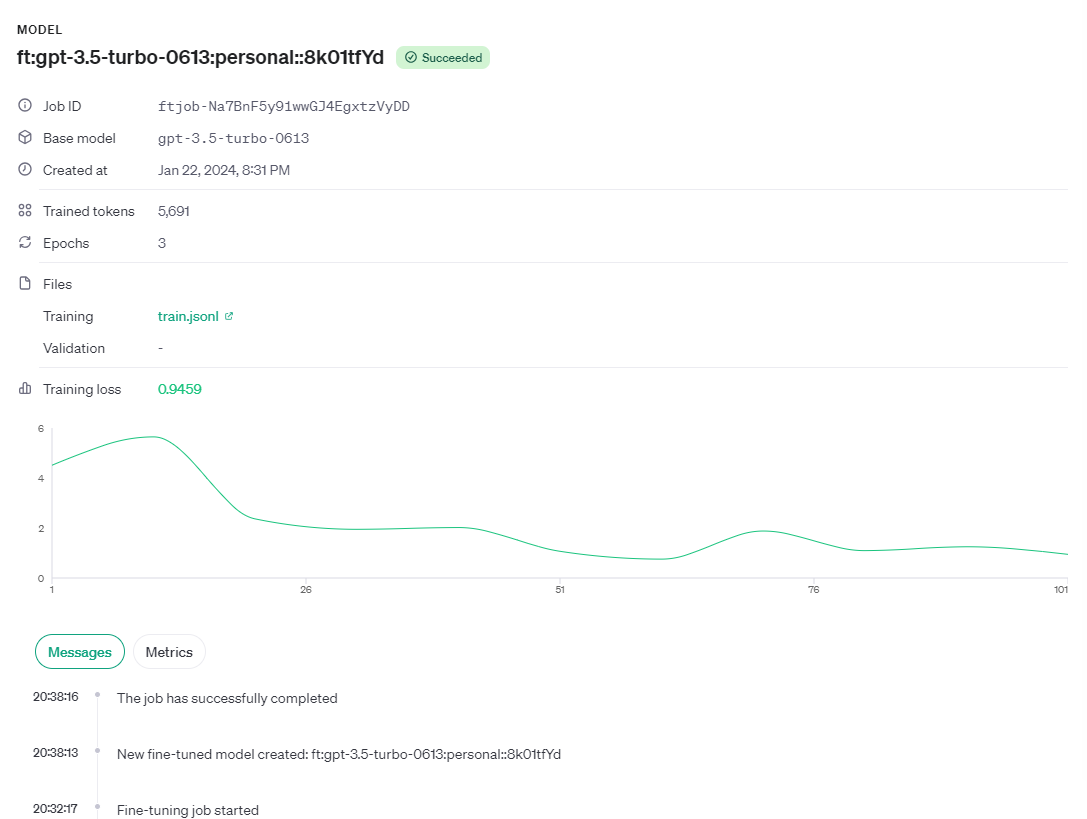
Na succesvolle afronding van een job bevatten de jobdetails het veld fine_tuned_model met de modelnaam. Je kunt vervolgens een API-aanroep naar dit model doen en een reactie krijgen van het model dat we zojuist hebben afgesteld.
from openai import OpenAI
client = OpenAI()


completion = client.chat.completions.create(
  model="ft:gpt-3.5-turbo-0613:personal::8k01tfYd",
  messages=[
    {"role": "system", "content": "You are a teaching assistant for Machine Learning. You should help to user to answer on his question."},
    {"role": "user", "content": "What is a loss function?"}
  ]
)
print(completion.choices[0].message)
Output:
ChatCompletionMessage(content="To measure how far we falter, it guides our way, our hope's defaulter.", role='assistant', function_call=None, tool_calls=None)Deze tutorial heeft je stap voor stap meegenomen door het proces van het fijn afstemmen van OpenAI’s GPT-model, een geavanceerde manier om de enorme capaciteiten van LLM’s voor gespecialiseerde domeintoepassingen te benutten. Met fine-tuning verfijn je de reacties van het taalmodel, zodat het specifieke taken, stijlen of domeinen met meer precisie en efficiëntie aankan.
In deze tutorial gebruiken we de OpenAI Python-API om een model te fine-tunen. Als je liever via een UI aan de slag gaat zonder een regel code te schrijven, bekijk dan de Datacamp-tutorial How to Fine Tune GPT 3.5.
Omdat GPT geen open-sourcemodel is, is het fine-tuningproces vrij eenvoudig en komt het neer op een API-call. Dat is heel anders bij het fine-tunen van open-sourcemodellen zoals Llama-2, Mistral, Stable Diffusion, enzovoort. Wil je leren hoe je verschillende open-sourcemodellen fine-tunet, bekijk dan deze blogs op DataCamp:
Voor meer beginnerresources over fine-tuning van LLM’s, bekijk An Introductory Guide to Fine-Tuning LLMs op Datacamp.
Begin vandaag nog aan je AI-reis!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

