
Cursus
Introductie tot Snowflake SQL
2 uur
57.5K
Het trainen van AI-modellen zit in de lift als een van de potentiële toepassingen van AI in data science. Meer specifiek kun je machine learning doen met Snowflake Cortex AI.
In deze gids bespreken we wat Snowflake Cortex AI is en wat je ermee kunt. Daarnaast geven we een eenvoudige tutorial om te starten met machine learning en AI met Python en wat SQL. Ben je nieuw bij Snowflake? Bekijk dan onze Introduction to Snowflake-cursus om snel bij te zijn.
Snowflake Cortex AI is een krachtige functie in de Snowflake AI Data Cloud, ontworpen om machine learning (ML)-operaties rechtstreeks binnen de Snowflake-omgeving te faciliteren.
Het maakt naadloze integratie van Python-ML-modellen met Snowflake-data mogelijk, zodat organisaties inzichten, voorspellingen en geavanceerde analyses uit grote datasets kunnen halen terwijl ze gebruikmaken van de cloudinfrastructuur.
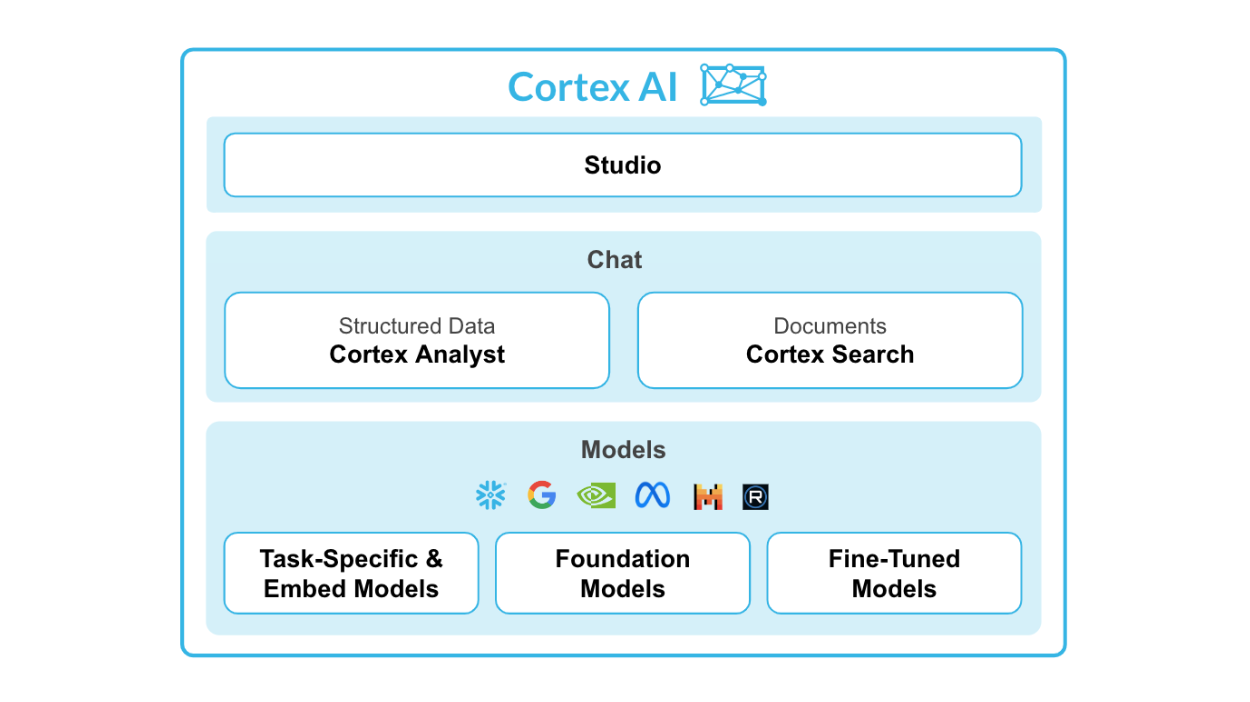
Bron: Snowflake Cortex AI
Belangrijkste functies van Snowflake Cortex AI:
Snowflake Cortex bestaat uit twee hoofdonderdelen—LLM-functies en ML-functies.
Voor LLM-functies heb je:
We bekijken elke functie verderop hieronder in meer detail.
Voor ML-functies heb je:
Wil je weten waar je Snowflake en zijn functies kunt leren? Onze beginners-Snowflake-tutorial en Snowflake-certificeringsgids helpen je op weg.
Laten we nu kijken naar de voordelen van deze tools samen gebruiken.
Een paar belangrijke voordelen van Snowflake Cortex AI zijn:
Ten eerste is Snowflake Cortex AI perfect voor bedrijven die hun data science-capaciteiten willen verbeteren zonder grote investeringen in resources. Met de no-code-omgeving kunnen zelfs niet-technische gebruikers eenvoudig ML-modellen ontwikkelen en implementeren.
Dit is vooral handig voor kleinere bedrijven of startups die misschien niet het budget hebben om een team van data scientists in te huren of in dure LLM’s te investeren.
Ten tweede kunnen gebruikers door Python in de compute-omgeving van Snowflake te integreren profiteren van de enorme bibliotheek met beschikbare Python-machinelearningalgoritmes en -tools. Zo kunnen ze geavanceerdere en nauwkeurigere modellen maken zonder nieuwe programmeertalen te hoeven leren.
Tot slot profiteren bedrijven die al met de Snowflake-omgeving werken optimaal van Cortex AI, omdat het naadloos integreert met hun bestaande datawarehouse, waardoor extra infrastructuur of datamigratie overbodig is.
Met Snowflake Cortex AI kunnen bedrijven machine learning gemakkelijk en efficiënt in hun bedrijfsprocessen implementeren.
In deze tutorial doorlopen we het opzetten van een machinelearning-pijplijn met Python en Snowflake Cortex AI.
Voordat je met ML aan de slag gaat met Snowflake Cortex AI, zorg dat je aan de volgende vereisten voldoet:
Je hebt eerst een Snowflake-instantie nodig waar je data wordt opgeslagen en verwerkt. Je kunt je aanmelden op de Snowflake-website.
Vul in het aanmeldformulier al je accountgegevens in en let erop dat je op de tweede pagina de volgende selecties maakt. Kies voor deze tutorial Standard Edition en Amazon Web Services voor de eenvoud en reproduceerbaarheid. Kies voor de server US West (Oregon) voor de beste selectie LLM-functies.
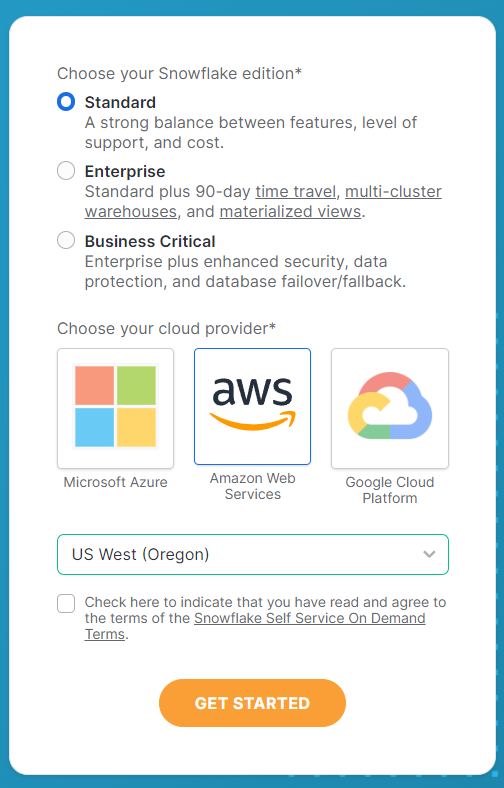
Zodra je deze opties hebt geselecteerd, klik je op Get Started om de activeringsmail te ontvangen. Ga naar je mail om je account te activeren en je Snowflake-account is klaar voor gebruik.
Vervolgens moet je ook aan een paar softwarevereisten voldoen.
Hier is een eenvoudige lijst met wat je nodig hebt:
Voordat je met een analyse begint, installeer je alle relevante pakketten zodat je codeeromgeving klaar is.
Om de benodigde pakketten te installeren, kun je pip gebruiken:
pip install snowflakepip install python-dotenvNadat je de libraries hebt geïnstalleerd, moet je je werkmap en bestanden instellen om te beginnen.
Ik heb een map gemaakt met de naam Cortex AI Tutorial en een nieuw .env bestand toegevoegd met de volgende informatie:
SNOWFLAKE_ACCOUNT = "<YOUR_ACCOUNT>" # eg. XXXX-XXXX

SNOWFLAKE_USER = "<YOUR_USER>"

SNOWFLAKE_USER_PASSWORD = "<YOUR_PASSWORD>"
Nadat je je accountgegevens hebt ingevoerd, sla je het bestand op en maak je in dezelfde map een Python- of Jupyter Notebook-bestand aan.
Nu je alles hebt ingesteld, koppelen we je Python-omgeving aan Snowflake.
Open je Python-bestand en importeer alle benodigde libraries. Dit is de code daarvoor:
import os
from dotenv import load_dotenv
from snowflake.snowpark import Session
from snowflake.cortex import Summarize, Complete, ExtractAnswer, Sentiment, Translate, EmbedText768
Vervolgens moet je de variabelen laden die je eerder in het .env-bestand hebt opgeslagen. Dit levert Snowflake je accountgegevens om in te loggen en functies te gebruiken.
# Loads environment variables from .env
load_dotenv()
connection_params = {
    "account": os.environ["SNOWFLAKE_ACCOUNT"],
    "user": os.environ["SNOWFLAKE_USER"],
    "password": os.environ["SNOWFLAKE_USER_PASSWORD"],
}
Zodra je met de variabelen verbinding hebt gemaakt, moet je een Snowflake-sessie opzetten. Dit is het object dat al je verzoeken afhandelt.
# Creates a Snowflake session

snowflake_session = Session.builder.configs(connection_params).create()Met de LLM-functies binnen Cortex AI kun je de kracht van LLM’s benutten zonder zelf AI-modellen te hoeven ontwikkelen.
Deze functies bieden de gemiddelde analytics-gebruiker AI-gestuurde analyses via enkele basistaken.
Dit zijn de functies die Snowflake Cortex heeft:
De summarize-functie wordt gebruikt om op basis van de ingevoerde tekst een samenvatting te genereren.
Hij gebruikt LLM’s om kerninformatie te identificeren en in verkorte vorm te presenteren.
Als je bijvoorbeeld een lang tekstdocument hebt en snel een overzicht van de inhoud wilt, kun je de summarize-functie gebruiken om een korte samenvatting te krijgen met de belangrijkste punten. Dit bespaart tijd en maakt snellere analyse van grote hoeveelheden data mogelijk.
De invoertaal is op het moment van schrijven beperkt tot Engels.
Zie de onderstaande code ter referentie:
# Defines the Summarize LLM Function
def summarize(user_text):
    summary = Summarize(text=user_text, session=snowflake_session)
return summaryDe translate-functie wordt gebruikt om tekst van de ene taal naar de andere om te zetten.
Hij gebruikt machinelearning-algoritmes en statistische modellen om de tekst nauwkeurig te vertalen.
Dit is handig wanneer je met data of documenten in verschillende talen werkt, omdat het communicatie en begrip vergemakkelijkt.
Als je bijvoorbeeld een rapport in het Spaans hebt en dit aan een Engelstalig publiek moet presenteren, kun je de translate-functie gebruiken om de tekst snel om te zetten. Dit maakt handmatige vertaling overbodig en bespaart tijd.
Zie de onderstaande code ter referentie:
# Defines the Translate LLM Function
def translate(user_text):
    translation = Translate(
        text=user_text, from_language="en", to_language="ko", session=snowflake_session
    )
return translationDe complete-functie is een allroundfunctie die kan worden gebruikt om specifieke taken uit te voeren. Dit gebeurt met zinsgewijze prompts die het AI-model sturen om de benodigde informatie te geven om een taak uit te voeren.
Zie de onderstaande code ter referentie:
# Defines the Complete LLM Function
def complete(user_text):
    completion = Complete(
        model="snowflake-arctic",
        prompt=f"Provide 3 relevant keywords from the following text: {user_text}",
        session=snowflake_session,
    )
return completionDe extract answer-functie geeft een antwoord op basis van de vraag die aan het model wordt gegeven. De input moet Engels zijn in een string- of JSON-formaat.
Zie de onderstaande code ter referentie:
# Defines the Extract Answer LLM Function
def extract_answer(user_text):
    answer = ExtractAnswer(
        from_text=user_text,
        question="What are some reasons why young adult South Koreans love coffee?",
        session=snowflake_session,
    )
return answerDe sentiment-functie geeft een kwantitatief getal op basis van het sentiment van de opgegeven tekst. De output is een waarde van -1 tot 1. Waarden met -1 zijn het negatiefst, 1 het positiefst en waarden rond 0 zijn neutraal.
Zie de onderstaande code ter referentie:
# Defines the Sentiment LLM Function
def sentiment(user_text):
    sentiment = Sentiment(text=user_text, session=snowflake_session)
return sentimentDe embed text-functies omvatten de EMBED_TEXT_768-functie en de EMBED_TEXT_1024-functie. Ze maken vector-embeddings van respectievelijk 768 en 1024 dimensies.
Zie de onderstaande code ter referentie voor de EMBED_TEXT_768-functie:
# Defines the Embed Text LLM Function
def embed_text(user_text):
    embed_text = EmbedText768(text=user_text, model='snowflake-arctic-embed-m', session=snowflake_session)
    return embed_text
Laten we ze nu samenvoegen in een main-functie en het met een voorbeeldtekst uitvoeren om de resultaten te bekijken.
Ik heb een eenvoudige, korte tekst gebruikt om in het model in te voeren, zoals hieronder weergegeven:
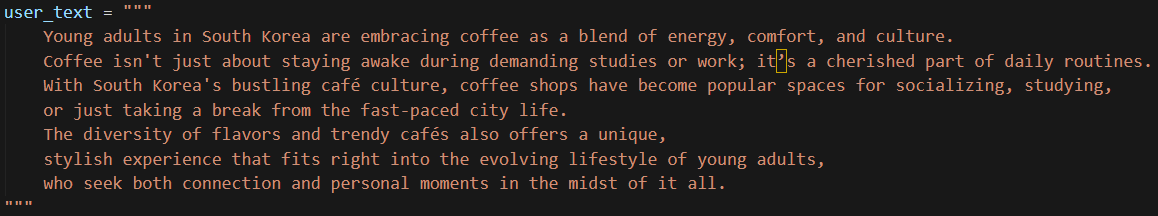
Voor het gemak van kopiëren en plakken, hier is de tekst:
user_text = """
        Young adults in South Korea are embracing coffee as a blend of energy, comfort, and culture.
        Coffee isn't just about staying awake during demanding studies or work; it’s a cherished part of daily routines.
        With South Korea's bustling café culture, coffee shops have become popular spaces for socializing, studying,
        or just taking a break from the fast-paced city life.
        The diversity of flavors and trendy cafés also offers a unique,
        stylish experience that fits right into the evolving lifestyle of young adults,
        who seek both connection and personal moments in the midst of it all.
    """
Laten we nu de code uitvoeren. Dat duurt maar een paar seconden.
Dit zijn de resultaten:
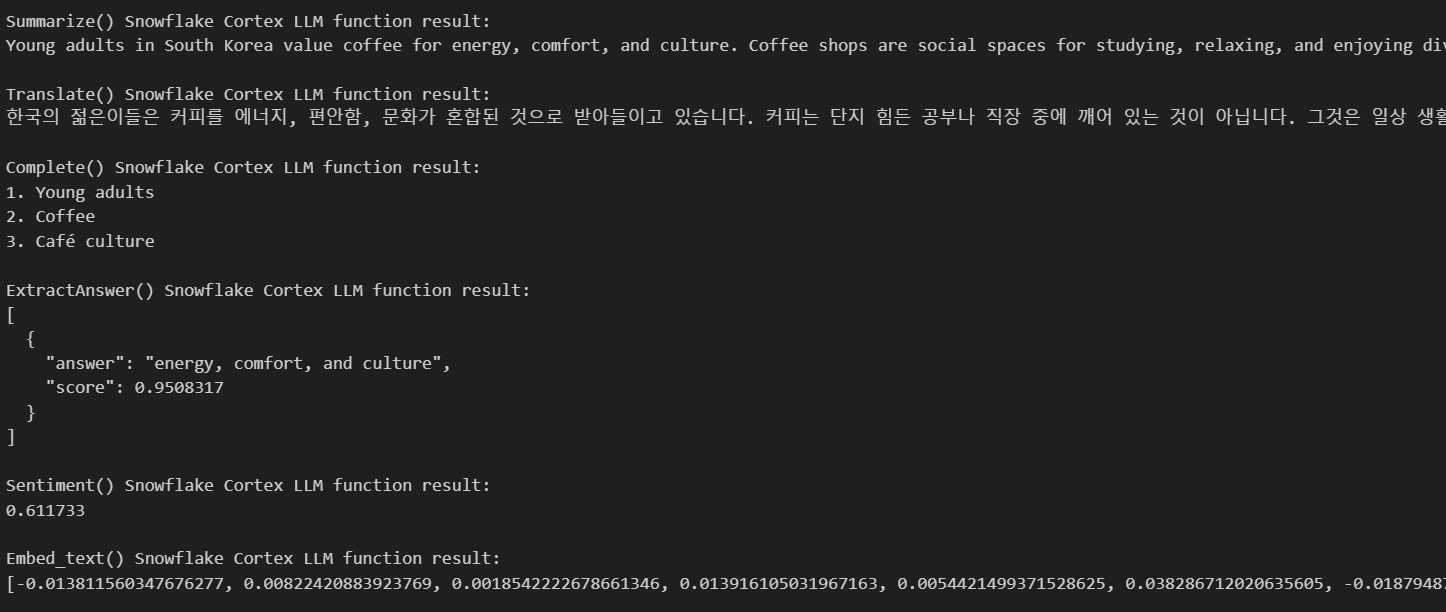
Zoals je ziet heeft de AI ons alle resultaten gegeven die we nodig hebben op basis van de tekst die we hebben aangeleverd. Het gaf een samenvatting, vertaalde mijn tekst naar het Koreaans, gaf drie trefwoorden op basis van mijn tekst en gaf antwoorden op mijn vragen.
Cortex AI heeft ook ML-functies die uitsluitend met SQL kunnen draaien. Dit zijn de verschillende functies.
Anomaliedetectie is essentieel om ongebruikelijke patronen te identificeren die niet passen bij het verwachte gedrag van je data. Snowflake vereenvoudigt anomaliedetectie met ingebouwde machinelearning-functies op basis van een gradient boosting machine (GBM), waarmee je snel uitschieters in je datasets kunt vinden.
Anomaliedetectie is vooral nuttig voor taken zoals:
Voor anomaliedetectie kun je de Snowflake-klasse ANOMALY_DETECTION (SNOWFLAKE.ML) gebruiken. Deze opdracht maakt een anomaliedetectiemodelobject aan. Deze stap past je model op de trainingsdata.
Zo kun je het gebruiken:
CREATE [ OR REPLACE ] SNOWFLAKE.ML.ANOMALY_DETECTION <model_name>(
  INPUT_DATA => <reference_to_training_data>,
  [ SERIES_COLNAME => '<series_column_name>', ]
  TIMESTAMP_COLNAME => '<timestamp_column_name>',
  TARGET_COLNAME => '<target_column_name>',
  LABEL_COLNAME => '<label_column_name>',
  [ CONFIG_OBJECT => <config_object> ]
)
[ [ WITH ] TAG ( <tag_name> = '<tag_value>' [ , <tag_name> = '<tag_value>' , ... ] ) ]
[ COMMENT = '<string_literal>' ]
Zodra je het object hebt gemaakt, kun je de methode <model_name>!DETECT_ANOMALIES gebruiken om anomaliedetectie uit te voeren,
<model_name>!DETECT_ANOMALIES(
  INPUT_DATA => <reference_to_data_to_analyze>,
  TIMESTAMP_COLNAME => '<timestamp_column_name>',
  TARGET_COLNAME => '<target_column_name>',
  [ CONFIG_OBJECT => <configuration_object>, ]
  [ SERIES_COLNAME => '<series_column_name>' ]
)
Dit is de daadwerkelijke predictiestap waarbij de uitschieters met de methode worden gedetecteerd.
Hier is een voorbeeld van anomaliedetectie met een dataset.
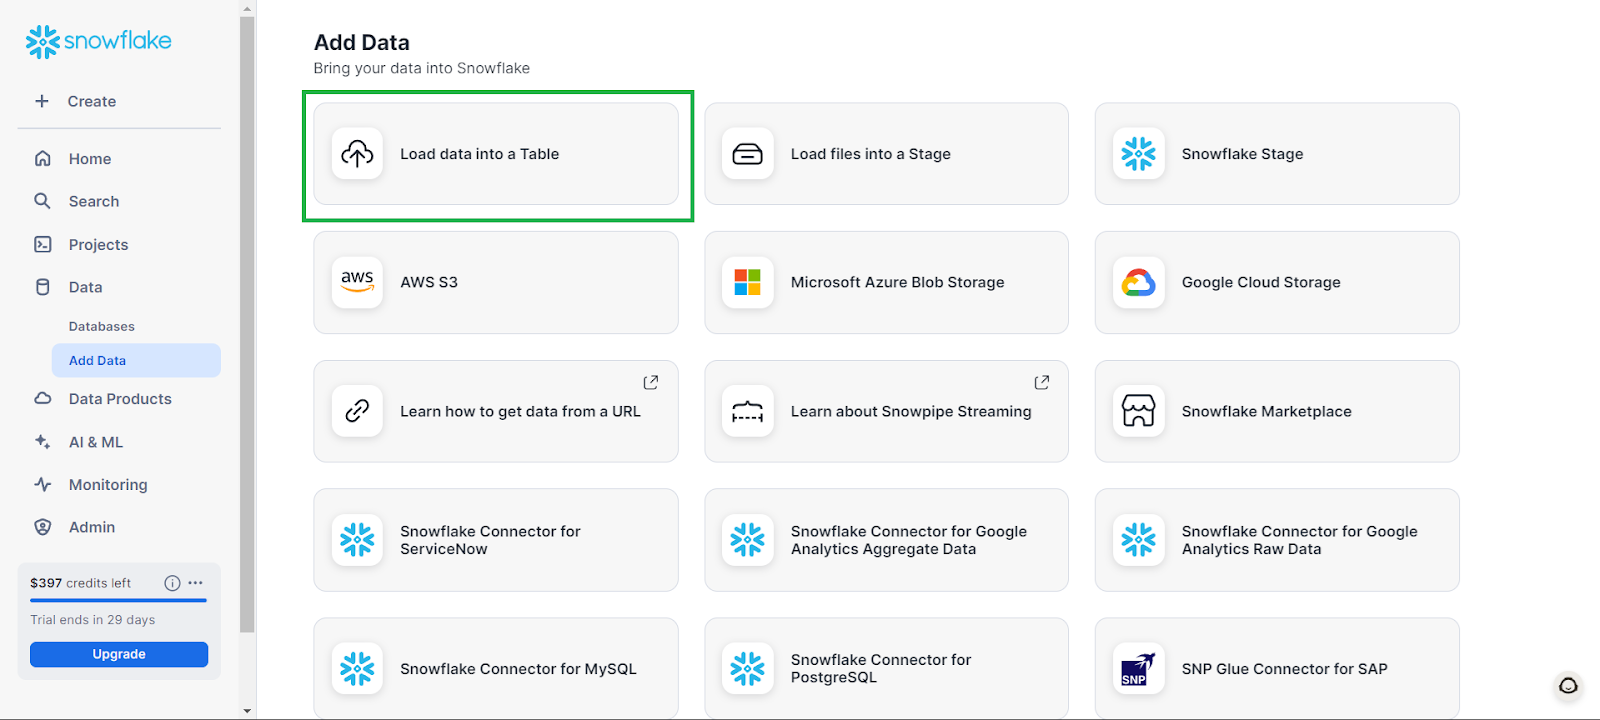
Maak eerst een database door naar Data in het linkertabblad te gaan, vervolgens Add Data en daarna Load data into a Table.
Klik in het pop-upvenster op + Database en geef je database een naam. Klik op Create en klik vervolgens in het hoofdpop-upvenster op Cancel.
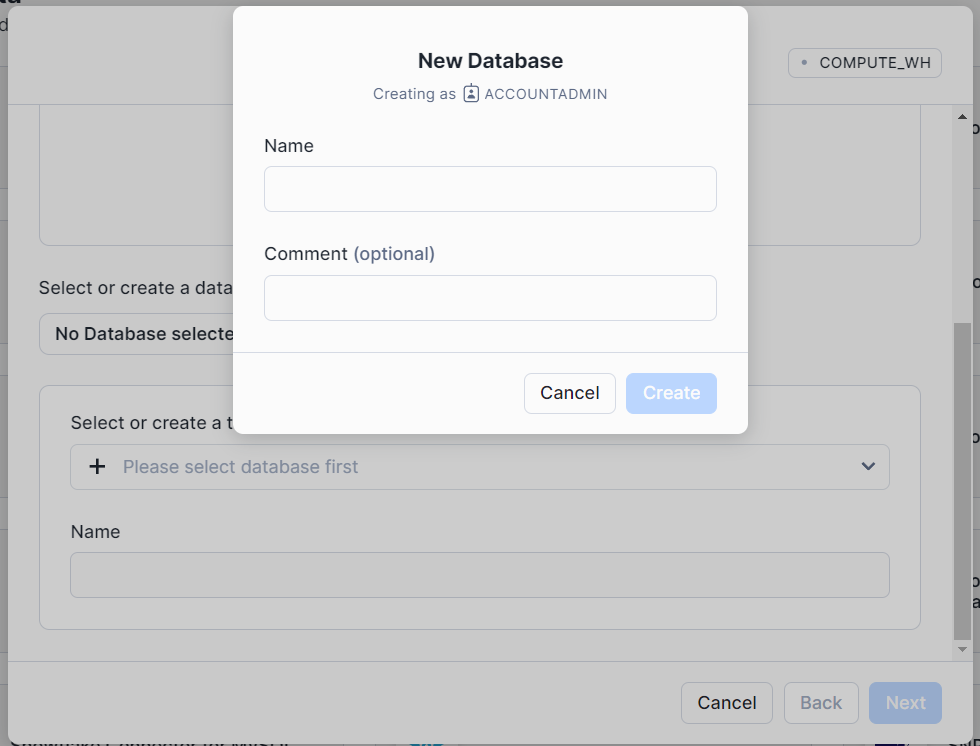
Dit maakt een lege database waar je mee kunt werken.
De onderstaande voorbeelden zijn aangepast uit de Snowflake-documentatie.
Om de anomaliedetectie te starten, ga je naar een nieuw SQL-werkblad, selecteer je je nieuwe database als gegevensbron en plak je de volgende code om een tabel te maken:
CREATE OR REPLACE TABLE historical_sales_data (
store_id NUMBER, item VARCHAR, date TIMESTAMP_NTZ, sales FLOAT, label BOOLEAN,
temperature NUMBER, humidity FLOAT, holiday VARCHAR);
// Creating the dataset
INSERT INTO historical_sales_data VALUES
  (1, 'jacket', to_timestamp_ntz('2020-01-01'), 2.0, false, 50, 0.3, 'new year'),
  (1, 'jacket', to_timestamp_ntz('2020-01-02'), 3.0, false, 52, 0.3, null),
  (1, 'jacket', to_timestamp_ntz('2020-01-03'), 5.0, false, 54, 0.2, null),
  (1, 'jacket', to_timestamp_ntz('2020-01-04'), 30.0, true, 54, 0.3, null),
  (1, 'jacket', to_timestamp_ntz('2020-01-05'), 8.0, false, 55, 0.2, null),
  (1, 'jacket', to_timestamp_ntz('2020-01-06'), 6.0, false, 55, 0.2, null),
  (1, 'jacket', to_timestamp_ntz('2020-01-07'), 4.6, false, 55, 0.2, null),
  (1, 'jacket', to_timestamp_ntz('2020-01-08'), 2.7, false, 55, 0.2, null),
  (1, 'jacket', to_timestamp_ntz('2020-01-09'), 8.6, false, 55, 0.2, null),
  (1, 'jacket', to_timestamp_ntz('2020-01-10'), 9.2, false, 55, 0.2, null),
  (1, 'jacket', to_timestamp_ntz('2020-01-11'), 4.6, false, 55, 0.2, null),
  (1, 'jacket', to_timestamp_ntz('2020-01-12'), 7.0, false, 55, 0.2, null),
  (1, 'jacket', to_timestamp_ntz('2020-01-13'), 3.6, false, 55, 0.2, null),
  (1, 'jacket', to_timestamp_ntz('2020-01-14'), 8.0, false, 55, 0.2, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-01'), 3.4, false, 50, 0.3, 'new year'),
  (2, 'umbrella', to_timestamp_ntz('2020-01-02'), 5.0, false, 52, 0.3, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-03'), 4.0, false, 54, 0.2, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-04'), 5.4, false, 54, 0.3, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-05'), 3.7, false, 55, 0.2, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-06'), 3.2, false, 55, 0.2, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-07'), 3.2, false, 55, 0.2, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-08'), 5.6, false, 55, 0.2, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-09'), 7.3, false, 55, 0.2, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-10'), 8.2, false, 55, 0.2, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-11'), 3.7, false, 55, 0.2, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-12'), 5.7, false, 55, 0.2, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-13'), 6.3, false, 55, 0.2, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-14'), 2.9, false, 55, 0.2, null);
Je code moet in een SQL-werkblad komen dat er zo uitziet:
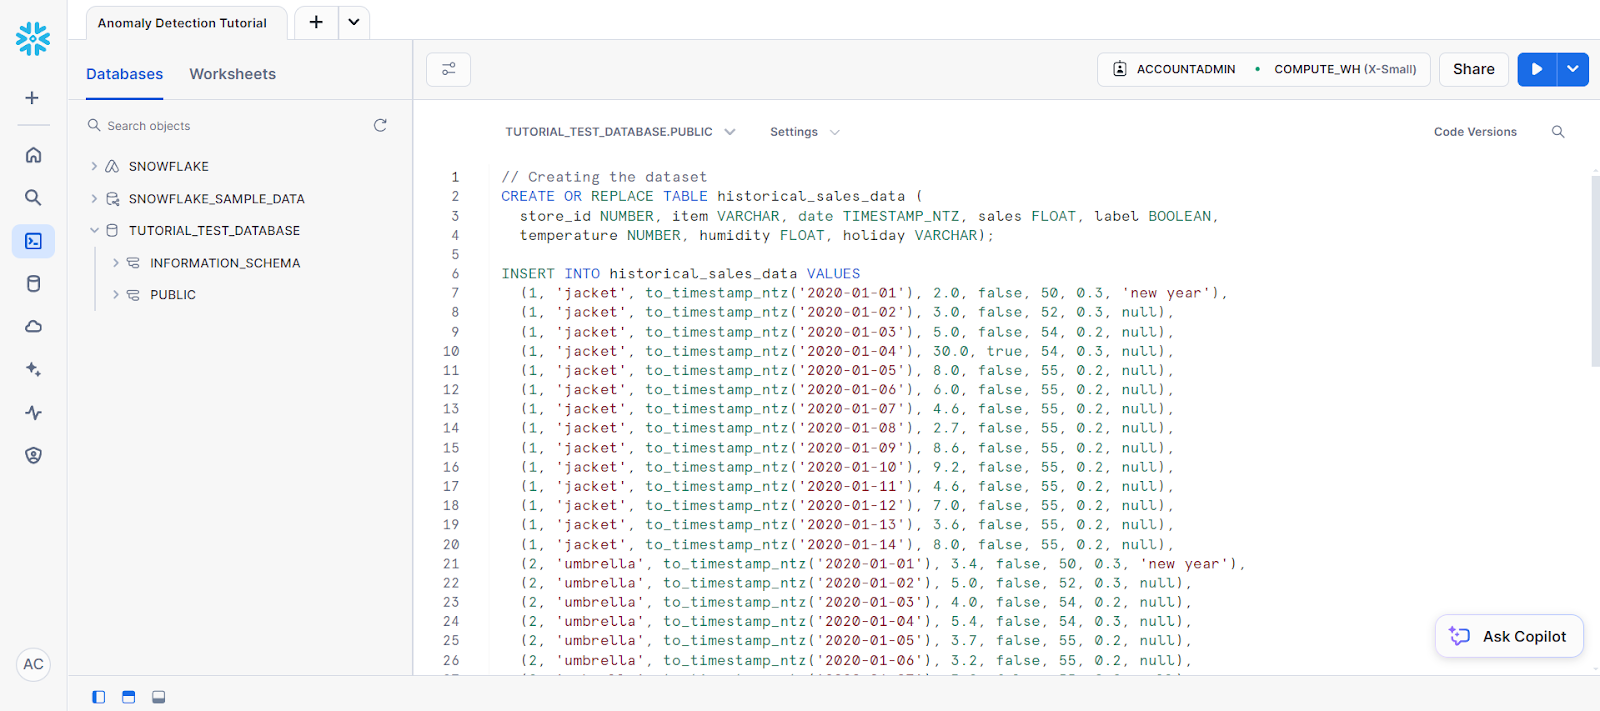
Vervolgens gebruik je de volgende statements om een tabel genaamd new_sales_data te maken.
// Creating a new table and adding training data
CREATE OR REPLACE TABLE new_sales_data (
  store_id NUMBER, item VARCHAR, date TIMESTAMP_NTZ, sales FLOAT,
  temperature NUMBER, humidity FLOAT, holiday VARCHAR);
INSERT INTO new_sales_data VALUES
  (1, 'jacket', to_timestamp_ntz('2020-01-16'), 6.0, 52, 0.3, null),
  (1, 'jacket', to_timestamp_ntz('2020-01-17'), 20.0, 53, 0.3, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-16'), 3.0, 52, 0.3, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-17'), 70.0, 53, 0.3, null);
Maak nu het anomaliedetectiemodel aan:
// Creating anomaly detection model object
CREATE OR REPLACE VIEW view_with_training_data
  AS SELECT date, sales FROM historical_sales_data
    WHERE store_id=1 AND item='jacket';
CREATE OR REPLACE SNOWFLAKE.ML.ANOMALY_DETECTION basic_model(
  INPUT_DATA => TABLE(view_with_training_data),
  TIMESTAMP_COLNAME => 'date',
  TARGET_COLNAME => 'sales',
  LABEL_COLNAME => '');
Dit zou een resultaat moeten geven dat aangeeft dat er een model is gemaakt, zoals hieronder.
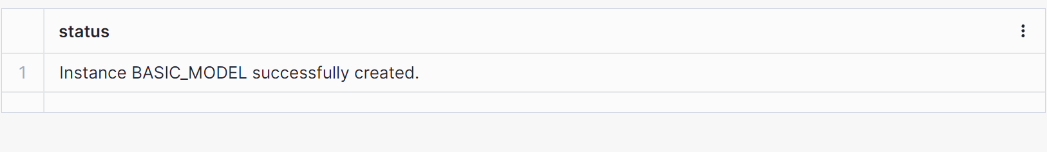
Laten we vervolgens het objectmodel gebruiken om te detecteren.
// Perform anomaly detection
CREATE OR REPLACE VIEW view_with_data_to_analyze
  AS SELECT date, sales FROM new_sales_data
    WHERE store_id=1 and item='jacket';
CALL basic_model!DETECT_ANOMALIES(
  INPUT_DATA => TABLE(view_with_data_to_analyze),
  TIMESTAMP_COLNAME =>'date',
  TARGET_COLNAME => 'sales'
);
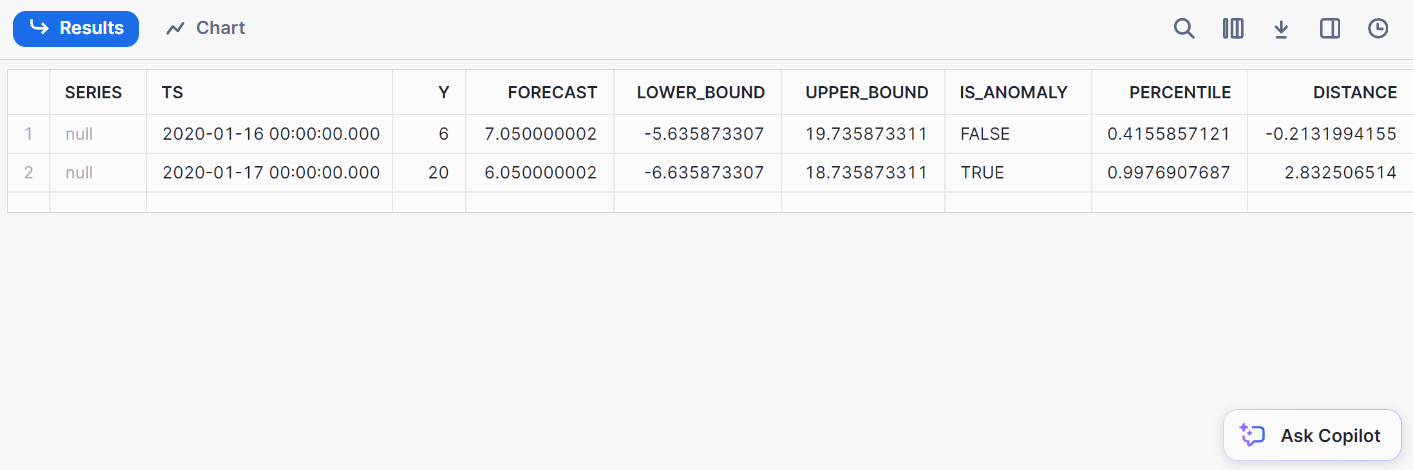
Dit is de output van de detectie:
Classificatie betekent het indelen van data in vooraf gedefinieerde klassen. Met Snowflake kun je data rechtstreeks binnen Snowflake classificeren, zonder data naar externe ML-omgevingen te exporteren.
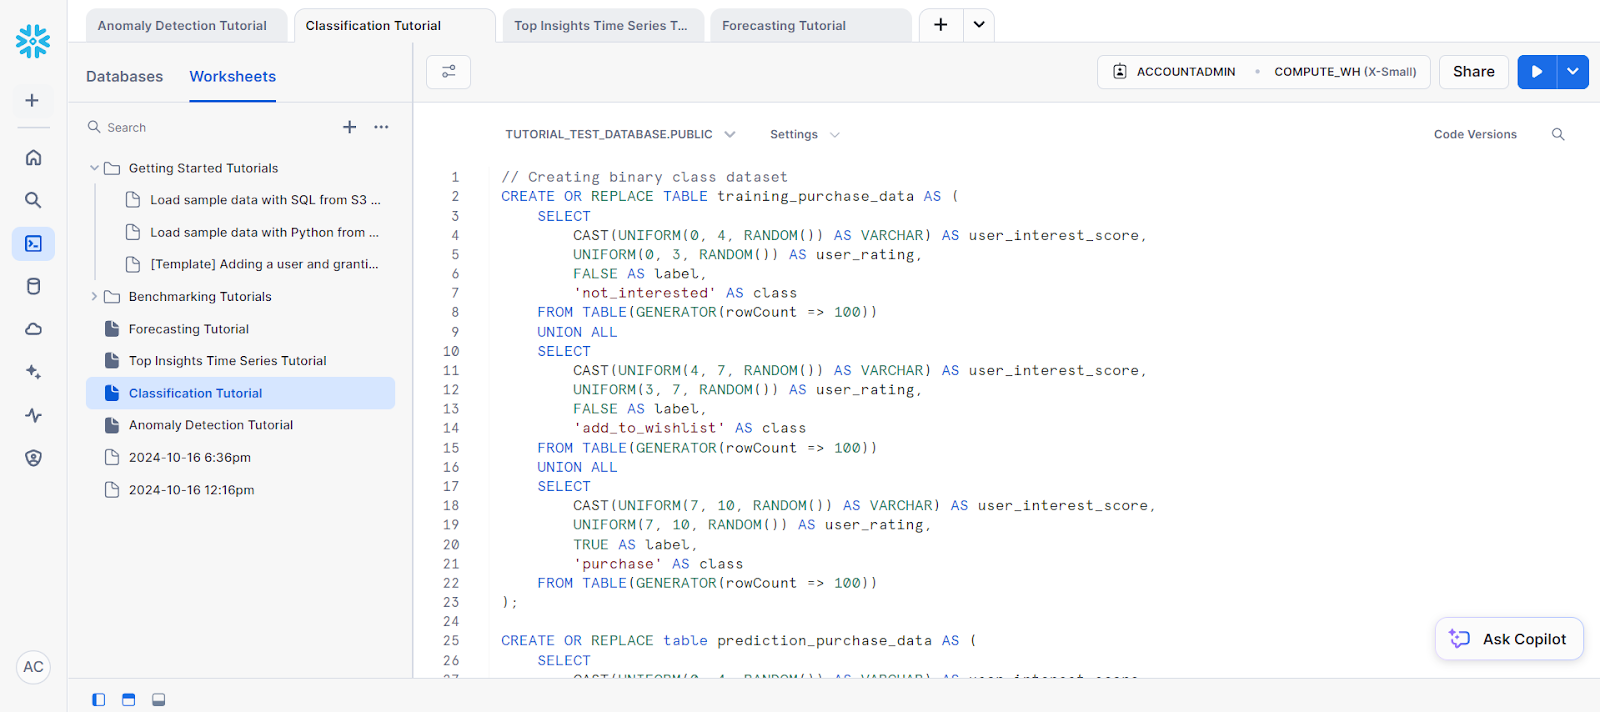
Maak om te beginnen een voorbeelddataset met de volgende code:
// Creating binary class dataset
CREATE OR REPLACE TABLE training_purchase_data AS (
    SELECT
        CAST(UNIFORM(0, 4, RANDOM()) AS VARCHAR) AS user_interest_score,
        UNIFORM(0, 3, RANDOM()) AS user_rating,
        FALSE AS label,
        'not_interested' AS class
    FROM TABLE(GENERATOR(rowCount => 100))
    UNION ALL
    SELECT
        CAST(UNIFORM(4, 7, RANDOM()) AS VARCHAR) AS user_interest_score,
        UNIFORM(3, 7, RANDOM()) AS user_rating,
        FALSE AS label,
        'add_to_wishlist' AS class
    FROM TABLE(GENERATOR(rowCount => 100))
    UNION ALL
    SELECT
        CAST(UNIFORM(7, 10, RANDOM()) AS VARCHAR) AS user_interest_score,
        UNIFORM(7, 10, RANDOM()) AS user_rating,
        TRUE AS label,
        'purchase' AS class
    FROM TABLE(GENERATOR(rowCount => 100))
);
CREATE OR REPLACE table prediction_purchase_data AS (
    SELECT
        CAST(UNIFORM(0, 4, RANDOM()) AS VARCHAR) AS user_interest_score,
        UNIFORM(0, 3, RANDOM()) AS user_rating
    FROM TABLE(GENERATOR(rowCount => 100))
    UNION ALL
    SELECT
        CAST(UNIFORM(4, 7, RANDOM()) AS VARCHAR) AS user_interest_score,
        UNIFORM(3, 7, RANDOM()) AS user_rating
    FROM TABLE(GENERATOR(rowCount => 100))
    UNION ALL
    SELECT
        CAST(UNIFORM(7, 10, RANDOM()) AS VARCHAR) AS user_interest_score,
        UNIFORM(7, 10, RANDOM()) AS user_rating
    FROM TABLE(GENERATOR(rowCount => 100))
);
Maak voor de trainingsdata een nieuwe view.
// Creating view for training data
CREATE OR REPLACE view binary_classification_view AS
    SELECT user_interest_score, user_rating, label
FROM training_purchase_data;
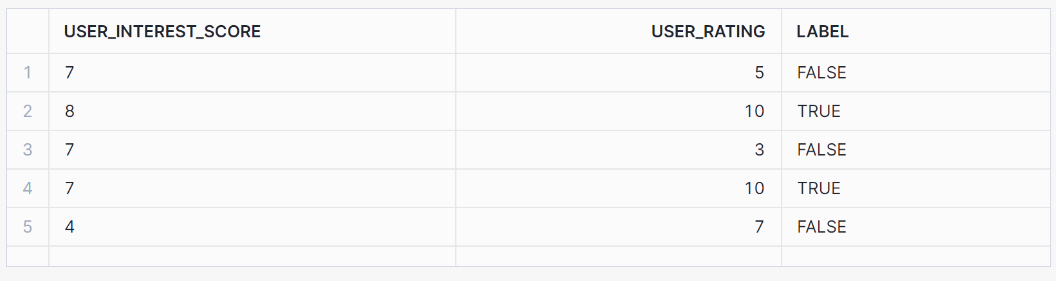
SELECT * FROM binary_classification_view ORDER BY RANDOM(42) LIMIT 5;
Deze view zou de volgende resultaten moeten geven:
Laten we vervolgens het model trainen op basis van onze trainingsdata:
// Training a binary classification model
CREATE OR REPLACE SNOWFLAKE.ML.CLASSIFICATION model_binary(
    INPUT_DATA => SYSTEM$REFERENCE('view', 'binary_classification_view'),
    TARGET_COLNAME => 'label'
);
Gebruik voor classificatie de PREDICT-methode:
// Performing prediction using PREDICT method
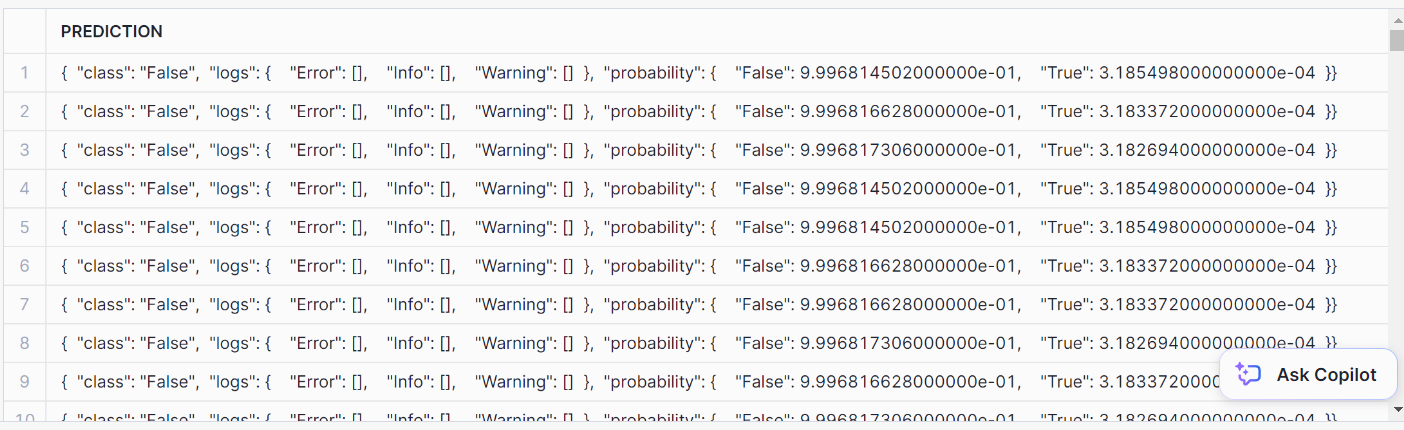
SELECT model_binary!PREDICT(INPUT_DATA => {*})
    AS prediction FROM prediction_purchase_data;
Zo ziet de voorspelling eruit:
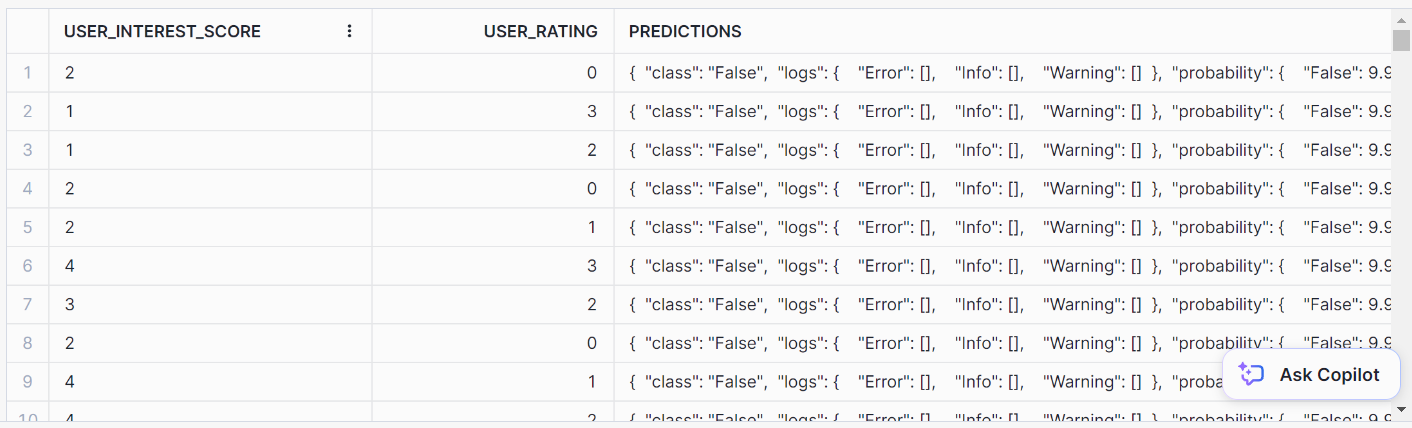
Gebruik deze SQL-instructie om het netjes te formatteren:
// Formatting SQL predictions
SELECT *, model_binary!PREDICT(INPUT_DATA => {*})
    AS predictions FROM prediction_purchase_data;
Je zou op dit nette uitvoerformaat voor de voorspellingen moeten uitkomen:
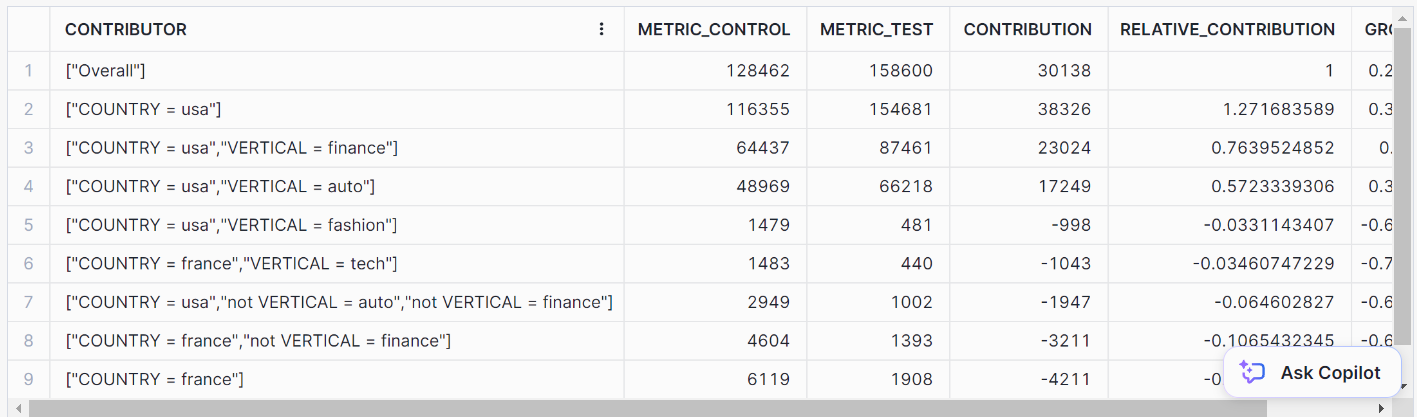
Top Insights is een monitoringtool om te zoeken naar fluctuaties in je metriek in de tijd via tijdreeksanalyse. Met een beslisboommodel kan Top Insights de belangrijkste factoren identificeren die bijdragen aan een stijging of daling van een bepaalde metriek.
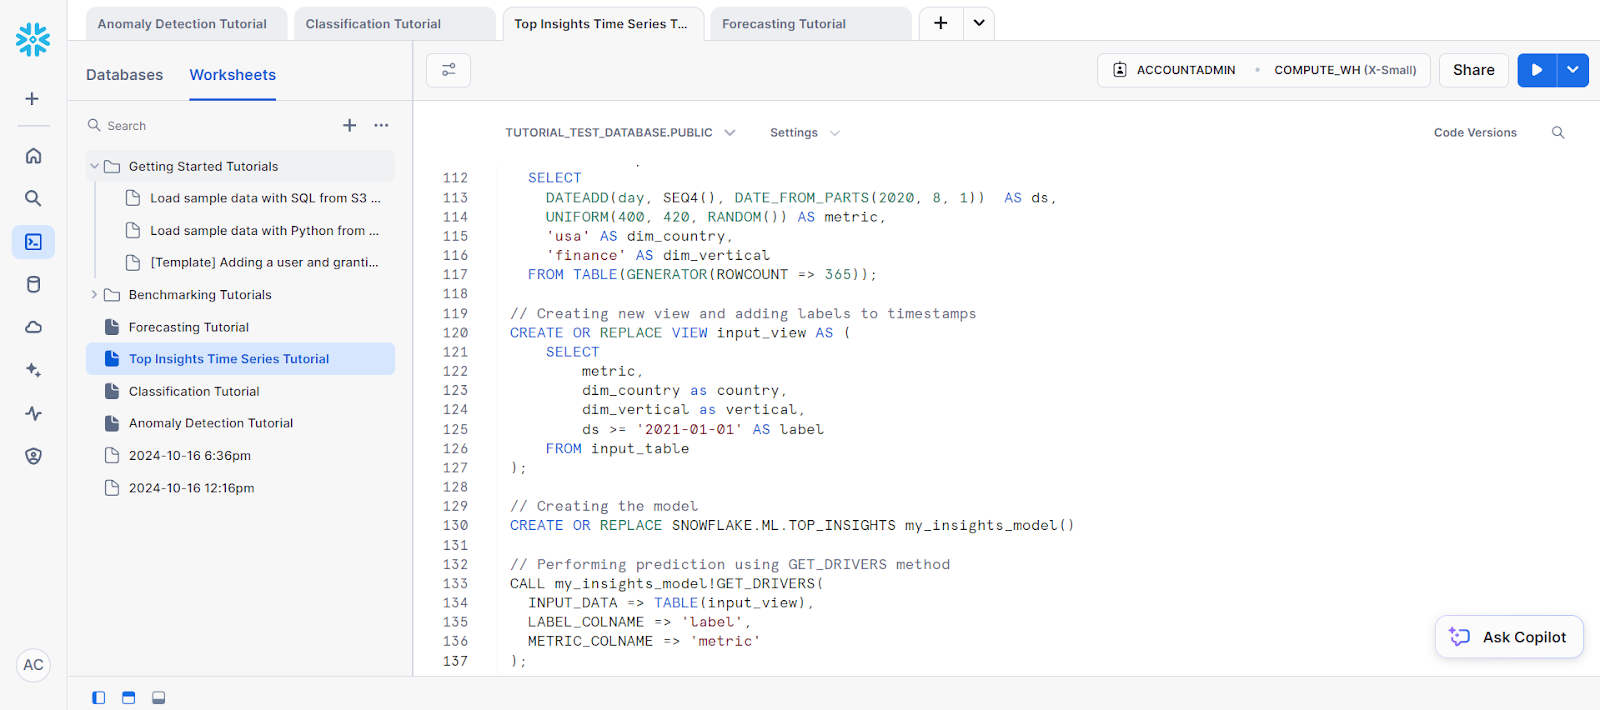
Laten we een voorbeeld bekijken van een tijdreeksanalyse met deze functie.
Laten we eerst een dataset maken:
// Creating dataset
CREATE OR REPLACE TABLE input_table(
  ds DATE, metric NUMBER, dim_country VARCHAR, dim_vertical VARCHAR);
INSERT INTO input_table
  SELECT
    DATEADD(day, SEQ4(), DATE_FROM_PARTS(2020, 4, 1)) AS ds,
    UNIFORM(1, 10, RANDOM()) AS metric,
    'usa' AS dim_country,
    'tech' AS dim_vertical
  FROM TABLE(GENERATOR(ROWCOUNT => 365));
INSERT INTO input_table
  SELECT
    DATEADD(day, SEQ4(), DATE_FROM_PARTS(2020, 4, 1)) AS ds,
    UNIFORM(1, 10, RANDOM()) AS metric,
    'usa' AS dim_country,
    'auto' AS dim_vertical
  FROM TABLE(GENERATOR(ROWCOUNT => 365));
INSERT INTO input_table
  SELECT
    DATEADD(day, seq4(), DATE_FROM_PARTS(2020, 4, 1)) AS ds,
    UNIFORM(1, 10, RANDOM()) AS metric,
    'usa' AS dim_country,
    'fashion' AS dim_vertical
  FROM TABLE(GENERATOR(ROWCOUNT => 365));
INSERT INTO input_table
  SELECT
    DATEADD(day, SEQ4(), DATE_FROM_PARTS(2020, 4, 1)) AS ds,
    UNIFORM(1, 10, RANDOM()) AS metric,
    'usa' AS dim_country,
    'finance' AS dim_vertical
  FROM TABLE(GENERATOR(ROWCOUNT => 365));
INSERT INTO input_table
  SELECT
    DATEADD(day, SEQ4(), DATE_FROM_PARTS(2020, 4, 1)) AS ds,
    UNIFORM(1, 10, RANDOM()) AS metric,
    'canada' AS dim_country,
    'fashion' AS dim_vertical
  FROM TABLE(GENERATOR(ROWCOUNT => 365));
INSERT INTO input_table
  SELECT
    DATEADD(day, SEQ4(), DATE_FROM_PARTS(2020, 4, 1)) AS ds,
    UNIFORM(1, 10, RANDOM()) AS metric,
    'canada' AS dim_country,
    'finance' AS dim_vertical
  FROM TABLE(GENERATOR(ROWCOUNT => 365));
INSERT INTO input_table
  SELECT
    DATEADD(day, SEQ4(), DATE_FROM_PARTS(2020, 4, 1)) AS ds,
    UNIFORM(1, 10, RANDOM()) AS metric,
    'canada' AS dim_country,
    'tech' AS dim_vertical
  FROM TABLE(GENERATOR(ROWCOUNT => 365));
INSERT INTO input_table
  SELECT
    DATEADD(day, SEQ4(), DATE_FROM_PARTS(2020, 4, 1)) AS ds,
    UNIFORM(1, 10, RANDOM()) AS metric,
    'canada' AS dim_country,
    'auto' AS dim_vertical
  FROM TABLE(GENERATOR(ROWCOUNT => 365));
INSERT INTO input_table
  SELECT
    DATEADD(day, SEQ4(), DATE_FROM_PARTS(2020, 4, 1)) AS ds,
    UNIFORM(1, 10, RANDOM()) AS metric,
    'france' AS dim_country,
    'fashion' AS dim_vertical
  FROM TABLE(GENERATOR(ROWCOUNT => 365));
INSERT INTO input_table
  SELECT
    DATEADD(day, SEQ4(), DATE_FROM_PARTS(2020, 4, 1)) AS ds,
    UNIFORM(1, 10, RANDOM()) AS metric,
    'france' AS dim_country,
    'finance' AS dim_vertical
  FROM TABLE(GENERATOR(ROWCOUNT => 365));
INSERT INTO input_table
  SELECT
    DATEADD(day, SEQ4(), DATE_FROM_PARTS(2020, 4, 1)) AS ds,
    UNIFORM(1, 10, RANDOM()) AS metric,
    'france' AS dim_country,
    'tech' AS dim_vertical
  FROM TABLE(GENERATOR(ROWCOUNT => 365));
INSERT INTO input_table
  SELECT
    DATEADD(day, SEQ4(), DATE_FROM_PARTS(2020, 4, 1)) AS ds,
    UNIFORM(1, 10, RANDOM()) AS metric,
    'france' AS dim_country,
    'auto' AS dim_vertical
  FROM TABLE(GENERATOR(ROWCOUNT => 365));
-- Data for the test group
INSERT INTO input_table
  SELECT
    DATEADD(day, SEQ4(), DATE_FROM_PARTS(2020, 8, 1)) AS ds,
    UNIFORM(300, 320, RANDOM()) AS metric,
    'usa' AS dim_country,
    'auto' AS dim_vertica
  FROM TABLE(GENERATOR(ROWCOUNT => 365));
INSERT INTO input_table
  SELECT
    DATEADD(day, SEQ4(), DATE_FROM_PARTS(2020, 8, 1))  AS ds,
    UNIFORM(400, 420, RANDOM()) AS metric,
    'usa' AS dim_country,
    'finance' AS dim_vertical
  FROM TABLE(GENERATOR(ROWCOUNT => 365));
// Creating new view and adding labels to timestamps
CREATE OR REPLACE VIEW input_view AS (
    SELECT
        metric,
        dim_country as country,
        dim_vertical as vertical,
        ds >= '2021-01-01' AS label
    FROM input_table
);
Vervolgens moeten we het modelobject voor de voorspelling maken. Dit is nodig om de GET_DRIVERS-methode te gebruiken.
// Creating the model
CREATE OR REPLACE SNOWFLAKE.ML.TOP_INSIGHTS my_insights_model()
Roep tot slot voor de voorspelling de GET_DRIVERS-methode aan.
// Performing prediction using GET_DRIVERS method
CALL my_insights_model!GET_DRIVERS(
  INPUT_DATA => TABLE(input_view),
  LABEL_COLNAME => 'label',
  METRIC_COLNAME => 'metric'
);
Dit zou de volgende resultaten moeten geven:
Forecasting is cruciaal wanneer je toekomstige waarden wilt voorspellen op basis van historische data. Of het nu gaat om verkoopprognoses, het voorspellen van energieverbruik of het voorspellen van webverkeer, de ingebouwde functies van Snowflake maken deze taken een stuk eenvoudiger.
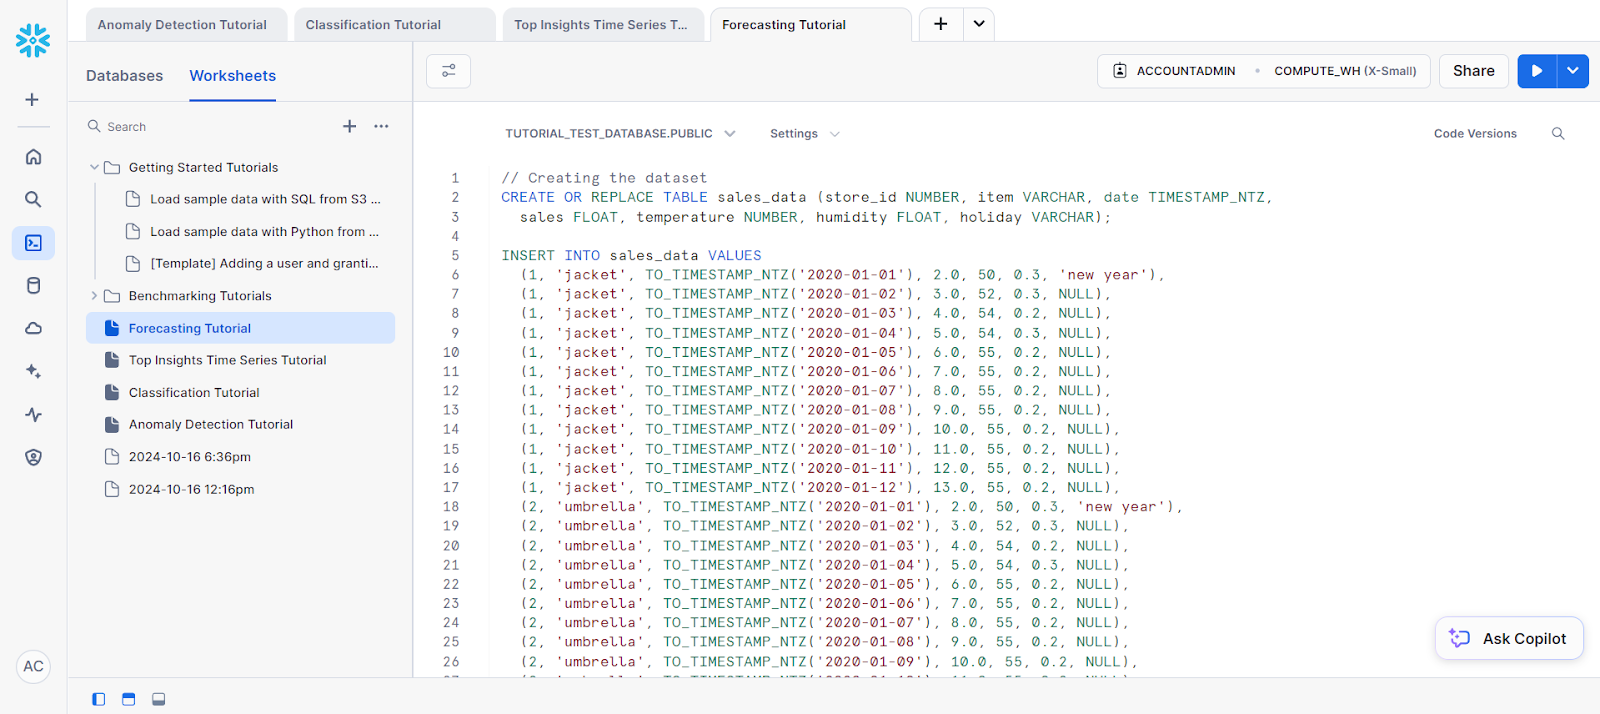
Voor ons voorbeeld bekijken we forecasting op een enkele serie:
// Creating the dataset
CREATE OR REPLACE TABLE sales_data (store_id NUMBER, item VARCHAR, date TIMESTAMP_NTZ,
  sales FLOAT, temperature NUMBER, humidity FLOAT, holiday VARCHAR);
INSERT INTO sales_data VALUES
  (1, 'jacket', TO_TIMESTAMP_NTZ('2020-01-01'), 2.0, 50, 0.3, 'new year'),
  (1, 'jacket', TO_TIMESTAMP_NTZ('2020-01-02'), 3.0, 52, 0.3, NULL),
  (1, 'jacket', TO_TIMESTAMP_NTZ('2020-01-03'), 4.0, 54, 0.2, NULL),
  (1, 'jacket', TO_TIMESTAMP_NTZ('2020-01-04'), 5.0, 54, 0.3, NULL),
  (1, 'jacket', TO_TIMESTAMP_NTZ('2020-01-05'), 6.0, 55, 0.2, NULL),
  (1, 'jacket', TO_TIMESTAMP_NTZ('2020-01-06'), 7.0, 55, 0.2, NULL),
  (1, 'jacket', TO_TIMESTAMP_NTZ('2020-01-07'), 8.0, 55, 0.2, NULL),
  (1, 'jacket', TO_TIMESTAMP_NTZ('2020-01-08'), 9.0, 55, 0.2, NULL),
  (1, 'jacket', TO_TIMESTAMP_NTZ('2020-01-09'), 10.0, 55, 0.2, NULL),
  (1, 'jacket', TO_TIMESTAMP_NTZ('2020-01-10'), 11.0, 55, 0.2, NULL),
  (1, 'jacket', TO_TIMESTAMP_NTZ('2020-01-11'), 12.0, 55, 0.2, NULL),
  (1, 'jacket', TO_TIMESTAMP_NTZ('2020-01-12'), 13.0, 55, 0.2, NULL),
  (2, 'umbrella', TO_TIMESTAMP_NTZ('2020-01-01'), 2.0, 50, 0.3, 'new year'),
  (2, 'umbrella', TO_TIMESTAMP_NTZ('2020-01-02'), 3.0, 52, 0.3, NULL),
  (2, 'umbrella', TO_TIMESTAMP_NTZ('2020-01-03'), 4.0, 54, 0.2, NULL),
  (2, 'umbrella', TO_TIMESTAMP_NTZ('2020-01-04'), 5.0, 54, 0.3, NULL),
  (2, 'umbrella', TO_TIMESTAMP_NTZ('2020-01-05'), 6.0, 55, 0.2, NULL),
  (2, 'umbrella', TO_TIMESTAMP_NTZ('2020-01-06'), 7.0, 55, 0.2, NULL),
  (2, 'umbrella', TO_TIMESTAMP_NTZ('2020-01-07'), 8.0, 55, 0.2, NULL),
  (2, 'umbrella', TO_TIMESTAMP_NTZ('2020-01-08'), 9.0, 55, 0.2, NULL),
  (2, 'umbrella', TO_TIMESTAMP_NTZ('2020-01-09'), 10.0, 55, 0.2, NULL),
  (2, 'umbrella', TO_TIMESTAMP_NTZ('2020-01-10'), 11.0, 55, 0.2, NULL),
  (2, 'umbrella', TO_TIMESTAMP_NTZ('2020-01-11'), 12.0, 55, 0.2, NULL),
  (2, 'umbrella', TO_TIMESTAMP_NTZ('2020-01-12'), 13.0, 55, 0.2, NULL);
-- Future values for additional columns (features)
CREATE OR REPLACE TABLE future_features (store_id NUMBER, item VARCHAR,
  date TIMESTAMP_NTZ, temperature NUMBER, humidity FLOAT, holiday VARCHAR);
INSERT INTO future_features VALUES
  (1, 'jacket', TO_TIMESTAMP_NTZ('2020-01-13'), 52, 0.3, NULL),
  (1, 'jacket', TO_TIMESTAMP_NTZ('2020-01-14'), 53, 0.3, NULL),
  (2, 'umbrella', TO_TIMESTAMP_NTZ('2020-01-13'), 52, 0.3, NULL),
  (2, 'umbrella', TO_TIMESTAMP_NTZ('2020-01-14'), 53, 0.3, NULL);
Laten we vervolgens de trainingsdata van de dataset scheiden.
// Creating a view for training data
CREATE OR REPLACE VIEW v1 AS SELECT date, sales
  FROM sales_data WHERE store_id=1 AND item='jacket';
SELECT * FROM v1;
Voordat je met forecasting kunt beginnen, moet je je model trainen op basis van de geselecteerde trainingsdata.
Zo doe je dat:
// Training a forecasting model
CREATE SNOWFLAKE.ML.FORECAST model1(
  INPUT_DATA => TABLE(v1),
  TIMESTAMP_COLNAME => 'date',
  TARGET_COLNAME => 'sales'
);
Roep tot slot voor de forecast de FORECAST-methode aan om de predictiestap te doen.
// Performing the forecast by calling the FORECAST method
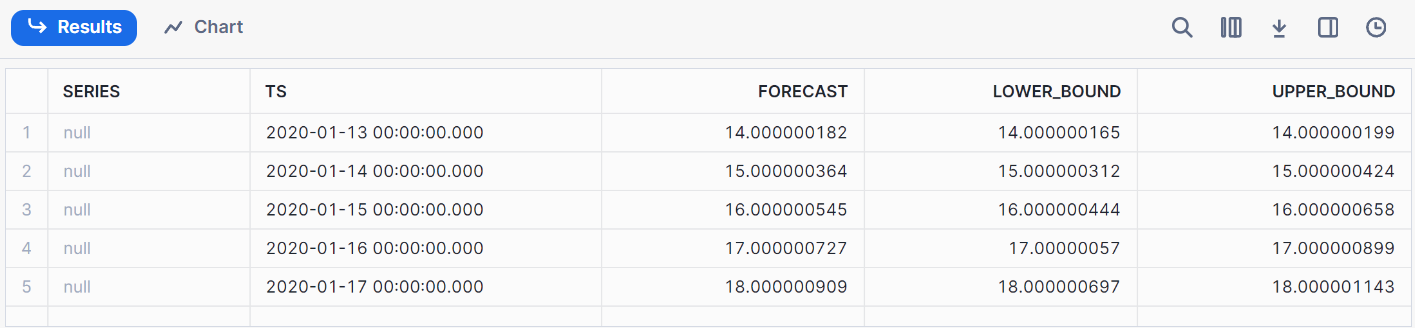
call model1!FORECAST(FORECASTING_PERIODS => 5);
Dit is de resulterende output van onze forecasting.
Het monitoren van modelprestaties kan met dashboards in Snowflake via integraties van derden (zoals Tableau) of door Snowflake-logs te bevragen. Nuttige metrics zoals accuracy, precision en recall kunnen worden gebruikt om modellen te volgen.
Snowflake Cortex AI vereenvoudigt machine learning door naadloze integratie van modellen vanuit het Snowflake-platform mogelijk te maken. Deze tutorial leidde je door het gebruik van Snowflake Cortex AI en Snowflake Cortex ML-functies.
Deze oplossing benut de schaalbaarheid van Snowflake en de flexibiliteit van Python, wat het ideaal maakt voor organisaties die machine learning willen implementeren zonder data buiten de cloud te verplaatsen.
Op zoek naar meer bronnen over Snowflake? Dan vind je onze Snowflake Beginner Tutorial en onze Snowpark-gids vast interessant. Zoek je iets uitgebreiders, dan is de Introduction to Snowflake-cursus misschien iets voor jou.
Top DataCamp Courses
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min

