
Corso
Introduzione a Snowflake SQL
2 ore
57.7K
L’addestramento di modelli di IA è in crescita come una delle applicazioni potenziali dell’IA nella data science. Più nello specifico, il machine learning può essere eseguito usando Snowflake Cortex AI.
In questa guida vedremo cos’è Snowflake Cortex AI e cosa può fare. Inoltre, forniremo un semplice tutorial su come iniziare con machine learning e IA usando Python e un po’ di SQL. Se sei alle prime armi con Snowflake, dai un’occhiata al nostro corso Introduction to Snowflake per metterti in pari.
Snowflake Cortex AI è una potente funzionalità integrata nello Snowflake AI Data Cloud, progettata per facilitare le operazioni di machine learning (ML) direttamente all’interno dell’ambiente Snowflake.
Consente l’integrazione senza soluzione di continuità dei modelli ML in Python con i dati in Snowflake, permettendo alle organizzazioni di ottenere insight, previsioni e analytics avanzate su grandi dataset sfruttando l’infrastruttura cloud.
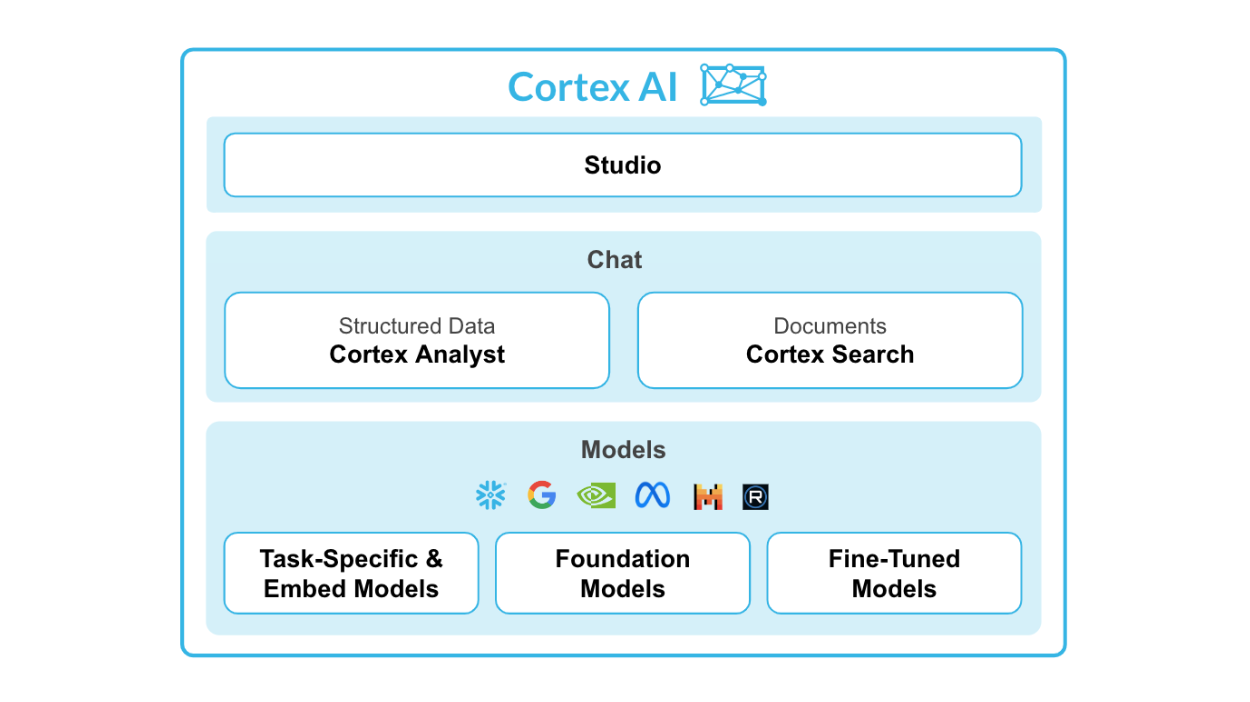
Fonte: Snowflake Cortex AI
Funzionalità chiave di Snowflake Cortex AI:
Snowflake Cortex si compone di due parti principali: funzioni LLM e funzioni ML.
Per le funzioni LLM, hai:
Vedremo ciascuna funzione più nel dettaglio più avanti.
Per le funzioni ML, hai:
Vuoi sapere dove imparare Snowflake e le sue funzioni? Il nostro Tutorial su Snowflake per principianti e la guida alle certificazioni Snowflake ti saranno utili.
Vediamo ora i vantaggi di usare insieme questi strumenti.
Alcuni benefici chiave nell’uso di Snowflake Cortex AI sono:
Innanzitutto, Snowflake Cortex AI è perfetto per le aziende che vogliono migliorare le proprie capacità di data science senza investimenti significativi in risorse. Con il suo ambiente no-code, anche gli utenti non tecnici possono sviluppare e distribuire facilmente modelli ML.
Questo è particolarmente utile per piccole aziende o startup che potrebbero non avere il budget per assumere un team di data scientist o investire in LLM costosi.
In secondo luogo, integrando Python nell’ambiente di calcolo di Snowflake, gli utenti possono sfruttare l’ampia libreria di algoritmi e strumenti di machine learning disponibili in Python. Significa poter creare modelli più avanzati e accurati senza dover imparare nuovi linguaggi di programmazione.
Infine, le aziende che hanno già adottato l’ambiente Snowflake trarranno il massimo beneficio da Cortex AI, poiché si integra perfettamente con il loro data warehouse esistente, eliminando la necessità di ulteriore infrastruttura o migrazioni di dati.
Con Snowflake Cortex AI, le aziende possono implementare facilmente ed efficientemente il machine learning nei propri processi.
In questo tutorial, passeremo attraverso la configurazione di una pipeline di machine learning usando Python e Snowflake Cortex AI.
Prima di iniziare a lavorare con l’ML in Snowflake Cortex AI, assicurati di soddisfare i seguenti requisiti:
Per prima cosa, ti servirà un’istanza Snowflake in cui i tuoi dati siano archiviati ed elaborati. Puoi registrarti sul sito Snowflake.
Nel modulo di registrazione, compila tutti i dettagli dell’account e presta attenzione a fare le seguenti selezioni nella seconda pagina. Seleziona Standard edition per questo tutorial e Amazon Web Services per semplicità e riproducibilità. Per il server, scegli US West (Oregon) per la migliore selezione di funzioni LLM disponibili.
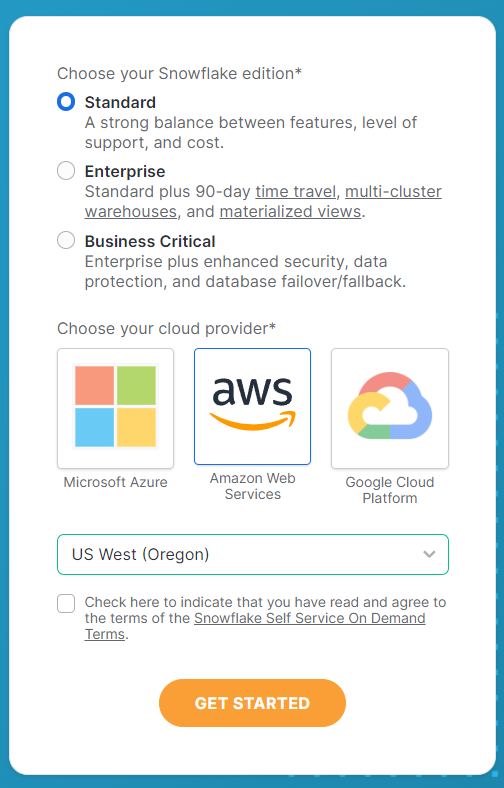
Una volta selezionate queste opzioni, clicca su Get Started per ricevere l’email di attivazione. Vai alla tua casella di posta per attivare l’account e il tuo account Snowflake sarà pronto all’uso.
Successivamente, dovrai anche soddisfare alcuni altri requisiti software.
Ecco un semplice elenco di elementi da avere:
Prima di iniziare qualsiasi analisi, installa tutti i pacchetti rilevanti così il tuo ambiente di coding sarà pronto.
Per installare i pacchetti necessari, puoi usare pip:
pip install snowflakepip install python-dotenvDopo aver installato le librerie, dovrai impostare la cartella e i file di lavoro per iniziare.
Ho creato una cartella chiamata Cortex AI Tutorial e incluso un file .env con le seguenti informazioni:
SNOWFLAKE_ACCOUNT = "<YOUR_ACCOUNT>" # eg. XXXX-XXXX

SNOWFLAKE_USER = "<YOUR_USER>"

SNOWFLAKE_USER_PASSWORD = "<YOUR_PASSWORD>"
Dopo aver inserito le informazioni del tuo account, salva il file e crea un file Python o un Jupyter Notebook nella stessa cartella.
Ora che è tutto pronto, colleghiamo il tuo ambiente Python a Snowflake.
Per iniziare, apri il tuo file Python e importa tutte le librerie necessarie. Ecco il codice:
import os
from dotenv import load_dotenv
from snowflake.snowpark import Session
from snowflake.cortex import Summarize, Complete, ExtractAnswer, Sentiment, Translate, EmbedText768
Poi, carica le variabili che hai salvato nel file .env salvato in precedenza. Questo fornirà a Snowflake le tue credenziali per accedere e usare le loro funzioni.
# Loads environment variables from .env
load_dotenv()
connection_params = {
    "account": os.environ["SNOWFLAKE_ACCOUNT"],
    "user": os.environ["SNOWFLAKE_USER"],
    "password": os.environ["SNOWFLAKE_USER_PASSWORD"],
}
Dopo esserti connesso usando le variabili, devi impostare una sessione Snowflake. Questo è l’oggetto che gestirà tutte le tue richieste.
# Creates a Snowflake session

snowflake_session = Session.builder.configs(connection_params).create()Le funzioni LLM in Cortex AI consentono di sfruttare il potenziale dei LLM senza dover sviluppare modelli di IA propri.
Queste funzioni forniscono all’utente medio di analytics analisi potenziate dall’IA attraverso alcuni compiti di base.
Ecco le funzioni presenti in Snowflake Cortex:
La funzione summarize viene usata per generare un riassunto dei dati in base all’input fornito.
Utilizza LLM per individuare le informazioni chiave e presentarle in formato condensato.
Ad esempio, se hai un lungo documento di testo e vuoi una panoramica rapida dei contenuti, puoi usare la funzione summarize per ottenere un breve sommario che catturi i punti importanti. Questo fa risparmiare tempo e consente un’analisi più rapida di grandi quantità di dati.
Al momento della stesura di questo articolo, la lingua di input è limitata all’inglese.
Vedi il codice qui sotto come riferimento:
# Defines the Summarize LLM Function
def summarize(user_text):
    summary = Summarize(text=user_text, session=snowflake_session)
return summaryLa funzione translate viene usata per convertire il testo da una lingua a un’altra.
Fa uso di algoritmi di machine learning e modelli statistici per tradurre il testo con precisione.
Può essere utile quando si lavora con dati o documenti in lingue diverse, poiché consente una comunicazione e una comprensione più agevoli.
Per esempio, se hai un report scritto in spagnolo e devi presentarlo a un pubblico anglofono, puoi usare la funzione translate per convertire rapidamente il testo. Questo elimina la necessità di una traduzione manuale e fa risparmiare tempo.
Vedi il codice qui sotto come riferimento:
# Defines the Translate LLM Function
def translate(user_text):
    translation = Translate(
        text=user_text, from_language="en", to_language="ko", session=snowflake_session
    )
return translationLa funzione complete è una funzione tuttofare che può essere usata per eseguire compiti specifici. Questo avviene tramite prompt testuali che guidano il modello di IA nel fornire le informazioni necessarie per eseguire un compito.
Vedi il codice qui sotto come riferimento:
# Defines the Complete LLM Function
def complete(user_text):
    completion = Complete(
        model="snowflake-arctic",
        prompt=f"Provide 3 relevant keywords from the following text: {user_text}",
        session=snowflake_session,
    )
return completionLa funzione extract answer fornisce una risposta in base alla domanda fornita al modello. L’input deve essere in inglese, in formato stringa o JSON.
Vedi il codice qui sotto come riferimento:
# Defines the Extract Answer LLM Function
def extract_answer(user_text):
    answer = ExtractAnswer(
        from_text=user_text,
        question="What are some reasons why young adult South Koreans love coffee?",
        session=snowflake_session,
    )
return answerLa funzione sentiment fornisce un valore quantitativo basato sul sentiment del testo. Restituisce un numero da -1 a 1. I valori vicini a -1 sono i più negativi, quelli vicini a 1 i più positivi e i valori attorno a 0 sono neutri.
Vedi il codice qui sotto come riferimento:
# Defines the Sentiment LLM Function
def sentiment(user_text):
    sentiment = Sentiment(text=user_text, session=snowflake_session)
return sentimentLe funzioni di embedding del testo includono la funzione EMBED_TEXT_768 e la funzione EMBED_TEXT_1024. Creano embedding vettoriali rispettivamente di 768 e 1024 dimensioni.
Vedi il codice qui sotto come riferimento per la funzione EMBED_TEXT_768:
# Defines the Embed Text LLM Function
def embed_text(user_text):
    embed_text = EmbedText768(text=user_text, model='snowflake-arctic-embed-m', session=snowflake_session)
    return embed_text
Ora mettiamole tutte insieme in una funzione principale ed eseguiamola su un testo di esempio per vedere i risultati.
Ho usato un testo semplice e breve da fornire in input al modello, come mostrato di seguito:
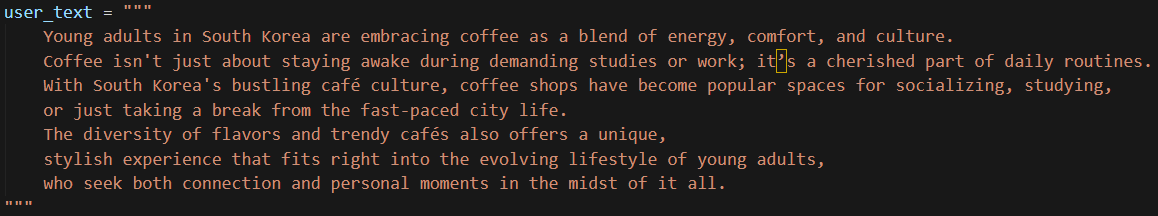
Per comodità di copia e incolla, ecco il testo:
user_text = """
        Young adults in South Korea are embracing coffee as a blend of energy, comfort, and culture.
        Coffee isn't just about staying awake during demanding studies or work; it’s a cherished part of daily routines.
        With South Korea's bustling café culture, coffee shops have become popular spaces for socializing, studying,
        or just taking a break from the fast-paced city life.
        The diversity of flavors and trendy cafés also offers a unique,
        stylish experience that fits right into the evolving lifestyle of young adults,
        who seek both connection and personal moments in the midst of it all.
    """
Ora eseguiamo il codice. Dovrebbe richiedere solo pochi secondi.
Ecco i risultati:
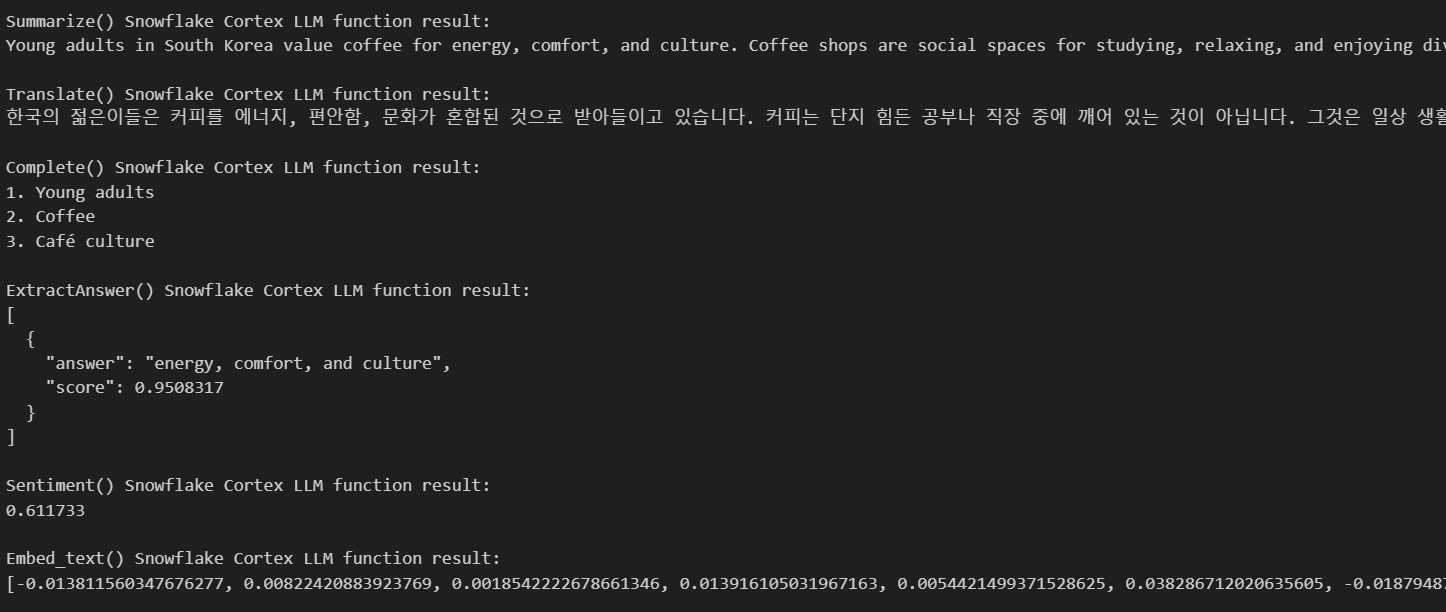
Come puoi vedere, l’IA ci ha dato tutti i risultati necessari in base al testo fornito. Ha prodotto un riassunto, ha tradotto il mio testo in coreano, mi ha fornito tre parole chiave basate sul testo e ha dato alcune risposte alle mie domande.
Cortex AI offre anche funzioni ML che possono essere eseguite solo con SQL. Ecco le varie funzioni disponibili.
Il rilevamento delle anomalie è essenziale per individuare pattern insoliti che non corrispondono al comportamento atteso dei tuoi dati. Snowflake semplifica il rilevamento delle anomalie fornendo funzioni ML integrate basate su gradient boosting machine (GBM) che consentono di identificare rapidamente gli outlier nei dataset.
Il rilevamento anomalie è particolarmente utile per attività come:
Per eseguire il rilevamento anomalie, si può usare la classe ANOMALY_DETECTION (SNOWFLAKE.ML) di Snowflake. Questo comando crea un oggetto modello per il rilevamento anomalie. Questo passaggio adatta il modello ai dati di training.
Ecco come puoi usarla:
CREATE [ OR REPLACE ] SNOWFLAKE.ML.ANOMALY_DETECTION <model_name>(
  INPUT_DATA => <reference_to_training_data>,
  [ SERIES_COLNAME => '<series_column_name>', ]
  TIMESTAMP_COLNAME => '<timestamp_column_name>',
  TARGET_COLNAME => '<target_column_name>',
  LABEL_COLNAME => '<label_column_name>',
  [ CONFIG_OBJECT => <config_object> ]
)
[ [ WITH ] TAG ( <tag_name> = '<tag_value>' [ , <tag_name> = '<tag_value>' , ... ] ) ]
[ COMMENT = '<string_literal>' ]
Una volta creato l’oggetto, puoi usare il metodo <model_name>!DETECT_ANOMALIES per eseguire il rilevamento anomalie,
<model_name>!DETECT_ANOMALIES(
  INPUT_DATA => <reference_to_data_to_analyze>,
  TIMESTAMP_COLNAME => '<timestamp_column_name>',
  TARGET_COLNAME => '<target_column_name>',
  [ CONFIG_OBJECT => <configuration_object>, ]
  [ SERIES_COLNAME => '<series_column_name>' ]
)
Questo è il passaggio di previsione effettivo, in cui gli outlier verranno rilevati usando il metodo.
Ecco un esempio di come eseguire il rilevamento anomalie usando un dataset.
Per prima cosa, puoi creare un database andando su Data nella scheda a sinistra, poi Add Data, quindi Load data into a Table.
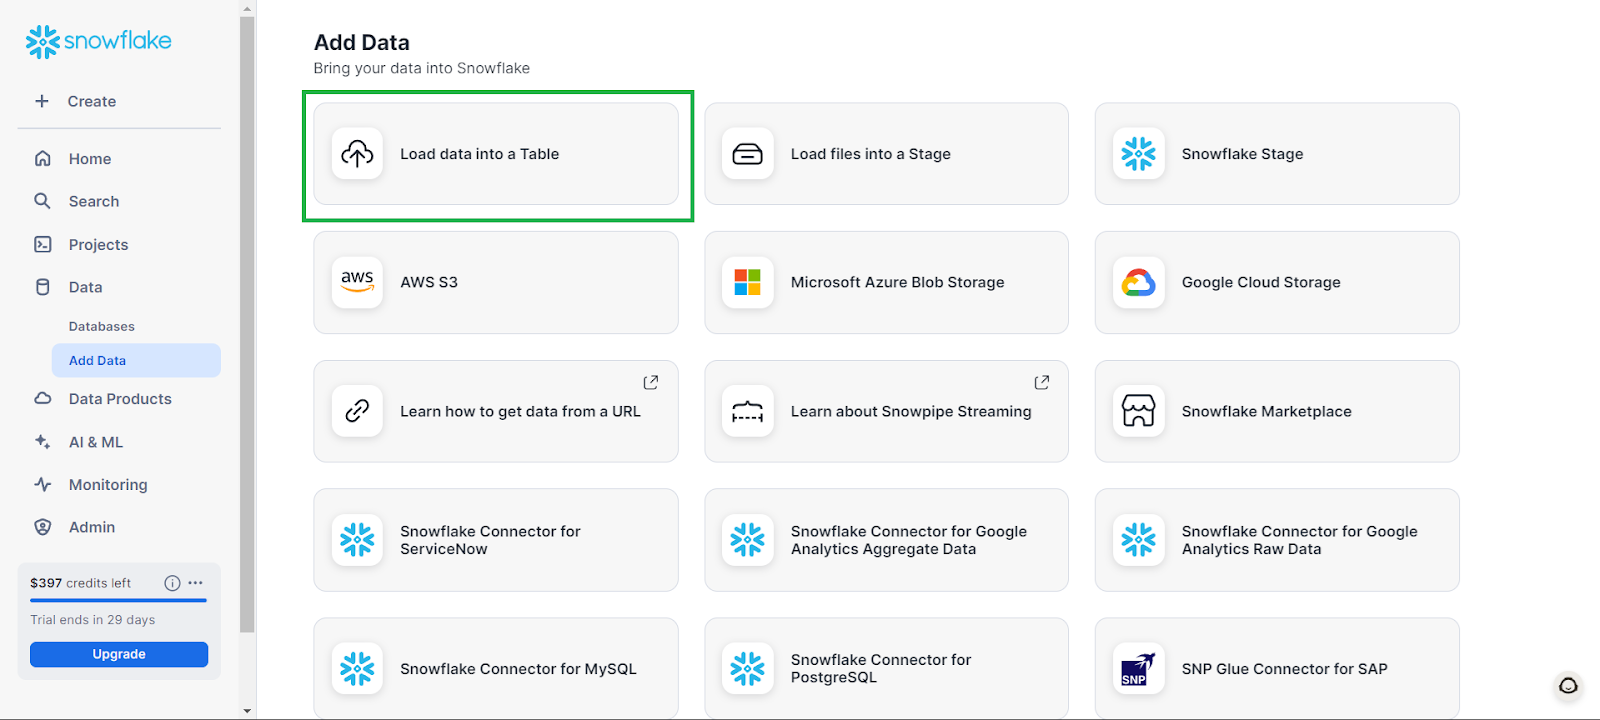
Nella finestra che si apre, clicca su + Database e assegna un nome al tuo database. Clicca su Create, quindi nella finestra principale del popup clicca su Cancel.
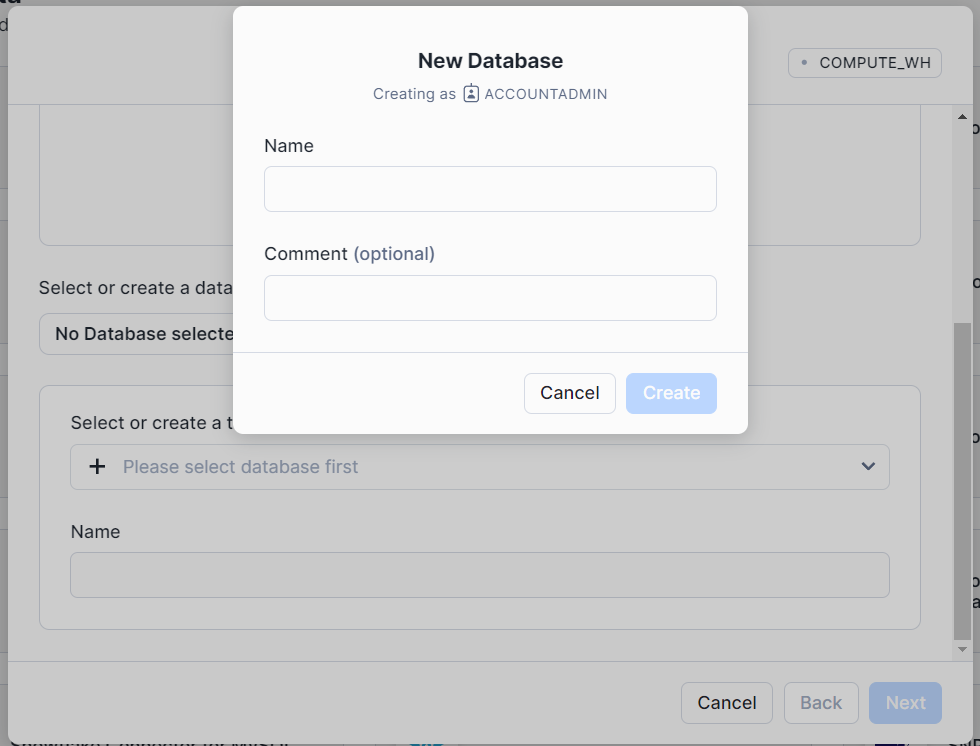
Questo creerà un database vuoto con cui puoi lavorare.
Gli esempi seguenti sono stati adattati dalla documentazione Snowflake.
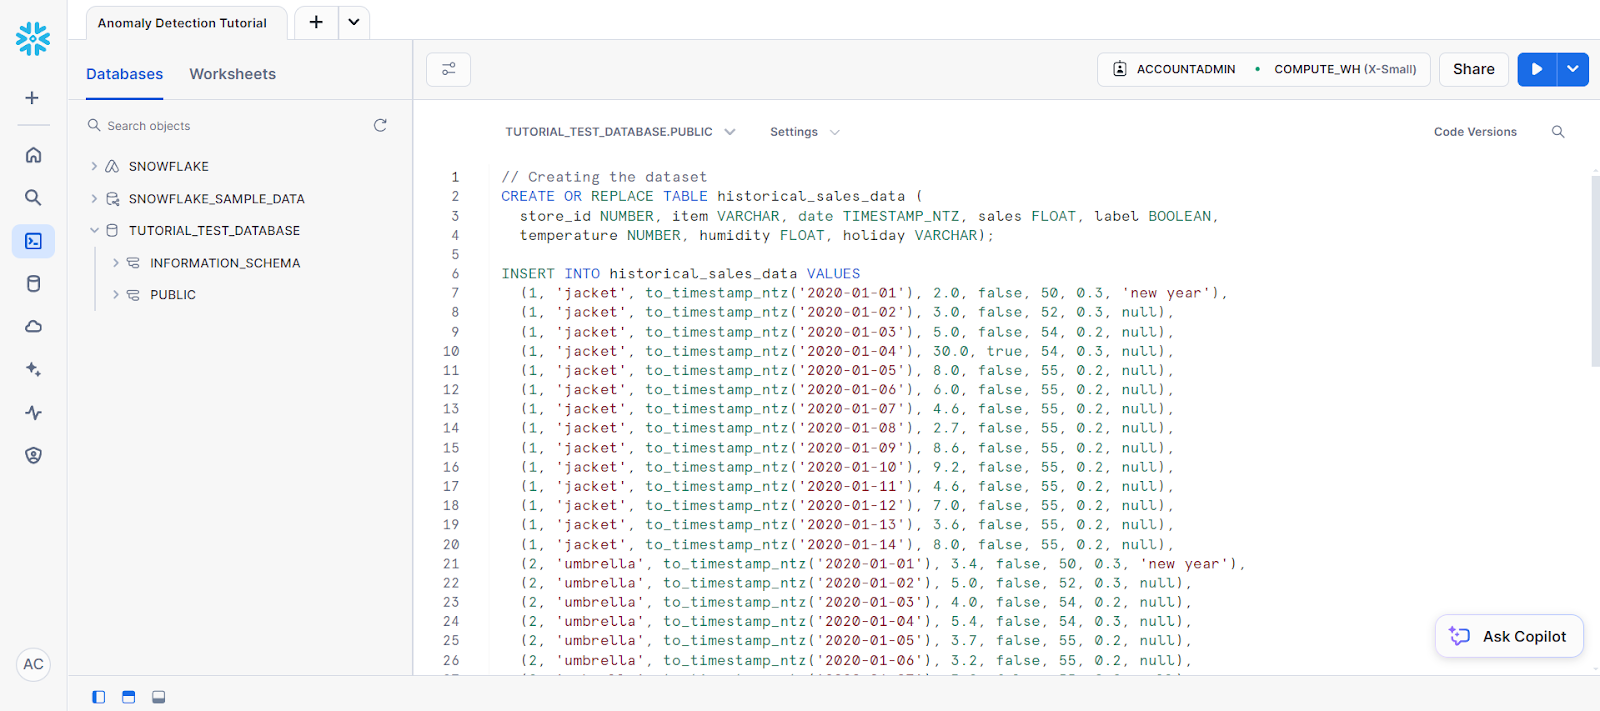
Per iniziare il rilevamento anomalie, vai in un nuovo foglio di lavoro SQL, seleziona il tuo nuovo database come sorgente dati e incolla il seguente codice per creare una tabella:
CREATE OR REPLACE TABLE historical_sales_data (
store_id NUMBER, item VARCHAR, date TIMESTAMP_NTZ, sales FLOAT, label BOOLEAN,
temperature NUMBER, humidity FLOAT, holiday VARCHAR);
// Creating the dataset
INSERT INTO historical_sales_data VALUES
  (1, 'jacket', to_timestamp_ntz('2020-01-01'), 2.0, false, 50, 0.3, 'new year'),
  (1, 'jacket', to_timestamp_ntz('2020-01-02'), 3.0, false, 52, 0.3, null),
  (1, 'jacket', to_timestamp_ntz('2020-01-03'), 5.0, false, 54, 0.2, null),
  (1, 'jacket', to_timestamp_ntz('2020-01-04'), 30.0, true, 54, 0.3, null),
  (1, 'jacket', to_timestamp_ntz('2020-01-05'), 8.0, false, 55, 0.2, null),
  (1, 'jacket', to_timestamp_ntz('2020-01-06'), 6.0, false, 55, 0.2, null),
  (1, 'jacket', to_timestamp_ntz('2020-01-07'), 4.6, false, 55, 0.2, null),
  (1, 'jacket', to_timestamp_ntz('2020-01-08'), 2.7, false, 55, 0.2, null),
  (1, 'jacket', to_timestamp_ntz('2020-01-09'), 8.6, false, 55, 0.2, null),
  (1, 'jacket', to_timestamp_ntz('2020-01-10'), 9.2, false, 55, 0.2, null),
  (1, 'jacket', to_timestamp_ntz('2020-01-11'), 4.6, false, 55, 0.2, null),
  (1, 'jacket', to_timestamp_ntz('2020-01-12'), 7.0, false, 55, 0.2, null),
  (1, 'jacket', to_timestamp_ntz('2020-01-13'), 3.6, false, 55, 0.2, null),
  (1, 'jacket', to_timestamp_ntz('2020-01-14'), 8.0, false, 55, 0.2, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-01'), 3.4, false, 50, 0.3, 'new year'),
  (2, 'umbrella', to_timestamp_ntz('2020-01-02'), 5.0, false, 52, 0.3, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-03'), 4.0, false, 54, 0.2, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-04'), 5.4, false, 54, 0.3, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-05'), 3.7, false, 55, 0.2, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-06'), 3.2, false, 55, 0.2, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-07'), 3.2, false, 55, 0.2, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-08'), 5.6, false, 55, 0.2, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-09'), 7.3, false, 55, 0.2, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-10'), 8.2, false, 55, 0.2, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-11'), 3.7, false, 55, 0.2, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-12'), 5.7, false, 55, 0.2, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-13'), 6.3, false, 55, 0.2, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-14'), 2.9, false, 55, 0.2, null);
Il tuo codice dovrebbe essere inserito in un foglio di lavoro SQL che appare così:
Segue poi queste istruzioni per creare una tabella chiamata new_sales_data.
// Creating a new table and adding training data
CREATE OR REPLACE TABLE new_sales_data (
  store_id NUMBER, item VARCHAR, date TIMESTAMP_NTZ, sales FLOAT,
  temperature NUMBER, humidity FLOAT, holiday VARCHAR);
INSERT INTO new_sales_data VALUES
  (1, 'jacket', to_timestamp_ntz('2020-01-16'), 6.0, 52, 0.3, null),
  (1, 'jacket', to_timestamp_ntz('2020-01-17'), 20.0, 53, 0.3, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-16'), 3.0, 52, 0.3, null),
  (2, 'umbrella', to_timestamp_ntz('2020-01-17'), 70.0, 53, 0.3, null);
Ora, crea il modello di rilevamento anomalie:
// Creating anomaly detection model object
CREATE OR REPLACE VIEW view_with_training_data
  AS SELECT date, sales FROM historical_sales_data
    WHERE store_id=1 AND item='jacket';
CREATE OR REPLACE SNOWFLAKE.ML.ANOMALY_DETECTION basic_model(
  INPUT_DATA => TABLE(view_with_training_data),
  TIMESTAMP_COLNAME => 'date',
  TARGET_COLNAME => 'sales',
  LABEL_COLNAME => '');
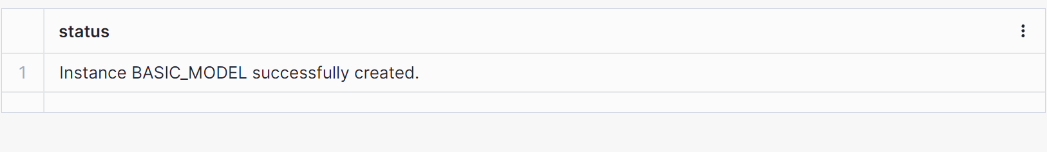
Dovrebbe apparire un risultato che indica che un modello è stato creato, come mostrato di seguito.
Successivamente, usiamo l’oggetto modello per fare un rilevamento.
// Perform anomaly detection
CREATE OR REPLACE VIEW view_with_data_to_analyze
  AS SELECT date, sales FROM new_sales_data
    WHERE store_id=1 and item='jacket';
CALL basic_model!DETECT_ANOMALIES(
  INPUT_DATA => TABLE(view_with_data_to_analyze),
  TIMESTAMP_COLNAME =>'date',
  TARGET_COLNAME => 'sales'
);
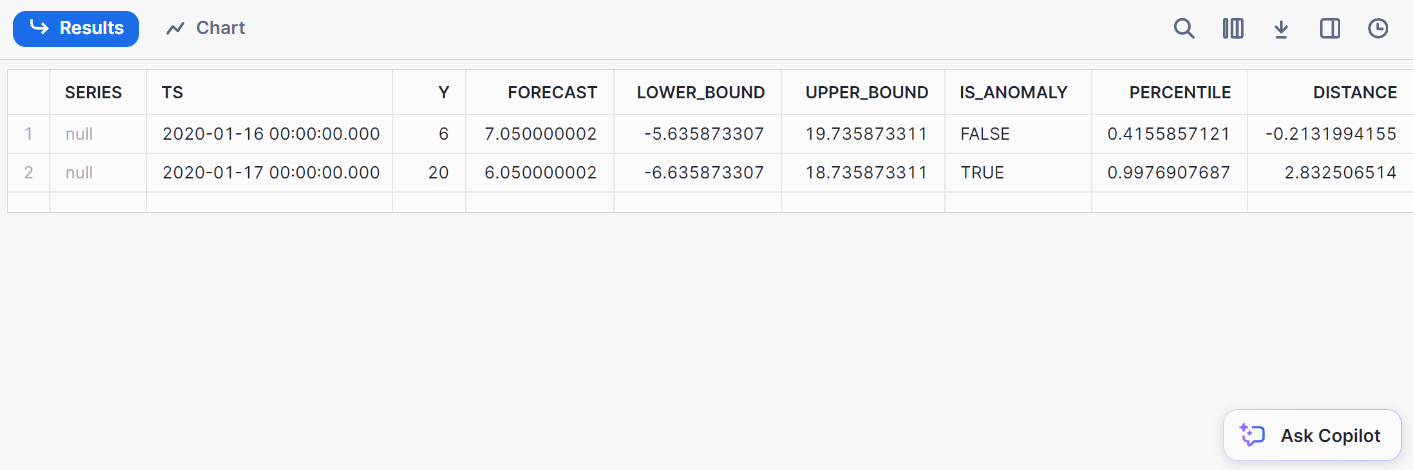
Ecco l’output del rilevamento:
La classificazione consiste nel categorizzare i dati in classi predefinite. Con Snowflake, puoi classificare i dati direttamente all’interno di Snowflake, eliminando la necessità di esportarli in ambienti ML esterni.
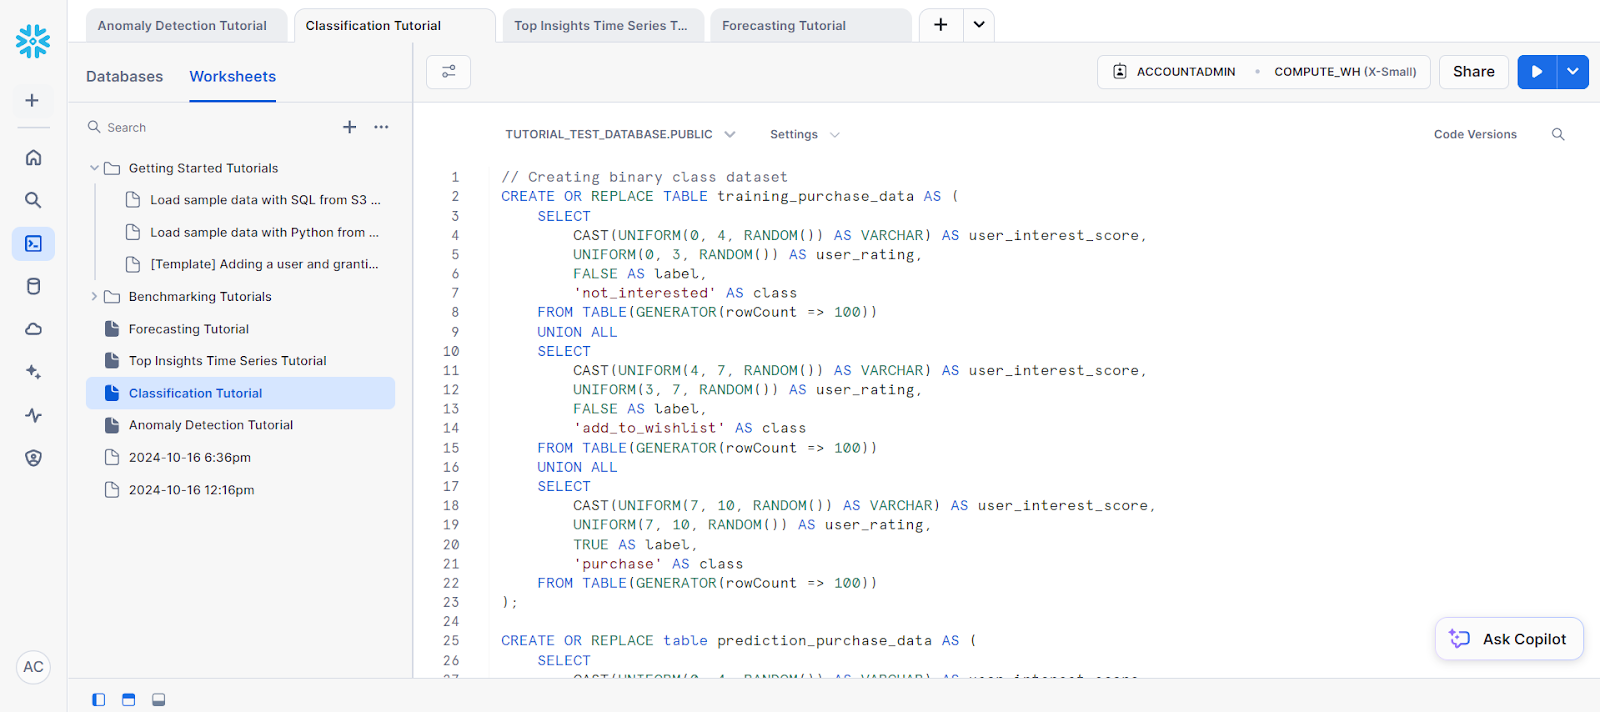
Per iniziare, crea un dataset di esempio usando il seguente codice:
// Creating binary class dataset
CREATE OR REPLACE TABLE training_purchase_data AS (
    SELECT
        CAST(UNIFORM(0, 4, RANDOM()) AS VARCHAR) AS user_interest_score,
        UNIFORM(0, 3, RANDOM()) AS user_rating,
        FALSE AS label,
        'not_interested' AS class
    FROM TABLE(GENERATOR(rowCount => 100))
    UNION ALL
    SELECT
        CAST(UNIFORM(4, 7, RANDOM()) AS VARCHAR) AS user_interest_score,
        UNIFORM(3, 7, RANDOM()) AS user_rating,
        FALSE AS label,
        'add_to_wishlist' AS class
    FROM TABLE(GENERATOR(rowCount => 100))
    UNION ALL
    SELECT
        CAST(UNIFORM(7, 10, RANDOM()) AS VARCHAR) AS user_interest_score,
        UNIFORM(7, 10, RANDOM()) AS user_rating,
        TRUE AS label,
        'purchase' AS class
    FROM TABLE(GENERATOR(rowCount => 100))
);
CREATE OR REPLACE table prediction_purchase_data AS (
    SELECT
        CAST(UNIFORM(0, 4, RANDOM()) AS VARCHAR) AS user_interest_score,
        UNIFORM(0, 3, RANDOM()) AS user_rating
    FROM TABLE(GENERATOR(rowCount => 100))
    UNION ALL
    SELECT
        CAST(UNIFORM(4, 7, RANDOM()) AS VARCHAR) AS user_interest_score,
        UNIFORM(3, 7, RANDOM()) AS user_rating
    FROM TABLE(GENERATOR(rowCount => 100))
    UNION ALL
    SELECT
        CAST(UNIFORM(7, 10, RANDOM()) AS VARCHAR) AS user_interest_score,
        UNIFORM(7, 10, RANDOM()) AS user_rating
    FROM TABLE(GENERATOR(rowCount => 100))
);
Ai fini dei dati di training, creiamo una nuova vista.
// Creating view for training data
CREATE OR REPLACE view binary_classification_view AS
    SELECT user_interest_score, user_rating, label
FROM training_purchase_data;
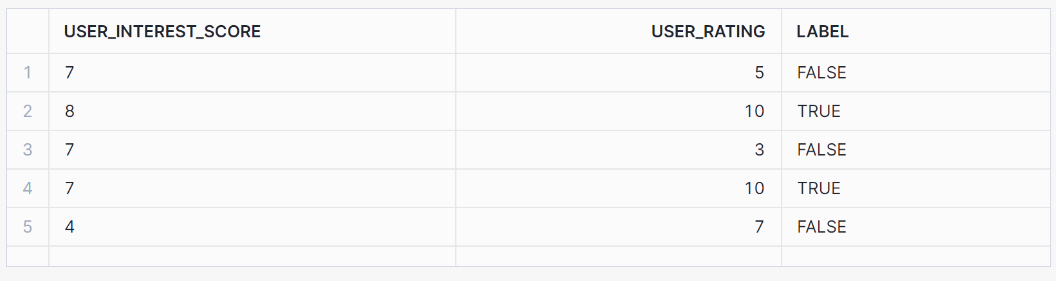
SELECT * FROM binary_classification_view ORDER BY RANDOM(42) LIMIT 5;
Questa vista dovrebbe restituire i seguenti risultati:
Ora alleniamo il modello sui dati di training:
// Training a binary classification model
CREATE OR REPLACE SNOWFLAKE.ML.CLASSIFICATION model_binary(
    INPUT_DATA => SYSTEM$REFERENCE('view', 'binary_classification_view'),
    TARGET_COLNAME => 'label'
);
Per eseguire la classificazione, usa il metodo PREDICT:
// Performing prediction using PREDICT method
SELECT model_binary!PREDICT(INPUT_DATA => {*})
    AS prediction FROM prediction_purchase_data;
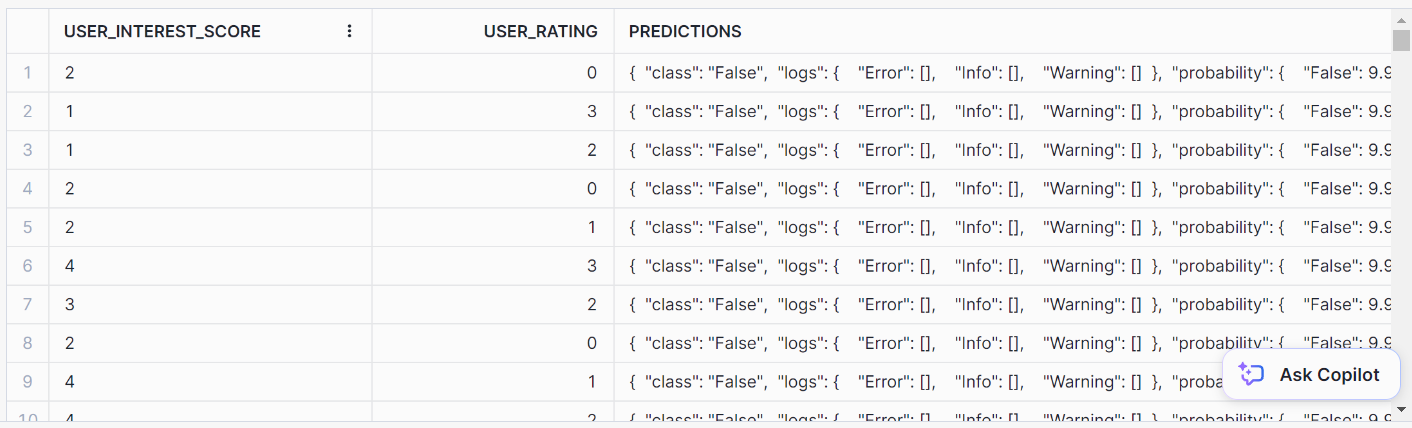
Ecco come appare la previsione:
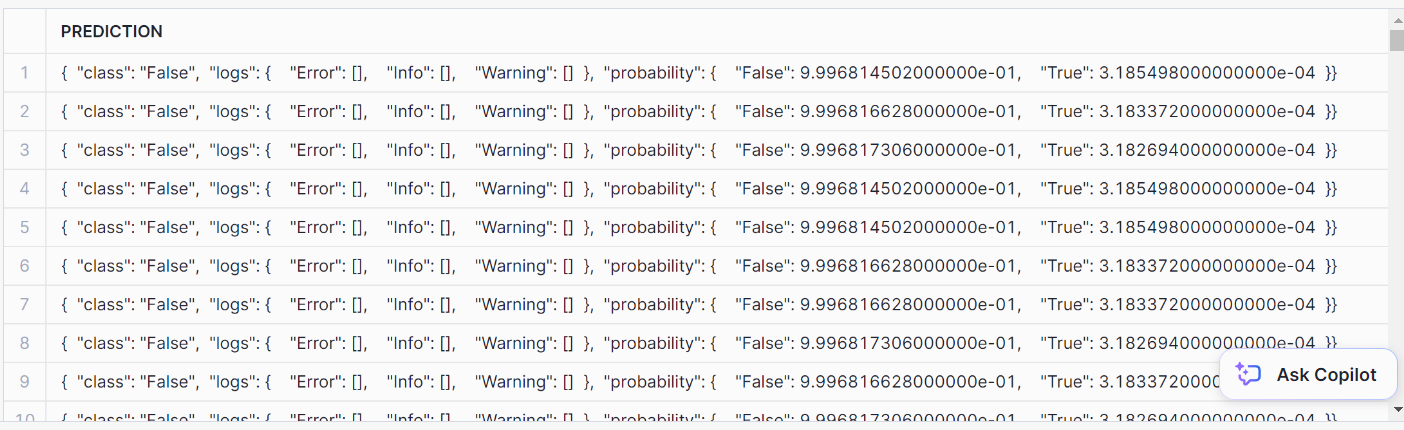
Per formattarla bene, usa questa istruzione SQL:
// Formatting SQL predictions
SELECT *, model_binary!PREDICT(INPUT_DATA => {*})
    AS predictions FROM prediction_purchase_data;
Dovresti ottenere questo formato pulito per le previsioni:
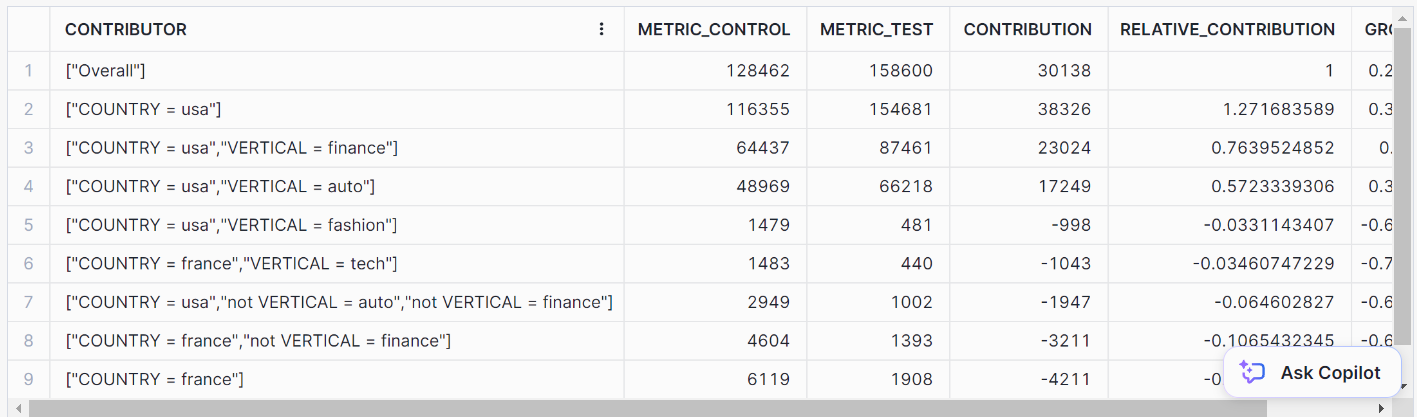
Top Insights è uno strumento di monitoraggio per osservare le fluttuazioni delle metriche nel tempo attraverso un’analisi di serie temporali. Usando un modello ad albero decisionale, Top Insights può identificare i fattori di contribuzione più significativi all’aumento o alla diminuzione di una determinata metrica.
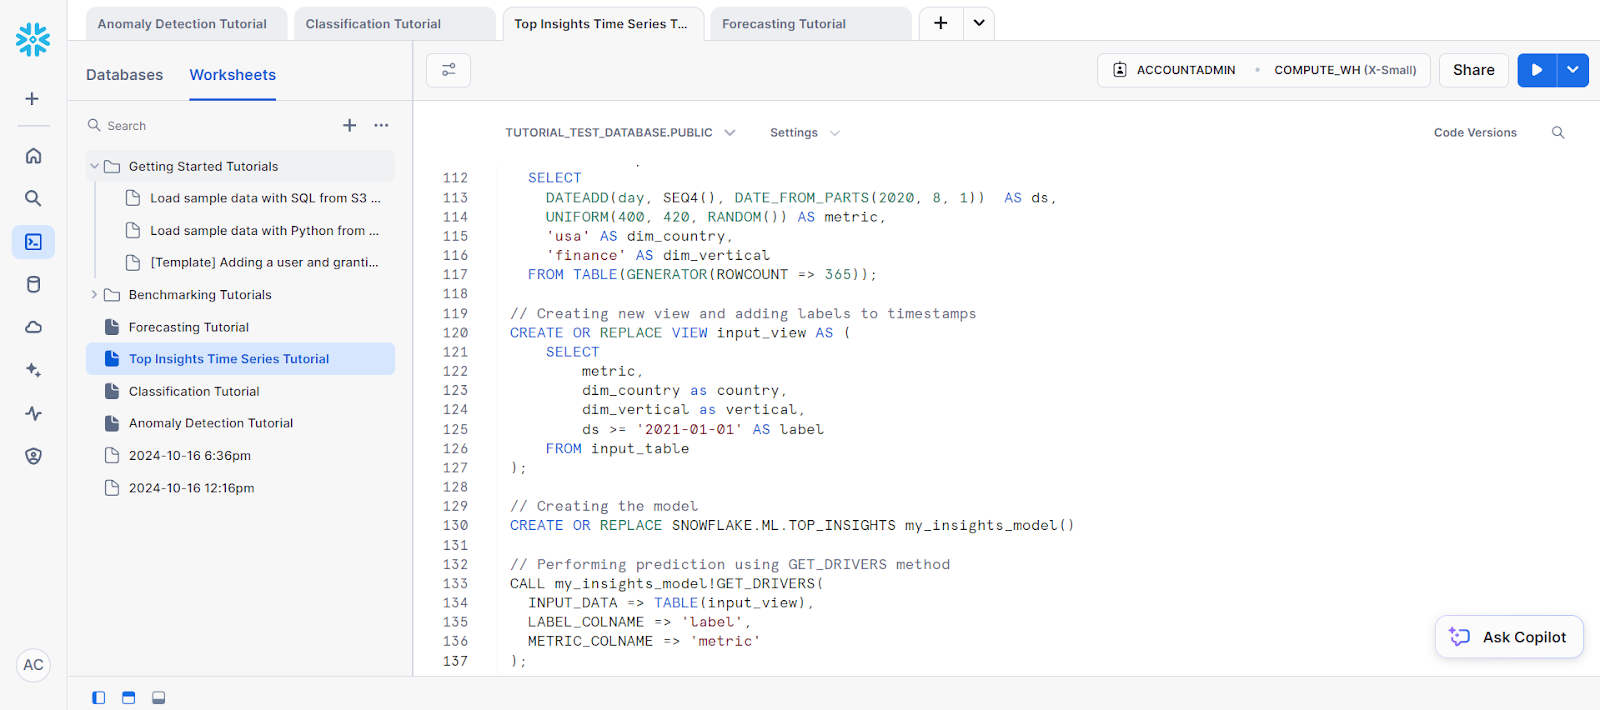
Vediamo un esempio di analisi di serie temporali usando questa funzione.
Per prima cosa, creiamo un dataset:
// Creating dataset
CREATE OR REPLACE TABLE input_table(
  ds DATE, metric NUMBER, dim_country VARCHAR, dim_vertical VARCHAR);
INSERT INTO input_table
  SELECT
    DATEADD(day, SEQ4(), DATE_FROM_PARTS(2020, 4, 1)) AS ds,
    UNIFORM(1, 10, RANDOM()) AS metric,
    'usa' AS dim_country,
    'tech' AS dim_vertical
  FROM TABLE(GENERATOR(ROWCOUNT => 365));
INSERT INTO input_table
  SELECT
    DATEADD(day, SEQ4(), DATE_FROM_PARTS(2020, 4, 1)) AS ds,
    UNIFORM(1, 10, RANDOM()) AS metric,
    'usa' AS dim_country,
    'auto' AS dim_vertical
  FROM TABLE(GENERATOR(ROWCOUNT => 365));
INSERT INTO input_table
  SELECT
    DATEADD(day, seq4(), DATE_FROM_PARTS(2020, 4, 1)) AS ds,
    UNIFORM(1, 10, RANDOM()) AS metric,
    'usa' AS dim_country,
    'fashion' AS dim_vertical
  FROM TABLE(GENERATOR(ROWCOUNT => 365));
INSERT INTO input_table
  SELECT
    DATEADD(day, SEQ4(), DATE_FROM_PARTS(2020, 4, 1)) AS ds,
    UNIFORM(1, 10, RANDOM()) AS metric,
    'usa' AS dim_country,
    'finance' AS dim_vertical
  FROM TABLE(GENERATOR(ROWCOUNT => 365));
INSERT INTO input_table
  SELECT
    DATEADD(day, SEQ4(), DATE_FROM_PARTS(2020, 4, 1)) AS ds,
    UNIFORM(1, 10, RANDOM()) AS metric,
    'canada' AS dim_country,
    'fashion' AS dim_vertical
  FROM TABLE(GENERATOR(ROWCOUNT => 365));
INSERT INTO input_table
  SELECT
    DATEADD(day, SEQ4(), DATE_FROM_PARTS(2020, 4, 1)) AS ds,
    UNIFORM(1, 10, RANDOM()) AS metric,
    'canada' AS dim_country,
    'finance' AS dim_vertical
  FROM TABLE(GENERATOR(ROWCOUNT => 365));
INSERT INTO input_table
  SELECT
    DATEADD(day, SEQ4(), DATE_FROM_PARTS(2020, 4, 1)) AS ds,
    UNIFORM(1, 10, RANDOM()) AS metric,
    'canada' AS dim_country,
    'tech' AS dim_vertical
  FROM TABLE(GENERATOR(ROWCOUNT => 365));
INSERT INTO input_table
  SELECT
    DATEADD(day, SEQ4(), DATE_FROM_PARTS(2020, 4, 1)) AS ds,
    UNIFORM(1, 10, RANDOM()) AS metric,
    'canada' AS dim_country,
    'auto' AS dim_vertical
  FROM TABLE(GENERATOR(ROWCOUNT => 365));
INSERT INTO input_table
  SELECT
    DATEADD(day, SEQ4(), DATE_FROM_PARTS(2020, 4, 1)) AS ds,
    UNIFORM(1, 10, RANDOM()) AS metric,
    'france' AS dim_country,
    'fashion' AS dim_vertical
  FROM TABLE(GENERATOR(ROWCOUNT => 365));
INSERT INTO input_table
  SELECT
    DATEADD(day, SEQ4(), DATE_FROM_PARTS(2020, 4, 1)) AS ds,
    UNIFORM(1, 10, RANDOM()) AS metric,
    'france' AS dim_country,
    'finance' AS dim_vertical
  FROM TABLE(GENERATOR(ROWCOUNT => 365));
INSERT INTO input_table
  SELECT
    DATEADD(day, SEQ4(), DATE_FROM_PARTS(2020, 4, 1)) AS ds,
    UNIFORM(1, 10, RANDOM()) AS metric,
    'france' AS dim_country,
    'tech' AS dim_vertical
  FROM TABLE(GENERATOR(ROWCOUNT => 365));
INSERT INTO input_table
  SELECT
    DATEADD(day, SEQ4(), DATE_FROM_PARTS(2020, 4, 1)) AS ds,
    UNIFORM(1, 10, RANDOM()) AS metric,
    'france' AS dim_country,
    'auto' AS dim_vertical
  FROM TABLE(GENERATOR(ROWCOUNT => 365));
-- Data for the test group
INSERT INTO input_table
  SELECT
    DATEADD(day, SEQ4(), DATE_FROM_PARTS(2020, 8, 1)) AS ds,
    UNIFORM(300, 320, RANDOM()) AS metric,
    'usa' AS dim_country,
    'auto' AS dim_vertica
  FROM TABLE(GENERATOR(ROWCOUNT => 365));
INSERT INTO input_table
  SELECT
    DATEADD(day, SEQ4(), DATE_FROM_PARTS(2020, 8, 1))  AS ds,
    UNIFORM(400, 420, RANDOM()) AS metric,
    'usa' AS dim_country,
    'finance' AS dim_vertical
  FROM TABLE(GENERATOR(ROWCOUNT => 365));
// Creating new view and adding labels to timestamps
CREATE OR REPLACE VIEW input_view AS (
    SELECT
        metric,
        dim_country as country,
        dim_vertical as vertical,
        ds >= '2021-01-01' AS label
    FROM input_table
);
Poi dobbiamo creare l’oggetto modello per la previsione. Serve per accedere al metodo GET_DRIVERS.
// Creating the model
CREATE OR REPLACE SNOWFLAKE.ML.TOP_INSIGHTS my_insights_model()
Infine, per la previsione, richiama il metodo GET_DRIVERS.
// Performing prediction using GET_DRIVERS method
CALL my_insights_model!GET_DRIVERS(
  INPUT_DATA => TABLE(input_view),
  LABEL_COLNAME => 'label',
  METRIC_COLNAME => 'metric'
);
Dovresti ottenere i seguenti risultati:
Il forecasting è fondamentale quando devi prevedere valori futuri basandoti su dati storici. Che si tratti di previsioni di vendita, consumo energetico o traffico web, le funzioni integrate di Snowflake semplificano molto questi compiti.
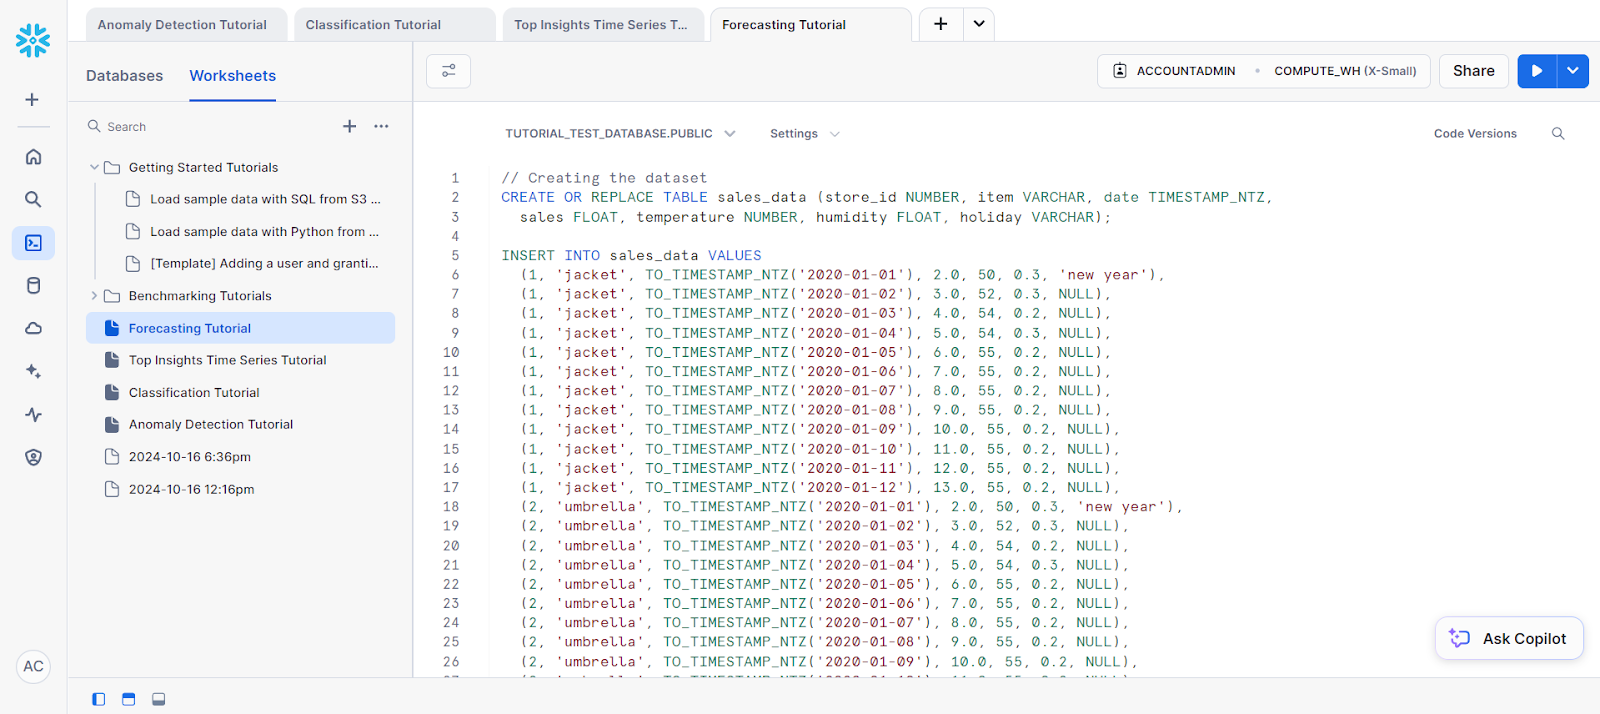
Per il nostro esempio, vediamo come effettuare un forecasting su una singola serie:
// Creating the dataset
CREATE OR REPLACE TABLE sales_data (store_id NUMBER, item VARCHAR, date TIMESTAMP_NTZ,
  sales FLOAT, temperature NUMBER, humidity FLOAT, holiday VARCHAR);
INSERT INTO sales_data VALUES
  (1, 'jacket', TO_TIMESTAMP_NTZ('2020-01-01'), 2.0, 50, 0.3, 'new year'),
  (1, 'jacket', TO_TIMESTAMP_NTZ('2020-01-02'), 3.0, 52, 0.3, NULL),
  (1, 'jacket', TO_TIMESTAMP_NTZ('2020-01-03'), 4.0, 54, 0.2, NULL),
  (1, 'jacket', TO_TIMESTAMP_NTZ('2020-01-04'), 5.0, 54, 0.3, NULL),
  (1, 'jacket', TO_TIMESTAMP_NTZ('2020-01-05'), 6.0, 55, 0.2, NULL),
  (1, 'jacket', TO_TIMESTAMP_NTZ('2020-01-06'), 7.0, 55, 0.2, NULL),
  (1, 'jacket', TO_TIMESTAMP_NTZ('2020-01-07'), 8.0, 55, 0.2, NULL),
  (1, 'jacket', TO_TIMESTAMP_NTZ('2020-01-08'), 9.0, 55, 0.2, NULL),
  (1, 'jacket', TO_TIMESTAMP_NTZ('2020-01-09'), 10.0, 55, 0.2, NULL),
  (1, 'jacket', TO_TIMESTAMP_NTZ('2020-01-10'), 11.0, 55, 0.2, NULL),
  (1, 'jacket', TO_TIMESTAMP_NTZ('2020-01-11'), 12.0, 55, 0.2, NULL),
  (1, 'jacket', TO_TIMESTAMP_NTZ('2020-01-12'), 13.0, 55, 0.2, NULL),
  (2, 'umbrella', TO_TIMESTAMP_NTZ('2020-01-01'), 2.0, 50, 0.3, 'new year'),
  (2, 'umbrella', TO_TIMESTAMP_NTZ('2020-01-02'), 3.0, 52, 0.3, NULL),
  (2, 'umbrella', TO_TIMESTAMP_NTZ('2020-01-03'), 4.0, 54, 0.2, NULL),
  (2, 'umbrella', TO_TIMESTAMP_NTZ('2020-01-04'), 5.0, 54, 0.3, NULL),
  (2, 'umbrella', TO_TIMESTAMP_NTZ('2020-01-05'), 6.0, 55, 0.2, NULL),
  (2, 'umbrella', TO_TIMESTAMP_NTZ('2020-01-06'), 7.0, 55, 0.2, NULL),
  (2, 'umbrella', TO_TIMESTAMP_NTZ('2020-01-07'), 8.0, 55, 0.2, NULL),
  (2, 'umbrella', TO_TIMESTAMP_NTZ('2020-01-08'), 9.0, 55, 0.2, NULL),
  (2, 'umbrella', TO_TIMESTAMP_NTZ('2020-01-09'), 10.0, 55, 0.2, NULL),
  (2, 'umbrella', TO_TIMESTAMP_NTZ('2020-01-10'), 11.0, 55, 0.2, NULL),
  (2, 'umbrella', TO_TIMESTAMP_NTZ('2020-01-11'), 12.0, 55, 0.2, NULL),
  (2, 'umbrella', TO_TIMESTAMP_NTZ('2020-01-12'), 13.0, 55, 0.2, NULL);
-- Future values for additional columns (features)
CREATE OR REPLACE TABLE future_features (store_id NUMBER, item VARCHAR,
  date TIMESTAMP_NTZ, temperature NUMBER, humidity FLOAT, holiday VARCHAR);
INSERT INTO future_features VALUES
  (1, 'jacket', TO_TIMESTAMP_NTZ('2020-01-13'), 52, 0.3, NULL),
  (1, 'jacket', TO_TIMESTAMP_NTZ('2020-01-14'), 53, 0.3, NULL),
  (2, 'umbrella', TO_TIMESTAMP_NTZ('2020-01-13'), 52, 0.3, NULL),
  (2, 'umbrella', TO_TIMESTAMP_NTZ('2020-01-14'), 53, 0.3, NULL);
Poi separiamo i dati di training dal dataset.
// Creating a view for training data
CREATE OR REPLACE VIEW v1 AS SELECT date, sales
  FROM sales_data WHERE store_id=1 AND item='jacket';
SELECT * FROM v1;
Prima di iniziare il forecasting, devi addestrare il modello sui dati di training selezionati.
Ecco come fare:
// Training a forecasting model
CREATE SNOWFLAKE.ML.FORECAST model1(
  INPUT_DATA => TABLE(v1),
  TIMESTAMP_COLNAME => 'date',
  TARGET_COLNAME => 'sales'
);
Infine, per la previsione, puoi chiamare il metodo FORECAST per il passaggio di prediction.
// Performing the forecast by calling the FORECAST method
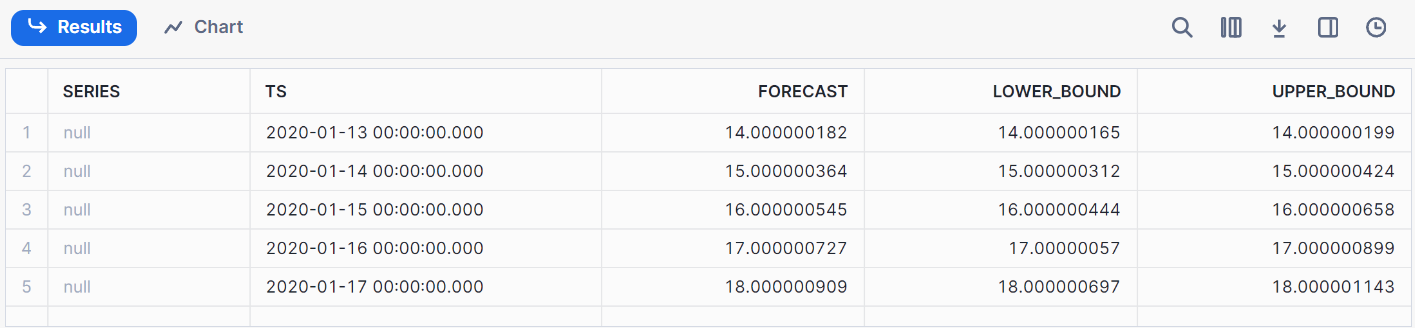
call model1!FORECAST(FORECASTING_PERIODS => 5);
Questo è l’output risultante del nostro forecasting.
Il monitoraggio delle prestazioni dei modelli può essere effettuato creando dashboard in Snowflake tramite integrazioni di terze parti (come Tableau) o interrogando i log di Snowflake. Alcune metriche utili come accuracy, precision e recall possono essere usate per tenere traccia dei modelli.
Snowflake Cortex AI semplifica il machine learning consentendo un’integrazione fluida dei modelli dalla piattaforma Snowflake. Questo tutorial ti ha guidato nell’uso di Snowflake Cortex AI e delle funzioni ML di Snowflake Cortex.
Questa soluzione sfrutta la scalabilità di Snowflake e la flessibilità di Python, risultando ideale per le organizzazioni che vogliono implementare il machine learning senza spostare i dati fuori dal cloud.
Cerchi altre risorse su Snowflake? Potrebbero interessarti il nostro Tutorial per principianti su Snowflake e la nostra guida a Snowpark. Se cerchi qualcosa di più completo, allora il corso Introduction to Snowflake potrebbe fare al caso tuo.
I migliori corsi DataCamp
Corso
Programma
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



