Lộ trình
Cơ bản về Trí tuệ Nhân tạo
10 giờ
Trong lĩnh vực mô hình ngôn ngữ lớn (LLM) đang phát triển nhanh chóng, việc nắm bắt các phương pháp tối tân như prompt tuning là điều then chốt. Kỹ thuật này, áp dụng cho các mô hình nền tảng đã được huấn luyện, giúp nâng cao hiệu năng mà không phải chịu chi phí tính toán cao như cách huấn luyện truyền thống.
Trong bài viết này, chúng ta sẽ tìm hiểu những điều cơ bản về prompt tuning, so sánh nó với fine-tuning và prompt engineering, và thảo luận về những lợi ích đáng kể của nó. Chúng tôi cũng sẽ đưa ra một ví dụ thực tiễn sử dụng nền tảng của HuggingFace, nơi chúng ta Prompt tune một mô hình bloomz-560m. Hướng dẫn này nhằm giúp bạn hiểu sâu hơn về prompt tuning và truyền cảm hứng để tích hợp nó vào các dự án của bạn.
Prompt tuning là một kỹ thuật được thiết kế để nâng cao hiệu năng của mô hình ngôn ngữ đã huấn luyện sẵn mà không làm thay đổi kiến trúc cốt lõi của nó. Thay vì điều chỉnh các trọng số cấu trúc sâu của mô hình, prompt tuning tinh chỉnh các prompt dẫn dắt phản hồi của mô hình. Phương pháp này dựa trên việc đưa vào các "soft prompt", một tập tham số có thể tinh chỉnh, được chèn vào đầu chuỗi đầu vào.
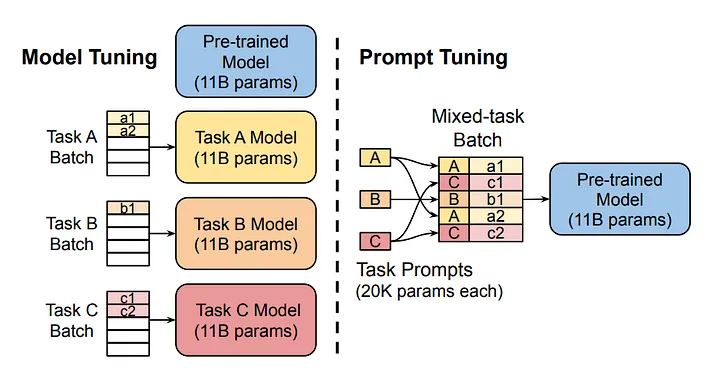
Nguồn hình ảnh
Sơ đồ so sánh cách tiếp cận tinh chỉnh mô hình truyền thống với prompt tuning. Hãy lưu ý rằng trong tinh chỉnh mô hình, mỗi tác vụ cần một mô hình riêng. Ngược lại, prompt tuning sử dụng cùng một mô hình nền tảng cho nhiều tác vụ bằng cách điều chỉnh các prompt đặc thù cho từng tác vụ.
Soft prompt là các token được tạo nhân tạo và thêm vào chuỗi đầu vào của mô hình. Các prompt này có thể được khởi tạo theo nhiều cách. Khởi tạo ngẫu nhiên là phổ biến, tuy nhiên cũng có thể khởi tạo dựa trên một số kinh nghiệm. Sau khi khởi tạo, soft prompt được gắn vào phần đầu của dữ liệu đầu vào. Khi mô hình xử lý dữ liệu này, nó xem xét cả soft prompt lẫn đầu vào thực tế.
Quy trình huấn luyện thường tương tự như khi huấn luyện một mạng nơ-ron sâu (DNN) tiêu chuẩn. Nó bắt đầu bằng một lượt lan truyền thuận, nơi mô hình xử lý đầu vào kết hợp qua các tầng và tạo ra đầu ra. Đầu ra này sau đó được so sánh với kết quả mong muốn bằng một hàm mất mát, đo lường độ chênh lệch giữa đầu ra của mô hình và giá trị kỳ vọng thực tế.
Trong quá trình lan truyền ngược, lỗi được truyền ngược qua mạng. Tuy nhiên, thay vì điều chỉnh trọng số của mạng, chúng ta chỉ thay đổi các tham số của soft prompt. Quy trình này lặp lại qua nhiều epoch, với các soft prompt dần học cách định hình việc xử lý đầu vào của mô hình sao cho giảm thiểu lỗi cho tác vụ đã cho.
Quy trình lan truyền thuận, đánh giá mất mát và lan truyền ngược được lặp lại qua nhiều epoch. Theo thời gian, các soft prompt này học cách định hình đầu vào theo những cách giúp liên tục giảm điểm mất mát, từ đó cải thiện hiệu năng theo tác vụ của mô hình mà không làm ảnh hưởng đến năng lực nền tảng của nó.
Prompt tuning, fine-tuning và prompt engineering là ba phương pháp khác nhau áp dụng cho các LLM đã huấn luyện sẵn nhằm cải thiện hiệu năng trên một tác vụ cụ thể. Các phương pháp này không loại trừ lẫn nhau và mỗi phương pháp phù hợp với một trường hợp sử dụng nhất định.
Fine-tuning tốn nhiều tài nguyên nhất, bao gồm việc huấn luyện lại toàn diện mô hình trên một tập dữ liệu cụ thể cho một mục đích cụ thể. Cách này điều chỉnh các trọng số của mô hình đã huấn luyện sẵn, tối ưu hóa cho những sắc thái chi tiết của dữ liệu nhưng đòi hỏi nguồn lực tính toán lớn và làm tăng nguy cơ overfitting. Nhiều LLM như ChatGPT trải qua fine-tuning sau khi hoàn tất huấn luyện tổng quát ban đầu cho nhiệm vụ dự đoán từ tiếp theo. Fine-tuning dạy các mô hình này cách hoạt động như trợ lý số, khiến chúng hữu ích hơn đáng kể so với một mô hình chỉ được huấn luyện tổng quát.
Prompt tuning điều chỉnh một tập tham số bổ sung, gọi là "soft prompt", được tích hợp vào quá trình xử lý đầu vào của mô hình. Phương pháp này thay đổi cách mô hình diễn giải các prompt đầu vào mà không cần đại tu hoàn toàn các trọng số, mang lại sự cân bằng giữa cải thiện hiệu năng và hiệu quả tài nguyên. Nó đặc biệt hữu ích khi nguồn lực tính toán hạn chế hoặc cần linh hoạt cho nhiều tác vụ, vì sau khi áp dụng kỹ thuật này, các trọng số gốc của mô hình vẫn không thay đổi.
Ngược lại, prompt engineering hoàn toàn không liên quan đến huấn luyện hay huấn luyện lại. Nó hoàn toàn dựa trên việc người dùng thiết kế prompt cho mô hình. Phương pháp này đòi hỏi hiểu biết tinh tế về khả năng xử lý của mô hình và tận dụng kiến thức vốn có đã được nhúng trong mô hình. Prompt engineering không cần tài nguyên tính toán vì chỉ dựa vào việc xây dựng đầu vào một cách có chiến lược để đạt kết quả. Hãy xem khóa học của DataCamp về prompt engineering dành cho nhà phát triển để tìm hiểu thêm.
Mỗi kỹ thuật cung cấp một cách tiếp cận khác nhau để khai thác năng lực của các mô hình đã huấn luyện sẵn. Lựa chọn giữa chúng phụ thuộc vào nhu cầu cụ thể của ứng dụng, chẳng hạn như mức độ sẵn có của tài nguyên tính toán, yêu cầu tùy biến mô hình và mức độ tương tác mong muốn với các tham số học của mô hình.
|
Phương pháp |
Cường độ sử dụng tài nguyên |
Cần huấn luyện |
Phù hợp nhất cho |
|
Fine-tuning |
Cao |
Có |
Các tác vụ cần tùy biến mô hình sâu |
|
Prompt tuning |
Thấp |
Có |
Duy trì tính toàn vẹn mô hình xuyên suốt các tác vụ |
|
Prompt engineering |
Không |
Không |
Điều chỉnh nhanh mà không tốn chi phí tính toán. |
Mỗi phương pháp đều có chỗ đứng tùy theo nhu cầu cụ thể của dự án.
Prompt tuning mang lại một số lợi ích quan trọng, khiến nó trở thành kỹ thuật không thể thiếu để tối ưu hóa các mô hình ngôn ngữ lớn.
Prompt tuning giữ nguyên các tham số của mô hình đã huấn luyện sẵn, giúp giảm đáng kể sức mạnh tính toán cần thiết. Hiệu quả này đặc biệt quan trọng trong môi trường hạn chế tài nguyên, cho phép sử dụng mô hình tinh vi mà không tốn kém. Khi kích thước trung bình của các mô hình nền tảng tăng lên, việc "đóng băng" các tham số mô hình càng hấp dẫn hơn vì không cần triển khai một mô hình riêng cho mỗi tác vụ.
Không giống như fine-tuning toàn diện, prompt tuning chỉ yêu cầu điều chỉnh một tập nhỏ tham số của soft prompt. Điều này tăng tốc quá trình thích ứng, cho phép chuyển đổi nhanh hơn giữa các tác vụ khác nhau và giảm thời gian gián đoạn.
Bằng cách giữ nguyên kiến trúc và trọng số cốt lõi của mô hình, prompt tuning bảo toàn các năng lực và tri thức gốc được nhúng trong mô hình đã huấn luyện sẵn. Điều này rất quan trọng để duy trì độ tin cậy và khả năng khái quát của mô hình trong nhiều ứng dụng khác nhau.
Prompt tuning tạo điều kiện sử dụng một mô hình nền tảng duy nhất cho nhiều tác vụ chỉ bằng cách thay đổi các soft prompt. Cách tiếp cận này giảm nhu cầu huấn luyện và duy trì các mô hình riêng cho từng tác vụ cụ thể, nâng cao khả năng mở rộng và đơn giản hóa quản lý mô hình.
Prompt tuning đòi hỏi ít can thiệp của con người hơn đáng kể so với prompt engineering, nơi việc cẩn thận soạn thảo prompt cho phù hợp một tác vụ cụ thể có thể dễ sai sót và tốn thời gian. Thay vào đó, việc tối ưu hóa tự động các soft prompt trong quá trình huấn luyện giúp giảm thiểu lỗi do con người và tối đa hóa hiệu quả.
Nghiên cứu cho thấy với các mô hình lớn, prompt tuning có thể đạt mức hiệu năng tương đương fine-tuning. Lợi ích này ngày càng đáng kể khi kích thước mô hình tăng, kết hợp hiệu quả cao với kết quả mạnh mẽ.
Trong hướng dẫn này, chúng ta sẽ áp dụng prompt tuning cho mô hình bloomz-560m của BigScience. Chúng ta sẽ làm việc trong hệ sinh thái Hugging Face với thư viện PEFT (Parameter-Efficient Fine-Tuning).
Mặc dù ở đây chúng ta tập trung vào tác vụ mô hình hóa ngôn ngữ nhân quả, thư viện PEFT hỗ trợ nhiều tác vụ, mô hình và kỹ thuật tuning khác nhau. Bạn có thể tìm các phương pháp PEFT tương thích cho những mô hình và tác vụ khác trên trang tài liệu của PEFT.
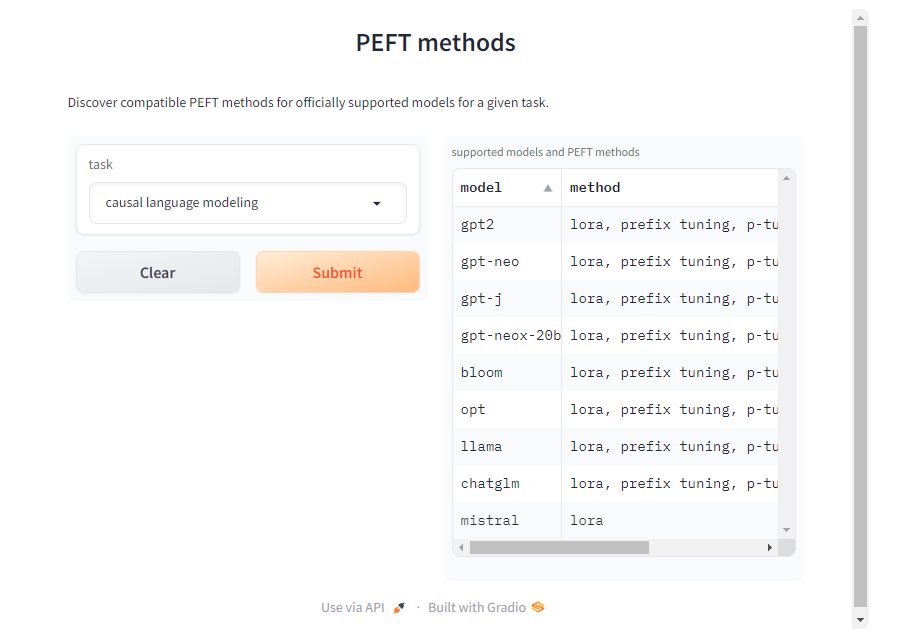
Đầu tiên, chúng ta tải mô hình và tokenizer từ mô hình bloomz-560m của BigScience. Tokenizer dùng để xử lý văn bản đầu vào, trong khi mô hình nền tảng đảm nhiệm các tác vụ mô hình hóa ngôn ngữ nhân quả. Tham số trust_remote_code=True cho phép bạn sử dụng mã tùy chỉnh do nhà duy trì mô hình cung cấp cho các kiến trúc cụ thể.
Dù điều này hữu ích để có đầy đủ chức năng, chỉ nên tin tưởng mã của mô hình nếu nó đến từ nguồn uy tín. Tránh sử dụng mã không đáng tin với các mô hình từ tác giả không rõ hoặc chưa được xác minh, vì có thể gây rủi ro về bảo mật hoặc ổn định.
from transformers import AutoModelForCausalLM, AutoTokenizer
model_name = "bigscience/bloomz-560m"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    trust_remote_code=True
)Trước khi tuning, điều quan trọng là thiết lập một đường cơ sở bằng cách chạy suy luận với mô hình nền tảng chưa được tuning. Sử dụng một prompt như "I want you to act as a logistician," chúng ta có thể quan sát cách mô hình tạo phản hồi khi chưa tuning. Hãy đảm bảo thêm một khoảng trắng sau prompt, nếu không mô hình có thể không tạo ra gì.
Điều này đóng vai trò mốc tham chiếu để so sánh cải thiện sau khi tuning.
Chúng ta sẽ dùng hàm tùy chỉnh generate_text để thao tác dễ dàng hơn.
def generate_text(model, tokenizer, prompt_text, max_tokens):
    prompt_text = tokenizer(prompt_text, return_tensors="pt")
    outputs = model.generate(
        input_ids=prompt_text["input_ids"],
        attention_mask=prompt_text["attention_mask"],
        max_length=max_tokens,
        repetition_penalty=1.5,
        eos_token_id=tokenizer.eos_token_id
    )
    return tokenizer.batch_decode(outputs, skip_special_tokens=True)


initial_output = generate_text(model, tokenizer, "I want you to act as a logistician. ", 100)
print("Initial model output:", initial_output)
Đây là đầu ra của mô hình:
['I want you to act as a logistician. You will be able to: Analyze the data']
Như bạn thấy, mô hình chưa thực sự nắm rõ ngữ cảnh.
Bộ dữ liệu là yếu tố then chốt của prompt tuning. Chúng tôi sử dụng bộ dữ liệu `awesome-chatgpt-prompts` để tuning. Bộ dữ liệu này cung cấp nội dung mang tính định hướng cho việc tuning, đảm bảo mô hình điều chỉnh phản hồi tương ứng.
from datasets import load_dataset

dataset_prompt = "fka/awesome-chatgpt-prompts"


data_prompt = load_dataset(dataset_prompt)
data_prompt = data_prompt.map(lambda x: tokenizer(x["prompt"]), batched=True)
train_prompts = data_prompt["train"].select(range(50))
Chúng ta token hóa bộ dữ liệu và chuẩn bị một tập con nhỏ cho huấn luyện.
Giờ đến phần thú vị nhất; chúng ta cấu hình prompt tuning bằng lớp PromptTuningConfig từ thư viện PEFT.
from peft import  get_peft_model, PromptTuningConfig, TaskType, PromptTuningInit

tuning_config = PromptTuningConfig(
    task_type=TaskType.CAUSAL_LM, #This type indicates the model will generate text.
    prompt_tuning_init=PromptTuningInit.RANDOM,  #The added virtual tokens are initializad with random numbers
    num_virtual_tokens=4, #Number of virtual tokens to be added and trained.
    tokenizer_name_or_path=model_name
)

peft_model = get_peft_model(model, tuning_config)
Các tham số huấn luyện được chỉ định bằng lớp TrainingArguments.
from transformers import TrainingArguments
training_args = TrainingArguments(
    use_cpu=True, # This is necessary for CPU clusters.
    output_dir = "./",
    auto_find_batch_size=True, # Find a suitable batch size that will fit into memory automatically, you can also use a custom batch size
    learning_rate= 0.005,
    num_train_epochs=5
    )
Một đối tượng Trainer quản lý quá trình huấn luyện. Với DataCollatorForLanguageModeling, bộ gom dữ liệu đảm bảo các mẫu huấn luyện được định dạng phù hợp. Giai đoạn huấn luyện được khởi động bằng phương thức train, tinh chỉnh mô hình bloomz-560m cho các tác vụ prompt cụ thể.
from transformers import Trainer, DataCollatorForLanguageModeling
trainer = Trainer(
    model=peft_model, # We pass in the PEFT version of the foundation model, bloomz-560M
    args=training_args, #The args for the training.
    train_dataset=train_prompts, #The dataset used to train the model.
    data_collator=DataCollatorForLanguageModeling(tokenizer, mlm=False) # mlm=False indicates not to use masked language modeling
    )
trainer.train()Mô hình đã tuning được lưu trong đối tượng trainer, chúng ta có thể dùng trainer.model để truy cập. Hãy dùng hàm generate_text để chạy suy luận với mô hình đã tuning!
tuned_output = generate_text(trainer.model, tokenizer, "I want you to act as a logistician. ", 100)
print("Tuned model output:", tuned_output)
Đây là đầu ra của mô hình đã tuning:
['I want you to act as a logistician. You will be responsible for the logistics of your business.']
Như bạn thấy, giờ mô hình đã biết một logistician làm gì. Hãy thoải mái thử nghiệm với các prompt, mô hình và bộ dữ liệu khác nhau!
Prompt tuning là một công cụ mạnh mẽ để giúp các mô hình ngôn ngữ lớn hiệu quả hơn cho một tác vụ cụ thể. Chúng ta đã khám phá prompt tuning bằng cách giải thích nó là gì và hoạt động ra sao. Sau đó, chúng ta so sánh với các kỹ thuật tương tự: fine-tuning và prompt engineering. Cuối cùng, chúng ta thảo luận lợi ích và đi qua hướng dẫn từng bước áp dụng prompt tuning cho một mô hình đã huấn luyện sẵn.
Khi lĩnh vực AI sinh sinh (generative AI) tiếp tục phát triển, việc cập nhật những tiến bộ mới nhất là rất quan trọng. Để nâng cao hơn nữa kỹ năng và hiểu biết về AI, Datacamp cung cấp nhiều tài nguyên chuyên sâu. Tôi khuyến khích bạn khám phá các hướng dẫn toàn diện sau:
Tiếp tục học cùng DataCamp
Lộ trình
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
