Podgląd następnego klocka pokazuje literę tetromina — O, I, T, S, Z — zamiast rysować kształt. Da się to czytać, gdy znasz notację, ale za każdym razem kosztuje ułamek sekundy, a przy szybkości to ma znaczenie. Żaden model nie był proszony o podgląd, więc to wybór, który Sol zaproponował i zbudował zbyt skromnie. To jedyne miejsce, gdzie bardziej dopracowana wersja jest mniej czytelna.
Co dostarczył Claude Opus 5.5
Opus 5.5 potrzebował 3 tur i 2 wywołań narzędzi, jednego glob i jednego zapisu, by dostarczyć 19 KB index.html nazwany „Flip Tetris”. Jego komentarz w nagłówku to staranniejsza specyfikacja z obu: randomizer 7-bag na stałym ziarnie, rotacja z wall kickami, osobne zapadanie rzędów per stos i uwaga, że klocek w locie po prostu odwraca kierunek, gdy grawitacja się zmienia.
Gra działa dokładnie jak opisano i tak samo stabilnie jak u Sol, z „duchem” klocka i paskiem odliczania, który przed flipem robi się czerwony. Podgląd następnego klocka rysuje faktyczny kształt, co jest słusznym wyborem i jedyną rzeczą, którą robi lepiej niż Sol na pierwszy rzut oka.
Dodał też licznik poziomu, o który nikt nie prosił, i uznałbym to za remis, nie plus: poziomy rosną tak powoli, że nie mają znaczenia, dopóki nie zajdziesz znacznie głębiej niż te buildy będą realistycznie grane. Tam, gdzie Opus traci, to feeling, nie logika: layout jest skromniejszy niż u Sol, a soft drop mniej płynny, więc traci punkt za jakość wizualną i jeden za kompletność.
Wyniki
| Miara | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Tury | 6 | 3 |
| Wywołania narzędzi | 9 | 2 |
| Koszt | 0,26 USD | 0,87 USD |
| Łącznie tokenów | 120 226 | 107 958 |
| Tokeny rozumowania | 8 123 | 22 551 |
| Uruchamialność | zaliczony | zaliczony |
| Mechanika flipu | 5 | 5 |
| Kompletność gry | 5 | 4 |
| Jakość wizualna i feeling | 5 | 4 |
| Wynik wg rubryki (średnia z trzech osi) | 5 | 4,3 |
GPT-6 Sol wygrywa ten test, ale niewielką różnicą i nie na trudnym elemencie. Obydwa poprawnie obsłużyły flip grawitacji, więc przewaga sprowadziła się do rzemiosła, a responsywność i wizualny szlif Sol dają mu przewagę nad Opus.
Bardziej wyraźnie różni je koszt przebiegów. Opus 5.5 wydał 0,87 USD wobec 0,26 USD u Sol, ponad trzykrotnie więcej, i zrobił to przy mniejszej liczbie tokenów łącznie: 108k wobec 120k. Różnicą jest rozumowanie: Opus myślał około trzy razy intensywniej na turę, osiągnął poprawny build w połowie tur i się zatrzymał. Sol iterował w pliku, tanio, i wyszedł nieco lepiej w feelingu.
To pojedynczy przebieg jednego zadania przy jednym ustawieniu wysiłku i bada logikę pętli gry w jednym pliku, nie długohoryzontową pracę na repozytoriach, którą benchmarkują dostawcy. Liczby kosztów to pojedyncze punkty danych, nie średnia.
Kiedy wybrać GPT-6 Sol vs Claude Opus 5.5
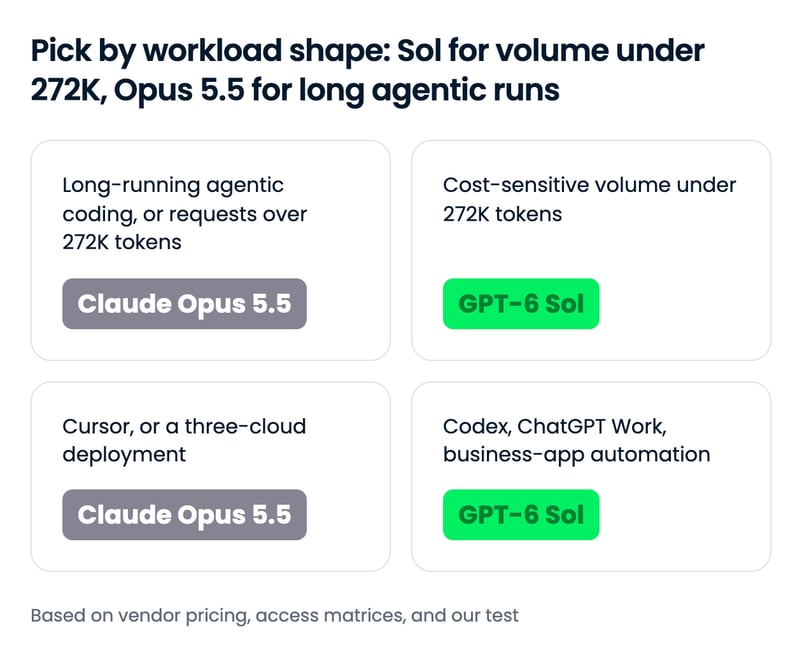
Rozgałęzienie wynika z rozmiaru żądania i kształtu obciążenia, a nie surowej mocy: poniżej 272K tokenów na żądanie zniżka Sol jest realna; powyżej, lub w pętlach mocno opartych na cache, rachunki się zbliżają, a publikowana przewaga Opus 5.5 w pracy agentowej to to, za co płacisz.
Wybierz GPT-6 Sol, jeśli...
- Uruchamiasz agentów o wysokim wolumenie, gdzie każde żądanie mieści się poniżej progu długiego kontekstu. Połowa ceny katalogowej kumuluje się przy milionach żądań, a stawka odczytu z cache i tak jest identyczna.
- Twój zespół już pracuje w Codex lub ChatGPT Work. Sol jest tam dostępny we wszystkich płatnych planach, a Codex to uprząż, pod którą OpenAI go stroiło.
- Automatyzujesz przepływy biznesowe w budżecie. Bieg Sol na AutomationBench kosztował 0,27 USD za zadanie, a twierdzenia OpenAI o koszcie na zadanie to jego najsilniejszy argument.
- Chcesz drabinki wysiłku, która schodzi do samego dołu. Ustawienie
nonew Sol i bezpieczne dla cache zmiany wysiłku pozwalają agentowi robić tanie follow-upy i eskalować tylko trudne kroki.
Wybierz Claude Opus 5.5, jeśli...
- Twoja praca to długotrwałe agentowe kodowanie: migracje, audyty i zadania wielorepozytoryjne. Opus 5.5 publikuje mocniejsze wyniki w każdym benchmarku agentowego kodowania, który raportuje, a anegdoty testerów dotyczą zadań trwających godziny.
- Twoje żądania rutynowo przekraczają próg długiego kontekstu Sol. Anthropic rozlicza pełne 1 mln okna w stawkach standardowych, a dopłata Sol zamyka większość różnicy w cenie przy tym rozmiarze.
- Potrzebujesz modelu w Cursor lub dziś na trzech hyperscalerach. Opus 5.5 jest na liście w Cursor i na Bedrock, Vertex AI oraz Microsoft Foundry; Sol nie jest dostępny w Cursor ani Vertex AI.
- Uruchamiasz agentów bez nadzoru i chcesz bardziej konserwatywnego modelu. Ewaluacja ograniczeń Anthropic i zabezpieczenia klasy Fable są dokładnie do tego, o ile twoja praca nie dotyczy cyberbezpieczeństwa.
Jak zacząć z GPT-6 Sol i Claude Opus 5.5
| Powierzchnia | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Aplikacja konsumencka | ChatGPT Work i Codex w planach Plus, Pro, Business, Enterprise i Edu; jeszcze nie w czacie ChatGPT | Aplikacje Claude; limity użycia podniesione w planach Pro, Max, Team i Enterprise na starcie |
| API pierwszej strony | Tak, OpenAI API (zalecane Responses API) | Tak, Claude API |
| Platformy chmurowe | Azure AI Foundry, AWS Bedrock | AWS Bedrock, Google Cloud Vertex AI, Microsoft Foundry |
| Agenci do kodowania | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| Routery zewnętrzne | OpenRouter, Vercel AI Gateway | OpenRouter, Vercel AI Gateway |
| ID modelu w API | gpt-6-sol | claude-opus-5-5 |
Opus 5.5 zadebiutował na wszystkich trzech głównych chmurach i w Cursor pierwszego dnia, podczas gdy Sol jest na dwóch chmurach i nie figuruje na liście modeli Cursor. W API stringi to gpt-6-sol i claude-opus-5-5.
Używanie GPT-6 Sol i Claude Opus 5.5 w agencie do kodowania
Każdy model jest dostarczany wewnątrz własnego agenta dostawcy, Codex dla Sol i Claude Code dla Opus 5.5, a oba są do wyboru w GitHub Copilot. Jeśli chcesz jednej uprzęży dla obu, agent oparty o router, taki jak OpenCode, sięga po nie przez OpenRouter jako openai/gpt-6-sol i anthropic/claude-opus-5.5, co pozwoliło nam uruchomić test na identycznych narzędziach.
Bezpośrednie wywołania API używają innych SDK, więc podmiana to klient i string modelu, a nie jedna linia:
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-sol",
reasoning={"effort": "high"},
input="Refactor this module and explain what you changed.",
)
print(response.output_text)from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=4096,
messages=[{"role": "user", "content": "Refactor this module and explain what you changed."}],
)
print(response.content[0].text)Pełne konfiguracje agentów omawiają nasze tutorial CLI Codex i tutorial Claude Code dotyczące instalacji i przepływów, a także nasze porównanie Codex vs Claude Code ważące same uprzęże.
Ostatnie uwagi
Jeśli twoje obciążenie to długie, agentowe kodowanie lub żądania przekraczają próg długiego kontekstu, użyj Claude Opus 5.5: publikuje mocniejsze liczby agentowe i nie karze cenowo dużych żądań. Jeśli działasz z wolumenem poniżej progu, żyjesz w Codex lub ChatGPT Work albo automatyzujesz aplikacje biznesowe w budżecie, użyj GPT-6 Sol i odłóż różnicę.
Najciekawsze jest to, że żaden dostawca nie zdołał umieścić nowego modelu konkurenta w swojej tabeli, a tam, gdzie mogliśmy porównać je sami — samowystarczalny build — tańszy model wyszedł lepiej pod względem szlifu.
Jeśli chcesz tworzyć z którymkolwiek z modeli, polecamy nasze kursy Working with the OpenAI API oraz Introduction to Claude Models.
FAQ
Kiedy powinienem użyć GPT-6 Sol zamiast Claude Opus 5.5?
Użyj GPT-6 Sol, gdy twoje żądania mieszczą się poniżej 272K tokenów wejściowych i liczy się wolumen: jego cennik to 2 USD za 1 mln tokenów wejścia i 10 USD za 1 mln tokenów wyjścia, czyli połowa stawek Claude Opus 5.5 (4 USD i 20 USD). To także naturalny wybór, jeśli twój zespół pracuje w Codex lub ChatGPT Work. Wybierz Opus 5.5 do długotrwałego agentowego kodowania, dla żądań powyżej 272K tokenów lub gdy potrzebujesz modelu w Cursor albo na wszystkich trzech głównych chmurach.
O ile tańszy jest GPT-6 Sol od Claude Opus 5.5?
W cenniku Claude Opus 5.5 kosztuje dokładnie dwa razy tyle co GPT-6 Sol dla wejścia (4 USD vs 2 USD za 1 mln tokenów), wyjścia (20 USD vs 10 USD) i zapisów do cache (5 USD vs 2,50 USD). Odczyty z cache kosztują 0,20 USD za 1 mln tokenów w obu. Sol nalicza 2x wejście i 1,5x wyjście przy każdym żądaniu powyżej 272K tokenów wejściowych, podczas gdy Anthropic rozlicza pełne 1 mln kontekstu w stawkach standardowych, więc różnica maleje do około 8% przy wyszukiwaniu w długim kontekście i do około 33% w pętlach agentów mocno używających cache.
Jakie są ID modeli w API dla GPT-6 Sol i Claude Opus 5.5?
W OpenAI API GPT-6 Sol to gpt-6-sol. W Claude API Claude Opus 5.5 to claude-opus-5-5, a w Amazon Bedrock to anthropic.claude-opus-5-5. Przez OpenRouter są to openai/gpt-6-sol i anthropic/claude-opus-5.5.
Gdzie mogę uzyskać dostęp do GPT-6 Sol i Claude Opus 5.5?
GPT-6 Sol jest dostępny w ChatGPT Work i Codex dla użytkowników Plus, Pro, Business, Enterprise i Edu, przez OpenAI API, na Azure AI Foundry i AWS Bedrock, w GitHub Copilot oraz przez OpenRouter; nie ma go jeszcze w konsumenckim czacie ChatGPT. Claude Opus 5.5 jest dostępny w aplikacjach Claude, przez Claude API, na AWS Bedrock, Google Cloud Vertex AI i Microsoft Foundry oraz w Claude Code, Cursor i GitHub Copilot.
Który jest lepszy do kodowania, GPT-6 Sol czy Claude Opus 5.5?
W opublikowanych benchmarkach prowadzi Claude Opus 5.5: Anthropic raportuje 66,4% na Terminal-Bench 4.0 i 54,4% na FrontierCode, podczas gdy OpenAI mówi, że GPT-6 Sol dorównuje Claude Fable 5.1 na FrontierCode, który Anthropic ocenia na 50,3%. W naszym praktycznym teście — jednoplikowy klon Tetrisa z flipem grawitacji — oba modele poprawnie rozwiązały logikę, a GPT-6 Sol zdobył 5,0 wobec 4,3 Opus 5.5 za szlif i feeling.
Uwaga poświęcona nowemu modelowi Anthropic trwała ledwie godzinę w wyścigu po bardziej wydajne i przystępne cenowo modele z czołówki.
Claude Opus 5.5 to pierwszy model z rodziny Claude 5.5, reklamowany jako wydajność na poziomie Fable 5.1 przy niższym koszcie działania niż Opus 5.
OpenAI odpowiedziało bardzo szybko, publikując GPT-6 Sol jako środkowy wariant rodziny GPT-6, trenowany tymi samymi metodami co flagowy GPT-6 Astra i wprowadzony na rynek w połowie ceny API jego poprzednika, GPT-5.6 Sol.
W tym artykule porównam GPT-6 Sol i Claude Opus 5.5 w wielu kategoriach wydajności, zabezpieczeniach i cenach oraz dołączę jeden praktyczny test budowy, który uruchomiłem na obu.
TL;DR
Czym jest GPT-6 Sol?
GPT-6 Sol to środkowy model GPT-6 od OpenAI, wydany 22 września 2026 roku, razem z GPT-6 Luna i pozycjonowany poniżej flagowego GPT-6 Astra.
Jego atutem jest receptura treningowa Astry za połowę ceny API GPT-5.6 Sol, z cache’owaniem promptów, które przetrwa zmiany nakładu rozumowania lub narzędzi w trakcie rozmowy.
Nasz przewodnik po GPT-6 Sol i Luna omawia premierę, a nasz tutorial API GPT-6 Astra prowadzi przez asynchroniczne narzędzia i sterowanie w tej rodzinie.
Czym jest Claude Opus 5.5?
Claude Opus 5.5 to pierwszy model Claude 5.5 od Anthropic, wydany 22 września 2026 roku, jako nowy wiodący model firmy do długotrwałego agentowego kodowania i pracy z wiedzą.
Jego atutem są wyniki klasy Fable w cenach Opus: Anthropic twierdzi, że dorównuje Claude Fable 5.1 w większości zadań i dostarcza zabezpieczenia z zakresu cyberbezpieczeństwa i biologii na poziomie Fable.
Nasz przewodnik po Opus 5.5 opisuje premierę, a nasz tutorial API Claude Opus 5 omawia API poprzedniej generacji.
GPT-6 Sol vs Claude Opus 5.5: porównanie bezpośrednie
Ze względu na bliskie terminy premier żaden dostawca nie umieścił nowego modelu konkurenta w swojej tabeli, więc modele pokrywają się tylko na dwóch benchmarkach i w obu prowadzi Opus 5.5. Argument Sol opiera się na cenie i na tym, jak poradził sobie w naszym teście.
nonedomax; mniej mylących twierdzeń o swojej pracy kodowej niż GPT-5.6 SolKodowanie i przepływy agentowe
Opus 5.5 publikuje mocniejsze liczby dla agentowego kodowania, a wpis o Sol nie kwestionuje ich bezpośrednio. Anthropic raportuje Opus 5.5 na Terminal-Bench 4.0, FrontierCode i CursorBench; OpenAI raportuje Sol na DeepSWE i opisuje wynik na FrontierCode tylko jako dopasowanie do Claude Fable 5.1 przy xhigh. Anthropic podaje Fable 5.1 na 50,3% na FrontierCode wobec 54,4% dla Opus 5.5, więc jeśli oba twierdzenia się utrzymują, Sol wypada około cztery punkty za Opus 5.5 w jedynym benchmarku kodowania, o którym wspominają obaj dostawcy.
Obaj dostawcy opierają się na długohoryzontowych anegdotach zamiast wspólnych wyników. Wewnętrzne przepisywanie HAProxy z C na Rusta w Anthropic skończyło się w 9,5 godziny dla Opus 5.5 wobec 12 dla Fable 5.1 przy 51% niższym koszcie. Argument OpenAI to koszt na zadanie: Sol ląduje w okolicach jednego punktu od wyniku Fable 5 na DeepSWE przy około 80% niższym koszcie.
Dwa powody, by traktować te tabele z rezerwą:
Na papierze Opus 5.5 to mocniejszy model do kodowania; nasz pojedynczy test budowy poniżej to miejsce, gdzie ta różnica się nie ujawniła.
Przepływy biznesowe i obsługa komputera
Opus 5.5 prowadzi w obu współdzielonych benchmarkach, a różnica na AutomationBench to najczystsza liczba w tym artykule: 40,0% dla Opus 5.5 wobec 33,2% dla Sol w teście Zapiera dla agentów pracujących w 47 narzędziach biznesowych.
Kontrargument Sol to rachunek: OpenAI przedstawia Sol jako pokonujący Claude Opus 5 przy 9% kosztu zadania Opus 5, choć porównanie dotyczy poprzedniego Opus, nie tego.
Opus 5.5 jest silniejszym agentem w punktacji; Sol to ten, którego stać, by działał na każdym zgłoszeniu.
Praca z wiedzą i rzetelność faktów
Opus 5.5 ma tu jedyną liczbę między dostawcami: 1846 Elo na GDPval-AA v2.1, przed wynikami GPT-6 Astra i GPT-5.6 Sol w tabeli Anthropic; samego Sol nie wymieniono. W teście pisania raportów Anthropic, gdzie dowolna wymyślona liczba oblewa run, 16 z 18 raportów Opus 5.5 przeszło, a ani Fable 5.1, ani Opus 5 nie zaliczyły ani razu.
Dowody Sol są wobec własnego poprzednika: na wewnętrznym zbiorze faktograficznym OpenAI Sol popełnia około dwa razy mniej błędów niż GPT-5.6 Sol. Test AA-Omniscience Artificial Analysis się zgadza, z haczykiem: wskaźnik halucynacji Sol spadł z 92% do 60%, podczas gdy odpowiedział tylko na 83% pytań wobec 99% u poprzednika.
Oba są ostrożniejsze niż poprzednicy; tylko Opus 5.5 pokazał to na tle rywala.
Zabezpieczenia i ograniczenia API
Sol to mniej ograniczone API, a Opus 5.5 jest bardziej nadzorowany.
Opus 5.5 nie może działać z wyłączonym myśleniem, odrzuca wymuszone użycie narzędzi i wiąże bloki myślenia z modelem oraz rozmową, które je wytworzyły, więc edytowany kontekst kończy się błędem 400 na kontach utworzonych po 31 sierpnia 2026. Większość zadań z cyberbezpieczeństwa jest przekierowana do Opus 4.8 poza jego Cyber Verification Program, a prace biologiczne wymagają Life Sciences Verification Program.
Drabinka Sol biegnie od
nonedomax, wysiłek można zmieniać w trakcie rozmowy bez psucia cache, a OpenAI raportuje mniej mylących twierdzeń o jego pracy kodowej niż u GPT-5.6 Sol.To celowy kompromis: Opus 5.5 próbował przekraczać granice kontenerów około 85% rzadziej niż Opus 5, co ma znaczenie dla agentów bez nadzoru.
Cennik: ile faktycznie zapłacisz
Opus 5.5 kosztuje dokładnie dwukrotność Sol w stawkach bazowych, ale dwa mechanizmy, za które agenci faktycznie płacą, łamią schemat: odczyty z cache kosztują tyle samo, a Sol dodaje dopłatę powyżej 272K tokenów, której Anthropic nie ma.
Stawki tokenów obok siebie
Premia jest stała dla wejścia, wyjścia i zapisów do cache, więc uderza w każdy kształt obciążenia jednakowo, dopóki nie wchodzi w grę cache lub długi kontekst. Wyjątkiem są odczyty z cache i Anthropic twierdzi, że stanowią one większość kosztu pracy agentowej i kodowania. Żaden dostawca nie publikuje osobnej stawki dla tokenów rozumowania, więc budżetuj je po stawce wyjścia.
Ile kosztuje realne obciążenie
Wiersz z przekroczeniem progu to sedno: gdy każde żądanie przekracza próg, dopłata Sol podnosi rachunek do poziomu w odległości 8% od Opus 5.5, więc rurociąg wyszukiwania w długim kontekście niemal nie zyskuje rabatu, wybierając Sol. Pętla z ciężkim cache zawęża różnicę do 33% z innego powodu: 1000 odczytów z cache kosztuje tyle samo w obu modelach, a tylko świeże tokeny niosą 2x premię.
Modele używają różnych tokenizatorów i żaden dostawca nie opublikował liczby tokenów dla wspólnego obciążenia, więc traktuj te sumy jako porównanie stawek, nie rachunku. Anthropic mówi, że Opus 5.5 używa mniej tokenów na zadanie niż Opus 5, ale nie porównuje tego z Sol.
Jak wypadły GPT-6 Sol i Claude Opus 5.5
Benchmarki od dwóch dostawców, którzy nie testowali wzajemnie nowych modeli, mają ograniczoną wartość, więc uruchomiłem jedno zadanie budowy przeciw obu z identycznym promptem i identycznymi narzędziami.
Test
Poprosiłem oba, by zbudowały jednoplikowego klona Tetrisa na planszy 12×24 z jednym twistem: grawitacja odwraca się co 20 sekund. Dwa elementy wymagane przez prompt czynią to trudnym: po odwróceniu klocki muszą spadać w stronę sufitu i blokować się na drugim stosie tamże, z czyszczeniem pełnych rzędów na obu stosach, a już zablokowane komórki nigdy nie mogą się poruszyć.
Oba modele działały w OpenCode z identycznym przypiętym zestawem narzędzi: tylko czytanie, wyszukiwanie i edycja plików, bez shella i bez sieci. Oba działały przy wysiłku rozumowania
high, po jednej próbie, bez retry, a prompt dostarczono bajt w bajt do świeżej sesji.Jedna asymetria do zapamiętania:
highjest o dwa szczeble poniżej sufitu w obu drabinkach, ale drabinka Sol ma dodatkowy dolny szczebelnone, więchighto u niego czwarty z sześciu poziomów, a u Opus 5.5 trzeci z pięciu.To był prompt:
Nagrałem koszt i oceniłem oba według trzech kryteriów, ze skalą 1–5:
Co dostarczył GPT-6 Sol
Sol potrzebował 6 tur i 9 wywołań narzędzi: wypisał, wyszukał i odczytał pustą przestrzeń roboczą, zanim zapisał 22 KB
index.html, po czym raz go spatchował. To, co powstało, ma własny branding „Fall / Rise, a game of shifting ground”, z panelem grawitacji, który przy flipie zmienia kolor z bursztynu na turkus, odliczaniem do następnej inwersji i kartą zasad na marginesie.Robi to, co powinno, działa płynnie i stabilnie: stos na podłodze pozostaje na miejscu przy flipie, klocki wznoszą się i blokują przy suficie, rzędy czyszczą się na obu stosach, a soft drop jest responsywny, co sprawiło, że granie było przyjemniejsze niż w drugim przypadku.