Você quer começar a usar a IA generativa?
Saiba como trabalhar com LLMs em Python diretamente em seu navegador
O que é o Llama 3?
O Llama 3 é uma IA de geração de texto. Assim como os modelos GPT da OpenAI e Claude da Anthropic, você escreve um prompt de texto e ele gera uma resposta em texto. Os modelos mais recentes prometem desempenho aprimorado, especialmente em compreensão de contexto e raciocínio lógico. Os modelos Llama alimentam o Meta AI, o assistente inteligente presente no Instagram, WhatsApp, Messenger e Facebook.
O Llama 3 é um modelo de "pesos abertos". Isso significa que o próprio modelo é open source, oferecendo alguma transparência sobre como realiza os cálculos. Ainda assim, os detalhes completos para recriá-lo, como os conjuntos de dados usados no treinamento, não são públicos.
Uma imagem de 3 lhamas feita com Midjourney. Prompt usado: “A cartoon of 3 llamas happily frolicking in a field”
Novas capacidades do Llama 3
O Llama 3 está disponível em dois tamanhos: um modelo com 8 bilhões de parâmetros e outro com 70 bilhões de parâmetros. Em geral, mais parâmetros resultam em respostas de melhor qualidade, mas deixam o modelo mais lento e caro para rodar. 70 bilhões de parâmetros é comparável a muitos modelos concorrentes, embora existam modelos notáveis com ainda mais parâmetros. Um terceiro modelo, maior, com 400 bilhões de parâmetros, foi anunciado como em desenvolvimento.
A janela de contexto — a quantidade de texto que pode ser considerada de uma vez — foi dobrada de 4.096 para 8.192 tokens. Um token refere-se a uma palavra ou pontuação, embora algumas palavras sejam quebradas em vários tokens. Em inglês, quatro tokens equivalem a cerca de três palavras, então a nova janela de contexto comporta aproximadamente 15 páginas de texto (considerando 400 palavras por página). Apesar do avanço, ainda está distante do estado da arte: os modelos Claude 3 oferecem janela de contexto de 200.000 tokens.
Outros recursos do modelo não foram detalhados no artigo do anúncio. Em vez disso, o foco ficou muito no ecossistema de software ao redor.
Ecossistema do Llama 3
Junto com o anúncio do Llama 3, a Meta apresentou um conjunto de ferramentas para facilitar e tornar mais seguro o trabalho com o Llama. Aqui vai um panorama.
Llama Guard 2
Llama Guard 2 é uma ferramenta baseada em LLM para classificar texto como "seguro" ou "inseguro". Pode ser usada tanto em prompts quanto em respostas. Por exemplo, ela detecta se um texto contém descrições de violência, discurso de ódio ou outros conteúdos inadequados.
Um caso de uso típico é um chatbot. Você pode checar cada prompt e, se o conteúdo for sinalizado como inseguro, exibir um aviso ou adotar outra forma de lidar com o problema. Da mesma forma, se o chatbot gerar uma resposta classificada como insegura, você pode interceptá-la e tentar novamente antes que o usuário veja.
Além do sinal seguro/inseguro, as respostas do Llama Guard 2 recebem um rótulo de segurança — uma entre onze categorias de conteúdo problemático da MLCommons AI Safety Taxonomy.
Llama Code Shield
Llama Code Shield classifica código como seguro ou inseguro. Com muitos desenvolvedores usando LLMs para ajudar a escrever código, existe o risco de código inseguro ser gerado e ir para produção. A ferramenta foi criada para ser incorporada em assistentes de codificação com IA e integrada a outras ferramentas como VSCode e DataLab.
CyberSec Eval 2
CyberSec Eval 2 permite avaliar o quão seguro é um LLM. A versão original avaliava a segurança na geração de código e a proteção contra ciberataques. A versão mais recente amplia isso, com recursos para avaliar suscetibilidade a prompt injection, capacidades ofensivas automatizadas de cibersegurança e propensão a abusar de um interpretador de código.
torchtune
torchtune é um pacote Python que funciona junto com o framework de deep learning PyTorch para facilitar o desenvolvimento de LLMs próprios. Há ferramentas para quatro tarefas:
- Criar novos modelos a partir de blocos de construção baseados em LLMs existentes
- Fazer fine-tuning de LLMs usando técnicas como LoRA e QLoRA
- Configurar parâmetros para treino, quantização e avaliação dos modelos
- Modelos de prompt e integração com datasets para treinamento mais acessível
O torchtune é integrado a plataformas populares de machine learning como a Hugging Face, Weights & Biases, EleutherAI e Executorch.
Quais são os casos de uso do Llama 3?
Os casos de uso do Llama 3 são os mesmos do Llama 2 e de outros LLMs. Entre os mais comuns estão:
- Chatbots: Automatizar atendimento, suporte e engajamento por meio de agentes conversacionais.
- Sumarização de documentos: Condensar documentos longos em versões curtas que destacam pontos-chave — útil em contextos jurídicos, acadêmicos e de negócios.
- Criação de conteúdo: Gerar artigos, relatórios, posts de blog e até textos criativos como poemas e histórias.
- Assistência em comunicação e e-mails: Automatizar rascunhos de e-mails, respostas e outras comunicações rotineiras.
- Descrições de produtos: Gerar automaticamente descrições únicas e atrativas para e-commerces.
- Ferramentas educacionais: Criar guias de estudo, questões de prova e conteúdos didáticos personalizados ao nível de aprendizagem dos alunos.
- Programação e geração de código: Ajudar desenvolvedores com trechos de código, depuração de código existente ou recomendações de programação.
- Relatórios de análise de dados: Resumir achados e gerar relatórios a partir de dados estruturados.
- Assistentes virtuais: Alimentar apps de assistente pessoal que organizam agendas, respondem perguntas e executam tarefas.
Como o desempenho do Llama 3 se compara?
O anúncio da Meta mostra resultados de benchmarks para as versões de oito bilhões (8B) e setenta bilhões (70B) de parâmetros do Llama 3, comparadas a outros dois modelos.
Foram usados os seguintes benchmarks:
- Massive Multitask Language Understanding (MMLU). Tarefas de matemática básica, história dos EUA, ciência da computação, direito e mais. Para alta precisão, os modelos precisam de amplo conhecimento de mundo e capacidade de resolver problemas.
- Graduate-Level Google-Proof Q&A (GPQA). Questões de múltipla escolha escritas por especialistas em biologia, física e química. As perguntas são de alta qualidade e extremamente difíceis: especialistas com ou cursando PhD atingem 74% de acurácia.
- HumanEval. Teste de correção funcional de código, usado para checar geração de código.
- GSM-8K. Problemas de matemática do ensino fundamental, de alta qualidade e linguisticamente diversos.
- MATH. Problemas de matemática do ensino fundamental II e médio.
O Llama 3 8B foi comparado ao Gemma 7B It do Google e ao Mistral 7B Instruct. São LLMs de tamanho semelhante (número de parâmetros parecido), modelos de pesos abertos disponíveis na plataforma Hugging Face e voltados para casos de uso parecidos. Os resultados estão na Figura 1.
O Llama 3 8B supera com folga os outros dois modelos em todos os cinco benchmarks.
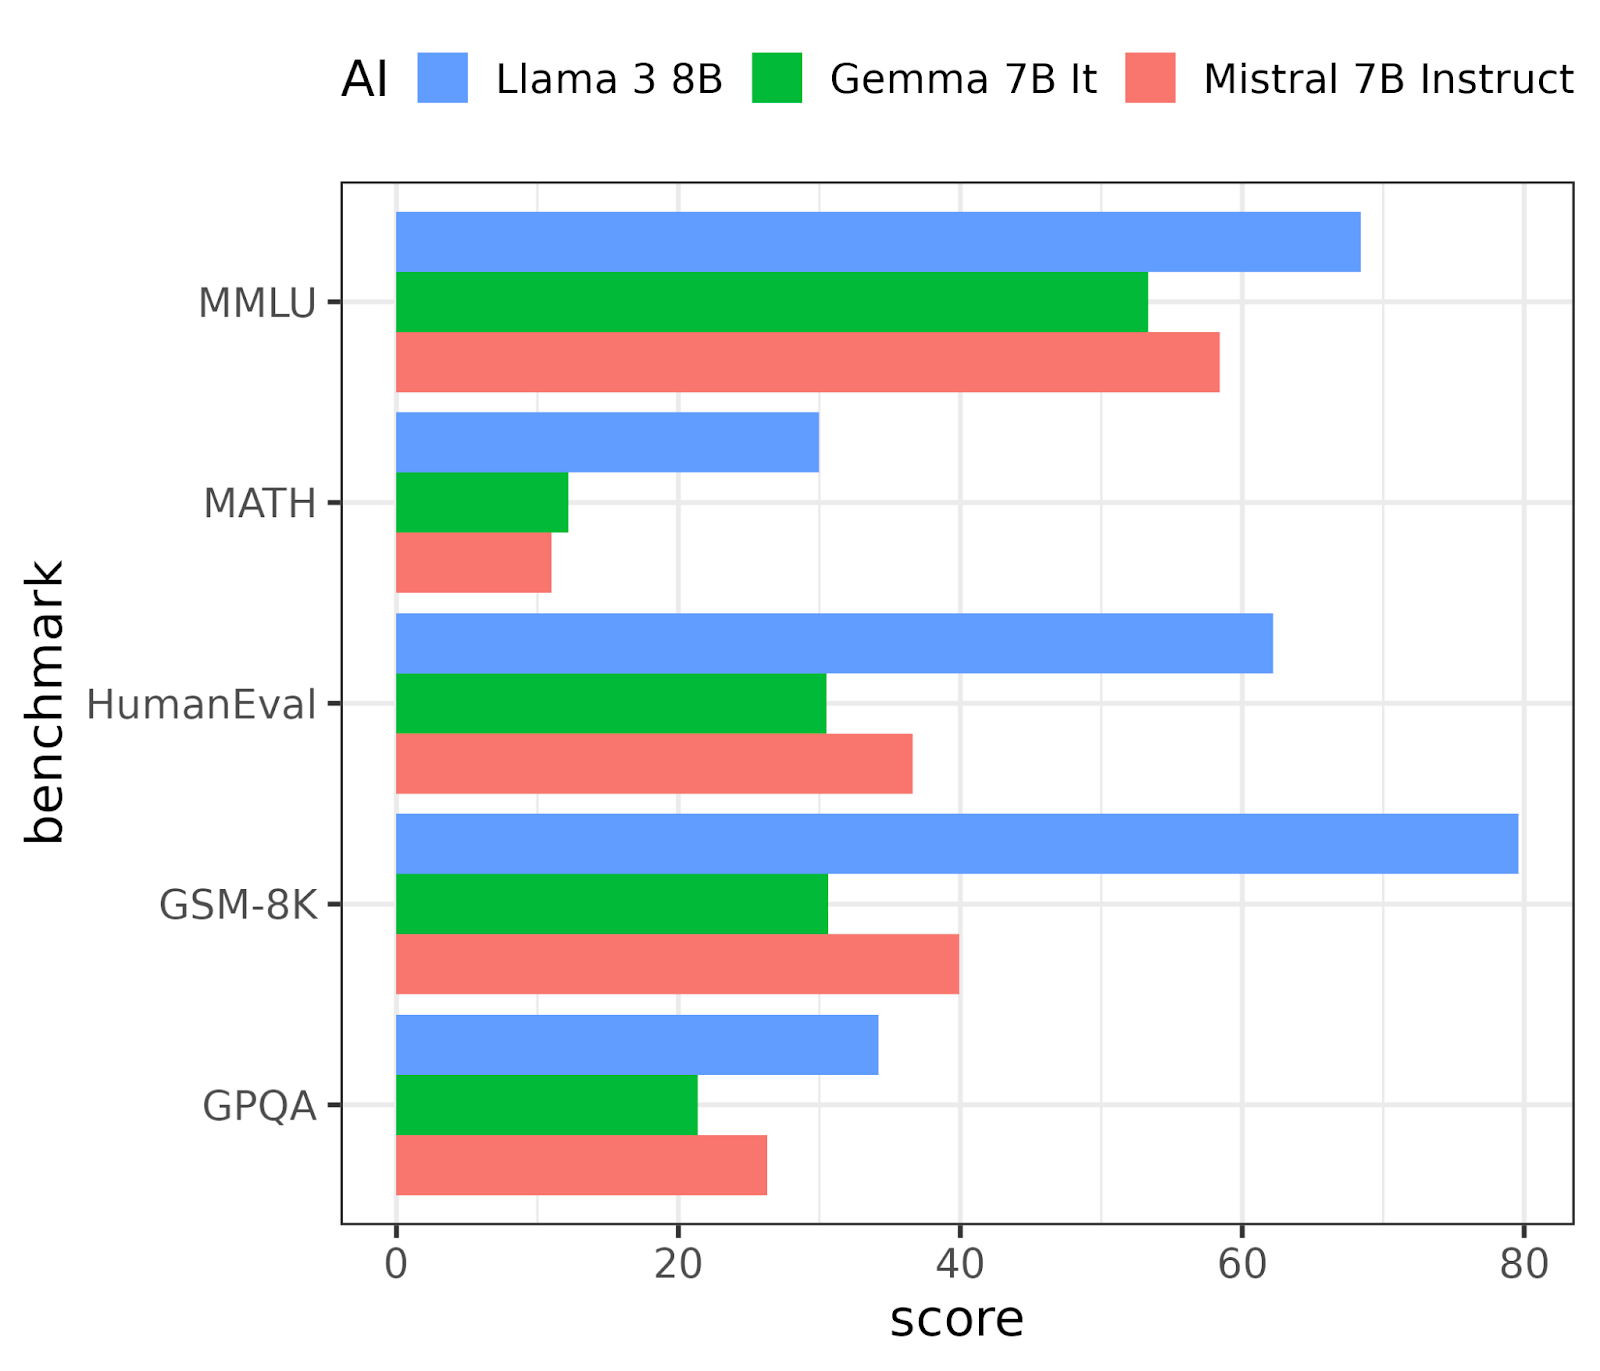
Figura 1. Desempenho do Llama 3 8B em comparação com dois modelos semelhantes em 5 benchmarks de LLM.
O Llama 3 70B foi comparado ao Gemini Pro 1.5 do Google DeepMind e ao Claude 3 Sonnet da Anthropic. São modelos próximos do estado da arte, embora não os mais potentes disponíveis (o topo hoje oscila entre o GPT-4 Turbo da OpenAI e o Claude 3 Opus da Anthropic). Os resultados estão na Figura 2.
Aqui, o desempenho fica praticamente empatado em três dos benchmarks. O Llama 3 80B vence no HumanEval (geração de código) e fica em segundo lugar atrás do Gemini Pro 1.5 no MATH.
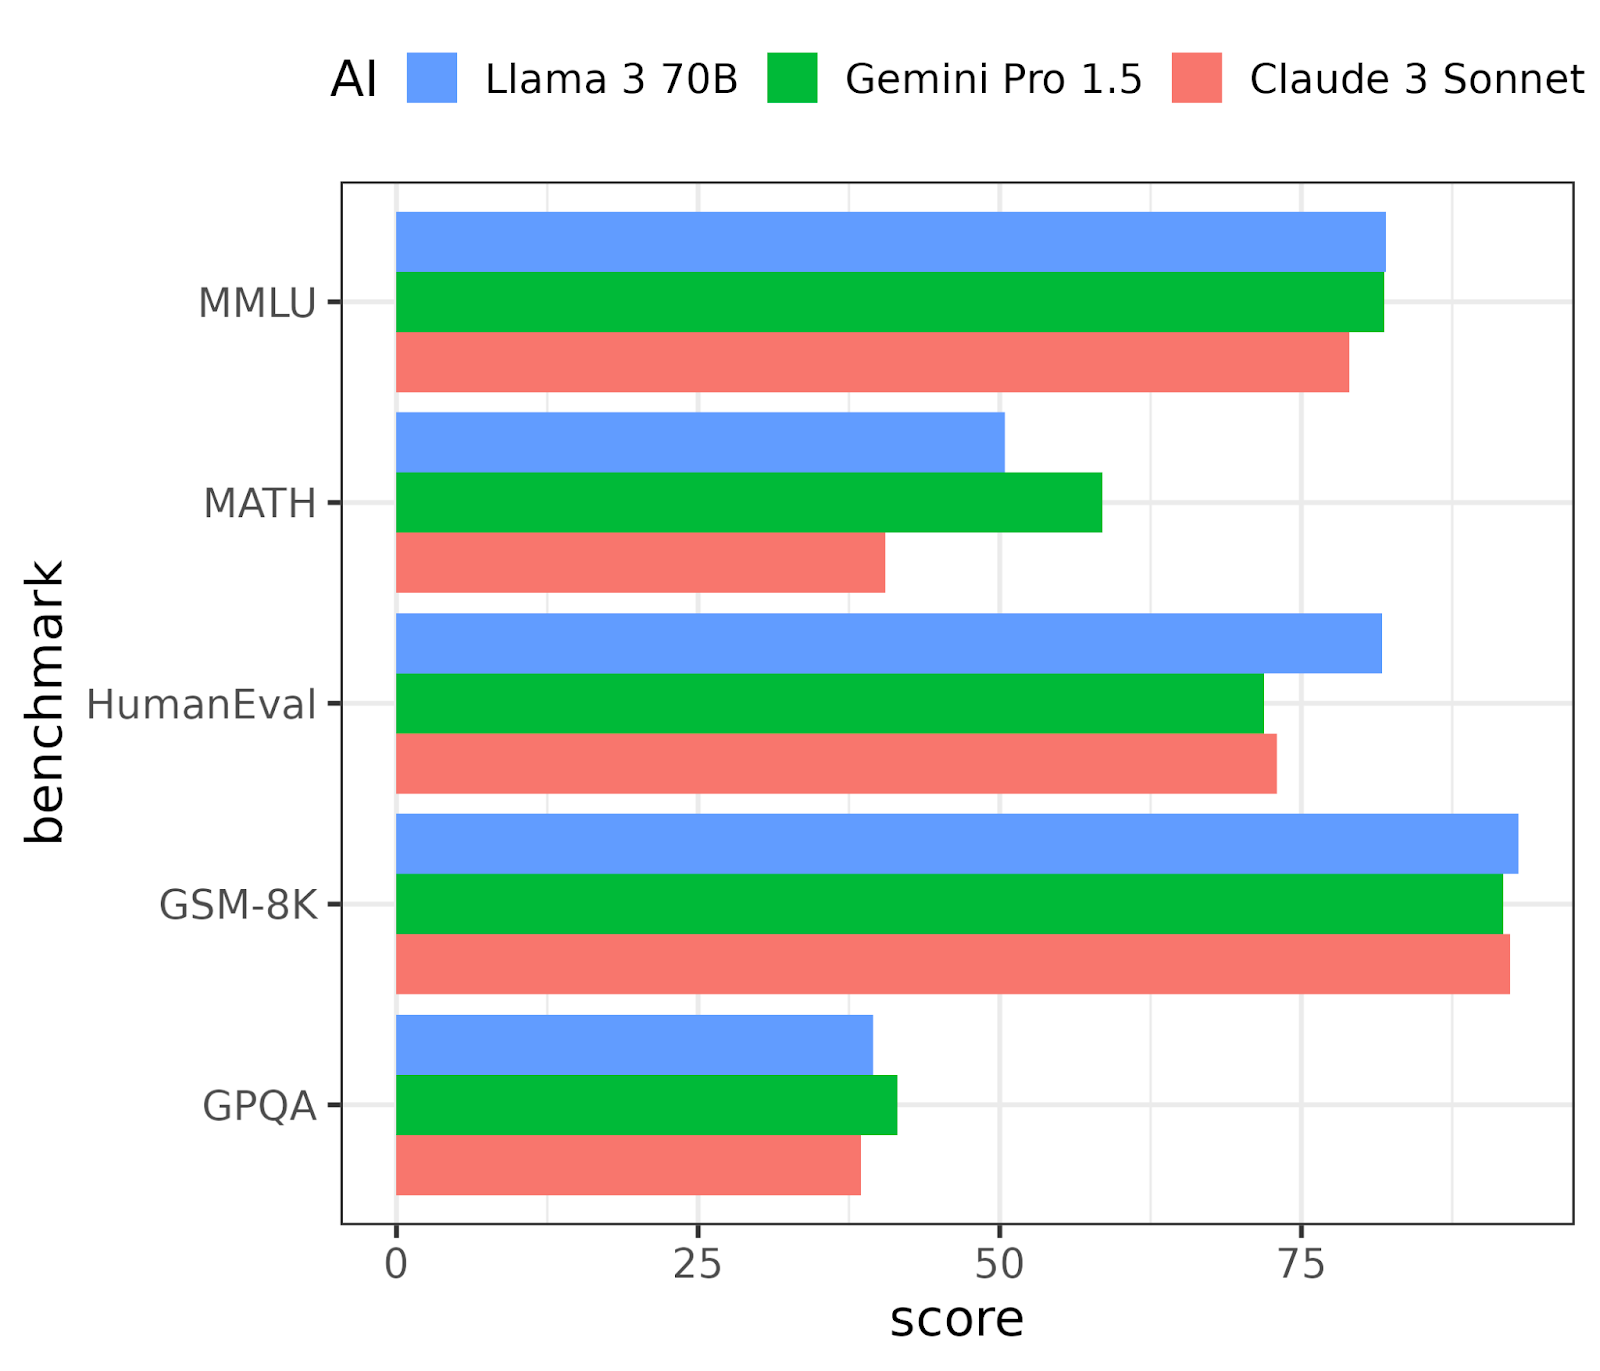
Figura 2. Desempenho do Llama 3 70B em comparação com dois modelos semelhantes em 5 benchmarks de LLM.
Interpretando os resultados dos benchmarks
Existem mais de cinco benchmarks: o Llama 3 foi avaliado em 15, mas apenas os resultados de cinco foram exibidos no anúncio. Da mesma forma, há muitas outras opções de LLMs para comparar. Não está claro até que ponto houve seleção dos resultados pela Meta ao apresentá-los.
Em segundo lugar, qualidade de saída é apenas uma métrica de desempenho. Tempo e custo para gerar respostas também são importantes e não foram abordados no anúncio.
Por fim, o desempenho sempre varia por caso de uso. Para ter resultados fiéis ao seu contexto, é preciso testar com seus próprios problemas e hardware.
Ranking da Chatbot Arena
Nos dias após o anúncio da Meta, o desempenho do Llama 3 apareceu no LMSYS Chatbot Arena Leaderboard, um ranking público de LLMs. O Llama 3 70B está atualmente em 6º lugar, a melhor posição entre os LLMs de pesos abertos. (Fica atrás de várias versões do OpenAI GPT-4, Anthropic Claude 3 Opus e Google Gemini Pro.) Já o Llama 3 8B está em 14º lugar.
São saltos de posição relevantes — vale explorar o que mudou desde o Llama 2.
Como o Llama 3 funciona?
O Llama 3 usa uma arquitetura transformer apenas com decodificador (decoder-only), como seus predecessores e a série GPT. Essa é a arquitetura mais comum para modelos que geram texto. (O tipo oposto, apenas com codificador, é usado para entender ou classificar o texto fornecido pelo usuário.)
O anúncio do Llama 3 não descreve mudanças radicais na estrutura do modelo ou no processo de treinamento. Em vez disso, há muitas otimizações equilibrando qualidade de resposta, velocidade e esforço de desenvolvimento.
Um novo tokenizador, usado para converter texto em tokens, é mais eficiente: prompts e respostas ocupam 15% menos tokens, permitindo colocar mais texto na janela de contexto.
Um novo mecanismo de atenção — a técnica que os LLMs usam para decidir quais palavras ou frases são essenciais para gerar a saída — chamado grouped query attention, oferece um melhor equilíbrio entre qualidade e velocidade de geração em comparação com mecanismos anteriores.
O conjunto de treinamento é sete vezes maior que o do Llama 2 e contém quatro vezes mais código. Em geral, mais código nos dados de treino deixa os LLMs melhores em gerar código.
Curiosamente, o Llama 2 foi usado para avaliar e classificar dados a serem incluídos no conjunto de treinamento do Llama 3. Usar IA para criar uma IA ainda melhor é um tema clássico de ficção científica (é um ponto de enredo em O guia do mochileiro das galáxias) e agora está virando prática.
O processo pós-treinamento também foi otimizado. Depois que um LLM é criado, esse LLM “bruto” pode ser ajustado para melhorar o desempenho. A Meta destaca que o processo do Llama 3 inclui as seguintes técnicas:
- Fine-tuning supervisionado, uma técnica de machine learning supervisionado em que pares de prompts e respostas de alta qualidade fornecem exemplos de boas saídas.
- Amostragem por rejeição (rejection sampling), em que várias saídas são geradas e ranqueadas, e as piores são descartadas.
- Técnicas de aprendizado por reforço Direct Policy Optimization e Proximal Policy Optimization, nas quais o modelo recebe recompensa por boas respostas.
O que não entrou?
Algumas ausências chamaram atenção neste lançamento.
Sem IA multimodal
O ChatGPT da OpenAI combina a IA de texto GPT-4 com a IA de imagem DALL∙E 3 — ou seja, é multimodal. O anúncio da Meta sugere que tornar o Llama 3 multimodal é uma meta para um futuro próximo.
Sem IA multilíngue
O dataset do Llama 3 é descrito como contendo 95% de textos em inglês. Isso significa que o desempenho deve ser bem mais fraco em outros idiomas. Assim como a IA multimodal, uma versão multilíngue do Llama 3 está no roadmap.
Sem Mixture of Experts
Uma técnica não mencionada no anúncio foi a arquitetura mixture of experts. Nela, um LLM é composto por vários LLMs menores, especializados em tarefas mais estreitas (por exemplo, um LLM para código, outro para sumarização de documentos e outro para diálogo). Ela foi popularizada pelos modelos Mixtral da Mistral AI e é apontada como base do GPT-4 da OpenAI, entregando melhor desempenho por parâmetro. Ou seja, é possível ter o mesmo desempenho com um modelo menor (portanto, mais barato e rápido) usando essa técnica. Como a Meta não a mencionou (nem há referência no repositório do Llama 3 no GitHub), podemos supor que não foi usada.
Sem world model
Yann LeCun, Chief AI Scientist da Meta, é um grande defensor de world models, em que a IA desenvolve um modelo interno de como o mundo funciona para aprender mais rápido, executar tarefas complexas e se adaptar a situações inéditas. Não houve menção a essa arquitetura radical no anúncio, então parece não estar presente no Llama 3.
Onde posso acessar o Llama 3?
O Llama 3 está disponível para download no site oficial e no repositório do GitHub. Ele já alimenta o assistente Meta AI no Facebook, Instagram, WhatsApp e Messenger, então você pode experimentar o Llama 3 indiretamente usando o Meta AI nessas plataformas.
Integrações com AWS, Databricks, Google Cloud, Hugging Face, Kaggle, IBM WatsonX, Microsoft Azure, NVIDIA NIM e Snowflake foram prometidas como “disponíveis em breve”, permitindo acessar o Llama 3 por essas plataformas.
O Llama 3 faz diferença?
No topo do desempenho, a disputa recente entre grandes modelos de linguagem tem sido entre o GPT-4 da OpenAI e o Claude 3 Opus da Anthropic, com o Google Gemini Pro e o Command R+ da Cohere logo atrás. Ainda não sabemos se a versão maior do Llama 3 que está em desenvolvimento vai brigar pela liderança, mas, por ora, a Meta alcançou ganhos substanciais de desempenho no Llama 3.
Nos últimos anos, modelos fechados (em que os detalhes não são públicos) superaram modelos mais abertos. O fato de o Llama 3 ter ficado em 6º lugar no ranking, portanto, é significativo.
O principal objetivo de curto prazo da Meta com o Llama é simplesmente alimentar o assistente Meta AI em suas plataformas sociais. É um modelo de negócios bem diferente do da OpenAI, Anthropic ou Cohere, que vendem seus LLMs para uso em produtos de IA de outras empresas. Nesse aspecto, benchmarks de desempenho para gerar código ou resolver problemas de matemática podem não ser tão relevantes para a empresa.
A Meta tem um dataset único de posts sociais criados por bilhões de usuários e — deixando de lado a vaidade — a métrica que realmente importa é: “O Llama 3 atende bem às necessidades dos usuários de redes sociais?”
Além disso, a abordagem de pesos abertos faz com que o Llama 3 possa ser potencialmente mais barato de operar que a concorrência. Ao essencialmente “disponibilizar” a IA, a Meta pressiona para baixo os preços que os concorrentes podem cobrar por suas APIs. Isso é importante: o otimismo de 2023 e os sonhos de desempenho sempre crescente da IA generativa deram lugar a um 2024 mais pé no chão, em que executivos perceberam o quão caro é manter recursos com LLM — e desempenho por dólar virou prioridade.
Modelos de pesos abertos também são importantes quando a privacidade de dados é crucial, como em finanças, saúde ou informações pessoalmente identificáveis. Enviar dados tão sensíveis para um LLM hospedado por outra empresa (como ocorre com o GPT e outros modelos fechados) traz um risco que a maioria das empresas não quer correr. Isso obriga a usar arquiteturas mais complexas em chatbots ou outros recursos de IA para separar os dados sensíveis do LLM. Um modelo de pesos abertos como o Llama 3 pode ser hospedado onde a organização preferir, facilitando criar produtos e recursos de IA mantendo a privacidade dos dados.
Considerações finais
O Llama 3 parece ser uma evolução incremental do Llama 2. Não houve grandes mudanças de arquitetura nem anúncio de recursos marcantes.
O foco nos trade-offs entre custo e desempenho sugere que a Meta mira uma IA que rode de forma barata em grande escala. As novidades mais empolgantes estão no ecossistema: ajudar outros desenvolvedores a criar LLMs de alta qualidade com mais eficiência é um dos maiores benefícios da abordagem aberta da Meta.
Se você quer dar os primeiros passos no mundo da IA generativa, nossa trilha de habilidades AI Fundamentals vai acelerar seu aprendizado em machine learning, deep learning, NLP, modelos generativos e muito mais. Você também pode ler nossos guias sobre fine-tuning do Llama 3, Llama 3.1 e Llama 3.2.
Você quer começar a usar a IA generativa?
Saiba como trabalhar com LLMs em Python diretamente em seu navegador