Curso
Trabalhar com a API da OpenAI
3 h
172.6K
Desde o lançamento do ChatGPT em novembro de 2022, chatbots com LLM ganharam destaque em inúmeros casos de uso.
A ideia de chatbot não é nova. Todo mundo já esbarrou em chatbots inúteis, tão engessados que mais parecem scripts de if-else. Além de dar um trabalhão para manter, eles pouco ajudam o usuário final — na prática, só geram frustração.
Mas agora, em 2024, os chatbots voltaram com tudo, graças aos Large Language Models (LLMs).
Neste blog, você vai aprender:
Você também pode conferir nosso curso Vector Databases for Embeddings with Pinecone e o code-along sobre construção de chatbots com a OpenAI API e Pinecone para se aprofundar.
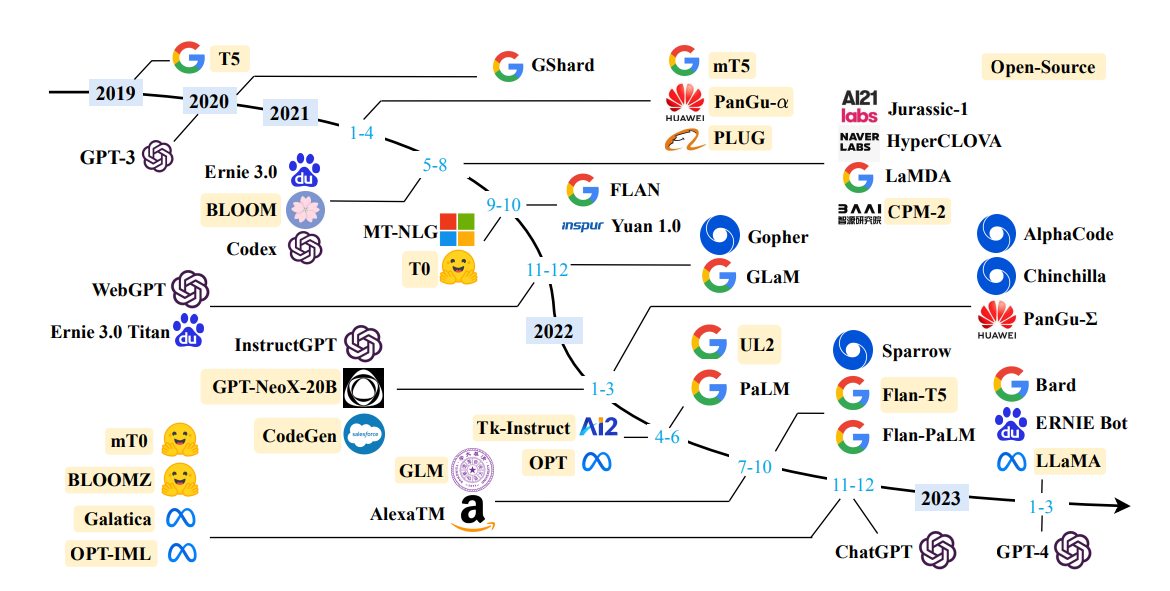
Large Language Models (LLMs) como o GPT-4 são algoritmos de machine learning avançados que usam técnicas de deep learning — especialmente a arquitetura de transformers — para compreender e gerar linguagem natural.
Eles são treinados em conjuntos massivos de dados, com trilhões de palavras de diversas fontes da internet, como livros, artigos, sites e repositórios de código. Esse treinamento extenso permite executar várias tarefas complexas de processamento de linguagem.
Uma das características mais marcantes dos LLMs é a capacidade de gerar texto sobre praticamente qualquer tema, em diferentes estilos e formatos — de escrita criativa a documentação técnica.
Eles se destacam em tarefas como sumarização, condensando documentos longos em resumos objetivos, e em IA conversacional, permitindo diálogos naturais e fluentes com usuários. Também são ótimos em tradução entre idiomas, capturando nuances como gírias e variações regionais.
No entanto, os LLMs têm desafios. Um ponto crítico é que podem "alucinar", gerando informações plausíveis porém incorretas ou sem sentido, especialmente diante de perguntas fora do escopo de treinamento ou prompts ambíguos.
Outro problema é o potencial de viés nas respostas, herdado dos dados de treinamento ou introduzido durante o desenvolvimento do modelo.
Os LLMs representam um grande avanço em IA e oferecem enorme potencial de inovação e ganho de eficiência em várias áreas — mas exigem uma gestão cuidadosa para mitigar riscos como viés e desinformação.
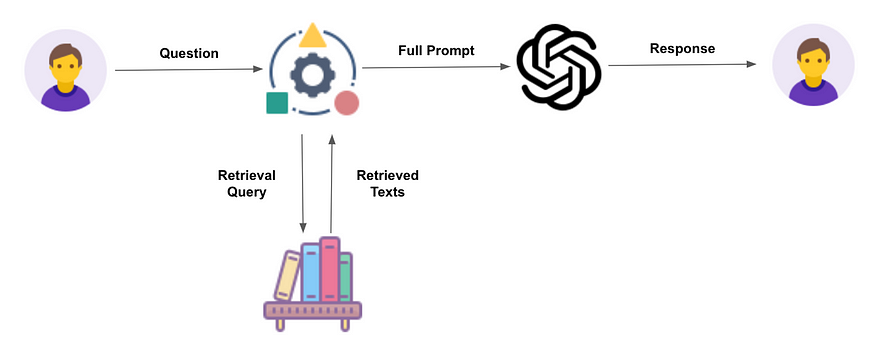
Embora poderosos, os LLMs têm limitações. Eles podem fornecer informações desatualizadas, genéricas ou até falsas quando a pergunta foge ao seu escopo de treinamento.
Também podem criar conteúdo factualmente incorreto ou sem sentido, mas apresentado como verdadeiro ou lógico — o fenômeno conhecido como alucinação.
RAG busca mitigar esses problemas orientando o LLM a recuperar informações relevantes de fontes pré-definidas. Isso aumenta a confiança do usuário, pois as respostas tendem a ser mais precisas e atribuíveis a fontes confiáveis.
Além disso, dá mais controle aos desenvolvedores sobre as respostas geradas pelo LLM, elevando a qualidade e a aplicabilidade do sistema.
Você pode aprender mais sobre retrieval augmented generation no nosso tutorial dedicado. Abaixo, resumimos as principais etapas do processo.
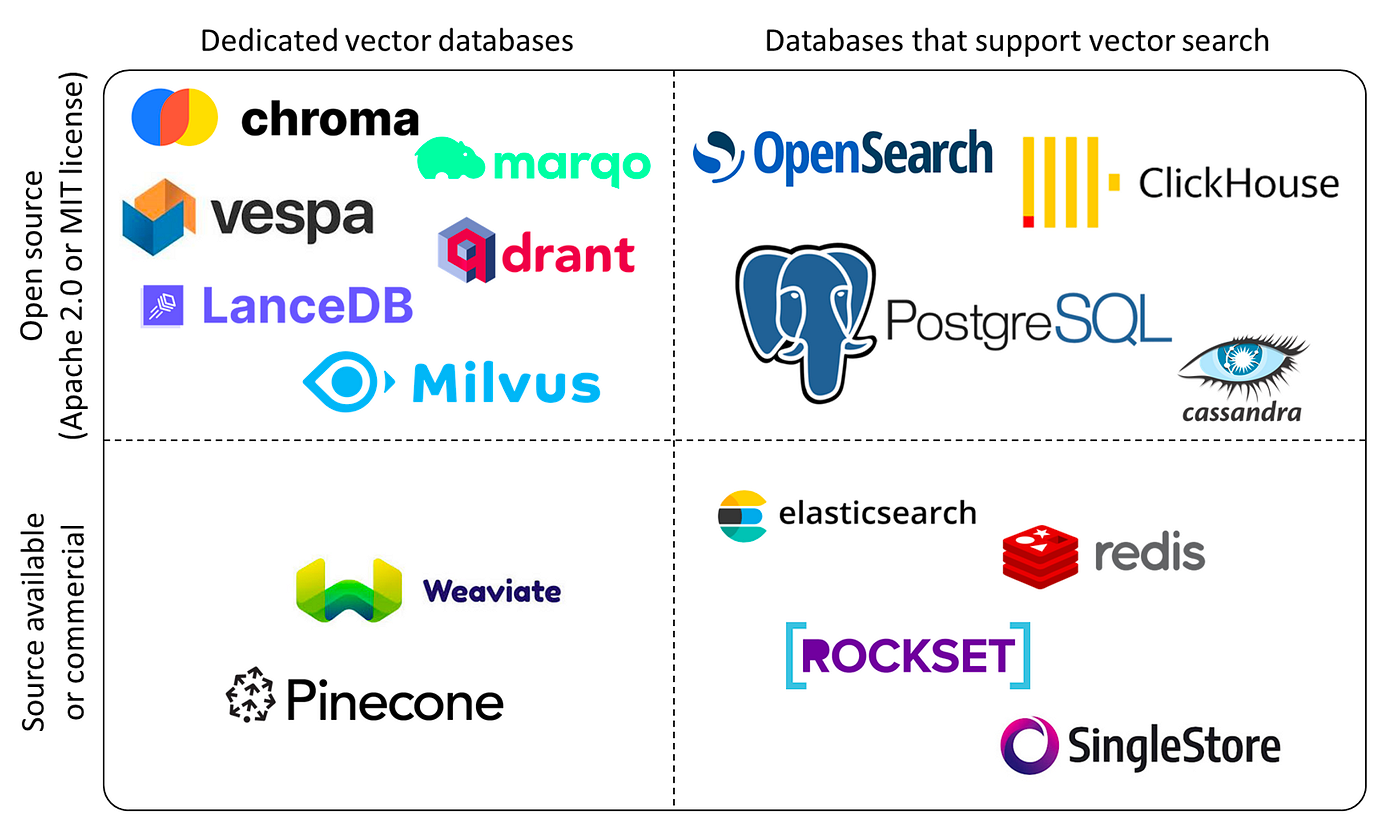
Bancos de dados vetoriais são bancos especializados para lidar com vetores de alta dimensão — representações matemáticas de atributos ou características de dados. Dependendo da complexidade e granularidade, esses vetores podem ter de dezenas a milhares de dimensões.
Esse tipo de banco é excelente para buscas por similaridade rápidas e precisas, baseadas em distância/similaridade entre vetores. Na prática, isso viabiliza consultas semânticas e contextuais, em vez de depender de correspondências exatas ou filtros pré-definidos.
Na prática, você pode usar bancos vetoriais para: encontrar imagens parecidas com base em conteúdo e estilo; localizar documentos semelhantes a outro com base em tema e sentimento; ou identificar produtos semelhantes considerando características e avaliações.
A consulta em um banco vetorial usa um vetor de busca que representa a informação desejada e aplica uma métrica de similaridade para medir a proximidade dos vetores no espaço vetorial. O resultado é uma lista ranqueada de vetores mais próximos à busca, permitindo acessar os dados brutos associados a cada vetor.
Eles usam diversos algoritmos, como índices k-nearest neighbors (k-NN) e métodos como HNSW (Hierarchical Navigable Small World) e IVF (Inverted File Index).
Bancos vetoriais são fundamentais em aplicações de retrieval augmented generation (RAG). Eles viabilizam busca por similaridade eficiente, expansão de conteúdo, diversidade e recuperação dinâmica de dados multimodais — algo crucial em IA generativa para reduzir vieses e alucinações.
O Pinecone é um banco vetorial popular, reconhecido pela eficiência e facilidade de uso, especialmente em cenários de grande escala. Foi pensado para desenvolvedores e cientistas de dados que precisam implementar busca vetorial em diferentes aplicações.
O Pinecone emprega técnicas avançadas de indexação, como quantização de produto e locality-sensitive hashing, permitindo buscas por similaridade eficientes e precisas em espaços vetoriais de alta dimensão — ideal para RAG. Você pode aprender mais no nosso tutorial sobre como dominar bancos vetoriais com Pinecone.
Neste tutorial, vamos usar o Pinecone como nosso banco de dados vetorial.
A plataforma de API da OpenAI dá acesso a todos os modelos treinados pela OpenAI disponíveis ao público — incluindo GPT, DALL-E, Whisper e outros.
A API é acessada por requisições HTTP, então você pode integrá-la com qualquer linguagem que faça esse tipo de chamada. No entanto, em Python existe a biblioteca openai, instalável via pip install openai, que facilita ainda mais trabalhar com essas APIs.
Trabalhar com a OpenAI API em Python usando a biblioteca openai leva apenas algumas linhas de código.
Exemplo em Python:
import os
os.environ["OPENAI_API_KEY"] = " "


from openai import OpenAI
client = OpenAI()


completion = client.chat.completions.create(
  model="gpt-4",
  messages=[
    {"role": "system", "content": "You are expert in Machine Learning."},
    {"role": "user", "content": "Explain how does random forest works?."}
  ]
)


print(completion.choices[0].message)
LangChain é um framework para desenvolver aplicações baseadas em modelos de linguagem. Ele oferece um nível de abstração que acelera a criação de protótipos e a ida do protótipo à produção. O crescimento e a popularidade ficam evidentes pelo número de estrelas no Github.
É um framework incrível. Porém, um alerta: ele ainda não é estável. A API muda com frequência e é possível que, quando você ler o código da próxima seção, algo já não funcione. Isso é esperado, pois a biblioteca ainda está em pre-release. No momento da escrita deste blog, a versão mais recente do LangChain é a 0.1.4.
Para implementar um back-end de RAG, precisamos dos embeddings dos dados externos. Se começarmos de dados brutos, teremos que gerar embeddings via OpenAI Embedding API ou outro modelo open-source.
Gerar embeddings de dados brutos é simples. Mas, se você usar as APIs da OpenAI, haverá cobrança por token.
Para este tutorial, reproduzi a maior parte do código desta seção a partir do guia oficial do Pinecone sobre LangChain. A documentação do Pinecone é excelente e está sempre atualizada.
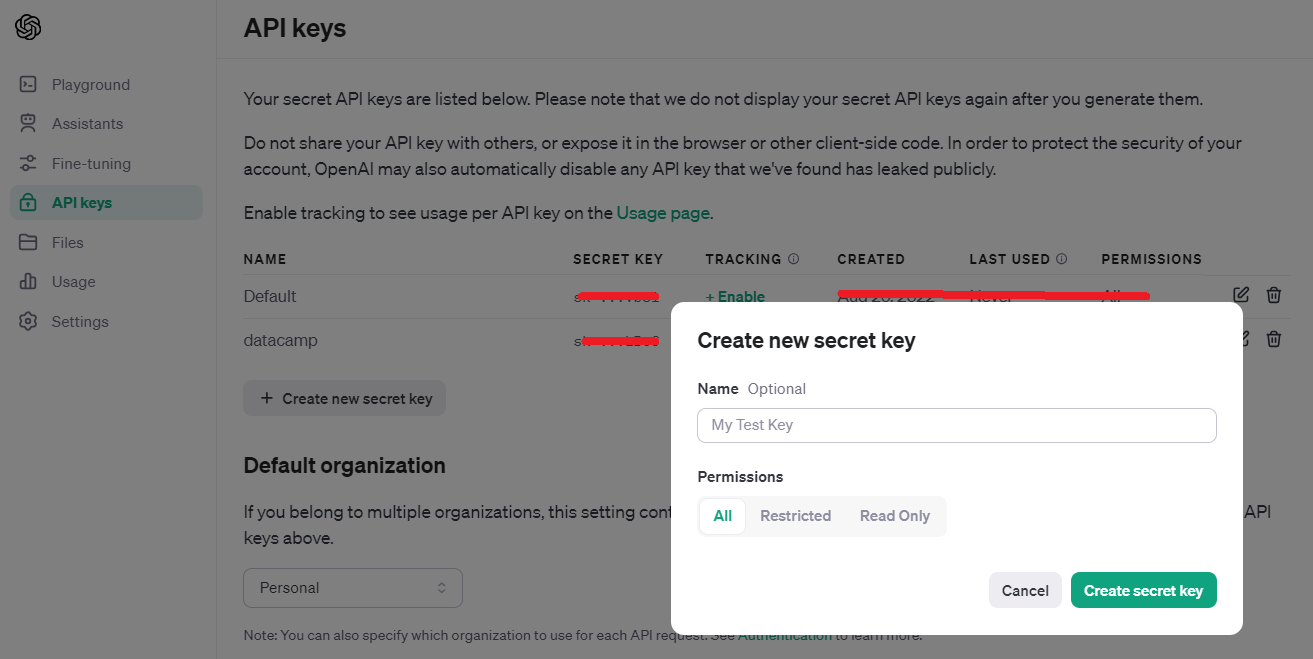
Depois de criar sua conta na OpenAI, acesse https://platform.openai.com/api-keys
Você precisa copiar a chave no momento em que ela é gerada, pois não haverá opção de visualizá-la novamente depois.
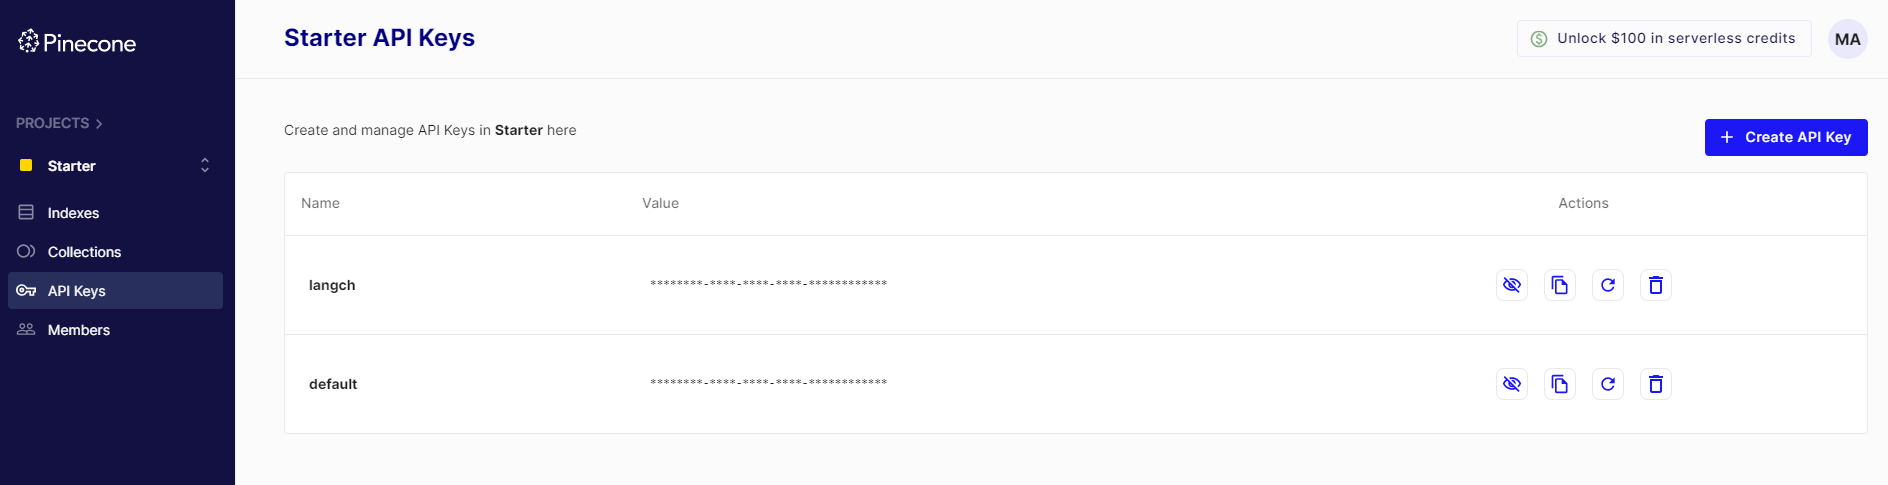
No Pinecone, faça login e clique em API Keys. No canto direito, clique no botão `Click API Key`.
Diferente da OpenAI, no Pinecone você não precisa necessariamente copiar a chave no momento da geração: há um ícone de cópia na coluna Actions que pode ser usado a qualquer momento.
Com as chaves de API da OpenAI e do Pinecone em mãos, defina-as como variáveis no Notebook. Alternativamente, você pode usar o módulo `os` em Python e definir essas chaves como variáveis de ambiente. Nesse caso, ajuste o código abaixo conforme necessário.
OPENAI_API_KEY = '...'
PINECONE_API_KEY = '...'Para seguir este tutorial, instale as bibliotecas abaixo com pip.
!pip install -qU \
  langchain==0.1.1 \
  langchain-community==0.0.13 \
  openai==0.27.7 \
  tiktoken==0.4.0 \
  pinecone-client==3.0.0 \
pinecone-datasets==0.7.0A biblioteca pinecone-datasets oferece alguns datasets de exemplo que já vêm com embeddings gerados pelo modelo embedding-ada-002 da OpenAI. Vamos usar o dataset wikipedia-simple-text-embedding-ada-002-100K.
Como o nome indica, são 100.000 documentos. Porém, aqui vamos amostrar apenas os primeiros 30.000 registros. Mesmo que não haja custo de geração (os embeddings já estão prontos para todos os 100.000), a amostragem acelera o processo.
import pinecone_datasets
dataset = pinecone_datasets.load_dataset('wikipedia-simple-text-embedding-ada-002-100K')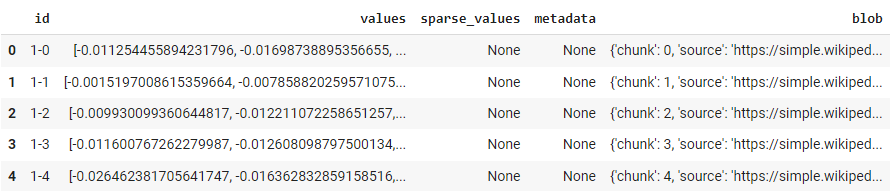
# drop metadata column and renamed blob to metadata
dataset.documents.drop(['metadata'], axis=1, inplace=True)
dataset.documents.rename(columns={'blob': 'metadata'}, inplace=True)


# sample 30k documents
dataset.documents.drop(dataset.documents.index[30_000:], inplace=True)from pinecone import Pinecone, ServerlessSpec
# configure client
pc = Pinecone(api_key=PINECONE_API_KEY)
# configure serverless spec
spec = ServerlessSpec(cloud='aws', region='us-west-2')
# check for and delete index if already exists
index_name = 'langchain-retrieval-augmentation-fast'
if index_name in pc.list_indexes().names():
pc.delete_index(index_name)
# we create a new index
pc.create_index(
index_name,
dimension=1536, # dimensionality of text-embedding-ada-002
metric='dotproduct',
spec=spec
)
Para se conectar ao índice e verificar as estatísticas:
index = pc.Index(index_name)
index.describe_index_stats()
A saída será:
{'dimension': 1536,
 'index_fullness': 0.0,
 'namespaces': {},
 'total_vector_count': 0}
1536 é a dimensionalidade dos embeddings do modelo ada-002. Note que o total de vetores é zero, pois ainda não inserimos nenhum dado (vetor).
Inserir dados no índice langchain-retrieval-augmentation-fast é bem simples:
for batch in dataset.iter_documents(batch_size=100):
    index.upsert(batch)
Esse comando leva alguns minutos para concluir.
Após a inserção, você também consegue visualizar os dados na interface do Pinecone:
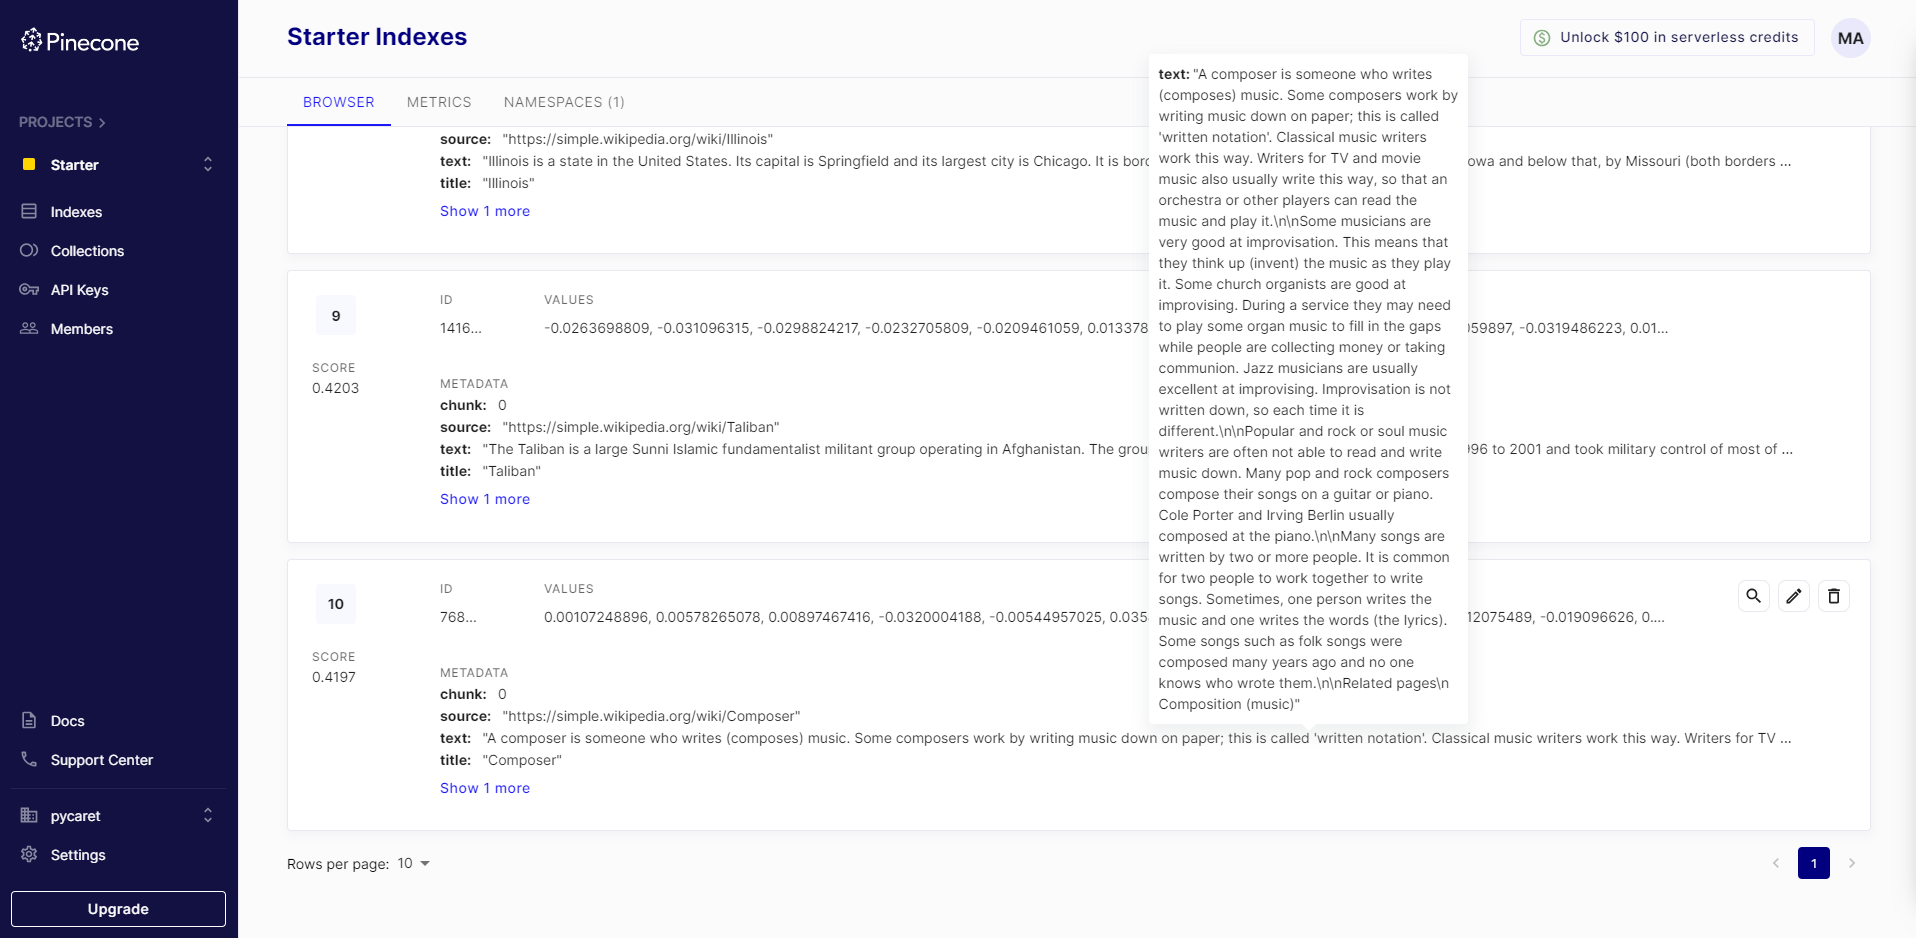
Agora que criamos o índice e inserimos os dados via Pinecone API, vamos passar ao LangChain. O próximo passo é iniciar um repositório vetorial no LangChain usando o mesmo índice que criamos.
from langchain.embeddings.openai import OpenAIEmbeddings
model_name = 'text-embedding-ada-002'
embed = OpenAIEmbeddings(model=model_name, openai_api_key=OPENAI_API_KEY)
Para inicializar o repositório vetorial:
from langchain.vectorstores import Pinecone
vectorstore = Pinecone(index, embed.embed_query, "text")
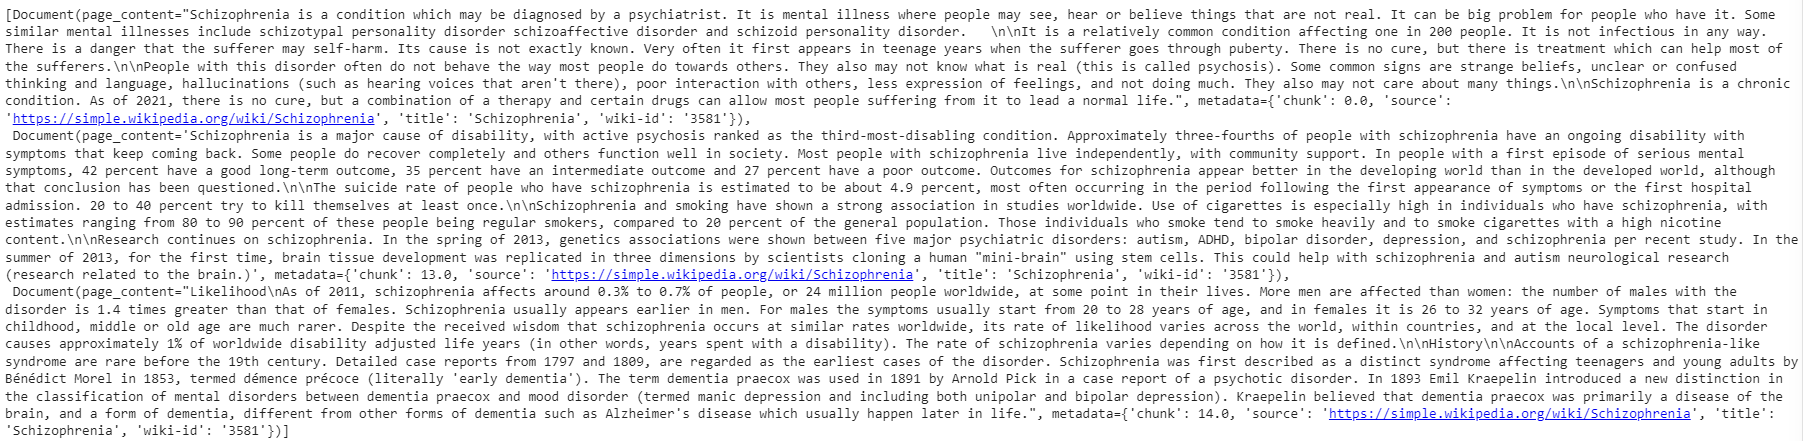
Agora você pode usar o objeto vectorstore para consultar os dados e ver os Top N resultados:
query = "What is Schizophrenia?"


vectorstore.similarity_search(query, k=3)
A saída é um objeto de documento do qual você pode extrair strings facilmente. Essencialmente, ele mostra os 3 documentos mais semelhantes com base na métrica escolhida no Passo 4 — aqui, dotmatrix.
Este é o passo final da nossa aplicação. Agora vamos envolver o LLM. Para isso, importe as classes ChatOpenAI e RetrievalQA do LangChain.
from langchain.chat_models import ChatOpenAI
from langchain.chains import RetrievalQA


# completion llm
llm = ChatOpenAI(
    openai_api_key=OPENAI_API_KEY,
    model_name='gpt-4',
    temperature=0.0
)


qa = RetrievalQA.from_chain_type(
    llm=llm,
    chain_type="stuff",
    retriever=vectorstore.as_retriever()
)


qa.run(query)
A saída de qa.run(query) é a resposta do modelo de linguagem.
Schizophrenia is a mental illness where people may see, hear or believe things that are not real. It often first appears in teenage years and is a chronic condition....Essa resposta vem de um dos documentos do `dataset`. Se você também quiser trazer a fonte (comum em aplicações de RAG), basta fazer um pequeno ajuste no código acima.
from langchain.chains import RetrievalQAWithSourcesChain


qa_with_sources = RetrievalQAWithSourcesChain.from_chain_type(
    llm=llm,
    chain_type="stuff",
    retriever=vectorstore.as_retriever()
)


qa_with_sources(query)
Saída:
{'question': 'What is Schizophrenia?',
 'answer': 'Schizophrenia is a mental illness where people may see, hear or believe things that are not real. It is a relatively common condition ...',
 'sources': 'https://simple.wikipedia.org/wiki/Schizophrenia'}
Perceba que, desta vez, a saída é um dicionário no qual você encontra a `source`.
Neste blog, exploramos uma das aplicações mais populares de LLMs: a técnica de Retrieval Augmented Generation (RAG), mostrando como ela aumenta a confiabilidade e a relevância das respostas de chatbots baseados em modelos como o GPT-4.
A evolução dos chatbots — de sistemas simples e baseados em regras para agentes conversacionais sofisticados movidos por IA — marca um salto tecnológico importante. Os LLMs trazem versatilidade e inteligência, permitindo conversas mais naturais e contextuais.
Também vimos o papel dos bancos de dados vetoriais, com foco no Pinecone, para armazenar e recuperar vetores de alta dimensão — peça-chave na implementação de RAG.
A implementação prática desses conceitos foi demonstrada com exemplos de código, aproveitando as APIs da OpenAI e do Pinecone e o framework LangChain em Python. Essas ferramentas simplificam o desenvolvimento e permitem criar, de forma rápida e eficiente, chatbots de IA adaptados a uma ampla variedade de aplicações.
Para saber mais sobre Vector Databases for Embeddings with Pinecone ou trabalhar com a OpenAI API, confira nossos cursos e aprimore seus conhecimentos nessas áreas.
Comece sua jornada em IA hoje mesmo!
Curso
Curso
Tutorial
Moez Ali
11 min
Tutorial
Tutorial
Abid Ali Awan
8 min
Tutorial
Moez Ali
9 min
Tutorial
Zoumana Keita
14 min
Tutorial
Zoumana Keita
7 min