course
Procesarea imaginilor în Python
4 oră
56.8K
Modelele Vision Language (VLMs) transformă rapid industriile, permițând sistemelor de AI să înțeleagă și să raționeze atât pe baza imaginilor, cât și a textului. Spre deosebire de modelele tradiționale de viziune computerizată, VLM-urile moderne pot interpreta imagini complexe, pot răspunde la întrebări detaliate despre conținut vizual și chiar pot procesa videoclipuri și documente cu text încorporat.
Această funcție le face neprețuite pentru diagnosticare medicală, controlul automat al calității și aplicații sensibile în care precizia contează mai mult decât viteza.
În acest blog, vom trece în revistă cele mai bune modele vision-language din 2026, atât open-source, cât și proprietare. Îți vom evidenția capabilitățile unice și apoi îți vom prezenta performanța și rezultatele din benchmark-uri. Pentru dezvoltatori și cercetători, am inclus și fragmente de cod de exemplu, ca să poți testa rapid aceste modele.
Dacă ești dornic să afli mai multe despre fundamentele acestor modele, nu rata parcursul de abilități Image Processing in Python.
Gemini 2.5 Pro este cel mai avansat model de AI al Google, aflat în prezent în fruntea clasamentelor LMArena și WebDevArena atât pentru sarcini vizuale, cât și de programare. Este conceput pentru raționament complex și înțelegere pe text, imagini, audio și video.
În ceea ce privește capabilitățile vision-language, se clasează printre modelele de top pe Open LLM leaderboard. Gemini 2.5 Pro poate interpreta imagini și videoclipuri, generând descrieri detaliate și conștiente de context, în timp ce răspunde la întrebări legate de conținutul vizual.
Sursă: Google Gemini
Poți accesa Gemini 2.5 Pro gratuit prin aplicația web Gemini la gemini.google.com/app sau folosind Google AI Studio.
Pentru dezvoltatori, Gemini 2.5 Pro este disponibil și prin Gemini API, Vertex AI și SDK-ul oficial Python, făcând simplă integrarea funcțiilor vision-language în propriile aplicații sau fluxuri de lucru.
Exemplu de utilizare:
from google.genai import types

with open('path/to/image.jpg', 'rb') as f:
      image_bytes = f.read()

  response = client.models.generate_content(
    model='gemini-2.5-pro',
    contents=[
      types.Part.from_bytes(
        data=image_bytes,
        mime_type='image/jpeg',
      ),
      'Explain the image.'
    ]
  )
print(response.text)InternVL3 este o serie avansată de modele multimodale de tip large language (MLLM) care le depășește pe cele din generația anterioară, InternVL 2.5. Excelează în percepție și raționament multimodal și are capabilități extinse, inclusiv utilizarea de unelte, agenți GUI, analiză industrială de imagini și percepție 3D.
Modelul InternVL3-78B folosește în mod specific InternViT-6B-448px-V2_5 pentru componenta de viziune și Qwen2.5-72B pentru componenta de limbaj. Cu un total de 78,41 miliarde de parametri, InternVL3-78B a obținut un scor de 72,2 pe benchmark-ul MMMU, stabilind un nou record de ultimă generație printre MLLM-urile open-source. Performanța sa este competitivă cu cea a modelelor proprietare de top.
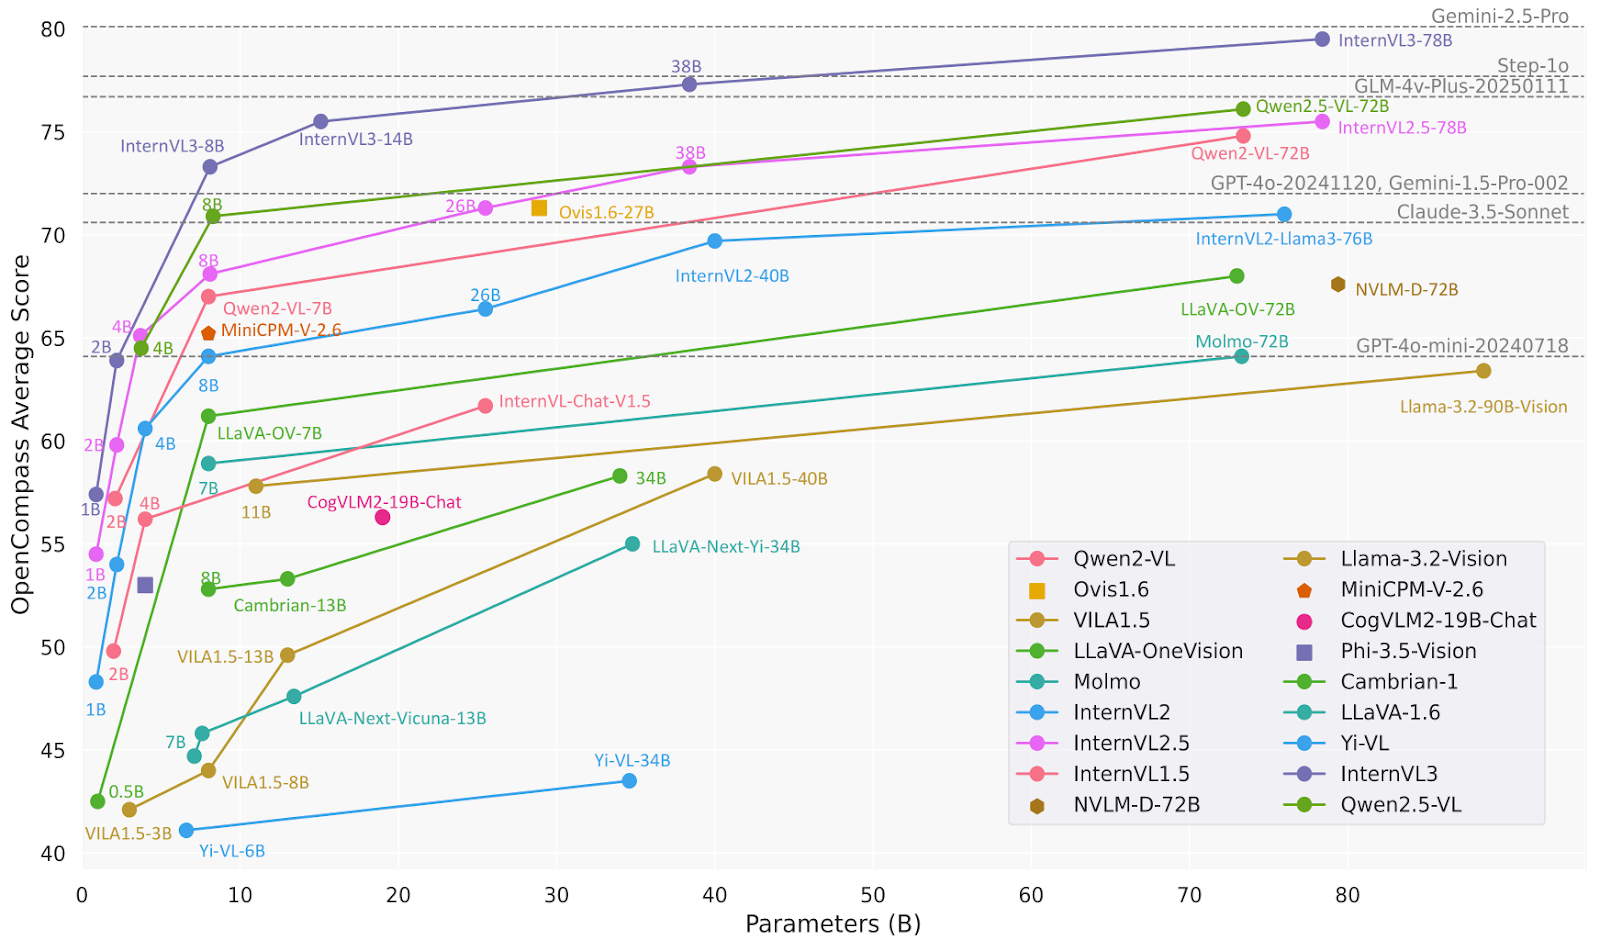
Sursă: OpenGVLab/InternVL3-78B · Hugging Face
Exemplu de utilizare:
# pip install lmdeploy>=0.7.3
from lmdeploy import pipeline, TurbomindEngineConfig, ChatTemplateConfig
from lmdeploy.vl import load_image

model = 'OpenGVLab/InternVL3-78B'
image = load_image('https://raw.githubusercontent.com/open-mmlab/mmdeploy/main/tests/data/tiger.jpeg')
pipe = pipeline(model, backend_config=TurbomindEngineConfig(session_len=16384, tp=4), chat_template_config=ChatTemplateConfig(model_name='internvl2_5'))
response = pipe(('Explain the image.', image))
print(response.text)Ovis2 este o serie de modele multimodale de tip large language (MLLM) dezvoltate de AIDC-AI. Aceste modele sunt proiectate să alinieze eficient embedding-urile vizuale și textuale. Modelul Ovis2-34B, în special, utilizează aimv2-1B-patch14-448 ca encoder vizual și Qwen2.5-32B-Instruct ca model de limbaj, însumând 34 de miliarde de parametri. Suportă o lungime maximă a contextului de 32.768 de tokeni și folosește precizie bfloat16 pentru procesare eficientă.
Ovis2-34B a demonstrat performanțe solide pe diverse teste de benchmark, obținând următoarele rezultate:
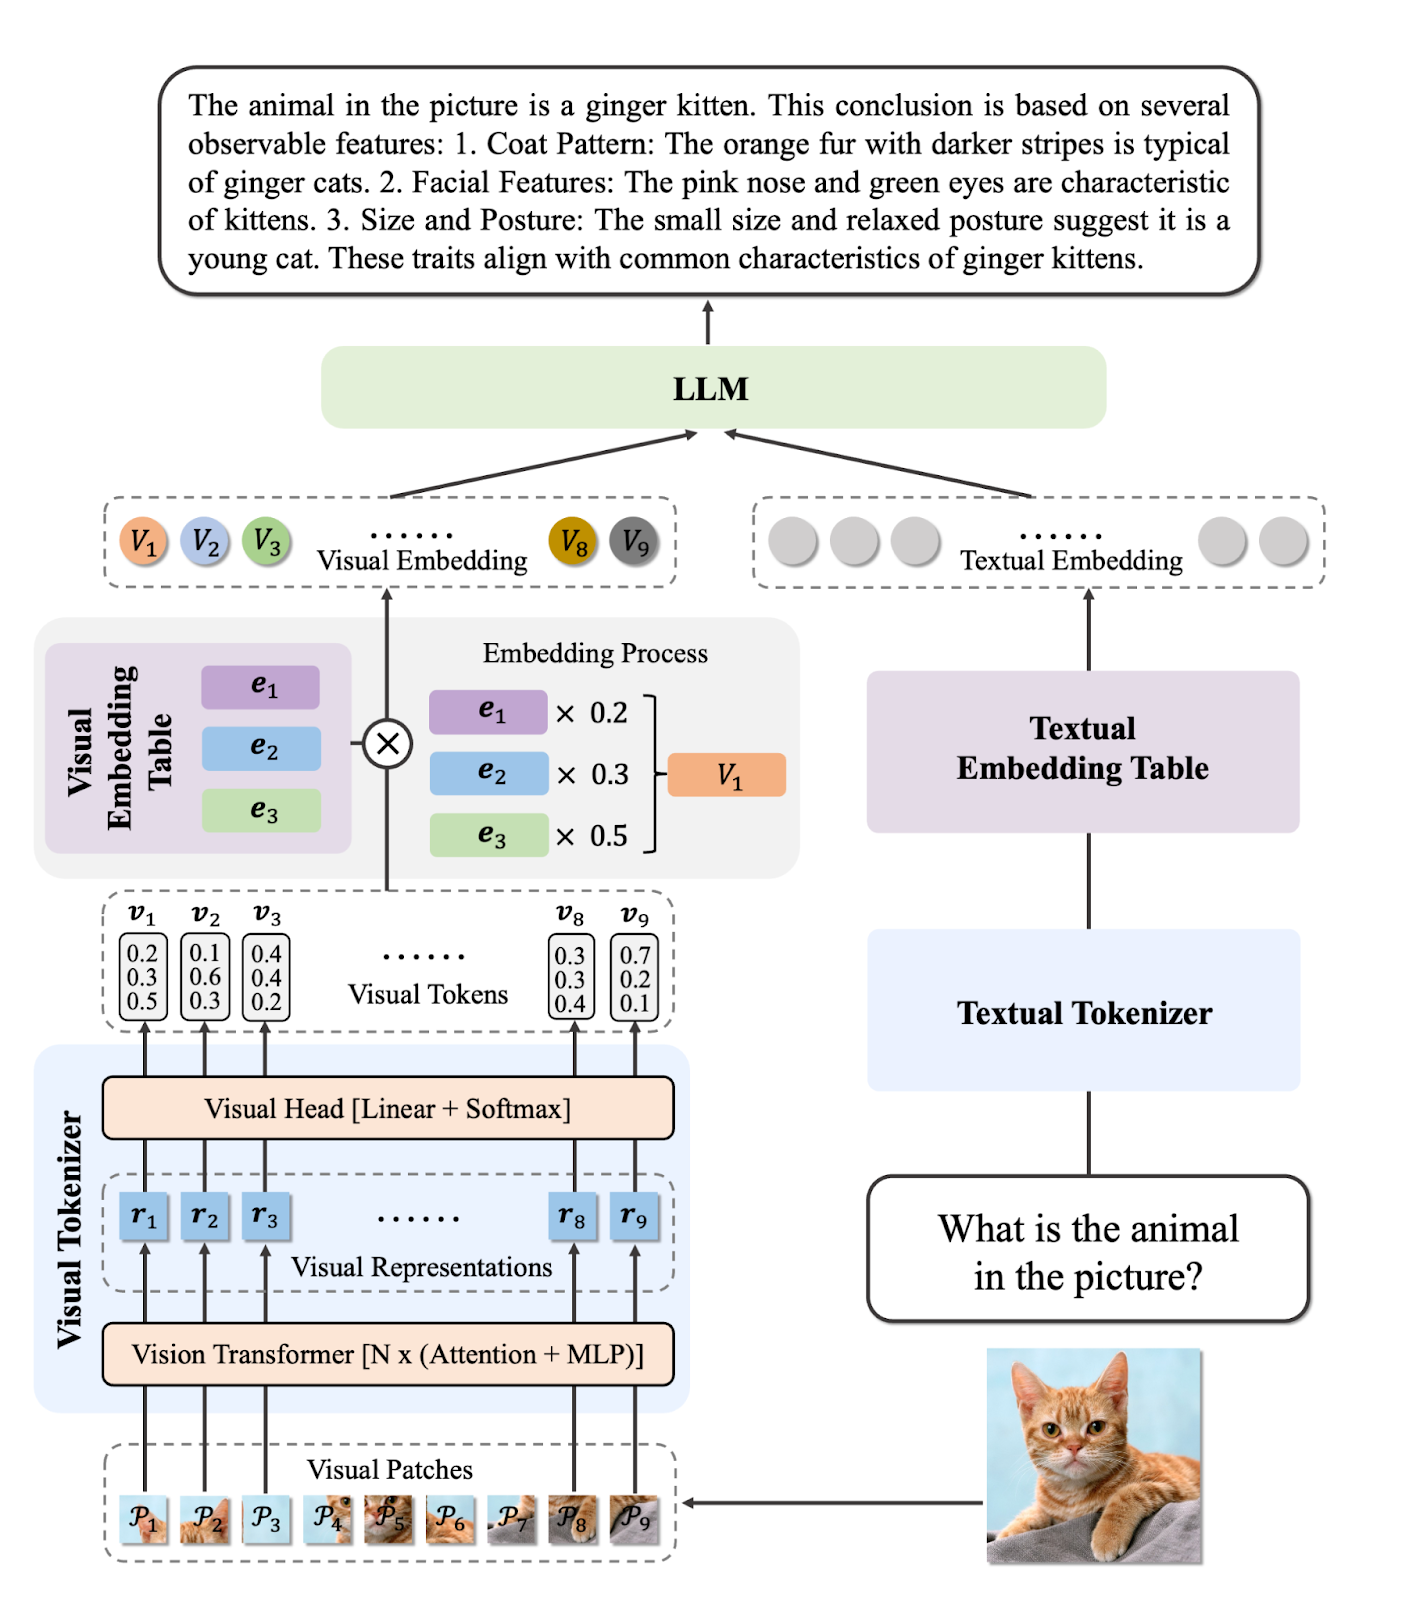
Sursă: AIDC-AI/Ovis2-34B · Hugging Face
Exemplu de utilizare:
import torch
from PIL import Image
from transformers import AutoModelForCausalLM

# load model
model = AutoModelForCausalLM.from_pretrained("AIDC-AI/Ovis2-34B",
                                             torch_dtype=torch.bfloat16,
                                             multimodal_max_length=32768,
                                             trust_remote_code=True).cuda()
text_tokenizer = model.get_text_tokenizer()
visual_tokenizer = model.get_visual_tokenizer()

# single-image input
image_path = '/data/images/example_1.jpg'
images = [Image.open(image_path)]
max_partition = 9
text = 'Describe the image.'
query = f'<image>\n{text}'


# format conversation
prompt, input_ids, pixel_values = model.preprocess_inputs(query, images, max_partition=max_partition)
attention_mask = torch.ne(input_ids, text_tokenizer.pad_token_id)
input_ids = input_ids.unsqueeze(0).to(device=model.device)
attention_mask = attention_mask.unsqueeze(0).to(device=model.device)
if pixel_values is not None:
    pixel_values = pixel_values.to(dtype=visual_tokenizer.dtype, device=visual_tokenizer.device)
pixel_values = [pixel_values]

# generate output
with torch.inference_mode():
    gen_kwargs = dict(
        max_new_tokens=1024,
        do_sample=False,
        top_p=None,
        top_k=None,
        temperature=None,
        repetition_penalty=None,
        eos_token_id=model.generation_config.eos_token_id,
        pad_token_id=text_tokenizer.pad_token_id,
        use_cache=True
    )
    output_ids = model.generate(input_ids, pixel_values=pixel_values, attention_mask=attention_mask, **gen_kwargs)[0]
    output = text_tokenizer.decode(output_ids, skip_special_tokens=True)
print(f'Output:\n{output}')Qwen2.5-VL-72B-Instruct este un model multimodal de tip large language (MLLM) din familia Qwen, conceput să înțeleagă și să proceseze atât informații vizuale, cât și textuale. Multe modele MLLM open-source se bazează pe el, ceea ce indică faptul că seria Qwen joacă un rol semnificativ în avansul cercetării în AI.
Qwen2.5-VL-72B-Instruct arată performanțe solide pe diverse benchmark-uri, inclusiv în înțelegerea imaginilor și videoclipurilor, precum și în funcții de agent. Obține 70,2 pe MMMUval, 74,8 pe MathVista_MINI și 70,8 pe MMStar.
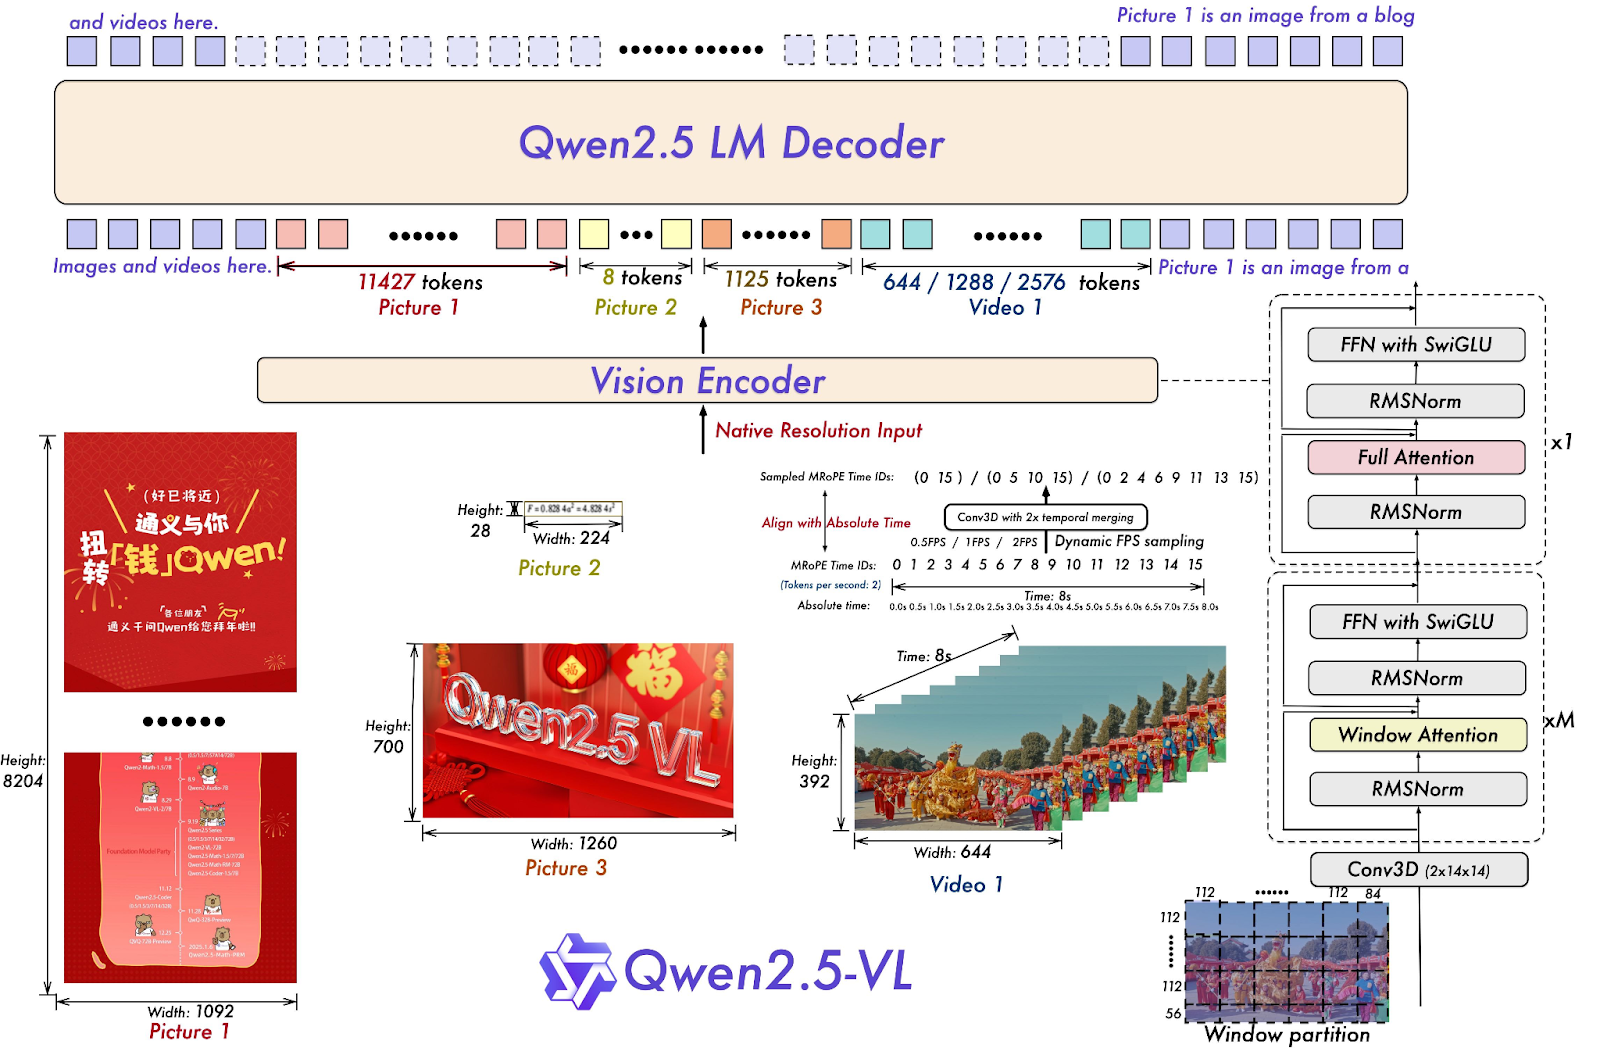
Sursă: Qwen/Qwen2.5-VL-72B-Instruct · Hugging Face
Exemplu de utilizare:
# pip install qwen-vl-utils[decord]==0.0.8

from transformers import Qwen2_5_VLForConditionalGeneration, AutoTokenizer, AutoProcessor
from qwen_vl_utils import process_vision_info

# default: Load the model on the available device(s)
model = Qwen2_5_VLForConditionalGeneration.from_pretrained(
    "Qwen/Qwen2.5-VL-72B-Instruct", torch_dtype="auto", device_map="auto"
)
# default processer
processor = AutoProcessor.from_pretrained("Qwen/Qwen2.5-VL-72B-Instruct")


messages = [
    {
        "role": "user",
        "content": [
            {
                "type": "image",
                "image": "https://qianwen-res.oss-cn-beijing.aliyuncs.com/Qwen-VL/assets/demo.jpeg",
            },
            {"type": "text", "text": "Describe this image."},
        ],
    }
]

# Preparation for inference
text = processor.apply_chat_template(
    messages, tokenize=False, add_generation_prompt=True
)
image_inputs, video_inputs = process_vision_info(messages)
inputs = processor(
    text=[text],
    images=image_inputs,
    videos=video_inputs,
    padding=True,
    return_tensors="pt",
)
inputs = inputs.to("cuda")

# Inference: Generation of the output
generated_ids = model.generate(**inputs, max_new_tokens=128)
generated_ids_trimmed = [
    out_ids[len(in_ids) :] for in_ids, out_ids in zip(inputs.input_ids, generated_ids)
]
output_text = processor.batch_decode(
    generated_ids_trimmed, skip_special_tokens=True, clean_up_tokenization_spaces=False
)
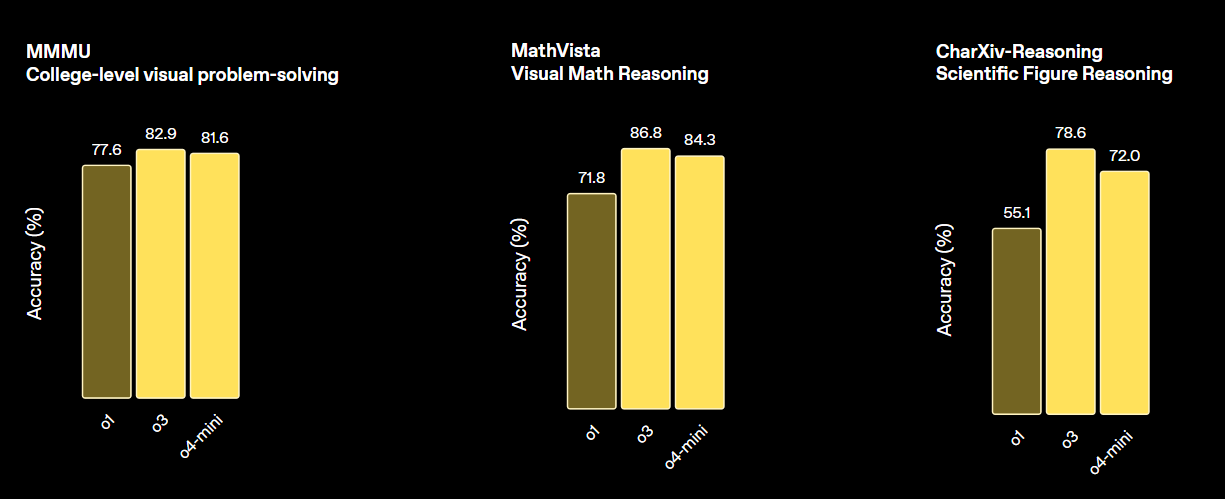
print(output_text)o3 de la OpenAI este un nou model de raționament conceput să ofere inteligență mai mare, costuri mai mici și utilizare mai eficientă a tokenilor în aplicații. Reprezintă o nouă generație de modele care pun accent pe capabilități avansate de raționament.
Acest model stabilește un nou standard pentru sarcini de matematică, știință, programare și raționament vizual. În diverse benchmark-uri de viziune, îl depășește pe o4-min și pe o1 și este la același nivel cu o3 Pro.
Sursă: Introducing OpenAI o3 and o4-mini | OpenAI
Exemplu de utilizare:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="o3-2025-04-16",
    input=[{
        "role": "user",
        "content": [
            {"type": "input_text", "text": "what's in this image?"},
            {
                "type": "input_image",
                "image_url": "https://upload.wikimedia.org/wikipedia/commons/thumb/d/dd/Gfp-wisconsin-madison-the-nature-boardwalk.jpg/2560px-Gfp-wisconsin-madison-the-nature-boardwalk.jpg",
            },
        ],
    }],
)

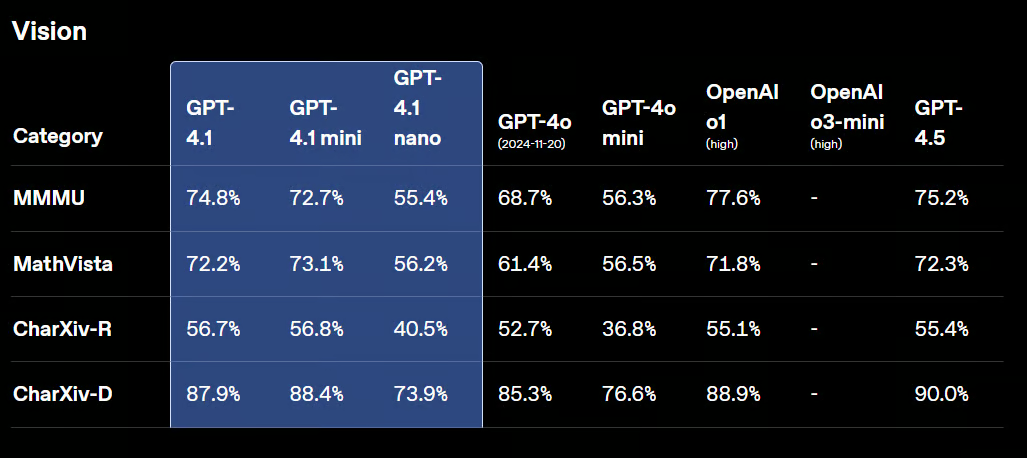
print(response.output_text)GPT-4.1 este o nouă familie de modele non-raționament, care include GPT-4.1, GPT-4.1 Mini și GPT-4.1 Nano. Aceste modele le-au depășit pe predecesoarele GPT-4o și GPT-4o Mini în diverse benchmark-uri.
GPT-4.1 își păstrează capabilitățile puternice de viziune, cu îmbunătățiri în analiza graficelor, diagramelor și a matematicii vizuale. Excelează la sarcini precum numărarea obiectelor, răspuns la întrebări vizuale și diverse forme de recunoaștere optică a caracterelor (OCR).
Sursă: Introducing GPT-4.1 in the API | OpenAI
Exemplu de utilizare:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-4.1-2025-04-14",
    input=[{
        "role": "user",
        "content": [
            {"type": "input_text", "text": "what's in this image?"},
            {
                "type": "input_image",
                "image_url": "https://upload.wikimedia.org/wikipedia/commons/thumb/d/dd/Gfp-wisconsin-madison-the-nature-boardwalk.jpg/2560px-Gfp-wisconsin-madison-the-nature-boardwalk.jpg",
            },
        ],
    }],
)

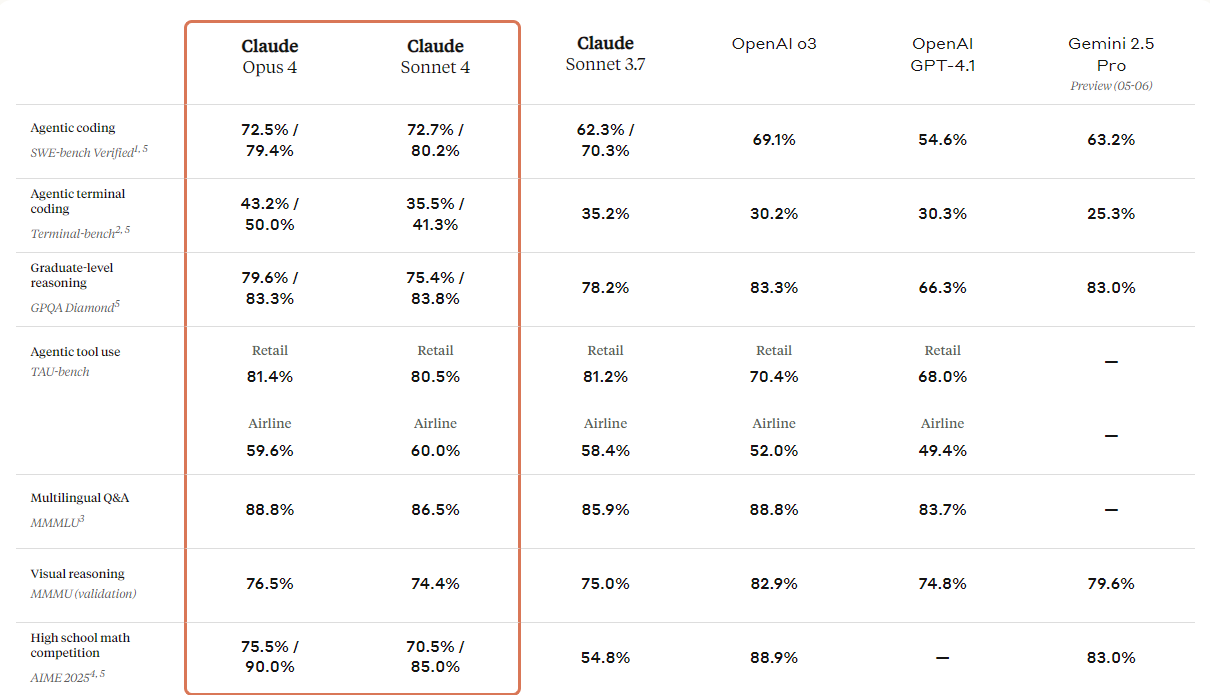
print(response.output_text)Anthropic a introdus următoarea generație a modelelor Claude: Claude 4 Opus și Claude 4 Sonnet. Aceste modele sunt proiectate să stabilească noi standarde în programare, raționament avansat și capabilități AI.
Vin cu capabilități de viziune îmbunătățite pe care utilizatorii le pot folosi pentru a înțelege imagini și apoi a genera cod sau a oferi informații pe baza acelor imagini. Deși este în esență un model de programare, are și capabilități multimodale, permițându-i să înțeleagă diferite tipuri de formate de fișiere.
Dacă te uiți la tabelul de comparație de mai jos, vei vedea că Claude 4 le depășește pe toate modelele de top, cu excepția modelului GPT-3 al OpenAI, în special la raționament vizual și răspuns la întrebări vizuale.
Sursă: Introducing Claude 4 \ Anthropic
Exemplu de utilizare:
import anthropic

client = anthropic.Anthropic()
message = client.messages.create(
    model="claude-sonnet-4-20250514",
    max_tokens=1024,
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image",
                    "source": {
                        "type": "url",
                        "url": "https://upload.wikimedia.org/wikipedia/commons/a/a7/Camponotus_flavomarginatus_ant.jpg",
                    },
                },
                {
                    "type": "text",
                    "text": "Describe this image."
                }
            ],
        }
    ],
)
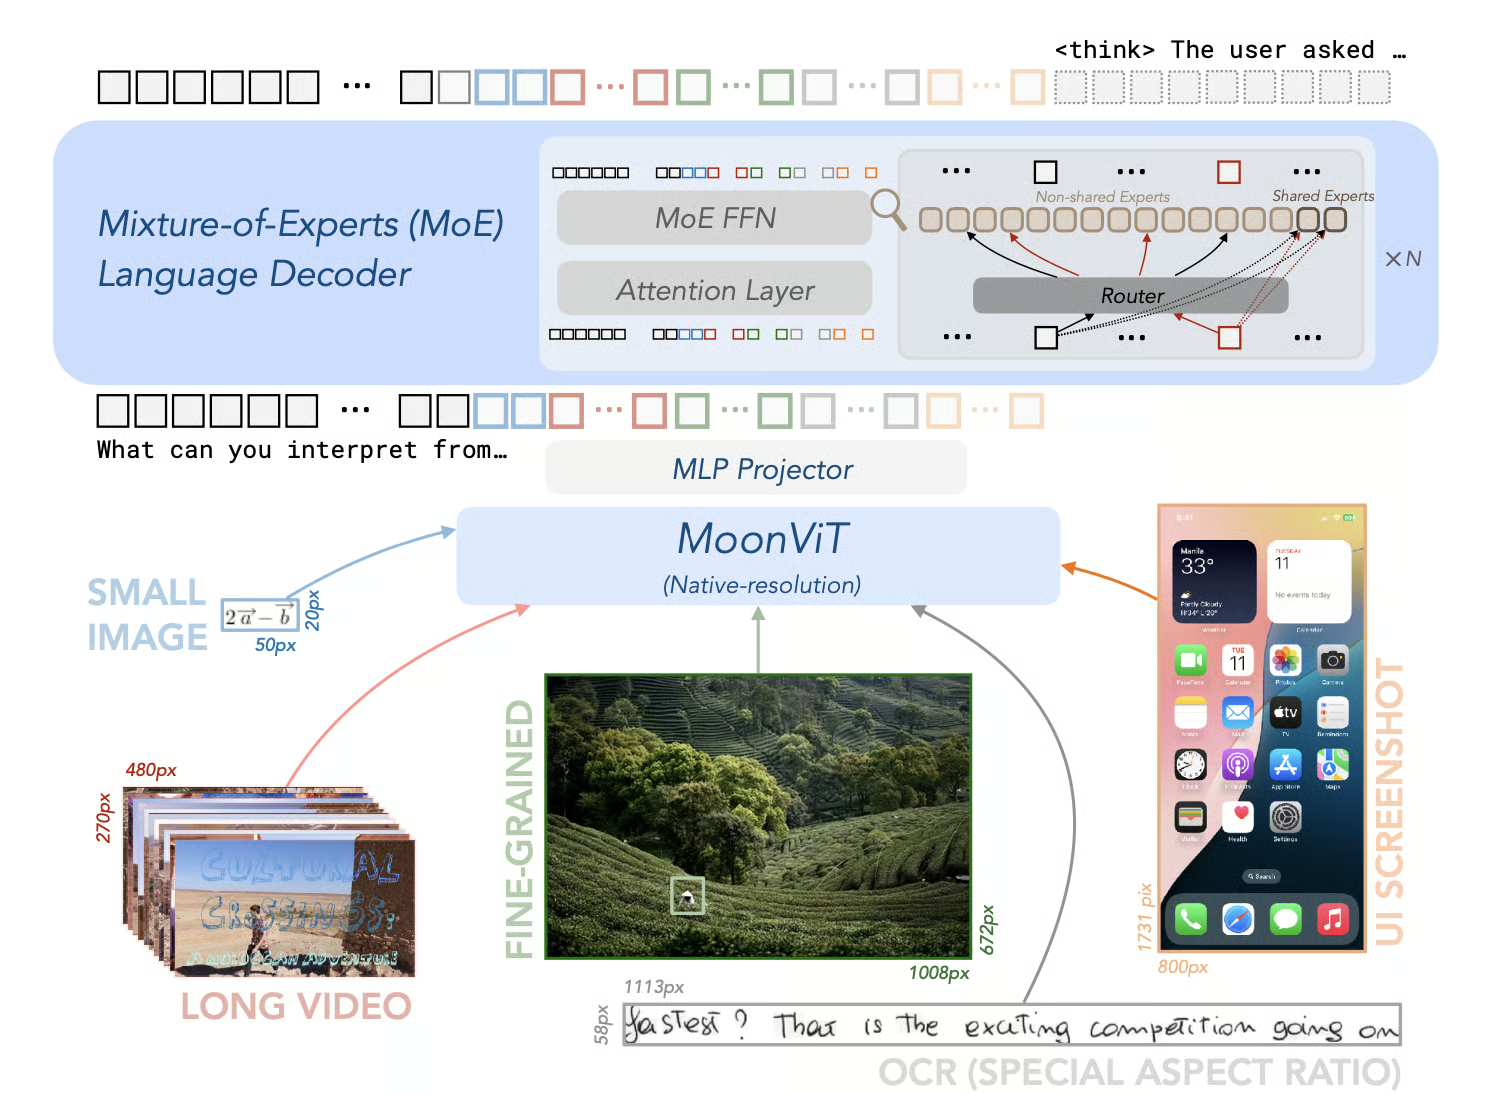
print(message)Kimi-VL-A3B-Thinking-2506 este un model open-source care marchează un progres semnificativ în AI multimodală. Excelează în benchmark-uri de raționament multimodal, obținând scoruri impresionante: 56,9 pe MathVision, 80,1 pe MathVista, 46,3 pe MMMU-Pro și 64,0 pe MMMU, reducând în același timp „lungimea gândirii” cu o medie de 20%.
Pe lângă capabilitățile de raționament, versiunea 2506 demonstrează o percepție și o înțelegere vizuală generală îmbunătățite. Se potrivește sau chiar depășește performanța modelelor fără „gândire” pe benchmark-uri precum MMBench-EN-v1.1 (84,4), MMStar (70,4), RealWorldQA (70,0) și MMVet (78,4).
Sursă: MoonshotAI/Kimi-VL: Kimi-VL
Exemplu de utilizare:
from transformers import AutoProcessor
from vllm import LLM, SamplingParams

model_path = "moonshotai/Kimi-VL-A3B-Thinking-2506"
llm = LLM(
    model_path,
    trust_remote_code=True,
    max_num_seqs=8,
    max_model_len=131072,
    limit_mm_per_prompt={"image": 256}
)

processor = AutoProcessor.from_pretrained(model_path, trust_remote_code=True)

sampling_params = SamplingParams(max_tokens=32768, temperature=0.8)


import requests
from PIL import Image

def extract_thinking_and_summary(text: str, bot: str = "◁think▷", eot: str = "◁/think▷") -> str:
    if bot in text and eot not in text:
        return ""
    if eot in text:
        return text[text.index(bot) + len(bot):text.index(eot)].strip(), text[text.index(eot) + len(eot) :].strip()
    return "", text

OUTPUT_FORMAT = "--------Thinking--------\n{thinking}\n\n--------Summary--------\n{summary}"

url = "https://huggingface.co/spaces/moonshotai/Kimi-VL-A3B-Thinking/resolve/main/images/demo6.jpeg"
image = Image.open(requests.get(url,stream=True).raw)

messages = [
    {"role": "user", "content": [{"type": "image", "image": ""}, {"type": "text", "text": "What kind of cat is this? Answer with one word."}]}
]
text = processor.apply_chat_template(messages, add_generation_prompt=True, return_tensors="pt")

outputs = llm.generate([{"prompt": text, "multi_modal_data": {"image": image}}], sampling_params=sampling_params)
generated_text = outputs[0].outputs[0].text

thinking, summary = extract_thinking_and_summary(generated_text)
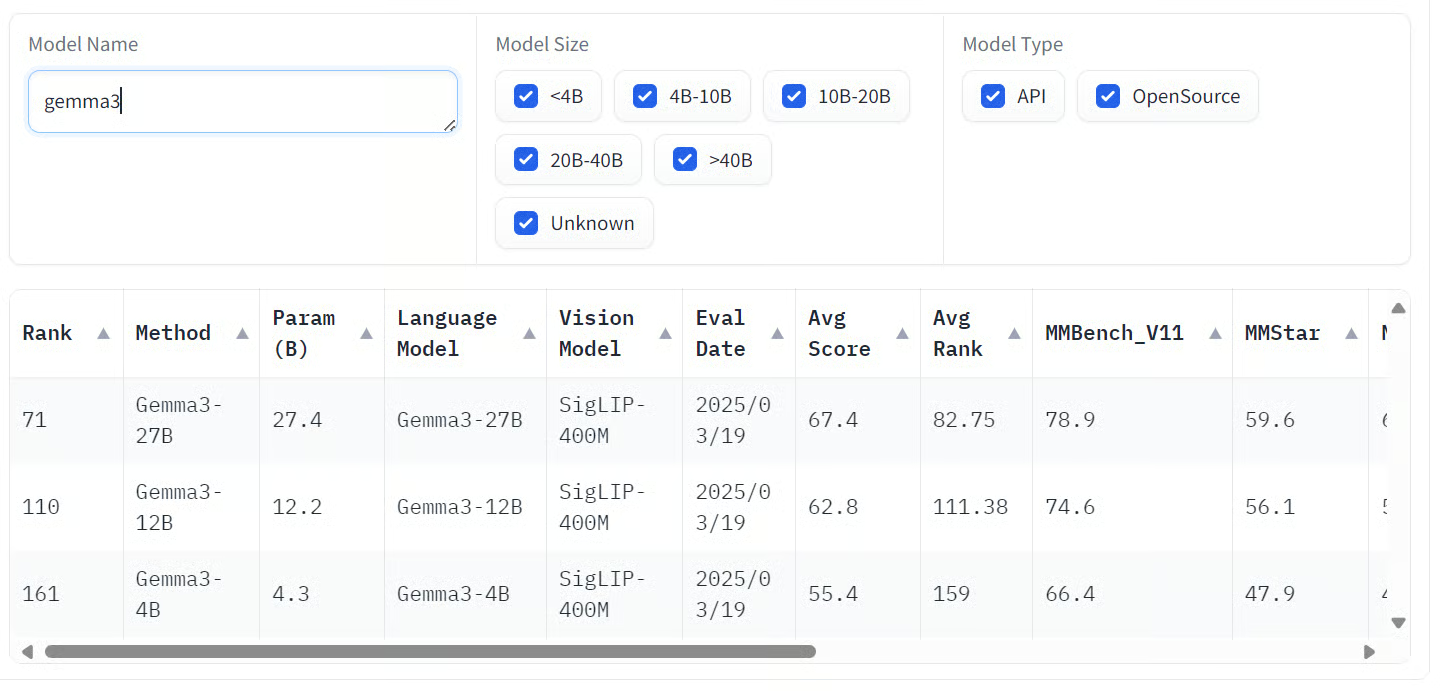
print(OUTPUT_FORMAT.format(thinking=thinking, summary=summary))Gemma 3 este o familie de modele AI multimodale dezvoltate de Google, capabile să proceseze atât intrări text, cât și imagini, pentru a produce ieșiri text. Aceste modele sunt disponibile în diverse dimensiuni: 1B, 4B, 12B și 27B, pentru cerințe diferite de hardware și performanță.
Varianta cea mai mare, Gemma 3 27B, a arătat performanțe impresionante în evaluările de preferință umană, depășind chiar modele mai mari precum Llama 3-405B și DeepSeek-V3.
Modelele demonstrează capabilități puternice pe diverse benchmark-uri. În special, excelează în sarcini multimodale, obținând scoruri notabile pe benchmark-uri precum COCOcap (116), DocVQA (85,6), MMMU (56,1) și VQAv2 (72,9).
Sursă: Open VLM Leaderboard
Exemplu de utilizare:
# pip install accelerate

from transformers import AutoProcessor, Gemma3ForConditionalGeneration
from PIL import Image
import requests
import torch

model_id = "google/gemma-3-27b-it"

model = Gemma3ForConditionalGeneration.from_pretrained(
    model_id, device_map="auto"
).eval()

processor = AutoProcessor.from_pretrained(model_id)

messages = [
    {
        "role": "system",
        "content": [{"type": "text", "text": "You are a helpful assistant."}]
    },
    {
        "role": "user",
        "content": [
            {"type": "image", "image": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/bee.jpg"},
            {"type": "text", "text": "Describe this image in detail."}
        ]
    }
]

inputs = processor.apply_chat_template(
    messages, add_generation_prompt=True, tokenize=True,
    return_dict=True, return_tensors="pt"
).to(model.device, dtype=torch.bfloat16)

input_len = inputs["input_ids"].shape[-1]

with torch.inference_mode():
    generation = model.generate(**inputs, max_new_tokens=100, do_sample=False)
    generation = generation[0][input_len:]

decoded = processor.decode(generation, skip_special_tokens=True)
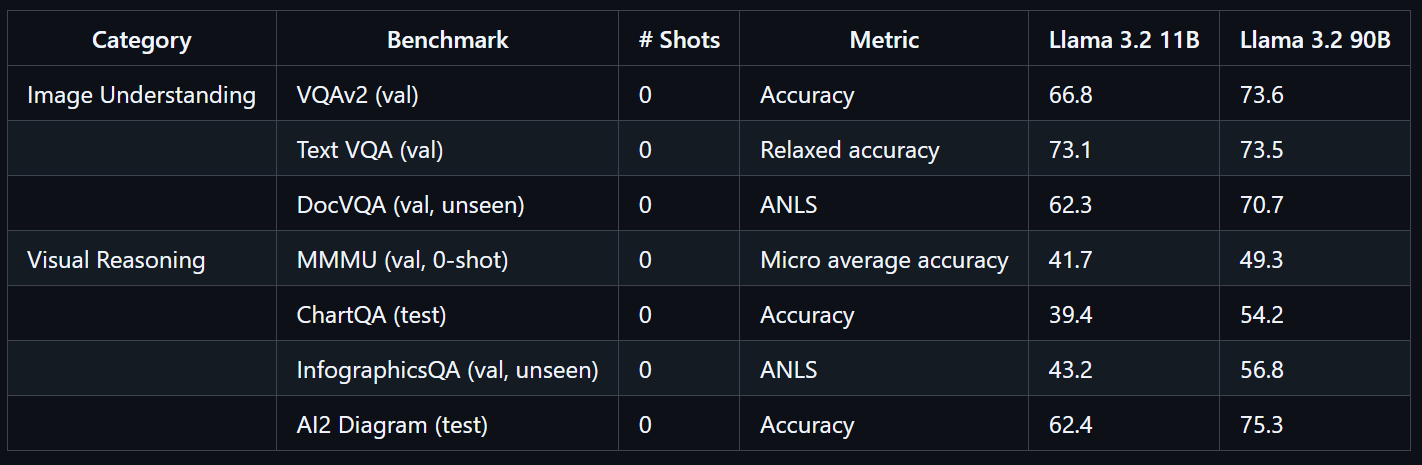
print(decoded)Modelul Llama 3.2 90B Vision Instruct este un model multimodal avansat, de tip large language, dezvoltat de Meta. Este conceput pentru sarcini care implică recunoaștere vizuală, raționament pe imagini și descriere.
Llama 3.2 90B Vision Instruct este construit pe versiunea doar-text Llama 3.1 și încorporează un adaptor de viziune antrenat separat, care îi permite să proceseze atât imagini, cât și text ca intrări, generând ieșiri text precise.
Antrenat la scară masivă, modelul Llama 3.2 90B Vision a necesitat 8,85 milioane de ore-GPU. Demonstrează performanțe excepționale pe benchmark-uri precum VQAv2 (73,6), Text VQA (73,5) și DocVQA (70,7).
Sursă: llama-models
Exemplu de utilizare:
import requests
import torch
from PIL import Image
from transformers import MllamaForConditionalGeneration, AutoProcessor

model_id = "meta-llama/Llama-3.2-90B-Vision-Instruct"

model = MllamaForConditionalGeneration.from_pretrained(
    model_id,
    torch_dtype=torch.bfloat16,
    device_map="auto",
)
processor = AutoProcessor.from_pretrained(model_id)

url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/0052a70beed5bf71b92610a43a52df6d286cd5f3/diffusers/rabbit.jpg"
image = Image.open(requests.get(url, stream=True).raw)

messages = [
    {"role": "user", "content": [
        {"type": "image"},
        {"type": "text", "text": "If I had to write a haiku for this one, it would be: "}
    ]}
]
input_text = processor.apply_chat_template(messages, add_generation_prompt=True)
inputs = processor(
    image,
    input_text,
    add_special_tokens=False,
    return_tensors="pt",
).to(model.device)

output = model.generate(**inputs, max_new_tokens=30)
print(processor.decode(output[0]))
Raționamentul vizual cu grafice este, de asemenea, punctul forte al celui mai nou model al Meta, Muse Spark.
Modelele vision-language transformă fundamental modul în care interacționăm cu informațiile vizuale și textuale, oferind acuratețe și flexibilitate remarcabile într-o gamă largă de industrii. Aceste modele îmbină perfect viziunea computerizată și procesarea limbajului natural, permițând aplicații noi, de la detecție avansată de obiecte până la asistenți vizuali intuitivi.
Dacă confidențialitatea și securitatea sunt prioritare pentru cazul tău de utilizare, îți recomand cu tărie să explorezi modelele vision-language open-source. Rularea acestor modele local îți oferă control total asupra datelor, făcându-le ideale pentru medii sensibile. VLM-urile open-source sunt, de asemenea, foarte adaptabile; majoritatea pot fi ajustate fin pe doar câteva sute de eșantioane pentru a obține rezultate excelente, adaptate nevoilor tale specifice.
Modelele proprietare, pe de altă parte, oferă acces fiabil și rentabil la capabilități de ultimă generație. Tind să fie foarte precise și pot fi integrate în fluxul tău de lucru cu doar câteva linii de cod, fiind accesibile chiar și pentru echipe fără expertiză profundă în AI.
Dacă ești dornic să înveți mai multe despre modelele vision language, nu rata aceste resurse:
Top cursuri DataCamp
course
course
track