course
Przetwarzanie obrazów w Pythonie
4 godz.
56.8K
Modele Vision Language (VLM) szybko zmieniają branże, umożliwiając systemom AI rozumienie i wnioskowanie zarówno na podstawie obrazów, jak i tekstu. W przeciwieństwie do tradycyjnych modeli komputerowego widzenia, nowoczesne VLM potrafią interpretować złożone obrazy, odpowiadać na szczegółowe pytania o treści wizualne, a nawet przetwarzać filmy i dokumenty z osadzonym tekstem.
Ta cecha czyni je bezcennymi w diagnostyce medycznej, automatycznej kontroli jakości oraz w wrażliwych zastosowaniach, gdzie precyzja liczy się bardziej niż szybkość.
W tym wpisie przeglądamy najlepsze modele vision-language w 2026 roku, zarówno open-source, jak i komercyjne. Podkreślimy ich unikalne możliwości, a następnie przedstawimy wyniki wydajności i benchmarków. Dla deweloperów i badaczy dołączyliśmy też przykładowe fragmenty kodu, abyś mógł szybko samodzielnie wypróbować te modele.
Jeśli chcesz poznać podstawy tych modeli, koniecznie zerknij na nasz Image Processing in Python.
Gemini 2.5 Pro to najnowszy, najbardziej zaawansowany model AI Google, który obecnie przewodzi rankingom LMArena i WebDevArena zarówno w zadaniach wizji, jak i kodowania. Został zaprojektowany do złożonego rozumowania i rozumienia tekstu, obrazów, dźwięku i wideo.
Pod względem możliwości vision-language należy do czołówki na Open LLM leaderboard. Gemini 2.5 Pro potrafi interpretować obrazy i filmy, generując szczegółowe, kontekstowe opisy i odpowiadając na pytania związane z treścią wizualną.
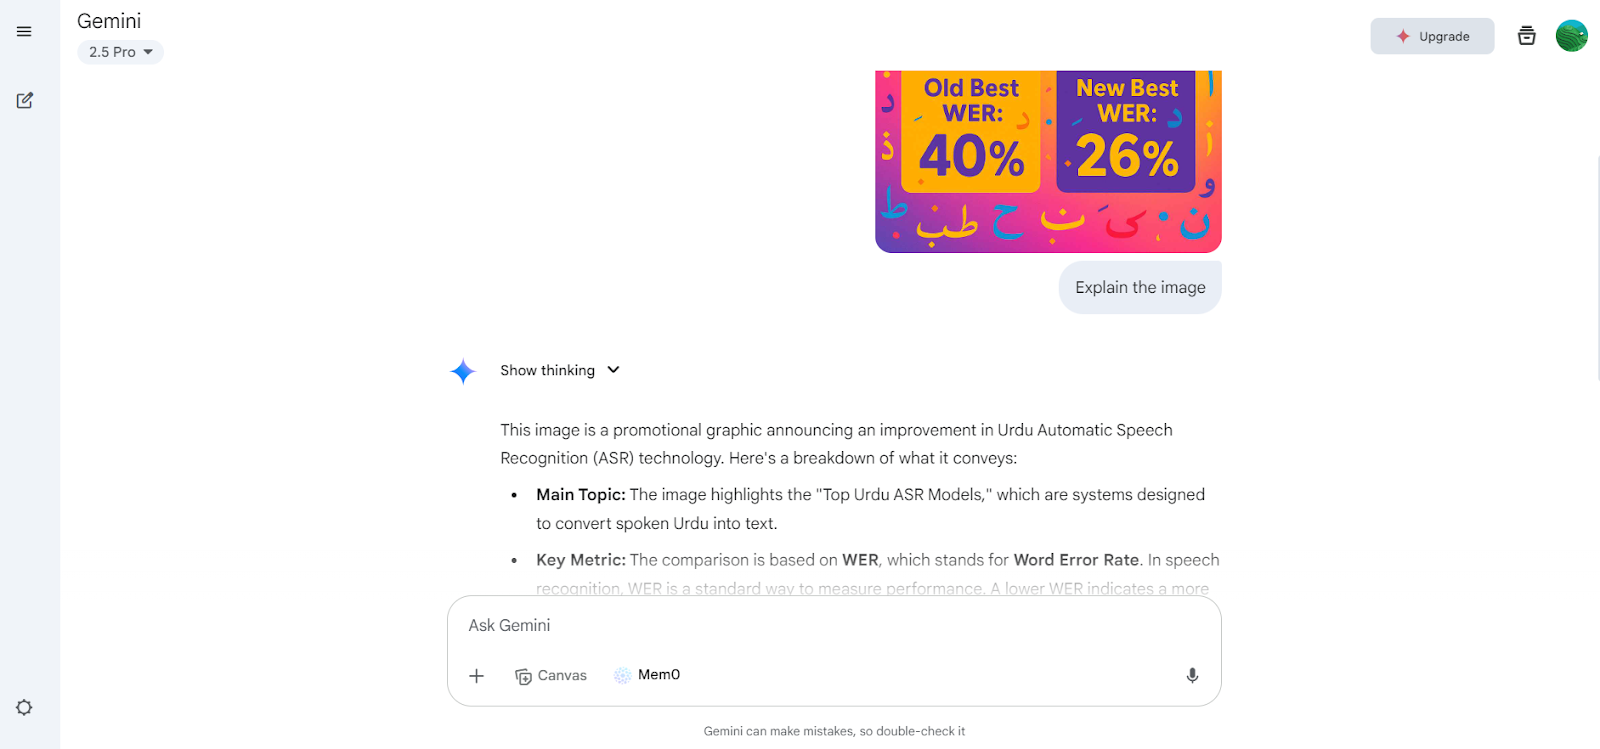
Źródło: Google Gemini
Do Gemini 2.5 Pro możesz uzyskać bezpłatny dostęp przez aplikację webową Gemini na gemini.google.com/app lub korzystając z Google AI Studio.
Deweloperzy mogą też korzystać z Gemini 2.5 Pro przez Gemini API, Vertex AI oraz oficjalne SDK dla Pythona, co ułatwia integrację funkcji vision-language z własnymi aplikacjami i procesami.
Przykładowe użycie:
from google.genai import types

with open('path/to/image.jpg', 'rb') as f:
      image_bytes = f.read()

  response = client.models.generate_content(
    model='gemini-2.5-pro',
    contents=[
      types.Part.from_bytes(
        data=image_bytes,
        mime_type='image/jpeg',
      ),
      'Explain the image.'
    ]
  )
print(response.text)InternVL3 to zaawansowana seria multimodalnych dużych modeli językowych (MLLM), przewyższająca poprzednika, InternVL 2.5. Wyróżnia się percepcją multimodalną i rozumowaniem oraz ma rozszerzone możliwości, w tym obsługę narzędzi, agentów GUI, przemysłową analizę obrazów i percepcję 3D.
Model InternVL3-78B wykorzystuje konkretnie InternViT-6B-448px-V2_5 jako komponent wizji oraz Qwen2.5-72B jako komponent językowy. Łącznie ma 78,41 mld parametrów i uzyskał wynik 72,2 w benchmarku MMMU, ustanawiając nowy stan sztuki wśród otwartych MLLM. Jego wydajność konkuruje z czołowymi modelami komercyjnymi.
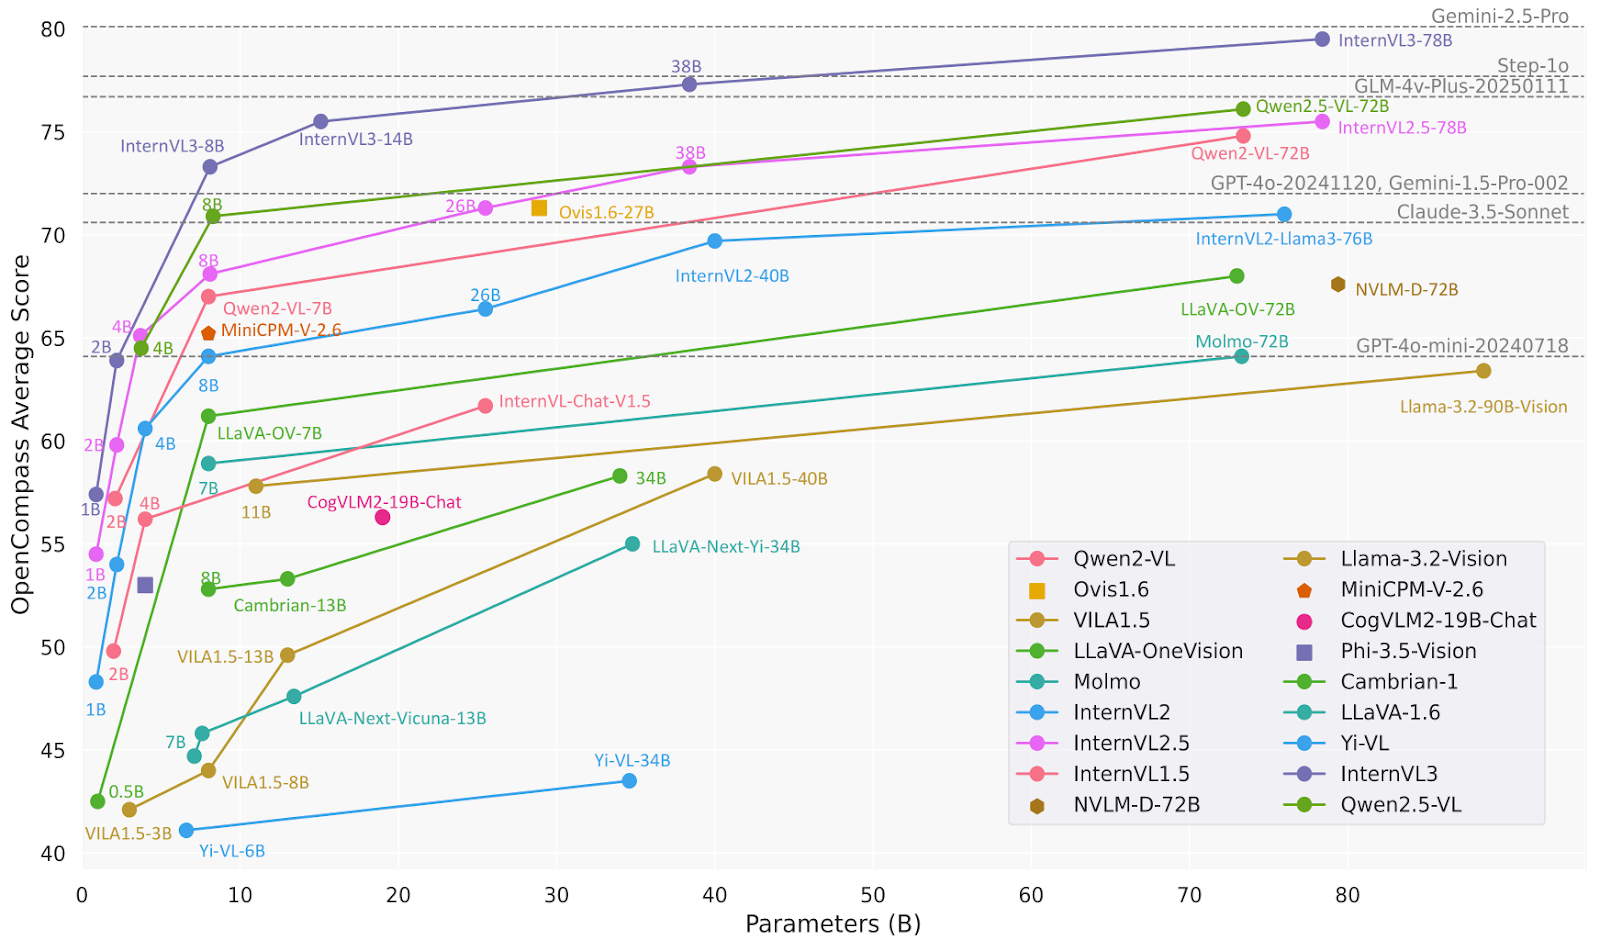
Źródło: OpenGVLab/InternVL3-78B · Hugging Face
Przykładowe użycie:
# pip install lmdeploy>=0.7.3
from lmdeploy import pipeline, TurbomindEngineConfig, ChatTemplateConfig
from lmdeploy.vl import load_image

model = 'OpenGVLab/InternVL3-78B'
image = load_image('https://raw.githubusercontent.com/open-mmlab/mmdeploy/main/tests/data/tiger.jpeg')
pipe = pipeline(model, backend_config=TurbomindEngineConfig(session_len=16384, tp=4), chat_template_config=ChatTemplateConfig(model_name='internvl2_5'))
response = pipe(('Explain the image.', image))
print(response.text)Ovis2 to seria multimodalnych dużych modeli językowych (MLLM) opracowanych przez AIDC-AI. Modele te są zaprojektowane tak, by skutecznie wyrównywać osadzenia wizualne i tekstowe. Model Ovis2-34B wykorzystuje aimv2-1B-patch14-448 jako enkoder wizji oraz Qwen2.5-32B-Instruct jako model językowy, łącznie 34 mld parametrów. Obsługuje maksymalną długość kontekstu 32 768 tokenów i używa precyzji bfloat16 dla wydajnego przetwarzania.
Ovis2-34B osiągnął dobre wyniki w różnych testach benchmarkowych, m.in.:
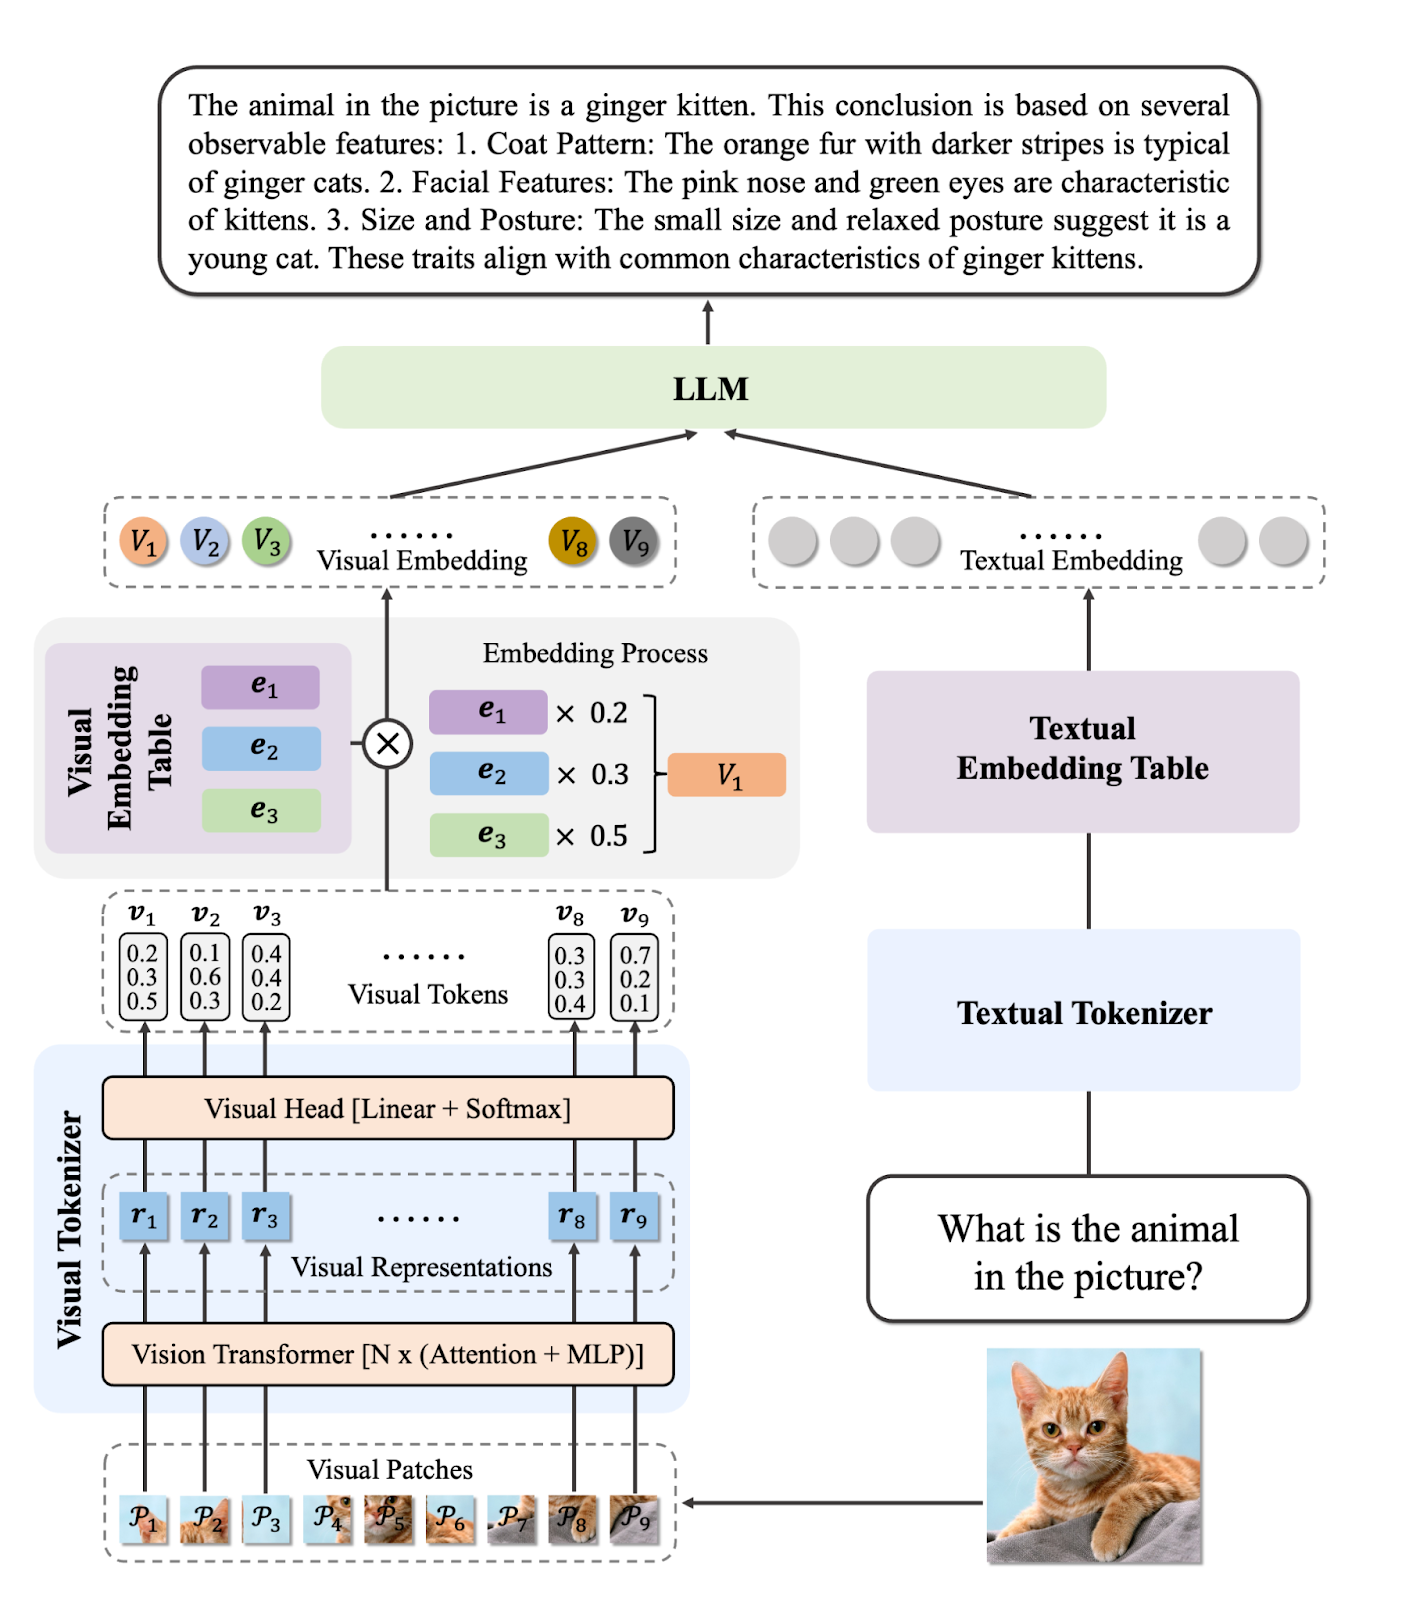
Źródło: AIDC-AI/Ovis2-34B · Hugging Face
Przykładowe użycie:
import torch
from PIL import Image
from transformers import AutoModelForCausalLM

# load model
model = AutoModelForCausalLM.from_pretrained("AIDC-AI/Ovis2-34B",
                                             torch_dtype=torch.bfloat16,
                                             multimodal_max_length=32768,
                                             trust_remote_code=True).cuda()
text_tokenizer = model.get_text_tokenizer()
visual_tokenizer = model.get_visual_tokenizer()

# single-image input
image_path = '/data/images/example_1.jpg'
images = [Image.open(image_path)]
max_partition = 9
text = 'Describe the image.'
query = f'<image>\n{text}'


# format conversation
prompt, input_ids, pixel_values = model.preprocess_inputs(query, images, max_partition=max_partition)
attention_mask = torch.ne(input_ids, text_tokenizer.pad_token_id)
input_ids = input_ids.unsqueeze(0).to(device=model.device)
attention_mask = attention_mask.unsqueeze(0).to(device=model.device)
if pixel_values is not None:
    pixel_values = pixel_values.to(dtype=visual_tokenizer.dtype, device=visual_tokenizer.device)
pixel_values = [pixel_values]

# generate output
with torch.inference_mode():
    gen_kwargs = dict(
        max_new_tokens=1024,
        do_sample=False,
        top_p=None,
        top_k=None,
        temperature=None,
        repetition_penalty=None,
        eos_token_id=model.generation_config.eos_token_id,
        pad_token_id=text_tokenizer.pad_token_id,
        use_cache=True
    )
    output_ids = model.generate(input_ids, pixel_values=pixel_values, attention_mask=attention_mask, **gen_kwargs)[0]
    output = text_tokenizer.decode(output_ids, skip_special_tokens=True)
print(f'Output:\n{output}')Qwen2.5-VL-72B-Instruct to multimodalny duży model językowy (MLLM) z rodziny Qwen, zaprojektowany do rozumienia i przetwarzania informacji wizualnych i tekstowych. Wiele otwartych MLLM bazuje na nim, co pokazuje, że seria Qwen odgrywa ważną rolę w rozwoju badań nad AI.
Qwen2.5-VL-72B-Instruct prezentuje mocne wyniki w wielu benchmarkach, obejmujących rozumienie obrazów i wideo oraz funkcje agentowe. Uzyskuje 70,2 w MMMUval, 74,8 w MathVista_MINI i 70,8 w MMStar.
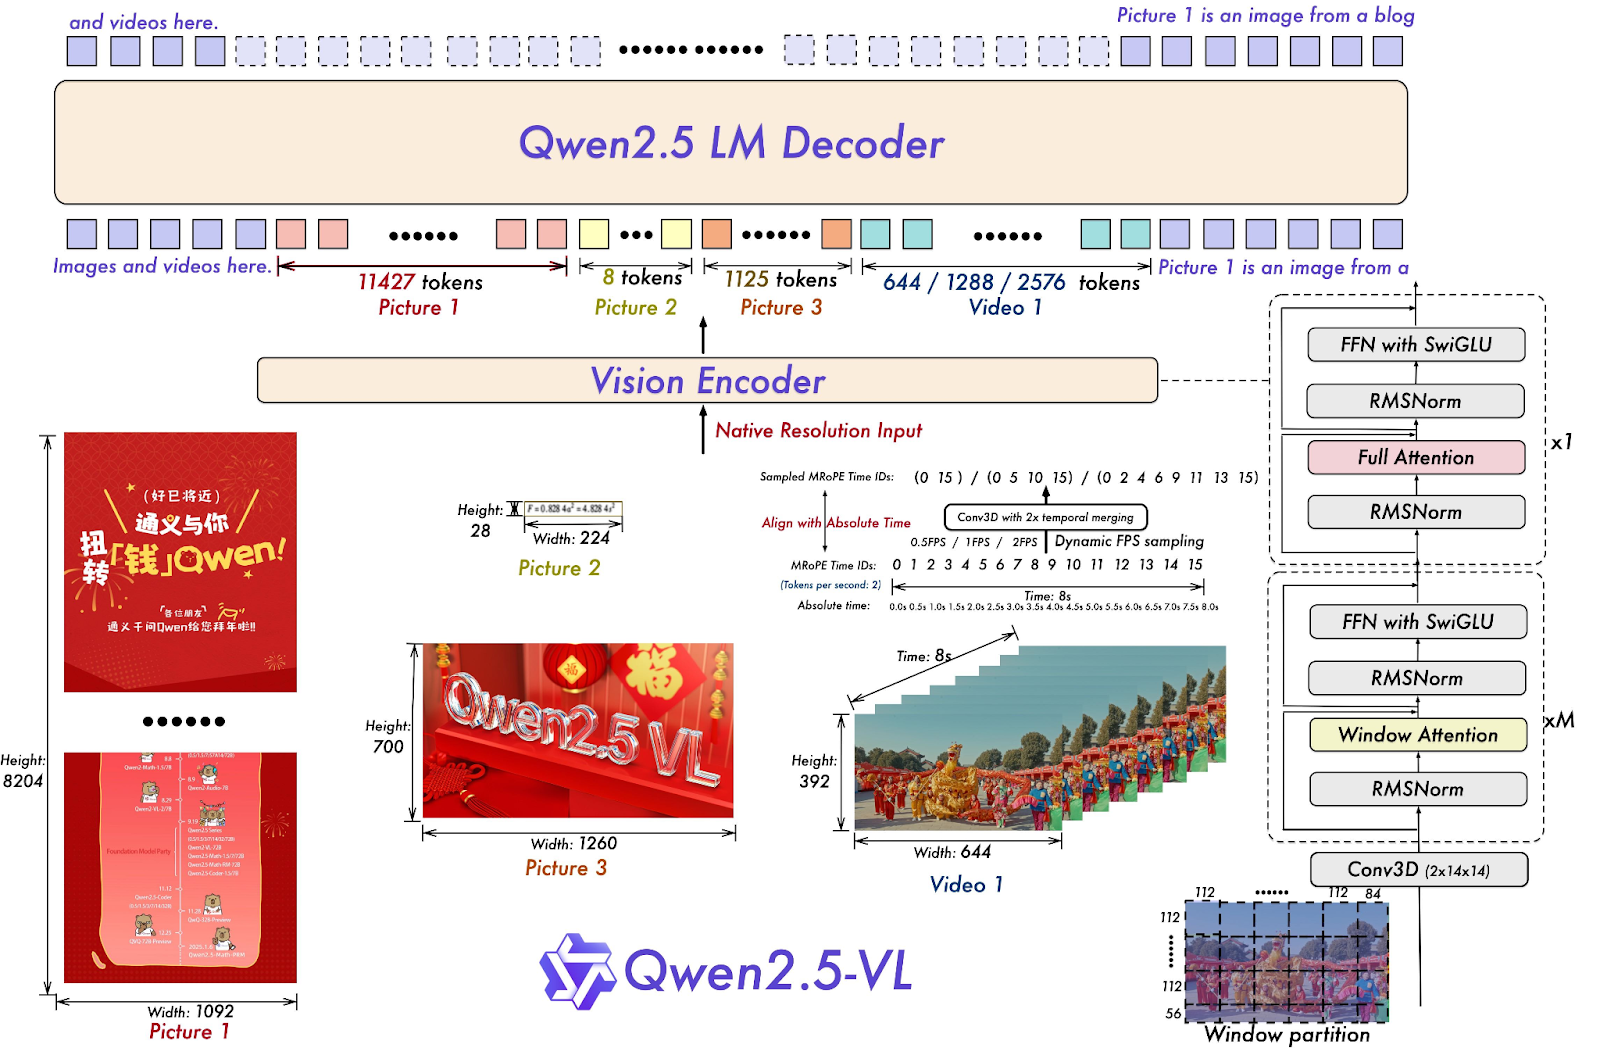
Źródło: Qwen/Qwen2.5-VL-72B-Instruct · Hugging Face
Przykładowe użycie:
# pip install qwen-vl-utils[decord]==0.0.8

from transformers import Qwen2_5_VLForConditionalGeneration, AutoTokenizer, AutoProcessor
from qwen_vl_utils import process_vision_info

# default: Load the model on the available device(s)
model = Qwen2_5_VLForConditionalGeneration.from_pretrained(
    "Qwen/Qwen2.5-VL-72B-Instruct", torch_dtype="auto", device_map="auto"
)
# default processer
processor = AutoProcessor.from_pretrained("Qwen/Qwen2.5-VL-72B-Instruct")


messages = [
    {
        "role": "user",
        "content": [
            {
                "type": "image",
                "image": "https://qianwen-res.oss-cn-beijing.aliyuncs.com/Qwen-VL/assets/demo.jpeg",
            },
            {"type": "text", "text": "Describe this image."},
        ],
    }
]

# Preparation for inference
text = processor.apply_chat_template(
    messages, tokenize=False, add_generation_prompt=True
)
image_inputs, video_inputs = process_vision_info(messages)
inputs = processor(
    text=[text],
    images=image_inputs,
    videos=video_inputs,
    padding=True,
    return_tensors="pt",
)
inputs = inputs.to("cuda")

# Inference: Generation of the output
generated_ids = model.generate(**inputs, max_new_tokens=128)
generated_ids_trimmed = [
    out_ids[len(in_ids) :] for in_ids, out_ids in zip(inputs.input_ids, generated_ids)
]
output_text = processor.batch_decode(
    generated_ids_trimmed, skip_special_tokens=True, clean_up_tokenization_spaces=False
)
print(output_text)o3 od OpenAI to nowy model rozumowania zaprojektowany, by zapewniać wyższą inteligencję, niższe koszty i bardziej efektywne wykorzystanie tokenów w aplikacjach. Reprezentuje nową generację modeli z naciskiem na zaawansowane zdolności rozumowania.
Model ten wyznacza nowy standard dla zadań z matematyki, nauk ścisłych, programowania i rozumowania wizualnego. W różnych benchmarkach wizji przewyższa zarówno o4-min, jak i o1, a jest porównywalny z o3 Pro.
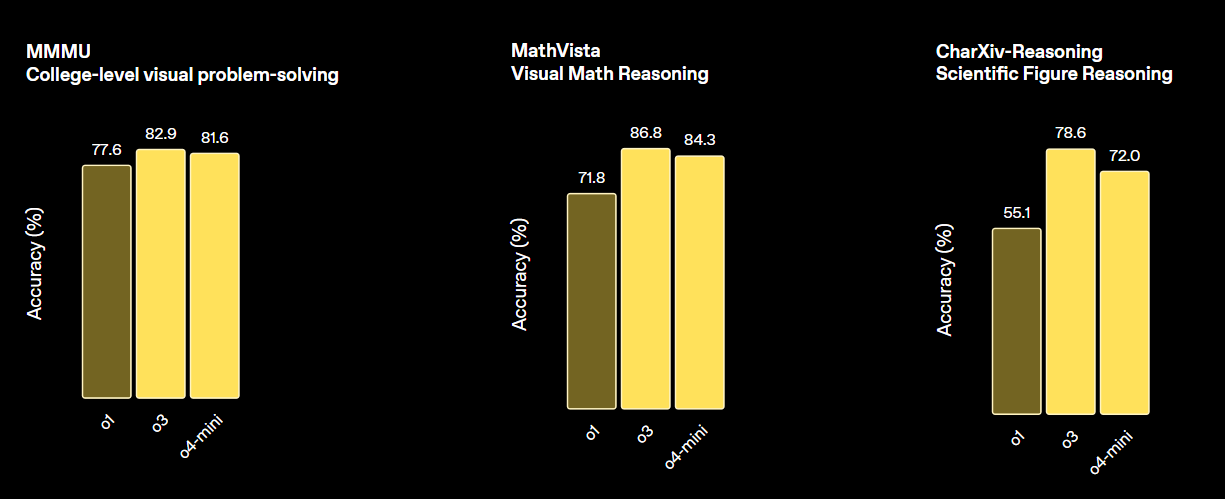
Źródło: Introducing OpenAI o3 and o4-mini | OpenAI
Przykładowe użycie:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="o3-2025-04-16",
    input=[{
        "role": "user",
        "content": [
            {"type": "input_text", "text": "what's in this image?"},
            {
                "type": "input_image",
                "image_url": "https://upload.wikimedia.org/wikipedia/commons/thumb/d/dd/Gfp-wisconsin-madison-the-nature-boardwalk.jpg/2560px-Gfp-wisconsin-madison-the-nature-boardwalk.jpg",
            },
        ],
    }],
)

print(response.output_text)GPT-4.1 to nowa rodzina modeli bez komponentu rozumowania, obejmująca GPT-4.1, GPT-4.1 Mini i GPT-4.1 Nano. Modele te przewyższają swoich poprzedników, GPT-4o i GPT-4o Mini, w wielu benchmarkach.
GPT-4.1 zachowuje silne możliwości wizualne, z usprawnieniami w analizie wykresów, diagramów i matematyki wizualnej. Świetnie radzi sobie z liczeniem obiektów, wizualnym odpowiadaniem na pytania oraz różnymi formami OCR.
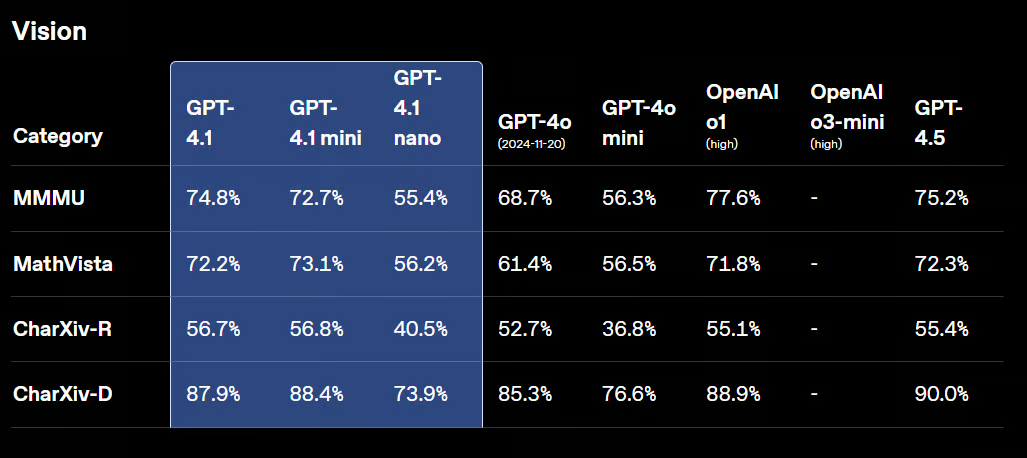
Źródło: Introducing GPT-4.1 in the API | OpenAI
Przykładowe użycie:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-4.1-2025-04-14",
    input=[{
        "role": "user",
        "content": [
            {"type": "input_text", "text": "what's in this image?"},
            {
                "type": "input_image",
                "image_url": "https://upload.wikimedia.org/wikipedia/commons/thumb/d/dd/Gfp-wisconsin-madison-the-nature-boardwalk.jpg/2560px-Gfp-wisconsin-madison-the-nature-boardwalk.jpg",
            },
        ],
    }],
)

print(response.output_text)Anthropic zaprezentował kolejną generację modeli Claude: Claude 4 Opus oraz Claude 4 Sonnet. Modele te wyznaczają nowe standardy w programowaniu, zaawansowanym rozumowaniu i możliwościach AI.
Oferują ulepszone możliwości wizji, które pozwalają użytkownikom rozumieć obrazy, a następnie generować kod lub dostarczać informacje na ich podstawie. Chociaż to zasadniczo model do kodowania, ma też możliwości multimodalne, dzięki czemu rozumie różne formaty plików.
Jak pokazuje tabela porównawcza poniżej, Claude 4 przewyższa wszystkie czołowe modele, z wyjątkiem GPT-3 od OpenAI, szczególnie w rozumowaniu wizualnym i wizualnym odpowiadaniu na pytania.
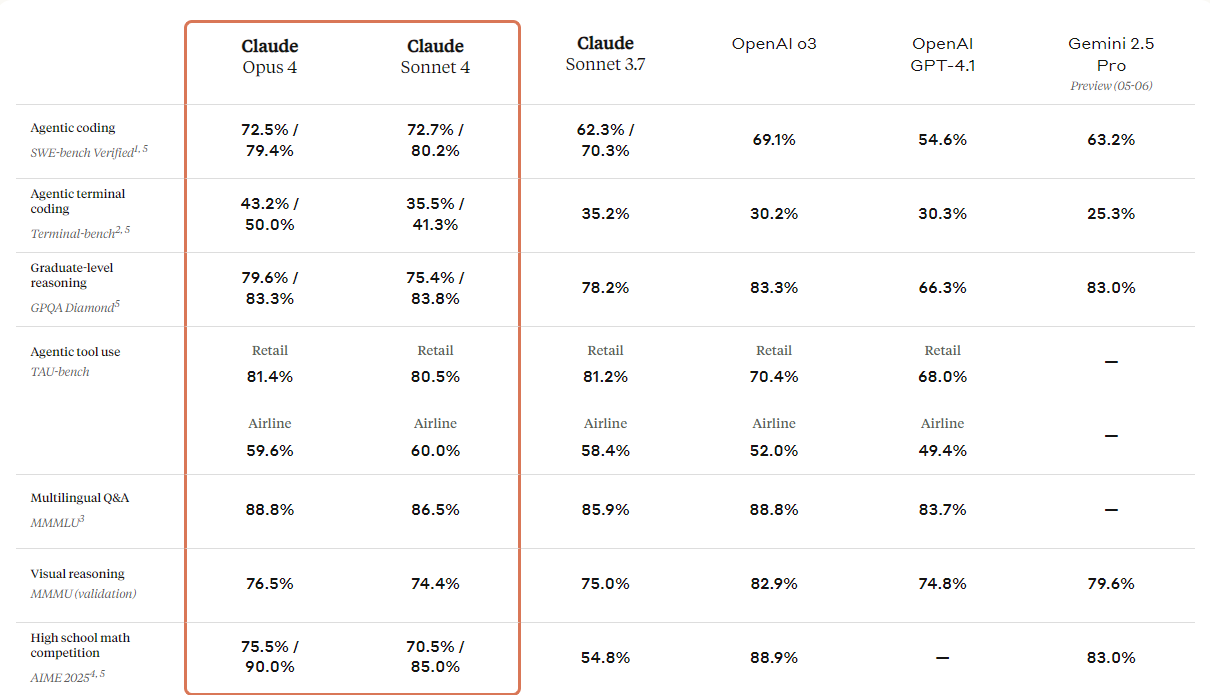
Źródło: Introducing Claude 4 \ Anthropic
Przykładowe użycie:
import anthropic

client = anthropic.Anthropic()
message = client.messages.create(
    model="claude-sonnet-4-20250514",
    max_tokens=1024,
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image",
                    "source": {
                        "type": "url",
                        "url": "https://upload.wikimedia.org/wikipedia/commons/a/a7/Camponotus_flavomarginatus_ant.jpg",
                    },
                },
                {
                    "type": "text",
                    "text": "Describe this image."
                }
            ],
        }
    ],
)
print(message)Kimi-VL-A3B-Thinking-2506 to otwarty model stanowiący istotny postęp w multimodalnym AI. Wyróżnia się w benchmarkach rozumowania multimodalnego, uzyskując imponujące wyniki: 56,9 w MathVision, 80,1 w MathVista, 46,3 w MMMU-Pro i 64,0 w MMMU, przy średnim skróceniu „długości myślenia” o 20%.
Poza rozumowaniem, wersja 2506 wykazuje lepszą ogólną percepcję i rozumienie wizualne. Dorównuje lub przewyższa modele bez trybu „thinking” w benchmarkach takich jak MMBench-EN-v1.1 (84,4), MMStar (70,4), RealWorldQA (70,0) i MMVet (78,4).
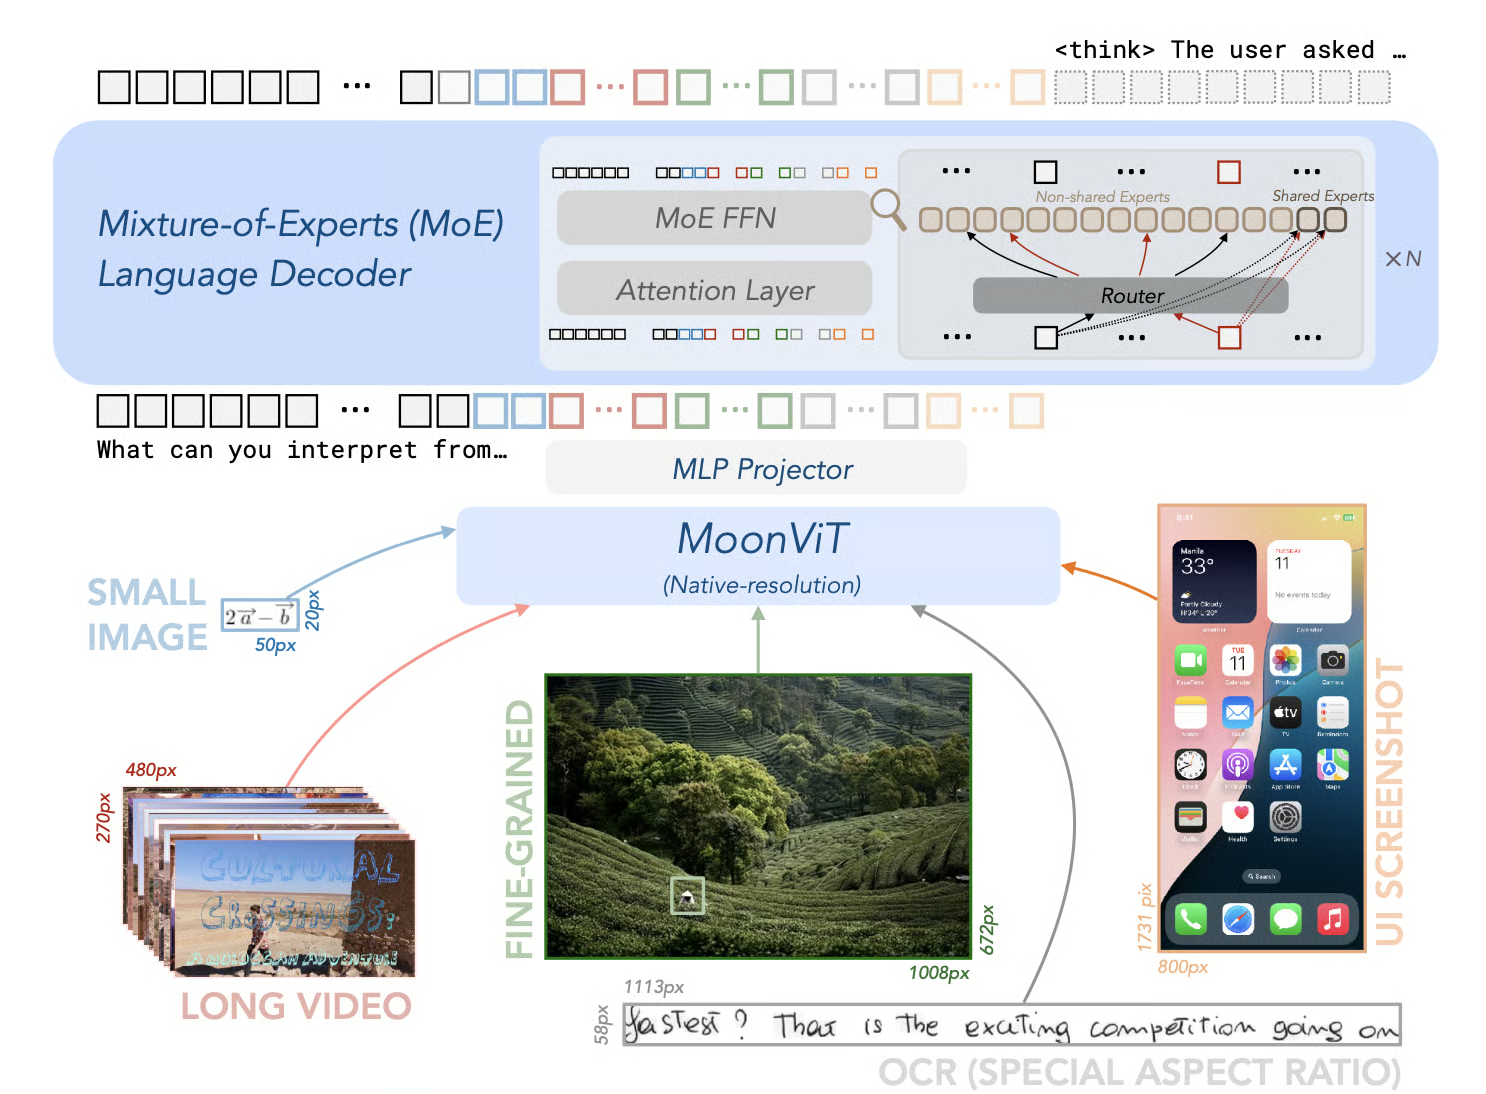
Źródło: MoonshotAI/Kimi-VL: Kimi-VL
Przykładowe użycie:
from transformers import AutoProcessor
from vllm import LLM, SamplingParams

model_path = "moonshotai/Kimi-VL-A3B-Thinking-2506"
llm = LLM(
    model_path,
    trust_remote_code=True,
    max_num_seqs=8,
    max_model_len=131072,
    limit_mm_per_prompt={"image": 256}
)

processor = AutoProcessor.from_pretrained(model_path, trust_remote_code=True)

sampling_params = SamplingParams(max_tokens=32768, temperature=0.8)


import requests
from PIL import Image

def extract_thinking_and_summary(text: str, bot: str = "◁think▷", eot: str = "◁/think▷") -> str:
    if bot in text and eot not in text:
        return ""
    if eot in text:
        return text[text.index(bot) + len(bot):text.index(eot)].strip(), text[text.index(eot) + len(eot) :].strip()
    return "", text

OUTPUT_FORMAT = "--------Thinking--------\n{thinking}\n\n--------Summary--------\n{summary}"

url = "https://huggingface.co/spaces/moonshotai/Kimi-VL-A3B-Thinking/resolve/main/images/demo6.jpeg"
image = Image.open(requests.get(url,stream=True).raw)

messages = [
    {"role": "user", "content": [{"type": "image", "image": ""}, {"type": "text", "text": "What kind of cat is this? Answer with one word."}]}
]
text = processor.apply_chat_template(messages, add_generation_prompt=True, return_tensors="pt")

outputs = llm.generate([{"prompt": text, "multi_modal_data": {"image": image}}], sampling_params=sampling_params)
generated_text = outputs[0].outputs[0].text

thinking, summary = extract_thinking_and_summary(generated_text)
print(OUTPUT_FORMAT.format(thinking=thinking, summary=summary))Gemma 3 to rodzina multimodalnych modeli AI opracowanych przez Google, zdolnych do przetwarzania wejść tekstowych i obrazowych oraz generowania wyjść tekstowych. Modele są dostępne w rozmiarach: 1B, 4B, 12B i 27B, aby dopasować się do różnych wymagań sprzętowych i wydajnościowych.
Największy wariant, Gemma 3 27B, osiąga imponujące wyniki w ocenach preferencji użytkowników, przewyższając nawet większe modele, takie jak Llama 3-405B i DeepSeek-V3.
Modele wykazują mocne możliwości w różnych benchmarkach. W szczególności wyróżniają się w zadaniach multimodalnych, osiągając znaczące wyniki w testach takich jak COCOcap (116), DocVQA (85,6), MMMU (56,1) i VQAv2 (72,9).
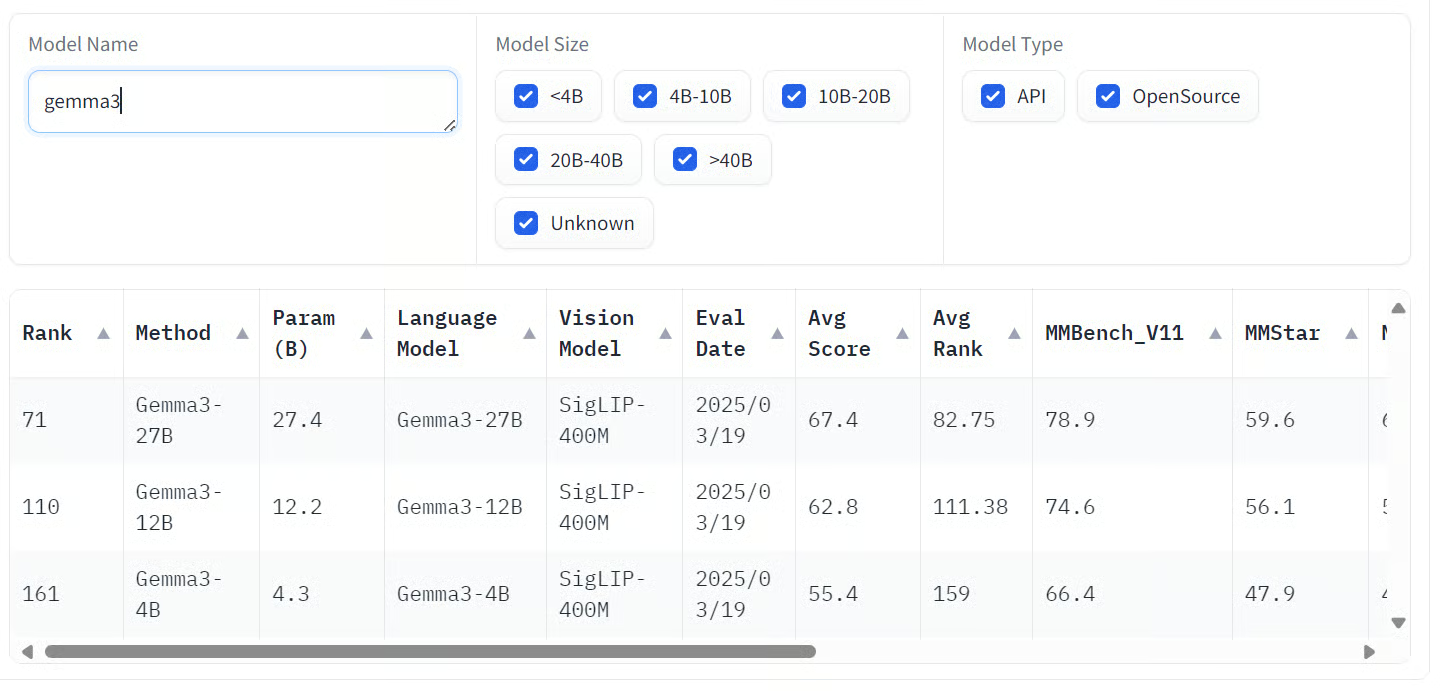
Źródło: Open VLM Leaderboard
Przykładowe użycie:
# pip install accelerate

from transformers import AutoProcessor, Gemma3ForConditionalGeneration
from PIL import Image
import requests
import torch

model_id = "google/gemma-3-27b-it"

model = Gemma3ForConditionalGeneration.from_pretrained(
    model_id, device_map="auto"
).eval()

processor = AutoProcessor.from_pretrained(model_id)

messages = [
    {
        "role": "system",
        "content": [{"type": "text", "text": "You are a helpful assistant."}]
    },
    {
        "role": "user",
        "content": [
            {"type": "image", "image": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/bee.jpg"},
            {"type": "text", "text": "Describe this image in detail."}
        ]
    }
]

inputs = processor.apply_chat_template(
    messages, add_generation_prompt=True, tokenize=True,
    return_dict=True, return_tensors="pt"
).to(model.device, dtype=torch.bfloat16)

input_len = inputs["input_ids"].shape[-1]

with torch.inference_mode():
    generation = model.generate(**inputs, max_new_tokens=100, do_sample=False)
    generation = generation[0][input_len:]

decoded = processor.decode(generation, skip_special_tokens=True)
print(decoded)Model Llama 3.2 90B Vision Instruct to zaawansowany multimodalny duży model językowy opracowany przez Meta. Jest przeznaczony do zadań związanych z rozpoznawaniem obrazów, rozumowaniem na obrazach i tworzeniem podpisów.
Llama 3.2 90B Vision Instruct bazuje na tekstowej wersji Llama 3.1 i wykorzystuje osobno trenowany adapter wizji, który pozwala mu przyjmować obrazy i tekst jako wejście oraz generować precyzyjne odpowiedzi tekstowe.
Trenowany na ogromną skalę, model Llama 3.2 90B Vision wymagał 8,85 mln godzin GPU. Osiąga znakomite wyniki w benchmarkach takich jak VQAv2 (73,6), Text VQA (73,5) i DocVQA (70,7).
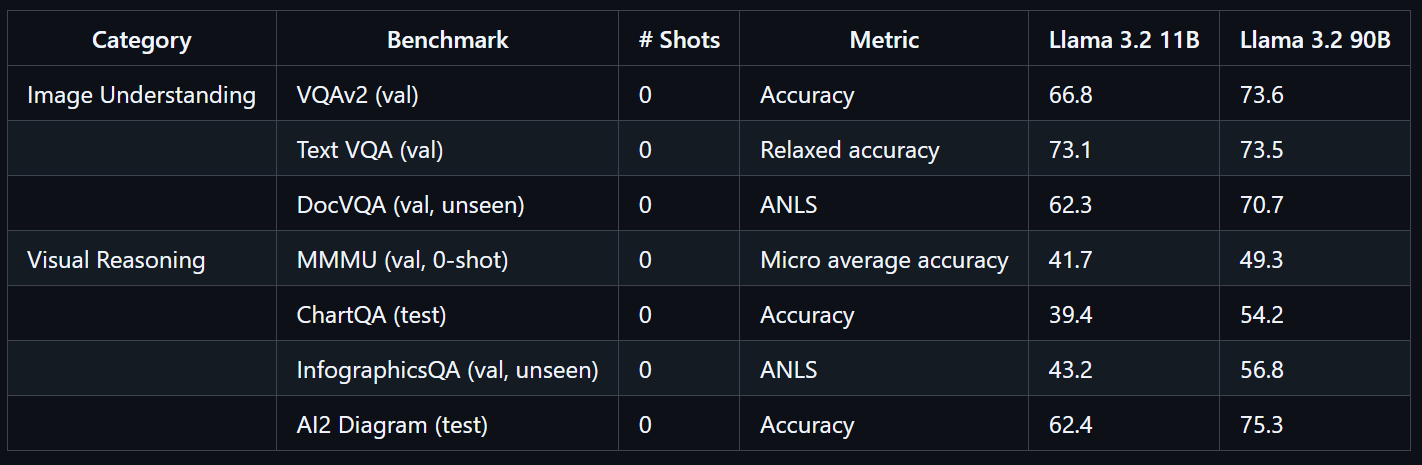
Źródło: llama-models
Przykładowe użycie:
import requests
import torch
from PIL import Image
from transformers import MllamaForConditionalGeneration, AutoProcessor

model_id = "meta-llama/Llama-3.2-90B-Vision-Instruct"

model = MllamaForConditionalGeneration.from_pretrained(
    model_id,
    torch_dtype=torch.bfloat16,
    device_map="auto",
)
processor = AutoProcessor.from_pretrained(model_id)

url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/0052a70beed5bf71b92610a43a52df6d286cd5f3/diffusers/rabbit.jpg"
image = Image.open(requests.get(url, stream=True).raw)

messages = [
    {"role": "user", "content": [
        {"type": "image"},
        {"type": "text", "text": "If I had to write a haiku for this one, it would be: "}
    ]}
]
input_text = processor.apply_chat_template(messages, add_generation_prompt=True)
inputs = processor(
    image,
    input_text,
    add_special_tokens=False,
    return_tensors="pt",
).to(model.device)

output = model.generate(**inputs, max_new_tokens=30)
print(processor.decode(output[0]))
Rozumowanie wizualne z wykorzystaniem wykresów jest też mocną stroną najnowszego modelu Meta, Muse Spark.
Modele vision-language fundamentalnie zmieniają sposób, w jaki pracujemy z informacjami wizualnymi i tekstowymi, oferując znakomitą dokładność i elastyczność w wielu branżach. Płynnie łączą komputerowe widzenie z przetwarzaniem języka naturalnego, umożliwiając nowe zastosowania — od zaawansowanego wykrywania obiektów po intuicyjne asystenty wizualne.
Jeśli prywatność i bezpieczeństwo są u ciebie priorytetem, zdecydowanie warto rozważyć otwarte modele vision-language. Uruchamianie ich lokalnie daje pełną kontrolę nad danymi, co jest idealne w wrażliwych środowiskach. Otwarte VLM są też bardzo elastyczne; większość można dostroić na podstawie zaledwie kilkuset próbek, by uzyskać świetne wyniki dopasowane do twoich potrzeb.
Modele komercyjne z kolei zapewniają niezawodny i opłacalny dostęp do najnowocześniejszych możliwości. Zwykle cechują się wysoką dokładnością i można je zintegrować z twoim workflow kilkoma liniami kodu, co sprawia, że są dostępne także dla zespołów bez głębokiej ekspertyzy w AI.
Jeśli chcesz dowiedzieć się więcej o modelach vision language, sprawdź te zasoby:
Najlepsze kursy DataCamp
course
course
Track