course
Python में इमेज प्रोसेसिंग
4 घंटा
56.8K
विज़न लैंग्वेज मॉडल (VLMs) तेजी से उद्योगों को बदल रहे हैं, क्योंकि ये AI सिस्टम को छवियों और पाठ—दोनों—को समझने और उन पर तर्क करने में सक्षम बनाते हैं। पारंपरिक कंप्यूटर विज़न मॉडलों के विपरीत, आधुनिक VLMs जटिल छवियों की व्याख्या कर सकते हैं, दृश्य सामग्री पर विस्तृत प्रश्नों के उत्तर दे सकते हैं, और यहां तक कि एम्बेडेड टेक्स्ट वाले वीडियो और दस्तावेज़ भी प्रोसेस कर सकते हैं।
यह क्षमता उन्हें चिकित्सा निदान, स्वचालित गुणवत्ता नियंत्रण और ऐसे संवेदनशील उपयोगों के लिए अमूल्य बनाती है, जहाँ गति से अधिक सटीकता मायने रखती है।
इस ब्लॉग में, हम 2026 के शीर्ष विज़न-लैंग्वेज मॉडलों की समीक्षा करेंगे—ओपन-सोर्स और स्वामित्व वाले, दोनों विकल्पों सहित। हम उनकी विशिष्ट क्षमताओं पर प्रकाश डालेंगे और फिर उनके प्रदर्शन व बेंचमार्क परिणाम प्रस्तुत करेंगे। डेवलपर्स और शोधकर्ताओं के लिए, हमने उदाहरण कोड स्निपेट भी शामिल किए हैं ताकि आप इन मॉडलों को जल्दी से स्वयं आज़मा सकें।
यदि आप इन मॉडलों की बुनियादी बातों के बारे में और जानने के इच्छुक हैं, तो हमारा Image Processing in Python स्किल ट्रैक अवश्य देखें।
Gemini 2.5 Pro Google का सबसे उन्नत AI मॉडल है, जो वर्तमान में विज़न और कोडिंग कार्यों के लिए LMArena और WebDevArena लीडरबोर्ड पर अग्रणी है। यह पाठ, छवियाँ, ऑडियो और वीडियो में जटिल तर्क और समझ के लिए डिज़ाइन किया गया है।
विज़न-लैंग्वेज क्षमताओं के संदर्भ में, यह Open LLM लीडरबोर्ड पर शीर्ष मॉडलों में शुमार है। Gemini 2.5 Pro छवियों और वीडियो की व्याख्या कर सकता है, विस्तृत और संदर्भ-संगत वर्णन जनरेट करता है, और दृश्य सामग्री से जुड़े प्रश्नों के उत्तर देता है।
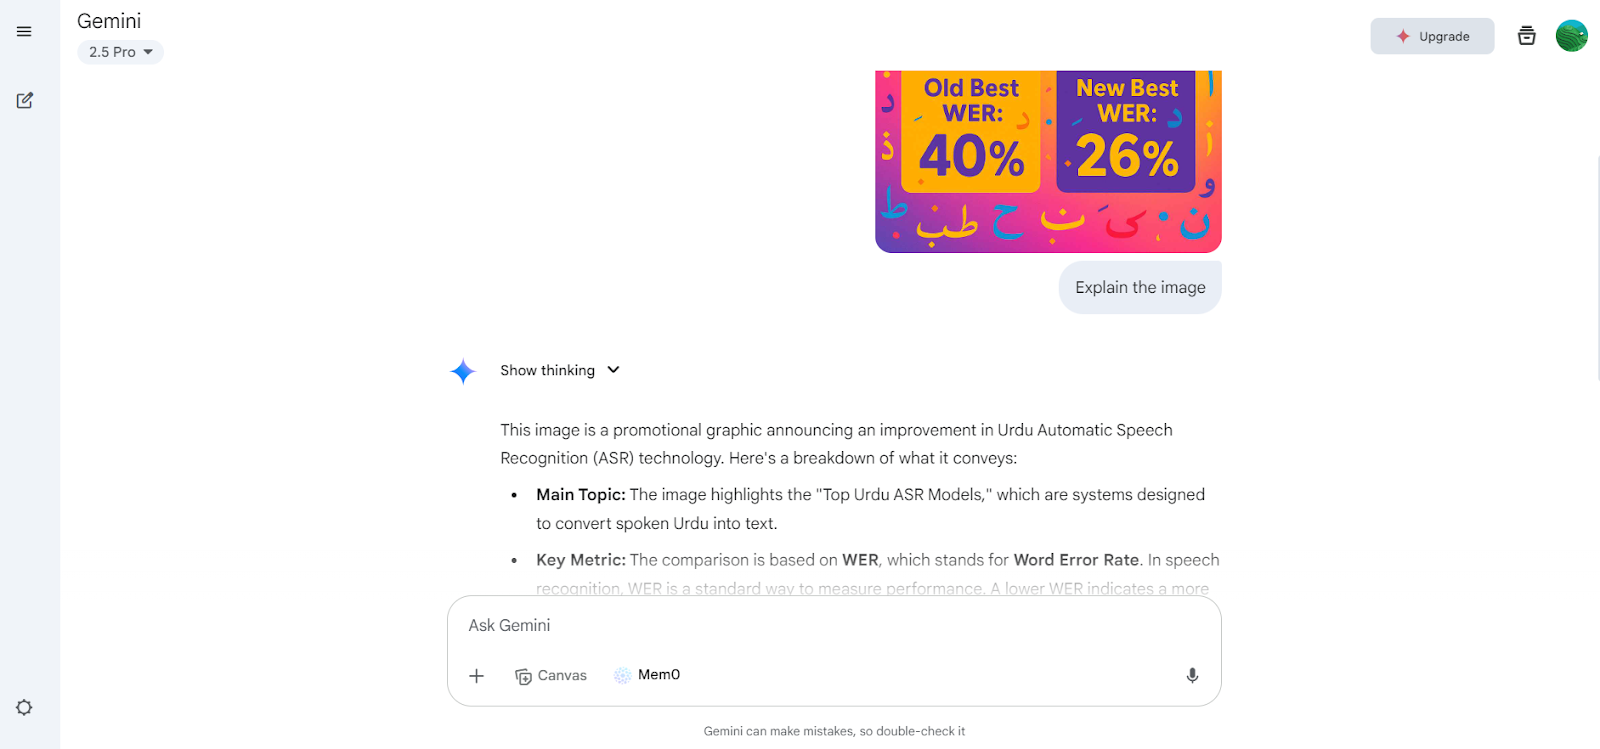
स्रोत: Google Gemini
आप gemini.google.com/app पर Gemini वेब ऐप के माध्यम से या Google AI Studio का उपयोग करके, Gemini 2.5 Pro तक निःशुल्क पहुँच प्राप्त कर सकते हैं।
डेवलपर्स के लिए, Gemini 2.5 Pro Gemini API, Vertex AI और आधिकारिक Python SDK के माध्यम से भी उपलब्ध है, जिससे इसकी विज़न-लैंग्वेज क्षमताओं को अपनी ऐप्लिकेशन या वर्कफ़्लो में शामिल करना आसान हो जाता है।
उदाहरण उपयोग:
from google.genai import types

with open('path/to/image.jpg', 'rb') as f:
      image_bytes = f.read()

  response = client.models.generate_content(
    model='gemini-2.5-pro',
    contents=[
      types.Part.from_bytes(
        data=image_bytes,
        mime_type='image/jpeg',
      ),
      'Explain the image.'
    ]
  )
print(response.text)InternVL3 एक उन्नत मल्टीमॉडल लार्ज लैंग्वेज मॉडल (MLLMs) श्रृंखला है जो अपने पूर्ववर्ती InternVL 2.5 से बेहतर प्रदर्शन करती है। यह मल्टीमॉडल परसेप्शन और रीजनिंग में उत्कृष्ट है और इसमें टूल उपयोग, GUI एजेंट, औद्योगिक छवि विश्लेषण और 3D विज़न परसेप्शन सहित उन्नत क्षमताएँ हैं।
विशेष रूप से, InternVL3-78B मॉडल अपने विज़न घटक के लिए InternViT-6B-448px-V2_5 और भाषा घटक के लिए Qwen2.5-72B का उपयोग करता है। कुल 78.41 अरब पैरामीटर के साथ, InternVL3-78B ने MMMU बेंचमार्क पर 72.2 का स्कोर हासिल किया है, जो ओपन-सोर्स MLLMs में एक नया स्टेट-ऑफ-द-आर्ट रिकॉर्ड स्थापित करता है। इसका प्रदर्शन अग्रणी स्वामित्व वाले मॉडलों के समकक्ष है।
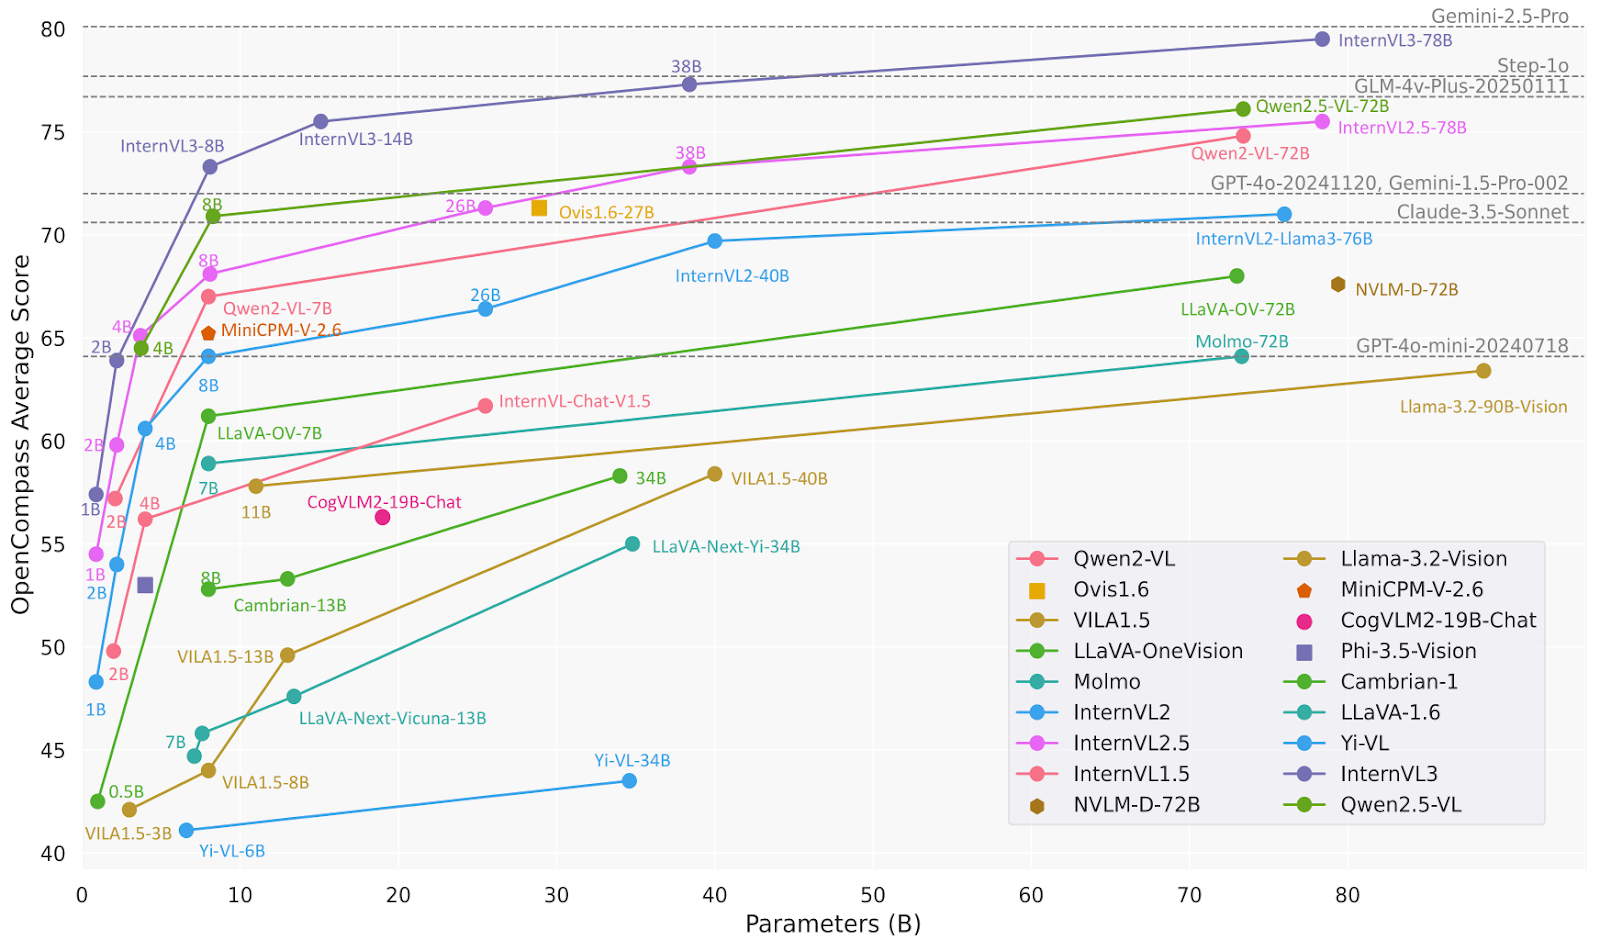
स्रोत: OpenGVLab/InternVL3-78B · Hugging Face
उदाहरण उपयोग:
# pip install lmdeploy>=0.7.3
from lmdeploy import pipeline, TurbomindEngineConfig, ChatTemplateConfig
from lmdeploy.vl import load_image

model = 'OpenGVLab/InternVL3-78B'
image = load_image('https://raw.githubusercontent.com/open-mmlab/mmdeploy/main/tests/data/tiger.jpeg')
pipe = pipeline(model, backend_config=TurbomindEngineConfig(session_len=16384, tp=4), chat_template_config=ChatTemplateConfig(model_name='internvl2_5'))
response = pipe(('Explain the image.', image))
print(response.text)Ovis2 AIDC-AI द्वारा विकसित मल्टीमॉडल लार्ज लैंग्वेज मॉडलों (MLLMs) की एक श्रृंखला है। ये मॉडल दृश्य और पाठ्य एम्बेडिंग को प्रभावी ढंग से संरेखित करने के लिए डिज़ाइन किए गए हैं। विशेष रूप से, Ovis2-34B मॉडल अपने विज़न एन्कोडर के रूप में aimv2-1B-patch14-448 और भाषा मॉडल के रूप में Qwen2.5-32B-Instruct का उपयोग करता है, जो कुल 34 अरब पैरामीटर होते हैं। यह अधिकतम 32,768 टोकन के कॉन्टेक्स्ट लंबाई का समर्थन करता है और कुशल प्रोसेसिंग के लिए bfloat16 प्रिसिशन का उपयोग करता है।
Ovis2-34B ने विभिन्न बेंचमार्क परीक्षणों पर मजबूत प्रदर्शन दिखाया है और निम्नलिखित परिणाम हासिल किए हैं:
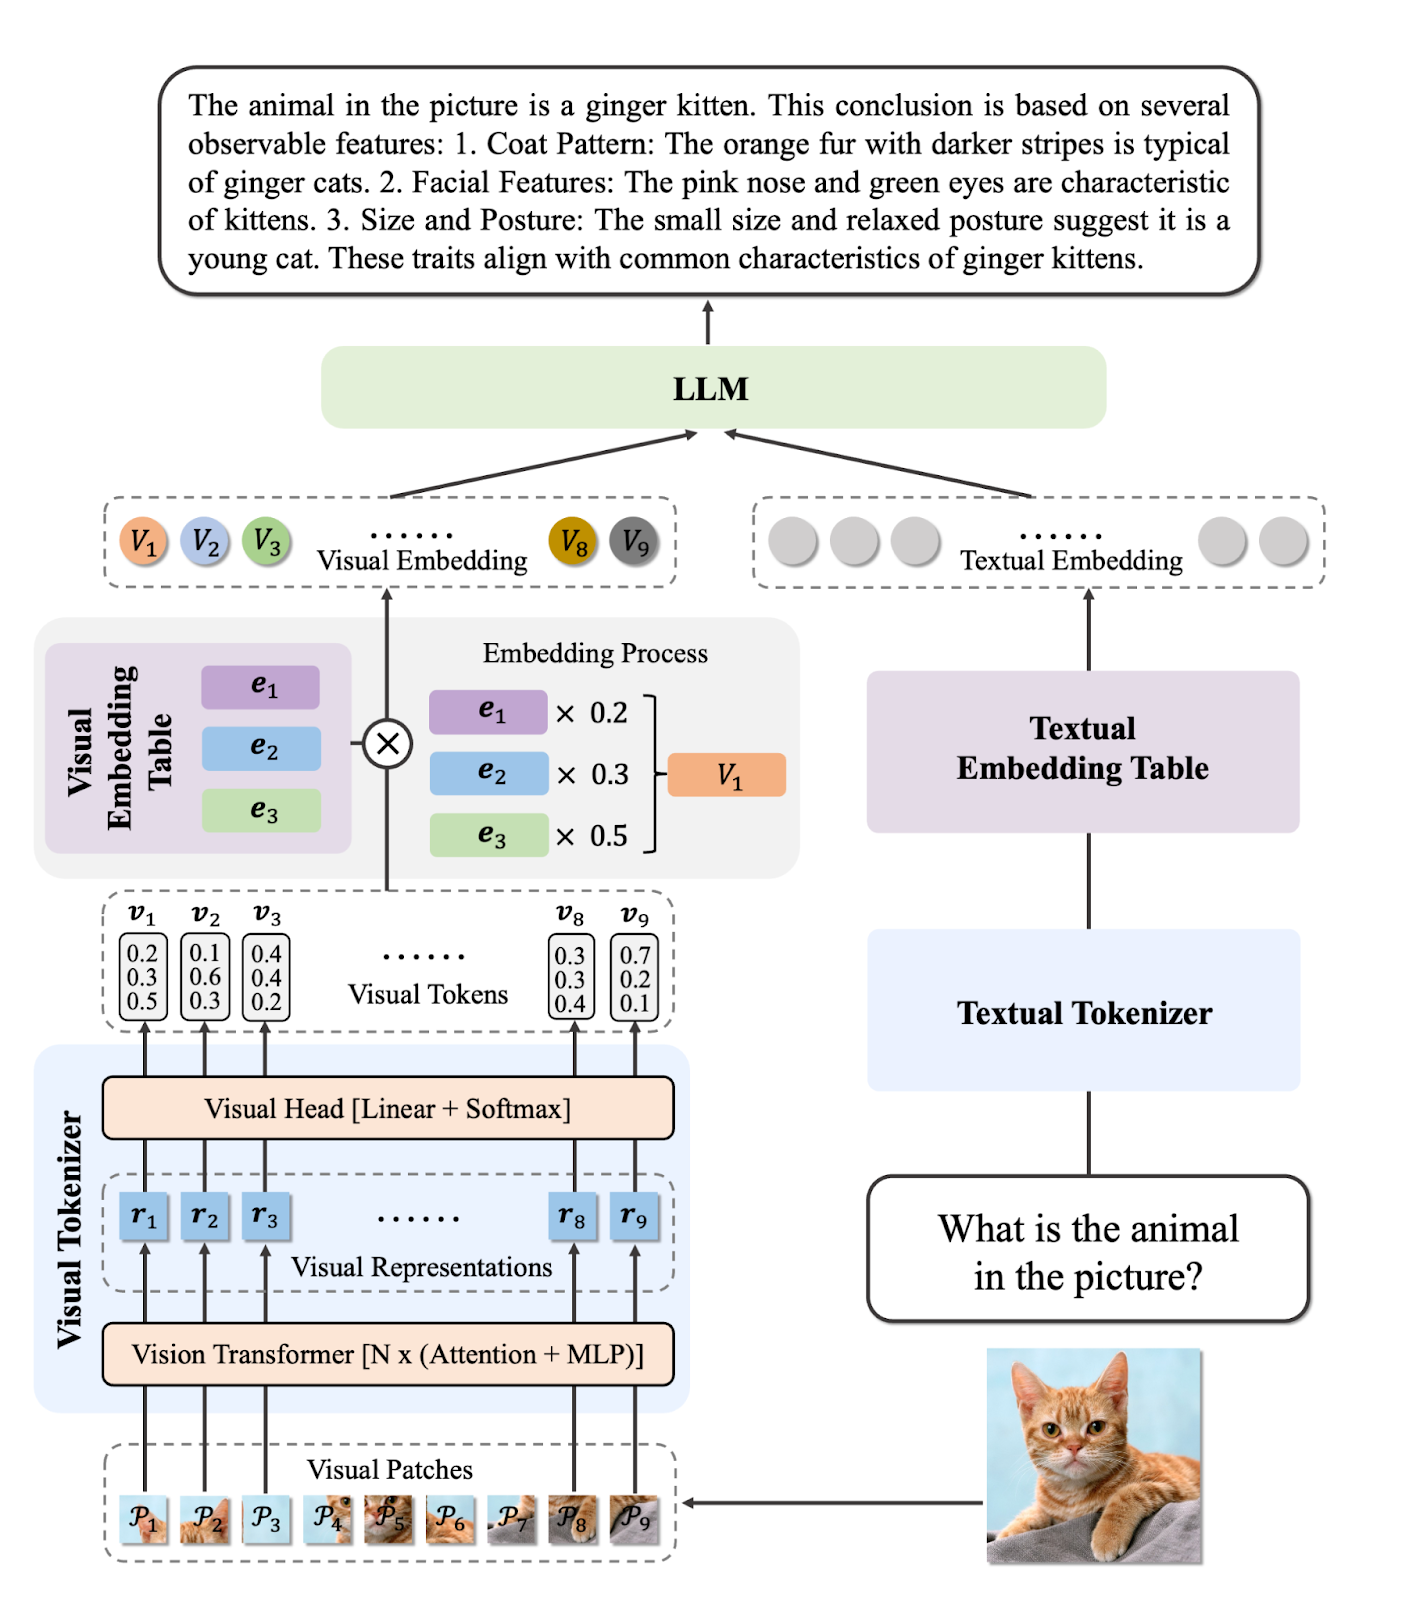
स्रोत: AIDC-AI/Ovis2-34B · Hugging Face
उदाहरण उपयोग:
import torch
from PIL import Image
from transformers import AutoModelForCausalLM

# load model
model = AutoModelForCausalLM.from_pretrained("AIDC-AI/Ovis2-34B",
                                             torch_dtype=torch.bfloat16,
                                             multimodal_max_length=32768,
                                             trust_remote_code=True).cuda()
text_tokenizer = model.get_text_tokenizer()
visual_tokenizer = model.get_visual_tokenizer()

# single-image input
image_path = '/data/images/example_1.jpg'
images = [Image.open(image_path)]
max_partition = 9
text = 'Describe the image.'
query = f'<image>\n{text}'


# format conversation
prompt, input_ids, pixel_values = model.preprocess_inputs(query, images, max_partition=max_partition)
attention_mask = torch.ne(input_ids, text_tokenizer.pad_token_id)
input_ids = input_ids.unsqueeze(0).to(device=model.device)
attention_mask = attention_mask.unsqueeze(0).to(device=model.device)
if pixel_values is not None:
    pixel_values = pixel_values.to(dtype=visual_tokenizer.dtype, device=visual_tokenizer.device)
pixel_values = [pixel_values]

# generate output
with torch.inference_mode():
    gen_kwargs = dict(
        max_new_tokens=1024,
        do_sample=False,
        top_p=None,
        top_k=None,
        temperature=None,
        repetition_penalty=None,
        eos_token_id=model.generation_config.eos_token_id,
        pad_token_id=text_tokenizer.pad_token_id,
        use_cache=True
    )
    output_ids = model.generate(input_ids, pixel_values=pixel_values, attention_mask=attention_mask, **gen_kwargs)[0]
    output = text_tokenizer.decode(output_ids, skip_special_tokens=True)
print(f'Output:\n{output}')Qwen2.5-VL-72B-Instruct Qwen परिवार का एक मल्टीमॉडल लार्ज लैंग्वेज मॉडल (MLLM) है, जिसे दृश्य और पाठ्य दोनों जानकारी को समझने और प्रोसेस करने के लिए डिजाइन किया गया है। कई ओपन-सोर्स MLLM मॉडल इसी पर आधारित हैं, जो दर्शाता है कि Qwen श्रृंखला AI अनुसंधान को आगे बढ़ाने में महत्वपूर्ण भूमिका निभाती है।
Qwen2.5-VL-72B-Instruct विभिन्न बेंचमार्क पर मजबूत प्रदर्शन दिखाता है—छवि और वीडियो समझ के साथ-साथ एजेंट फ़ंक्शंस में भी। यह MMMUval बेंचमार्क पर 70.2, MathVista_MINI पर 74.8, और MMStar पर 70.8 स्कोर करता है।
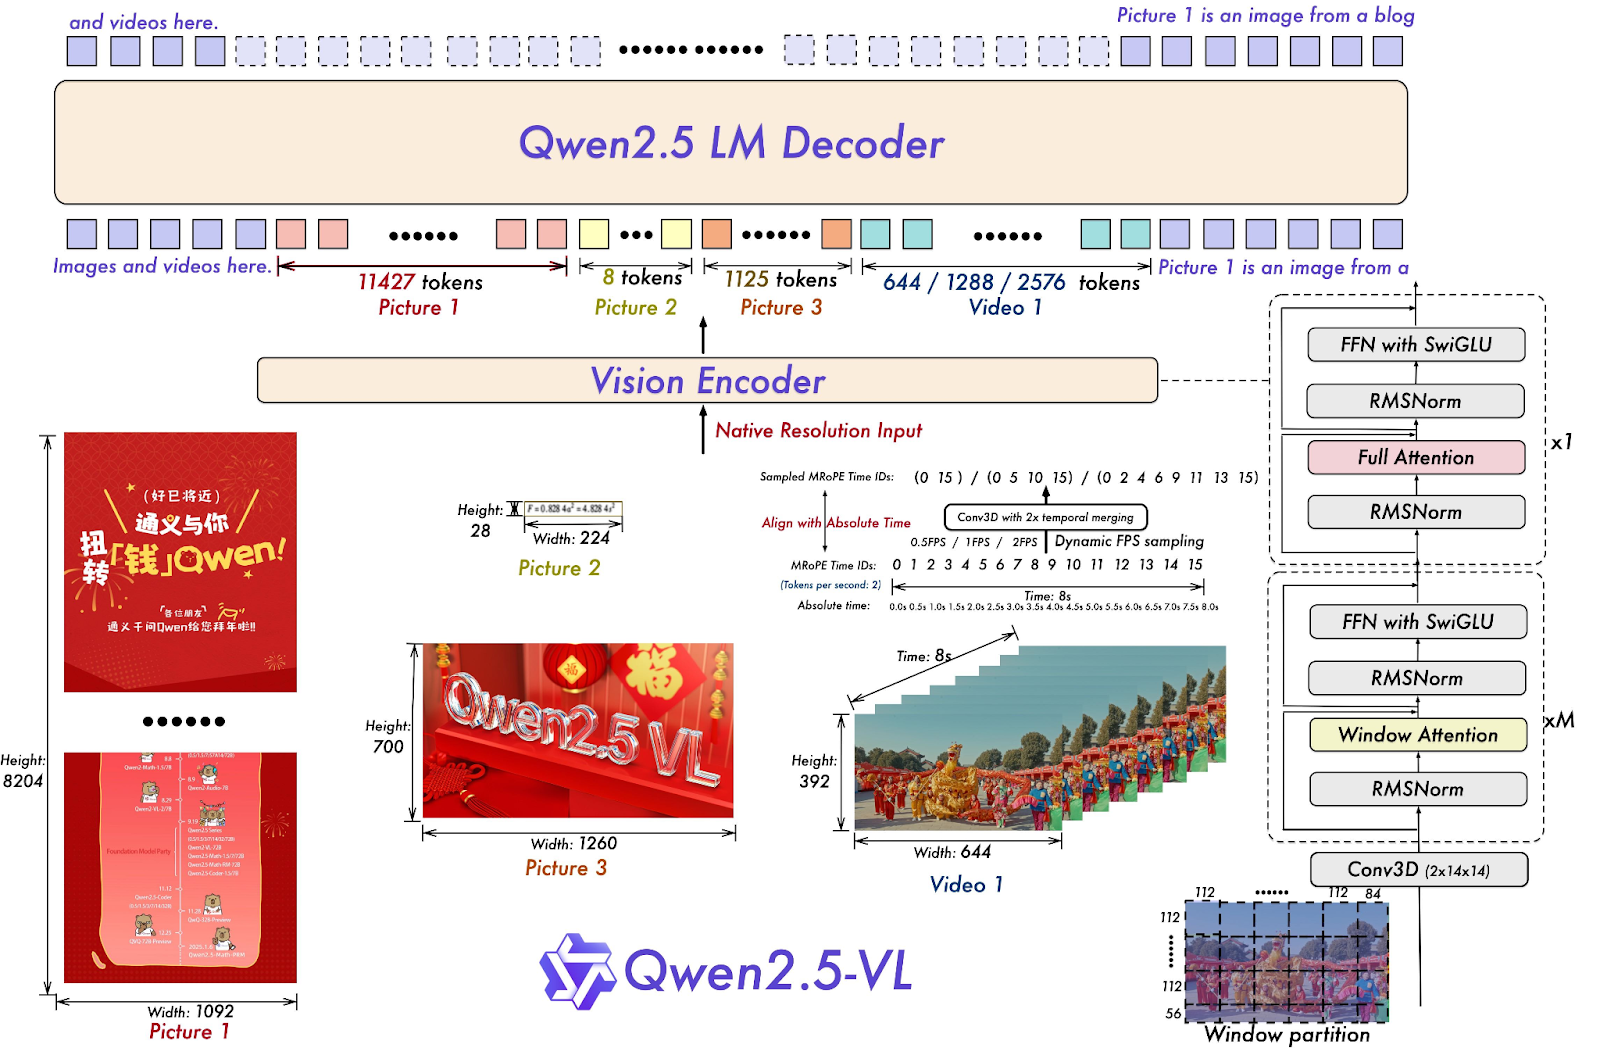
स्रोत: Qwen/Qwen2.5-VL-72B-Instruct · Hugging Face
उदाहरण उपयोग:
# pip install qwen-vl-utils[decord]==0.0.8

from transformers import Qwen2_5_VLForConditionalGeneration, AutoTokenizer, AutoProcessor
from qwen_vl_utils import process_vision_info

# default: Load the model on the available device(s)
model = Qwen2_5_VLForConditionalGeneration.from_pretrained(
    "Qwen/Qwen2.5-VL-72B-Instruct", torch_dtype="auto", device_map="auto"
)
# default processer
processor = AutoProcessor.from_pretrained("Qwen/Qwen2.5-VL-72B-Instruct")


messages = [
    {
        "role": "user",
        "content": [
            {
                "type": "image",
                "image": "https://qianwen-res.oss-cn-beijing.aliyuncs.com/Qwen-VL/assets/demo.jpeg",
            },
            {"type": "text", "text": "Describe this image."},
        ],
    }
]

# Preparation for inference
text = processor.apply_chat_template(
    messages, tokenize=False, add_generation_prompt=True
)
image_inputs, video_inputs = process_vision_info(messages)
inputs = processor(
    text=[text],
    images=image_inputs,
    videos=video_inputs,
    padding=True,
    return_tensors="pt",
)
inputs = inputs.to("cuda")

# Inference: Generation of the output
generated_ids = model.generate(**inputs, max_new_tokens=128)
generated_ids_trimmed = [
    out_ids[len(in_ids) :] for in_ids, out_ids in zip(inputs.input_ids, generated_ids)
]
output_text = processor.batch_decode(
    generated_ids_trimmed, skip_special_tokens=True, clean_up_tokenization_spaces=False
)
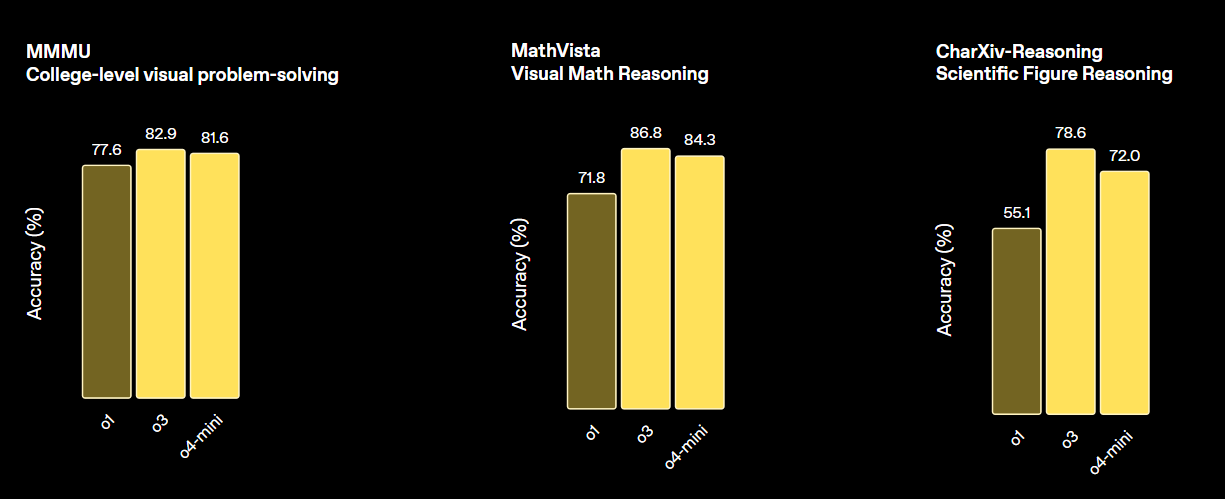
print(output_text)OpenAI का o3 एक नया रीजनिंग मॉडल है, जिसे अनुप्रयोगों में उच्च बुद्धिमत्ता, कम लागत, और अधिक कुशल टोकन उपयोग प्रदान करने के लिए डिज़ाइन किया गया है। यह उन्नत तर्क क्षमताओं पर जोर देने वाले मॉडलों की नई पीढ़ी का प्रतिनिधित्व करता है।
यह मॉडल गणित, विज्ञान, कोडिंग और दृश्य तर्क जैसे कार्यों के लिए नया मानक तय करता है। विभिन्न विज़न बेंचमार्क के संदर्भ में, यह o4-min और o1 दोनों से बेहतर प्रदर्शन करता है और o3 Pro के बराबर है।
स्रोत: Introducing OpenAI o3 and o4-mini | OpenAI
उदाहरण उपयोग:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="o3-2025-04-16",
    input=[{
        "role": "user",
        "content": [
            {"type": "input_text", "text": "what's in this image?"},
            {
                "type": "input_image",
                "image_url": "https://upload.wikimedia.org/wikipedia/commons/thumb/d/dd/Gfp-wisconsin-madison-the-nature-boardwalk.jpg/2560px-Gfp-wisconsin-madison-the-nature-boardwalk.jpg",
            },
        ],
    }],
)

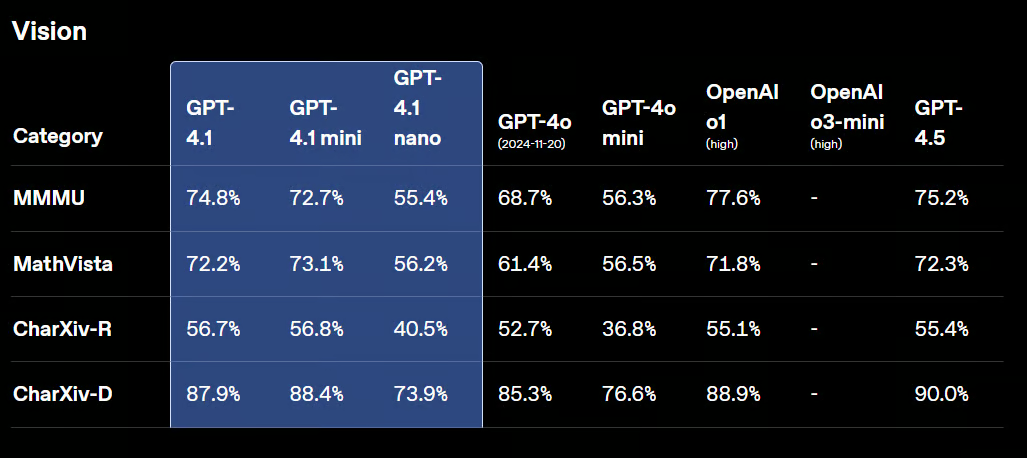
print(response.output_text)GPT-4.1 गैर-रीजनिंग मॉडलों का नया परिवार है, जिसमें GPT-4.1, GPT-4.1 Mini और GPT-4.1 Nano शामिल हैं। इन मॉडलों ने विभिन्न बेंचमार्क पर अपने पूर्ववर्तियों GPT-4o और GPT-4o Mini को पीछे छोड़ दिया है।
GPT-4.1 अपनी मजबूत विज़न क्षमताएँ बनाए रखता है, साथ ही चार्ट, डायग्राम और विज़ुअल मैथमेटिक्स के विश्लेषण में सुधार लाता है। यह वस्तु-गणना, दृश्य प्रश्नोत्तर, और विभिन्न प्रकार के ऑप्टिकल कैरेक्टर रिकग्निशन (OCR) जैसे कार्यों में उत्कृष्ट है।
स्रोत: Introducing GPT-4.1 in the API | OpenAI
उदाहरण उपयोग:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-4.1-2025-04-14",
    input=[{
        "role": "user",
        "content": [
            {"type": "input_text", "text": "what's in this image?"},
            {
                "type": "input_image",
                "image_url": "https://upload.wikimedia.org/wikipedia/commons/thumb/d/dd/Gfp-wisconsin-madison-the-nature-boardwalk.jpg/2560px-Gfp-wisconsin-madison-the-nature-boardwalk.jpg",
            },
        ],
    }],
)

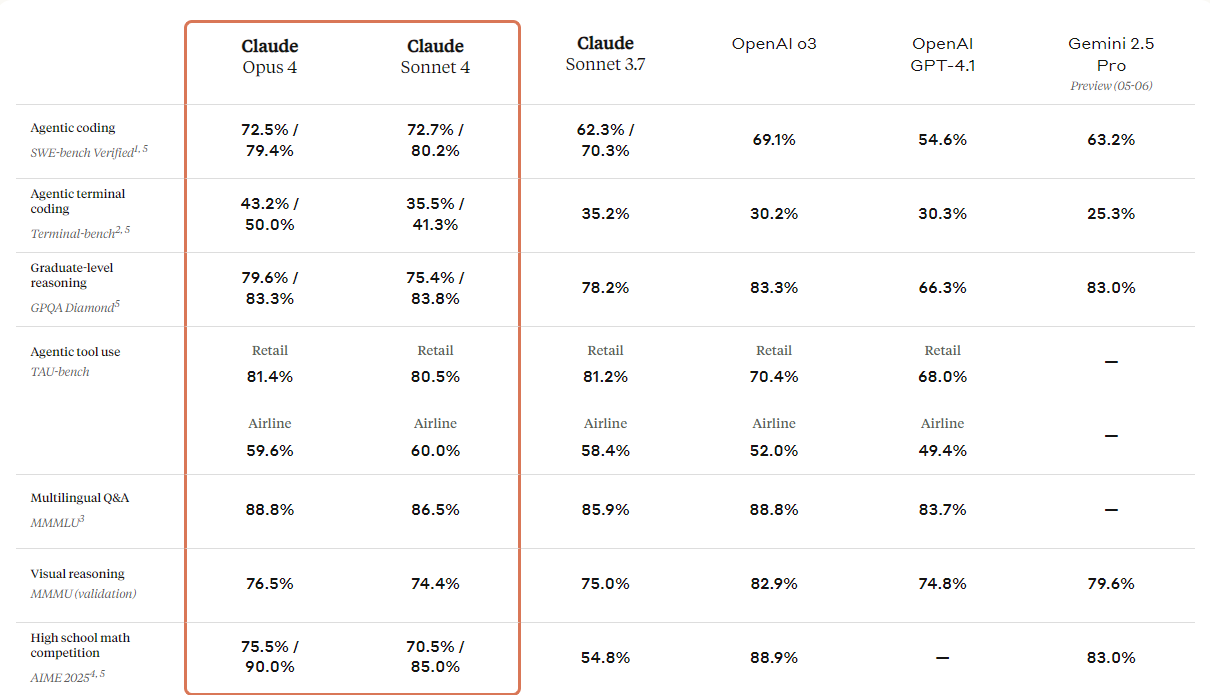
print(response.output_text)Anthropic ने अपने Claude मॉडलों की अगली पीढ़ी पेश की है: Claude 4 Opus और Claude 4 Sonnet। ये मॉडल कोडिंग, उन्नत तर्क और AI क्षमताओं में नए मानक स्थापित करने के लिए डिज़ाइन किए गए हैं।
इनमें बेहतर विज़न क्षमताएँ हैं, जिनका उपयोगकर्ता छवियों को समझने के लिए कर सकते हैं और फिर उन छवियों के आधार पर कोड जनरेट कर सकते हैं या जानकारी प्रदान कर सकते हैं। यद्यपि यह मूल रूप से एक कोडिंग मॉडल है, फिर भी इसमें मल्टीमॉडल क्षमताएँ हैं, जो इसे विभिन्न प्रकार के फ़ाइल फ़ॉर्मैट समझने में सक्षम बनाती हैं।
यदि आप नीचे दी गई तुलना तालिका देखें, तो आप पाएँगे कि Claude 4 सभी शीर्ष मॉडलों से बेहतर प्रदर्शन करता है—OpenAI के GPT-3 मॉडल को छोड़कर—विशेषकर विज़ुअलाइज़ेशन रीजनिंग और दृश्य प्रश्नोत्तर में।
स्रोत: Introducing Claude 4 \ Anthropic
उदाहरण उपयोग:
import anthropic

client = anthropic.Anthropic()
message = client.messages.create(
    model="claude-sonnet-4-20250514",
    max_tokens=1024,
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image",
                    "source": {
                        "type": "url",
                        "url": "https://upload.wikimedia.org/wikipedia/commons/a/a7/Camponotus_flavomarginatus_ant.jpg",
                    },
                },
                {
                    "type": "text",
                    "text": "Describe this image."
                }
            ],
        }
    ],
)
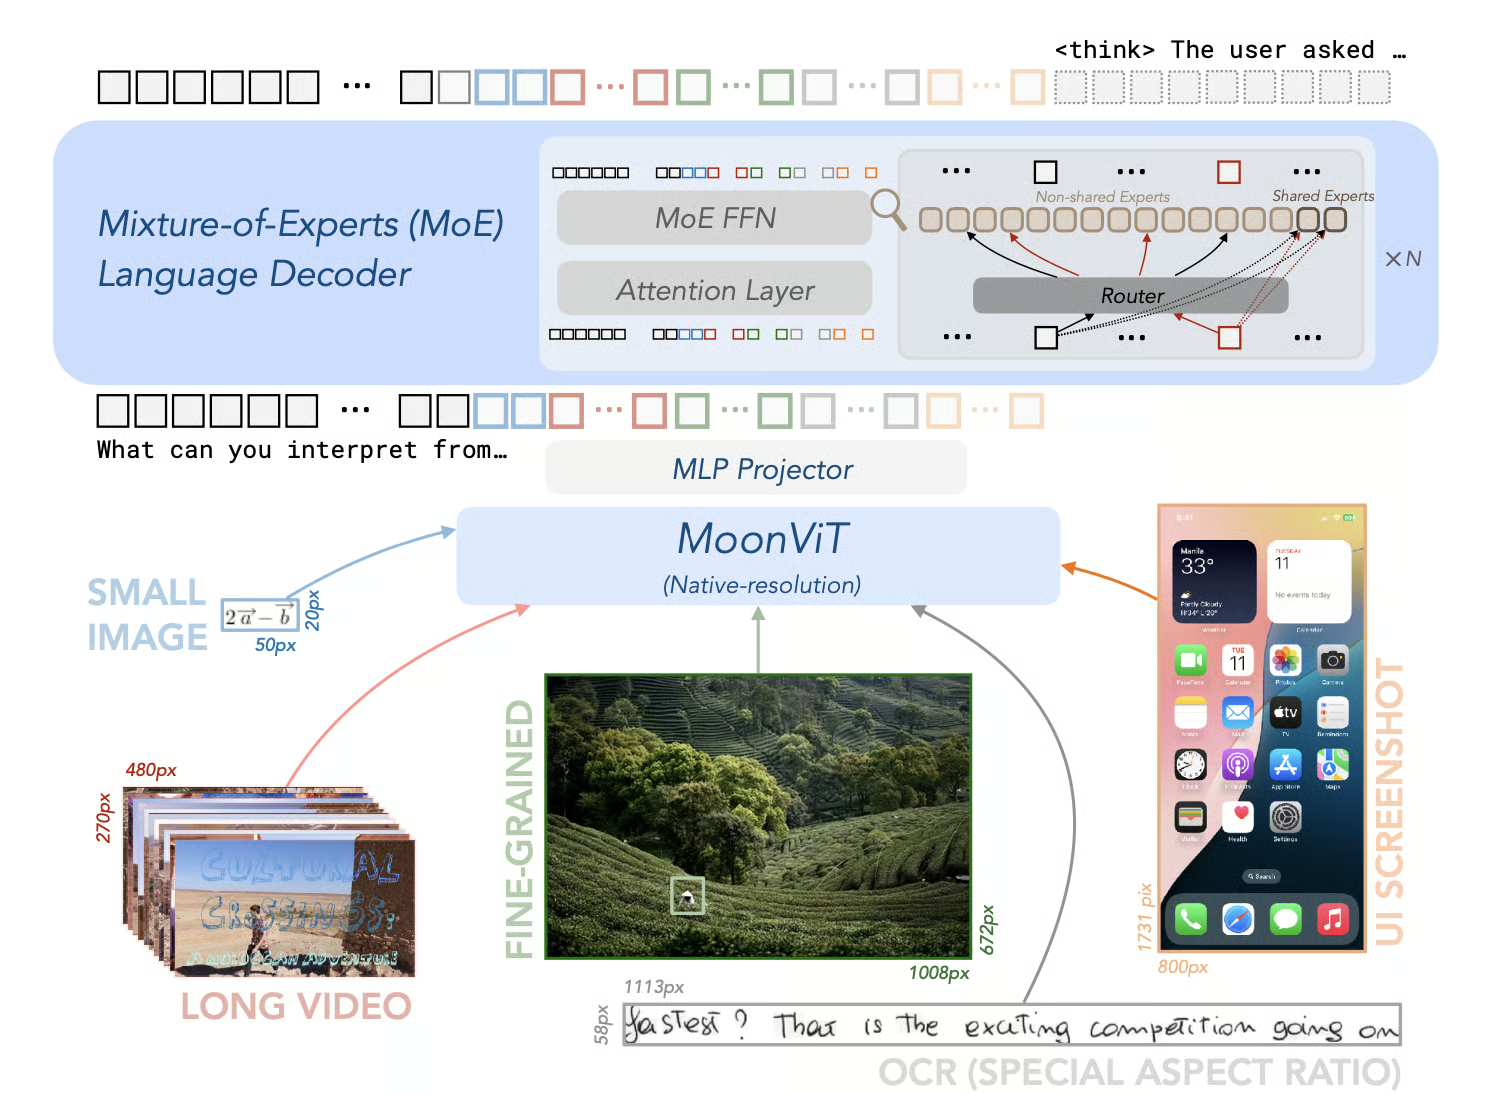
print(message)Kimi-VL-A3B-Thinking-2506 एक ओपन-सोर्स मॉडल है जो मल्टीमॉडल AI में एक महत्वपूर्ण प्रगति को दर्शाता है। यह मल्टीमॉडल रीजनिंग बेंचमार्क पर उत्कृष्टता दिखाता है और प्रभावशाली सटीकता स्कोर प्राप्त करता है: MathVision पर 56.9, MathVista पर 80.1, MMMU-Pro पर 46.3, और MMMU पर 64.0—साथ ही अपने "थिंकिंग लेंथ" को औसतन 20% तक घटाता है।
रीजनिंग क्षमताओं के अलावा, 2506 संस्करण सामान्य दृश्य परसेप्शन और समझ में भी बेहतर प्रदर्शन दर्शाता है। यह MMBench-EN-v1.1 (84.4), MMStar (70.4), RealWorldQA (70.0), और MMVet (78.4) जैसे बेंचमार्क पर नॉन-थिंकिंग मॉडलों की बराबरी करता है या उन्हें पीछे छोड़ देता है।
स्रोत: MoonshotAI/Kimi-VL: Kimi-VL
उदाहरण उपयोग:
from transformers import AutoProcessor
from vllm import LLM, SamplingParams

model_path = "moonshotai/Kimi-VL-A3B-Thinking-2506"
llm = LLM(
    model_path,
    trust_remote_code=True,
    max_num_seqs=8,
    max_model_len=131072,
    limit_mm_per_prompt={"image": 256}
)

processor = AutoProcessor.from_pretrained(model_path, trust_remote_code=True)

sampling_params = SamplingParams(max_tokens=32768, temperature=0.8)


import requests
from PIL import Image

def extract_thinking_and_summary(text: str, bot: str = "◁think▷", eot: str = "◁/think▷") -> str:
    if bot in text and eot not in text:
        return ""
    if eot in text:
        return text[text.index(bot) + len(bot):text.index(eot)].strip(), text[text.index(eot) + len(eot) :].strip()
    return "", text

OUTPUT_FORMAT = "--------Thinking--------\n{thinking}\n\n--------Summary--------\n{summary}"

url = "https://huggingface.co/spaces/moonshotai/Kimi-VL-A3B-Thinking/resolve/main/images/demo6.jpeg"
image = Image.open(requests.get(url,stream=True).raw)

messages = [
    {"role": "user", "content": [{"type": "image", "image": ""}, {"type": "text", "text": "What kind of cat is this? Answer with one word."}]}
]
text = processor.apply_chat_template(messages, add_generation_prompt=True, return_tensors="pt")

outputs = llm.generate([{"prompt": text, "multi_modal_data": {"image": image}}], sampling_params=sampling_params)
generated_text = outputs[0].outputs[0].text

thinking, summary = extract_thinking_and_summary(generated_text)
print(OUTPUT_FORMAT.format(thinking=thinking, summary=summary))Gemma 3 Google द्वारा विकसित मल्टीमॉडल AI मॉडलों का एक परिवार है, जो पाठ और छवि—दोनों—इनपुट प्रोसेस कर टेक्स्ट आउटपुट जनरेट कर सकता है। ये मॉडल 1B, 4B, 12B और 27B जैसे विभिन्न आकारों में उपलब्ध हैं, ताकि हार्डवेयर और प्रदर्शन की विविध आवश्यकताओं को पूरा किया जा सके।
सबसे बड़ा संस्करण, Gemma 3 27B, मानवीय वरीयता मूल्यांकनों में प्रभावशाली प्रदर्शन दिखा चुका है, और Llama 3-405B तथा DeepSeek-V3 जैसे बड़े मॉडलों से भी बेहतर साबित हुआ है।
ये मॉडल विभिन्न बेंचमार्क पर मजबूत क्षमताएँ दर्शाते हैं। विशेष रूप से, ये मल्टीमॉडल कार्यों में उत्कृष्ट हैं और COCOcap (116), DocVQA (85.6), MMMU (56.1), और VQAv2 (72.9) जैसे बेंचमार्क पर उल्लेखनीय स्कोर प्राप्त करते हैं।
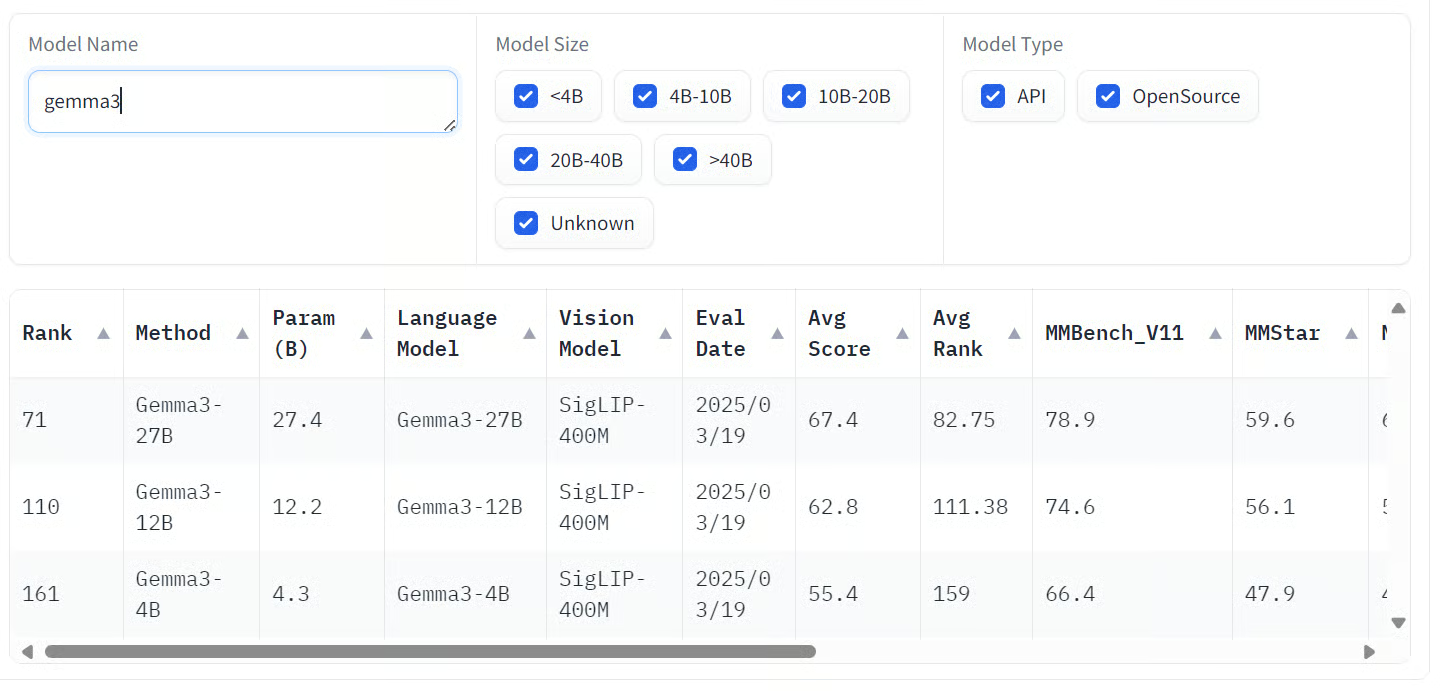
स्रोत: Open VLM Leaderboard
उदाहरण उपयोग:
# pip install accelerate

from transformers import AutoProcessor, Gemma3ForConditionalGeneration
from PIL import Image
import requests
import torch

model_id = "google/gemma-3-27b-it"

model = Gemma3ForConditionalGeneration.from_pretrained(
    model_id, device_map="auto"
).eval()

processor = AutoProcessor.from_pretrained(model_id)

messages = [
    {
        "role": "system",
        "content": [{"type": "text", "text": "You are a helpful assistant."}]
    },
    {
        "role": "user",
        "content": [
            {"type": "image", "image": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/bee.jpg"},
            {"type": "text", "text": "Describe this image in detail."}
        ]
    }
]

inputs = processor.apply_chat_template(
    messages, add_generation_prompt=True, tokenize=True,
    return_dict=True, return_tensors="pt"
).to(model.device, dtype=torch.bfloat16)

input_len = inputs["input_ids"].shape[-1]

with torch.inference_mode():
    generation = model.generate(**inputs, max_new_tokens=100, do_sample=False)
    generation = generation[0][input_len:]

decoded = processor.decode(generation, skip_special_tokens=True)
print(decoded)Llama 3.2 90B Vision Instruct मॉडल Meta द्वारा विकसित एक उन्नत मल्टीमॉडल लार्ज लैंग्वेज मॉडल है। यह विज़ुअल रिकग्निशन, इमेज रीजनिंग और कैप्शनिंग से जुड़े कार्यों के लिए डिज़ाइन किया गया है।
Llama 3.2 90B Vision Instruct, Llama 3.1 टेक्स्ट-ओनली संस्करण पर आधारित है और इसमें एक अलग से प्रशिक्षित विज़न एडेप्टर शामिल है, जो इसे छवियों और टेक्स्ट—दोनों—को इनपुट के रूप में प्रोसेस कर सटीक टेक्स्ट आउटपुट जनरेट करने में सक्षम बनाता है।
विस्तृत पैमाने पर प्रशिक्षण के साथ, Llama 3.2 90B Vision मॉडल को 8.85 मिलियन GPU-घंटों की आवश्यकता हुई। यह VQAv2 (73.6), Text VQA (73.5), और DocVQA (70.7) जैसे बेंचमार्क पर असाधारण प्रदर्शन दिखाता है।
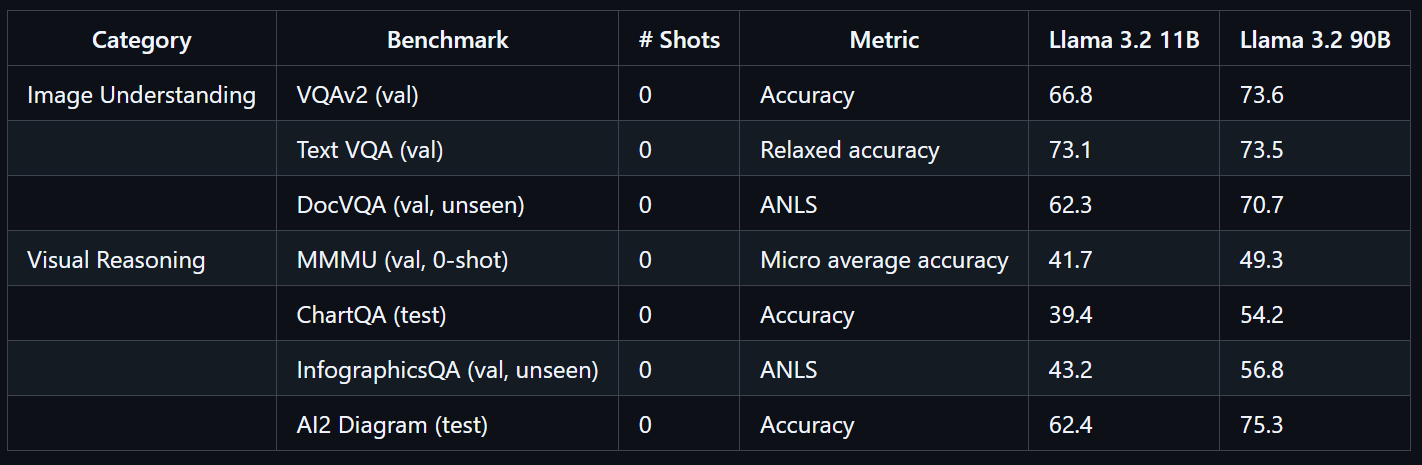
स्रोत: llama-models
उदाहरण उपयोग:
import requests
import torch
from PIL import Image
from transformers import MllamaForConditionalGeneration, AutoProcessor

model_id = "meta-llama/Llama-3.2-90B-Vision-Instruct"

model = MllamaForConditionalGeneration.from_pretrained(
    model_id,
    torch_dtype=torch.bfloat16,
    device_map="auto",
)
processor = AutoProcessor.from_pretrained(model_id)

url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/0052a70beed5bf71b92610a43a52df6d286cd5f3/diffusers/rabbit.jpg"
image = Image.open(requests.get(url, stream=True).raw)

messages = [
    {"role": "user", "content": [
        {"type": "image"},
        {"type": "text", "text": "If I had to write a haiku for this one, it would be: "}
    ]}
]
input_text = processor.apply_chat_template(messages, add_generation_prompt=True)
inputs = processor(
    image,
    input_text,
    add_special_tokens=False,
    return_tensors="pt",
).to(model.device)

output = model.generate(**inputs, max_new_tokens=30)
print(processor.decode(output[0]))
ग्राफ़ के साथ विज़ुअल रीजनिंग, Meta के नवीनतम मॉडल Muse Spark की भी ताकत है।
विज़न-लैंग्वेज मॉडल मूल रूप से इस बात को बदल रहे हैं कि हम दृश्य और पाठ्य जानकारी—दोनों—से कैसे इंटरैक्ट करते हैं, और अनेक उद्योगों में उल्लेखनीय सटीकता और लचीलापन दे रहे हैं। ये मॉडल कंप्यूटर विज़न और प्राकृतिक भाषा प्रसंस्करण का सहज समागम करते हैं, जिससे उन्नत ऑब्जेक्ट डिटेक्शन से लेकर सहज विज़ुअल असिस्टेंट तक के नए अनुप्रयोग संभव होते हैं।
यदि आपकी उपयोग-स्थितियों में गोपनीयता और सुरक्षा सर्वोच्च प्राथमिकताएँ हैं, तो मैं ओपन-सोर्स विज़न-लैंग्वेज मॉडलों का अन्वेषण करने की अत्यधिक अनुशंसा करता/करती हूँ। इन मॉडलों को लोकल रूप से चलाना आपको अपने डेटा पर पूर्ण नियंत्रण देता है, जिससे वे संवेदनशील वातावरण के लिए आदर्श बन जाते हैं। ओपन-सोर्स VLMs अत्यधिक अनुकूलनीय भी हैं; अधिकांश को कुछ सौ नमूनों पर फाइन-ट्यून कर आपकी विशिष्ट आवश्यकताओं के अनुरूप उत्कृष्ट परिणाम प्राप्त किए जा सकते हैं।
दूसरी ओर, स्वामित्व वाले मॉडल अत्याधुनिक क्षमताओं तक विश्वसनीय और किफायती पहुँच प्रदान करते हैं। ये आमतौर पर अत्यधिक सटीक होते हैं और केवल कुछ पंक्तियों के कोड के साथ आपके वर्कफ़्लो में एकीकृत किए जा सकते हैं—यहाँ तक कि उन टीमों के लिए भी जिनके पास गहरा AI विशेषज्ञता नहीं है।
यदि आप विज़न लैंग्वेज मॉडलों के बारे में और सीखने के इच्छुक हैं, तो ये संसाधन अवश्य देखें:
Top DataCamp Courses
course
course
Track