Track
Обработка естественного языка на Python
20 ч
Vision Language Models (VLMs) стремительно меняют индустрии, позволяя ИИ‑системам понимать и рассуждать как об изображениях, так и о тексте. В отличие от традиционных моделей компьютерного зрения, современные VLM способны интерпретировать сложные изображения, отвечать на детальные вопросы о визуальном контенте, а также обрабатывать видео и документы со встроенным текстом.
Эта возможность делает их незаменимыми для медицинской диагностики, автоматизированного контроля качества и чувствительных областей, где точность важнее скорости.
В этом обзоре мы рассмотрим лучшие vision-language модели 2026 года, как с открытым исходным кодом, так и проприетарные. Мы отметим их уникальные возможности, а затем представим результаты производительности и бенчмарков. Для разработчиков и исследователей мы также включили примеры кода, чтобы вы могли быстро попробовать эти модели на практике.
Если вы хотите глубже разобраться в основах этих моделей, обязательно изучите наш трек навыков «Обработка изображений в Python».
Gemini 2.5 Pro — самая продвинутая модель ИИ от Google, возглавляющая рейтинги LMArena и WebDevArena как в задачах по зрению, так и по коду. Она создана для сложного рассуждения и понимания текста, изображений, аудио и видео.
С точки зрения возможностей vision-language она входит в число лучших моделей в таблице лидеров Open LLM. Gemini 2.5 Pro умеет интерпретировать изображения и видео, создавая подробные, контекстно‑зависимые описания и отвечая на вопросы по визуальному контенту.
Источник: Google Gemini
Доступ к Gemini 2.5 Pro возможен бесплатно через веб‑приложение Gemini по адресу gemini.google.com/app или с помощью Google AI Studio.
Для разработчиков Gemini 2.5 Pro также доступна через Gemini API, Vertex AI и официальный Python SDK, что упрощает интеграцию возможностей vision-language в ваши приложения и рабочие процессы.
Пример использования:
from google.genai import types

with open('path/to/image.jpg', 'rb') as f:
      image_bytes = f.read()

  response = client.models.generate_content(
    model='gemini-2.5-pro',
    contents=[
      types.Part.from_bytes(
        data=image_bytes,
        mime_type='image/jpeg',
      ),
      'Explain the image.'
    ]
  )
print(response.text)InternVL3 — это продвинутая серия мультимодальных больших языковых моделей (MLLM), превосходящая своего предшественника InternVL 2.5. Она сильна в мультимодальном восприятии и рассуждении и получила расширенные возможности, включая использование инструментов, GUI‑агентов, промышленный анализ изображений и 3D‑восприятие.
Модель InternVL3-78B использует InternViT-6B-448px-V2_5 в качестве зрительного компонента и Qwen2.5-72B в качестве языкового. С общим числом 78,41 млрд параметров InternVL3-78B набрала 72,2 на бенчмарке MMMU, установив новый рекорд среди открытых MLLM. Её качество сопоставимо с ведущими проприетарными моделями.
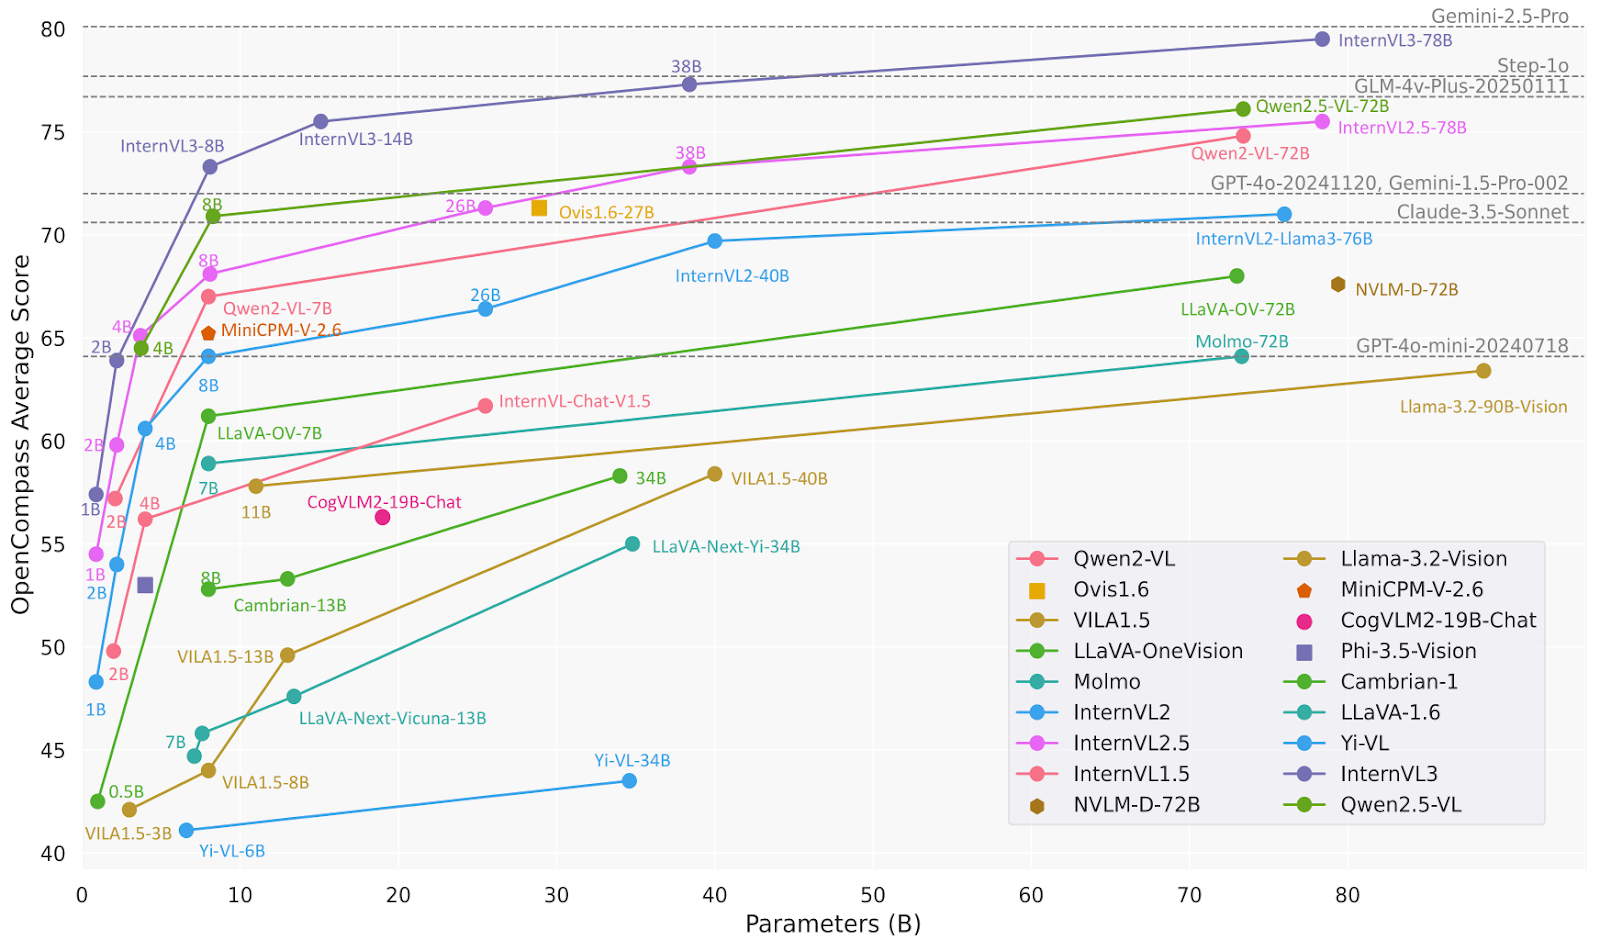
Источник: OpenGVLab/InternVL3-78B · Hugging Face
Пример использования:
# pip install lmdeploy>=0.7.3
from lmdeploy import pipeline, TurbomindEngineConfig, ChatTemplateConfig
from lmdeploy.vl import load_image

model = 'OpenGVLab/InternVL3-78B'
image = load_image('https://raw.githubusercontent.com/open-mmlab/mmdeploy/main/tests/data/tiger.jpeg')
pipe = pipeline(model, backend_config=TurbomindEngineConfig(session_len=16384, tp=4), chat_template_config=ChatTemplateConfig(model_name='internvl2_5'))
response = pipe(('Explain the image.', image))
print(response.text)Ovis2 — серия мультимодальных больших языковых моделей (MLLM), разработанных AIDC-AI. Эти модели эффективно выравнивают визуальные и текстовые эмбеддинги. В частности, Ovis2-34B использует aimv2-1B-patch14-448 как визионерный энкодер и Qwen2.5-32B-Instruct как языковую модель, в сумме 34 млрд параметров. Поддерживает максимальный контекст 32 768 токенов и использует точность bfloat16 для эффективной обработки.
Ovis2-34B демонстрирует высокие результаты на различных бенчмарках, включая следующее:
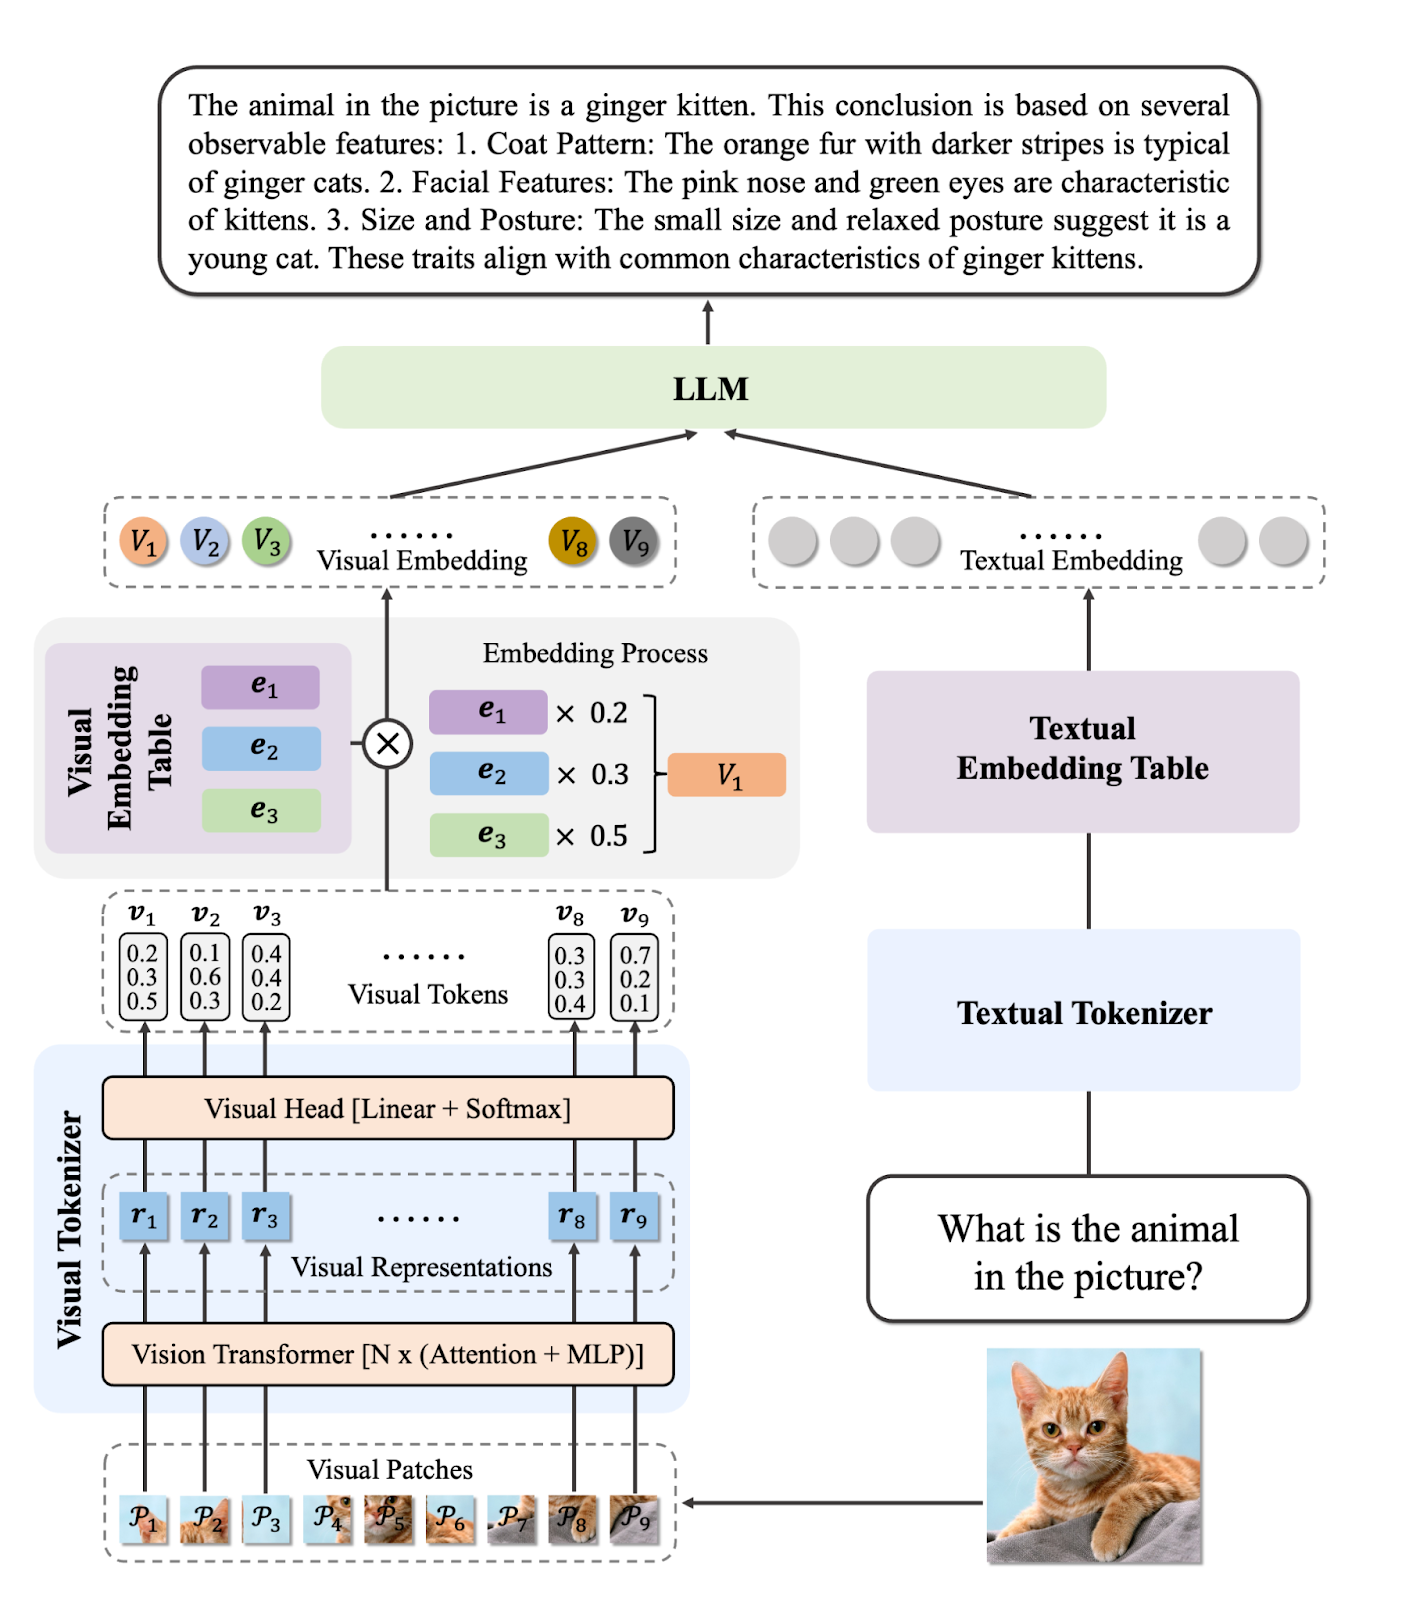
Источник: AIDC-AI/Ovis2-34B · Hugging Face
Пример использования:
import torch
from PIL import Image
from transformers import AutoModelForCausalLM

# load model
model = AutoModelForCausalLM.from_pretrained("AIDC-AI/Ovis2-34B",
                                             torch_dtype=torch.bfloat16,
                                             multimodal_max_length=32768,
                                             trust_remote_code=True).cuda()
text_tokenizer = model.get_text_tokenizer()
visual_tokenizer = model.get_visual_tokenizer()

# single-image input
image_path = '/data/images/example_1.jpg'
images = [Image.open(image_path)]
max_partition = 9
text = 'Describe the image.'
query = f'<image>\n{text}'


# format conversation
prompt, input_ids, pixel_values = model.preprocess_inputs(query, images, max_partition=max_partition)
attention_mask = torch.ne(input_ids, text_tokenizer.pad_token_id)
input_ids = input_ids.unsqueeze(0).to(device=model.device)
attention_mask = attention_mask.unsqueeze(0).to(device=model.device)
if pixel_values is not None:
    pixel_values = pixel_values.to(dtype=visual_tokenizer.dtype, device=visual_tokenizer.device)
pixel_values = [pixel_values]

# generate output
with torch.inference_mode():
    gen_kwargs = dict(
        max_new_tokens=1024,
        do_sample=False,
        top_p=None,
        top_k=None,
        temperature=None,
        repetition_penalty=None,
        eos_token_id=model.generation_config.eos_token_id,
        pad_token_id=text_tokenizer.pad_token_id,
        use_cache=True
    )
    output_ids = model.generate(input_ids, pixel_values=pixel_values, attention_mask=attention_mask, **gen_kwargs)[0]
    output = text_tokenizer.decode(output_ids, skip_special_tokens=True)
print(f'Output:\n{output}')Qwen2.5-VL-72B-Instruct — мультимодальная большая языковая модель (MLLM) из семейства Qwen, созданная для понимания и обработки визуальной и текстовой информации. Многие открытые MLLM основаны на ней, что подчёркивает значимую роль серии Qwen в развитии исследований ИИ.
Qwen2.5-VL-72B-Instruct показывает сильные результаты на разных бенчмарках, включая понимание изображений и видео, а также агентные функции. Баллы: 70,2 на MMMUval, 74,8 на MathVista_MINI и 70,8 на MMStar.
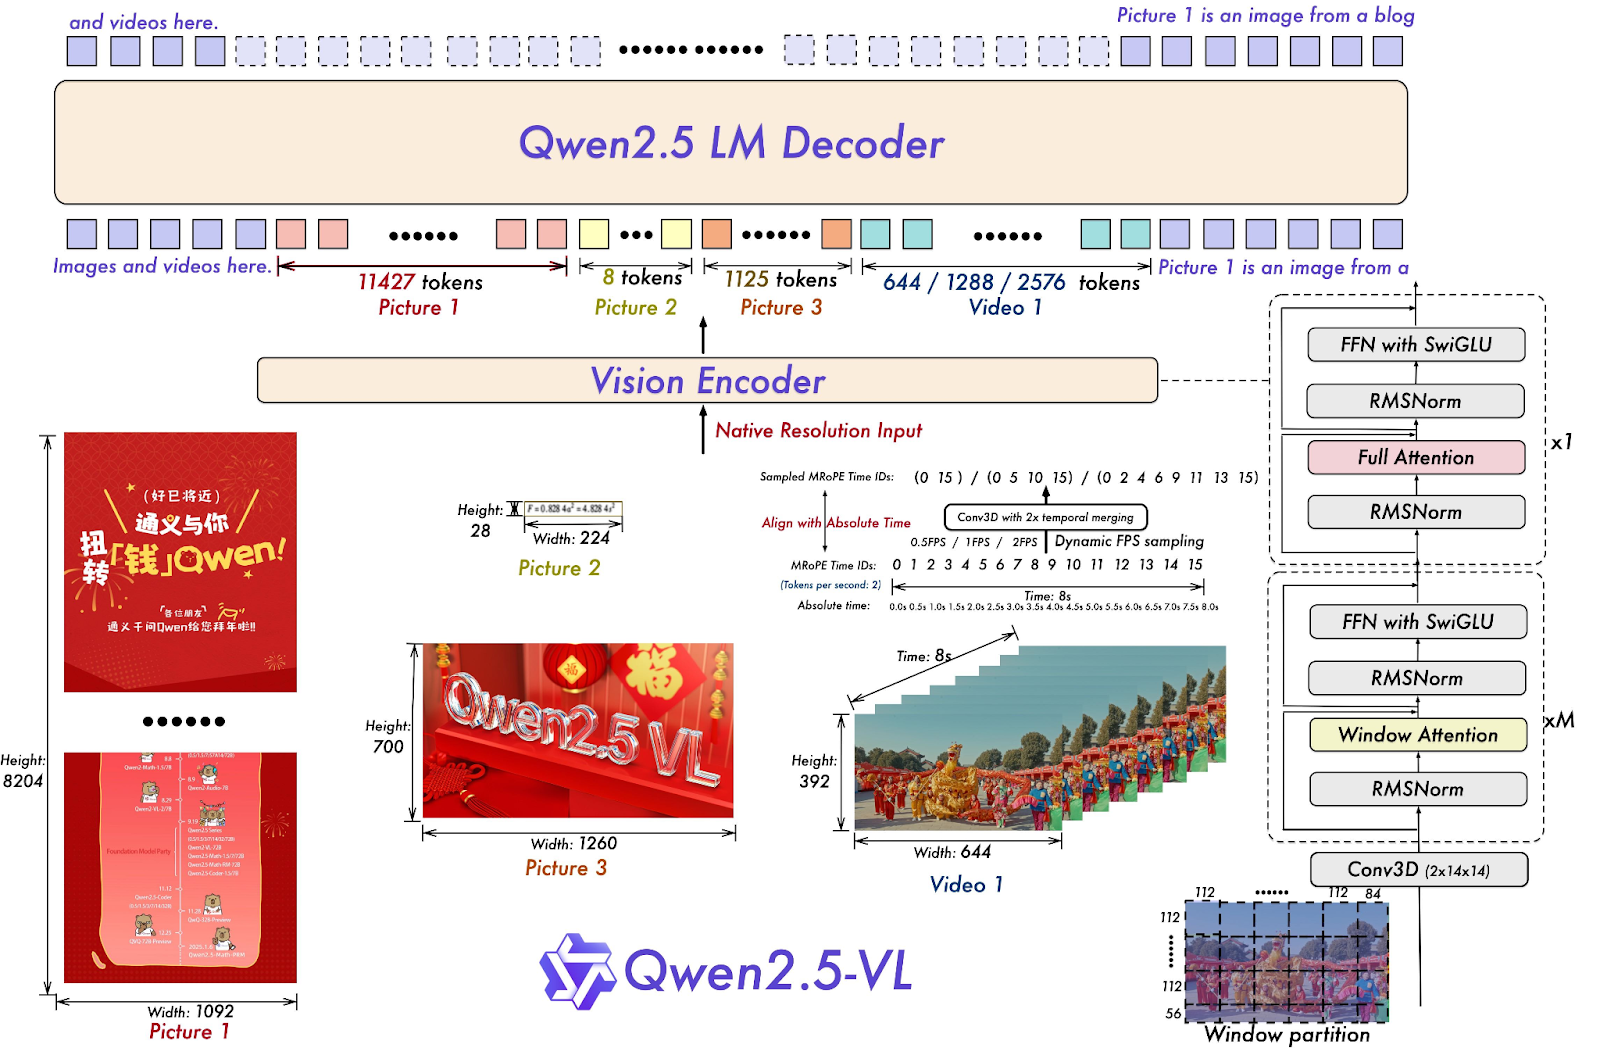
Источник: Qwen/Qwen2.5-VL-72B-Instruct · Hugging Face
Пример использования:
# pip install qwen-vl-utils[decord]==0.0.8

from transformers import Qwen2_5_VLForConditionalGeneration, AutoTokenizer, AutoProcessor
from qwen_vl_utils import process_vision_info

# default: Load the model on the available device(s)
model = Qwen2_5_VLForConditionalGeneration.from_pretrained(
    "Qwen/Qwen2.5-VL-72B-Instruct", torch_dtype="auto", device_map="auto"
)
# default processer
processor = AutoProcessor.from_pretrained("Qwen2.5-VL-72B-Instruct")


messages = [
    {
        "role": "user",
        "content": [
            {
                "type": "image",
                "image": "https://qianwen-res.oss-cn-beijing.aliyuncs.com/Qwen-VL/assets/demo.jpeg",
            },
            {"type": "text", "text": "Describe this image."},
        ],
    }
]

# Preparation for inference
text = processor.apply_chat_template(
    messages, tokenize=False, add_generation_prompt=True
)
image_inputs, video_inputs = process_vision_info(messages)
inputs = processor(
    text=[text],
    images=image_inputs,
    videos=video_inputs,
    padding=True,
    return_tensors="pt",
)
inputs = inputs.to("cuda")

# Inference: Generation of the output
generated_ids = model.generate(**inputs, max_new_tokens=128)
generated_ids_trimmed = [
    out_ids[len(in_ids) :] for in_ids, out_ids in zip(inputs.input_ids, generated_ids)
]
output_text = processor.batch_decode(
    generated_ids_trimmed, skip_special_tokens=True, clean_up_tokenization_spaces=False
)
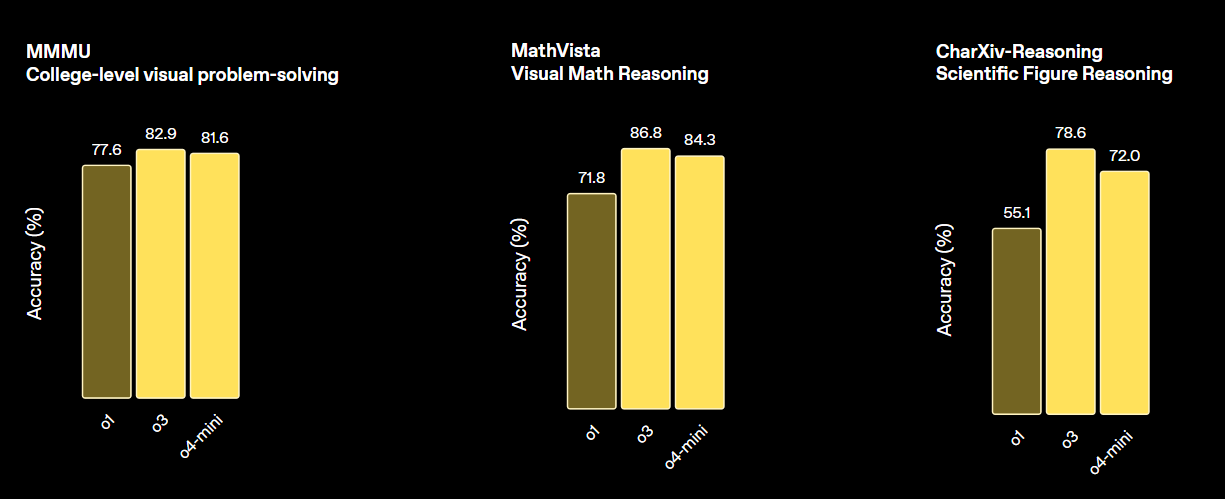
print(output_text)OpenAI o3 — новая модель рассуждения, разработанная для более высокого интеллекта, снижения затрат и более эффективного использования токенов в приложениях. Она представляет новое поколение моделей с упором на продвинутые способности к рассуждению.
Эта модель задаёт новый стандарт для задач по математике, науке, программированию и визуальному рассуждению. По различным бенчмаркам по зрению она превосходит и o4-min, и o1, а по качеству сопоставима с o3 Pro.
Источник: Introducing OpenAI o3 and o4-mini | OpenAI
Пример использования:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="o3-2025-04-16",
    input=[{
        "role": "user",
        "content": [
            {"type": "input_text", "text": "what's in this image?"},
            {
                "type": "input_image",
                "image_url": "https://upload.wikimedia.org/wikipedia/commons/thumb/d/dd/Gfp-wisconsin-madison-the-nature-boardwalk.jpg/2560px-Gfp-wisconsin-madison-the-nature-boardwalk.jpg",
            },
        ],
    }],
)

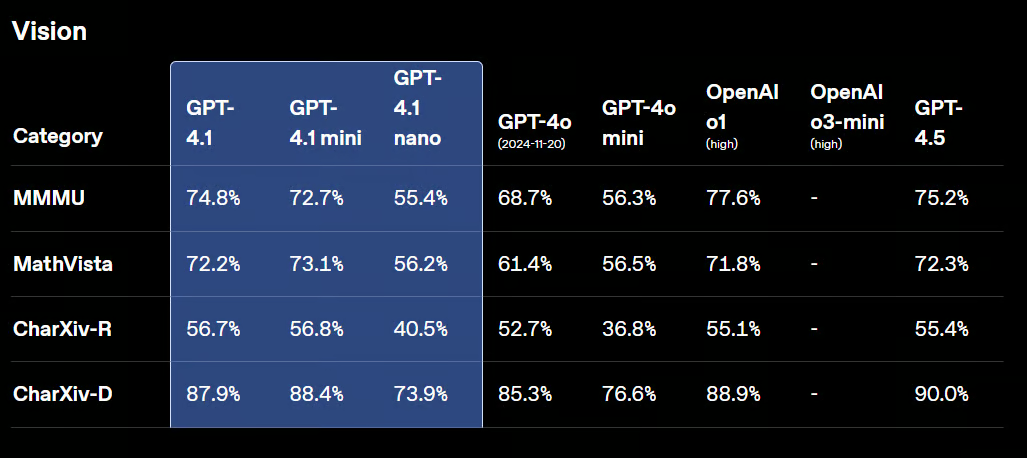
print(response.output_text)GPT-4.1 — новое семейство «нераспозновательных» моделей, включающее GPT-4.1, GPT-4.1 Mini и GPT-4.1 Nano. Эти модели превзошли своих предшественников, GPT-4o и GPT-4o Mini, по ряду бенчмарков.
GPT-4.1 сохраняет сильные визуальные возможности, улучшив анализ графиков, схем и визуальной математики. Она отлично справляется с подсчётом объектов, визуальными вопросами‑ответами и различными задачами OCR.
Источник: Introducing GPT-4.1 in the API | OpenAI
Пример использования:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-4.1-2025-04-14",
    input=[{
        "role": "user",
        "content": [
            {"type": "input_text", "text": "what's in this image?"},
            {
                "type": "input_image",
                "image_url": "https://upload.wikimedia.org/wikipedia/commons/thumb/d/dd/Gfp-wisconsin-madison-the-nature-boardwalk.jpg/2560px-Gfp-wisconsin-madison-the-nature-boardwalk.jpg",
            },
        ],
    }],
)

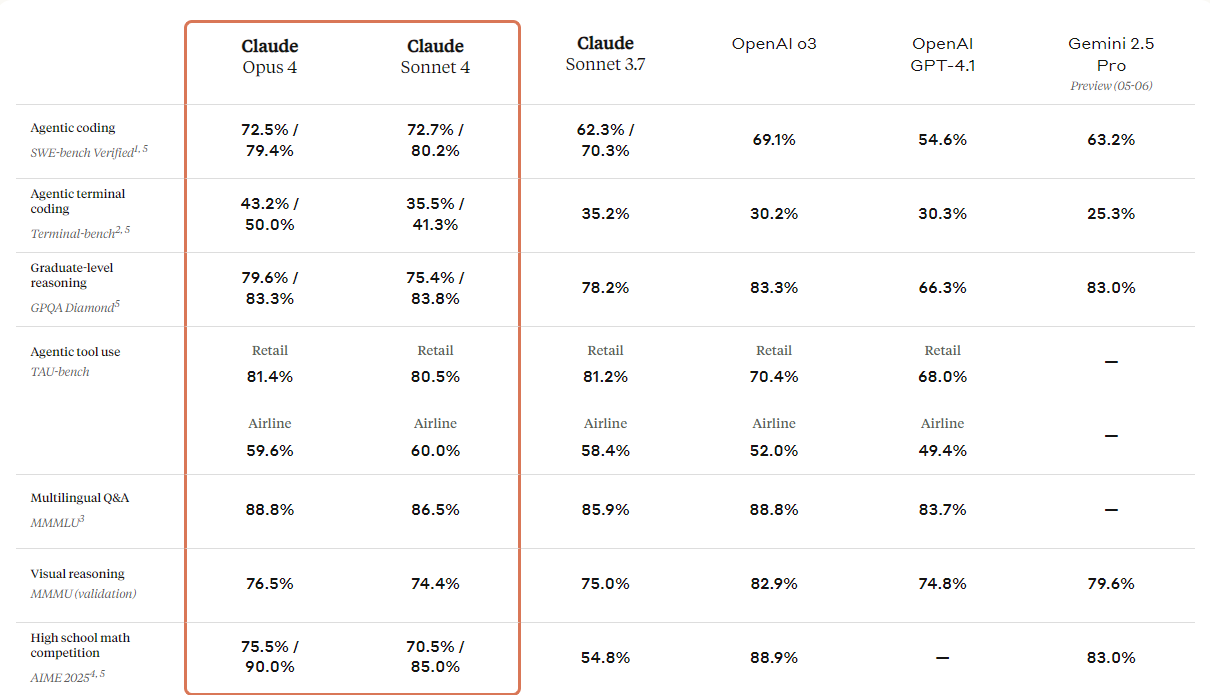
print(response.output_text)Anthropic представила новое поколение моделей Claude: Claude 4 Opus и Claude 4 Sonnet. Эти модели созданы, чтобы задать новые стандарты в кодинге, продвинутом рассуждении и возможностях ИИ.
Они получили улучшенные визуальные возможности: можно анализировать изображения, а затем генерировать код или предоставлять информацию на их основе. Хотя в основе — модель для программирования, у неё также есть мультимодальные возможности, позволяющие понимать разные форматы файлов.
Если посмотреть на таблицу сравнения ниже, видно, что Claude 4 превосходит все топовые модели, за исключением GPT‑3 от OpenAI, особенно в визуальном рассуждении и визуальных вопросах‑ответах.
Источник: Introducing Claude 4 \ Anthropic
Пример использования:
import anthropic

client = anthropic.Anthropic()
message = client.messages.create(
    model="claude-sonnet-4-20250514",
    max_tokens=1024,
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image",
                    "source": {
                        "type": "url",
                        "url": "https://upload.wikimedia.org/wikipedia/commons/a/a7/Camponotus_flavomarginatus_ant.jpg",
                    },
                },
                {
                    "type": "text",
                    "text": "Describe this image."
                }
            ],
        }
    ],
)
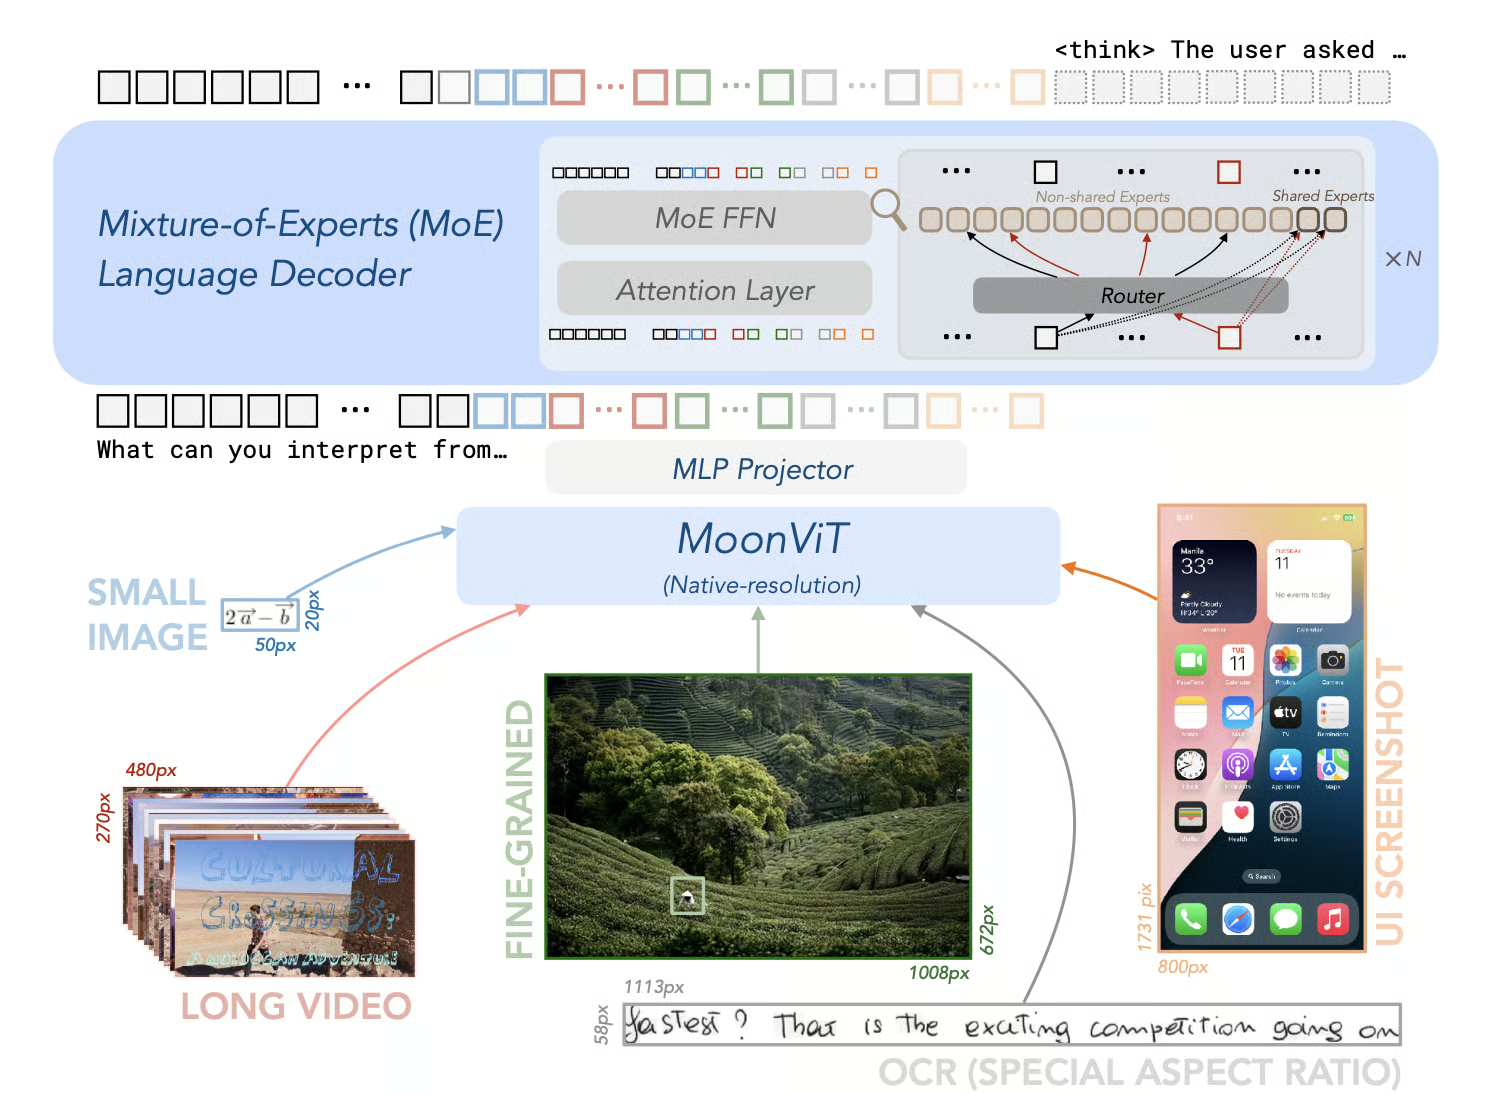
print(message)Kimi-VL-A3B-Thinking-2506 — это модель с открытым исходным кодом, ставшая значимым шагом вперёд в мультимодальном ИИ. Она выдаёт высокую точность на бенчмарках мультимодального рассуждения: 56,9 на MathVision, 80,1 на MathVista, 46,3 на MMMU-Pro и 64,0 на MMMU, при этом в среднем сокращая «длину рассуждений» на 20%.
Помимо рассуждений, версия 2506 демонстрирует улучшенное общее визуальное восприятие и понимание. Она сопоставима или даже превосходит «не‑thinking» модели на бенчмарках MMBench-EN-v1.1 (84,4), MMStar (70,4), RealWorldQA (70,0) и MMVet (78,4).
Источник: MoonshotAI/Kimi-VL: Kimi-VL
Пример использования:
from transformers import AutoProcessor
from vllm import LLM, SamplingParams

model_path = "moonshotai/Kimi-VL-A3B-Thinking-2506"
llm = LLM(
    model_path,
    trust_remote_code=True,
    max_num_seqs=8,
    max_model_len=131072,
    limit_mm_per_prompt={"image": 256}
)

processor = AutoProcessor.from_pretrained(model_path, trust_remote_code=True)

sampling_params = SamplingParams(max_tokens=32768, temperature=0.8)


import requests
from PIL import Image

def extract_thinking_and_summary(text: str, bot: str = "◁think▷", eot: str = "◁/think▷") -> str:
    if bot in text and eot not in text:
        return ""
    if eot in text:
        return text[text.index(bot) + len(bot):text.index(eot)].strip(), text[text.index(eot) + len(eot) :].strip()
    return "", text

OUTPUT_FORMAT = "--------Thinking--------\n{thinking}\n\n--------Summary--------\n{summary}"

url = "https://huggingface.co/spaces/moonshotai/Kimi-VL-A3B-Thinking/resolve/main/images/demo6.jpeg"
image = Image.open(requests.get(url,stream=True).raw)

messages = [
    {"role": "user", "content": [{"type": "image", "image": ""}, {"type": "text", "text": "What kind of cat is this? Answer with one word."}]}
]
text = processor.apply_chat_template(messages, add_generation_prompt=True, return_tensors="pt")

outputs = llm.generate([{"prompt": text, "multi_modal_data": {"image": image}}], sampling_params=sampling_params)
generated_text = outputs[0].outputs[0].text

thinking, summary = extract_thinking_and_summary(generated_text)
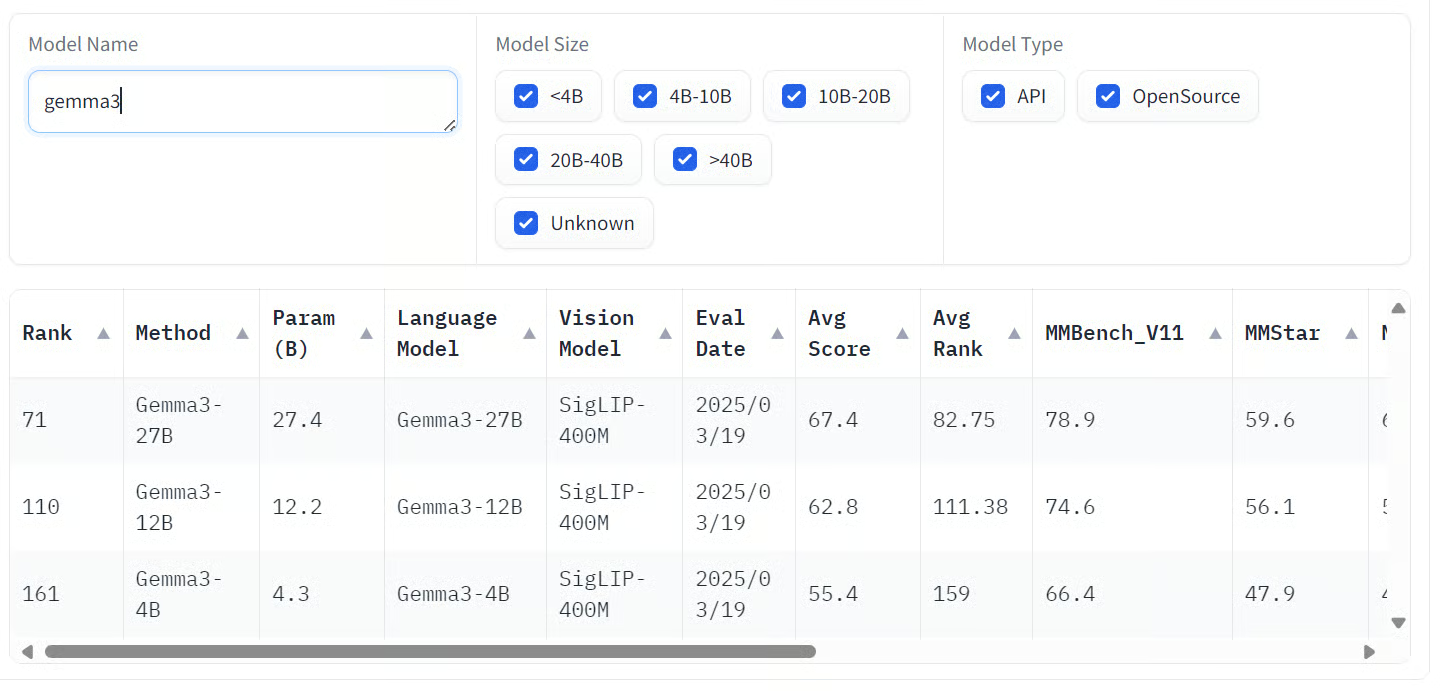
print(OUTPUT_FORMAT.format(thinking=thinking, summary=summary))Gemma 3 — семейство мультимодальных ИИ‑моделей от Google, способных принимать на вход текст и изображения и выдавать текст. Доступны варианты разных размеров: 1B, 4B, 12B и 27B — под разные требования к железу и производительности.
Крупнейший вариант, Gemma 3 27B, показал впечатляющие результаты в оценках предпочтений людей, превзойдя даже более крупные модели, такие как Llama 3-405B и DeepSeek-V3.
Модели демонстрируют сильные результаты на разных бенчмарках. Особенно они успешны в мультимодальных задачах, показывая заметные баллы на COCOcap (116), DocVQA (85,6), MMMU (56,1) и VQAv2 (72,9).
Источник: Open VLM Leaderboard
Пример использования:
# pip install accelerate

from transformers import AutoProcessor, Gemma3ForConditionalGeneration
from PIL import Image
import requests
import torch

model_id = "google/gemma-3-27b-it"

model = Gemma3ForConditionalGeneration.from_pretrained(
    model_id, device_map="auto"
).eval()

processor = AutoProcessor.from_pretrained(model_id)

messages = [
    {
        "role": "system",
        "content": [{"type": "text", "text": "You are a helpful assistant."}]
    },
    {
        "role": "user",
        "content": [
            {"type": "image", "image": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/bee.jpg"},
            {"type": "text", "text": "Describe this image in detail."}
        ]
    }
]

inputs = processor.apply_chat_template(
    messages, add_generation_prompt=True, tokenize=True,
    return_dict=True, return_tensors="pt"
).to(model.device, dtype=torch.bfloat16)

input_len = inputs["input_ids"].shape[-1]

with torch.inference_mode():
    generation = model.generate(**inputs, max_new_tokens=100, do_sample=False)
    generation = generation[0][input_len:]

decoded = processor.decode(generation, skip_special_tokens=True)
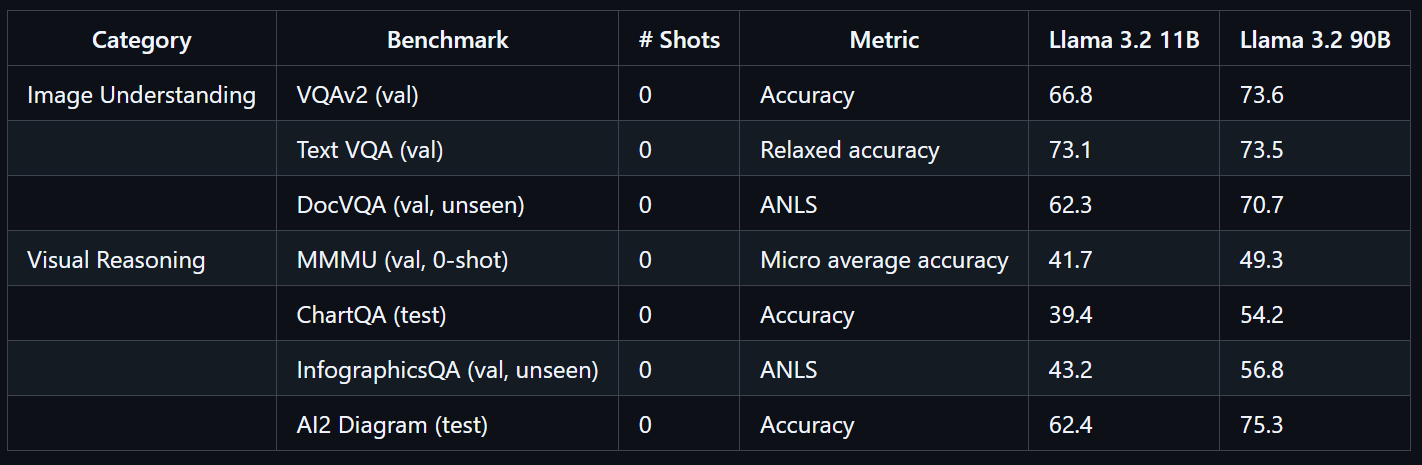
print(decoded)Модель Llama 3.2 90B Vision Instruct — это продвинутый мультимодальный большой языковой модель от Meta. Она предназначена для задач визуального распознавания, рассуждения по изображениям и подписей к ним.
Llama 3.2 90B Vision Instruct основана на текстовой версии Llama 3.1 и включает отдельно обученный визуальный адаптер, который позволяет принимать на вход изображения и текст и генерировать точные текстовые ответы.
Обученная в крупном масштабе, модель Llama 3.2 90B Vision потребовала 8,85 млн GPU‑часов. Она демонстрирует выдающиеся результаты на бенчмарках VQAv2 (73,6), Text VQA (73,5) и DocVQA (70,7).
Источник: llama-models
Пример использования:
import requests
import torch
from PIL import Image
from transformers import MllamaForConditionalGeneration, AutoProcessor

model_id = "meta-llama/Llama-3.2-90B-Vision-Instruct"

model = MllamaForConditionalGeneration.from_pretrained(
    model_id,
    torch_dtype=torch.bfloat16,
    device_map="auto",
)
processor = AutoProcessor.from_pretrained(model_id)

url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/0052a70beed5bf71b92610a43a52df6d286cd5f3/diffusers/rabbit.jpg"
image = Image.open(requests.get(url, stream=True).raw)

messages = [
    {"role": "user", "content": [
        {"type": "image"},
        {"type": "text", "text": "If I had to write a haiku for this one, it would be: "}
    ]}
]
input_text = processor.apply_chat_template(messages, add_generation_prompt=True)
inputs = processor(
    image,
    input_text,
    add_special_tokens=False,
    return_tensors="pt",
).to(model.device)

output = model.generate(**inputs, max_new_tokens=30)
print(processor.decode(output[0]))
Визуальное рассуждение с графиками — также сильная сторона новейшей модели Meta, Muse Spark.
Vision-language модели кардинально меняют взаимодействие с визуальной и текстовой информацией, обеспечивая впечатляющую точность и гибкость во множестве отраслей. Они органично объединяют компьютерное зрение и обработку естественного языка, открывая приложения от продвинутого обнаружения объектов до интуитивных визуальных ассистентов.
Если для вашего кейса приоритетны приватность и безопасность, стоит обратить внимание на открытые vision-language модели. Запуская их локально, вы полностью контролируете данные — это идеально для чувствительных сред. Открытые VLM также хорошо адаптируются: зачастую их можно дообучить на нескольких сотнях примеров и получить отличные результаты под ваши задачи.
Проприетарные модели, в свою очередь, предоставляют надёжный и экономичный доступ к передовым возможностям. Они, как правило, очень точны и интегрируются в ваш рабочий процесс несколькими строками кода, что делает их доступными даже для команд без глубоких компетенций в ИИ.
Если вы хотите больше узнать о vision-language моделях, обратите внимание на эти материалы:
Лучшие курсы DataCamp
Track
Course
Course