Cours
Traitement d’images en Python
4 h
56.8K
Les Vision Language Models (VLMs) transforment rapidement les secteurs en permettant aux systèmes d’IA de comprendre et de raisonner à la fois sur des images et du texte. À la différence des modèles de vision par ordinateur traditionnels, les VLM modernes savent interpréter des images complexes, répondre à des questions détaillées sur du contenu visuel, et même traiter des vidéos et des documents contenant du texte intégré.
Cette capacité les rend précieux pour le diagnostic médical, le contrôle qualité automatisé et les usages sensibles où la précision prime sur la vitesse.
Dans cet article, nous passons en revue les meilleurs modèles vision-langage de 2026, open source comme propriétaires. Nous mettrons en avant leurs atouts uniques puis présenterons leurs performances et résultats de benchmarks. Pour les développeurs et chercheurs, nous incluons également des extraits de code pour tester rapidement ces modèles.
Si vous souhaitez approfondir les fondamentaux de ces modèles, consultez notre parcours Image Processing in Python.
Gemini 2.5 Pro est le modèle d’IA le plus avancé de Google, actuellement en tête des classements LMArena et WebDevArena pour les tâches de vision et de code. Il est conçu pour le raisonnement complexe et la compréhension sur le texte, l’image, l’audio et la vidéo.
Côté vision-langage, il figure parmi les meilleurs modèles du classement Open LLM. Gemini 2.5 Pro interprète images et vidéos, génère des descriptions détaillées et contextuelles, et répond aux questions liées au contenu visuel.
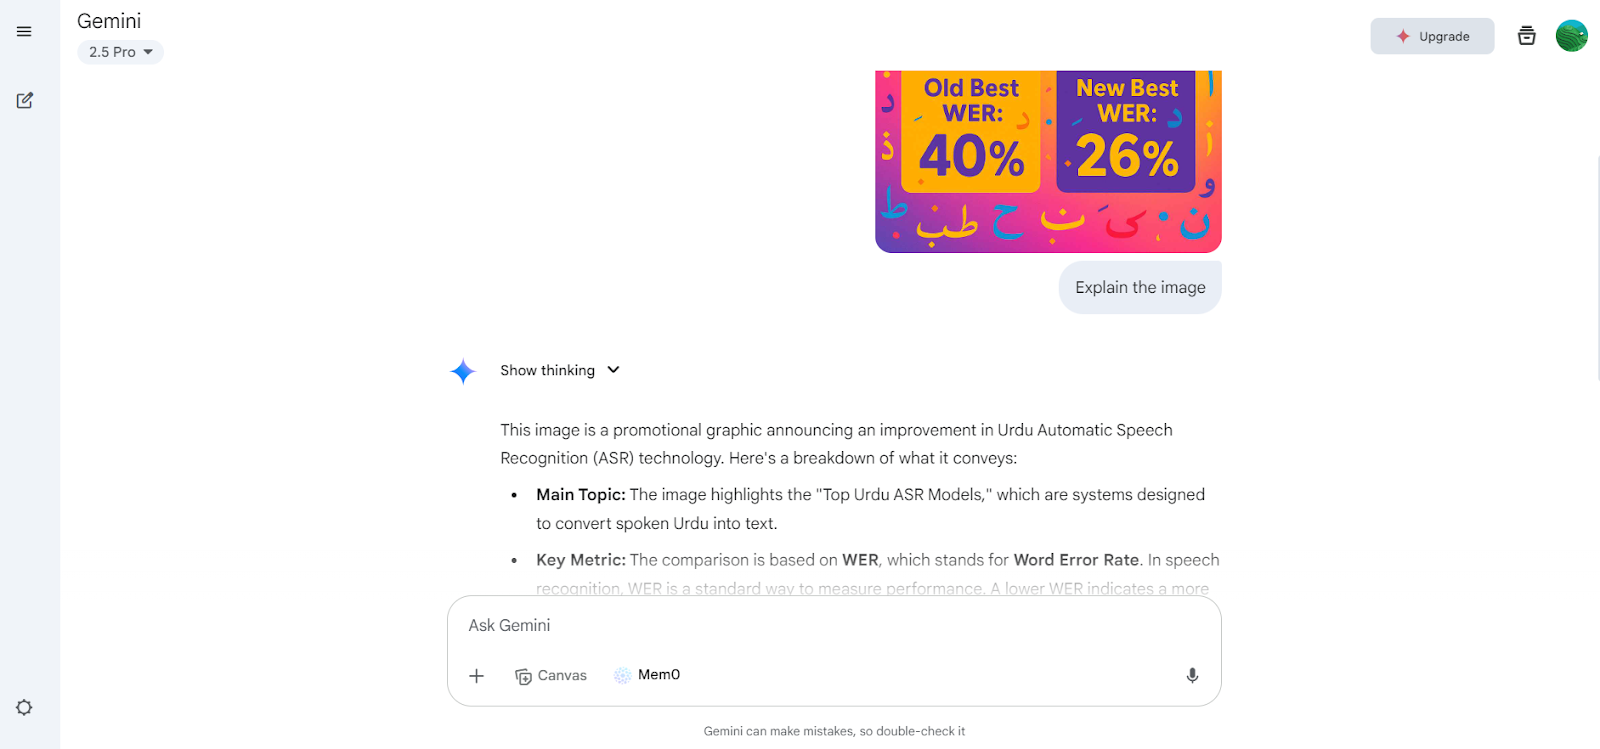
Source : Google Gemini
Vous pouvez accéder gratuitement à Gemini 2.5 Pro via l’application web Gemini à l’adresse gemini.google.com/app ou via Google AI Studio.
Pour les développeurs, Gemini 2.5 Pro est également disponible via l’API Gemini, Vertex AI et le SDK Python officiel, ce qui facilite l’intégration de ses fonctionnalités vision-langage dans vos applications ou workflows.
Exemple d’utilisation :
from google.genai import types

with open('path/to/image.jpg', 'rb') as f:
      image_bytes = f.read()

  response = client.models.generate_content(
    model='gemini-2.5-pro',
    contents=[
      types.Part.from_bytes(
        data=image_bytes,
        mime_type='image/jpeg',
      ),
      'Explain the image.'
    ]
  )
print(response.text)InternVL3 est une série avancée de modèles de langage multimodaux (MLLM) qui surpasse son prédécesseur, InternVL 2.5. Il excelle en perception et en raisonnement multimodaux et apporte des améliorations notables, notamment l’usage d’outils, des agents GUI, l’analyse d’images industrielles et la perception 3D.
Le modèle InternVL3-78B utilise spécifiquement InternViT-6B-448px-V2_5 pour la vision et Qwen2.5-72B pour la partie langage. Avec 78,41 milliards de paramètres, InternVL3-78B a obtenu un score de 72,2 sur le benchmark MMMU, établissant un nouvel état de l’art parmi les MLLM open source. Ses performances rivalisent avec celles des meilleurs modèles propriétaires.
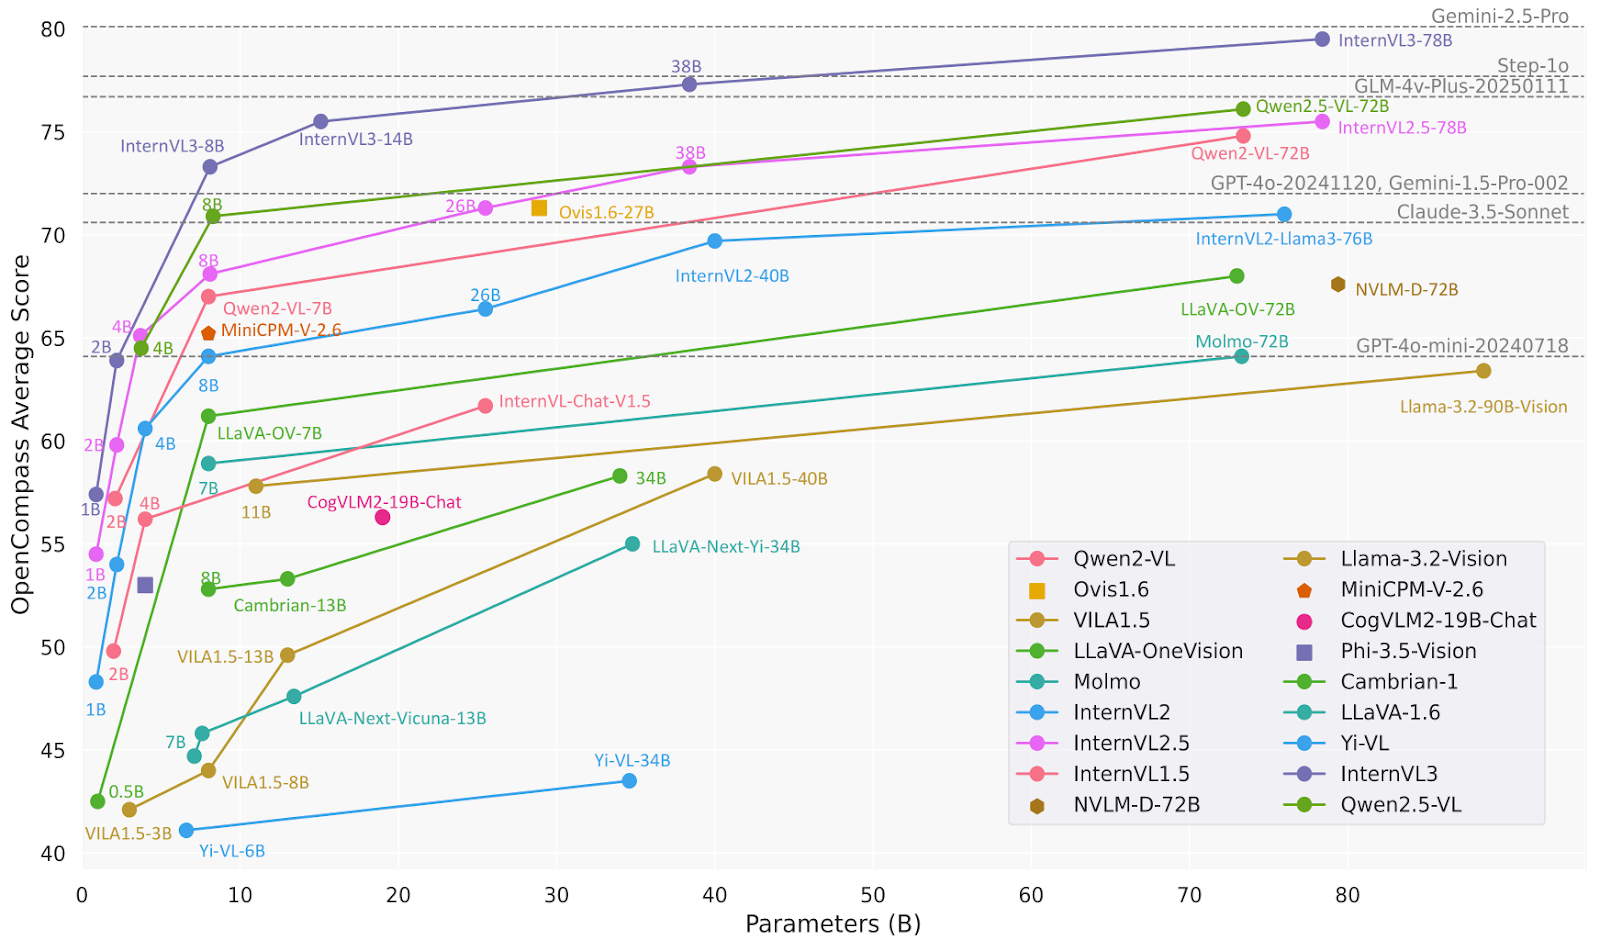
Source : OpenGVLab/InternVL3-78B · Hugging Face
Exemple d’utilisation :
# pip install lmdeploy>=0.7.3
from lmdeploy import pipeline, TurbomindEngineConfig, ChatTemplateConfig
from lmdeploy.vl import load_image

model = 'OpenGVLab/InternVL3-78B'
image = load_image('https://raw.githubusercontent.com/open-mmlab/mmdeploy/main/tests/data/tiger.jpeg')
pipe = pipeline(model, backend_config=TurbomindEngineConfig(session_len=16384, tp=4), chat_template_config=ChatTemplateConfig(model_name='internvl2_5'))
response = pipe(('Explain the image.', image))
print(response.text)Ovis2 est une série de modèles de langage multimodaux (MLLM) développés par AIDC-AI. Ces modèles sont conçus pour aligner efficacement les plongements visuels et textuels. Le modèle Ovis2-34B utilise notamment aimv2-1B-patch14-448 comme encodeur de vision et Qwen2.5-32B-Instruct comme modèle de langage, pour un total de 34 milliards de paramètres. Il prend en charge une longueur de contexte maximale de 32 768 tokens et utilise la précision bfloat16 pour un traitement efficace.
Ovis2-34B affiche de solides performances sur divers benchmarks, avec les résultats suivants :
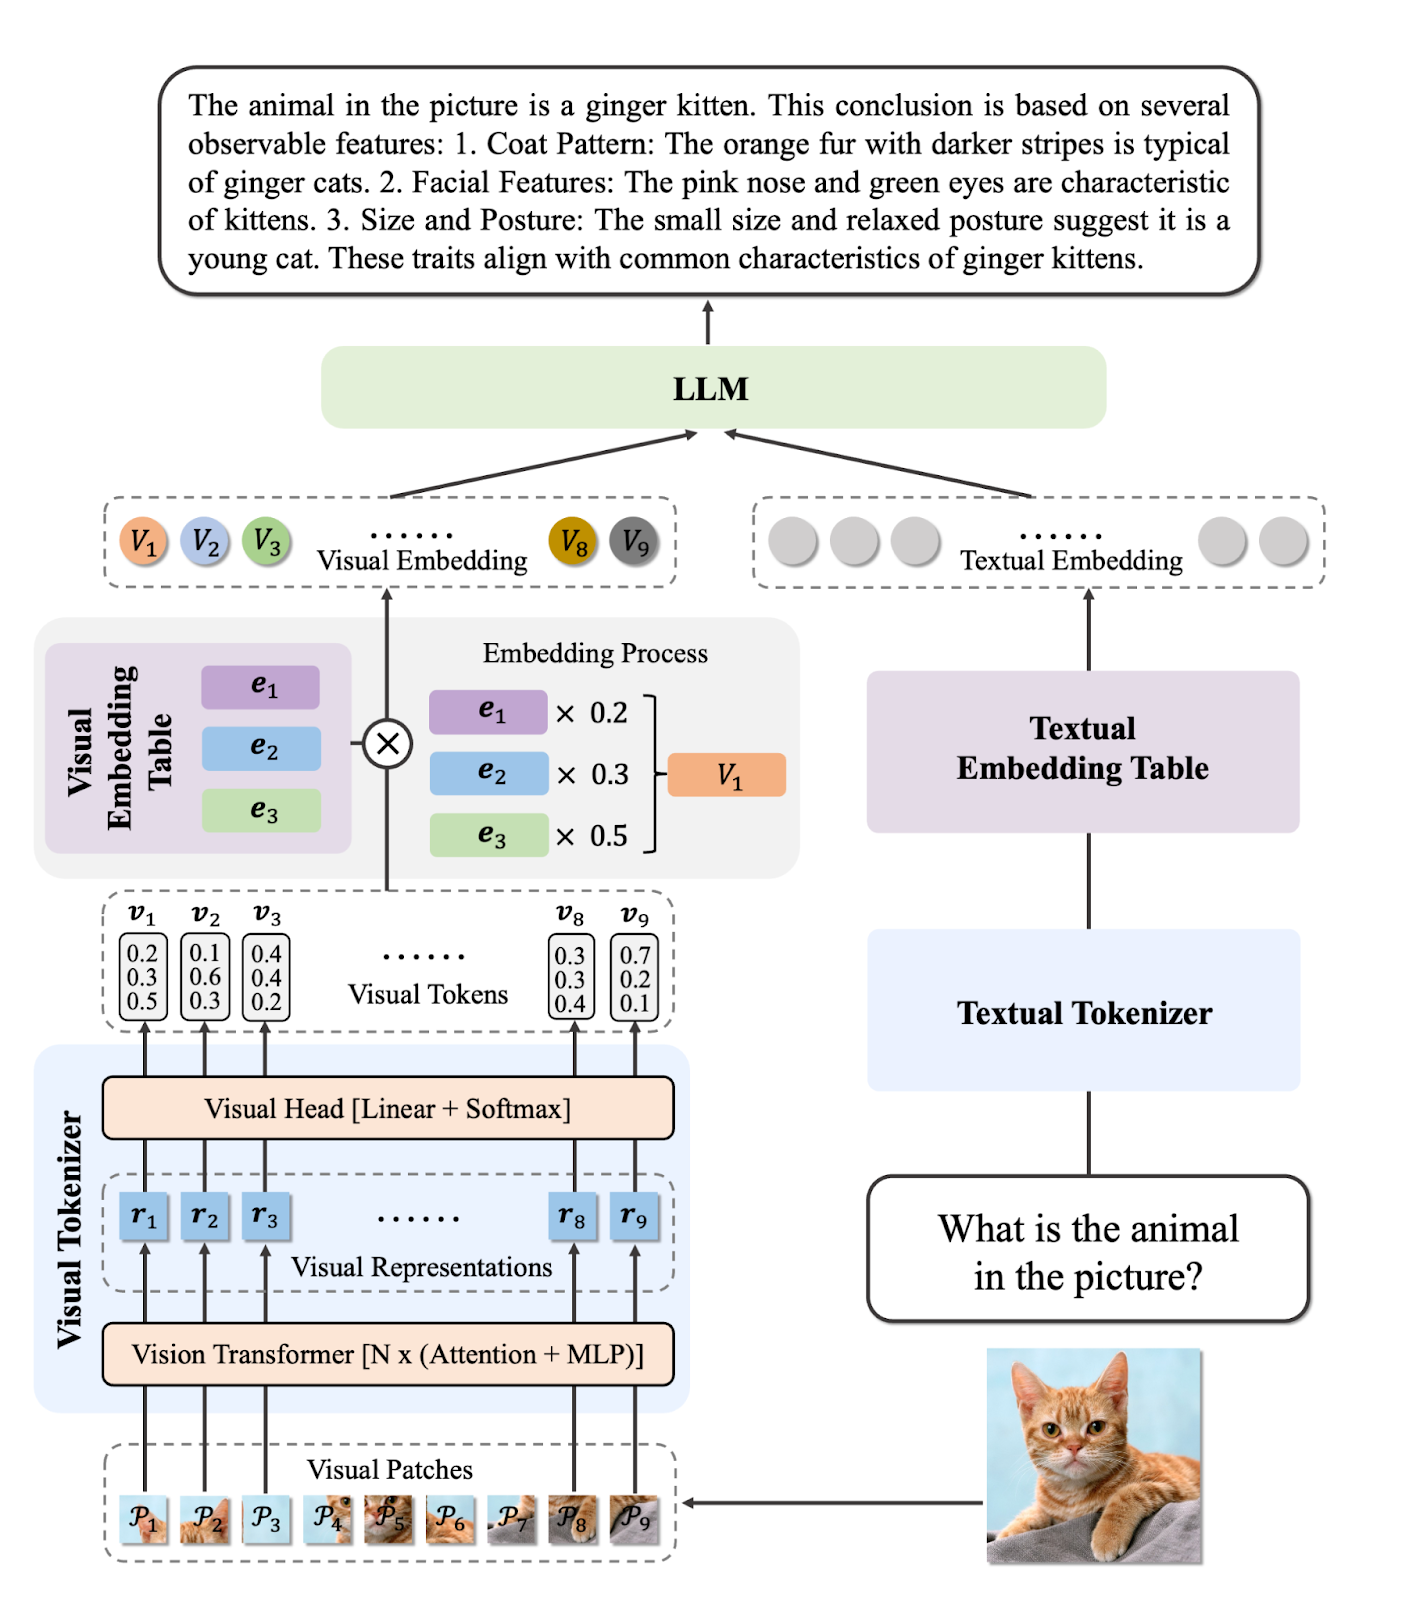
Source : AIDC-AI/Ovis2-34B · Hugging Face
Exemple d’utilisation :
import torch
from PIL import Image
from transformers import AutoModelForCausalLM

# load model
model = AutoModelForCausalLM.from_pretrained("AIDC-AI/Ovis2-34B",
                                             torch_dtype=torch.bfloat16,
                                             multimodal_max_length=32768,
                                             trust_remote_code=True).cuda()
text_tokenizer = model.get_text_tokenizer()
visual_tokenizer = model.get_visual_tokenizer()

# single-image input
image_path = '/data/images/example_1.jpg'
images = [Image.open(image_path)]
max_partition = 9
text = 'Describe the image.'
query = f'<image>\n{text}'


# format conversation
prompt, input_ids, pixel_values = model.preprocess_inputs(query, images, max_partition=max_partition)
attention_mask = torch.ne(input_ids, text_tokenizer.pad_token_id)
input_ids = input_ids.unsqueeze(0).to(device=model.device)
attention_mask = attention_mask.unsqueeze(0).to(device=model.device)
if pixel_values is not None:
    pixel_values = pixel_values.to(dtype=visual_tokenizer.dtype, device=visual_tokenizer.device)
pixel_values = [pixel_values]

# generate output
with torch.inference_mode():
    gen_kwargs = dict(
        max_new_tokens=1024,
        do_sample=False,
        top_p=None,
        top_k=None,
        temperature=None,
        repetition_penalty=None,
        eos_token_id=model.generation_config.eos_token_id,
        pad_token_id=text_tokenizer.pad_token_id,
        use_cache=True
    )
    output_ids = model.generate(input_ids, pixel_values=pixel_values, attention_mask=attention_mask, **gen_kwargs)[0]
    output = text_tokenizer.decode(output_ids, skip_special_tokens=True)
print(f'Output:\n{output}')Qwen2.5-VL-72B-Instruct est un modèle de langage multimodal (MLLM) de la famille Qwen, conçu pour comprendre et traiter à la fois des informations visuelles et textuelles. De nombreux MLLM open source s’appuient dessus, preuve que la série Qwen joue un rôle majeur dans l’avancement de la recherche en IA.
Qwen2.5-VL-72B-Instruct affiche d’excellents résultats sur divers benchmarks, tant en compréhension d’images et de vidéos que sur les fonctions d’agent. Il obtient 70,2 sur MMMUval, 74,8 sur MathVista_MINI et 70,8 sur MMStar.
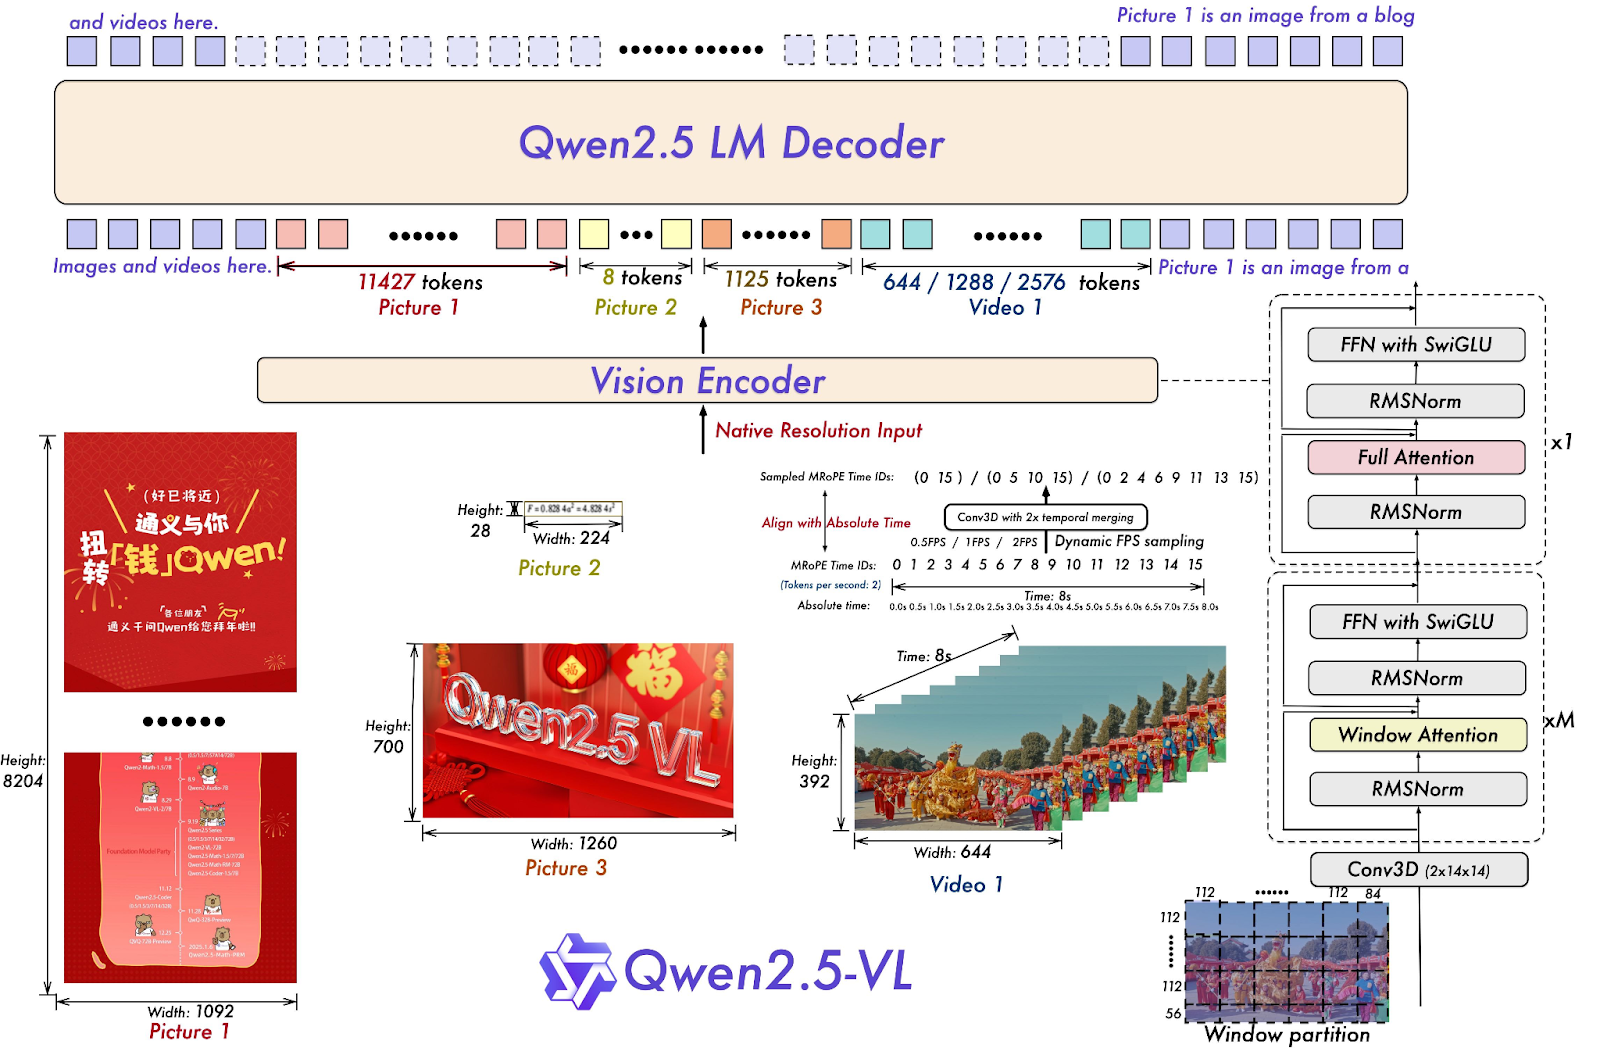
Source : Qwen/Qwen2.5-VL-72B-Instruct · Hugging Face
Exemple d’utilisation :
# pip install qwen-vl-utils[decord]==0.0.8

from transformers import Qwen2_5_VLForConditionalGeneration, AutoTokenizer, AutoProcessor
from qwen_vl_utils import process_vision_info

# default: Load the model on the available device(s)
model = Qwen2_5_VLForConditionalGeneration.from_pretrained(
    "Qwen/Qwen2.5-VL-72B-Instruct", torch_dtype="auto", device_map="auto"
)
# default processer
processor = AutoProcessor.from_pretrained("Qwen2.5-VL-72B-Instruct")


messages = [
    {
        "role": "user",
        "content": [
            {
                "type": "image",
                "image": "https://qianwen-res.oss-cn-beijing.aliyuncs.com/Qwen-VL/assets/demo.jpeg",
            },
            {"type": "text", "text": "Describe this image."},
        ],
    }
]

# Preparation for inference
text = processor.apply_chat_template(
    messages, tokenize=False, add_generation_prompt=True
)
image_inputs, video_inputs = process_vision_info(messages)
inputs = processor(
    text=[text],
    images=image_inputs,
    videos=video_inputs,
    padding=True,
    return_tensors="pt",
)
inputs = inputs.to("cuda")

# Inference: Generation of the output
generated_ids = model.generate(**inputs, max_new_tokens=128)
generated_ids_trimmed = [
    out_ids[len(in_ids) :] for in_ids, out_ids in zip(inputs.input_ids, generated_ids)
]
output_text = processor.batch_decode(
    generated_ids_trimmed, skip_special_tokens=True, clean_up_tokenization_spaces=False
)
print(output_text)o3 d’OpenAI est un nouveau modèle de raisonnement conçu pour offrir une intelligence supérieure, des coûts réduits et une utilisation des tokens plus efficiente dans les applications. Il inaugure une nouvelle génération de modèles centrés sur des capacités de raisonnement avancées.
Il fixe un nouveau standard pour les tâches en mathématiques, sciences, code et raisonnement visuel. Sur divers benchmarks de vision, il dépasse o4-min et o1, et rivalise avec o3 Pro.
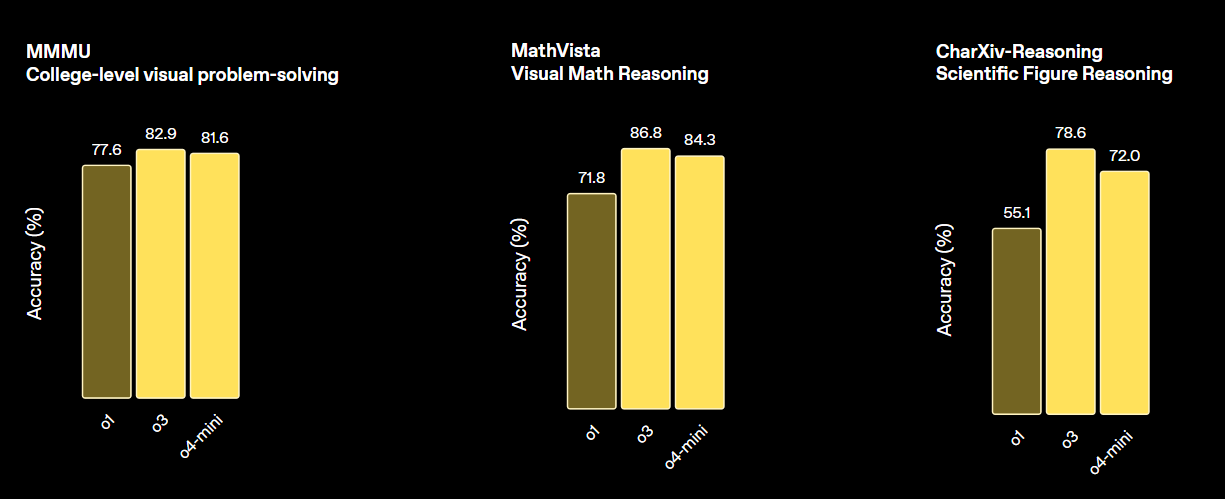
Source : Introducing OpenAI o3 and o4-mini | OpenAI
Exemple d’utilisation :
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="o3-2025-04-16",
    input=[{
        "role": "user",
        "content": [
            {"type": "input_text", "text": "what's in this image?"},
            {
                "type": "input_image",
                "image_url": "https://upload.wikimedia.org/wikipedia/commons/thumb/d/dd/Gfp-wisconsin-madison-the-nature-boardwalk.jpg/2560px-Gfp-wisconsin-madison-the-nature-boardwalk.jpg",
            },
        ],
    }],
)

print(response.output_text)GPT-4.1 est une nouvelle famille de modèles non « reasoning », incluant GPT-4.1, GPT-4.1 Mini et GPT-4.1 Nano. Ces modèles surpassent leurs prédécesseurs, GPT-4o et GPT-4o Mini, sur de nombreux benchmarks.
GPT-4.1 conserve de solides capacités en vision, avec des progrès en analyse de graphiques, schémas et mathématiques visuelles. Il excelle sur des tâches comme le comptage d’objets, le VQA (Visual Question Answering) et différentes formes d’OCR.
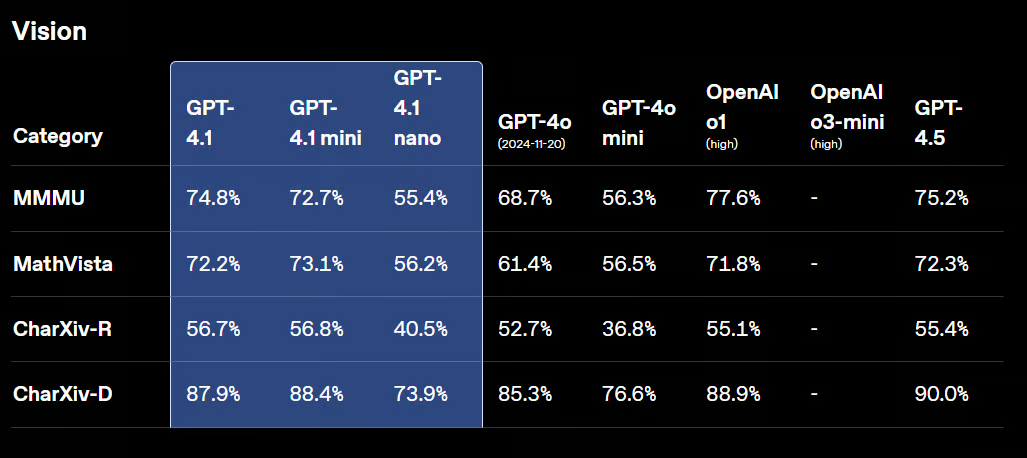
Source : Introducing GPT-4.1 in the API | OpenAI
Exemple d’utilisation :
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-4.1-2025-04-14",
    input=[{
        "role": "user",
        "content": [
            {"type": "input_text", "text": "what's in this image?"},
            {
                "type": "input_image",
                "image_url": "https://upload.wikimedia.org/wikipedia/commons/thumb/d/dd/Gfp-wisconsin-madison-the-nature-boardwalk.jpg/2560px-Gfp-wisconsin-madison-the-nature-boardwalk.jpg",
            },
        ],
    }],
)

print(response.output_text)Anthropic a introduit la nouvelle génération de ses modèles Claude : Claude 4 Opus et Claude 4 Sonnet. Ces modèles visent de nouveaux standards en code, raisonnement avancé et capacités d’IA.
Ils intègrent des capacités de vision améliorées pour comprendre des images puis générer du code ou fournir des informations basées sur ces images. Bien qu’axé sur le code, le modèle est véritablement multimodal et comprend plusieurs types de formats de fichiers.
Comme le montre le tableau comparatif ci-dessous, Claude 4 surpasse la plupart des meilleurs modèles, à l’exception du modèle GPT-3 d’OpenAI, notamment en raisonnement visuel et en VQA.
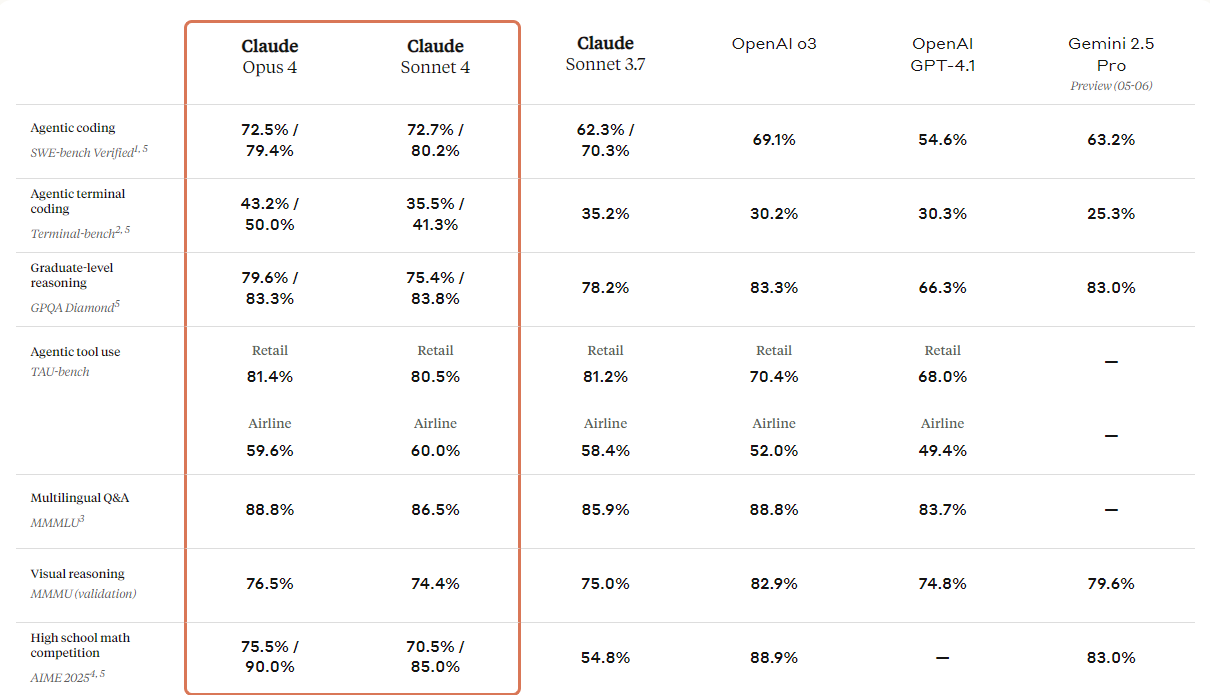
Source : Introducing Claude 4 \ Anthropic
Exemple d’utilisation :
import anthropic

client = anthropic.Anthropic()
message = client.messages.create(
    model="claude-sonnet-4-20250514",
    max_tokens=1024,
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image",
                    "source": {
                        "type": "url",
                        "url": "https://upload.wikimedia.org/wikipedia/commons/a/a7/Camponotus_flavomarginatus_ant.jpg",
                    },
                },
                {
                    "type": "text",
                    "text": "Describe this image."
                }
            ],
        }
    ],
)
print(message)Kimi-VL-A3B-Thinking-2506 est un modèle open source qui marque une avancée majeure en IA multimodale. Il brille sur les benchmarks de raisonnement multimodal, avec des scores remarquables : 56,9 sur MathVision, 80,1 sur MathVista, 46,3 sur MMMU-Pro et 64,0 sur MMMU, tout en réduisant sa « longueur de réflexion » en moyenne de 20 %.
Au-delà du raisonnement, la version 2506 améliore la perception et la compréhension visuelles générales. Elle égale ou dépasse même les modèles non « thinking » sur des benchmarks tels que MMBench-EN-v1.1 (84,4), MMStar (70,4), RealWorldQA (70,0) et MMVet (78,4).
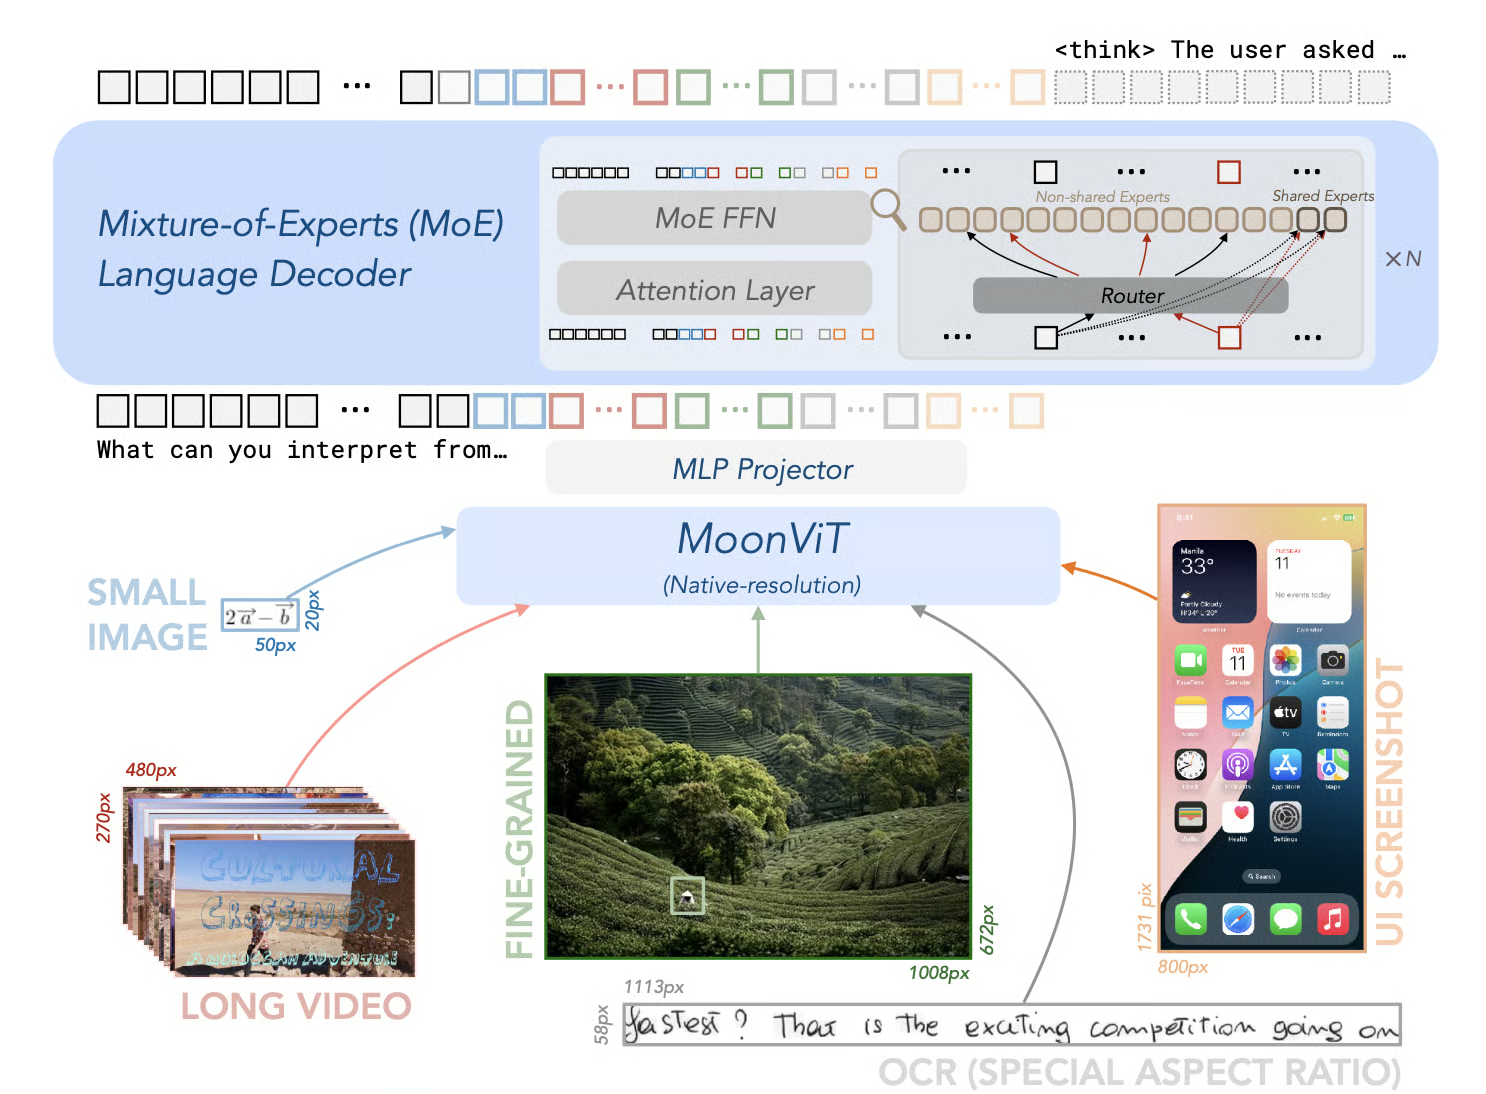
Source : MoonshotAI/Kimi-VL: Kimi-VL
Exemple d’utilisation :
from transformers import AutoProcessor
from vllm import LLM, SamplingParams

model_path = "moonshotai/Kimi-VL-A3B-Thinking-2506"
llm = LLM(
    model_path,
    trust_remote_code=True,
    max_num_seqs=8,
    max_model_len=131072,
    limit_mm_per_prompt={"image": 256}
)

processor = AutoProcessor.from_pretrained(model_path, trust_remote_code=True)

sampling_params = SamplingParams(max_tokens=32768, temperature=0.8)


import requests
from PIL import Image

def extract_thinking_and_summary(text: str, bot: str = "◁think▷", eot: str = "◁/think▷") -> str:
    if bot in text and eot not in text:
        return ""
    if eot in text:
        return text[text.index(bot) + len(bot):text.index(eot)].strip(), text[text.index(eot) + len(eot) :].strip()
    return "", text

OUTPUT_FORMAT = "--------Thinking--------\n{thinking}\n\n--------Summary--------\n{summary}"

url = "https://huggingface.co/spaces/moonshotai/Kimi-VL-A3B-Thinking/resolve/main/images/demo6.jpeg"
image = Image.open(requests.get(url,stream=True).raw)

messages = [
    {"role": "user", "content": [{"type": "image", "image": ""}, {"type": "text", "text": "What kind of cat is this? Answer with one word."}]}
]
text = processor.apply_chat_template(messages, add_generation_prompt=True, return_tensors="pt")

outputs = llm.generate([{"prompt": text, "multi_modal_data": {"image": image}}], sampling_params=sampling_params)
generated_text = outputs[0].outputs[0].text

thinking, summary = extract_thinking_and_summary(generated_text)
print(OUTPUT_FORMAT.format(thinking=thinking, summary=summary))Gemma 3 est une famille de modèles d’IA multimodaux développés par Google, capables de traiter des entrées texte et image pour produire des sorties textuelles. Les modèles existent en plusieurs tailles : 1B, 4B, 12B et 27B, pour répondre à différents besoins matériels et de performance.
La plus grande variante, Gemma 3 27B, affiche d’excellentes performances dans les évaluations de préférence humaine, dépassant même des modèles plus volumineux comme Llama 3-405B et DeepSeek-V3.
Les modèles se distinguent sur de nombreux benchmarks. En particulier, ils excellent en tâches multimodales, avec des scores notables sur COCOcap (116), DocVQA (85,6), MMMU (56,1) et VQAv2 (72,9).
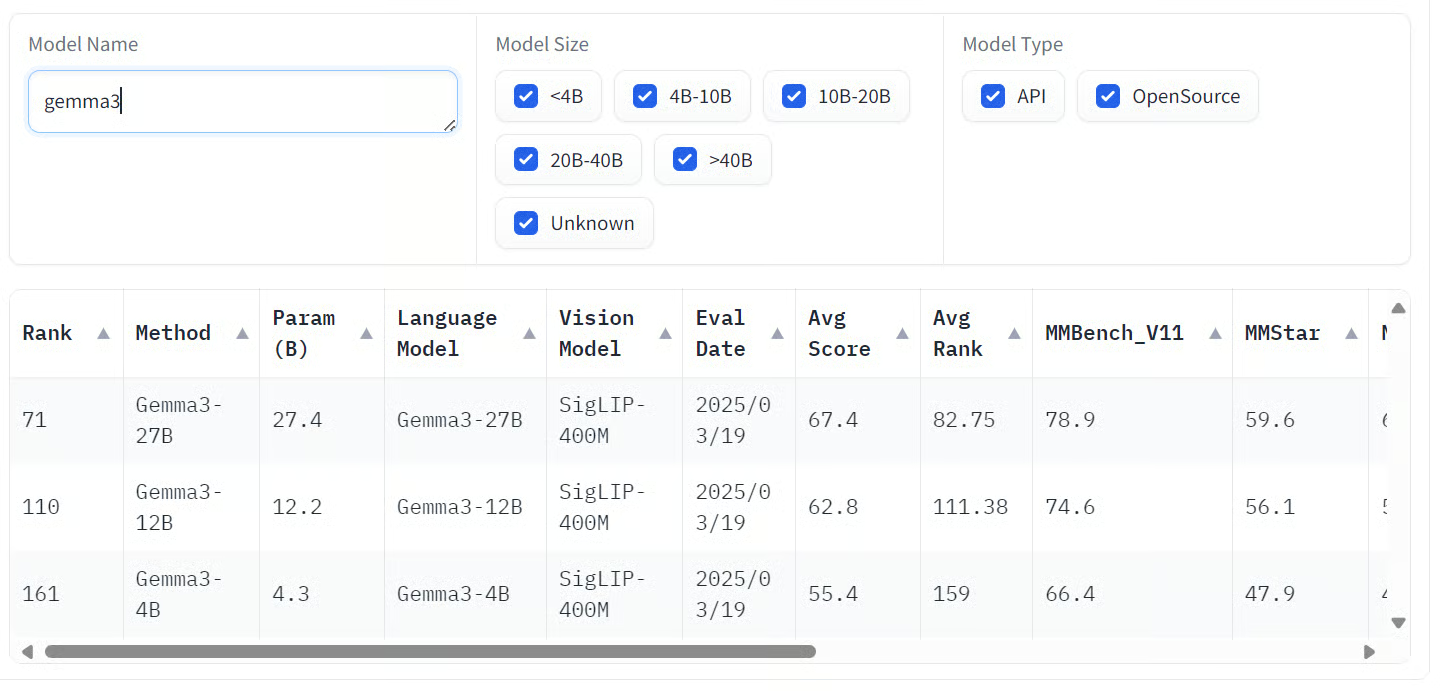
Source : Open VLM Leaderboard
Exemple d’utilisation :
# pip install accelerate

from transformers import AutoProcessor, Gemma3ForConditionalGeneration
from PIL import Image
import requests
import torch

model_id = "google/gemma-3-27b-it"

model = Gemma3ForConditionalGeneration.from_pretrained(
    model_id, device_map="auto"
).eval()

processor = AutoProcessor.from_pretrained(model_id)

messages = [
    {
        "role": "system",
        "content": [{"type": "text", "text": "You are a helpful assistant."}]
    },
    {
        "role": "user",
        "content": [
            {"type": "image", "image": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/bee.jpg"},
            {"type": "text", "text": "Describe this image in detail."}
        ]
    }
]

inputs = processor.apply_chat_template(
    messages, add_generation_prompt=True, tokenize=True,
    return_dict=True, return_tensors="pt"
).to(model.device, dtype=torch.bfloat16)

input_len = inputs["input_ids"].shape[-1]

with torch.inference_mode():
    generation = model.generate(**inputs, max_new_tokens=100, do_sample=False)
    generation = generation[0][input_len:]

decoded = processor.decode(generation, skip_special_tokens=True)
print(decoded)Le modèle Llama 3.2 90B Vision Instruct est un modèle de langage multimodal avancé développé par Meta. Il est conçu pour la reconnaissance visuelle, le raisonnement sur images et la génération de légendes.
Llama 3.2 90B Vision Instruct s’appuie sur la version texte seule Llama 3.1 et intègre un adaptateur de vision entraîné séparément, ce qui lui permet de traiter des entrées image et texte et de générer des sorties textuelles précises.
Entraîné à très grande échelle, le modèle Llama 3.2 90B Vision a nécessité 8,85 millions d’heures GPU. Il affiche d’excellents résultats sur VQAv2 (73,6), Text VQA (73,5) et DocVQA (70,7).
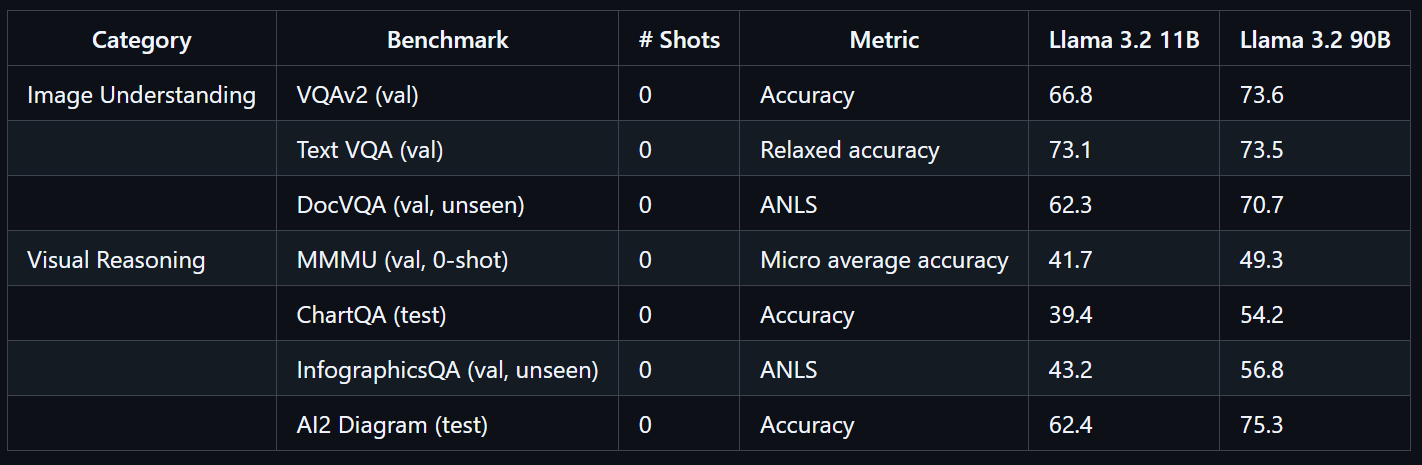
Source : llama-models
Exemple d’utilisation :
import requests
import torch
from PIL import Image
from transformers import MllamaForConditionalGeneration, AutoProcessor

model_id = "meta-llama/Llama-3.2-90B-Vision-Instruct"

model = MllamaForConditionalGeneration.from_pretrained(
    model_id,
    torch_dtype=torch.bfloat16,
    device_map="auto",
)
processor = AutoProcessor.from_pretrained(model_id)

url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/0052a70beed5bf71b92610a43a52df6d286cd5f3/diffusers/rabbit.jpg"
image = Image.open(requests.get(url, stream=True).raw)

messages = [
    {"role": "user", "content": [
        {"type": "image"},
        {"type": "text", "text": "If I had to write a haiku for this one, it would be: "}
    ]}
]
input_text = processor.apply_chat_template(messages, add_generation_prompt=True)
inputs = processor(
    image,
    input_text,
    add_special_tokens=False,
    return_tensors="pt",
).to(model.device)

output = model.generate(**inputs, max_new_tokens=30)
print(processor.decode(output[0]))
Le raisonnement visuel avec des graphiques est aussi un point fort du tout dernier modèle de Meta, Muse Spark.
Les modèles vision-langage transforment en profondeur notre interaction avec l’information visuelle et textuelle, en offrant une précision et une flexibilité remarquables dans de nombreux secteurs. En combinant de façon fluide vision par ordinateur et traitement du langage naturel, ils ouvrent la voie à de nouvelles applications, de la détection d’objets avancée aux assistants visuels intuitifs.
Si la confidentialité et la sécurité sont prioritaires pour votre cas d’usage, nous vous recommandons vivement d’explorer les modèles vision-langage open source. Les exécuter en local vous donne un contrôle total sur vos données, idéal pour les environnements sensibles. Les VLM open source sont aussi très adaptables : la plupart se prêtent à un affinement avec quelques centaines d’exemples seulement pour atteindre d’excellents résultats adaptés à vos besoins.
Les modèles propriétaires, de leur côté, offrent un accès fiable et économique à l’état de l’art. Très précis, ils s’intègrent à votre workflow en quelques lignes de code, même sans expertise IA poussée au sein de l’équipe.
Pour aller plus loin sur les modèles vision-langage, consultez ces ressources :
Meilleurs cours DataCamp
Cours
Cours
Cursus
blog
Lynn Heidmann
blog
blog
Kurtis Pykes
9 min
blog
Kurtis Pykes
15 min
blog
Zoumana Keita
15 min
Tutoriel