
Kurs
Bildverarbeitung mit Python
4 Std.
56.8K
Vision Language Models (VLMs) verändern Branchen im Eiltempo, weil sie KI-Systemen ermöglichen, Bilder und Text gemeinsam zu verstehen und darüber zu schlussfolgern. Anders als klassische Computer-Vision-Modelle können moderne VLMs komplexe Bilder interpretieren, detaillierte Fragen zu visuellen Inhalten beantworten und sogar Videos sowie Dokumente mit eingebettetem Text verarbeiten.
Diese Fähigkeit macht sie unschätzbar wertvoll für medizinische Diagnostik, automatisierte Qualitätskontrolle und sensible Anwendungen, bei denen Präzision wichtiger ist als Geschwindigkeit.
In diesem Blog stellen wir die wichtigsten Vision-Language-Modelle 2026 vor – sowohl Open Source als auch proprietär. Wir zeigen ihre besonderen Stärken und vergleichen anschließend Leistung und Benchmarks. Für Entwicklerinnen und Entwickler sowie Forschende haben wir außerdem Beispielcodes eingebunden, damit du die Modelle schnell selbst ausprobieren kannst.
Wenn du mehr über die Grundlagen dieser Modelle erfahren willst, schau dir unbedingt unseren Image Processing in Python Skill Track an.
Gemini 2.5 Pro ist Googles fortschrittlichstes KI-Modell und führt aktuell die LMArena- und WebDevArena-Ranglisten für Vision- und Coding-Aufgaben an. Es ist für komplexes Schlussfolgern und Verständnis über Text, Bilder, Audio und Video hinweg ausgelegt.
Bei seinen Vision-Language-Fähigkeiten zählt es zu den Topmodellen auf dem Open-LLM-Leaderboard. Gemini 2.5 Pro interpretiert Bilder und Videos, erzeugt detaillierte, kontextbezogene Beschreibungen und beantwortet Fragen zu visuellen Inhalten.
Quelle: Google Gemini
Du kannst Gemini 2.5 Pro kostenlos über die Gemini-Web-App unter gemini.google.com/app oder mit Google AI Studio nutzen.
Für Entwickler ist Gemini 2.5 Pro außerdem über die Gemini API, Vertex AI und das offizielle Python-SDK verfügbar – so integrierst du VLM-Funktionen unkompliziert in eigene Anwendungen oder Workflows.
Beispiel:
from google.genai import types

with open('path/to/image.jpg', 'rb') as f:
      image_bytes = f.read()

  response = client.models.generate_content(
    model='gemini-2.5-pro',
    contents=[
      types.Part.from_bytes(
        data=image_bytes,
        mime_type='image/jpeg',
      ),
      'Explain the image.'
    ]
  )
print(response.text)InternVL3 ist eine fortschrittliche Reihe multimodaler Large Language Models (MLLMs) und übertrifft den Vorgänger InternVL 2.5. Es glänzt bei multimodaler Wahrnehmung und beim Schlussfolgern und bringt erweiterte Fähigkeiten mit – darunter Toolnutzung, GUI-Agents, industrielle Bildanalyse und 3D-Vision.
Das Modell InternVL3-78B nutzt speziell InternViT-6B-448px-V2_5 als Vision-Komponente und Qwen2.5-72B als Sprachkomponente. Mit insgesamt 78,41 Milliarden Parametern erreicht InternVL3-78B 72,2 Punkte im MMMU-Benchmark – ein neuer Open-Source-Stand der Technik unter MLLMs. Die Leistung ist mit führenden proprietären Modellen wettbewerbsfähig.
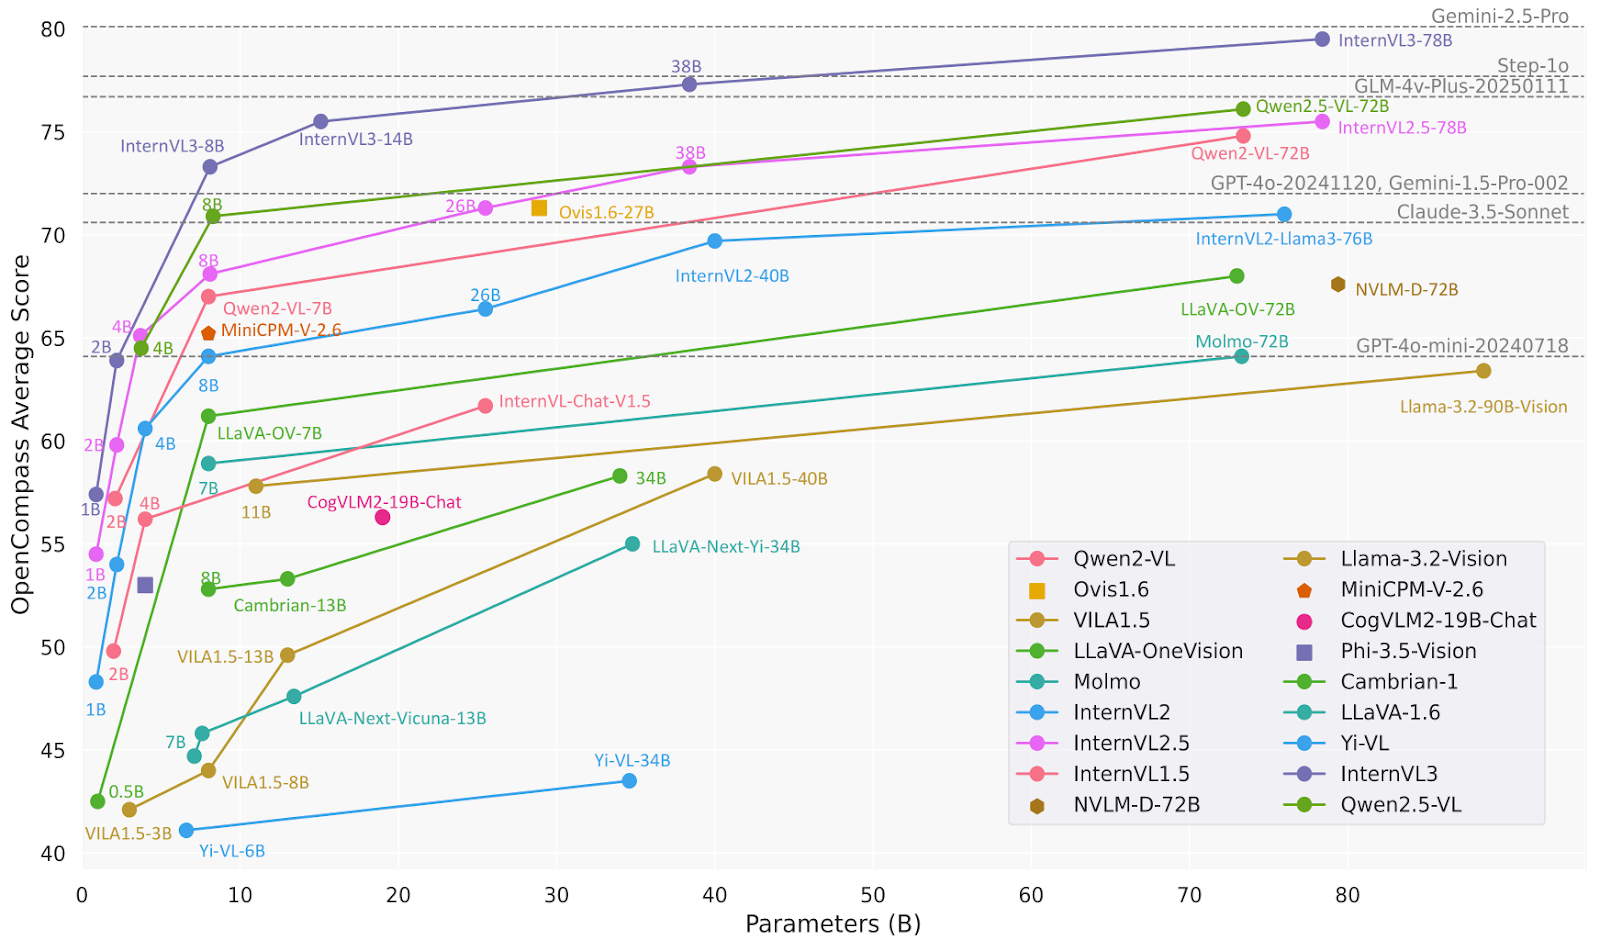
Quelle: OpenGVLab/InternVL3-78B · Hugging Face
Beispiel:
# pip install lmdeploy>=0.7.3
from lmdeploy import pipeline, TurbomindEngineConfig, ChatTemplateConfig
from lmdeploy.vl import load_image

model = 'OpenGVLab/InternVL3-78B'
image = load_image('https://raw.githubusercontent.com/open-mmlab/mmdeploy/main/tests/data/tiger.jpeg')
pipe = pipeline(model, backend_config=TurbomindEngineConfig(session_len=16384, tp=4), chat_template_config=ChatTemplateConfig(model_name='internvl2_5'))
response = pipe(('Explain the image.', image))
print(response.text)Ovis2 ist eine Reihe multimodaler Large Language Models (MLLMs) von AIDC-AI. Die Modelle sind darauf ausgelegt, visuelle und textuelle Embeddings effektiv zu alignen. Ovis2-34B setzt als Vision-Encoder aimv2-1B-patch14-448 und als Sprachmodell Qwen2.5-32B-Instruct ein – insgesamt 34 Milliarden Parameter. Es unterstützt eine maximale Kontextlänge von 32.768 Tokens und nutzt bfloat16 für effiziente Verarbeitung.
Ovis2-34B zeigt starke Ergebnisse in verschiedenen Benchmarks und erreicht unter anderem:
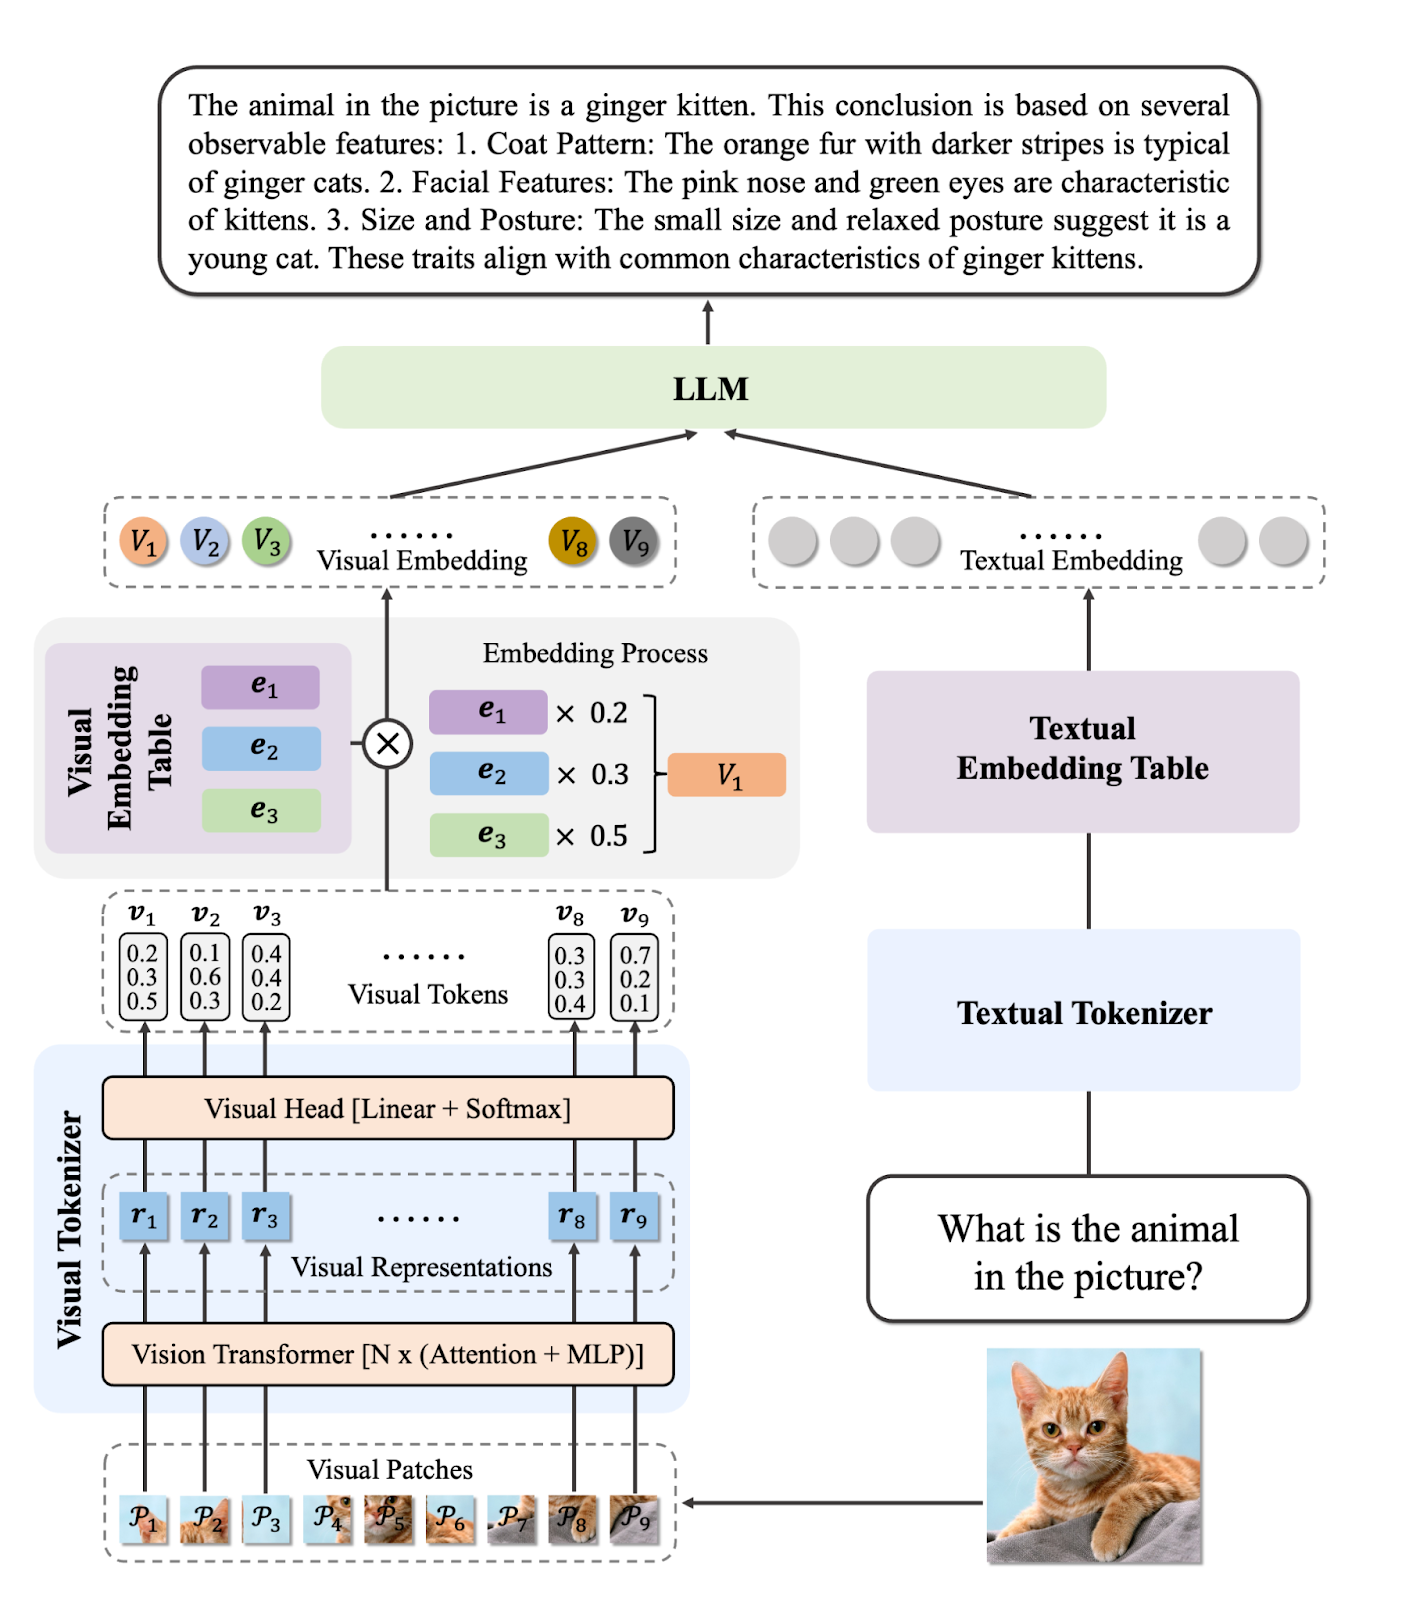
Quelle: AIDC-AI/Ovis2-34B · Hugging Face
Beispiel:
import torch
from PIL import Image
from transformers import AutoModelForCausalLM

# load model
model = AutoModelForCausalLM.from_pretrained("AIDC-AI/Ovis2-34B",
                                             torch_dtype=torch.bfloat16,
                                             multimodal_max_length=32768,
                                             trust_remote_code=True).cuda()
text_tokenizer = model.get_text_tokenizer()
visual_tokenizer = model.get_visual_tokenizer()

# single-image input
image_path = '/data/images/example_1.jpg'
images = [Image.open(image_path)]
max_partition = 9
text = 'Describe the image.'
query = f'<image>\n{text}'


# format conversation
prompt, input_ids, pixel_values = model.preprocess_inputs(query, images, max_partition=max_partition)
attention_mask = torch.ne(input_ids, text_tokenizer.pad_token_id)
input_ids = input_ids.unsqueeze(0).to(device=model.device)
attention_mask = attention_mask.unsqueeze(0).to(device=model.device)
if pixel_values is not None:
    pixel_values = pixel_values.to(dtype=visual_tokenizer.dtype, device=visual_tokenizer.device)
pixel_values = [pixel_values]

# generate output
with torch.inference_mode():
    gen_kwargs = dict(
        max_new_tokens=1024,
        do_sample=False,
        top_p=None,
        top_k=None,
        temperature=None,
        repetition_penalty=None,
        eos_token_id=model.generation_config.eos_token_id,
        pad_token_id=text_tokenizer.pad_token_id,
        use_cache=True
    )
    output_ids = model.generate(input_ids, pixel_values=pixel_values, attention_mask=attention_mask, **gen_kwargs)[0]
    output = text_tokenizer.decode(output_ids, skip_special_tokens=True)
print(f'Output:\n{output}')Qwen2.5-VL-72B-Instruct ist ein multimodales Large Language Model (MLLM) aus der Qwen-Familie, das visuelle und textuelle Informationen versteht und verarbeitet. Viele Open-Source-MLLMs bauen darauf auf – ein klarer Hinweis auf die Bedeutung der Qwen-Reihe für den KI-Fortschritt.
Qwen2.5-VL-72B-Instruct liefert starke Ergebnisse in diversen Benchmarks – von Bild- und Videoverständnis bis hin zu Agent-Funktionen. Es erzielt 70,2 Punkte bei MMMUval, 74,8 bei MathVista_MINI und 70,8 bei MMStar.
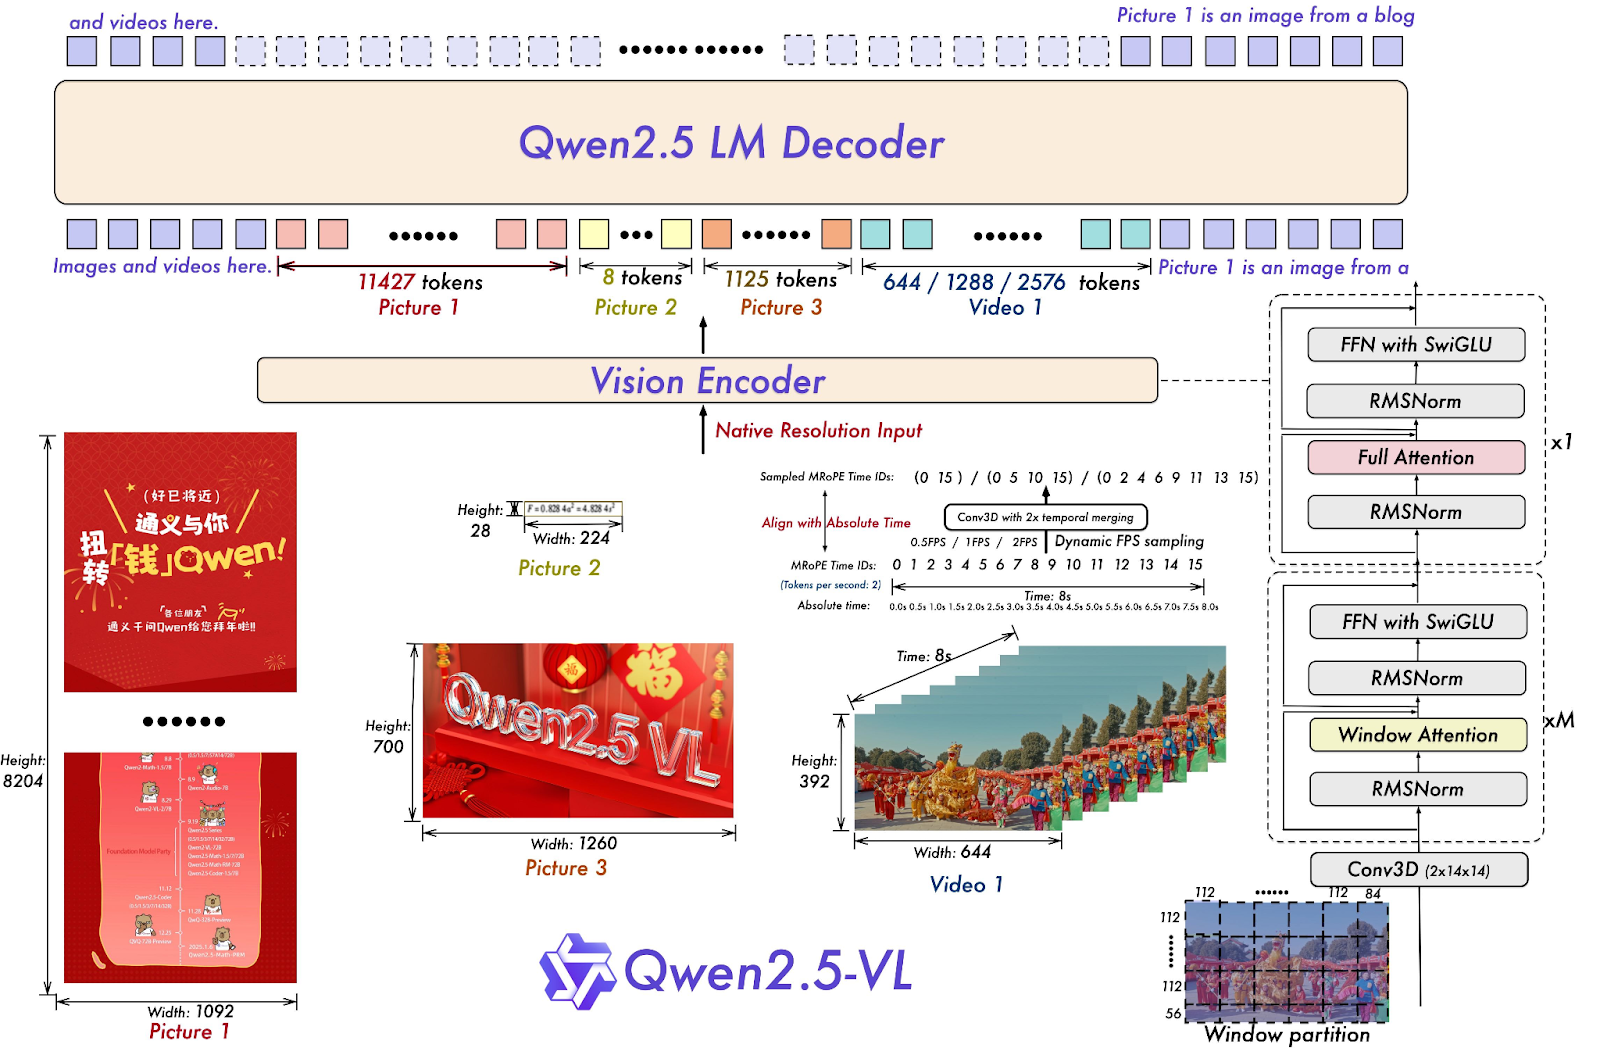
Quelle: Qwen/Qwen2.5-VL-72B-Instruct · Hugging Face
Beispiel:
# pip install qwen-vl-utils[decord]==0.0.8

from transformers import Qwen2_5_VLForConditionalGeneration, AutoTokenizer, AutoProcessor
from qwen_vl_utils import process_vision_info

# default: Load the model on the available device(s)
model = Qwen2_5_VLForConditionalGeneration.from_pretrained(
    "Qwen/Qwen2.5-VL-72B-Instruct", torch_dtype="auto", device_map="auto"
)
# default processer
processor = AutoProcessor.from_pretrained("Qwen/Qwen2.5-VL-72B-Instruct")


messages = [
    {
        "role": "user",
        "content": [
            {
                "type": "image",
                "image": "https://qianwen-res.oss-cn-beijing.aliyuncs.com/Qwen-VL/assets/demo.jpeg",
            },
            {"type": "text", "text": "Describe this image."},
        ],
    }
]

# Preparation for inference
text = processor.apply_chat_template(
    messages, tokenize=False, add_generation_prompt=True
)
image_inputs, video_inputs = process_vision_info(messages)
inputs = processor(
    text=[text],
    images=image_inputs,
    videos=video_inputs,
    padding=True,
    return_tensors="pt",
)
inputs = inputs.to("cuda")

# Inference: Generation of the output
generated_ids = model.generate(**inputs, max_new_tokens=128)
generated_ids_trimmed = [
    out_ids[len(in_ids) :] for in_ids, out_ids in zip(inputs.input_ids, generated_ids)
]
output_text = processor.batch_decode(
    generated_ids_trimmed, skip_special_tokens=True, clean_up_tokenization_spaces=False
)
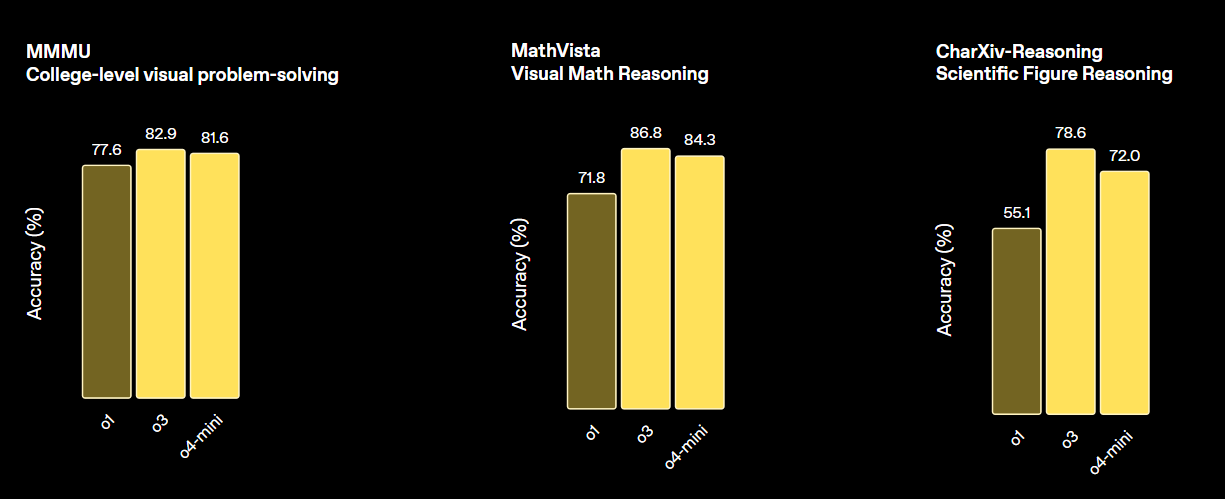
print(output_text)OpenAIs o3 ist ein neues Reasoning-Modell, das höhere Intelligenz, geringere Kosten und effizientere Token-Nutzung in Anwendungen bietet. Es steht für eine neue Generation von Modellen mit Fokus auf fortgeschrittenes Schlussfolgern.
Das Modell setzt neue Maßstäbe in Mathematik, Naturwissenschaften, Coding und visuellem Schlussfolgern. In diversen Vision-Benchmarks übertrifft es sowohl o4-min als auch o1 und liegt auf Augenhöhe mit o3 Pro.
Quelle: Introducing OpenAI o3 and o4-mini | OpenAI
Beispiel:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="o3-2025-04-16",
    input=[{
        "role": "user",
        "content": [
            {"type": "input_text", "text": "what's in this image?"},
            {
                "type": "input_image",
                "image_url": "https://upload.wikimedia.org/wikipedia/commons/thumb/d/dd/Gfp-wisconsin-madison-the-nature-boardwalk.jpg/2560px-Gfp-wisconsin-madison-the-nature-boardwalk.jpg",
            },
        ],
    }],
)

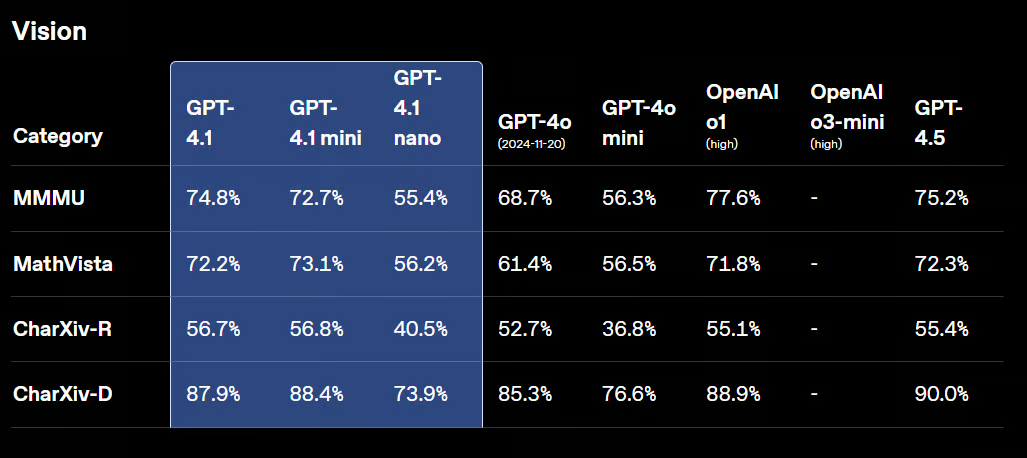
print(response.output_text)GPT-4.1 ist eine neue Familie von Non-Reasoning-Modellen, darunter GPT-4.1, GPT-4.1 Mini und GPT-4.1 Nano. Diese Modelle übertreffen GPT-4o und GPT-4o Mini in zahlreichen Benchmarks.
GPT-4.1 behält starke Vision-Fähigkeiten und wurde bei der Analyse von Charts, Diagrammen und visueller Mathematik verbessert. Es überzeugt bei Aufgaben wie Objektezählen, Visual Question Answering und verschiedenen Formen der Texterkennung (OCR).
Quelle: Introducing GPT-4.1 in the API | OpenAI
Beispiel:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-4.1-2025-04-14",
    input=[{
        "role": "user",
        "content": [
            {"type": "input_text", "text": "what's in this image?"},
            {
                "type": "input_image",
                "image_url": "https://upload.wikimedia.org/wikipedia/commons/thumb/d/dd/Gfp-wisconsin-madison-the-nature-boardwalk.jpg/2560px-Gfp-wisconsin-madison-the-nature-boardwalk.jpg",
            },
        ],
    }],
)

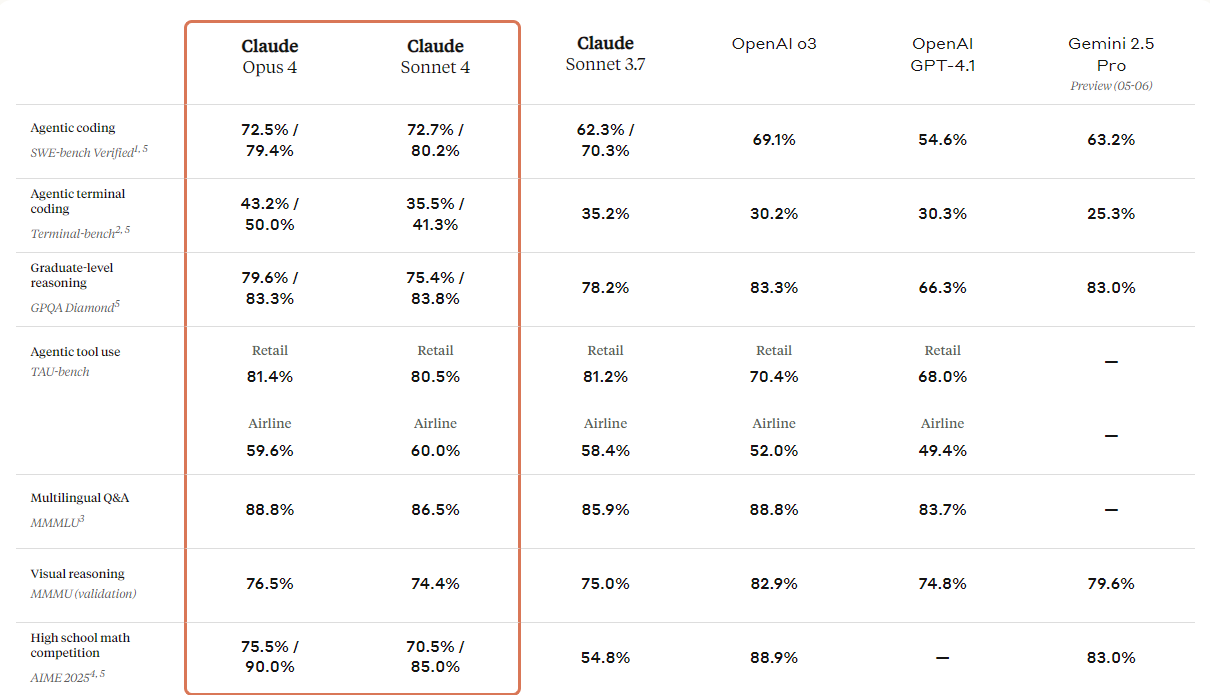
print(response.output_text)Anthropic hat die nächste Generation seiner Claude-Modelle vorgestellt: Claude 4 Opus und Claude 4 Sonnet. Diese Modelle setzen neue Maßstäbe beim Coden, beim fortgeschrittenen Reasoning und bei KI-Fähigkeiten.
Sie bringen verbesserte Vision-Fähigkeiten mit, um Bilder zu verstehen und darauf basierend Code zu generieren oder Informationen zu liefern. Obwohl es vor allem ein Coding-Modell ist, besitzt es multimodale Fähigkeiten und versteht verschiedene Dateiformate.
Ein Blick auf die Vergleichstabelle unten zeigt: Claude 4 übertrifft nahezu alle Topmodelle – mit Ausnahme von OpenAIs GPT-3 – insbesondere beim visuellen Schlussfolgern und beim Visual Question Answering.
Quelle: Introducing Claude 4 \ Anthropic
Beispiel:
import anthropic

client = anthropic.Anthropic()
message = client.messages.create(
    model="claude-sonnet-4-20250514",
    max_tokens=1024,
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image",
                    "source": {
                        "type": "url",
                        "url": "https://upload.wikimedia.org/wikipedia/commons/a/a7/Camponotus_flavomarginatus_ant.jpg",
                    },
                },
                {
                    "type": "text",
                    "text": "Describe this image."
                }
            ],
        }
    ],
)
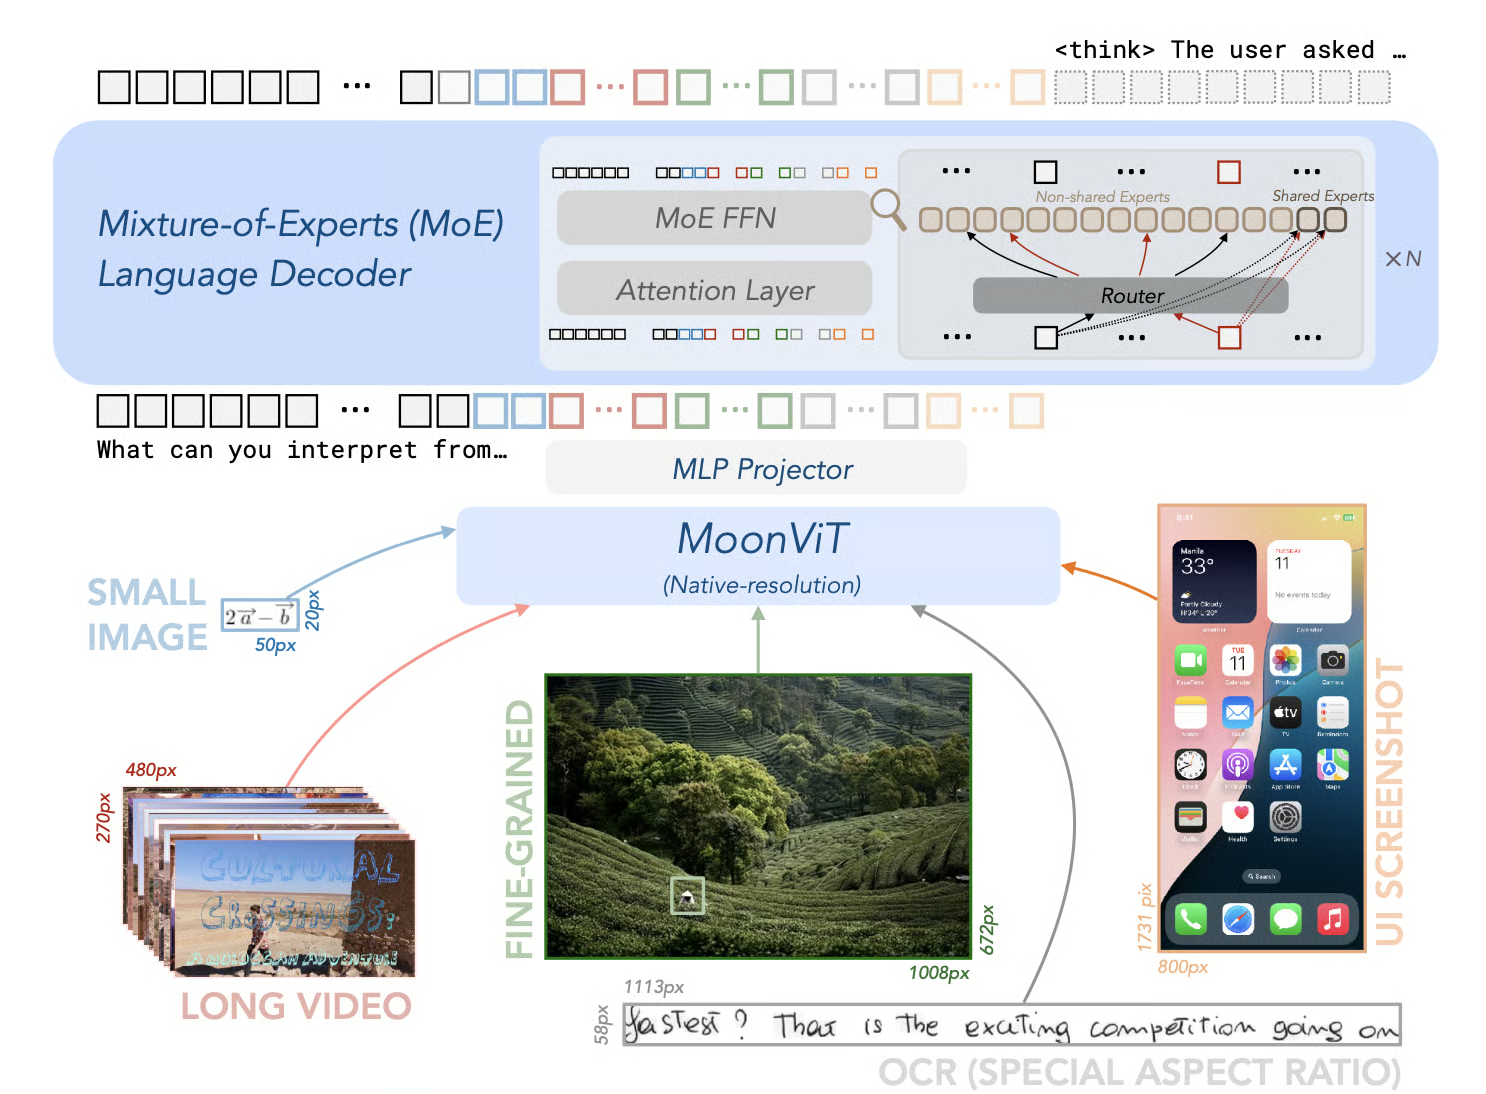
print(message)Kimi-VL-A3B-Thinking-2506 ist ein Open-Source-Modell und ein großer Schritt nach vorn für multimodale KI. Es überzeugt in Reasoning-Benchmarks mit starken Werten: 56,9 bei MathVision, 80,1 bei MathVista, 46,3 bei MMMU-Pro und 64,0 bei MMMU – bei im Schnitt 20% kürzerer "Thinking Length".
Neben dem Schlussfolgern bietet die Version 2506 eine verbesserte allgemeine visuelle Wahrnehmung und ein besseres Verständnis. Sie erreicht Werte auf oder über dem Niveau von Non-Thinking-Modellen, z. B. MMBench-EN-v1.1 (84,4), MMStar (70,4), RealWorldQA (70,0) und MMVet (78,4).
Quelle: MoonshotAI/Kimi-VL: Kimi-VL
Beispiel:
from transformers import AutoProcessor
from vllm import LLM, SamplingParams

model_path = "moonshotai/Kimi-VL-A3B-Thinking-2506"
llm = LLM(
    model_path,
    trust_remote_code=True,
    max_num_seqs=8,
    max_model_len=131072,
    limit_mm_per_prompt={"image": 256}
)

processor = AutoProcessor.from_pretrained(model_path, trust_remote_code=True)

sampling_params = SamplingParams(max_tokens=32768, temperature=0.8)


import requests
from PIL import Image

def extract_thinking_and_summary(text: str, bot: str = "◁think▷", eot: str = "◁/think▷") -> str:
    if bot in text and eot not in text:
        return ""
    if eot in text:
        return text[text.index(bot) + len(bot):text.index(eot)].strip(), text[text.index(eot) + len(eot) :].strip()
    return "", text

OUTPUT_FORMAT = "--------Thinking--------\n{thinking}\n\n--------Summary--------\n{summary}"

url = "https://huggingface.co/spaces/moonshotai/Kimi-VL-A3B-Thinking/resolve/main/images/demo6.jpeg"
image = Image.open(requests.get(url,stream=True).raw)

messages = [
    {"role": "user", "content": [{"type": "image", "image": ""}, {"type": "text", "text": "What kind of cat is this? Answer with one word."}]}
]
text = processor.apply_chat_template(messages, add_generation_prompt=True, return_tensors="pt")

outputs = llm.generate([{"prompt": text, "multi_modal_data": {"image": image}}], sampling_params=sampling_params)
generated_text = outputs[0].outputs[0].text

thinking, summary = extract_thinking_and_summary(generated_text)
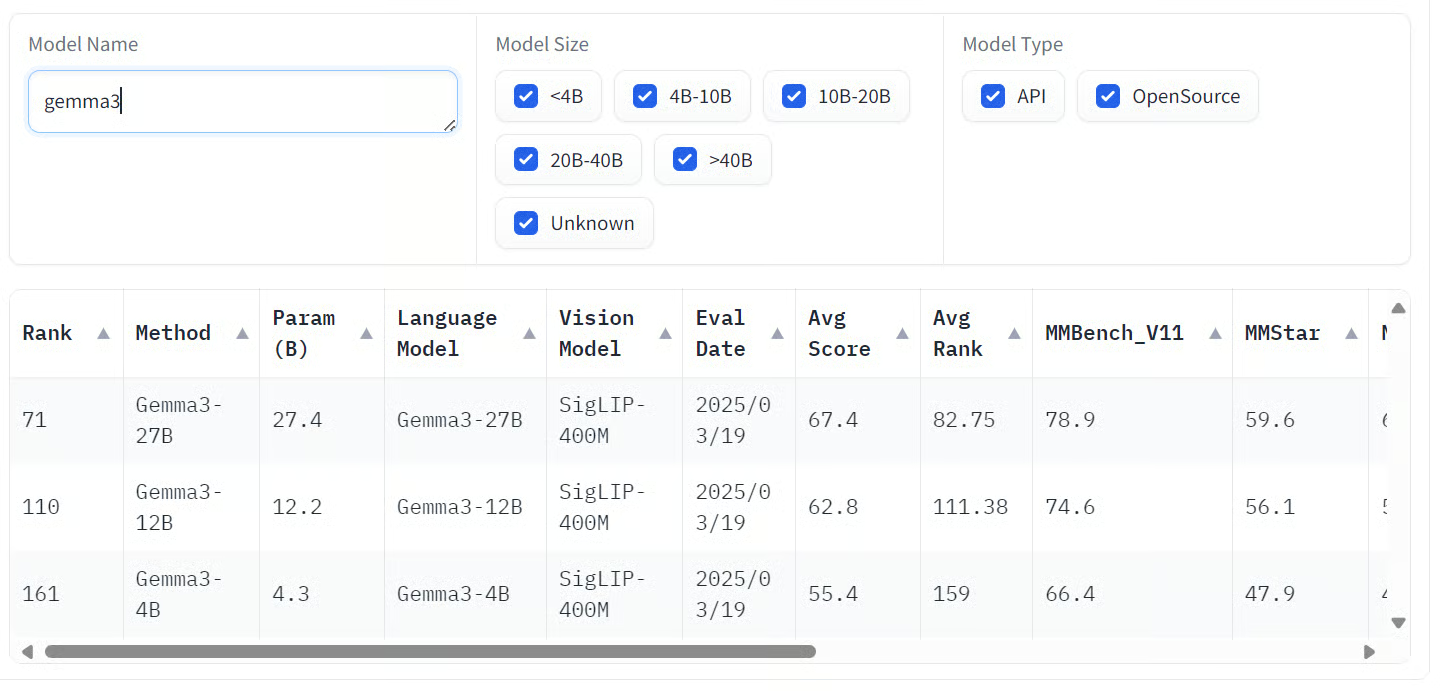
print(OUTPUT_FORMAT.format(thinking=thinking, summary=summary))Gemma 3 ist eine Familie multimodaler KI-Modelle von Google, die Text- und Bildeingaben verarbeiten und Textausgaben erzeugen. Es gibt sie in verschiedenen Größen – 1B, 4B, 12B und 27B – passend zu unterschiedlichen Hardware- und Performance-Anforderungen.
Die größte Variante, Gemma 3 27B, überzeugt in Human-Preference-Evaluierungen und übertrifft sogar größere Modelle wie Llama 3-405B und DeepSeek-V3.
Die Modelle zeigen starke Leistungen über viele Benchmarks hinweg. Besonders in multimodalen Aufgaben glänzen sie – etwa mit Topwerten bei COCOcap (116), DocVQA (85,6), MMMU (56,1) und VQAv2 (72,9).
Quelle: Open VLM Leaderboard
Beispiel:
# pip install accelerate

from transformers import AutoProcessor, Gemma3ForConditionalGeneration
from PIL import Image
import requests
import torch

model_id = "google/gemma-3-27b-it"

model = Gemma3ForConditionalGeneration.from_pretrained(
    model_id, device_map="auto"
).eval()

processor = AutoProcessor.from_pretrained(model_id)

messages = [
    {
        "role": "system",
        "content": [{"type": "text", "text": "You are a helpful assistant."}]
    },
    {
        "role": "user",
        "content": [
            {"type": "image", "image": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/bee.jpg"},
            {"type": "text", "text": "Describe this image in detail."}
        ]
    }
]

inputs = processor.apply_chat_template(
    messages, add_generation_prompt=True, tokenize=True,
    return_dict=True, return_tensors="pt"
).to(model.device, dtype=torch.bfloat16)

input_len = inputs["input_ids"].shape[-1]

with torch.inference_mode():
    generation = model.generate(**inputs, max_new_tokens=100, do_sample=False)
    generation = generation[0][input_len:]

decoded = processor.decode(generation, skip_special_tokens=True)
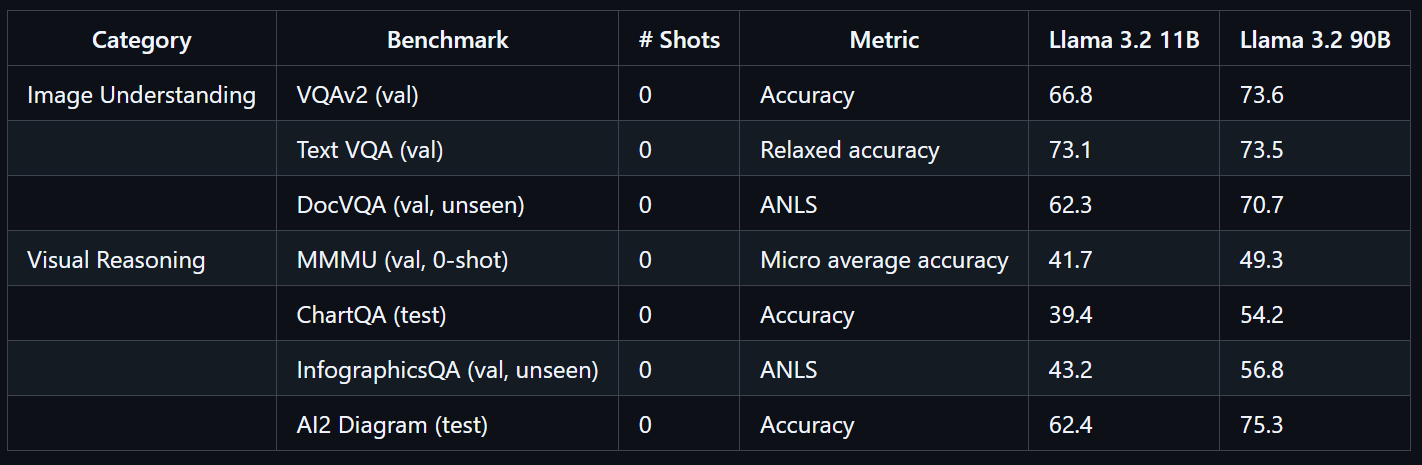
print(decoded)Das Llama 3.2 90B Vision Instruct-Modell ist ein fortschrittliches multimodales Large Language Model von Meta. Es wurde für visuelle Erkennung, Bild-Reasoning und Captioning entwickelt.
Llama 3.2 90B Vision Instruct basiert auf der textbasierten Llama-3.1-Version und integriert einen separat trainierten Vision-Adapter. Dadurch kann es Bild- und Texteingaben verarbeiten und präzise Textausgaben erzeugen.
Das Training erfolgte im großen Maßstab und benötigte 8,85 Millionen GPU-Stunden. Das Modell liefert Topresultate in Benchmarks wie VQAv2 (73,6), Text VQA (73,5) und DocVQA (70,7).
Quelle: llama-models
Beispiel:
import requests
import torch
from PIL import Image
from transformers import MllamaForConditionalGeneration, AutoProcessor

model_id = "meta-llama/Llama-3.2-90B-Vision-Instruct"

model = MllamaForConditionalGeneration.from_pretrained(
    model_id,
    torch_dtype=torch.bfloat16,
    device_map="auto",
)
processor = AutoProcessor.from_pretrained(model_id)

url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/0052a70beed5bf71b92610a43a52df6d286cd5f3/diffusers/rabbit.jpg"
image = Image.open(requests.get(url, stream=True).raw)

messages = [
    {"role": "user", "content": [
        {"type": "image"},
        {"type": "text", "text": "If I had to write a haiku for this one, it would be: "}
    ]}
]
input_text = processor.apply_chat_template(messages, add_generation_prompt=True)
inputs = processor(
    image,
    input_text,
    add_special_tokens=False,
    return_tensors="pt",
).to(model.device)

output = model.generate(**inputs, max_new_tokens=30)
print(processor.decode(output[0]))
Visuelles Schlussfolgern mit Diagrammen ist auch die Stärke von Metas neuestem Modell, Muse Spark.
Vision-Language-Modelle verändern grundlegend, wie wir mit visuellen und textuellen Informationen arbeiten. Sie liefern beeindruckende Genauigkeit und Flexibilität über zahlreiche Branchen hinweg. Durch die nahtlose Verbindung von Computer Vision und Natural Language Processing entstehen neue Anwendungen – von fortgeschrittener Objekterkennung bis zu intuitiven visuellen Assistenten.
Wenn Datenschutz und Sicherheit für deinen Use Case an erster Stelle stehen, lohnt sich ein Blick auf Open-Source-Vision-Language-Modelle. Der lokale Betrieb gibt dir volle Kontrolle über deine Daten – ideal für sensible Umgebungen. Open-Source-VLMs sind zudem sehr anpassbar; oft reichen ein paar hundert Beispiele für Fine-Tuning, um hervorragende, auf deinen Bedarf zugeschnittene Ergebnisse zu erzielen.
Proprietäre Modelle wiederum bieten verlässlichen, kosteneffizienten Zugang zum Stand der Technik. Sie sind meist sehr präzise und lassen sich mit wenigen Zeilen Code in Workflows integrieren – auch ohne tiefe KI-Expertise im Team.
Wenn du tiefer in Vision-Language-Modelle einsteigen willst, empfehlen wir diese Ressourcen:
Top-DataCamp-Kurse
Kurs
Kurs
Lernpfad
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Blog
Zoumana Keita
15 Min.
Blog
Matt Crabtree
14 Min.
Blog
Nathaniel Taylor-Leach
8 Min.
Tutorial
Matt Crabtree
5 Min.


