Curso
Procesamiento de Imágenes en Python
4 h
56.8K
Los Vision Language Models (VLMs) están transformando sectores a gran velocidad al permitir que los sistemas de IA comprendan y razonen sobre imágenes y texto. A diferencia de los modelos tradicionales de visión por computador, los VLM modernos interpretan imágenes complejas, responden preguntas detalladas sobre contenido visual e incluso procesan vídeos y documentos con texto incrustado.
Esta capacidad los hace imprescindibles en diagnóstico médico, control de calidad automatizado y aplicaciones sensibles donde la precisión pesa más que la velocidad.
En este artículo revisamos los mejores modelos visión‑lenguaje de 2026, incluyendo opciones open source y propietarias. Destacaremos sus capacidades únicas y presentaremos su rendimiento y resultados en benchmarks. Para desarrolladores e investigadores, también incluimos fragmentos de código para que puedas probarlos rápidamente.
Si quieres profundizar en los fundamentos de estos modelos, no te pierdas nuestro itinerario Image Processing in Python.
Gemini 2.5 Pro es el modelo de IA más avanzado de Google y actualmente lidera los rankings de LMArena y WebDevArena en tareas de visión y de código. Está diseñado para razonamiento complejo y comprensión de texto, imágenes, audio y vídeo.
En capacidades visión‑lenguaje, figura entre los mejores modelos del Open LLM leaderboard. Gemini 2.5 Pro interpreta imágenes y vídeos, y genera descripciones detalladas y con contexto mientras responde preguntas sobre el contenido visual.
Fuente: Google Gemini
Puedes acceder gratis a Gemini 2.5 Pro en la web de Gemini en gemini.google.com/app o usando Google AI Studio.
Para desarrolladores, Gemini 2.5 Pro también está disponible vía la API de Gemini, Vertex AI y el SDK oficial de Python, lo que facilita integrar sus funciones visión‑lenguaje en tus aplicaciones o flujos de trabajo.
Ejemplo de uso:
from google.genai import types

with open('path/to/image.jpg', 'rb') as f:
      image_bytes = f.read()

  response = client.models.generate_content(
    model='gemini-2.5-pro',
    contents=[
      types.Part.from_bytes(
        data=image_bytes,
        mime_type='image/jpeg',
      ),
      'Explain the image.'
    ]
  )
print(response.text)InternVL3 es una serie avanzada de modelos multimodales de lenguaje (MLLM) que supera a su predecesor, InternVL 2.5. Destaca en percepción y razonamiento multimodal y añade capacidades como uso de herramientas, agentes de interfaz (GUI), análisis de imágenes industriales y percepción 3D.
Concretamente, el modelo InternVL3-78B usa InternViT-6B-448px-V2_5 como componente de visión y Qwen2.5-72B como componente de lenguaje. Con 78,41 mil millones de parámetros, ha logrado 72,2 en el benchmark MMMU, marcando un nuevo estado del arte entre los MLLM open source. Su rendimiento compite con los principales modelos propietarios.
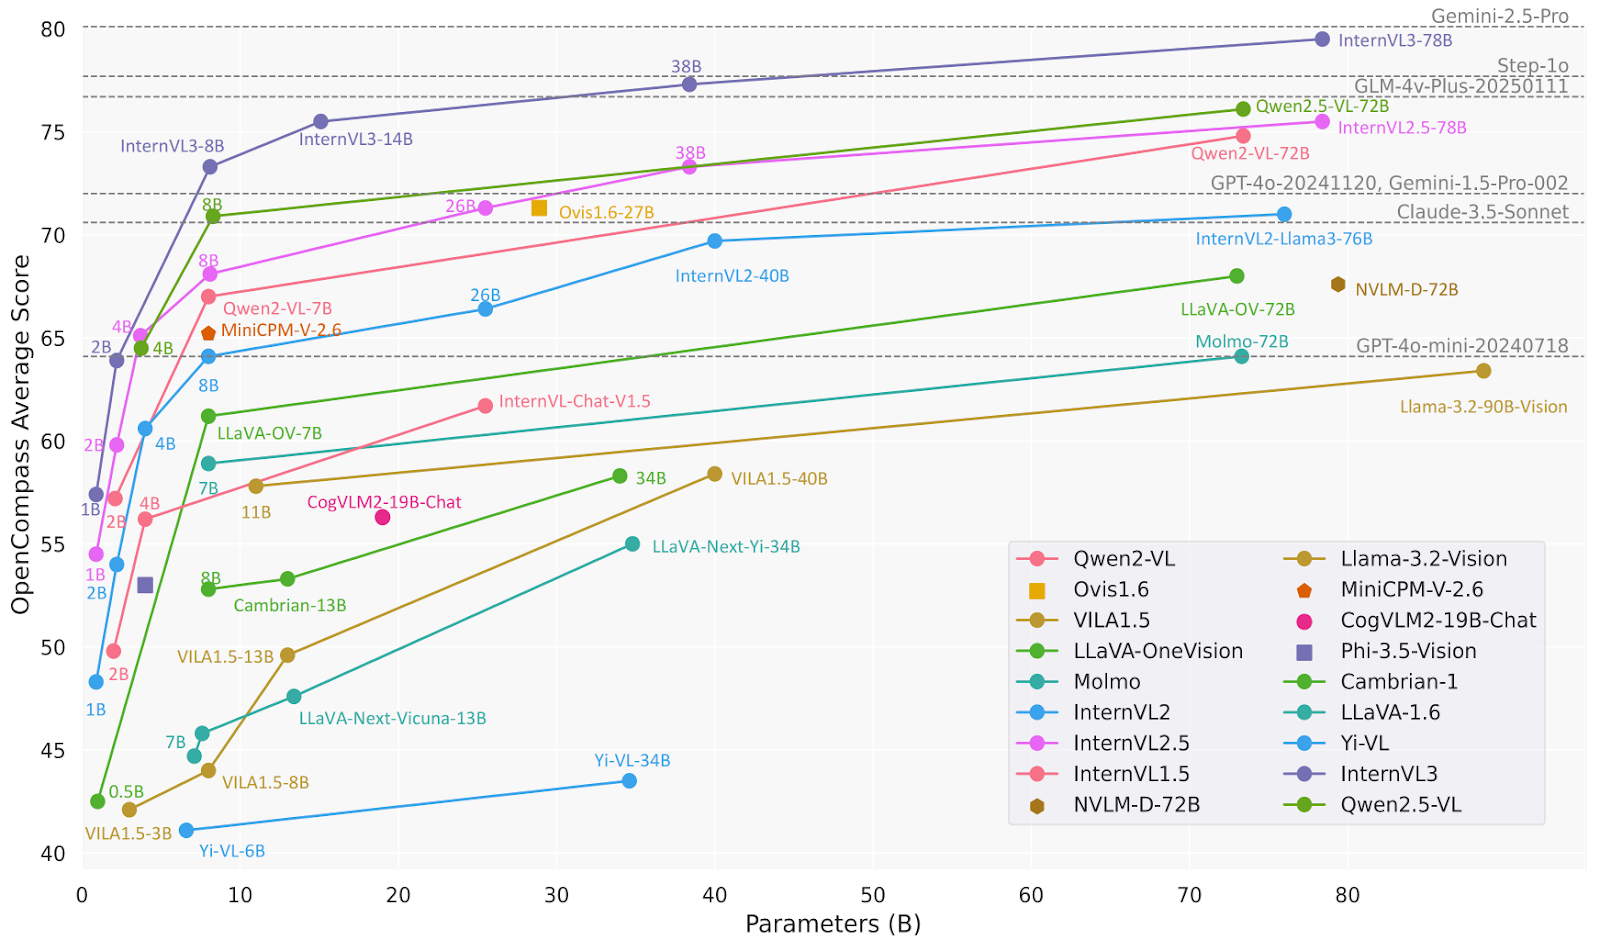
Fuente: OpenGVLab/InternVL3-78B · Hugging Face
Ejemplo de uso:
# pip install lmdeploy>=0.7.3
from lmdeploy import pipeline, TurbomindEngineConfig, ChatTemplateConfig
from lmdeploy.vl import load_image

model = 'OpenGVLab/InternVL3-78B'
image = load_image('https://raw.githubusercontent.com/open-mmlab/mmdeploy/main/tests/data/tiger.jpeg')
pipe = pipeline(model, backend_config=TurbomindEngineConfig(session_len=16384, tp=4), chat_template_config=ChatTemplateConfig(model_name='internvl2_5'))
response = pipe(('Explain the image.', image))
print(response.text)Ovis2 es una serie de modelos multimodales de lenguaje (MLLM) desarrollados por AIDC-AI. Están diseñados para alinear de forma eficaz los embeddings visuales y textuales. El modelo Ovis2-34B, en particular, utiliza aimv2-1B-patch14-448 como codificador de visión y Qwen2.5-32B-Instruct como modelo de lenguaje, sumando 34 mil millones de parámetros. Admite una longitud de contexto máxima de 32.768 tokens y usa precisión bfloat16 para un procesamiento eficiente.
Ovis2-34B ha mostrado un rendimiento sólido en varios benchmarks, con estos resultados:
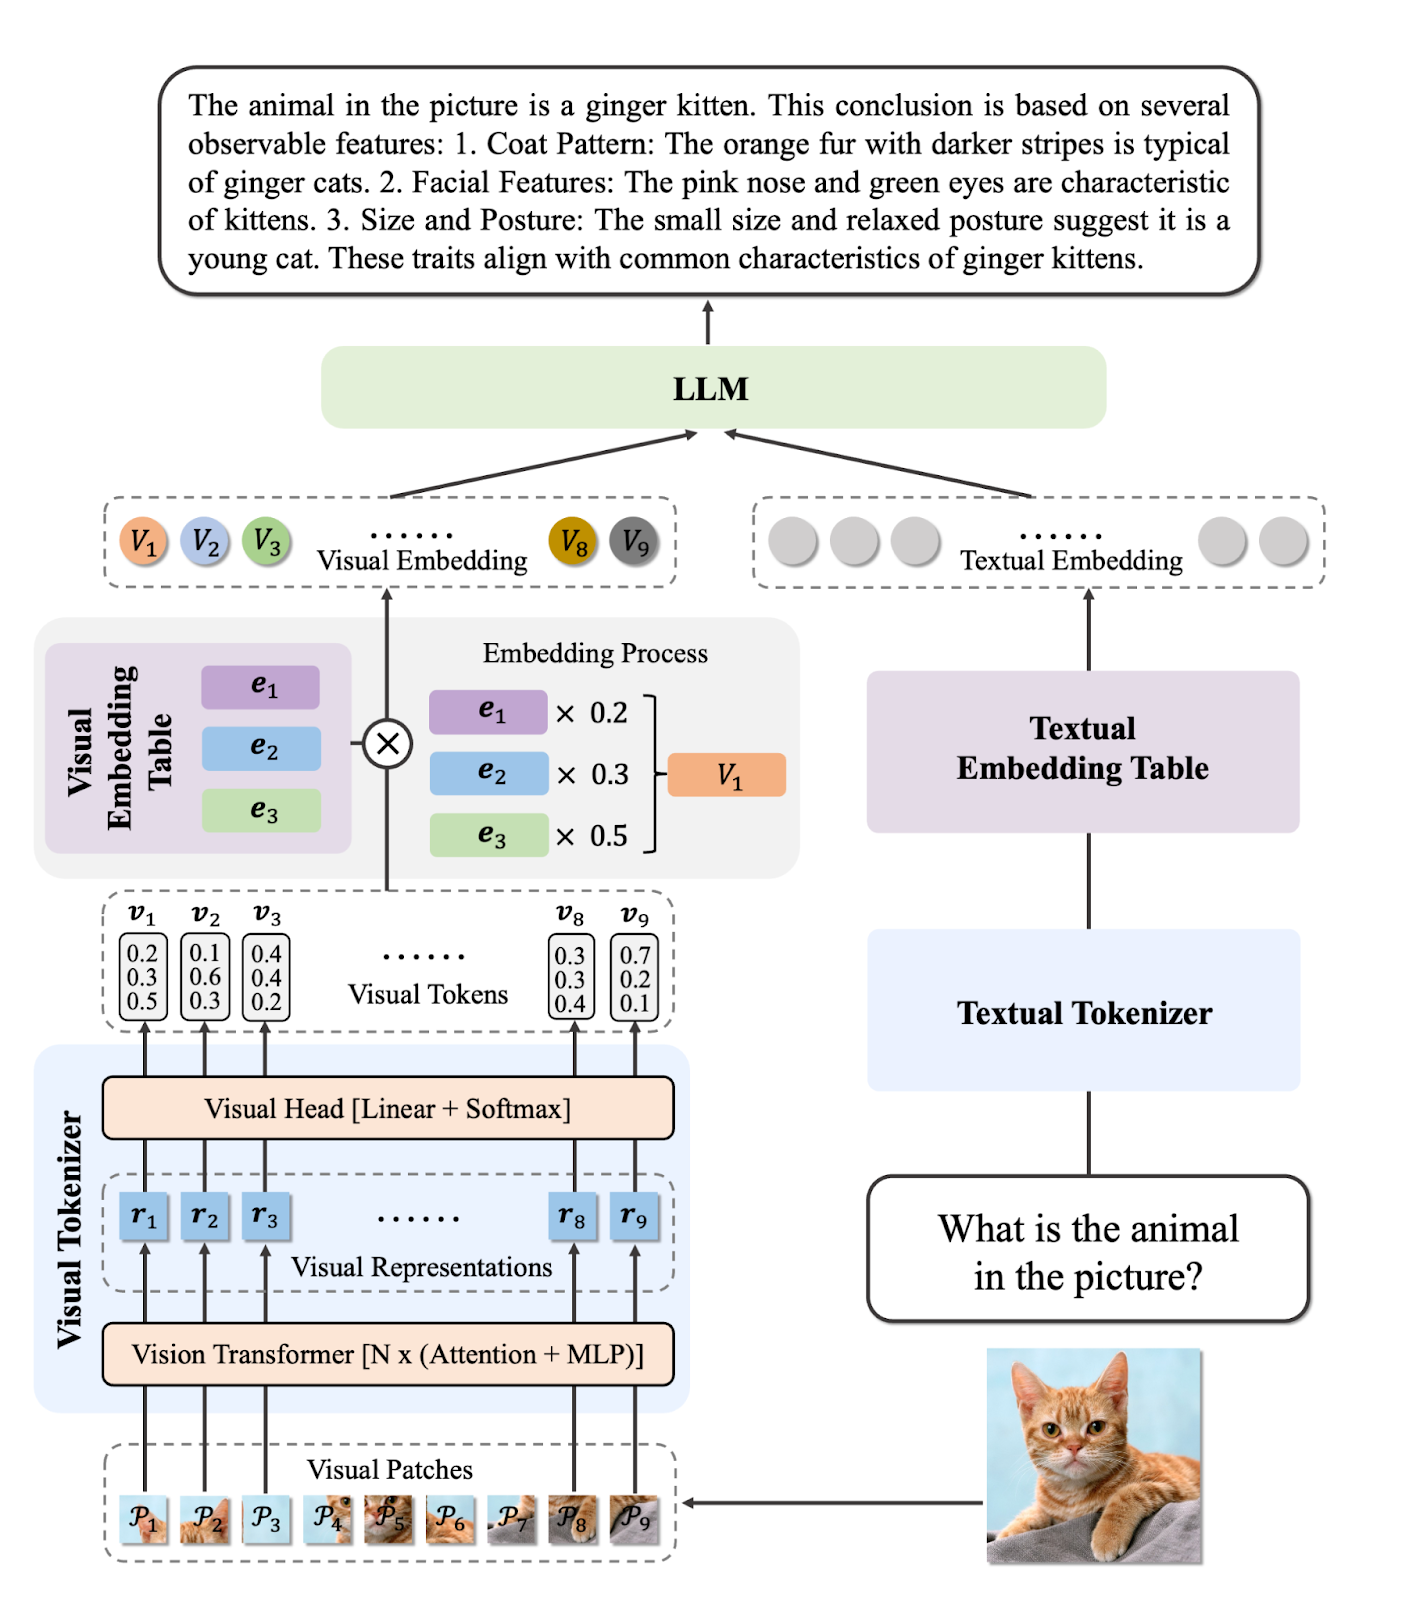
Fuente: AIDC-AI/Ovis2-34B · Hugging Face
Ejemplo de uso:
import torch
from PIL import Image
from transformers import AutoModelForCausalLM

# load model
model = AutoModelForCausalLM.from_pretrained("AIDC-AI/Ovis2-34B",
                                             torch_dtype=torch.bfloat16,
                                             multimodal_max_length=32768,
                                             trust_remote_code=True).cuda()
text_tokenizer = model.get_text_tokenizer()
visual_tokenizer = model.get_visual_tokenizer()

# single-image input
image_path = '/data/images/example_1.jpg'
images = [Image.open(image_path)]
max_partition = 9
text = 'Describe the image.'
query = f'<image>\n{text}'


# format conversation
prompt, input_ids, pixel_values = model.preprocess_inputs(query, images, max_partition=max_partition)
attention_mask = torch.ne(input_ids, text_tokenizer.pad_token_id)
input_ids = input_ids.unsqueeze(0).to(device=model.device)
attention_mask = attention_mask.unsqueeze(0).to(device=model.device)
if pixel_values is not None:
    pixel_values = pixel_values.to(dtype=visual_tokenizer.dtype, device=visual_tokenizer.device)
pixel_values = [pixel_values]

# generate output
with torch.inference_mode():
    gen_kwargs = dict(
        max_new_tokens=1024,
        do_sample=False,
        top_p=None,
        top_k=None,
        temperature=None,
        repetition_penalty=None,
        eos_token_id=model.generation_config.eos_token_id,
        pad_token_id=text_tokenizer.pad_token_id,
        use_cache=True
    )
    output_ids = model.generate(input_ids, pixel_values=pixel_values, attention_mask=attention_mask, **gen_kwargs)[0]
    output = text_tokenizer.decode(output_ids, skip_special_tokens=True)
print(f'Output:\n{output}')Qwen2.5-VL-72B-Instruct es un modelo multimodal de la familia Qwen, diseñado para comprender y procesar información visual y textual. Muchos MLLM open source se basan en él, señal de que la serie Qwen juega un papel clave en el avance de la investigación en IA.
Qwen2.5-VL-72B-Instruct muestra un rendimiento sólido en diversos benchmarks, tanto en comprensión de imágenes y vídeo como en funciones de agente. Obtiene 70,2 en MMMUval, 74,8 en MathVista_MINI y 70,8 en MMStar.
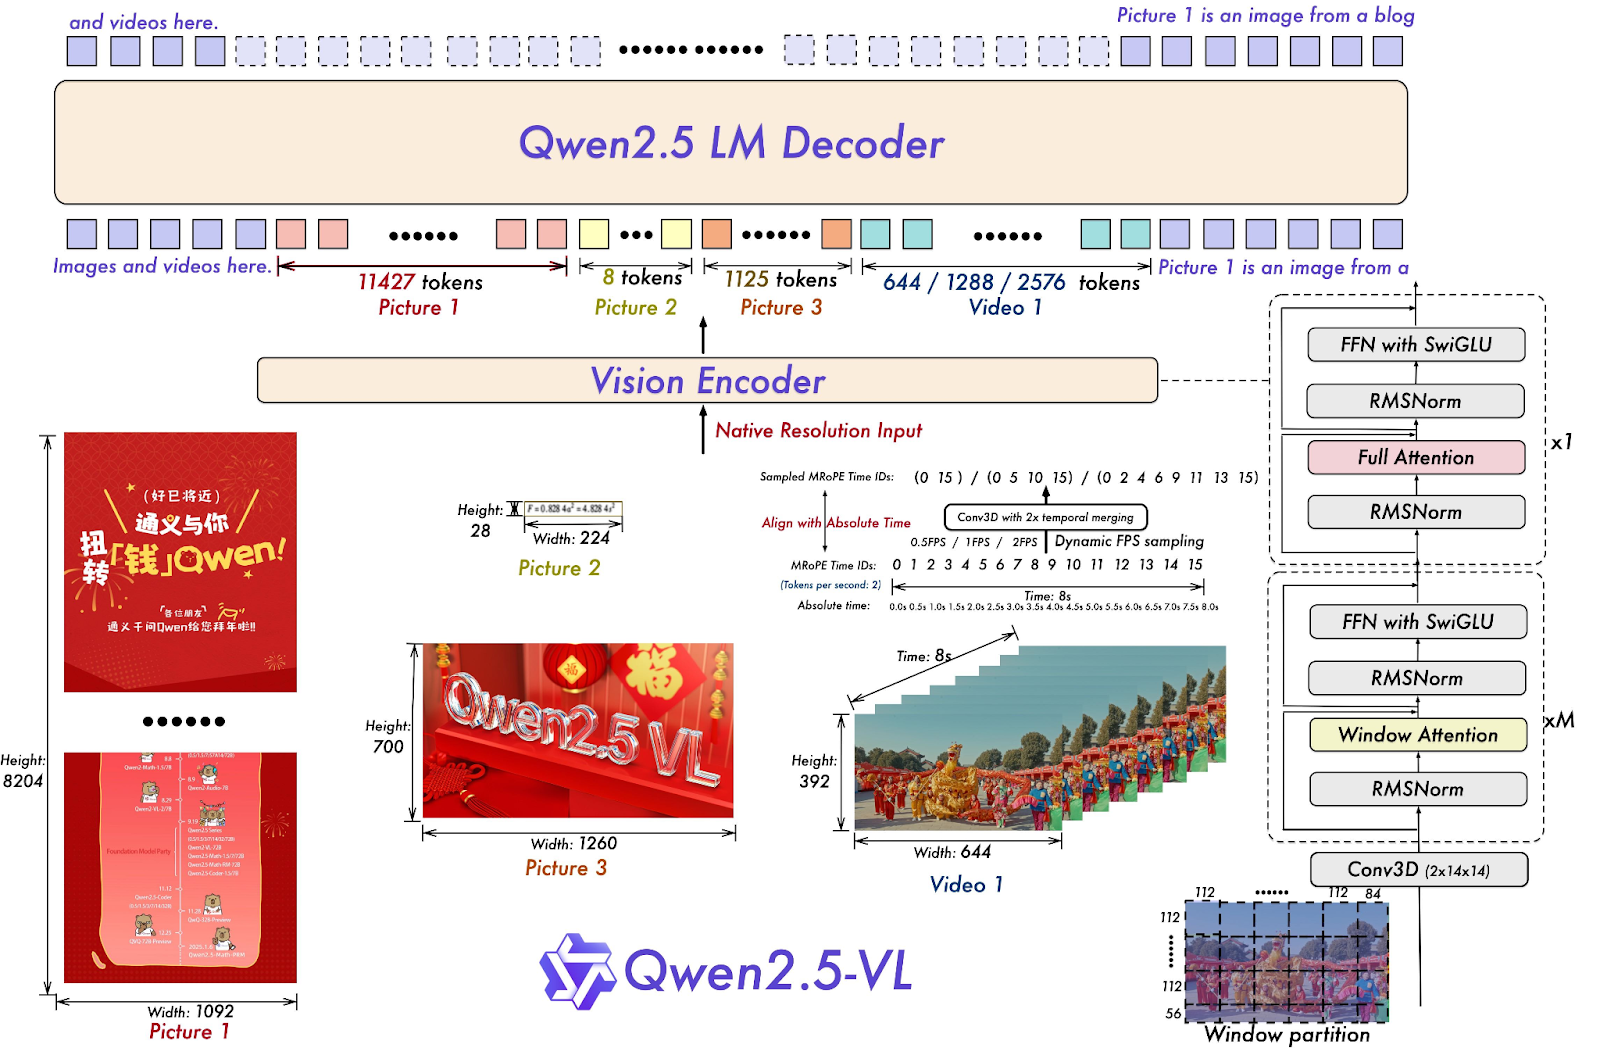
Fuente: Qwen/Qwen2.5-VL-72B-Instruct · Hugging Face
Ejemplo de uso:
# pip install qwen-vl-utils[decord]==0.0.8

from transformers import Qwen2_5_VLForConditionalGeneration, AutoTokenizer, AutoProcessor
from qwen_vl_utils import process_vision_info

# default: Load the model on the available device(s)
model = Qwen2_5_VLForConditionalGeneration.from_pretrained(
    "Qwen/Qwen2.5-VL-72B-Instruct", torch_dtype="auto", device_map="auto"
)
# default processer
processor = AutoProcessor.from_pretrained("Qwen/Qwen2.5-VL-72B-Instruct")


messages = [
    {
        "role": "user",
        "content": [
            {
                "type": "image",
                "image": "https://qianwen-res.oss-cn-beijing.aliyuncs.com/Qwen-VL/assets/demo.jpeg",
            },
            {"type": "text", "text": "Describe this image."},
        ],
    }
]

# Preparation for inference
text = processor.apply_chat_template(
    messages, tokenize=False, add_generation_prompt=True
)
image_inputs, video_inputs = process_vision_info(messages)
inputs = processor(
    text=[text],
    images=image_inputs,
    videos=video_inputs,
    padding=True,
    return_tensors="pt",
)
inputs = inputs.to("cuda")

# Inference: Generation of the output
generated_ids = model.generate(**inputs, max_new_tokens=128)
generated_ids_trimmed = [
    out_ids[len(in_ids) :] for in_ids, out_ids in zip(inputs.input_ids, generated_ids)
]
output_text = processor.batch_decode(
    generated_ids_trimmed, skip_special_tokens=True, clean_up_tokenization_spaces=False
)
print(output_text)o3 de OpenAI es un nuevo modelo de razonamiento pensado para aportar más inteligencia, menores costes y un uso más eficiente de tokens en aplicaciones. Representa una nueva generación de modelos que priorizan el razonamiento avanzado.
Establece un nuevo estándar en tareas de matemáticas, ciencia, programación y razonamiento visual. En varios benchmarks de visión, supera a o4-min y o1, y está a la par de o3 Pro.
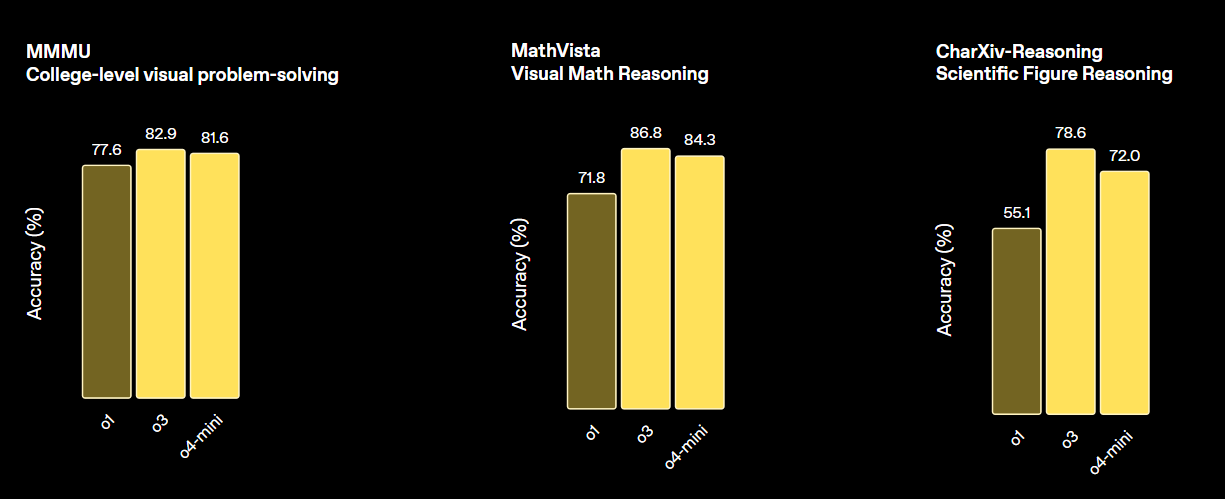
Fuente: Introducing OpenAI o3 and o4-mini | OpenAI
Ejemplo de uso:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="o3-2025-04-16",
    input=[{
        "role": "user",
        "content": [
            {"type": "input_text", "text": "what's in this image?"},
            {
                "type": "input_image",
                "image_url": "https://upload.wikimedia.org/wikipedia/commons/thumb/d/dd/Gfp-wisconsin-madison-the-nature-boardwalk.jpg/2560px-Gfp-wisconsin-madison-the-nature-boardwalk.jpg",
            },
        ],
    }],
)

print(response.output_text)GPT-4.1 es una nueva familia de modelos sin razonamiento explícito, que incluye GPT-4.1, GPT-4.1 Mini y GPT-4.1 Nano. Superan a sus predecesores, GPT-4o y GPT-4o Mini, en varios benchmarks.
GPT-4.1 mantiene capacidades de visión sólidas, con mejoras al analizar gráficos, diagramas y matemáticas visuales. Destaca en tareas como conteo de objetos, preguntas y respuestas visuales y distintas formas de OCR.
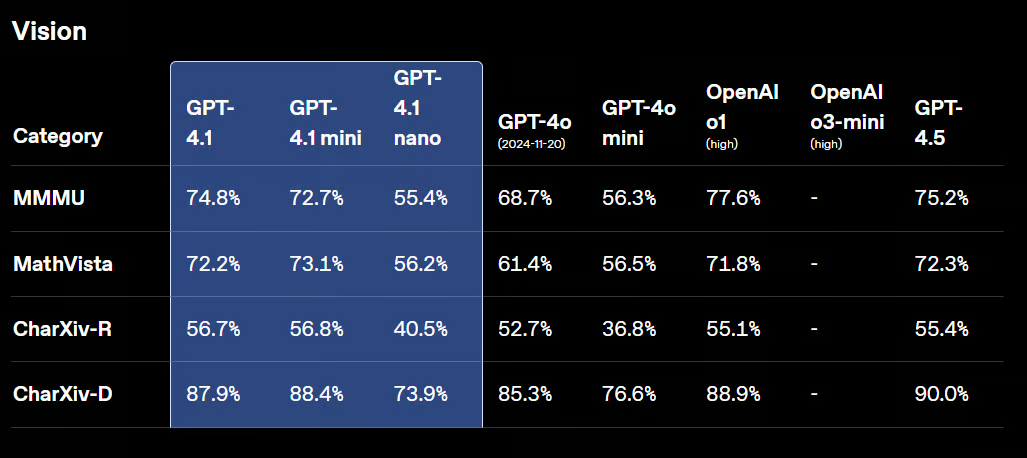
Fuente: Introducing GPT-4.1 in the API | OpenAI
Ejemplo de uso:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-4.1-2025-04-14",
    input=[{
        "role": "user",
        "content": [
            {"type": "input_text", "text": "what's in this image?"},
            {
                "type": "input_image",
                "image_url": "https://upload.wikimedia.org/wikipedia/commons/thumb/d/dd/Gfp-wisconsin-madison-the-nature-boardwalk.jpg/2560px-Gfp-wisconsin-madison-the-nature-boardwalk.jpg",
            },
        ],
    }],
)

print(response.output_text)Anthropic ha presentado la siguiente generación de sus modelos Claude: Claude 4 Opus y Claude 4 Sonnet. Estos modelos aspiran a marcar nuevas referencias en programación, razonamiento avanzado y capacidades de IA.
Llegan con mejoras en visión que permiten comprender imágenes y luego generar código o aportar información a partir de ellas. Aunque su base es la programación, también son multimodales y entienden distintos tipos de formatos de archivo.
Si revisas la tabla comparativa inferior, verás que Claude 4 supera a casi todos los modelos punteros, salvo el modelo GPT‑3 de OpenAI, especialmente en razonamiento sobre visualizaciones y preguntas y respuestas visuales.
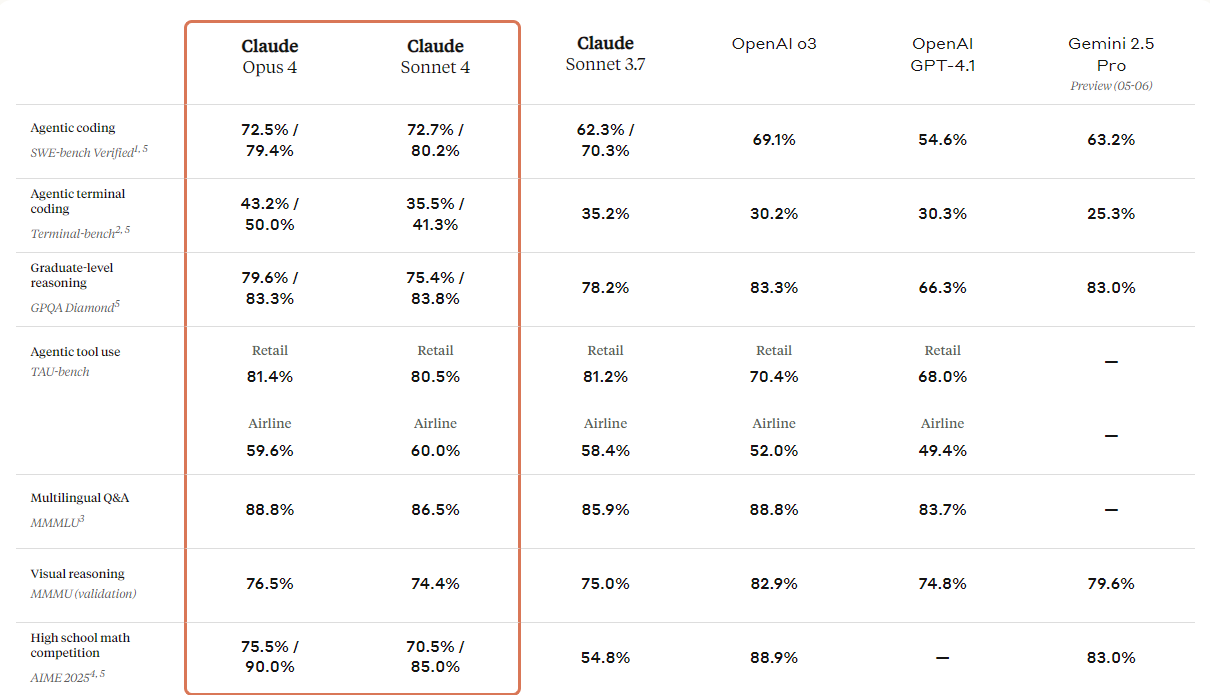
Fuente: Introducing Claude 4 \ Anthropic
Ejemplo de uso:
import anthropic

client = anthropic.Anthropic()
message = client.messages.create(
    model="claude-sonnet-4-20250514",
    max_tokens=1024,
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image",
                    "source": {
                        "type": "url",
                        "url": "https://upload.wikimedia.org/wikipedia/commons/a/a7/Camponotus_flavomarginatus_ant.jpg",
                    },
                },
                {
                    "type": "text",
                    "text": "Describe this image."
                }
            ],
        }
    ],
)
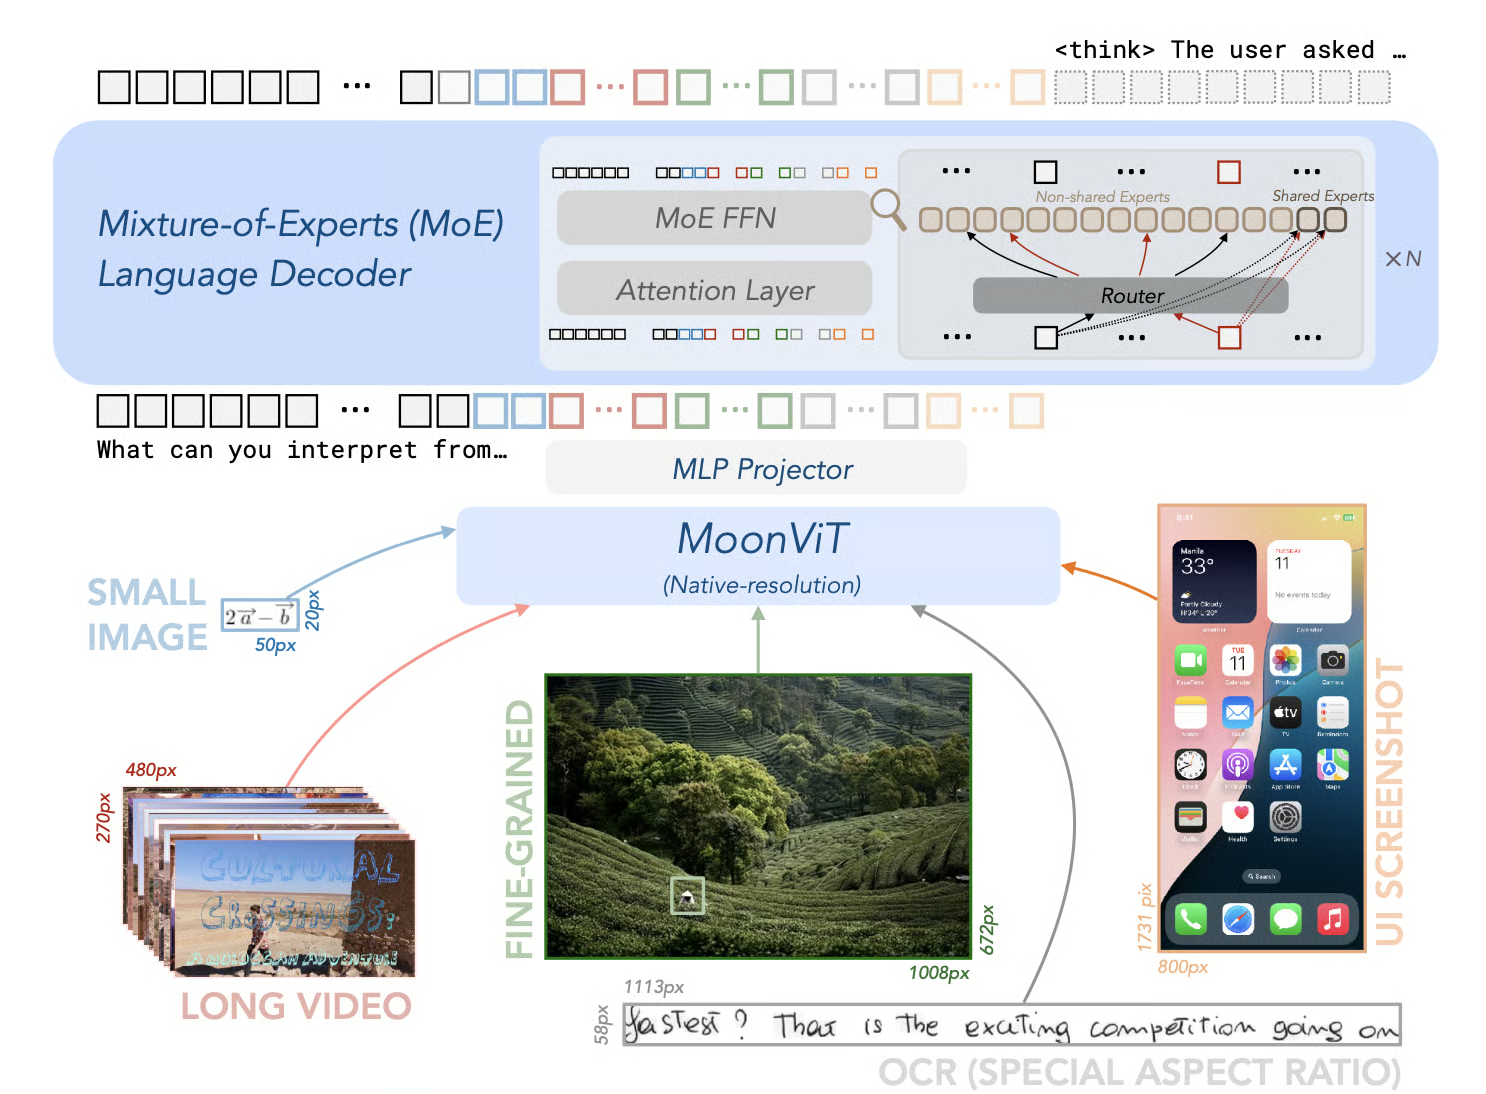
print(message)Kimi-VL-A3B-Thinking-2506 es un modelo open source que supone un avance importante en IA multimodal. Destaca en benchmarks de razonamiento multimodal, con puntuaciones notables: 56,9 en MathVision, 80,1 en MathVista, 46,3 en MMMU-Pro y 64,0 en MMMU, reduciendo además su "thinking length" un 20% de media.
Además del razonamiento, la versión 2506 mejora la percepción y comprensión visual general. Iguala o supera a modelos sin razonamiento en benchmarks como MMBench-EN-v1.1 (84,4), MMStar (70,4), RealWorldQA (70,0) y MMVet (78,4).
Fuente: MoonshotAI/Kimi-VL: Kimi-VL
Ejemplo de uso:
from transformers import AutoProcessor
from vllm import LLM, SamplingParams

model_path = "moonshotai/Kimi-VL-A3B-Thinking-2506"
llm = LLM(
    model_path,
    trust_remote_code=True,
    max_num_seqs=8,
    max_model_len=131072,
    limit_mm_per_prompt={"image": 256}
)

processor = AutoProcessor.from_pretrained(model_path, trust_remote_code=True)

sampling_params = SamplingParams(max_tokens=32768, temperature=0.8)


import requests
from PIL import Image

def extract_thinking_and_summary(text: str, bot: str = "◁think▷", eot: str = "◁/think▷") -> str:
    if bot in text and eot not in text:
        return ""
    if eot in text:
        return text[text.index(bot) + len(bot):text.index(eot)].strip(), text[text.index(eot) + len(eot) :].strip()
    return "", text

OUTPUT_FORMAT = "--------Thinking--------\n{thinking}\n\n--------Summary--------\n{summary}"

url = "https://huggingface.co/spaces/moonshotai/Kimi-VL-A3B-Thinking/resolve/main/images/demo6.jpeg"
image = Image.open(requests.get(url,stream=True).raw)

messages = [
    {"role": "user", "content": [{"type": "image", "image": ""}, {"type": "text", "text": "What kind of cat is this? Answer with one word."}]}
]
text = processor.apply_chat_template(messages, add_generation_prompt=True, return_tensors="pt")

outputs = llm.generate([{"prompt": text, "multi_modal_data": {"image": image}}], sampling_params=sampling_params)
generated_text = outputs[0].outputs[0].text

thinking, summary = extract_thinking_and_summary(generated_text)
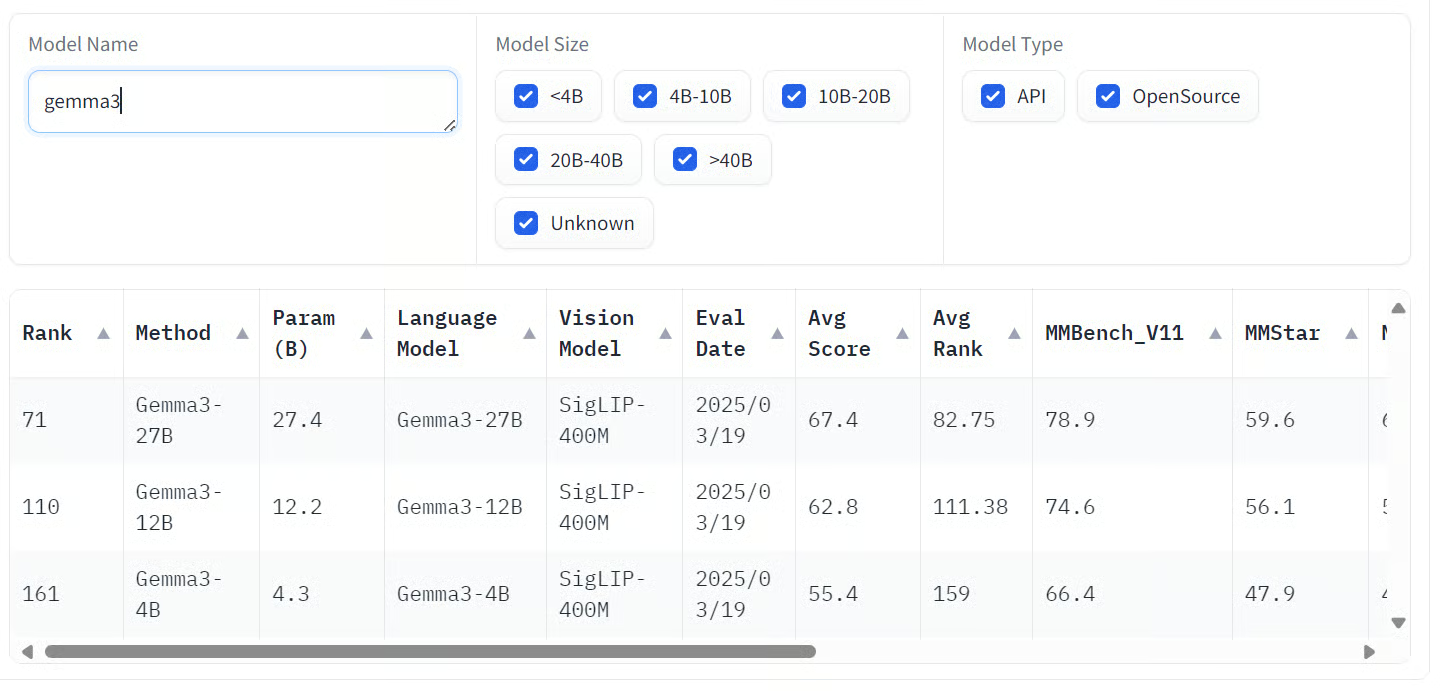
print(OUTPUT_FORMAT.format(thinking=thinking, summary=summary))Gemma 3 es una familia de modelos multimodales de IA desarrollados por Google, capaces de procesar entradas de texto e imagen para producir salidas de texto. Están disponibles en varios tamaños: 1B, 4B, 12B y 27B, para distintas necesidades de hardware y rendimiento.
La variante más grande, Gemma 3 27B, ha logrado resultados destacables en evaluaciones de preferencia humana, superando incluso a modelos mayores como Llama 3-405B y DeepSeek‑V3.
Los modelos demuestran gran capacidad en diversos benchmarks. En tareas multimodales destacan con puntuaciones como COCOcap (116), DocVQA (85,6), MMMU (56,1) y VQAv2 (72,9).
Fuente: Open VLM Leaderboard
Ejemplo de uso:
# pip install accelerate

from transformers import AutoProcessor, Gemma3ForConditionalGeneration
from PIL import Image
import requests
import torch

model_id = "google/gemma-3-27b-it"

model = Gemma3ForConditionalGeneration.from_pretrained(
    model_id, device_map="auto"
).eval()

processor = AutoProcessor.from_pretrained(model_id)

messages = [
    {
        "role": "system",
        "content": [{"type": "text", "text": "You are a helpful assistant."}]
    },
    {
        "role": "user",
        "content": [
            {"type": "image", "image": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/bee.jpg"},
            {"type": "text", "text": "Describe this image in detail."}
        ]
    }
]

inputs = processor.apply_chat_template(
    messages, add_generation_prompt=True, tokenize=True,
    return_dict=True, return_tensors="pt"
).to(model.device, dtype=torch.bfloat16)

input_len = inputs["input_ids"].shape[-1]

with torch.inference_mode():
    generation = model.generate(**inputs, max_new_tokens=100, do_sample=False)
    generation = generation[0][input_len:]

decoded = processor.decode(generation, skip_special_tokens=True)
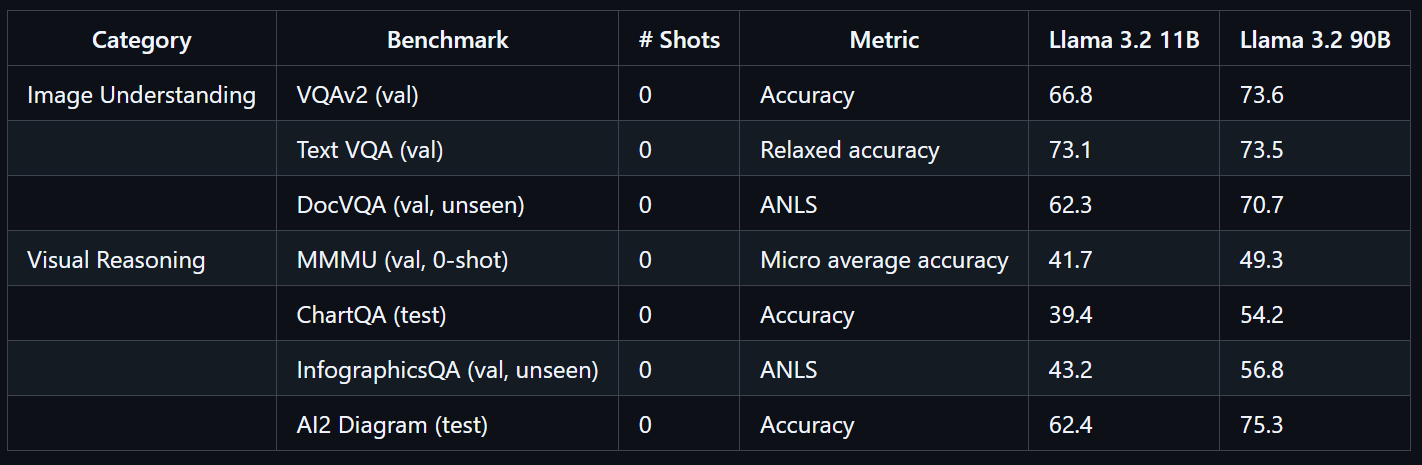
print(decoded)El modelo Llama 3.2 90B Vision Instruct es un modelo multimodal avanzado desarrollado por Meta. Está diseñado para reconocimiento visual, razonamiento sobre imágenes y generación de descripciones.
Llama 3.2 90B Vision Instruct parte de la versión solo texto Llama 3.1 e incorpora un adaptador de visión entrenado por separado, lo que le permite procesar imágenes y texto como entradas y generar salidas de texto precisas.
Entrenado a gran escala, Llama 3.2 90B Vision requirió 8,85 millones de horas de GPU. Ofrece un rendimiento excelente en benchmarks como VQAv2 (73,6), Text VQA (73,5) y DocVQA (70,7).
Fuente: llama-models
Ejemplo de uso:
import requests
import torch
from PIL import Image
from transformers import MllamaForConditionalGeneration, AutoProcessor

model_id = "meta-llama/Llama-3.2-90B-Vision-Instruct"

model = MllamaForConditionalGeneration.from_pretrained(
    model_id,
    torch_dtype=torch.bfloat16,
    device_map="auto",
)
processor = AutoProcessor.from_pretrained(model_id)

url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/0052a70beed5bf71b92610a43a52df6d286cd5f3/diffusers/rabbit.jpg"
image = Image.open(requests.get(url, stream=True).raw)

messages = [
    {"role": "user", "content": [
        {"type": "image"},
        {"type": "text", "text": "If I had to write a haiku for this one, it would be: "}
    ]}
]
input_text = processor.apply_chat_template(messages, add_generation_prompt=True)
inputs = processor(
    image,
    input_text,
    add_special_tokens=False,
    return_tensors="pt",
).to(model.device)

output = model.generate(**inputs, max_new_tokens=30)
print(processor.decode(output[0]))
El razonamiento visual con gráficos también es uno de los puntos fuertes del modelo más reciente de Meta, Muse Spark.
Los modelos visión‑lenguaje están transformando de raíz cómo interactuamos con la información visual y textual, ofreciendo gran precisión y flexibilidad en múltiples sectores. Combinan sin fisuras visión por computador y procesamiento del lenguaje natural, habilitando desde detección avanzada de objetos hasta asistentes visuales intuitivos.
Si la privacidad y la seguridad son prioritarias en tu caso de uso, te recomiendo explorar modelos visión‑lenguaje open source. Ejecutarlos en local te da control total sobre tus datos, ideal para entornos sensibles. Además, los VLM de código abierto son muy adaptables: la mayoría puede afinarse con apenas unos cientos de ejemplos para lograr resultados excelentes a medida de tus necesidades.
Los modelos propietarios, por su parte, ofrecen acceso fiable y rentable al estado del arte. Suelen ser muy precisos y se integran en tu flujo de trabajo con apenas unas líneas de código, lo que los hace accesibles incluso para equipos sin gran experiencia en IA.
Si quieres aprender más sobre modelos visión‑lenguaje, echa un vistazo a estos recursos:
Top DataCamp Courses
Curso
Curso
programa
blog
Dr Ana Rojo-Echeburúa
9 min
blog
Bhavishya Pandit
8 min
blog
Abid Ali Awan
13 min
blog
Joleen Bothma
12 min
Tutorial
Arunn Thevapalan
12 min
Tutorial
Adel Nehme
9 min