course
Bildbehandling i Python
4 timmar
56.8K
Vision Language Models (VLMs) förändrar snabbt industrier genom att möjliggöra för AI-system att förstå och resonera kring både bilder och text. Till skillnad från traditionella datorsynsmodeller kan moderna VLM:er tolka komplexa bilder, besvara detaljerade frågor om visuellt innehåll och till och med bearbeta videor och dokument med inbäddad text.
Denna förmåga gör dem ovärderliga för medicinsk diagnostik, automatiserad kvalitetskontroll och känsliga tillämpningar där precision är viktigare än hastighet.
I den här bloggen går vi igenom de bästa vision-language-modellerna 2026, både öppna och proprietära alternativ. Vi lyfter fram deras unika förmågor och presenterar sedan deras prestanda och benchmarkresultat. För utvecklare och forskare har vi även inkluderat exempel på kod så att du snabbt kan testa modellerna själv.
Om du vill lära dig mer om grunderna i dessa modeller, glöm inte att kolla in vår Image Processing in Python-spår.
Gemini 2.5 Pro är Googles mest avancerade AI-modell och toppar just nu LMArena- och WebDevArena-listorna för både visuella och kodrelaterade uppgifter. Den är byggd för komplext resonemang och förståelse över text, bilder, ljud och video.
När det gäller dess vision-language-förmågor rankas den som en av toppmodellerna på Open LLM Leaderboard. Gemini 2.5 Pro kan tolka bilder och videor, generera detaljerade och kontextmedvetna beskrivningar samt besvara frågor kopplade till visuellt innehåll.
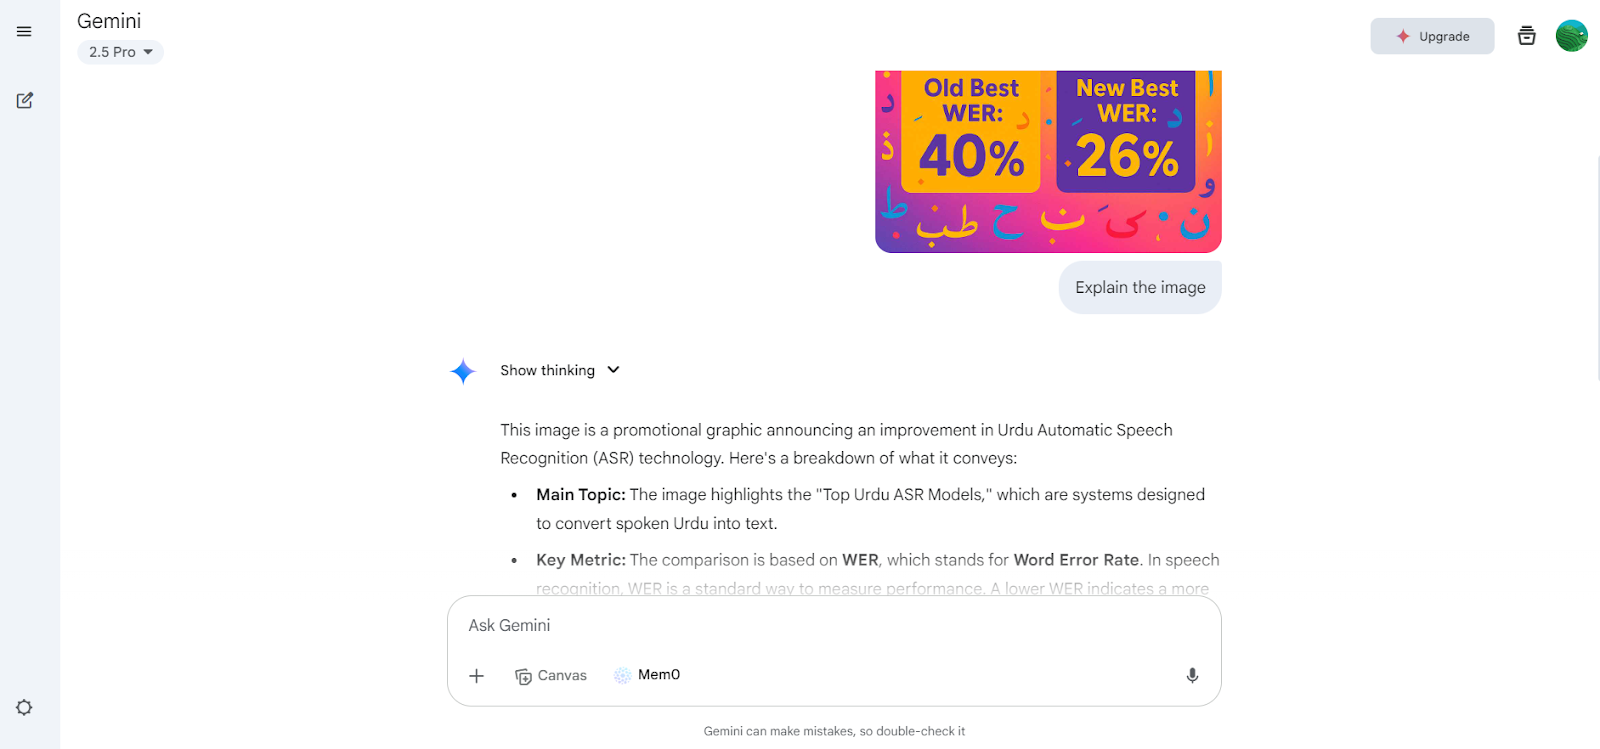
Källa: Google Gemini
Du kan komma åt Gemini 2.5 Pro gratis via Gemini webbapp på gemini.google.com/app eller genom att använda Google AI Studio.
För utvecklare finns Gemini 2.5 Pro även tillgänglig via Gemini API, Vertex AI och det officiella Python-SDK:t, vilket gör det enkelt att integrera dess vision-language-funktioner i dina egna applikationer eller arbetsflöden.
Exempel på användning:
from google.genai import types

with open('path/to/image.jpg', 'rb') as f:
      image_bytes = f.read()

  response = client.models.generate_content(
    model='gemini-2.5-pro',
    contents=[
      types.Part.from_bytes(
        data=image_bytes,
        mime_type='image/jpeg',
      ),
      'Explain the image.'
    ]
  )
print(response.text)InternVL3 är en avancerad serie multimodala stora språkmodeller (MLLM) som överträffar sin föregångare, InternVL 2.5. Den utmärker sig i multimodal perception och resonemang och har förbättrade förmågor, inklusive verktygsanvändning, GUI-agenter, industriell bildanalys och 3D-visionsperception.
Modellen InternVL3-78B använder specifikt InternViT-6B-448px-V2_5 för sin visionskomponent och Qwen2.5-72B för sin språkkomponent. Med totalt 78,41 miljarder parametrar har InternVL3-78B uppnått 72,2 på MMMU-benchmarken och satt ett nytt toppresultat bland öppna MLLM:er. Dess prestanda är konkurrenskraftig jämfört med ledande proprietära modeller.
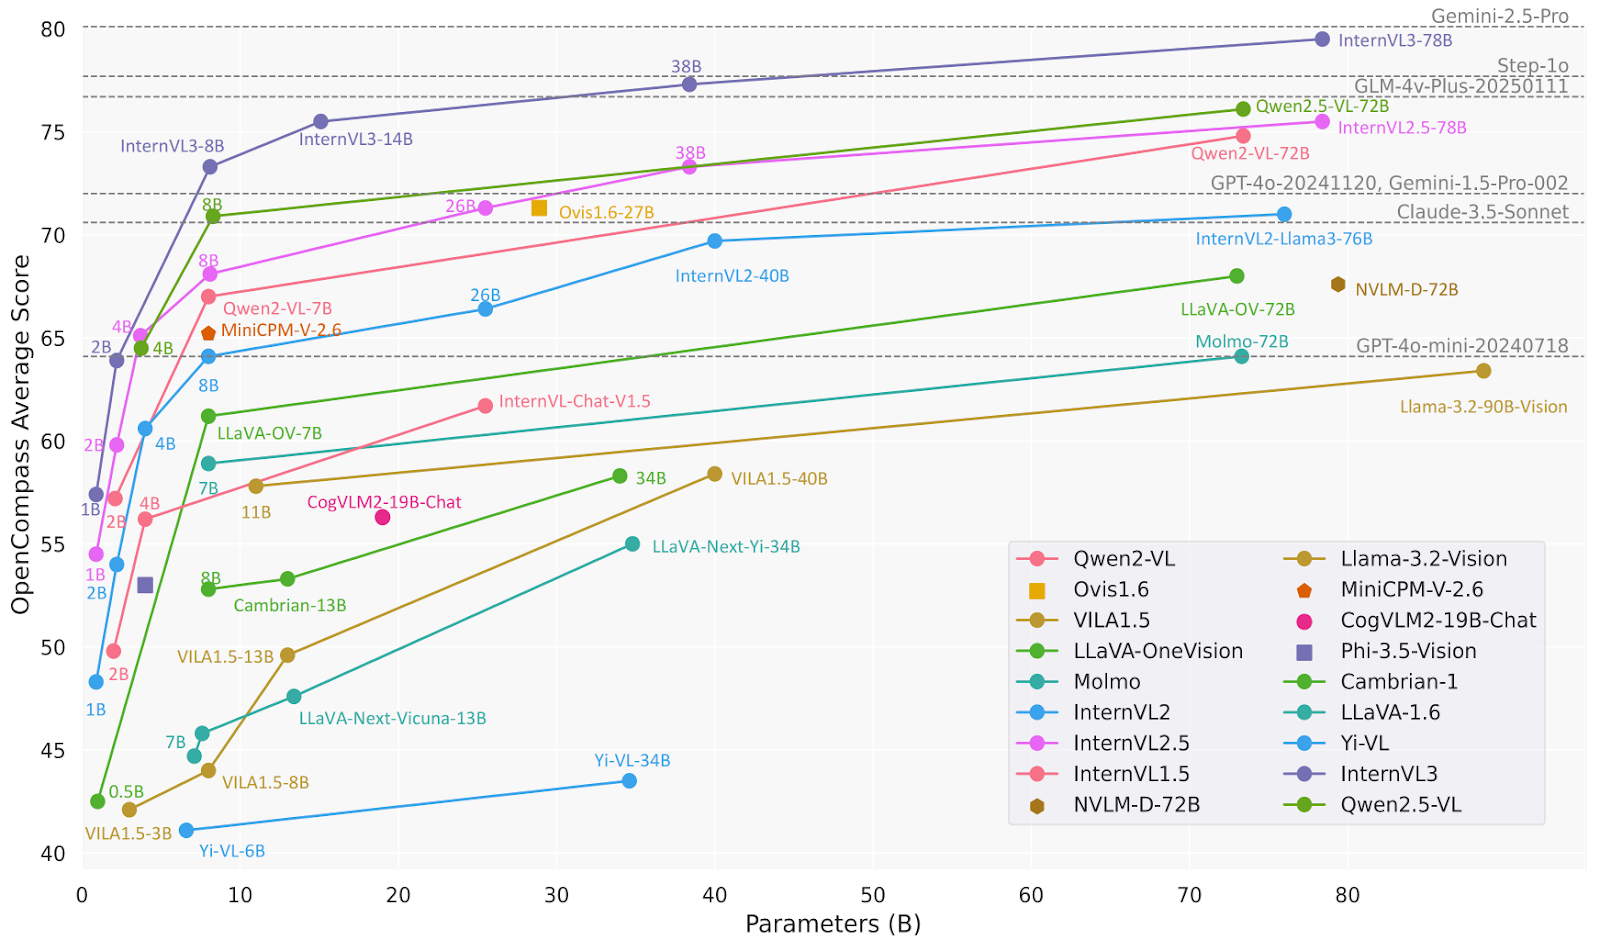
Källa: OpenGVLab/InternVL3-78B · Hugging Face
Exempel på användning:
# pip install lmdeploy>=0.7.3
from lmdeploy import pipeline, TurbomindEngineConfig, ChatTemplateConfig
from lmdeploy.vl import load_image

model = 'OpenGVLab/InternVL3-78B'
image = load_image('https://raw.githubusercontent.com/open-mmlab/mmdeploy/main/tests/data/tiger.jpeg')
pipe = pipeline(model, backend_config=TurbomindEngineConfig(session_len=16384, tp=4), chat_template_config=ChatTemplateConfig(model_name='internvl2_5'))
response = pipe(('Explain the image.', image))
print(response.text)Ovis2 är en serie multimodala stora språkmodeller (MLLM) utvecklade av AIDC-AI. Dessa modeller är utformade för att effektivt linjera visuella och textuella inbäddningar. Modellen Ovis2-34B använder särskilt aimv2-1B-patch14-448 som sin visionskodare och Qwen2.5-32B-Instruct som sitt språkmodul, totalt 34 miljarder parametrar. Den stöder en maximal kontextlängd på 32 768 token och använder bfloat16-precision för effektiv bearbetning.
Ovis2-34B har visat stark prestanda på olika benchmarktester och uppnått följande resultat:
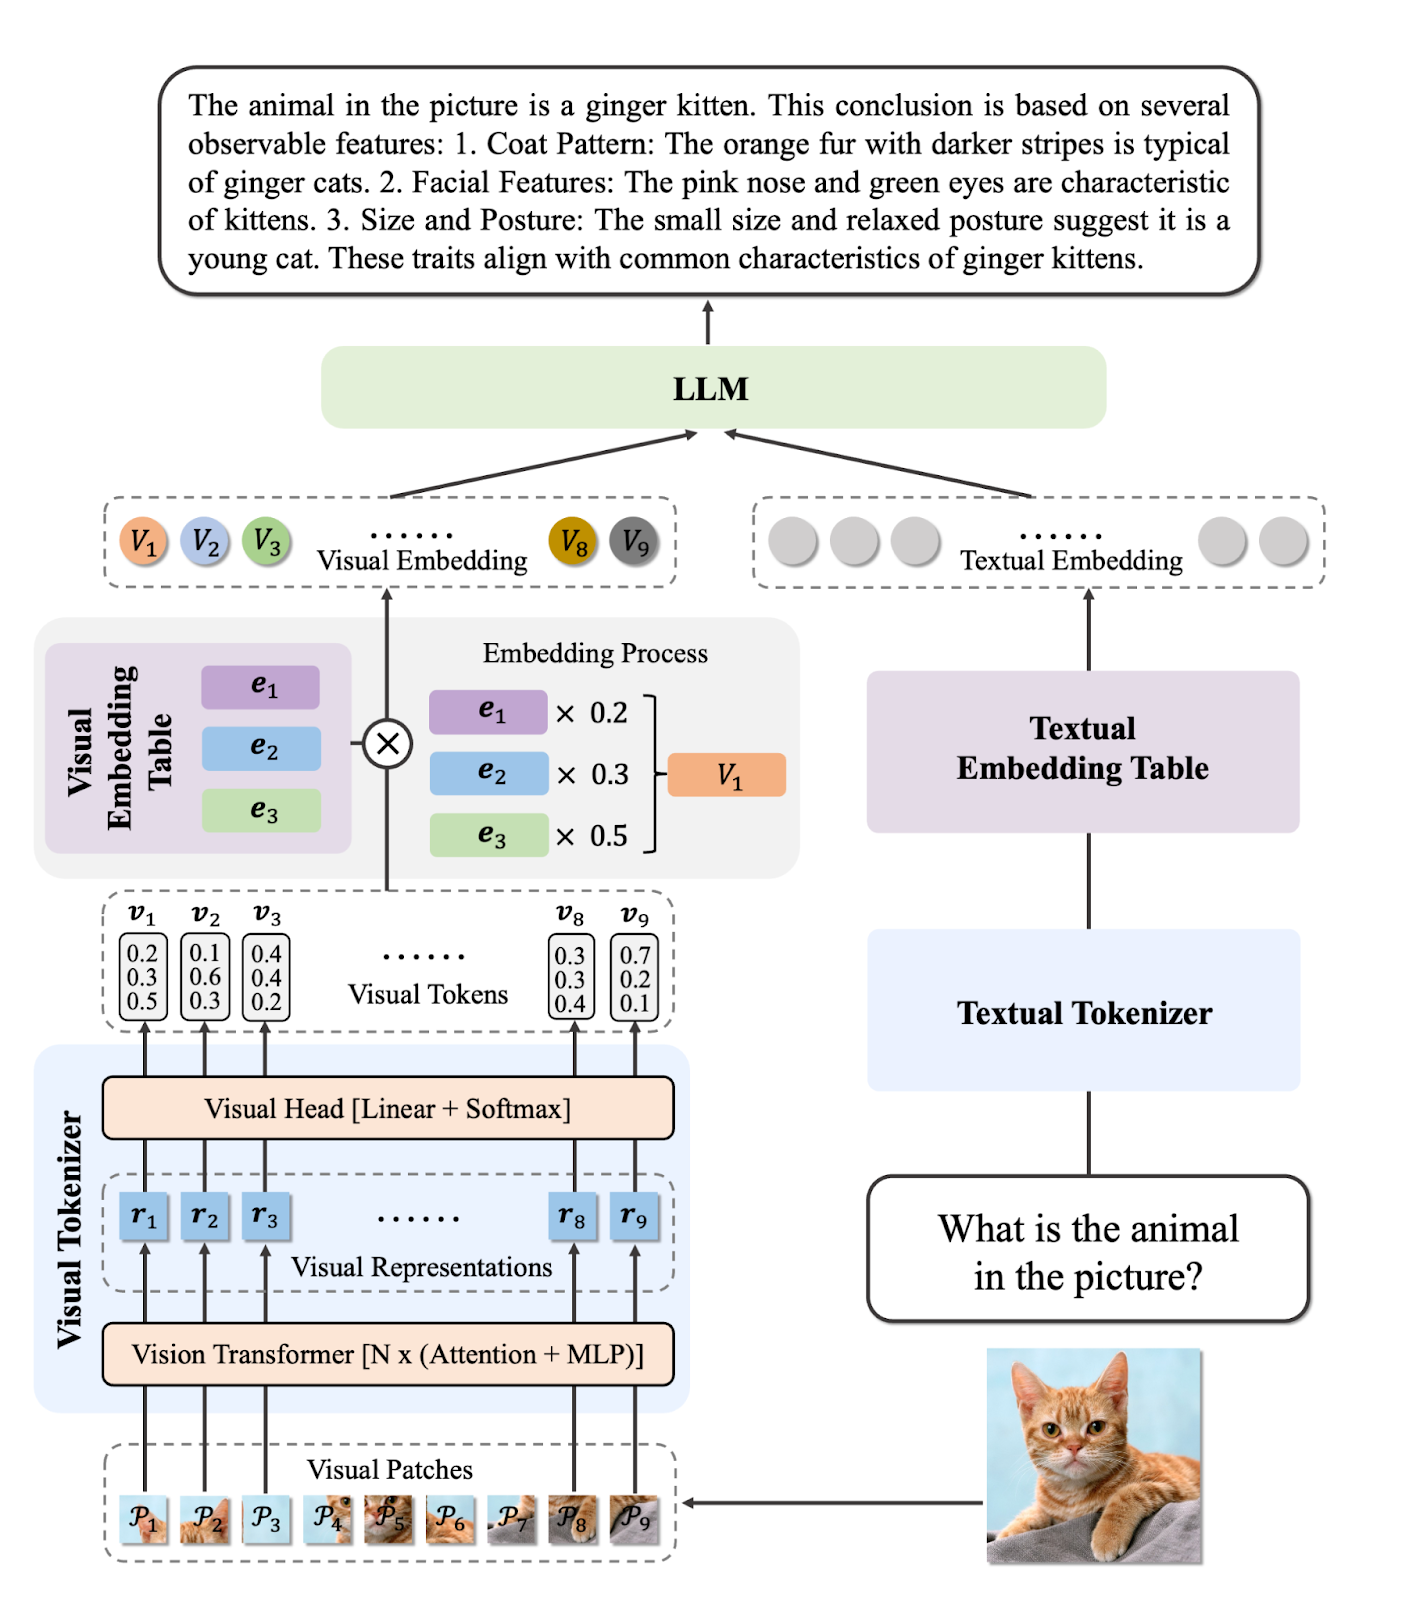
Källa: AIDC-AI/Ovis2-34B · Hugging Face
Exempel på användning:
import torch
from PIL import Image
from transformers import AutoModelForCausalLM

# load model
model = AutoModelForCausalLM.from_pretrained("AIDC-AI/Ovis2-34B",
                                             torch_dtype=torch.bfloat16,
                                             multimodal_max_length=32768,
                                             trust_remote_code=True).cuda()
text_tokenizer = model.get_text_tokenizer()
visual_tokenizer = model.get_visual_tokenizer()

# single-image input
image_path = '/data/images/example_1.jpg'
images = [Image.open(image_path)]
max_partition = 9
text = 'Describe the image.'
query = f'<image>\n{text}'


# format conversation
prompt, input_ids, pixel_values = model.preprocess_inputs(query, images, max_partition=max_partition)
attention_mask = torch.ne(input_ids, text_tokenizer.pad_token_id)
input_ids = input_ids.unsqueeze(0).to(device=model.device)
attention_mask = attention_mask.unsqueeze(0).to(device=model.device)
if pixel_values is not None:
    pixel_values = pixel_values.to(dtype=visual_tokenizer.dtype, device=visual_tokenizer.device)
pixel_values = [pixel_values]

# generate output
with torch.inference_mode():
    gen_kwargs = dict(
        max_new_tokens=1024,
        do_sample=False,
        top_p=None,
        top_k=None,
        temperature=None,
        repetition_penalty=None,
        eos_token_id=model.generation_config.eos_token_id,
        pad_token_id=text_tokenizer.pad_token_id,
        use_cache=True
    )
    output_ids = model.generate(input_ids, pixel_values=pixel_values, attention_mask=attention_mask, **gen_kwargs)[0]
    output = text_tokenizer.decode(output_ids, skip_special_tokens=True)
print(f'Output:\n{output}')Qwen2.5-VL-72B-Instruct är en multimodal stor språkmodell (MLLM) från Qwen-familjen, utformad för att förstå och bearbeta både visuellt och textuellt innehåll. Många öppna MLLM-modeller bygger på den, vilket visar att Qwen-serien spelar en viktig roll för AI-forskningens utveckling.
Qwen2.5-VL-72B-Instruct uppvisar stark prestanda över flera benchmarktester, inklusive förmågor inom bild- och videoförståelse samt agentfunktioner. Den får 70,2 på MMMUval, 74,8 på MathVista_MINI och 70,8 på MMStar.
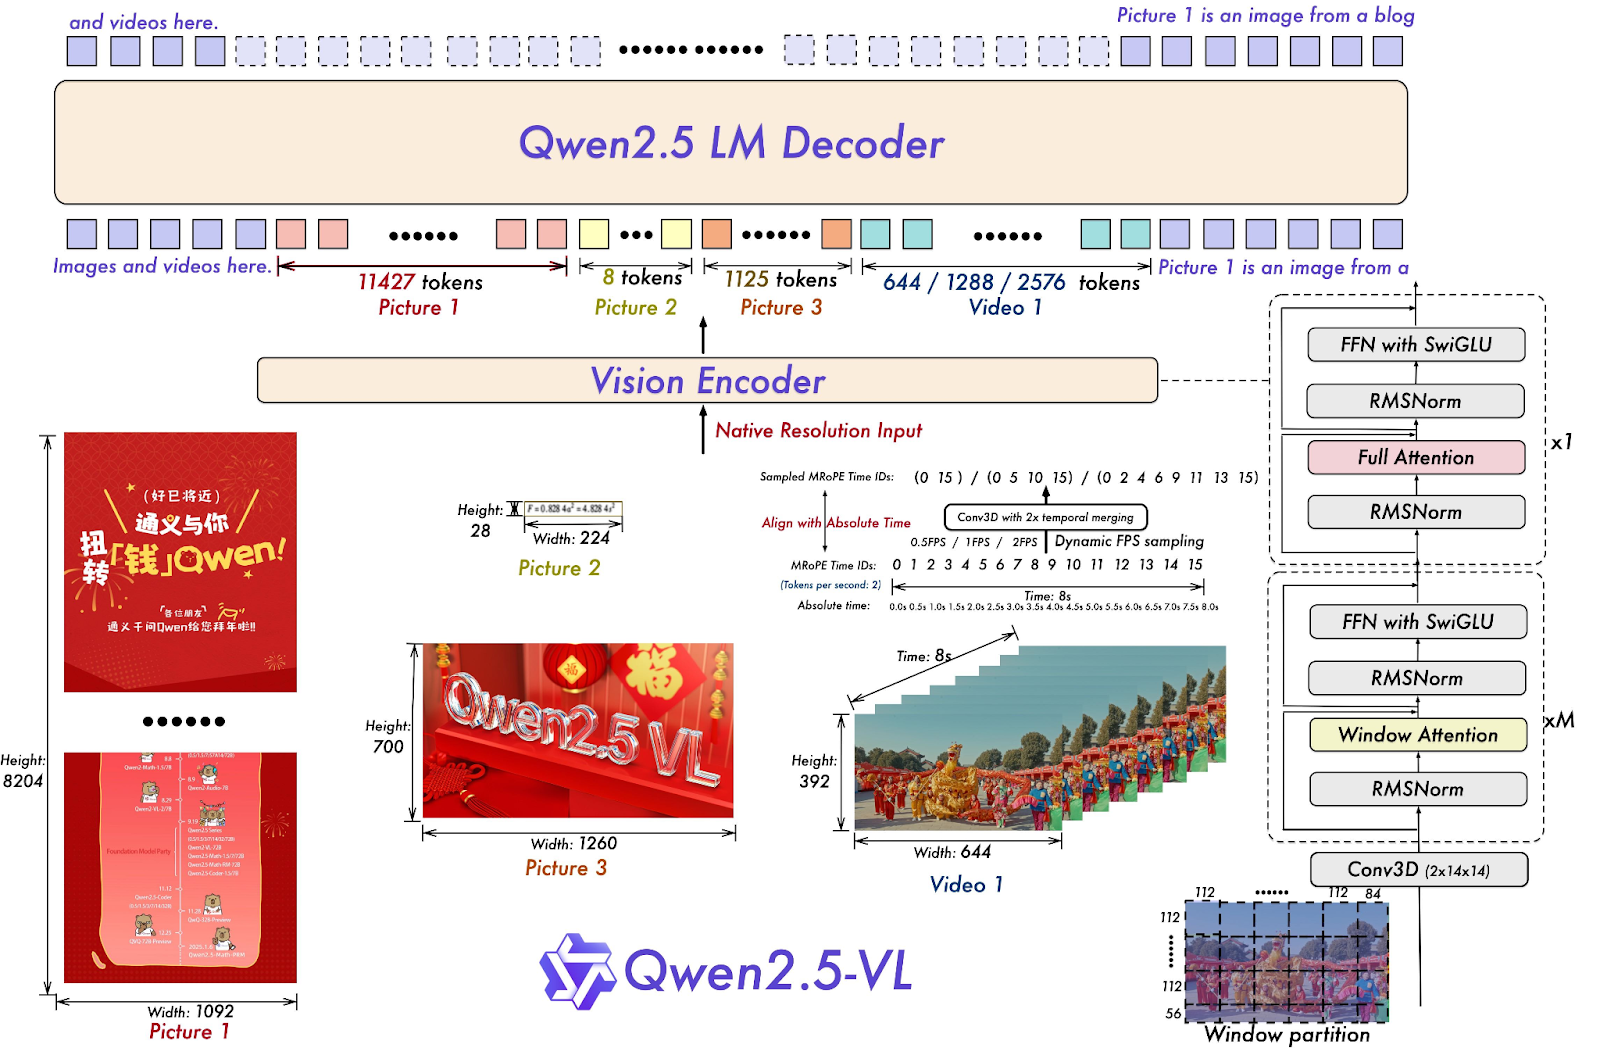
Källa: Qwen/Qwen2.5-VL-72B-Instruct · Hugging Face
Exempel på användning:
# pip install qwen-vl-utils[decord]==0.0.8

from transformers import Qwen2_5_VLForConditionalGeneration, AutoTokenizer, AutoProcessor
from qwen_vl_utils import process_vision_info

# default: Load the model on the available device(s)
model = Qwen2_5_VLForConditionalGeneration.from_pretrained(
    "Qwen/Qwen2.5-VL-72B-Instruct", torch_dtype="auto", device_map="auto"
)
# default processer
processor = AutoProcessor.from_pretrained("Qwen/Qwen2.5-VL-72B-Instruct")


messages = [
    {
        "role": "user",
        "content": [
            {
                "type": "image",
                "image": "https://qianwen-res.oss-cn-beijing.aliyuncs.com/Qwen-VL/assets/demo.jpeg",
            },
            {"type": "text", "text": "Describe this image."},
        ],
    }
]

# Preparation for inference
text = processor.apply_chat_template(
    messages, tokenize=False, add_generation_prompt=True
)
image_inputs, video_inputs = process_vision_info(messages)
inputs = processor(
    text=[text],
    images=image_inputs,
    videos=video_inputs,
    padding=True,
    return_tensors="pt",
)
inputs = inputs.to("cuda")

# Inference: Generation of the output
generated_ids = model.generate(**inputs, max_new_tokens=128)
generated_ids_trimmed = [
    out_ids[len(in_ids) :] for in_ids, out_ids in zip(inputs.input_ids, generated_ids)
]
output_text = processor.batch_decode(
    generated_ids_trimmed, skip_special_tokens=True, clean_up_tokenization_spaces=False
)
print(output_text)OpenAI:s o3 är en ny resonemangsmodell som är utformad för att ge högre intelligens, lägre kostnader och mer effektiv tokenanvändning i applikationer. Den representerar en ny generation modeller som betonar avancerade resonemangsförmågor.
Modellen sätter en ny standard för uppgifter inom matematik, vetenskap, kodning och visuellt resonemang. I olika visionsbenchmarks överträffar den både o4-min och o1 och är i nivå med o3 Pro.
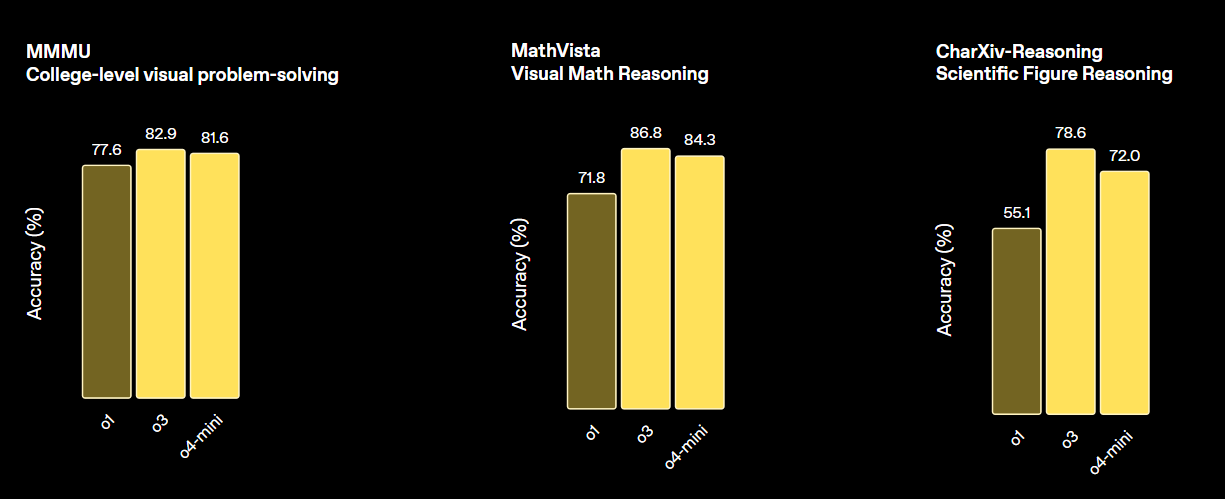
Källa: Introducing OpenAI o3 and o4-mini | OpenAI
Exempel på användning:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="o3-2025-04-16",
    input=[{
        "role": "user",
        "content": [
            {"type": "input_text", "text": "what's in this image?"},
            {
                "type": "input_image",
                "image_url": "https://upload.wikimedia.org/wikipedia/commons/thumb/d/dd/Gfp-wisconsin-madison-the-nature-boardwalk.jpg/2560px-Gfp-wisconsin-madison-the-nature-boardwalk.jpg",
            },
        ],
    }],
)

print(response.output_text)GPT-4.1 är en ny familj av icke-resonerande modeller, inklusive GPT-4.1, GPT-4.1 Mini och GPT-4.1 Nano. Dessa modeller har överträffat sina föregångare, GPT-4o och GPT-4o Mini, i flera benchmarks.
GPT-4.1 behåller starka visuella förmågor, med förbättringar i analys av diagram, skisser och visuell matematik. Den är mycket bra på uppgifter som objektuppräkning, visuella frågor och svar (VQA) och olika former av optisk teckenigenkänning (OCR).
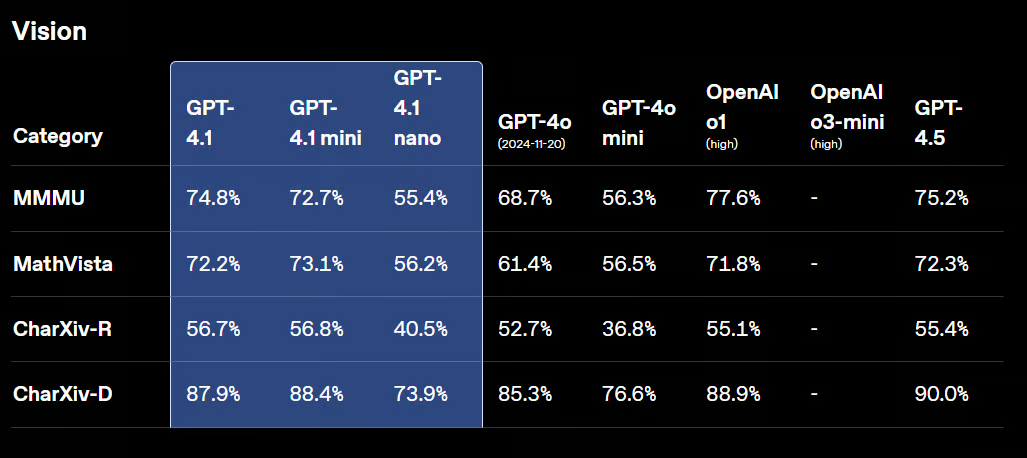
Källa: Introducing GPT-4.1 in the API | OpenAI
Exempel på användning:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-4.1-2025-04-14",
    input=[{
        "role": "user",
        "content": [
            {"type": "input_text", "text": "what's in this image?"},
            {
                "type": "input_image",
                "image_url": "https://upload.wikimedia.org/wikipedia/commons/thumb/d/dd/Gfp-wisconsin-madison-the-nature-boardwalk.jpg/2560px-Gfp-wisconsin-madison-the-nature-boardwalk.jpg",
            },
        ],
    }],
)

print(response.output_text)Anthropic har lanserat nästa generation av sina Claude-modeller: Claude 4 Opus och Claude 4 Sonnet. Dessa modeller är utformade för att sätta nya standarder inom kodning, avancerat resonemang och AI-kapaciteter.
De kommer med förbättrade visuella förmågor som användare kan utnyttja för att förstå bilder och sedan generera kod eller ge information baserat på bilderna. Även om det i grunden är en kodningsmodell har den också multimodala förmågor som gör att den kan förstå olika filformat.
Om du tittar på jämförelsetabellen nedan ser du att Claude 4 överträffar alla toppmodeller utom OpenAI:s GPT-3-modell, särskilt i visuellt resonemang och visuella frågor och svar.
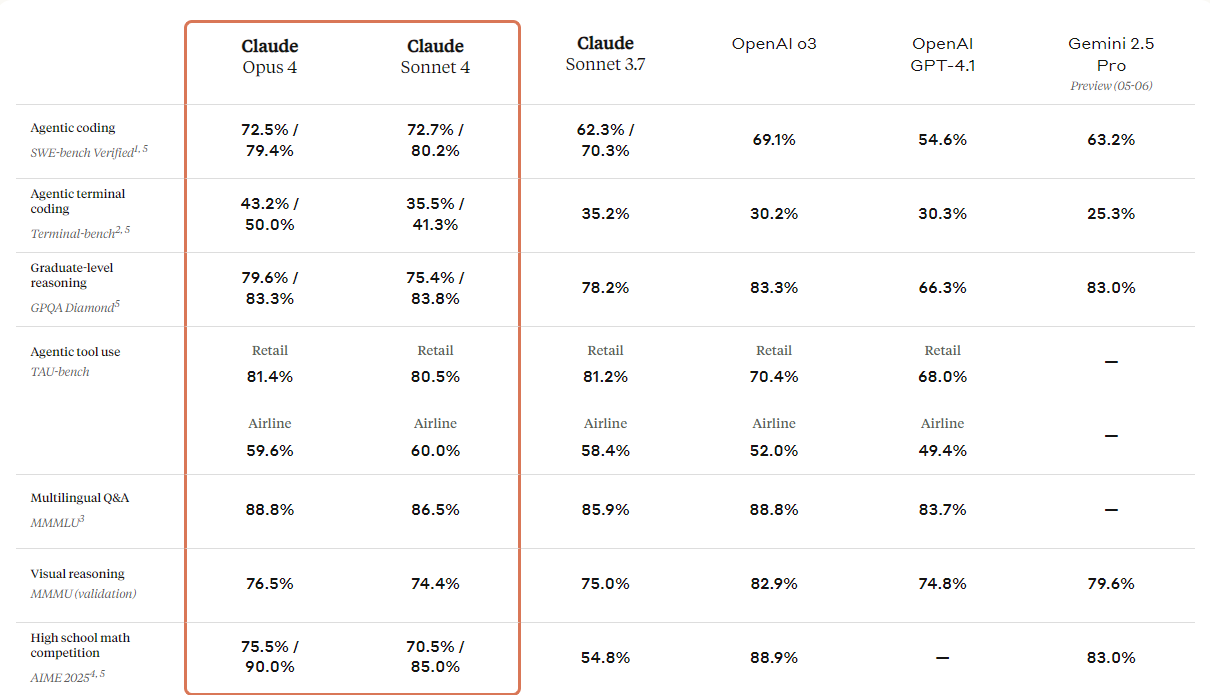
Källa: Introducing Claude 4 \ Anthropic
Exempel på användning:
import anthropic

client = anthropic.Anthropic()
message = client.messages.create(
    model="claude-sonnet-4-20250514",
    max_tokens=1024,
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image",
                    "source": {
                        "type": "url",
                        "url": "https://upload.wikimedia.org/wikipedia/commons/a/a7/Camponotus_flavomarginatus_ant.jpg",
                    },
                },
                {
                    "type": "text",
                    "text": "Describe this image."
                }
            ],
        }
    ],
)
print(message)Kimi-VL-A3B-Thinking-2506 är en öppen modell som markerar ett betydande framsteg inom multimodal AI. Den utmärker sig i multimodala resonemangsbenchmarks och uppnår imponerande träffsäkerhet: 56,9 på MathVision, 80,1 på MathVista, 46,3 på MMMU-Pro och 64,0 på MMMU, samtidigt som den minskar sin ”tänkelängd” med i genomsnitt 20%.
Utöver resonemangsförmågorna visar version 2506 förbättrad generell visuell perception och förståelse. Den matchar eller överträffar till och med prestandan hos icke-resonerande modeller på benchmarks som MMBench-EN-v1.1 (84,4), MMStar (70,4), RealWorldQA (70,0) och MMVet (78,4).
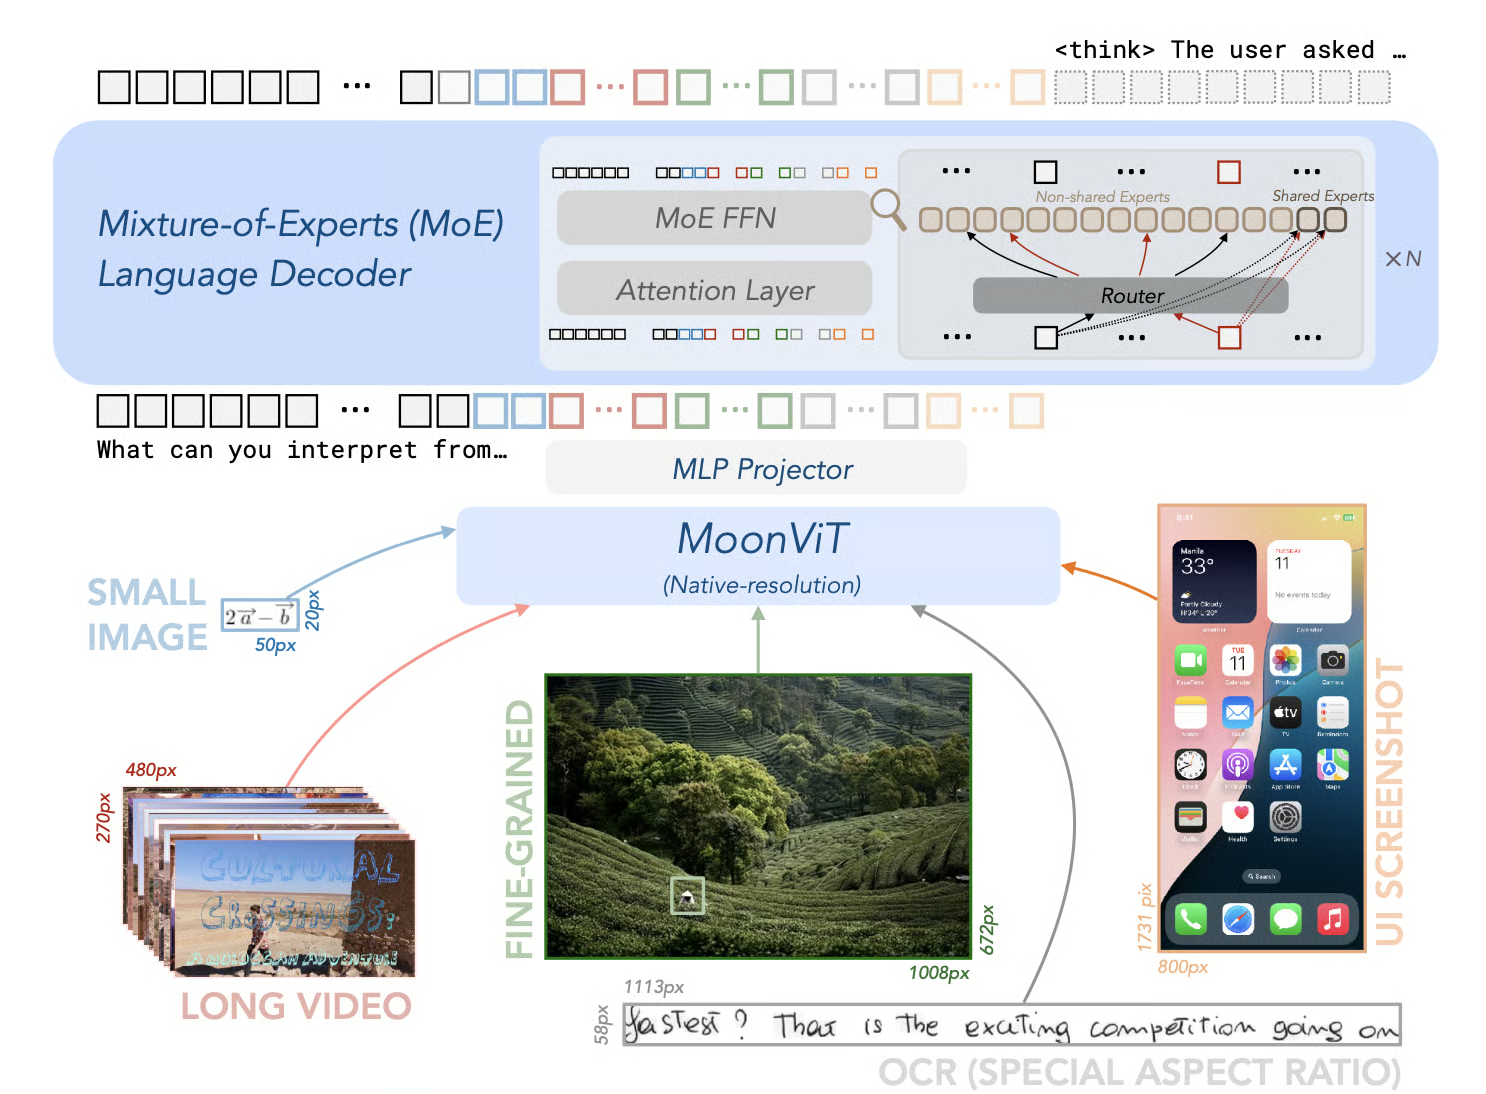
Källa: MoonshotAI/Kimi-VL: Kimi-VL
Exempel på användning:
from transformers import AutoProcessor
from vllm import LLM, SamplingParams

model_path = "moonshotai/Kimi-VL-A3B-Thinking-2506"
llm = LLM(
    model_path,
    trust_remote_code=True,
    max_num_seqs=8,
    max_model_len=131072,
    limit_mm_per_prompt={"image": 256}
)

processor = AutoProcessor.from_pretrained(model_path, trust_remote_code=True)

sampling_params = SamplingParams(max_tokens=32768, temperature=0.8)


import requests
from PIL import Image

def extract_thinking_and_summary(text: str, bot: str = "◁think▷", eot: str = "◁/think▷") -> str:
    if bot in text and eot not in text:
        return ""
    if eot in text:
        return text[text.index(bot) + len(bot):text.index(eot)].strip(), text[text.index(eot) + len(eot) :].strip()
    return "", text

OUTPUT_FORMAT = "--------Thinking--------\n{thinking}\n\n--------Summary--------\n{summary}"

url = "https://huggingface.co/spaces/moonshotai/Kimi-VL-A3B-Thinking/resolve/main/images/demo6.jpeg"
image = Image.open(requests.get(url,stream=True).raw)

messages = [
    {"role": "user", "content": [{"type": "image", "image": ""}, {"type": "text", "text": "What kind of cat is this? Answer with one word."}]}
]
text = processor.apply_chat_template(messages, add_generation_prompt=True, return_tensors="pt")

outputs = llm.generate([{"prompt": text, "multi_modal_data": {"image": image}}], sampling_params=sampling_params)
generated_text = outputs[0].outputs[0].text

thinking, summary = extract_thinking_and_summary(generated_text)
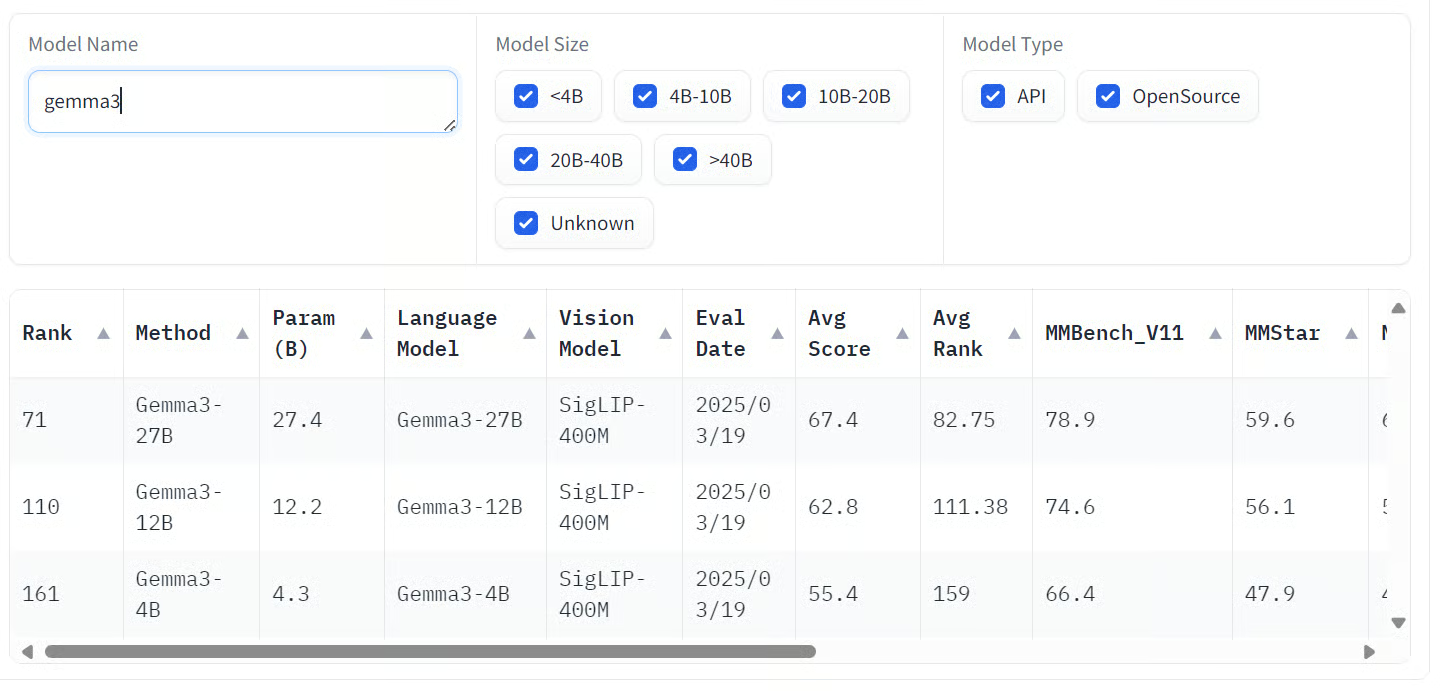
print(OUTPUT_FORMAT.format(thinking=thinking, summary=summary))Gemma 3 är en familj av multimodala AI-modeller utvecklade av Google, som kan bearbeta både text- och bildinmatning för att producera textutdata. Modellerna finns i olika storlekar: 1B, 4B, 12B och 27B, för att passa olika hårdvaru- och prestandakrav.
Den största varianten, Gemma 3 27B, har visat imponerande resultat i mänskliga preferensutvärderingar och överträffar till och med större modeller som Llama 3-405B och DeepSeek-V3.
Modellerna uppvisar starka förmågor över flera benchmarks. Särskilt utmärker de sig i multimodala uppgifter och når höga poäng på benchmarks som COCOcap (116), DocVQA (85,6), MMMU (56,1) och VQAv2 (72,9).
Källa: Open VLM Leaderboard
Exempel på användning:
# pip install accelerate

from transformers import AutoProcessor, Gemma3ForConditionalGeneration
from PIL import Image
import requests
import torch

model_id = "google/gemma-3-27b-it"

model = Gemma3ForConditionalGeneration.from_pretrained(
    model_id, device_map="auto"
).eval()

processor = AutoProcessor.from_pretrained(model_id)

messages = [
    {
        "role": "system",
        "content": [{"type": "text", "text": "You are a helpful assistant."}]
    },
    {
        "role": "user",
        "content": [
            {"type": "image", "image": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/bee.jpg"},
            {"type": "text", "text": "Describe this image in detail."}
        ]
    }
]

inputs = processor.apply_chat_template(
    messages, add_generation_prompt=True, tokenize=True,
    return_dict=True, return_tensors="pt"
).to(model.device, dtype=torch.bfloat16)

input_len = inputs["input_ids"].shape[-1]

with torch.inference_mode():
    generation = model.generate(**inputs, max_new_tokens=100, do_sample=False)
    generation = generation[0][input_len:]

decoded = processor.decode(generation, skip_special_tokens=True)
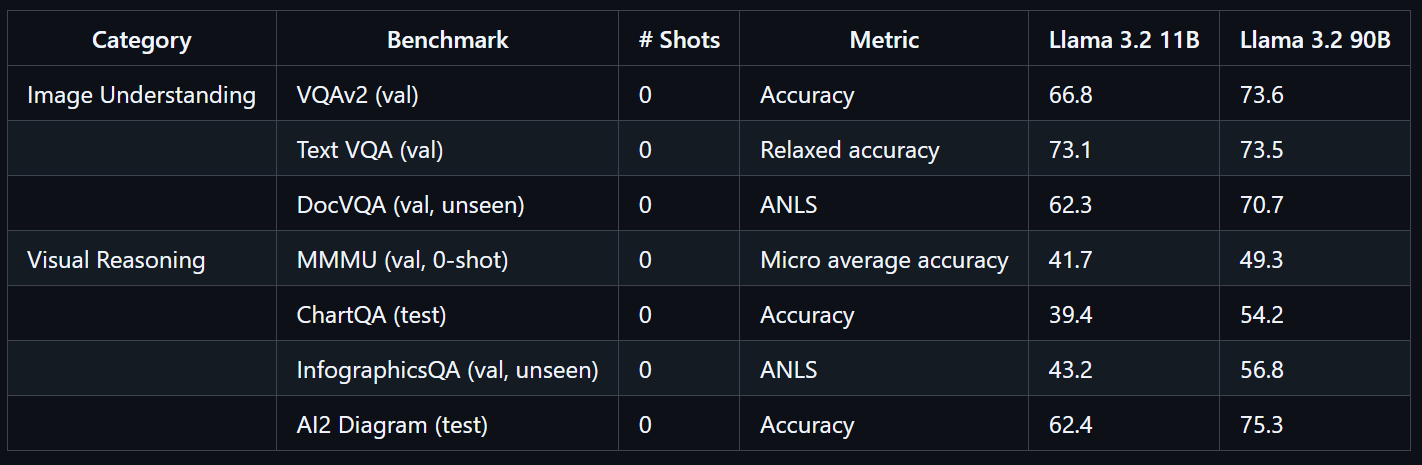
print(decoded)Llama 3.2 90B Vision Instruct är en avancerad multimodal stor språkmodell utvecklad av Meta. Den är utformad för uppgifter som visuell igenkänning, bildresonemang och bildtextning.
Llama 3.2 90B Vision Instruct bygger på Llama 3.1 i textversion och inkluderar en separat tränad visionsadapter, vilket gör att den kan bearbeta både bilder och text som indata och generera precisa textutdata.
Tränad i massiv skala krävde Llama 3.2 90B Vision 8,85 miljoner GPU-timmar. Den visar exceptionell prestanda på benchmarks som VQAv2 (73,6), Text VQA (73,5) och DocVQA (70,7).
Källa: llama-models
Exempel på användning:
import requests
import torch
from PIL import Image
from transformers import MllamaForConditionalGeneration, AutoProcessor

model_id = "meta-llama/Llama-3.2-90B-Vision-Instruct"

model = MllamaForConditionalGeneration.from_pretrained(
    model_id,
    torch_dtype=torch.bfloat16,
    device_map="auto",
)
processor = AutoProcessor.from_pretrained(model_id)

url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/0052a70beed5bf71b92610a43a52df6d286cd5f3/diffusers/rabbit.jpg"
image = Image.open(requests.get(url, stream=True).raw)

messages = [
    {"role": "user", "content": [
        {"type": "image"},
        {"type": "text", "text": "If I had to write a haiku for this one, it would be: "}
    ]}
]
input_text = processor.apply_chat_template(messages, add_generation_prompt=True)
inputs = processor(
    image,
    input_text,
    add_special_tokens=False,
    return_tensors="pt",
).to(model.device)

output = model.generate(**inputs, max_new_tokens=30)
print(processor.decode(output[0]))
Visuellt resonemang med diagram är också en styrka hos Metas senaste modell, Muse Spark.
Vision-language-modeller förändrar i grunden hur vi interagerar med både visuellt och textuellt innehåll och levererar anmärkningsvärd noggrannhet och flexibilitet i en rad branscher. Dessa modeller sammanfogar sömlöst datorsyn och naturlig språkbehandling och möjliggör nya tillämpningar från avancerad objektdetektering till intuitiva visuella assistenter.
Om integritet och säkerhet är högsta prioritet för din användning rekommenderar jag starkt att utforska öppna vision-language-modeller. Genom att köra dessa modeller lokalt får du full kontroll över dina data, vilket gör dem idealiska för känsliga miljöer. Öppna VLM:er är också mycket anpassningsbara; de flesta kan fintrimmas på bara några hundra exempel för att nå utmärkta resultat skräddarsydda efter dina behov.
Proprietära modeller å andra sidan ger tillförlitlig och kostnadseffektiv tillgång till det allra senaste. De tenderar att vara mycket träffsäkra och kan integreras i ditt arbetsflöde med bara några rader kod, vilket gör dem tillgängliga även för team utan djup AI-expertis.
Om du vill lära dig mer om vision-language-modeller, kolla gärna in följande resurser:
Toppkurser på DataCamp
course
course
track