Curso
Processamento de Imagens em Python
4 h
56.8K
Os Vision Language Models (VLMs) estão transformando rapidamente diversos setores ao permitir que sistemas de IA entendam e raciocinem sobre imagens e texto. Diferente dos modelos tradicionais de visão computacional, os VLMs modernos interpretam imagens complexas, respondem a perguntas detalhadas sobre o conteúdo visual e até processam vídeos e documentos com texto incorporado.
Essa capacidade os torna indispensáveis em diagnósticos médicos, controle de qualidade automatizado e aplicações sensíveis, em que a precisão vale mais que a velocidade.
Neste blog, vamos analisar os principais modelos de visão e linguagem de 2026, incluindo opções open-source e proprietárias. Vamos destacar seus diferenciais e, em seguida, apresentar resultados de desempenho e benchmarks. Para desenvolvedores e pesquisadores, incluímos também trechos de código para você testar rapidamente esses modelos.
Se você quer se aprofundar nos fundamentos desses modelos, confira nossa trilha Image Processing in Python.
Gemini 2.5 Pro é o modelo de IA mais avançado do Google e atualmente lidera os rankings do LMArena e do WebDevArena para tarefas de visão e de código. Ele foi projetado para raciocínio complexo e entendimento em texto, imagens, áudio e vídeo.
Em capacidades de visão e linguagem, figura entre os melhores modelos no Open LLM leaderboard. O Gemini 2.5 Pro interpreta imagens e vídeos, gera descrições detalhadas e com contexto e responde a perguntas relacionadas ao conteúdo visual.
Fonte: Google Gemini
Você pode acessar o Gemini 2.5 Pro gratuitamente pelo app web em gemini.google.com/app ou usando o Google AI Studio.
Para desenvolvedores, o Gemini 2.5 Pro também está disponível via Gemini API, Vertex AI e SDK oficial em Python, facilitando a integração de recursos de visão e linguagem nos seus apps ou fluxos de trabalho.
Exemplo de uso:
from google.genai import types

with open('path/to/image.jpg', 'rb') as f:
      image_bytes = f.read()

  response = client.models.generate_content(
    model='gemini-2.5-pro',
    contents=[
      types.Part.from_bytes(
        data=image_bytes,
        mime_type='image/jpeg',
      ),
      'Explain the image.'
    ]
  )
print(response.text)InternVL3 é uma série avançada de modelos multimodais de linguagem (MLLMs) que supera seu antecessor, o InternVL 2.5. Ele se destaca em percepção e raciocínio multimodais e traz recursos aprimorados, como uso de ferramentas, agentes de GUI, análise de imagens industriais e percepção 3D.
Especificamente, o InternVL3-78B usa o InternViT-6B-448px-V2_5 como componente de visão e o Qwen2.5-72B como componente de linguagem. Com 78,41 bilhões de parâmetros, o InternVL3-78B alcançou 72,2 no benchmark MMMU, estabelecendo um novo estado da arte entre os MLLMs open-source. Seu desempenho é competitivo com modelos proprietários líderes.
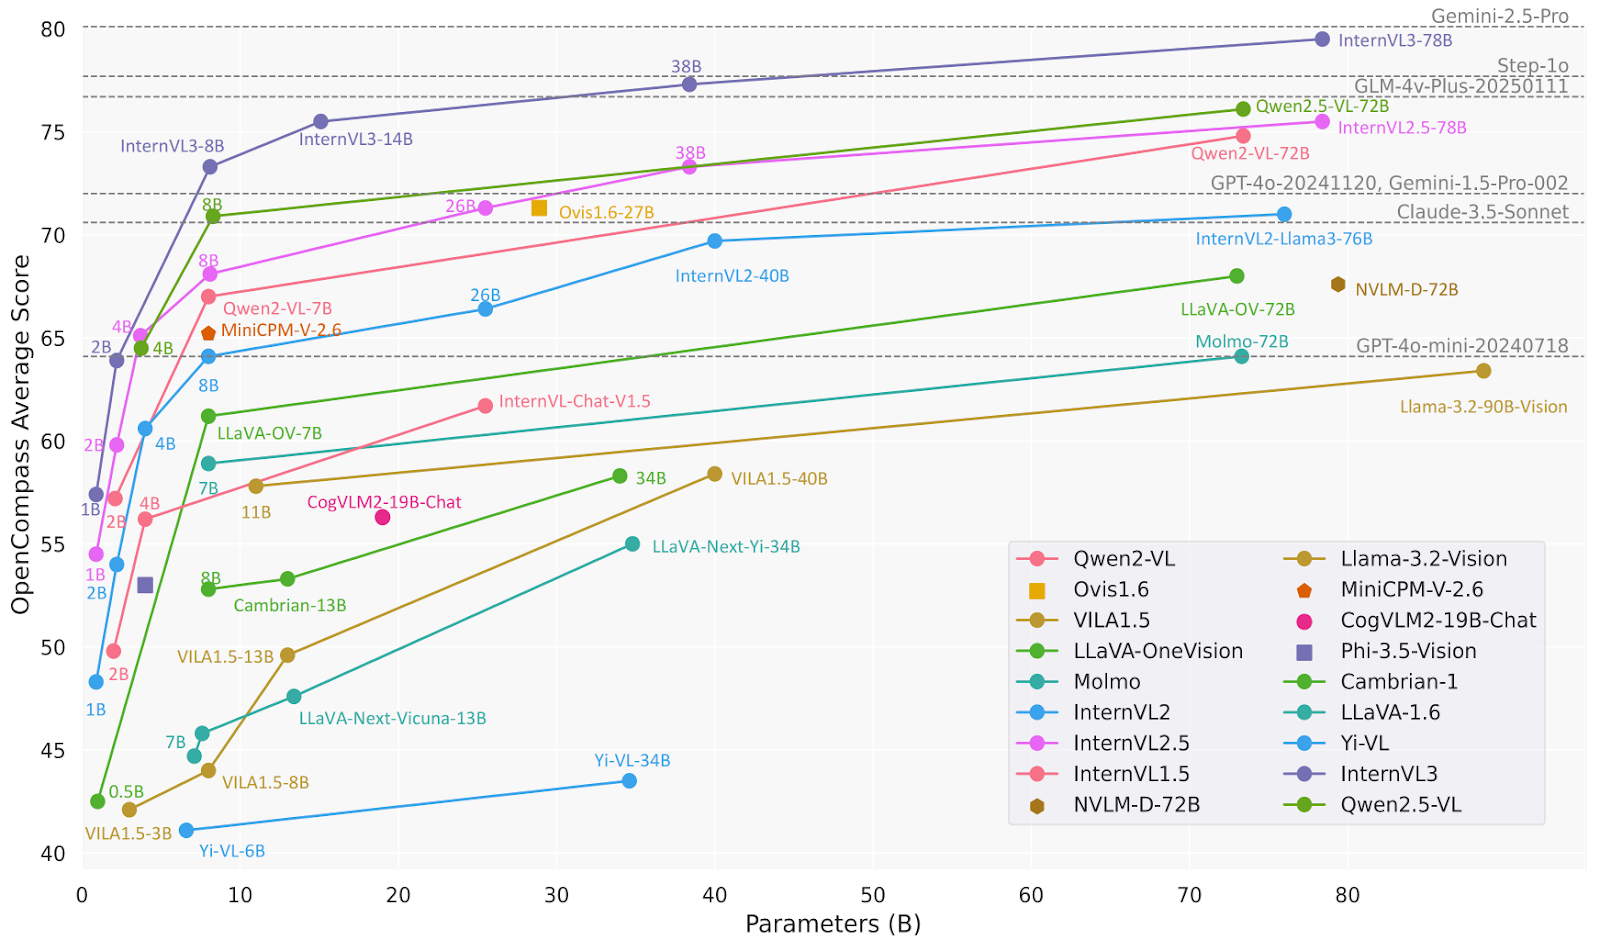
Fonte: OpenGVLab/InternVL3-78B · Hugging Face
Exemplo de uso:
# pip install lmdeploy>=0.7.3
from lmdeploy import pipeline, TurbomindEngineConfig, ChatTemplateConfig
from lmdeploy.vl import load_image

model = 'OpenGVLab/InternVL3-78B'
image = load_image('https://raw.githubusercontent.com/open-mmlab/mmdeploy/main/tests/data/tiger.jpeg')
pipe = pipeline(model, backend_config=TurbomindEngineConfig(session_len=16384, tp=4), chat_template_config=ChatTemplateConfig(model_name='internvl2_5'))
response = pipe(('Explain the image.', image))
print(response.text)O Ovis2 é uma série de modelos multimodais de linguagem (MLLMs) desenvolvidos pela AIDC-AI. Eles foram projetados para alinhar de forma eficiente embeddings visuais e textuais. O modelo Ovis2-34B utiliza o aimv2-1B-patch14-448 como codificador de visão e o Qwen2.5-32B-Instruct como modelo de linguagem, totalizando 34 bilhões de parâmetros. Ele suporta comprimento de contexto máximo de 32.768 tokens e usa precisão bfloat16 para processamento eficiente.
O Ovis2-34B mostrou desempenho consistente em diversos benchmarks, alcançando:
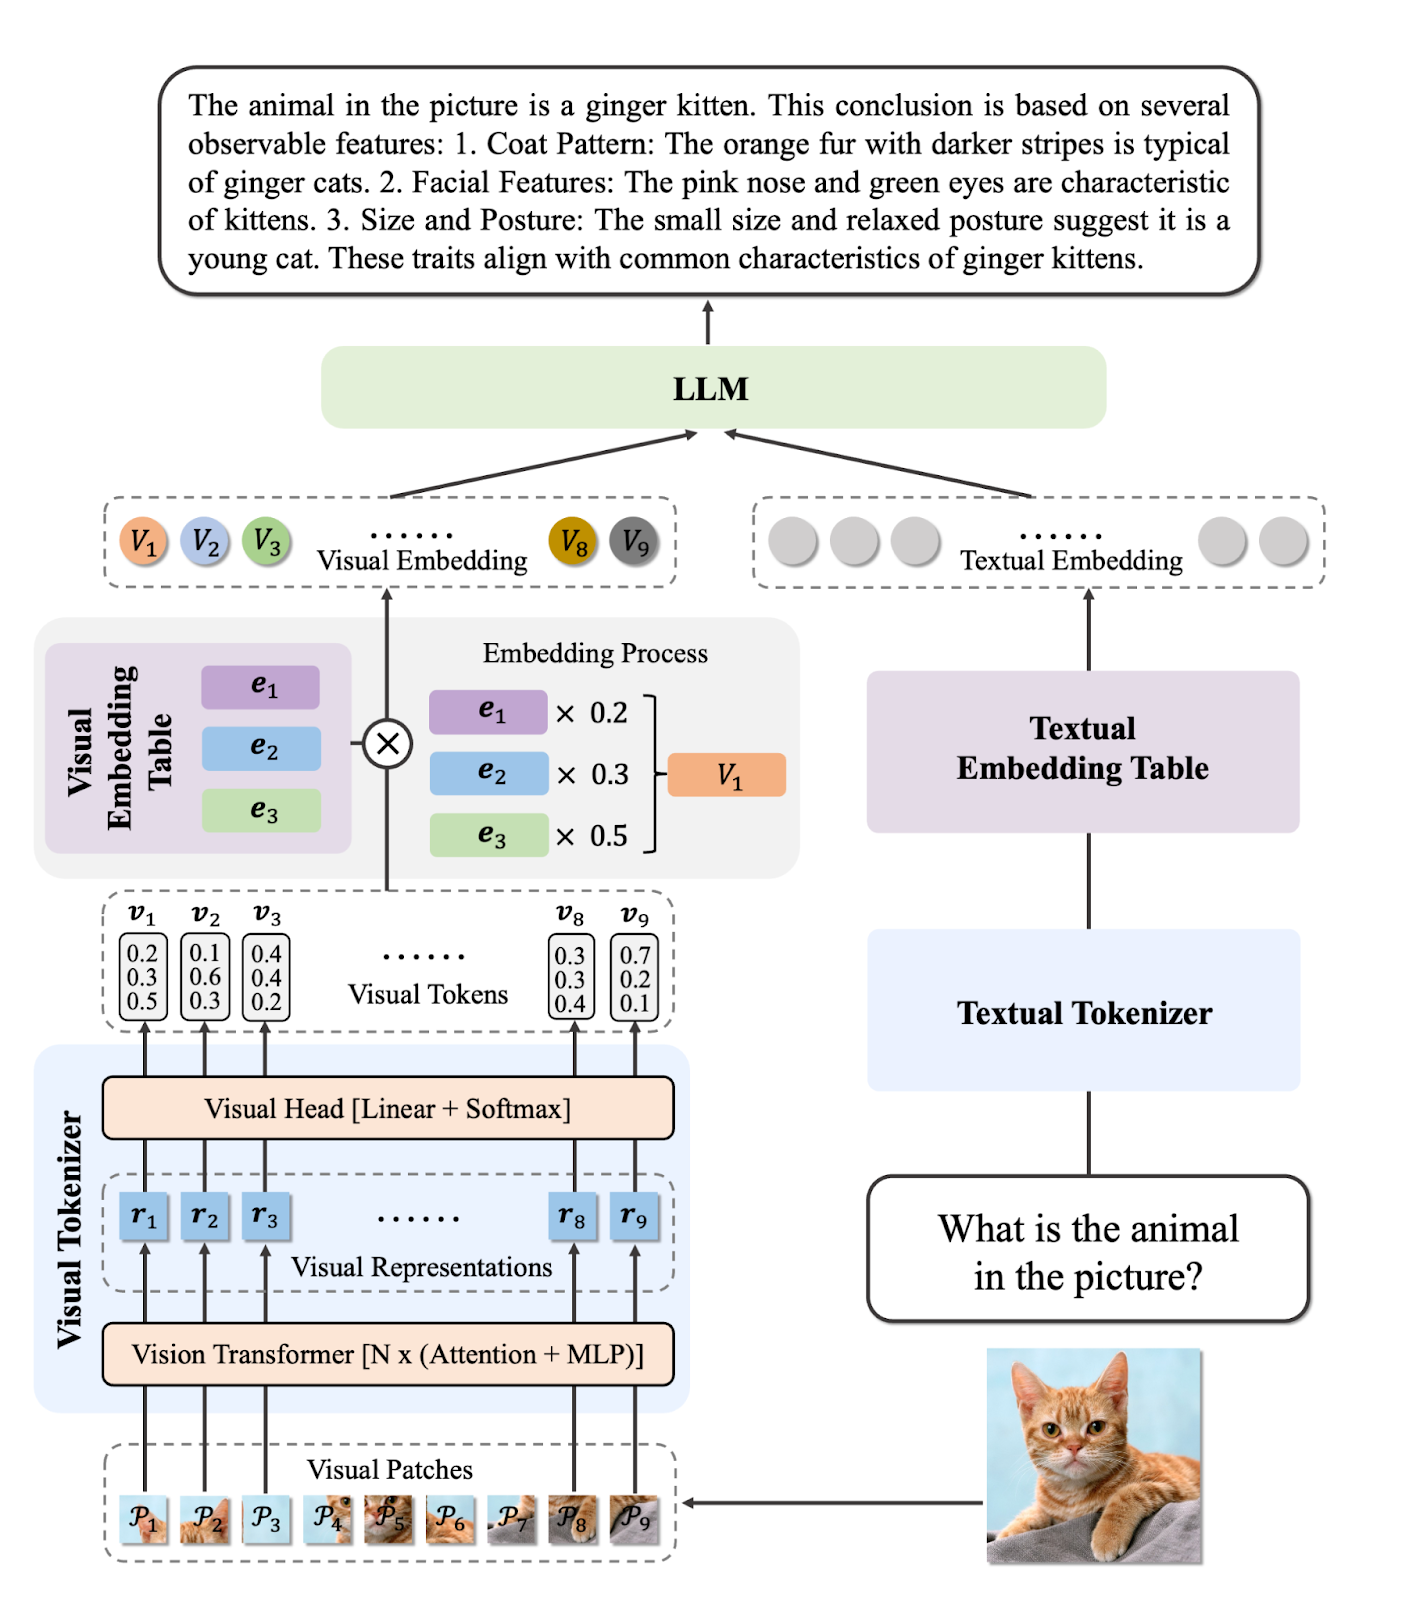
Fonte: AIDC-AI/Ovis2-34B · Hugging Face
Exemplo de uso:
import torch
from PIL import Image
from transformers import AutoModelForCausalLM

# load model
model = AutoModelForCausalLM.from_pretrained("AIDC-AI/Ovis2-34B",
                                             torch_dtype=torch.bfloat16,
                                             multimodal_max_length=32768,
                                             trust_remote_code=True).cuda()
text_tokenizer = model.get_text_tokenizer()
visual_tokenizer = model.get_visual_tokenizer()

# single-image input
image_path = '/data/images/example_1.jpg'
images = [Image.open(image_path)]
max_partition = 9
text = 'Describe the image.'
query = f'<image>\n{text}'


# format conversation
prompt, input_ids, pixel_values = model.preprocess_inputs(query, images, max_partition=max_partition)
attention_mask = torch.ne(input_ids, text_tokenizer.pad_token_id)
input_ids = input_ids.unsqueeze(0).to(device=model.device)
attention_mask = attention_mask.unsqueeze(0).to(device=model.device)
if pixel_values is not None:
    pixel_values = pixel_values.to(dtype=visual_tokenizer.dtype, device=visual_tokenizer.device)
pixel_values = [pixel_values]

# generate output
with torch.inference_mode():
    gen_kwargs = dict(
        max_new_tokens=1024,
        do_sample=False,
        top_p=None,
        top_k=None,
        temperature=None,
        repetition_penalty=None,
        eos_token_id=model.generation_config.eos_token_id,
        pad_token_id=text_tokenizer.pad_token_id,
        use_cache=True
    )
    output_ids = model.generate(input_ids, pixel_values=pixel_values, attention_mask=attention_mask, **gen_kwargs)[0]
    output = text_tokenizer.decode(output_ids, skip_special_tokens=True)
print(f'Output:\n{output}')Qwen2.5-VL-72B-Instruct é um modelo multimodal de linguagem da família Qwen, projetado para entender e processar informações visuais e textuais. Muitos MLLMs open-source se baseiam nele, evidenciando o papel relevante da série Qwen no avanço da pesquisa em IA.
O Qwen2.5-VL-72B-Instruct apresenta desempenho robusto em diversos benchmarks, incluindo compreensão de imagens e vídeos e funções de agente. Ele marca 70,2 no MMMUval, 74,8 no MathVista_MINI e 70,8 no MMStar.
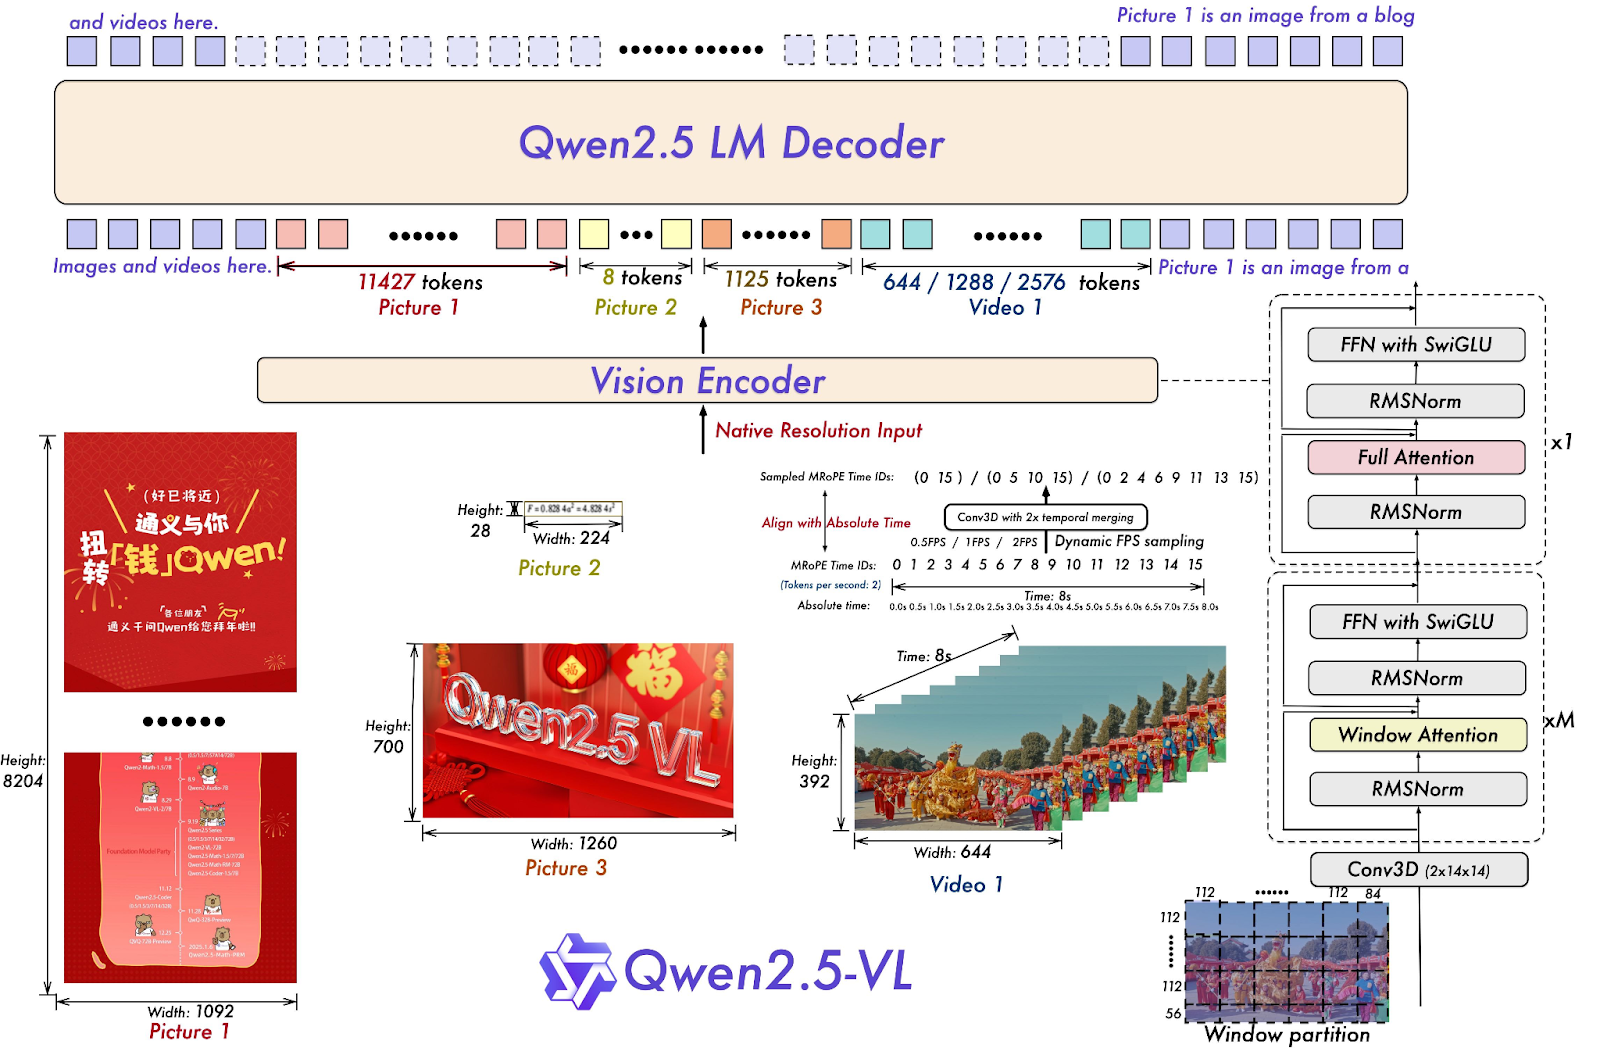
Fonte: Qwen/Qwen2.5-VL-72B-Instruct · Hugging Face
Exemplo de uso:
# pip install qwen-vl-utils[decord]==0.0.8

from transformers import Qwen2_5_VLForConditionalGeneration, AutoTokenizer, AutoProcessor
from qwen_vl_utils import process_vision_info

# default: Load the model on the available device(s)
model = Qwen2_5_VLForConditionalGeneration.from_pretrained(
    "Qwen/Qwen2.5-VL-72B-Instruct", torch_dtype="auto", device_map="auto"
)
# default processer
processor = AutoProcessor.from_pretrained("Qwen2.5-VL-72B-Instruct")


messages = [
    {
        "role": "user",
        "content": [
            {
                "type": "image",
                "image": "https://qianwen-res.oss-cn-beijing.aliyuncs.com/Qwen-VL/assets/demo.jpeg",
            },
            {"type": "text", "text": "Describe this image."},
        ],
    }
]

# Preparation for inference
text = processor.apply_chat_template(
    messages, tokenize=False, add_generation_prompt=True
)
image_inputs, video_inputs = process_vision_info(messages)
inputs = processor(
    text=[text],
    images=image_inputs,
    videos=video_inputs,
    padding=True,
    return_tensors="pt",
)
inputs = inputs.to("cuda")

# Inference: Generation of the output
generated_ids = model.generate(**inputs, max_new_tokens=128)
generated_ids_trimmed = [
    out_ids[len(in_ids) :] for in_ids, out_ids in zip(inputs.input_ids, generated_ids)
]
output_text = processor.batch_decode(
    generated_ids_trimmed, skip_special_tokens=True, clean_up_tokenization_spaces=False
)
print(output_text)o3 da OpenAI é um novo modelo voltado para raciocínio, projetado para oferecer mais inteligência, custos menores e uso de tokens mais eficiente nas aplicações. Ele representa uma nova geração de modelos que priorizam capacidades avançadas de raciocínio.
Esse modelo define um novo patamar para tarefas de matemática, ciência, programação e raciocínio visual. Em diferentes benchmarks de visão, supera o o4-min e o o1 e empata com o o3 Pro.
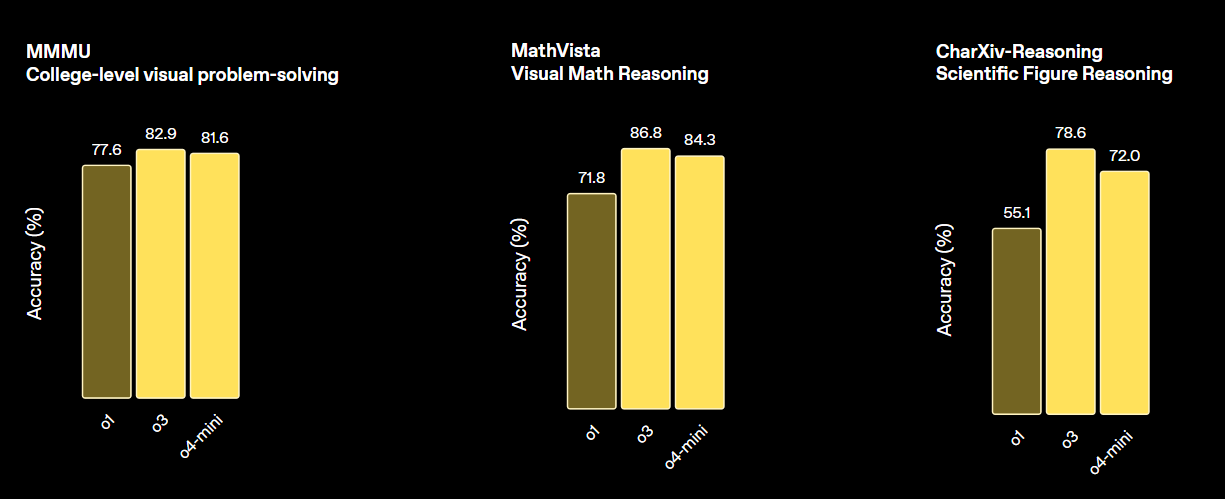
Fonte: Introducing OpenAI o3 and o4-mini | OpenAI
Exemplo de uso:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="o3-2025-04-16",
    input=[{
        "role": "user",
        "content": [
            {"type": "input_text", "text": "what's in this image?"},
            {
                "type": "input_image",
                "image_url": "https://upload.wikimedia.org/wikipedia/commons/thumb/d/dd/Gfp-wisconsin-madison-the-nature-boardwalk.jpg/2560px-Gfp-wisconsin-madison-the-nature-boardwalk.jpg",
            },
        ],
    }],
)

print(response.output_text)GPT-4.1 é uma nova família de modelos sem cadeia de raciocínio explícita, que inclui GPT-4.1, GPT-4.1 Mini e GPT-4.1 Nano. Esses modelos superaram seus predecessores, GPT-4o e GPT-4o Mini, em diversos benchmarks.
O GPT-4.1 mantém fortes capacidades de visão, com melhorias na análise de gráficos, diagramas e matemática visual. Ele se destaca em tarefas como contagem de objetos, VQA (visual question answering) e diferentes formas de OCR.
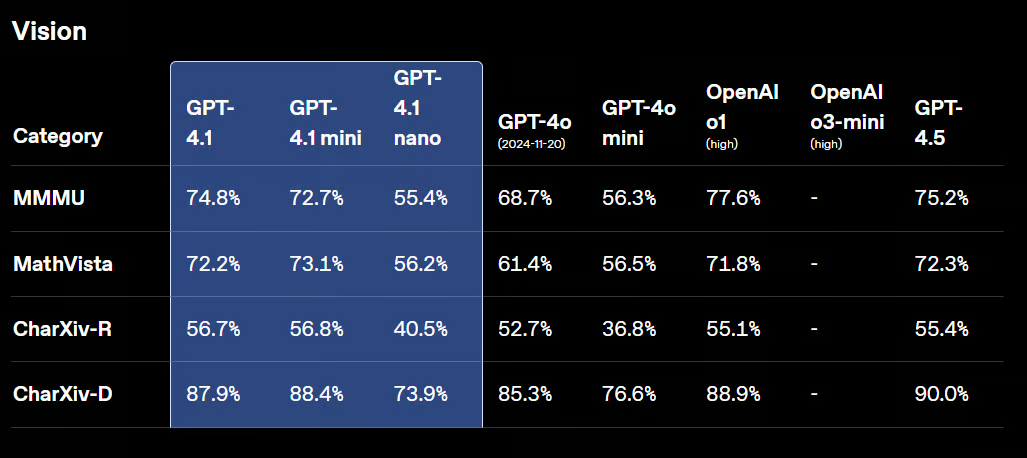
Fonte: Introducing GPT-4.1 in the API | OpenAI
Exemplo de uso:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-4.1-2025-04-14",
    input=[{
        "role": "user",
        "content": [
            {"type": "input_text", "text": "what's in this image?"},
            {
                "type": "input_image",
                "image_url": "https://upload.wikimedia.org/wikipedia/commons/thumb/d/dd/Gfp-wisconsin-madison-the-nature-boardwalk.jpg/2560px-Gfp-wisconsin-madison-the-nature-boardwalk.jpg",
            },
        ],
    }],
)

print(response.output_text)A Anthropic apresentou a nova geração dos modelos Claude: Claude 4 Opus e Claude 4 Sonnet. Esses modelos chegam para definir novos padrões em programação, raciocínio avançado e capacidades gerais de IA.
Eles trazem visão aprimorada para entender imagens e, a partir delas, gerar código ou fornecer informações. Apesar de ser, essencialmente, um modelo de código, ele também é multimodal e entende diferentes formatos de arquivo.
Na tabela comparativa abaixo, você verá que o Claude 4 supera praticamente todos os modelos de ponta, com exceção do GPT-3 da OpenAI, especialmente em raciocínio de visualizações e VQA.
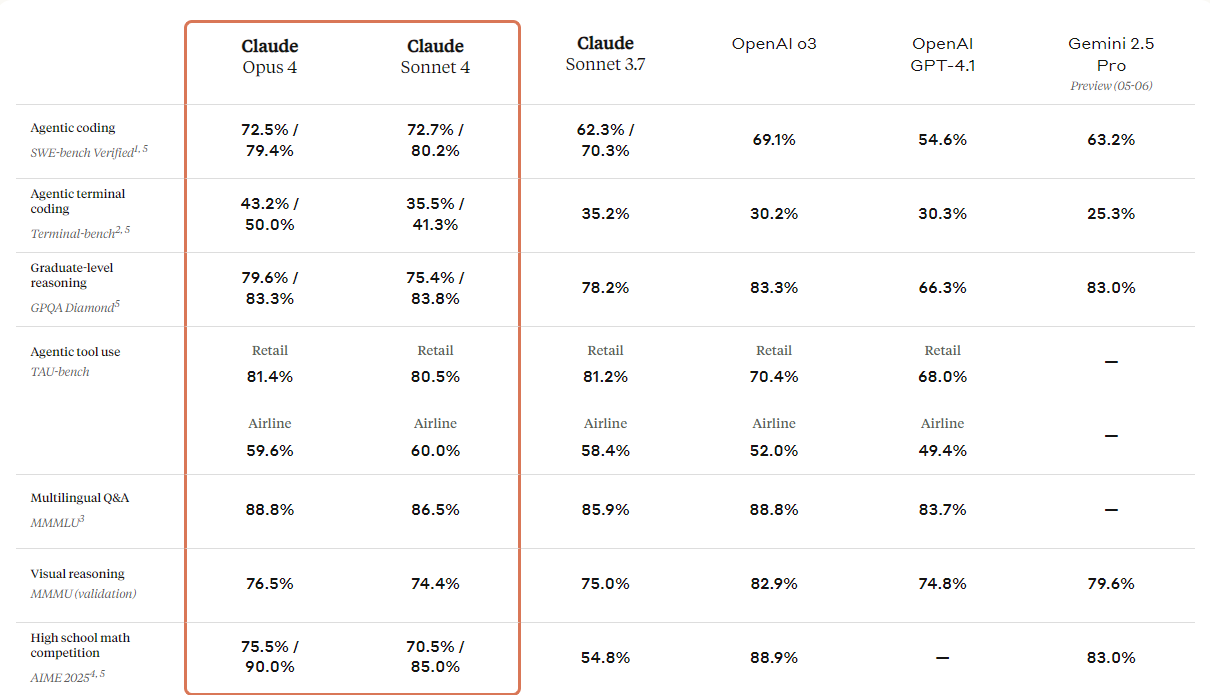
Fonte: Introducing Claude 4 \ Anthropic
Exemplo de uso:
import anthropic

client = anthropic.Anthropic()
message = client.messages.create(
    model="claude-sonnet-4-20250514",
    max_tokens=1024,
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image",
                    "source": {
                        "type": "url",
                        "url": "https://upload.wikimedia.org/wikipedia/commons/a/a7/Camponotus_flavomarginatus_ant.jpg",
                    },
                },
                {
                    "type": "text",
                    "text": "Describe this image."
                }
            ],
        }
    ],
)
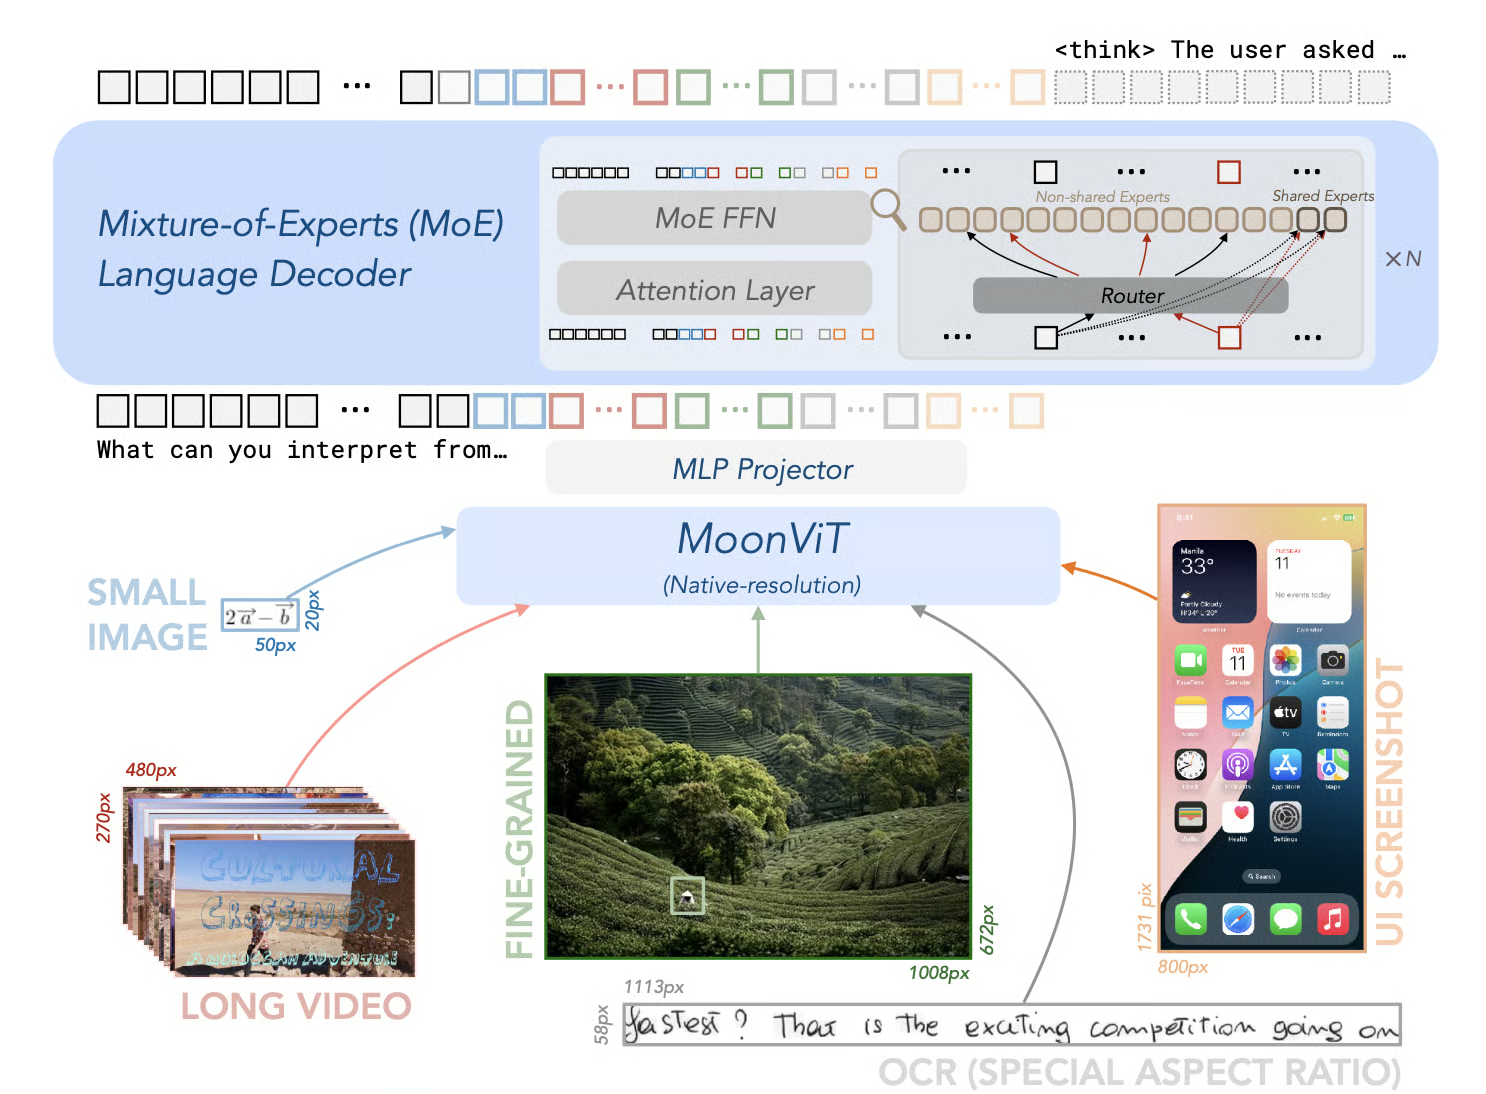
print(message)O Kimi-VL-A3B-Thinking-2506 é um modelo open-source que marca um avanço significativo em IA multimodal. Ele se destaca em benchmarks de raciocínio multimodal, com ótimas pontuações: 56,9 no MathVision, 80,1 no MathVista, 46,3 no MMMU-Pro e 64,0 no MMMU, reduzindo em média 20% o seu "comprimento de pensamento".
Além do raciocínio, a versão 2506 apresenta melhor percepção e entendimento visual geral. Ela iguala — e às vezes supera — modelos sem cadeia de pensamento explícita em benchmarks como MMBench-EN-v1.1 (84,4), MMStar (70,4), RealWorldQA (70,0) e MMVet (78,4).
Fonte: MoonshotAI/Kimi-VL: Kimi-VL
Exemplo de uso:
from transformers import AutoProcessor
from vllm import LLM, SamplingParams

model_path = "moonshotai/Kimi-VL-A3B-Thinking-2506"
llm = LLM(
    model_path,
    trust_remote_code=True,
    max_num_seqs=8,
    max_model_len=131072,
    limit_mm_per_prompt={"image": 256}
)

processor = AutoProcessor.from_pretrained(model_path, trust_remote_code=True)

sampling_params = SamplingParams(max_tokens=32768, temperature=0.8)


import requests
from PIL import Image

def extract_thinking_and_summary(text: str, bot: str = "◁think▷", eot: str = "◁/think▷") -> str:
    if bot in text and eot not in text:
        return ""
    if eot in text:
        return text[text.index(bot) + len(bot):text.index(eot)].strip(), text[text.index(eot) + len(eot) :].strip()
    return "", text

OUTPUT_FORMAT = "--------Thinking--------\n{thinking}\n\n--------Summary--------\n{summary}"

url = "https://huggingface.co/spaces/moonshotai/Kimi-VL-A3B-Thinking/resolve/main/images/demo6.jpeg"
image = Image.open(requests.get(url,stream=True).raw)

messages = [
    {"role": "user", "content": [{"type": "image", "image": ""}, {"type": "text", "text": "What kind of cat is this? Answer with one word."}]}
]
text = processor.apply_chat_template(messages, add_generation_prompt=True, return_tensors="pt")

outputs = llm.generate([{"prompt": text, "multi_modal_data": {"image": image}}], sampling_params=sampling_params)
generated_text = outputs[0].outputs[0].text

thinking, summary = extract_thinking_and_summary(generated_text)
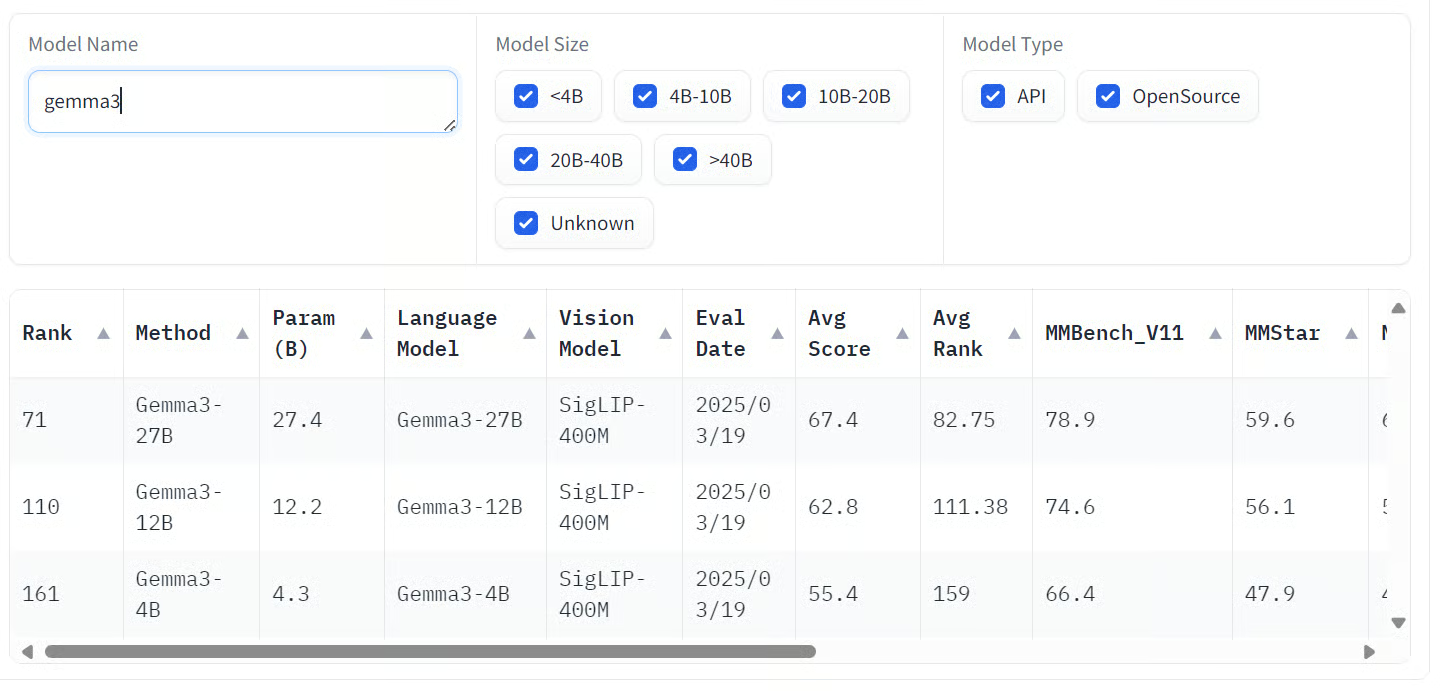
print(OUTPUT_FORMAT.format(thinking=thinking, summary=summary))Gemma 3 é uma família de modelos multimodais de IA desenvolvidos pelo Google, capazes de processar entradas de texto e imagem para gerar saídas em texto. Os modelos estão disponíveis em vários tamanhos: 1B, 4B, 12B e 27B, atendendo a diferentes requisitos de hardware e desempenho.
A variante maior, Gemma 3 27B, apresentou desempenho impressionante em avaliações de preferência humana, superando até modelos maiores como Llama 3-405B e DeepSeek-V3.
Os modelos mostram grande capacidade em vários benchmarks. Em tarefas multimodais, alcançam pontuações de destaque em testes como COCOcap (116), DocVQA (85,6), MMMU (56,1) e VQAv2 (72,9).
Fonte: Open VLM Leaderboard
Exemplo de uso:
# pip install accelerate

from transformers import AutoProcessor, Gemma3ForConditionalGeneration
from PIL import Image
import requests
import torch

model_id = "google/gemma-3-27b-it"

model = Gemma3ForConditionalGeneration.from_pretrained(
    model_id, device_map="auto"
).eval()

processor = AutoProcessor.from_pretrained(model_id)

messages = [
    {
        "role": "system",
        "content": [{"type": "text", "text": "You are a helpful assistant."}]
    },
    {
        "role": "user",
        "content": [
            {"type": "image", "image": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/bee.jpg"},
            {"type": "text", "text": "Describe this image in detail."}
        ]
    }
]

inputs = processor.apply_chat_template(
    messages, add_generation_prompt=True, tokenize=True,
    return_dict=True, return_tensors="pt"
).to(model.device, dtype=torch.bfloat16)

input_len = inputs["input_ids"].shape[-1]

with torch.inference_mode():
    generation = model.generate(**inputs, max_new_tokens=100, do_sample=False)
    generation = generation[0][input_len:]

decoded = processor.decode(generation, skip_special_tokens=True)
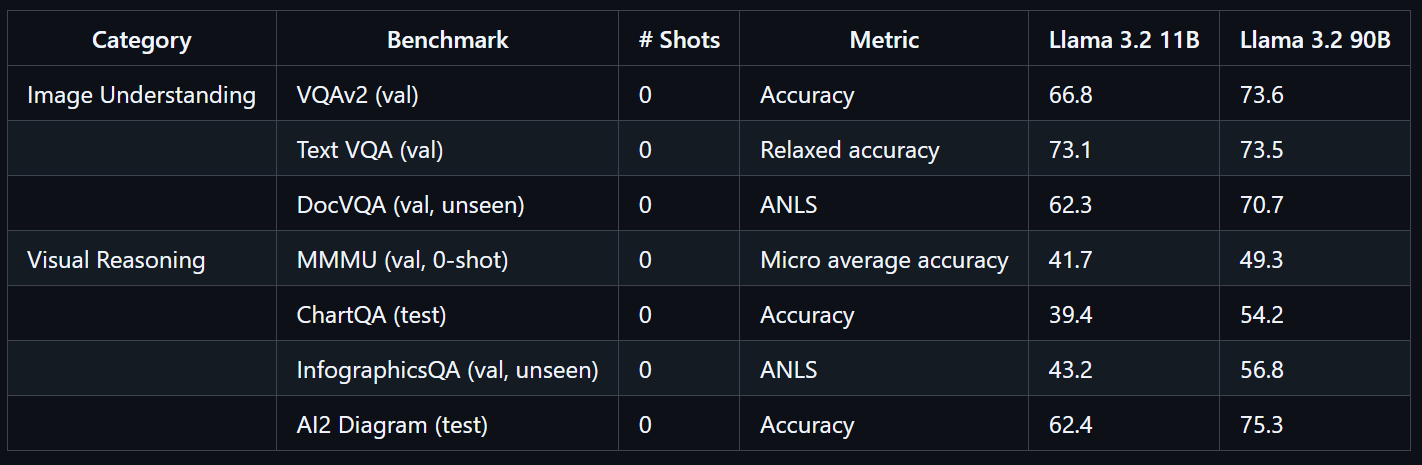
print(decoded)O Llama 3.2 90B Vision Instruct é um modelo multimodal avançado desenvolvido pela Meta. Ele é voltado para tarefas de reconhecimento visual, raciocínio sobre imagens e geração de legendas.
Construído sobre a versão apenas texto do Llama 3.1, o Llama 3.2 90B Vision Instruct incorpora um adaptador de visão treinado separadamente, permitindo processar imagens e texto como entrada e gerar saídas em texto com precisão.
Treinado em larga escala, o Llama 3.2 90B Vision exigiu 8,85 milhões de horas de GPU. Ele apresenta desempenho excepcional em benchmarks como VQAv2 (73,6), Text VQA (73,5) e DocVQA (70,7).
Fonte: llama-models
Exemplo de uso:
import requests
import torch
from PIL import Image
from transformers import MllamaForConditionalGeneration, AutoProcessor

model_id = "meta-llama/Llama-3.2-90B-Vision-Instruct"

model = MllamaForConditionalGeneration.from_pretrained(
    model_id,
    torch_dtype=torch.bfloat16,
    device_map="auto",
)
processor = AutoProcessor.from_pretrained(model_id)

url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/0052a70beed5bf71b92610a43a52df6d286cd5f3/diffusers/rabbit.jpg"
image = Image.open(requests.get(url, stream=True).raw)

messages = [
    {"role": "user", "content": [
        {"type": "image"},
        {"type": "text", "text": "If I had to write a haiku for this one, it would be: "}
    ]}
]
input_text = processor.apply_chat_template(messages, add_generation_prompt=True)
inputs = processor(
    image,
    input_text,
    add_special_tokens=False,
    return_tensors="pt",
).to(model.device)

output = model.generate(**inputs, max_new_tokens=30)
print(processor.decode(output[0]))
Raciocínio visual com gráficos também é um ponto forte do modelo mais recente da Meta, Muse Spark.
Os modelos de visão e linguagem estão transformando a forma como interagimos com informações visuais e textuais, entregando precisão e flexibilidade notáveis em diversos setores. Ao unir visão computacional e processamento de linguagem natural, eles viabilizam aplicações que vão de detecção avançada de objetos a assistentes visuais intuitivos.
Se privacidade e segurança são prioridades no seu caso de uso, vale muito explorar modelos open-source de visão e linguagem. Executá-los localmente dá controle total sobre seus dados, ideal para ambientes sensíveis. Além disso, VLMs open-source são altamente adaptáveis: muitos atingem ótimos resultados com fine-tuning feito em apenas algumas centenas de amostras, ajustando-se às suas necessidades.
Modelos proprietários, por sua vez, oferecem acesso confiável e econômico ao estado da arte. Costumam ser muito precisos e podem ser integrados ao seu fluxo com poucas linhas de código — acessíveis mesmo para times sem expertise profunda em IA.
Para aprender mais sobre modelos de visão e linguagem, confira estes recursos:
Principais cursos da DataCamp
Curso
Curso
Programa
blog
Bhavishya Pandit
8 min
blog
Dr Ana Rojo-Echeburúa
9 min
blog
Abid Ali Awan
13 min
blog
Hesam Sheikh Hassani
15 min
blog
Richie Cotton
7 min
Tutorial
Arunn Thevapalan
12 min