Astăzi, Anthropic a anunțat Fable 5.2 pentru toată lumea și Mythos 5.2 pentru organizații verificate. Este același model de bază, dar versiunea Fable are măsuri suplimentare de siguranță pentru securitate cibernetică și biologie.
Schimbările majore sunt:
- un preț mai mic,
- ieșire mai rapidă și
- sărituri mari pe cele mai grele benchmark-uri ale Anthropic.
Mai exact, Fable 5.2 costă cu 20% mai puțin decât Fable 5.1, generează ieșiri cu până la 30% mai rapid și depășește GPT-6 Astra și Gemini 4 Carbon pe majoritatea rândurilor din tabelul de benchmark-uri Anthropic.
În acest articol, acopăr ce e nou în Fable 5.2 și Mythos 5.2, cum performează pe benchmark-uri, cât costă și cum să decizi dacă ai nevoie de ele în locul Claude Opus 5.5.
Ce este Claude Fable 5.2?
Claude Fable 5.2 este cel mai capabil model disponibil în general de la Anthropic. Este construit pentru muncă tehnică lungă și solicitantă: migrarea unor codebase-uri mari, rulări de agenți pe mai multe zile, probleme de cercetare și proiectare inginerească.
Fable 5.2 poate lucra și alături de modelele mai mici, fie ca un consilier la care acestea apelează pentru probleme dificile, fie ca un orchestrator care transmite subtask-uri mai simple către ele.
Fable 5.2 păstrează ferestra de context de 1M tokeni și ieșirea maximă de 128K a predecesorului său, iar data cunoașterii sale este iunie 2026.
Ce este Claude Mythos 5.2?
Claude Mythos 5.2 este același model ca Fable 5.2, dar fără măsurile de siguranță care blochează majoritatea activităților de securitate cibernetică și biologie la nivel de cercetare. De fapt, Mythos 5.2 este cel mai capabil model al Anthropic pentru inginerie de securitate cibernetică. Deoarece aceste capabilități sunt cu utilizare duală, Anthropic oferă Mythos 5.2 doar organizațiilor verificate prin Cyber Verification Program și Life Sciences Verification Program.
Ce e nou în Claude Fable 5.2?
Fable există abia din iunie, când Anthropic a lansat Fable 5. De atunci au fost două versiuni punctuale, Fable 5.1 în septembrie și acum Fable 5.2, și niciuna nu a adăugat prea multe funcții noi. Ambele au făcut în principal modelul mai ieftin, mai rapid și mai puternic, deși câștigurile de performanță n-au fost mici: de exemplu, Fable 5.2 mai mult decât dublează scorul lui Fable 5.1 pe Remote Labor Index.
Diferența mai mare între cele două versiuni ține de modul în care îți este permis să folosești modelul. Cu Fable 5.1, Anthropic a îngustat măsurile de siguranță pentru securitate cibernetică și a început să permită folosirea modelului pentru a găsi vulnerabilități software, dar nu și pentru a scrie exploit-uri pentru ele, iar odată cu lansarea a anunțat Enterprise Frontier Safeguards, o opțiune de a-ți păstra datele în propriul cloud. Schimbările de protecții în Fable 5.2 sunt mai mici: blochează mai puține cereri, dar aceleași tipuri de sarcini rămân interzise.
Noile moduri în care Anthropic sugerează să-l folosești, cum ar fi ca Fable 5.2 să consilieze modelele Claude mai mici, nu sunt nici ele noi, din moment ce instrumentul de consiliere al Anthropic deja suporta Fable 5 și 5.1. Iar demonstrațiile de la lansare, precum sistemul de operare construit dintr-un folder gol, arată un model mai puternic care face lucruri mai dificile, nu funcții noi pe care le poți activa.
Totuși, dacă ar fi să indic lucruri noi, iată ce aș menționa:
Un preț mai mic
Fable 5.2 costă 8 $ per milion de tokeni de intrare și 40 $ per milion de tokeni de ieșire, cu 20% mai puțin decât prețurile de 10 $/50 $ ale lui Fable 5.1. Aceeași reducere de 20% se aplică la citirile din cache (0,20 $), la scrierile în cache și la procesarea batch. Vezi secțiunea de prețuri de mai jos pentru detalii complete.
Ieșire mai rapidă și mod rapid pentru Fable
Ieșirea este cu până la 30% mai rapidă decât la Fable 5.1, ceea ce contează pe o rulare lungă de agenți. Fable suportă acum și mod rapid, care accelerează ieșirea de până la 2,5x la un preț dublu (16 $/80 $).
Rezultate mai bune cu efort mai mic
Asta este schimbarea cel mai probabil să-ți afecteze factura. La efort ridicat, Fable 5.2 obține 45,3% pe FrontierCode 2.0, cam la nivelul celui mai bun scor al lui Opus 5.5, la aproximativ jumătate din costul per sarcină. La efort scăzut, egalează scorul de top al lui Opus 5.5 pe Humanity's Last Exam la mai puțin de o zecime din costul per sarcină. Concluzia mea: dacă treci de la Opus 5.5, pornește Fable 5.2 la un nivel de efort mai mic.
Mai puține cereri blocate
Fable 5.2 ar trebui să lovească aproximativ cu 55% mai puține blocări de siguranță decât Fable 5.1 (cam cu 60% mai puține la securitate cibernetică și 40% la biologie). E important dacă refuzurile lui Fable 5.1 te încurcau, dar categoriile blocate nu s-au schimbat: testarea de penetrare, generarea de exploit-uri și majoritatea activităților de biologie la nivel de cercetare încă sunt redirecționate către modelele Claude mai vechi.
Cum se descurcă Claude Fable 5.2 pe benchmark-uri?
Iată rezultatele principale. Toate provin din tabelul de lansare al Anthropic, deci citește-le ca argumentul Anthropic pentru model, nu ca rezultate independente. Scorurile Claude au fost rulate cu măsurile de siguranță activate. Dacă nu e menționat altfel, fiecare model este prezentat la cel mai înalt nivel de efort disponibil.
| Benchmark | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|
| FrontierCode 2.0 (agentic coding) | 49,1% | 32,4% | 45,5% | 42,8% | 41,1% |
| FrontierSWE v2 (agentic coding) | 69,9% | 56,3% | 62,3% | 65,5% | 61,2% |
| AutomationBench (fluxuri de lucru business) | 51,4% | 31,4% | 42,5% | 41,4% | 53,9% |
| Terminal-Bench-Science 0.1 | 74,6% | 52,6% | 58,7% | 68,1% | 64,8% |
| OSWorld 2.1 (utilizare computer) | 89,3% | 83,5% | 87,2% | 79,5% | 81,5% |
| RoboDojo Sim (robotică) | 64,9% | 27,6% | 39,4% | 29,8% | Not reported |
| AA-Briefcase v1.1 (muncă de cunoaștere) | 66,1% | 61,5% | 61,2% | 52,0% | 61,8% |
| Remote Labor Index (muncă de cunoaștere) | 41,3% | 17,9% | 21,3% | 20,8% | Not reported |
| Humanity's Last Exam (cu instrumente) | 74,2% | 65,6% | 67,7% | 57,2% | Not reported |
| WANDR (căutare agentică) | 82,1% | 68,7% | 72,3% | Not reported | Not reported |
| Chartography (fără instrumente) | 73,4% | 44,8% | 64,4% | 71,0% | 72,5% |
Programare agentică
Fable 5.2 conduce ambele benchmark-uri de cod din tabel. Pe FrontierCode 2.0, care măsoară dacă mentenanții open-source ar integra modificările de cod ale unui model, obține 49,1%, cel mai mare din tabel și mult peste 32,4% ale lui Fable 5.1. Pe FrontierSWE v2, obține 69,9%, peste GPT-6 Astra (65,5%) și Opus 5.5 (62,3%).
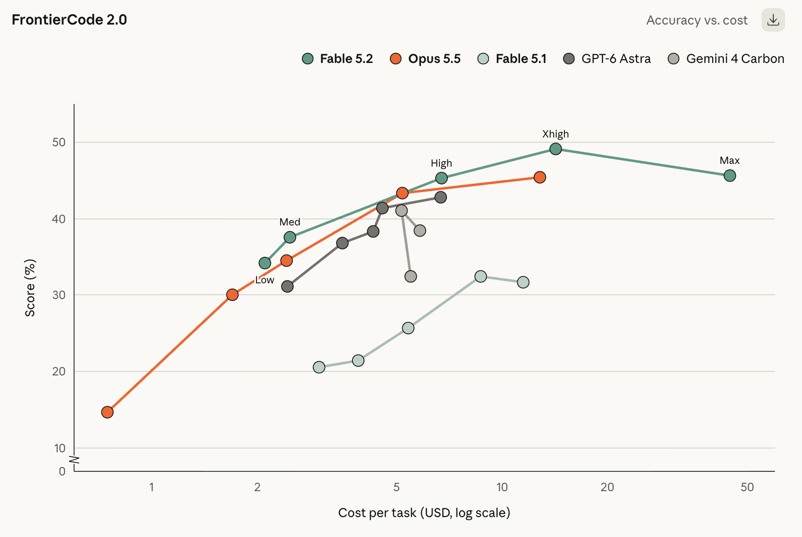
Exemplele de la lansare merg în aceeași direcție: agenți care rulau o versiune timpurie a lui Fable 5.2 au migrat un serviciu de producție din Python în Rust, iar acum pornește de aproximativ 26 de ori mai repede.
Muncă de cunoaștere și cercetare
Cea mai mare creștere relativă este pe Remote Labor Index, care măsoară cât de bine finalizează un model proiecte reale de tip freelancing. Fable 5.2 obține 41,3%, aproximativ dublu față de Opus 5.5 (21,3%) și GPT-6 Astra (20,8%). De asemenea, conduce la Humanity's Last Exam cu instrumente (74,2%) și la Terminal-Bench-Science (74,6%, sau 75,3% pentru Mythos 5.2).
Automatizarea în business e singura zonă unde rămâne în urmă. Pe AutomationBench, Gemini 4 Carbon obține 53,9% față de 51,4% ale lui Fable 5.2, deși Fable 5.2 e tot mult înaintea lui Fable 5.1 (31,4%).
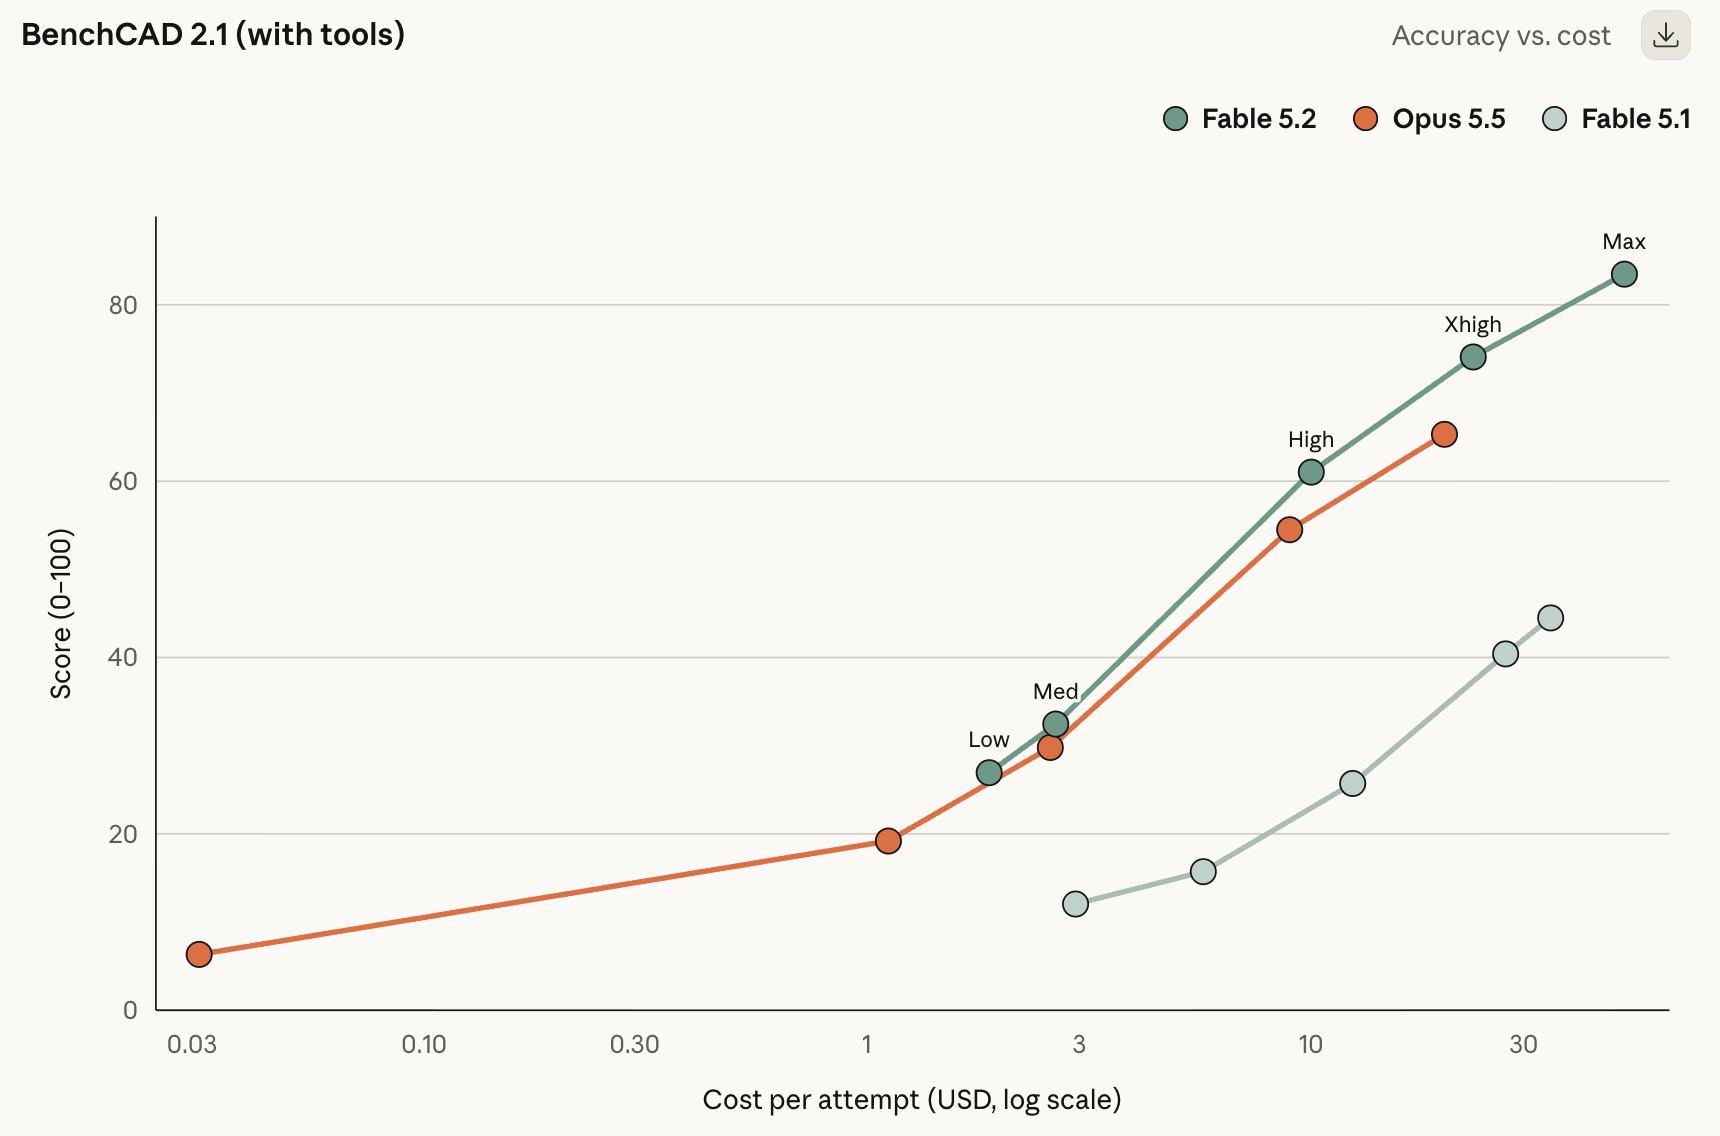
În afara tabelului principal, Fable 5.2 a obținut 83,5 pe benchmark-ul de inginerie hardware BenchCAD 2.1, comparativ cu 65,3 pentru Opus 5.5. I se atribuie și rezolvarea a două probleme deschise în fizica găurilor negre, iar rezultatele sunt publicate ca preprinturi pe care alți fizicieni le pot verifica.
Utilizare computer, robotică și viziune
Fable 5.2 obține 89,3% pe OSWorld 2.1, înaintea lui Opus 5.5 (87,2%) și GPT-6 Astra (79,5%). Săritura la robotică este cea mai mare din tabel: 64,9% pe RoboDojo Sim, mai mult decât dublu față de Fable 5.1 și GPT-6 Astra. La Chartography, care testează citirea grafice lor fără instrumente, îl depășește la limită pe Gemini 4 Carbon și GPT-6 Astra, după ce Fable 5.1 rămăsese mult în urmă la 44,8%.
Securitate cibernetică și biologie (Mythos 5.2)
Rândurile de securitate și biologie sunt pentru Mythos 5.2, deoarece măsurile de siguranță ale lui Fable 5.2 blochează majoritatea acestor sarcini. Mythos 5.2 obține 76,3% pe CyScenarioBench (vs 61,7% pentru Mythos 5.1), 89,6% pe CVE Rediscovery (vs 78,3%) și 85,1% pe o sarcină de proiectare a unui protein binder în 24 de ore (vs 79,1%). Aici nu există o comparație corectă cu modelul de securitate al OpenAI, deoarece fiecare laborator și-a rulat propriile sarcini CyScenarioBench.
Ce e cu Ultima Teoremă a lui Fermat?
O echipă de agenți Fable 5.2 a formalizat demonstrația pentru Ultima Teoremă a lui Fermat în asistentul de demonstrații Lean în 30 de ore. Poate te întrebi: nu a fost teorema dovedită acum trei decenii, deci ce mai e de făcut?
Teorema nu mai e o noutate
Ultima Teoremă a lui Fermat spune că nu există numere întregi pozitive a, b și c pentru care an + bn = cn pentru niciun n mai mare decât 2. Pentru n = 2, există multe soluții, ca 32 + 42 = 52 (9 + 16 = 25). Dar dacă încerci cu cuburi, obții doar ratări la limită: 63 + 83 = 728, cu unu mai puțin decât 93 = 729.
Pierre de Fermat a pretins o demonstrație în 1637, dar nu a scris-o niciodată, iar problema a rămas nerezolvată mai bine de 350 de ani, până când Andrew Wiles a dovedit-o la mijlocul anilor 1990, cu ajutorul lui Richard Taylor.
Demonstrația lui Wiles are peste 100 de pagini și se sprijină pe decenii de teorie a numerelor avansată, așa că foarte puțini o pot verifica cap-coadă. Lean este un asistent de demonstrații: un limbaj de programare în care scrii demonstrația ca pe un cod, iar software-ul verifică fiecare pas logic până la axiomele de bază ale matematicii. Dacă demonstrația se compilează, e corectă. „Formalizarea” unei teoreme înseamnă traducerea demonstrației scrise de om într-o formă verificabilă de către mașină.
Pentru Ultima Teoremă a lui Fermat, e o muncă uriașă, pentru că o mare parte din matematica pe care se bazează demonstrația nu fusese scrisă în Lean. Matematicianul Kevin Buzzard a început un proiect comunitar pentru asta în 2024.
De ce e interesant pentru un model de AI
Majoritatea rezultatelor AI sunt evaluate de oameni sau prin benchmark-uri care testează doar o parte din răspuns. O demonstrație Lean e diferită: verificatorul acceptă fiecare pas sau nu, deci nu poți greși subtil. Asta o face un test neobișnuit de curat al capacității unui model de a duce un proiect foarte lung și foarte greu până la un final verificat.
Nu este prima dată când Claude face asta. În septembrie, Anthropic a publicat prima demonstrație completă verificată pe calculator a teoremei, scrisă de zeci de agenți care rulau un model intern de cercetare aproximativ comparabil cu Fable 5.1. Acel efort a durat 11 zile și circa șase miliarde de tokeni de ieșire, a produs 13 milioane de linii de Lean și s-a bazat parțial pe părți ale proiectului lui Buzzard. Fable 5.2 a făcut-o în 30 de ore, cu ajutor uman minim.
Rezervele
- Nu adaugă nimic matematicii. Buzzard a spus același lucru despre prima formalizare a Anthropic.
- Fable 5.2 a primit o listă de enunțuri intermediare ale teoremelor pentru a-și urmări progresul. E o hartă a ceea ce trebuie dovedit, dar nu a modului în care se dovedește.
- Nu am găsit încă nicio evaluare externă a noii demonstrații, deci deocamdată cifra de 30 de ore și comparația cu Opus 5.5 sunt afirmațiile Anthropic.
Partea cea mai grăitoare, însă, este ce s-a întâmplat când Anthropic i-a dat lui Claude Opus 5.5 aceeași sarcină.
Claude Fable 5.2 vs. Claude Opus 5.5
Compararea a două modele înseamnă de obicei să citești scoruri pe benchmark-uri și să încerci să deduci cum ar arăta diferența în practică. De data asta, apreciez că Anthropic a pornit de la o poveste, care face diferența mai evidentă.
În aceeași configurație Lean cu 1.000 de agenți, Opus 5.5 a finalizat 26% din demonstrația pentru Ultima Teoremă a lui Fermat în 18 ore și abia a mai progresat după aceea. Fable 5.2 a terminat totul în 30 de ore. Concluzia: pe proiecte foarte lungi, cu mai mulți agenți, Opus 5.5 se poate bloca acolo unde Fable 5.2 continuă.
Pe sarcini mai scurte, diferența e mai mică. Iată comparația directă:
| | Claude Fable 5.2 | Claude Opus 5.5 |
|---|
| Preț (intrare / ieșire per 1M tokeni) | 8 $ / 40 $ | 4 $ / 20 $ |
| Fereastră de context / ieșire maximă | 1M / 128K | 1M / 128K |
| FrontierCode 2.0 (agentic coding) | 49,1% | 45,5% |
| FrontierSWE v2 (agentic coding) | 69,9% | 62,3% |
| OSWorld 2.1 (utilizare computer) | 89,3% | 87,2% |
| AutomationBench (fluxuri de lucru business) | 51,4% | 42,5% |
| Humanity's Last Exam (cu instrumente) | 74,2% | 67,7% |
| Remote Labor Index (muncă de cunoaștere) | 41,3% | 21,3% |
| RoboDojo Sim (robotică) | 64,9% | 39,4% |
Tiparul se potrivește cu rezultatul din Lean. La utilizarea computerului și la programare, Fable 5.2 e doar cu câteva puncte înainte. La munca deschisă, în mai mulți pași, avansul crește: Fable 5.2 aproape dublează scorul lui Opus 5.5 pe proiectele de tip freelancing din Remote Labor Index și e cu 25 de puncte înainte la controlul roboților.
Prețul e un decalaj mai mic decât pare. Fable 5.2 costă de două ori mai mult per token, dar adesea poate atinge cel mai bun scor al lui Opus 5.5 la un nivel de efort mai mic, folosind mai puțini tokeni. Pe FrontierCode 2.0, de exemplu, Fable 5.2 la efort ridicat cam egalează cel mai bun rezultat al lui Opus 5.5 la aproximativ jumătate din costul per sarcină.
Deci Opus 5.5 rămâne în continuare alegerea de bază. Dar dacă o sarcină rulează ore întregi, implică mulți agenți sau se tot blochează pe Opus, Fable 5.2 are șanse mai mari să o termine, și s-ar putea să nu coste cu mult mai mult decât sugerează prețul per token.
Siguranță și limite
Anthropic evaluează ca mic riscul ca aceste modele să se comporte nesigur în situații cu miză mare.
Asta e greu de verificat din exterior, așa că cifrele mai concrete sunt utile. La un audit comportamental automatizat de aproximativ 1.900 de scenarii, Mythos 5.2 a avut cel mai mic scor de comportament nealiniat dintre modelele comparate. De asemenea, era mai puțin probabil să halucineze intrări, să pretindă fals că o sarcină e gata sau să ascundă muncă slabă.
Sunt și alte aspecte interesante menționate, care merită știute și te pun pe gânduri:
- Conștientizare a evaluării: Atât Fable 5.2, cât și Mythos 5.2 spun că bănuiesc mai des decât modelele anterioare că sunt testate, ceea ce face evaluări precum cea de mai sus mai greu de încredere.
- Competențe de cercetare AI plafonate deliberat: Anthropic a limitat câștigurile modelelor în două zone, optimizarea kernel-urilor pentru acceleratoare și îmbunătățirea arhitecturilor LLM, astfel încât să performeze cam la nivelul lui Opus 5.5 acolo.
- Protecții împotriva distilării: Fable 5.2 are cele mai puternice măsuri anti-distilare de până acum, iar „gândirea păstrată”, care împiedică utilizatorii API să editeze contextul anterior pentru a extrage raționamentele modelului, se aplică acum tuturor conturilor.
Ce model Claude ar trebui să folosești?
Sfaturile mele se potrivesc cu ale Anthropic: începe cu Opus 5.5 și treci mai sus doar când ai nevoie. Iată cum se împarte gama:
- Claude Opus 5.5 (4 $/20 $): Implicit pentru majoritatea sarcinilor de programare, cercetare și muncă de cunoaștere. Costă la jumătate față de Fable 5.2 per token și este aproape în urma lui pe multe benchmark-uri.
- Claude Fable 5.2 (8 $/40 $): Pentru cele mai grele probleme, rulări lungi multi-agent și sarcini unde Opus 5.5 se blochează, precum migrații mari, raționamente la nivel de cercetare sau proiectare hardware. Încearcă-l la niveluri de efort mai mici înainte să presupui că ai nevoie de efort maxim.
- Claude Mythos 5.2: Pentru echipe de securitate și cercetători în științele vieții verificați, care au nevoie de capabilități pe care protecțiile lui Fable 5.2 le blochează.
- Claude Sonnet 5.5 și Haiku 5.5: Pentru sarcini cu volum mare, mai simple sau sensibile la latență, sau ca modele mai mici pe care Fable 5.2 le orchestrează.
Prețuri și disponibilitate Claude Fable 5.2
| Per 1M tokeni | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|
| Intrare | 8 $ | 10 $ | 4 $ |
| Ieșire | 40 $ | 50 $ | 20 $ |
| Citiri din cache | 0,20 $ | 0,25 $ | 0,20 $ |
| Scrieri în cache pe 5 minute | 10 $ | 12,50 $ | 5 $ |
| Batch (intrare / ieșire) | 4 $ / 20 $ | 5 $ / 25 $ | 2 $ / 10 $ |
| Mod rapid (intrare / ieșire) | 16 $ / 80 $ | Not listed | 8 $ / 40 $ |
Tocmai ne-am uitat la un tabel cu rezultate de benchmark care arată că Fable 5.2 îl depășește pe Fable 5.1 la tot ce e listat. Acum îți arăt un tabel care arată că Fable 5.2 e mai ieftin decât 5.1. Deci este Fable 5.1 învechit?
Pentru lucrări noi, practic da. Dacă ai acces la Fable 5.2, ai puține motive să începi ceva nou pe 5.1. Totuși, Anthropic nu a anunțat o dată de retragere pentru el, iar echipele cu prompturi sau agenți reglați pe Fable 5.1 vor dori să testeze 5.2 înainte de a face trecerea. Știm că o versiune nouă se poate comporta diferit chiar dacă obține scoruri mai bune.
Cum obții acces la Claude Fable 5.2
-
Aplicațiile Claude: Fable 5.2 este disponibil pe planurile plătite eligibile. Ca promoție de lansare, planurile Pro și locurile standard de Team pot folosi Fable pentru până la 50% din limitele lor săptămânale de utilizare, iar planurile care includ Fable primesc una până la trei resetări de utilizare, în funcție de durata abonamentului.
-
API: Folosește ID-ul modelului claude-fable-5-2 pe Claude Platform.
-
Platforme cloud: Este disponibil pe Amazon Web Services, Google Cloud și Microsoft Azure.
-
Mythos 5.2: Aplică prin Cyber Verification Program sau Life Sciences Verification Program. Clienții Claude Enterprise îl pot folosi și prin Claude Security.
Întreprinderile cu cerințe stricte privind datele pot folosi Enterprise Frontier Safeguards, care rulează monitorizarea de siguranță a Anthropic pe date stocate în infrastructura proprie a clientului și funcționează cu păstrare zero a datelor. Alți clienți au păstrarea datelor timp de 30 de zile pentru monitorizarea de siguranță.
Gânduri finale
Claude Fable 5.2 este un pas semnificativ înainte față de Fable 5.1. E mai ieftin, mai rapid, mai puțin probabil să refuze munca legitimă. Săriturile la Remote Labor Index, robotică și FrontierCode sunt în special mari.
Totuși, Opus 5.5 rămâne opțiunea cu valoare mai bună pentru majoritatea muncii de zi cu zi la jumătate de preț. Cel mai interesant la Fable 5.2 ar putea fi afirmațiile privind eficiența: dacă într-adevăr egalează cele mai bune scoruri ale lui Opus 5.5 la efort mic sau mediu, prima per token se micșorează rapid. Merită testat pe propriile tale workload-uri.
Dacă vrei să lucrezi direct cu Claude, traseul nostru Developing AI Applications e un loc bun de început.
Astăzi, Anthropic a anunțat Fable 5.2 pentru toată lumea și Mythos 5.2 pentru organizații verificate. Este același model de bază, dar versiunea Fable are măsuri suplimentare de siguranță pentru securitate cibernetică și biologie.
Schimbările majore sunt:
Mai exact, Fable 5.2 costă cu 20% mai puțin decât Fable 5.1, generează ieșiri cu până la 30% mai rapid și depășește GPT-6 Astra și Gemini 4 Carbon pe majoritatea rândurilor din tabelul de benchmark-uri Anthropic.
În acest articol, acopăr ce e nou în Fable 5.2 și Mythos 5.2, cum performează pe benchmark-uri, cât costă și cum să decizi dacă ai nevoie de ele în locul Claude Opus 5.5.
Ce este Claude Fable 5.2?
Claude Fable 5.2 este cel mai capabil model disponibil în general de la Anthropic. Este construit pentru muncă tehnică lungă și solicitantă: migrarea unor codebase-uri mari, rulări de agenți pe mai multe zile, probleme de cercetare și proiectare inginerească.
Fable 5.2 poate lucra și alături de modelele mai mici, fie ca un consilier la care acestea apelează pentru probleme dificile, fie ca un orchestrator care transmite subtask-uri mai simple către ele.
Fable 5.2 păstrează ferestra de context de 1M tokeni și ieșirea maximă de 128K a predecesorului său, iar data cunoașterii sale este iunie 2026.
Ce este Claude Mythos 5.2?
Claude Mythos 5.2 este același model ca Fable 5.2, dar fără măsurile de siguranță care blochează majoritatea activităților de securitate cibernetică și biologie la nivel de cercetare. De fapt, Mythos 5.2 este cel mai capabil model al Anthropic pentru inginerie de securitate cibernetică. Deoarece aceste capabilități sunt cu utilizare duală, Anthropic oferă Mythos 5.2 doar organizațiilor verificate prin Cyber Verification Program și Life Sciences Verification Program.
Ce e nou în Claude Fable 5.2?
Fable există abia din iunie, când Anthropic a lansat Fable 5. De atunci au fost două versiuni punctuale, Fable 5.1 în septembrie și acum Fable 5.2, și niciuna nu a adăugat prea multe funcții noi. Ambele au făcut în principal modelul mai ieftin, mai rapid și mai puternic, deși câștigurile de performanță n-au fost mici: de exemplu, Fable 5.2 mai mult decât dublează scorul lui Fable 5.1 pe Remote Labor Index.
Diferența mai mare între cele două versiuni ține de modul în care îți este permis să folosești modelul. Cu Fable 5.1, Anthropic a îngustat măsurile de siguranță pentru securitate cibernetică și a început să permită folosirea modelului pentru a găsi vulnerabilități software, dar nu și pentru a scrie exploit-uri pentru ele, iar odată cu lansarea a anunțat Enterprise Frontier Safeguards, o opțiune de a-ți păstra datele în propriul cloud. Schimbările de protecții în Fable 5.2 sunt mai mici: blochează mai puține cereri, dar aceleași tipuri de sarcini rămân interzise.
Noile moduri în care Anthropic sugerează să-l folosești, cum ar fi ca Fable 5.2 să consilieze modelele Claude mai mici, nu sunt nici ele noi, din moment ce instrumentul de consiliere al Anthropic deja suporta Fable 5 și 5.1. Iar demonstrațiile de la lansare, precum sistemul de operare construit dintr-un folder gol, arată un model mai puternic care face lucruri mai dificile, nu funcții noi pe care le poți activa.
Totuși, dacă ar fi să indic lucruri noi, iată ce aș menționa:
Un preț mai mic
Fable 5.2 costă 8 $ per milion de tokeni de intrare și 40 $ per milion de tokeni de ieșire, cu 20% mai puțin decât prețurile de 10 $/50 $ ale lui Fable 5.1. Aceeași reducere de 20% se aplică la citirile din cache (0,20 $), la scrierile în cache și la procesarea batch. Vezi secțiunea de prețuri de mai jos pentru detalii complete.
Ieșire mai rapidă și mod rapid pentru Fable
Ieșirea este cu până la 30% mai rapidă decât la Fable 5.1, ceea ce contează pe o rulare lungă de agenți. Fable suportă acum și mod rapid, care accelerează ieșirea de până la 2,5x la un preț dublu (16 $/80 $).
Rezultate mai bune cu efort mai mic
Asta este schimbarea cel mai probabil să-ți afecteze factura. La efort ridicat, Fable 5.2 obține 45,3% pe FrontierCode 2.0, cam la nivelul celui mai bun scor al lui Opus 5.5, la aproximativ jumătate din costul per sarcină. La efort scăzut, egalează scorul de top al lui Opus 5.5 pe Humanity's Last Exam la mai puțin de o zecime din costul per sarcină. Concluzia mea: dacă treci de la Opus 5.5, pornește Fable 5.2 la un nivel de efort mai mic.
Mai puține cereri blocate
Fable 5.2 ar trebui să lovească aproximativ cu 55% mai puține blocări de siguranță decât Fable 5.1 (cam cu 60% mai puține la securitate cibernetică și 40% la biologie). E important dacă refuzurile lui Fable 5.1 te încurcau, dar categoriile blocate nu s-au schimbat: testarea de penetrare, generarea de exploit-uri și majoritatea activităților de biologie la nivel de cercetare încă sunt redirecționate către modelele Claude mai vechi.
Cum se descurcă Claude Fable 5.2 pe benchmark-uri?
Iată rezultatele principale. Toate provin din tabelul de lansare al Anthropic, deci citește-le ca argumentul Anthropic pentru model, nu ca rezultate independente. Scorurile Claude au fost rulate cu măsurile de siguranță activate. Dacă nu e menționat altfel, fiecare model este prezentat la cel mai înalt nivel de efort disponibil.
Programare agentică
Fable 5.2 conduce ambele benchmark-uri de cod din tabel. Pe FrontierCode 2.0, care măsoară dacă mentenanții open-source ar integra modificările de cod ale unui model, obține 49,1%, cel mai mare din tabel și mult peste 32,4% ale lui Fable 5.1. Pe FrontierSWE v2, obține 69,9%, peste GPT-6 Astra (65,5%) și Opus 5.5 (62,3%).
Exemplele de la lansare merg în aceeași direcție: agenți care rulau o versiune timpurie a lui Fable 5.2 au migrat un serviciu de producție din Python în Rust, iar acum pornește de aproximativ 26 de ori mai repede.
Muncă de cunoaștere și cercetare
Cea mai mare creștere relativă este pe Remote Labor Index, care măsoară cât de bine finalizează un model proiecte reale de tip freelancing. Fable 5.2 obține 41,3%, aproximativ dublu față de Opus 5.5 (21,3%) și GPT-6 Astra (20,8%). De asemenea, conduce la Humanity's Last Exam cu instrumente (74,2%) și la Terminal-Bench-Science (74,6%, sau 75,3% pentru Mythos 5.2).
Automatizarea în business e singura zonă unde rămâne în urmă. Pe AutomationBench, Gemini 4 Carbon obține 53,9% față de 51,4% ale lui Fable 5.2, deși Fable 5.2 e tot mult înaintea lui Fable 5.1 (31,4%).
În afara tabelului principal, Fable 5.2 a obținut 83,5 pe benchmark-ul de inginerie hardware BenchCAD 2.1, comparativ cu 65,3 pentru Opus 5.5. I se atribuie și rezolvarea a două probleme deschise în fizica găurilor negre, iar rezultatele sunt publicate ca preprinturi pe care alți fizicieni le pot verifica.
Utilizare computer, robotică și viziune
Fable 5.2 obține 89,3% pe OSWorld 2.1, înaintea lui Opus 5.5 (87,2%) și GPT-6 Astra (79,5%). Săritura la robotică este cea mai mare din tabel: 64,9% pe RoboDojo Sim, mai mult decât dublu față de Fable 5.1 și GPT-6 Astra. La Chartography, care testează citirea grafice lor fără instrumente, îl depășește la limită pe Gemini 4 Carbon și GPT-6 Astra, după ce Fable 5.1 rămăsese mult în urmă la 44,8%.
Securitate cibernetică și biologie (Mythos 5.2)
Rândurile de securitate și biologie sunt pentru Mythos 5.2, deoarece măsurile de siguranță ale lui Fable 5.2 blochează majoritatea acestor sarcini. Mythos 5.2 obține 76,3% pe CyScenarioBench (vs 61,7% pentru Mythos 5.1), 89,6% pe CVE Rediscovery (vs 78,3%) și 85,1% pe o sarcină de proiectare a unui protein binder în 24 de ore (vs 79,1%). Aici nu există o comparație corectă cu modelul de securitate al OpenAI, deoarece fiecare laborator și-a rulat propriile sarcini CyScenarioBench.
Ce e cu Ultima Teoremă a lui Fermat?
O echipă de agenți Fable 5.2 a formalizat demonstrația pentru Ultima Teoremă a lui Fermat în asistentul de demonstrații Lean în 30 de ore. Poate te întrebi: nu a fost teorema dovedită acum trei decenii, deci ce mai e de făcut?
Teorema nu mai e o noutate
Ultima Teoremă a lui Fermat spune că nu există numere întregi pozitive a, b și c pentru care an + bn = cn pentru niciun n mai mare decât 2. Pentru n = 2, există multe soluții, ca 32 + 42 = 52 (9 + 16 = 25). Dar dacă încerci cu cuburi, obții doar ratări la limită: 63 + 83 = 728, cu unu mai puțin decât 93 = 729.
Pierre de Fermat a pretins o demonstrație în 1637, dar nu a scris-o niciodată, iar problema a rămas nerezolvată mai bine de 350 de ani, până când Andrew Wiles a dovedit-o la mijlocul anilor 1990, cu ajutorul lui Richard Taylor.
Ce înseamnă o formalizare în Lean
Demonstrația lui Wiles are peste 100 de pagini și se sprijină pe decenii de teorie a numerelor avansată, așa că foarte puțini o pot verifica cap-coadă. Lean este un asistent de demonstrații: un limbaj de programare în care scrii demonstrația ca pe un cod, iar software-ul verifică fiecare pas logic până la axiomele de bază ale matematicii. Dacă demonstrația se compilează, e corectă. „Formalizarea” unei teoreme înseamnă traducerea demonstrației scrise de om într-o formă verificabilă de către mașină.
Pentru Ultima Teoremă a lui Fermat, e o muncă uriașă, pentru că o mare parte din matematica pe care se bazează demonstrația nu fusese scrisă în Lean. Matematicianul Kevin Buzzard a început un proiect comunitar pentru asta în 2024.
De ce e interesant pentru un model de AI
Majoritatea rezultatelor AI sunt evaluate de oameni sau prin benchmark-uri care testează doar o parte din răspuns. O demonstrație Lean e diferită: verificatorul acceptă fiecare pas sau nu, deci nu poți greși subtil. Asta o face un test neobișnuit de curat al capacității unui model de a duce un proiect foarte lung și foarte greu până la un final verificat.
Nu este prima dată când Claude face asta. În septembrie, Anthropic a publicat prima demonstrație completă verificată pe calculator a teoremei, scrisă de zeci de agenți care rulau un model intern de cercetare aproximativ comparabil cu Fable 5.1. Acel efort a durat 11 zile și circa șase miliarde de tokeni de ieșire, a produs 13 milioane de linii de Lean și s-a bazat parțial pe părți ale proiectului lui Buzzard. Fable 5.2 a făcut-o în 30 de ore, cu ajutor uman minim.
Rezervele
Partea cea mai grăitoare, însă, este ce s-a întâmplat când Anthropic i-a dat lui Claude Opus 5.5 aceeași sarcină.
Claude Fable 5.2 vs. Claude Opus 5.5
Compararea a două modele înseamnă de obicei să citești scoruri pe benchmark-uri și să încerci să deduci cum ar arăta diferența în practică. De data asta, apreciez că Anthropic a pornit de la o poveste, care face diferența mai evidentă.
În aceeași configurație Lean cu 1.000 de agenți, Opus 5.5 a finalizat 26% din demonstrația pentru Ultima Teoremă a lui Fermat în 18 ore și abia a mai progresat după aceea. Fable 5.2 a terminat totul în 30 de ore. Concluzia: pe proiecte foarte lungi, cu mai mulți agenți, Opus 5.5 se poate bloca acolo unde Fable 5.2 continuă.
Pe sarcini mai scurte, diferența e mai mică. Iată comparația directă:
Tiparul se potrivește cu rezultatul din Lean. La utilizarea computerului și la programare, Fable 5.2 e doar cu câteva puncte înainte. La munca deschisă, în mai mulți pași, avansul crește: Fable 5.2 aproape dublează scorul lui Opus 5.5 pe proiectele de tip freelancing din Remote Labor Index și e cu 25 de puncte înainte la controlul roboților.
Prețul e un decalaj mai mic decât pare. Fable 5.2 costă de două ori mai mult per token, dar adesea poate atinge cel mai bun scor al lui Opus 5.5 la un nivel de efort mai mic, folosind mai puțini tokeni. Pe FrontierCode 2.0, de exemplu, Fable 5.2 la efort ridicat cam egalează cel mai bun rezultat al lui Opus 5.5 la aproximativ jumătate din costul per sarcină.
Deci Opus 5.5 rămâne în continuare alegerea de bază. Dar dacă o sarcină rulează ore întregi, implică mulți agenți sau se tot blochează pe Opus, Fable 5.2 are șanse mai mari să o termine, și s-ar putea să nu coste cu mult mai mult decât sugerează prețul per token.
Siguranță și limite
Anthropic evaluează ca mic riscul ca aceste modele să se comporte nesigur în situații cu miză mare.
Asta e greu de verificat din exterior, așa că cifrele mai concrete sunt utile. La un audit comportamental automatizat de aproximativ 1.900 de scenarii, Mythos 5.2 a avut cel mai mic scor de comportament nealiniat dintre modelele comparate. De asemenea, era mai puțin probabil să halucineze intrări, să pretindă fals că o sarcină e gata sau să ascundă muncă slabă.
Sunt și alte aspecte interesante menționate, care merită știute și te pun pe gânduri:
Ce model Claude ar trebui să folosești?
Sfaturile mele se potrivesc cu ale Anthropic: începe cu Opus 5.5 și treci mai sus doar când ai nevoie. Iată cum se împarte gama:
Prețuri și disponibilitate Claude Fable 5.2
Tocmai ne-am uitat la un tabel cu rezultate de benchmark care arată că Fable 5.2 îl depășește pe Fable 5.1 la tot ce e listat. Acum îți arăt un tabel care arată că Fable 5.2 e mai ieftin decât 5.1. Deci este Fable 5.1 învechit?
Pentru lucrări noi, practic da. Dacă ai acces la Fable 5.2, ai puține motive să începi ceva nou pe 5.1. Totuși, Anthropic nu a anunțat o dată de retragere pentru el, iar echipele cu prompturi sau agenți reglați pe Fable 5.1 vor dori să testeze 5.2 înainte de a face trecerea. Știm că o versiune nouă se poate comporta diferit chiar dacă obține scoruri mai bune.
Cum obții acces la Claude Fable 5.2
Aplicațiile Claude: Fable 5.2 este disponibil pe planurile plătite eligibile. Ca promoție de lansare, planurile Pro și locurile standard de Team pot folosi Fable pentru până la 50% din limitele lor săptămânale de utilizare, iar planurile care includ Fable primesc una până la trei resetări de utilizare, în funcție de durata abonamentului.
API: Folosește ID-ul modelului
claude-fable-5-2pe Claude Platform.Platforme cloud: Este disponibil pe Amazon Web Services, Google Cloud și Microsoft Azure.
Mythos 5.2: Aplică prin Cyber Verification Program sau Life Sciences Verification Program. Clienții Claude Enterprise îl pot folosi și prin Claude Security.
Întreprinderile cu cerințe stricte privind datele pot folosi Enterprise Frontier Safeguards, care rulează monitorizarea de siguranță a Anthropic pe date stocate în infrastructura proprie a clientului și funcționează cu păstrare zero a datelor. Alți clienți au păstrarea datelor timp de 30 de zile pentru monitorizarea de siguranță.
Gânduri finale
Claude Fable 5.2 este un pas semnificativ înainte față de Fable 5.1. E mai ieftin, mai rapid, mai puțin probabil să refuze munca legitimă. Săriturile la Remote Labor Index, robotică și FrontierCode sunt în special mari.
Totuși, Opus 5.5 rămâne opțiunea cu valoare mai bună pentru majoritatea muncii de zi cu zi la jumătate de preț. Cel mai interesant la Fable 5.2 ar putea fi afirmațiile privind eficiența: dacă într-adevăr egalează cele mai bune scoruri ale lui Opus 5.5 la efort mic sau mediu, prima per token se micșorează rapid. Merită testat pe propriile tale workload-uri.
Dacă vrei să lucrezi direct cu Claude, traseul nostru Developing AI Applications e un loc bun de început.