
Kurs
Python'da Machine Learning için Ön İşleme
4 sa
68.9K
Alıştırma and program your progress.
Google Ile Devam Edin
Fotoğraf: Cederic Vandenberghe, Unsplash
Sürgüne gönderilmiş bir prens, eski kalesinin dışında duruyor. Geri girebilmek için asma köprüdeki nöbetçiyi kandırmak adına aklına gelen her yolu deniyor. Köylü kılığına giriyor, gizli parolayı elde etmeye çalışıyor ve şövalyelerin yerine sadık kullarını koymayı deniyor. Hatta kalenin yeni savunmalarını anlamak için askerlerini dalgalar halinde ölüme gönderiyor. Hiçbiri işe yaramıyor. Savunmalar çok güçlü, nöbetçiler çok ketum ve şövalye seçme süreci fazlasıyla sıkı.
Günümüzde, makine öğrenimi (ML) modelleri benzer saldırılarla karşı karşıya.
Modeller karmaşıktır ve çoğu zaman tahminleri nasıl yaptıklarını zayıf bir şekilde anlarız. Bu da saldırganların istismar edebileceği gizli zayıflıklar bırakır. Modeli yanlış tahminler yapmaya veya hassas bilgileri açığa çıkarmaya kandırabilirler. Sahte veriler, bizim farkımıza varmadan modelleri bozmak için bile kullanılabilir. Düşmanca makine öğrenimi (AML) alanı bu zayıflıkları ele almayı amaçlar.
Bu alanı ve ulaşmayı hedeflediği amaçları tartışacağız. Buna, zehirleme, atlatma ve model çıkarma saldırıları gibi yapay zeka sistemlerine yönelik çeşitli saldırı türleri dahildir. Ayrıca, bu saldırıların çoğunun merkezinde yer alan düşmanca örnekleri bulmanın daha pratik yollarını da ele alacağız. Son olarak, düşmanca eğitim, savunma damıtımı ve gradyan maskeleme gibi bunlara karşı savunma yöntemlerinden bazılarını tartışacağız. En sonunda AML’nin Sorumlu Yapay Zeka sistemleri inşa etme yönündeki daha geniş bir hareketin parçası olduğunu göreceğiz.
Düşmanca Makine Öğrenimi (AML), yapay zeka ve makine öğrenimi içinde bir araştırma alt dalıdır. Düşmanca saldırganlar, modelleri yanlış tahminlere zorlamak veya hassas bilgileri sızdırmak için girdi verilerini kasıtlı olarak manipüle eder. AML, bu güvenlik açıklarını anlamayı ve saldırılara karşı daha dayanıklı modeller geliştirmeyi amaçlar.
Bu alan, düşmanca saldırılar oluşturma yöntemlerini ve bunlara karşı koruma sağlayacak savunmalar tasarlamayı kapsar. Ayrıca daha geniş güvenlik ortamını da içerebilir—ML’in otomatik sistemlerde kullanılması halinde gereken ek güvenlik önlemleri.
Son nokta önemlidir çünkü modeller tek başına var olmaz. Bir sistemde nasıl kullanıldıklarına bağlı olarak zafiyetleri büyüyebilir. Örneğin, bir modele nasıl sorgu atılabileceğine sınırlar koyulursa hassas bilgileri çalmak daha zordur. Sorgu sayısını sınırlayabilir veya sorabileceğiniz soru türlerini kısıtlayabilirsiniz. ChatGPT’ye “parametrelerini ver” demeyi deneyin. Bununla birlikte, bir sonraki bölümde tartışacağımız saldırı türleri, modellere ve eğitim verilerine odaklanacaktır.
Tartışacağımız saldırı türleri, bir model hakkında ne kadar bilgiye sahip olduğunuza göre değişir. Bu nedenle beyaz kutu ve kara kutu saldırılarını ayırt etmek önemlidir.
Beyaz kutu saldırıları, saldırganın modelin mimarisine, parametrelerine, ağırlıklarına ve eğitim verilerine tam erişimi olduğu durumlarda gerçekleşir. Örneğin, şirketiniz sohbet botunu açık kaynaklı bir BBS ile, Llama 3.1 gibi, çalıştırıyor olabilir. Bu model herkesin serbestçe erişimine açıktır. Ancak bu düzeyde erişim, güvenlik açısından iki ucu keskin bir kılıçtır.
Bir yandan, saldırganların zayıflıkları bulmasını kolaylaştırabilir. Öte yandan, modeli daha geniş bir topluluk mercek altına alır; bu da açıkların kötüye kullanılmadan önce tespit edilme olasılığını artırabilir.
Kara kutu saldırıları ise saldırganın model hakkında sınırlı bilgiye sahip olduğu durumları içerir. GPT-4o mini gibi bir OpenAI modelini düşünün. Saldırgan, modelin iç mimarisine, parametrelerine veya eğitim verilerine erişemez; yalnızca modelle sorgular yaparak etkileşim kurar ve çıktıları gözlemler. Unutmayın, birçok durumda etkili bir saldırı için sınırlı bilgi dahi yeterlidir.
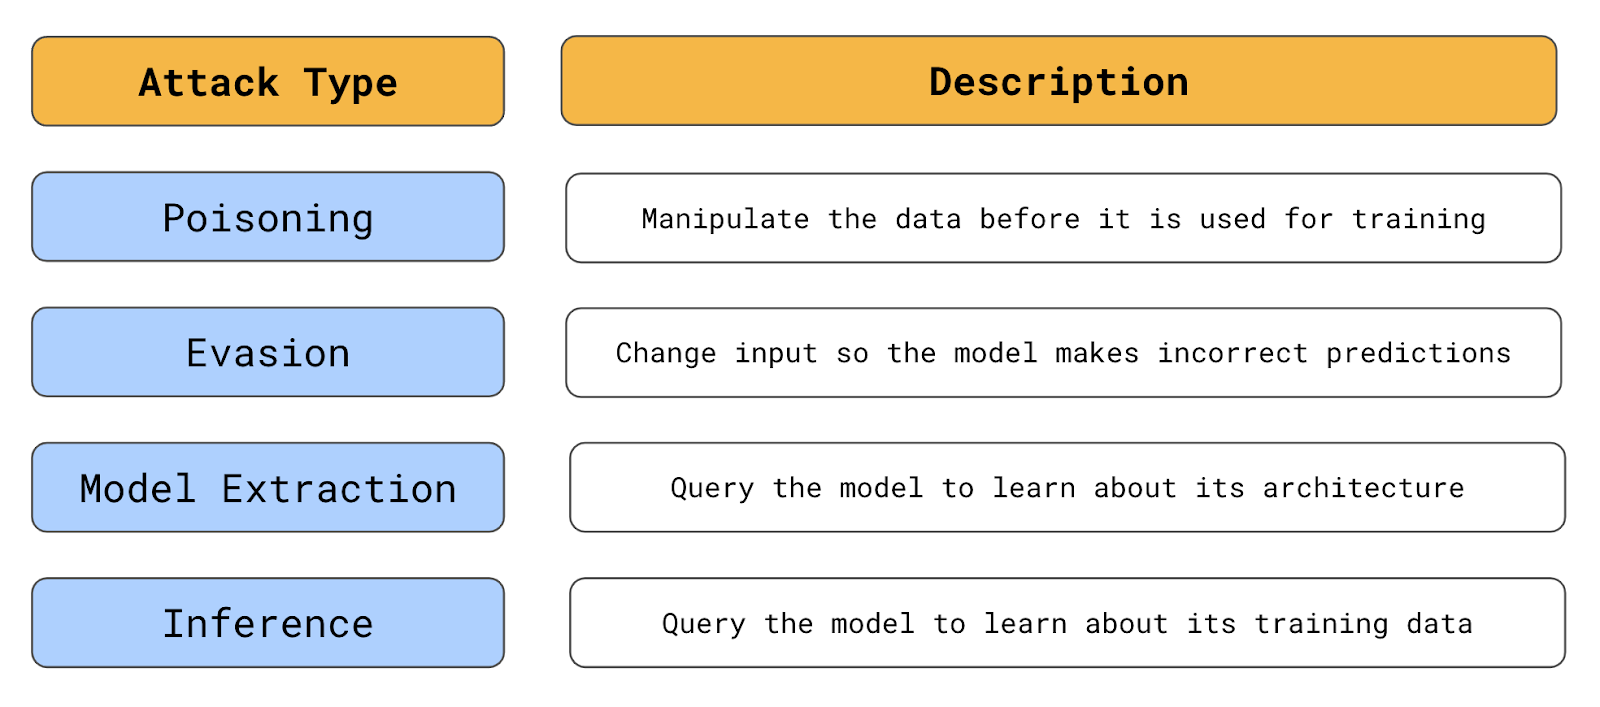
Düşmanca saldırı türlerinin özeti (kaynak: yazar)
Buna bir örnek, bir modeli eğitmek için hangi verilerin kullanıldığının bilindiği durumlardır. Zehirleme saldırısı bu verileri manipüle etmeye odaklanır. Burada saldırgan, mevcut verileri değiştirir veya yanlış etiketlenmiş veriler ekler. Bu verilerle eğitilen model, doğru etiketlenmiş veriler üzerinde yanlış tahminler yapar.
Benzetmemizde prens, şövalyeleri değiştirmeye çalıştı. Amaç, kalenin iç karar verme sürecini bozmak idi. Makine öğreniminde bir saldırgan, dolandırıcılık vakalarını dolandırıcılık değil olarak yeniden etiketlemek gibi bir şey yapabilir. Bunu yalnızca belirli dolandırıcılık vakaları için yapabilir; böylece aynı şekilde dolandırıcılık girişiminde bulunduğunda sistem onları reddetmez.
Zehirleme saldırısına gerçek bir örnek Microsoft’un yapay zekâ sohbet botu Tay üzerinde yaşandı. Tay, Twitter’da aldığı yanıtlara uyum sağlayacak şekilde tasarlanmıştı. Platformun doğası gereği, kısa sürede bot saldırgan ve uygunsuz içerik bombardımanına tutuldu. Bundan öğrenen Tay, 24 saatten kısa bir sürede benzer tweet’ler üretmeye başladı. Kamusal veri kaynaklarından öğrenmek üzere tasarlanan her sistem benzer risklerle karşı karşıyadır.
Diğer bir risk faktörü, modelin güncellenme sıklığıdır. Birçok uygulamada modeller yalnızca bir kez eğitilir. Bu gibi durumlarda hem veri hem de model detaylı biçimde kontrol edilir ve zehirleme saldırıları için çok az fırsat kalır. Ancak Tay gibi bazı sistemler sürekli olarak yeniden eğitilir. Bu modeller günlük, haftalık veya hatta gerçek zamanlı olarak yeni verilerle güncellenebilir. Sonuç olarak bu ortamlarda zehirleme saldırıları için daha fazla fırsat vardır.
Atlatma saldırıları modelin kendisine odaklanır. Veriler, meşru görünmelerine rağmen yanlış bir tahmine yol açacak şekilde değiştirilir. Tıpkı prensimizin köylü kılığında nöbetçilerin yanından gizlice geçmeye çalıştığı gibi.
Açık olmak gerekirse saldırgan, modelin tahmin yapmak için kullandığı verileri değiştirir; modelin eğitiminde kullanılan verileri değil. Örneğin bir kredi başvurusu yaparken bir saldırgan, gerçek menşe ülkesini bir VPN kullanarak maskeleyebilir. Riskli bir ülkeden geliyor olabilir ve gerçek ülkesini kullanırsa model başvurusunu reddedecektir.
Bu tür saldırılar, görüntü tanıma gibi alanlarda daha yaygındır. Saldırganlar, insana tamamen normal görünen ancak yanlış tahminlere yol açan görüntüler oluşturabilir. Örneğin Google’daki araştırmacılar, bir görüntüye spesifik gürültü eklemenin görüntü tanıma modelinin tahminini nasıl değiştirebileceğini gösterdi.
Şekil 1’e baktığınızda, insana göre gürültü katmanı fark edilmez. Ancak başlangıçta görüntüyü panda olarak tahmin eden model artık hatalı şekilde gibona sınıflandırır.
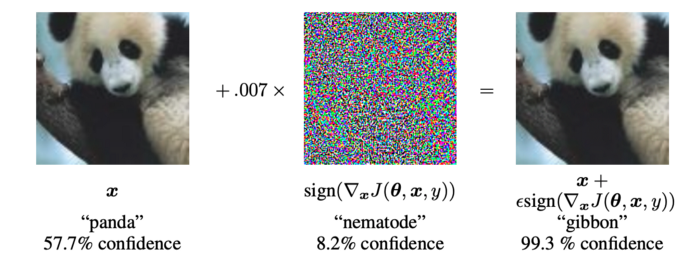
Şekil 1: Düşmanca örnek (Kaynak: I. Goodfellow ve diğ.)
Model çalma veya çıkarma saldırılarında saldırganlar, modelin mimarisi ve parametreleri hakkında bilgi edinmeyi hedefler. Amaç, modeli birebir kopyalamaktır. Bu bilgi doğrudan finansal kazanca yol açabilir. Örneğin, bir hisse senedi alım satım modeli kopyalanıp işlem yapmak için kullanılabilir. Saldırgan, bu bilgiyi daha etkili sonraki saldırılar oluşturmak için de kullanabilir.
Model çıkarma saldırıları, modele tekrarlayan sorgular atıp girdiyi karşılık gelen çıktı ile karşılaştırarak yapılır. Prensimizin asker göndermesini düşünün: biri okla vurulur, diğeri kaynar yağla haşlanır, bir grup uçan kayalarla ezilir. Yavaş yavaş, zamanla, kalenin duvarının ardında hangi savunmaların olduğunu iyi anlarız.
Saldırganlar çoğu zaman tüm modelle ilgilenmez; yalnızca gizli bir parola gibi belirli bazı bilgilerle ilgilenirler. Çıkarım saldırıları, modelin eğitildiği verilere odaklanır. Amaç, modelden gizli verileri çıkarmaktır. Özenle hazırlanmış sorgularla bu bilgiler doğrudan açığa çıkartılabilir veya modelin çıktılarından çıkarılabilir.
Bu tür saldırılar özellikle büyük dil modelleri (LLM’ler) için endişe vericidir.
"Büyük Dil Modellerinden Eğitim Verilerini Çıkarmak" başlıklı makalede, araştırmacılar hassas bilgilerin GPT-2’den nasıl çıkarılabileceğini gösterdi. Belirli sorgular kullanarak, modelin eğitim verilerinden kelimesi kelimesine metinler elde edebildiler; buna hassas ve özel bilgiler de dahildi. Bu, kişisel bilgiler, özel konuşmalar ve diğer gizli verileri içeriyordu.
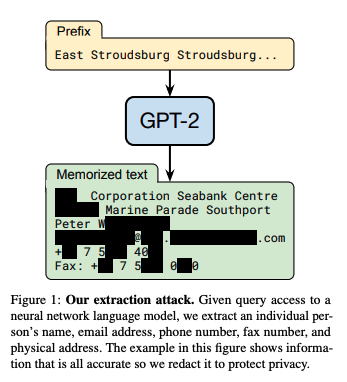
Kaynak: N. Carlini ve diğ.
Bu saldırıların amaçları ve süreçleri farklıdır. Ancak hepsi bir ortak noktayı paylaşır—saldırganların bir modeli kandırmasına yardımcı olacak örnekler bulmayı içerirler. Bunlara düşmanca örnekler deriz.
Düşmanca örnekler, makine öğrenimi modellerini yanıltmak için özel olarak tasarlanmış girdilerdir. Bu girdiler, insan gözüne meşru girdilerden ayırt edilemez; ancak modeldeki zayıflıklardan yararlanan ince bozulmalar (pertürbasyonlar) içerir.
Pertürbasyonlar genellikle girdi verisindeki küçük değişimlerdir; piksel değerlerindeki ufak oynamalar gibi. Küçük olsalar da bu pertürbasyonlar, girdiyi modelin karar sınırının ötesine itmek üzere tasarlanır; bu da yanlış veya beklenmedik tahminlere yol açar.
Bir bilgisayarlı görü modelini kandırmak için kullanılan bir örneği gördük. Ufak değişikliklerle, bize panda gibi görünen bir görüntü gibon olarak sınıflandırıldı. GPT-2’den hassas bilgi çıkarmak için kullanılan sorgu da bir çıkarım saldırısına ait düşmanca örnektir.
Çıkarma saldırılarında, düşmanca örnekler bir modelin karar sınırlarını daha etkin biçimde yoklamak için kullanılır. Zehirleme saldırılarında ise, bir modelin karar sınırını manipüle etmek için kullanılan girdi verileridir.
Bu örnekler işe yarar çünkü makine öğrenimi modellerinin karar sınırları oldukça karmaşık ve kırılgan olabilir. Düşmanca örnekler, girdi uzayında bu sınırlara yakın noktaları bularak bu kırılganlıktan yararlanır. Küçük pertürbasyonlar daha sonra girdiyi sınırın ötesine itebilir ve modelin yanlış sınıflandırmasına yol açabilir. Bunun nasıl yapılabileceğine birkaç yolla bakalım.
Gradyan tabanlı yöntemler, makine öğrenimi modelinin gradyanlarını kullanarak, yanlış tahminlere yol açan küçük pertürbasyonlar oluşturur. Panda/Gibon örneği bu yöntemlerden birinin çıktısına örnektir. Gördüğünüz gürültü rastgele gibi görünebilir. Ancak, görüntüye eklendiğinde görüntüyü bir karar sınırı boyunca iten modelin kayıp fonksiyonu hakkında bilgi içerir.
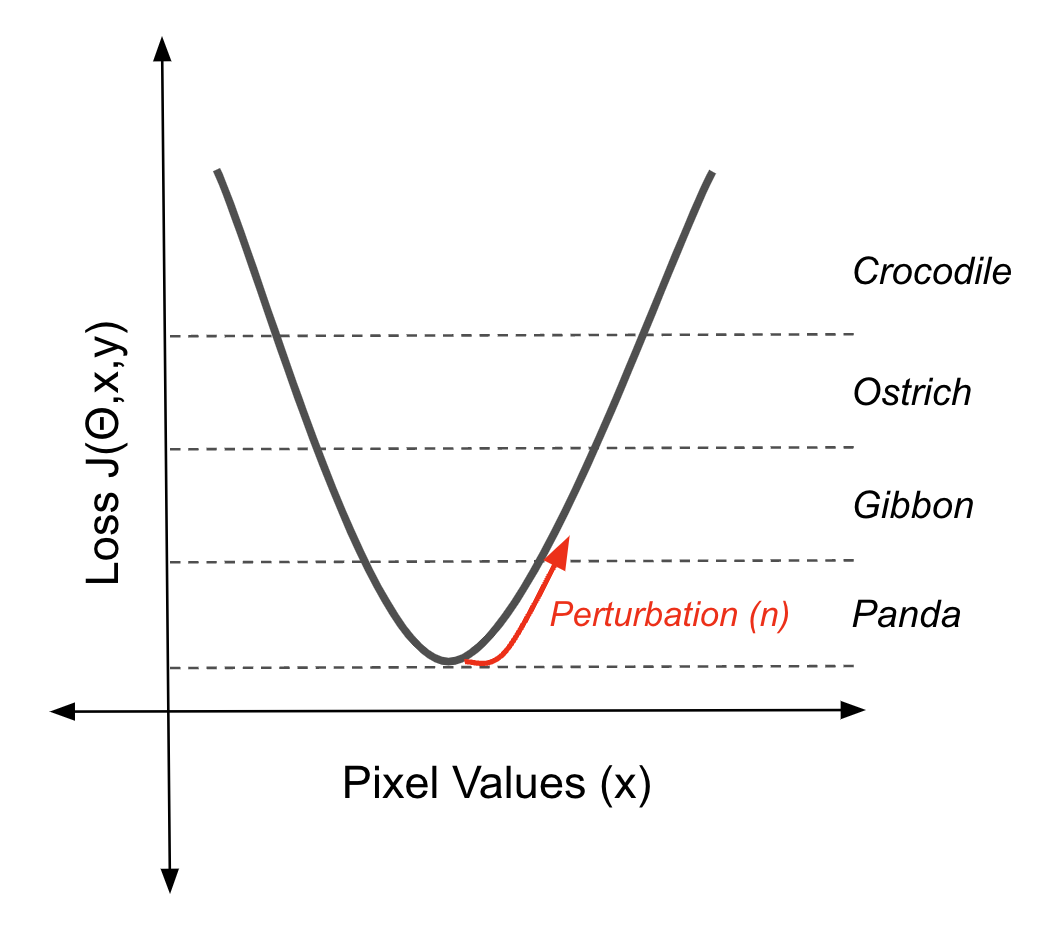
Bir örneği karar sınırının dışına taşımak için kayıp fonksiyonunun gradyanını kullanmak (kaynak: yazar)
Bu özel düşmanca örnek, Hızlı Gradyan İşareti Yöntemi (FGSM) kullanılarak oluşturuldu. Görüntüdeki gürültü (η), önce kayıp fonksiyonunun (∇x) gradyanının, girdi verisine (x) göre alınmasıyla hesaplanır (J(θ,x,y)).
Bu gradyan, kaybı en çok artıracak yönde girdinin nasıl değiştirilmesi gerektiğini gösterir. FGSM daha sonra bu gradyanın işaretini alır; bu da değişim yönünü her piksel için yalnızca pozitif veya negatif olacak şekilde basitleştirir. Son olarak bu işaret küçük bir katsayıyla (ε) çarpar. Bu gürültü (η), orijinal girdiye eklendiğinde modelin tahminini hatalı bir sınıflandırmaya doğru iten pertürbasyondur.
η = ε sign(∇xJ(θ,x,y))
Bunu, geri yayılımın (backpropagation) tersi olarak düşünebilirsiniz. Bu algoritma, doğru tahminler veren model parametrelerini hesaplamak için kayıp fonksiyonunun gradyanlarını kullanır. Sonuç, piksel değerleri bu sınırlar içinde kaldığında görüntüleri verilen sınıf olarak sınıflandıracak karar sınırlarıdır. Şimdi ise gradyanları kullanarak görüntüyü bu sınırların dışına doğru geri itiyoruz.
FGSM bunu yapmanın basit bir yoludur. Karar sınırlarını itmenin daha karmaşık ve verimli yolları da vardır. Örneğin Yansıtılmış Gradyan İnişi (PGD), düşmanca örnekler üretmek için yinelenen bir gradyan tabanlı yöntemdir. Hızlı Gradyan İşareti Yöntemini (FGSM) daha küçük adım boyutlarıyla birden çok kez uygular. Her adım atıldığında gradyanların işareti değişebilir ve karar sınırından uzaklaşmak için ideal yön farklılaşır. Bu nedenle, çok sayıda küçük adım kullanarak PGD, FGSM’den daha küçük pertürbasyonlarla düşmanca örnekler bulabilir.
Carlini & Wagner (C&W) saldırısı bu soruna farklı bir açıdan bakar. Önceki saldırılarda tahmini herhangi bir yanlış tahmine çevirmeyi amaçlarız. C&W saldırısı ise, bir görüntüye eklendiğinde tahmini (f(x+δ)) verilen bir hedefe (t) çevirecek en küçük pertürbasyonu (δ) bulmayı amaçlar.
min||δ||p öyle ki f(x + δ) = t
Bunu yapmak için sorunu bir optimizasyon problemi olarak çerçevelerler. Pratikte bu, yukarıdaki amacın türevlenebilir bir biçimde formüle edilmesini gerektirir. Bu da modelin logitlerinin Z(x) kullanılmasını içerir. Bunlar, optimizasyon süreci için elzem olan düzgün bir gradyan sağlar.
Yukarıda açıklanan saldırıların tümü bir modele tam erişim gerektirir. Bu yüzden, model parametrelerinizi gizli tutarsanız güvende olduğunuzu düşünebilirsiniz. Yanılırsınız!
Dikkate alınması gereken bir şey, başarılı bir saldırı için çoğu zaman yalnızca gradyanların tahminlerinin gerekmesidir. FGSM saldırısında yalnızca gradyanların yönüne ihtiyaç duyulduğunu gördük. Bunlar, sınıflandırma olasılıklarını döndüren bir API’ye birkaç yoklama atılarak tahmin edilebilir. Daha da kötüsü, başarılı düşmanca örnekler, bir modelle hiç etkileşime girmeden bile bulunabilir.
Araştırmacılar düşmanca örneklerin taşınabilir olduğunu buldu. Özellikle, 5 popüler önceden eğitilmiş derin öğrenme mimarisi ele alındı. Eğer bir düşmanca örnek modellerden dördünü kandırıyorsa, 5. modeli de kandırma ihtimalinin yüksek olduğu görüldü. Bu olasılık %96’nın üzerinde; hatta mimarilerden biri için %100.
Benzer şekilde, evrensel düşmanca örneklerin mimariler arasında genelleştiği gösterildi. Bu, pek çok görüntüye eklendiğinde bu görüntülerin tahminini değiştiren bir pertürbasyondur. Önemlisi, evrensel örnekler yalnızca tek bir ağın tam beyaz kutu bilgisiyle bulunur. Şekil 2’de, farklı mimariler için ne kadar benzer göründüklerini görebilirsiniz. Bunların varlığı, farklı mimarilerin karar sınırları arasında benzerlikler olabileceğini düşündürür.
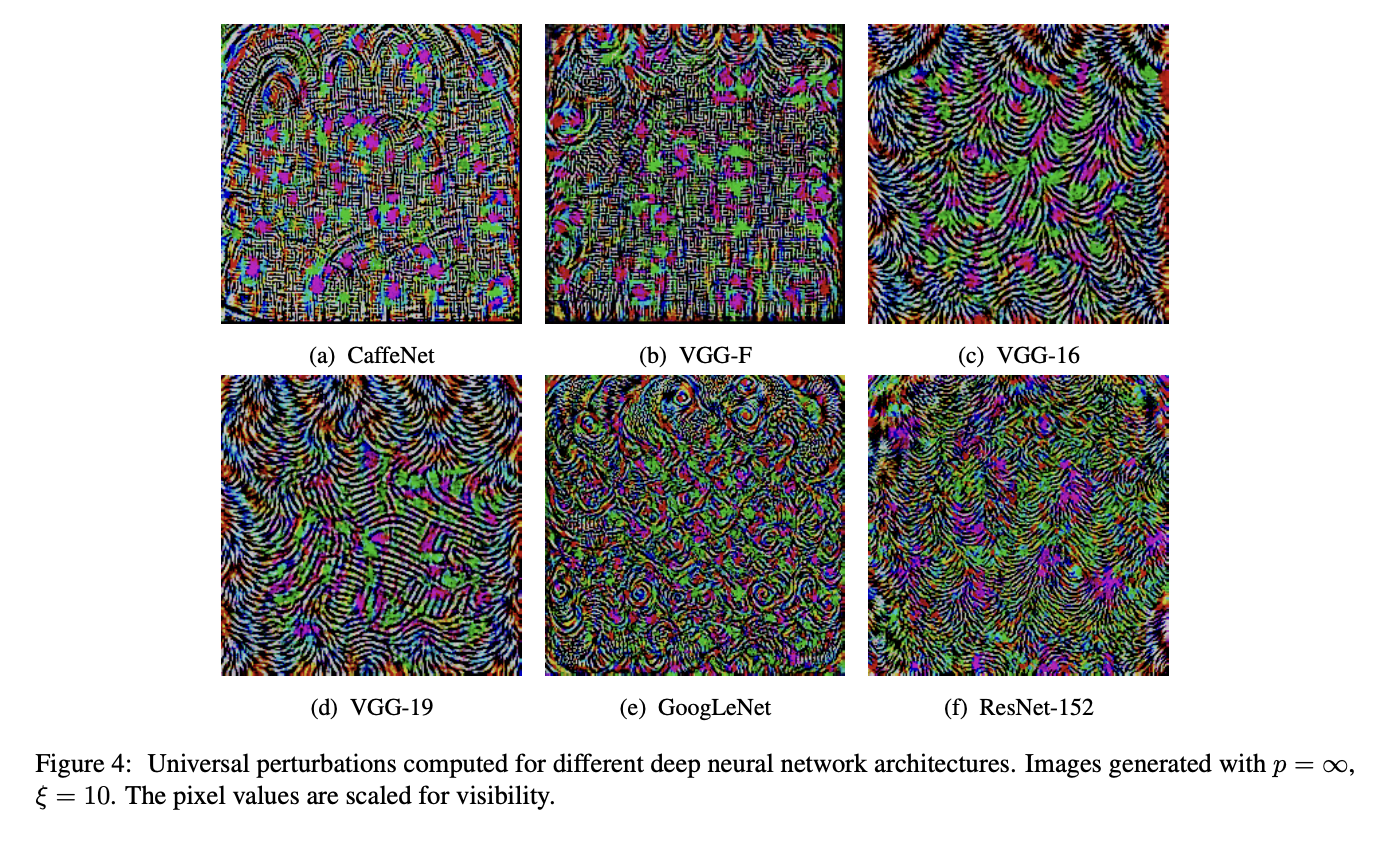
Şekil 2: Farklı derin sinir ağları için hesaplanan evrensel pertürbasyonlar (kaynak: Moosavi-Dezfooli ve diğ.)
Bu bulguların sonucu olarak hiçbir ağ güvende değildir. Kendi modelinizi eğitip beyaz kutu yöntemi çalıştırarak bilinmeyen bir sınıflandırıcıya saldırabilirsiniz.
Son bir umut kırıntısı, bu saldırıların yalnızca sanal ortamda yapılabileceğidir. Çalışmaları için piksel değerlerini değiştirmeniz gerekir. O halde gerçek dünyayla etkileşen modeller için bu yapılamaz, değil mi?
Henüz sevinseniz iyi olur.
Araştırmacılar düşmanca yamalar adı verilen bir yöntem geliştirdi. Bunlar yazdırılıp gerçek zamanlı herhangi bir sahneye eklenerek bir görüntü sınıflandırıcıyı kandırabilir.
Yamalar evrenseldir çünkü herhangi bir sahneye saldırmak için kullanılabilirler; sağlamdır çünkü çok çeşitli dönüşümler altında çalışırlar; ve hedeflidir çünkü bir sınıflandırıcının herhangi bir hedef sınıfı çıktısı üretmesine neden olabilirler.
T. B. Brown et al.
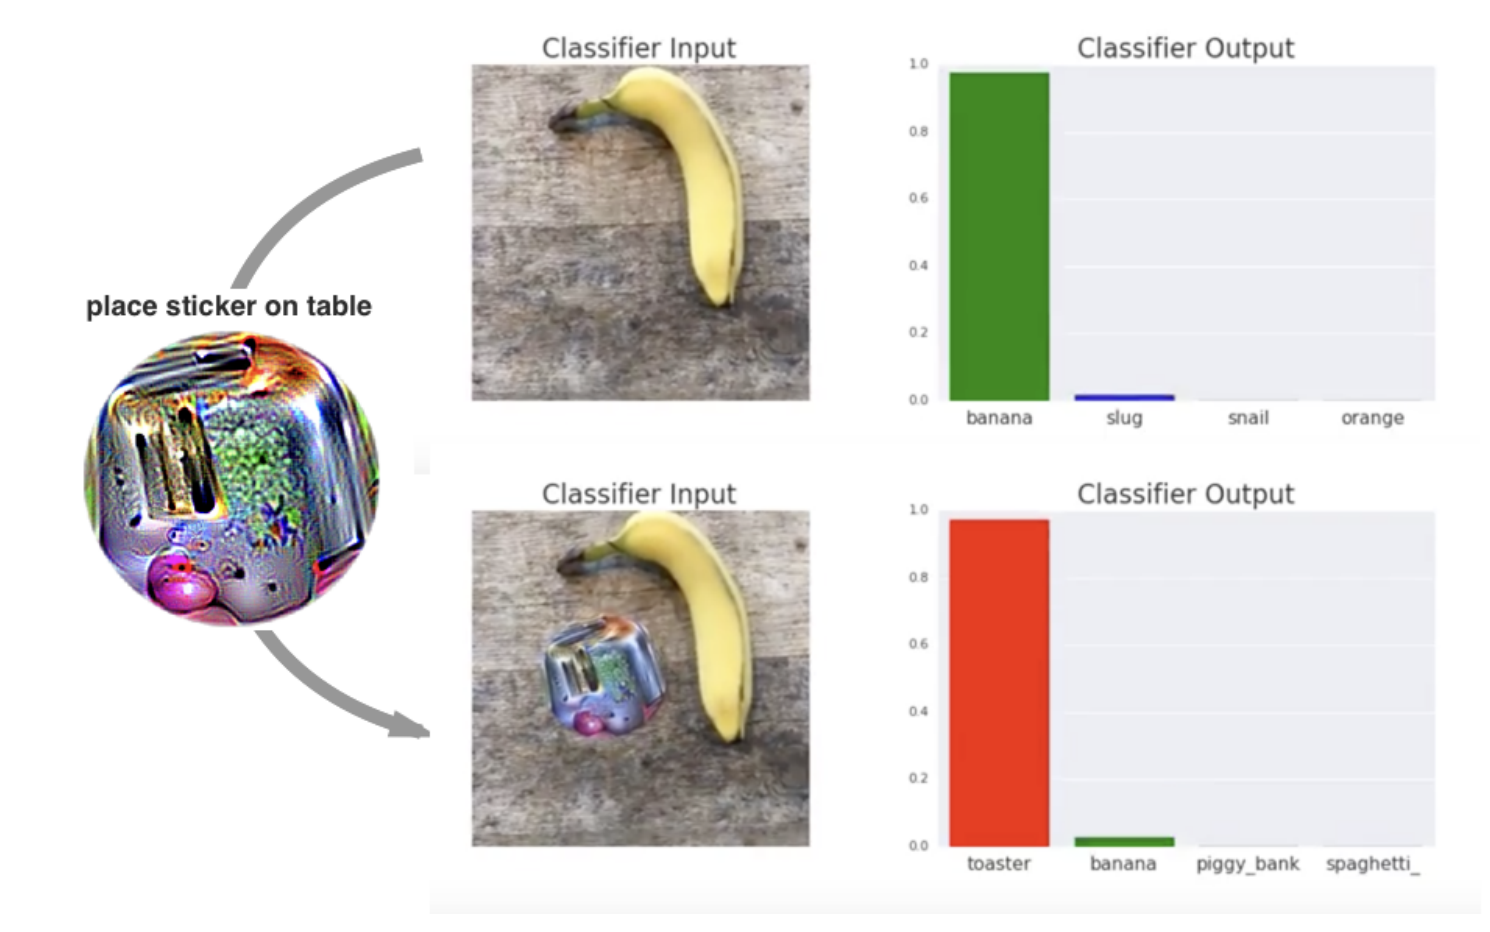
İş başında bir düşmanca yama (kaynak: T. B. Brown ve diğ.)
Benzer araştırmalar, birkaç çıkartma ile bir dur işareti tahmininin değiştirilebileceğini ve bir yüz tanıma modelinin bir gözlükle kandırılabileceğini gösterdi. Yani gerçekten de hiçbir ağ güvende değil. Onları düşmanca saldırılardan korumak için AML’nin diğer tarafına—savunma yöntemlerine—başvuruyoruz.
Ağları savunmanın yolları, onlara saldırma yolları kadar çeşitlidir. Eğitim verilerini, eğitim sürecini veya doğrudan ağı ayarlayabiliriz. Bu bölümün sonunda tartıştığımız gibi, bazen en basit çözüm derin öğrenmeyi hiç kullanmamaktır.
İlk yaklaşım eğitim verilerine odaklanır. Düşmanca eğitim, modelin saldırılara karşı dayanıklılığını artırmak için eğitim veri setinin düşmanca örneklerle zenginleştirilmesini içerir. Bu örnekler, yukarıda bahsedilen bilinen saldırılar kullanılarak bulunur. Temel fikir, modelin eğitim aşamasında düşmanca pertürbasyonlara maruz bırakılması ve bu tür girdileri tanıyıp bunlara direnmeyi öğrenmesidir.
Savunma damıtımı, bir modelin başka bir modelin yumuşatılmış çıktı olasılıklarını taklit edecek şekilde eğitilmesini içerir. Önce standart bir modeli (öğretmen model) orijinal veri seti üzerinde eğitiriz. Öğretmen model, eğitim verileri için yumuşak etiketler (sınıflar üzerindeki olasılık dağılımları) üretir. Daha sonra bir öğrenci model bu yumuşak etiketlerle eğitilir. Sonuç, küçük pertürbasyonlara daha dayanıklı, daha yumuşak karar sınırlarına sahip bir modeldir.
Gradyan maskeleme, modelin gradyanlarını gizleyen veya saklayan çeşitli teknikleri kapsar. Örneğin, ikili bir aktivasyon fonksiyonu gibi türevlenemez bir katman ağa ekleyebiliriz. Bu, sürekli giriş değerlerini ikili çıktılara dönüştürür.
Model değiştirme, ilkel bir gradyan maskeleme yaklaşımıdır. Sistem içinde birden fazla model kullanmayı içerir. Tahmin yapmak için kullanılan model rastgele değiştirilir. Bu, hareketli bir hedef oluşturur; çünkü bir saldırgan hangi modelin o anda kullanıldığını bilemez. Ayrıca bir saldırının başarılı olması için tüm modellerin ele geçirilmesi gerekir.
AML, yapay zekadaki başka bir alanla ilişkilidir: Açıklanabilir Yapay Zekâ (XAI). Burada tartıştığımız pertürbasyon yöntemleri, modellerin nasıl tahmin yaptığını açıklamak için kullanılanlara benzer. Ancak temel benzerlik şudur: Basit modeller yalnızca açıklaması daha kolay olmakla kalmaz, aynı zamanda savunulmaları da daha kolaydır.
Pek çok problem, doğrusal regresyon veya lojistik regresyon gibi basit modellerle çözülebilir. Anlattığımız saldırıların birçoğu bu modeller söz konusu olduğunda etkisiz ya da ilgisizdir.
Bunun nedeni, bu modellerin doğası gereği yorumlanabilir olmasıdır; yani nasıl çalıştıklarını kolayca anlayabiliriz. Zayıflıklar, karmaşık derin öğrenme mimarilerinde olduğu gibi gizli kalmaz. Dolayısıyla, basit bir savunma, sorun için gerekli olmadıkça derin öğrenmeyi hiç kullanmamaktır.
Bu, makalenin başındaki noktaya da bağlıdır—AML, modellerin çalıştığı daha geniş güvenlik ortamıyla ilgilidir. Sonuç olarak, birçok ek savunma yöntemi bu daha geniş ortamı kapsar. Buna bir modeli eğitmeden önce girdi verilerini doğrulamak ve temizlemek dahildir. Anomali tespiti modelleri de, bir ağa iletilmeden önce düşmanca örnekleri tespit etmek için kullanılmıştır. Bunların tümü, yapay zeka sistemiyle birlikte çalışan süreçler gerektirir.
Yapay zekâ ve ML hayatımızın merkezine yerleştikçe, AML giderek daha önemli hale geliyor. Sağlığımız ve finansımız hakkında karar veren sistemlerin kolayca kandırılamaması kritik önemdedir. İster kasıtlı ister kazara olsun. Birkaç çıkartmayla kandırılabilecek bir otonom araca güvenmem. Böyle bir saldırı sürücü tarafından fark edilmeyebilir; ancak aracın yanlış ve hayatî risk taşıyan kararlar almasına neden olabilir.
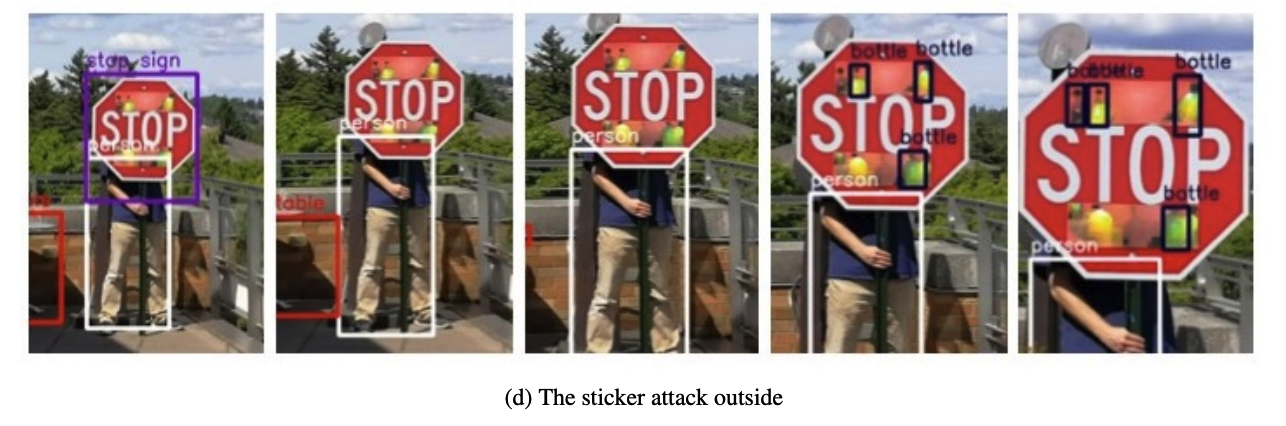 Şekil X: Yolo nesne tespiti v2’nin bir dur işaretini tanıyamaması (kaynak: K. Eykholt ve diğ.)
Bu sistemleri tasarlarken, AML’nin daha büyük bir Sorumlu Yapay Zekâ hareketinin parçası olduğunu kabul etmeliyiz. İyi bir kaleyi yönetmek için bir kral adil davranmalı, kararları gerekçelendirmeli, halkının mahremiyetini korumalı ve onların güvenliğini ve emniyetini sağlamalıdır. AML’nin ele almaya çalıştığı şey de bu son iki boyuttur.
Bununla birlikte, güvenlik ve emniyetin Sorumlu Yapay Zekâ’nın diğer yönlerinden temelde farklı olduğunu da kabul etmeliyiz. Adalet, yorumlanabilirlik ve mahremiyet pasiftir. AML ise kötü niyetli aktörlerin yöntemlerini aktif olarak baltalamaya çalıştığı bir ortamda çalışır.
Bu nedenle, sezgisel olarak ters gelse de, bu alandaki araştırmaların büyük kısmı zayıflıkları ve saldırıları bulmayı amaçlar. Bunlar arasında zehirleme, atlatma, model çıkarma ve çıkarım saldırıları bulunur. Ayrıca burada tartıştığımız FGSM, PGD, C&W ve düşmanca yamalar gibi düşmanca örnek bulmanın daha pratik yöntemleri de dahildir.
Amaç, bunları kötü niyetli aktörlerden önce keşfetmektir. Uygun savunmalar, örneğin düşmanca eğitim, savunma damıtımı ve gradyan maskeleme gibi yöntemler, bu saldırılar zarar vermeden önce geliştirilip etkisiz hale getirilebilir.
Bu anlamda AML, daha geniş siber güvenlik silahlanma yarışının da bir parçasıdır. Yeni zayıflıklar, saldırılar ve savunmalar daima ortaya çıkacaktır; AML araştırmacıları ve profesyonellerinin düşmanca saldırganlardan bir adım önde olmak için mücadele etmeleri gerekecektir.
Bu yarışın bir parçası olmak isterseniz, başlangıç için bazı Python çerçeveleri:
Bu yazıda, düşmanca makine öğrenimi alanını; hedeflerini, farklı saldırı türlerini (zehirleme, atlatma, model çıkarma ve çıkarım) ve düşmanca örneklerin model zayıflıklarını istismar etmek için nasıl kullanıldığını inceledik.
Ayrıca düşmanca eğitim, savunma damıtımı ve gradyan maskeleme gibi çeşitli savunma mekanizmalarını ve uygun olduğunda daha basit modeller kullanmanın önemini tartıştık.
Bu konuyla ilgili daha fazla bilgi edinmek isterseniz, şu kursa göz atın: Veri Güvenliğine Giriş.
Makine öğrenimi hakkında daha fazlasını öğrenin!
Kurs
Kurs
Alıştırma and program your progress.
Google Ile Devam Edinblog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




